私のサイトでは、記事と weeknotes はオーガニック文章だ。その一方で、技術ノートは、LLM 生成だ。純度 100 % の LLM 製だ。恥ずべきことはない。LLM で、正確かつ読みやすい文章を書くための実験場として技術ノートを使っている。ついでに、知らない技術を学ぶためにも活用している。
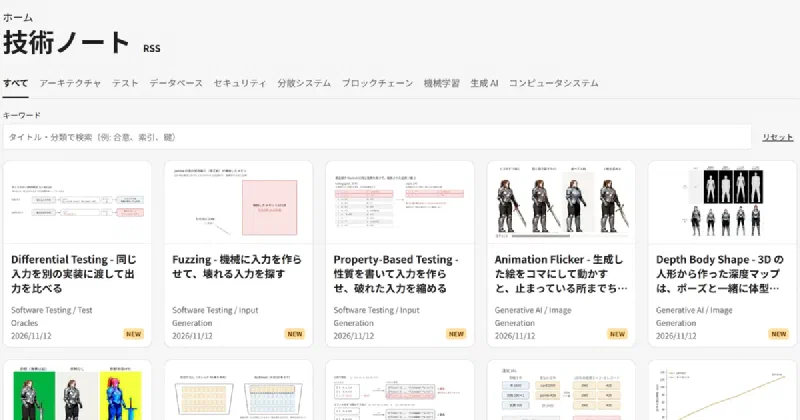
LLM で書いた技術ノートの一覧
私は、文章の品質を上げるために技術ノートを何度も書き直している。初期の頃は、「技術ノートのテンプレート構成」と「nao1215/omokage(サイト内の私の文章を学習し、私の文体との一致度を評価する OSS)」の両輪で技術ノートを書き上げていた。当時は素朴なスキルを使っていた。
技術ノートを増やすたびに、課題に気づいてきた。以下が一例である。
- 私が使わない言い回しや表記(例:DB をデータベースと書く)が登場
- 文章だけでは理解しづらい
- 固定化された技術ノート構成では面白みに欠ける
- Mermaid や Markdown を駆使した表や図が分かりづらい
- 用語の説明がない
上記の課題を解決するために、現在はスキルと git hooks で品質を制御している。執筆前に「読者が最初に知りたい問い」を箇条書きで挙げ、その順で節を組む。面白さは「意外性 × 具体性 × 独自性 × 読者との関連性」と定義し、どれか一つでも 0 なら面白くないと判断する。私の経験が活かせる場合は、その経験をインプットとして渡しておく(例:画像生成系の技術ノートには、直近のゲーム制作での知見が含まれている)。
図は目的で使い分けており、順序や状態は Mermaid、数量は matplotlib、本文と同じ文字組みで並べたい比較や工程は HTML+CSS、時間で変化するものは動く WebP で描く。書き終えたら、初学者役のサブエージェントが上から読み、別のサブエージェントが一次資料と照合して事実確認する。コミット前の検証は、git hooks で機械的に強制している。前のトピックでも書いたが、LLM がスキルを守らないので、Linter に寄せた。
| タイミング | 検査内容 | NG の場合 |
|---|---|---|
| pre-commit |
| コミット不可 |
| pre-push |
| push 不可 |
| 書き直し時 |
| コミット不可 |
| CI(デプロイ時) |
| 最後に公開した版へ戻す |
現状の課題は、面白さや理解しやすさの評価がブレることだ。5 段階評価で 2 であれば「確かに悪い文章だな」と感じるが、評価3〜5 は「なぜこれが評価 3 なんだ?」というケースがある。評価をしている LLM 間でも結果がブレる。一応、評価因子があり、採点ロジックを定量的に決めているが、若干の曖昧さがある。
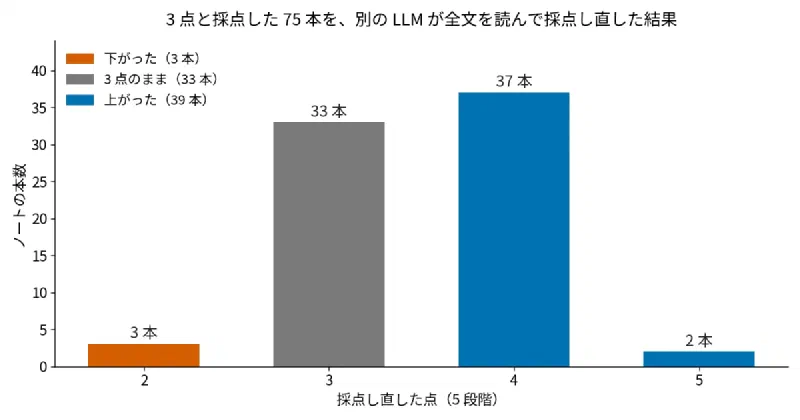
3 点と採点した 75 本を、別の LLM が全文を読んで採点し直した結果