Property-Based Testing(プロパティベーステスト)は、入力と期待値の組を人が書く代わりに、どの入力でも成り立つはずの性質を書き、入力を機械に作らせて性質が破れる入力を探すテスト手法です。性質が破れた入力を反例と呼びます。多くのライブラリは、反例を見つけると、性質が破れたまま入力を小さくする縮小(shrinking)も行います。
著者は 2026 年 8 月に、Go のライブラリ filesql の Distinct に性質を書きました。filesql は CSV などのファイルを SQL で読むライブラリで、Distinct は当時あった frame パッケージの、重複した行を 1 行にまとめる関数です。文書には「全ての列の値が等しい行を重複とみなす」とあり、入力と期待値を並べたテストも通っていました。
性質は「Distinct が返す行の数は、値が本当に異なる行の数に等しい」です。標準ライブラリの testing/quick で入力を作らせると、4 個目の入力で性質が破れ、20 行の表が反例として報告されました。testing/quick は反例を縮めないので、著者は手で行を消して 2 行まで減らし、Issue #354 に報告しました。残った 2 行は、整数の 7 と文字列の “7” のように、値は異なるのに Distinct が 1 行にまとめた組でした。
手元では、修正前のコードを写し、同じ性質を testing/quick と、反例を縮める rapid で回し直しました。下の図は、乱数の初期値(種)を 1 にした回の反例で、Issue の 20 行の表とは別の表です。
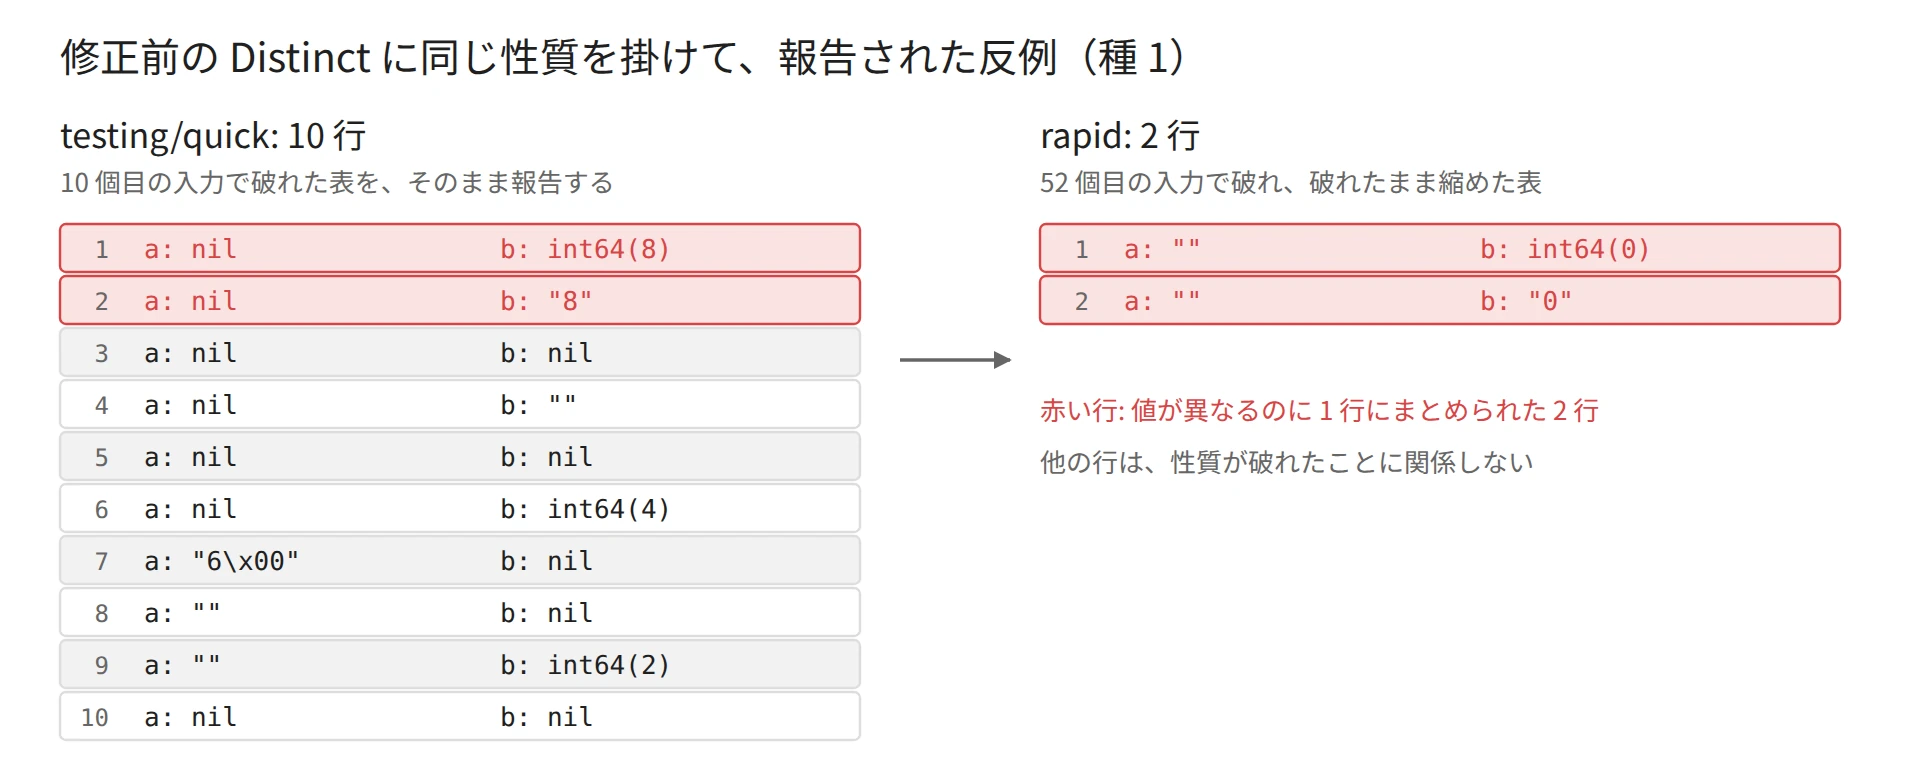
testing/quick は 10 行の表、rapid は原因の 2 行だけを返した(種 1)
左の 10 行のうち、性質が破れた原因は赤い 2 行だけです。残りの 8 行は、原因を探す人が 1 行ずつ消して確認する必要があります。右の rapid は、その作業を済ませた 2 行を返しています。
本記事では、Issue #354 のバグと、その修正に残っていたもう 1 つのバグを手元で再現し、Property-Based Testing の書き方と、反例の縮小、入力の範囲の決め方を説明します。扱う疑問は以下の通りです。
- 入力と期待値を並べるテストと、何が違うのか。
- 反例を縮めると、何が変わるのか。
- 入力の作り方の違いで、見つかるバグがどう変わるのか。
- Fuzzing と何が違い、どう使い分けるのか。
- テストに足す時に、何を決めるのか。
例ではなく性質を書く
本記事では、入力と期待値の組を並べるテストを例のテストと呼びます。Go ではテーブル駆動テストの形でよく書きます。例のテストは、書いた人が思い付いた入力しか試しません。Distinct の例のテストには、整数の行だけの表や、文字列の行だけの表はありましたが、整数の 7 と文字列の “7” が同じ列に並ぶ表はありませんでした。
Property-Based Testing では、例の代わりに 2 つを書きます。1 つは入力の作り方で、生成器(generator)と呼びます。もう 1 つは、作った入力で成り立つはずの性質です。ライブラリは生成器で入力を作り、性質を確認する処理を数百回繰り返します。
以下は、本記事の実験で使う性質です。行の値を Go の配列にして map の鍵に入れると、型と値が両方同じ行だけが 1 つにまとまります。この単純な数え方を正しい答えとして、Distinct の結果の行数と比べます。
// 表は a と b の 2 列。セルは nil、int64、string のどれか。
type table [][2]any

// 性質: Distinct が返す行の数は、値が本当に異なる行の数に等しい。
// セルは nil・int64・string だけなので、[2]any を map の鍵にすれば
// 「型と値が両方同じ」の比較になる。
func check(tb table) error {
	want := map[[2]any]struct{}{}
	for _, r := range tb {
		want[r] = struct{}{}
	}
	rowKey := makeRowKey
	if os.Getenv("KEY") == "fixed" {
		rowKey = fixedRowKey
	}
	got := len(DistinctWith(tb.rows(), []string{"a", "b"}, rowKey))
	if got != len(want) {
		return fmt.Errorf("Distinct は %d 行、異なる行は %d 行", got, len(want))
	}
	return nil
}
tb.rows() は、列名から値への map を並べた Distinct の入力の形に、表を直す関数です。DistinctWith は、行の鍵を作る関数を差し替えられるように実験で足した関数で、makeRowKey を渡すと修正前の Distinct と同じ動きになります。fixedRowKey は後の実験 2 で使う修正後の鍵で、環境変数 KEY で切り替えます。
性質を確認するためには、正しい答えを別の方法で出す必要があります。ここでは、map で数えるという遅いが間違えにくい方法を使いました。正しい答えを出す方法が見つからない時に、入力を変えた時の出力の関係で確認する方法は Metamorphic Testing のノートで、同じ仕様の別の実装と比べる方法は Differential Testing のノートで扱っています。
QuickCheck から rapid まで
Property-Based Testing は、Haskell の QuickCheck を説明した 2000 年の論文 で広まりました。Python には Hypothesis があり、本記事で使う rapid はこれを手本にしています。
Go では、標準ライブラリの testing/quick が関数の引数の型から入力を作ります。ただし、testing/quick は新しい機能を受け付けない方針(frozen)で、反例の縮小もありません。本記事で使う rapid は、README で Hypothesis と同じ使い勝手を Go に持ち込むことを目的に掲げ、反例を自動で縮めます。バージョンは 2026-03-30 に出た v1.3.0 を使いました。
修正前の Distinct が 1 行にまとめた値
修正前の Distinct は、行ごとに鍵となる文字列を作り、同じ鍵が 2 回目に出た行を捨てていました。鍵を作る関数は以下です。main ブランチの commit 014315b から写しました。
// makeRowKey は修正前の filesql と同じ。値を %v で文字列にし、NUL でつなぐ。
func makeRowKey(row map[string]any, columns []string) string {
	parts := make([]string, len(columns))
	for i, col := range columns {
		parts[i] = fmt.Sprintf("%v", row[col])
	}
	// Use null byte as separator to avoid collisions
	return strings.Join(parts, "\x00")
}
%v は値を文字列にする書式で、整数の 7 も文字列の “7” も同じ 7 になります。値が無いことを表す nil は <nil> という文字列になります。列の値の区切りには、文字列に入りにくい NUL(\x00)を使っていました。コメントには「衝突を避けるために NUL を区切りに使う」とありますが、値の中に NUL があると区切りの位置がずれ、別の組と同じ鍵になります。
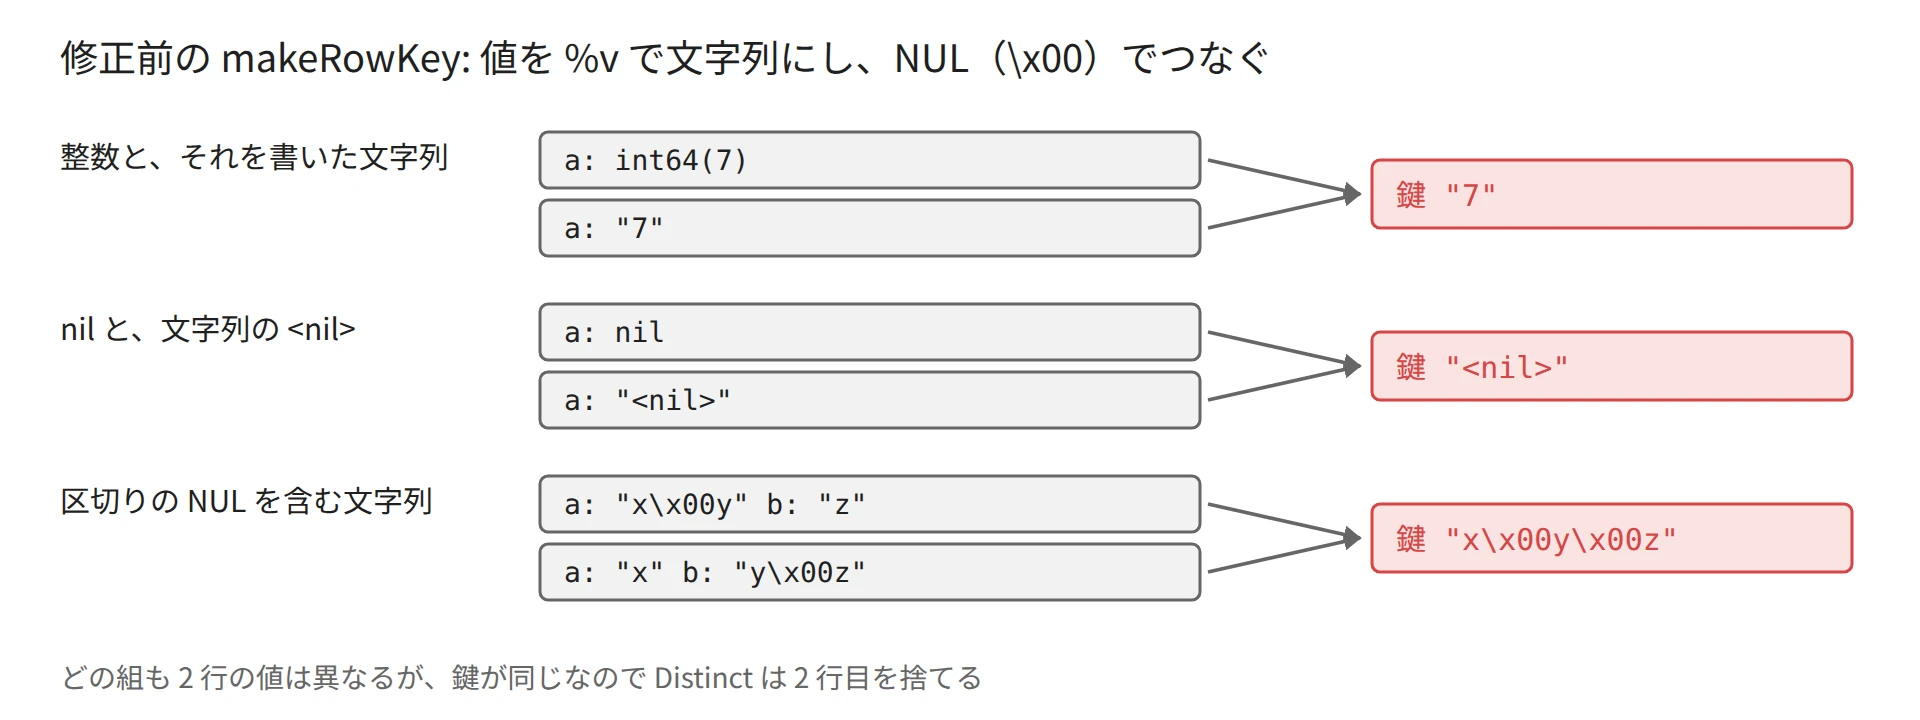
値の異なる 2 行が、同じ鍵になる 3 つの組
3 つの組は、どれも Issue #354 に書いた反例です。filesql は commit 305c7bf で、値の型ごとに印を付け、値の文字列の前に長さを書く形に鍵を変えました。例えば、整数の 7 は n1:7、文字列の “7” は s1:7、nil は z0: になります。長さがあると、値の中の NUL が隣の値に届きません。この修正にはもう 1 つ、数を全て float64 にしてから文字列にするという処理が入っていて、それが実験 2 の題材になります。
なお、frame パッケージは v0.48.0 で filesql から削除されました。本記事の実験では、修正前と修正後の鍵を作る関数を lab に写して使います。
実験 1: 同じ性質を testing/quick と rapid で回す
実験 1 では、修正前の鍵に同じ性質を掛け、2 つのライブラリが返す反例を比べます。表は 0〜20 行・2 列で、セルは nil・整数・文字列のどれかです。生成器は 2 つ用意しました。
- 狭い生成器: 整数は 0〜9、文字列は数字・
x・NUL から 0〜2 文字。 - 広い生成器: 整数は int64 の全範囲、文字列はライブラリの既定の作り方。
以下は rapid の生成器と、性質を確認するテストです。testing/quick の生成器も同じ範囲で書きました(下の折り畳み)。1 回の実行で入力を最大 500 個作り、乱数の種を 1〜100 に変え、ライブラリと生成器の 4 つの組ごとに 100 回実行しました。
// rapid の生成器。狭い・広いの範囲は testing/quick と同じにする。
func rapidCell(gen string) *rapid.Generator[any] {
	if gen == "broad" {
		return rapid.OneOf(
			rapid.Just[any](nil),
			rapid.Map(rapid.Int64(), func(v int64) any { return v }),
			rapid.Map(rapid.String(), func(v string) any { return v }),
		)
	}
	return rapid.OneOf(
		rapid.Just[any](nil),
		rapid.Map(rapid.Int64Range(0, 9), func(v int64) any { return v }),
		rapid.Map(rapid.StringOfN(rapid.SampledFrom([]rune(narrowRunes)), 0, 2, -1), func(v string) any { return v }),
	)
}

func rapidTable(gen string) *rapid.Generator[table] {
	cell := rapidCell(gen)
	row := rapid.Custom(func(t *rapid.T) [2]any { return [2]any{cell.Draw(t, "a"), cell.Draw(t, "b")} })
	return rapid.Map(rapid.SliceOfN(row, 0, 20), func(v [][2]any) table { return table(v) })
}

func TestRapid(t *testing.T) {
	gen := rapidTable(os.Getenv("GEN"))
	rapid.Check(t, func(t *rapid.T) {
		tb := gen.Draw(t, "table")
		if err := check(tb); err != nil {
			logShrink(tb)
			t.Fatalf("反例 %d 行: %s: %v", len(tb), show(tb), err)
		}
	})
}
rapid.OneOf は複数の生成器から 1 つを選んで値を作り、rapid.Map は作った値を別の型に変えます。StringOfN の引数は最小と最大の文字数と、バイト数の上限で、-1 は上限無しです。Draw は、生成器から値を 1 つ取り出します。
narrowRunes は狭い生成器が使う文字の一覧 "0123456789x\x00" です。logShrink は、縮める途中で性質が破れた表をファイルに記録する、実験用の関数です。lab の実際のコードには、後の実験 2 で使う 3 つ目の生成器も入っています。
testing/quick の生成器(lab/distinct/distinct_test.go から抜粋)
testing/quick は、引数の型が Generate という関数を持っていれば、それを呼んで入力を作ります。
type narrowTable table

func narrowCell(r *rand.Rand) any {
	switch r.Intn(3) {
	case 0:
		return nil
	case 1:
		return int64(r.Intn(10))
	default:
		var b strings.Builder
		for range r.Intn(3) {
			b.WriteByte(narrowRunes[r.Intn(len(narrowRunes))])
		}
		return b.String()
	}
}

func genTable(r *rand.Rand, cell func(*rand.Rand) any) table {
	tb := make(table, r.Intn(21)) // 0〜20 行
	for i := range tb {
		tb[i] = [2]any{cell(r), cell(r)}
	}
	return tb
}

func (narrowTable) Generate(r *rand.Rand, _ int) reflect.Value {
	return reflect.ValueOf(narrowTable(genTable(r, narrowCell)))
}

// 種ごとに quick.Check を呼ぶ。
cfg := &quick.Config{MaxCount: 500, Rand: rand.New(rand.NewSource(int64(seed)))}
err = quick.Check(func(tb narrowTable) bool { return check(table(tb)) == nil }, cfg)
結果は以下の通りです。「何個目」は性質が初めて破れた入力の番号で、100 回の中央値です。
| ライブラリ | 生成器 | 見つけた回数 | 何個目 | 反例の行数 |
|---|---|---|---|---|
| testing/quick | 狭い | 100 / 100 | 10 | 6〜20、中央値 15.5 |
| rapid | 狭い | 100 / 100 | 24 | 100 回とも 2 |
| testing/quick | 広い | 0 / 100 | - | - |
| rapid | 広い | 2 / 100 | 124.5 | 2 回とも 2 |
狭い生成器では、どちらも 100 回とも見つけました。違いは反例の大きさで、testing/quick は最初に破れた表をそのまま返し、rapid は 100 回とも 2 行まで縮めました。
rapid は破れたまま縮める
rapid は、入力を作る時に引いた乱数の列を記録しておきます。反例が見つかると、その列の一部を消したり値を小さくしたりして入力を作り直し、性質がまだ破れるかを試します。破れたら、小さくした方を新しい反例として残します。以下の動画は、種 1 で性質が破れた 23 個の表を破れた順に並べたものです。最初の 1 個が見つけた反例で、残りの 22 個が縮めた結果です。
20 行の反例が、22 回縮めて原因の 2 行になる(1 個 0.5 秒で表示)
最初の 20 行の表で原因になっていたのは、3 行目と 13 行目の 2 行です。rapid は行を消す試しを繰り返し、原因の 2 行を残したまま、関係の無い 18 行を消しました。表の中の値も、整数は 0、文字列は空文字列に近づいていきます。rapid は縮めた反例を testdata/rapid/ に保存し、次の実行では乱数で入力を作る前にその反例を試します。
縮めた反例は、原因を 1 つしか見せません。狭い生成器の 100 回の反例は、全て整数と文字列の組で、NUL の組は 1 回も出ませんでした。縮小は最初に見つけた表の中で行うので、乱数で作った表に現れやすい整数と文字列の組が残ります。そのため、1 つ直した後も、同じ性質で反例を探し直す必要があります。
広い生成器では見つからない
広い生成器では、testing/quick は 100 回とも見つけられませんでした。int64 の全範囲から 2 つ選んだ整数が、たまたま同じ文字列と組になることはほぼありません。rapid の 2 回は、int64(2) と "2" のように小さい値の組でした。rapid は README にあるように、小さい値や端の値を多めに作るので、広い範囲を指定しても 0 に近い値が出ます。
衝突を探す性質では、入力の範囲を広げるほど、同じ値や似た値の組ができにくくなります。範囲を広げれば強いテストになるわけではありません。
実験 2: 修正後の鍵と、2^53 の境界
commit 305c7bf の修正では、整数と小数を同じ値として扱うために、数を全て float64 にしてから文字列にしていました。filesql の文書が「1 と 1.0 と 1.00 は同じ値」と定めていたからです。
ところが float64 は、2^53(9007199254740992)を超える整数を全ては表せません。float64 は数の精度が 53 ビットなので、2^53 を超えると表せる整数が 2 つおきになります。間の整数は両隣から等しく離れているので、決まりに従って両隣のうち 4 の倍数の方へ丸まります。
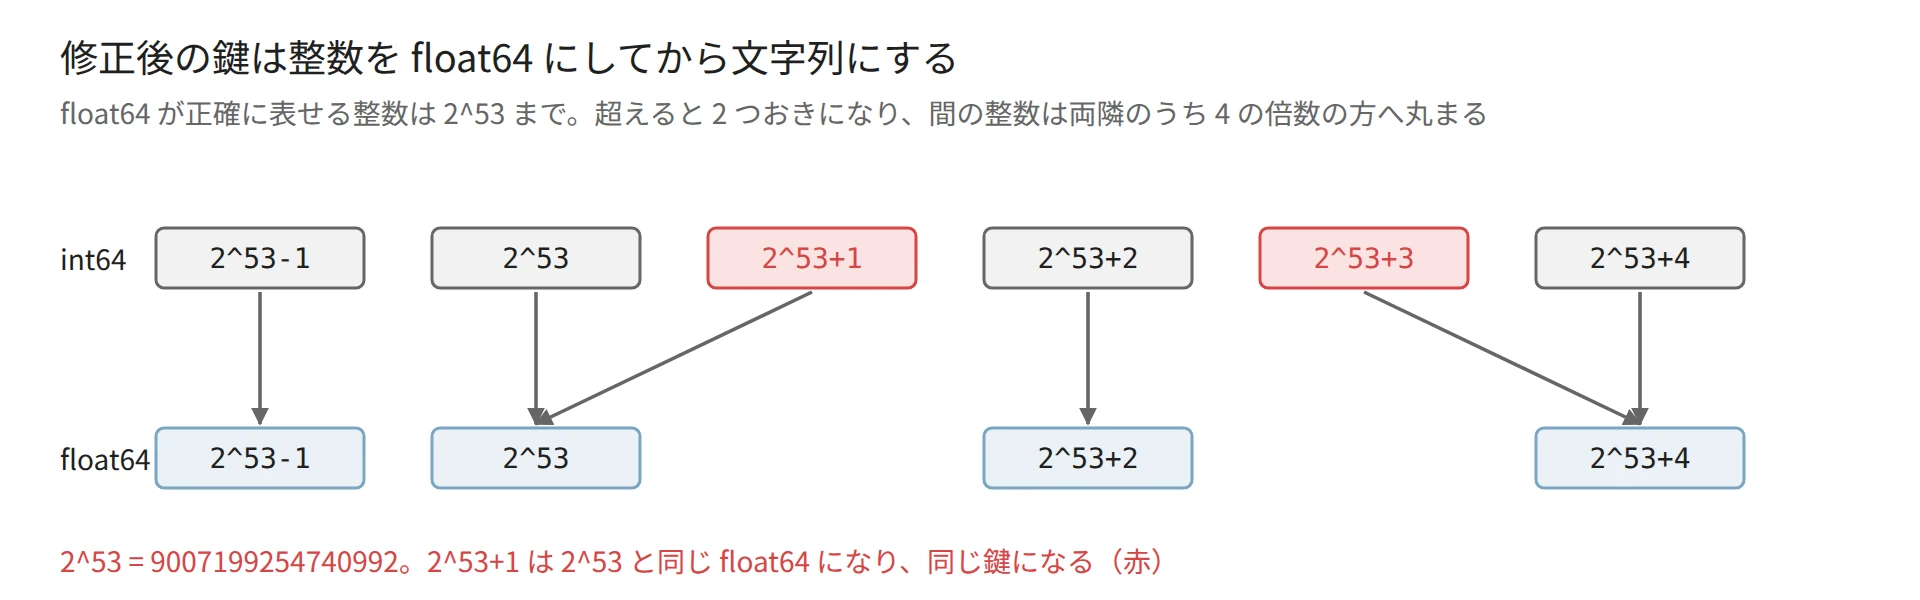
2^53 を超えると、隣り合う 2 つの整数が同じ float64 になる
そのため、修正後の鍵では、2^53 と 2^53+1 が同じ鍵になり、Distinct は 1 行にまとめます。著者は修正の 7 時間後に、整数の境界の値を試す境界値分析でこれを見つけ、Issue #379 に報告しました。修正は v0.44.0 の公開前に入ったので、このバグを含むバージョンは公開されていません。
実験 2 では、修正後の鍵に rapid で性質を掛け、生成器の範囲で結果が変わるかを確認しました。実験 1 の 2 つの生成器に、整数に 2^53 の前後を混ぜた生成器を足しています。
// rapidCell の先頭に足した分岐(lab の distinct_test.go から抜粋)
if gen == "edge" {
	// 境界を足した生成器: 整数に、float64 で正確に表せる最大の連続した整数 2^53 の前後を混ぜる。
	return rapid.OneOf(
		rapid.Just[any](nil),
		rapid.Map(rapid.OneOf(rapid.Int64Range(0, 9), rapid.Int64Range(1<<53-2, 1<<53+2)), func(v int64) any { return v }),
		rapid.Map(rapid.StringOfN(rapid.SampledFrom([]rune(narrowRunes)), 0, 2, -1), func(v string) any { return v }),
	)
}
| 生成器 | 見つけた回数 | 縮めた反例 |
|---|---|---|
| 狭い | 0 / 100 | - |
| 広い | 0 / 100 | - |
| 2^53 の前後を混ぜる | 100 / 100 | 2^53 と 2^53+1 が並ぶ 2 行 |
狭い生成器の整数は 0〜9 なので、2^53 には届きません。広い生成器は 2^53 を超える整数も作りますが、2 つの整数が隣り合う確率はほぼ 0 です。2^53 の前後を混ぜると 100 回とも見つかりました。縮めた反例は、もう 1 つの列の値は回によって違いますが、どれも int64(9007199254740992) と int64(9007199254740993) が同じ列に並ぶ 2 行でした。
Property-Based Testing は、境界値分析を置き換えません。どこに境界があるかを知っているのは人で、その境界を生成器に入れると、境界の周りの組み合わせを機械が試します。実験 2 で 2^53 の前後を混ぜたのは、Issue #379 で答えを知っていたからです。
実験 3: 同じ性質を fuzz に掛ける
Fuzzing は、既にある入力を少しずつ変えて新しい入力を作ります。変えた入力がプログラムの新しい分岐を通ると、その入力を次に変える元として残します。どの分岐を通ったかの記録をカバレッジと呼びます。最初の入力は f.Add で渡します。Go の go test -fuzz が作れるのは、バイト列や数・文字列のような基本の型だけで、表は作れません。そこで実験 3 では、バイト列を表に読み替えてから同じ性質を確認しました。
// go test -fuzz に掛ける。バイト列を表に読み替える。
// 1 バイト目が行の数、各セルは 1 バイトの種類の後に、整数なら 8 バイト、
// 文字列なら 1 バイトの長さ(16 で割った余り)とその長さのバイト列。
func FuzzDistinct(f *testing.F) {
	f.Add([]byte{1, 0, 0})
	f.Fuzz(func(t *testing.T, data []byte) {
		tb := decode(data)
		if err := check(tb); err != nil {
			t.Fatalf("反例 %d 行: %s: %v", len(tb), show(tb), err)
		}
	})
}
読み替える関数 decode は distinct_test.go にあります。行の数は 1 バイト目を 21 で割った余りです。セルの種類は、種類のバイトを 3 で割った余りが 0 なら nil、1 なら整数、2 なら文字列です。バイトが尽きて種類のバイトが無いセルは nil になります。
修正前と修正後の鍵で 5 回ずつ、1 回 60 秒まで回しました。Go の fuzz は、新しい分岐を通った入力をキャッシュのディレクトリに残し、次の実行の出発点にします。回ごとに go clean -fuzzcache でキャッシュを消し、前の回が見つけた入力を引き継がないようにしています。
| 鍵 | 見つけた回数 | 見つけるまでの時間 | 反例の行数 |
|---|---|---|---|
| 修正前 | 5 / 5 | 0.4〜1.8 秒 | 4 回は 6 行、1 回は 8 行 |
| 修正後 | 5 / 5 | 0.8〜1.4 秒 | 5 回とも 6 行 |
fuzz は 5 回とも 2 秒以内に、修正後のバグを見つけました。実験 2 で、rapid の広い生成器が 1 回も見つけられなかったバグです。
2^53 という境界を教えていないのに見つかったのは、fuzz が既にある入力の一部を写したり、1 バイトだけ変えたり、小さな値を足し引きしたりして新しい入力を作るからです。8 バイトの整数を写して 1 バイト変えると、下の図のように、隣り合う整数の組ができます。rapid の README も、testing.F.Fuzz と比べて、rapid は構造のある値を作るのは得意だが、カバレッジの手掛かりと入力を少しずつ変える仕組みは持たない、と書いています。
fuzz はバイト列を縮める
一方で、fuzz が返す反例は表として縮んでいません。下の図は、修正後の鍵の 1 回目で見つかった入力と、それを表に読み替えた結果です。
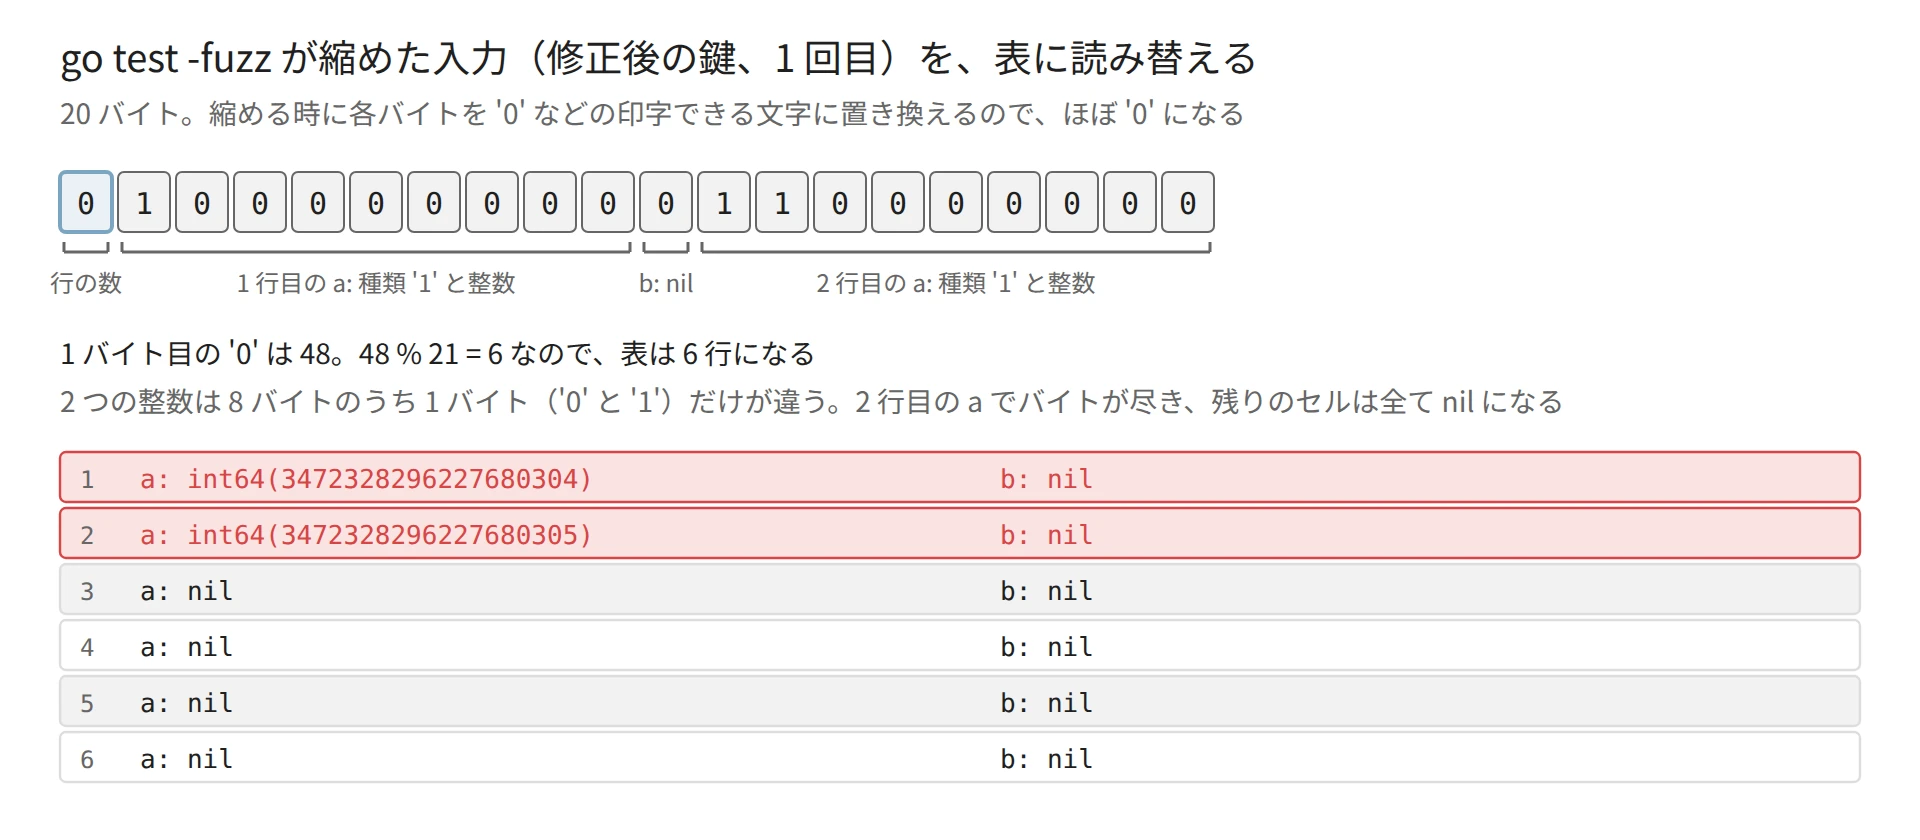
fuzz はバイト列を縮めるので、読み替えた表には nil だけの 4 行が残る
Go の fuzz は、反例のバイト列を短くした後、各バイトを 0 などの印字できる文字に置き換えて読みやすくします。1 バイト目の 0 は 48 で、48 を 21 で割った余りは 6 なので、表は 6 行になります。種類のバイトの 1 は 49 で、3 で割った余りが 1 なので整数、0 は余りが 0 なので nil です。性質に関係するのは赤い 2 行だけで、残りの 4 行はバイトが尽きて nil になった行です。2 つの整数は約 3.5 × 10^18 で、2^53 を大きく超えています。
fuzz は入力をバイト列としてしか知らないので、「行を 1 つ消す」という縮め方ができません。rapid の MakeFuzz を使うと、rapid の生成器は乱数の代わりに go test -fuzz が作るバイト列を引きます。fuzz の書き換えで入力を探し、値の作り方は rapid の生成器に任せる形です。
似た手法との違い
ここまでの 3 つの実験と、Software Testing の他のノートの手法を並べます。
| 手法 | 入力を作るもの | 確認すること | 失敗時に返るもの |
|---|---|---|---|
| 例のテスト | 人 | 書いた期待値 | 書いた入力 |
| Property-Based Testing | 生成器 | 出力の性質 | 縮めた値 |
| Fuzzing | 入力の書き換え | 落ちない・止まる・性質 | 縮めたバイト列 |
| Metamorphic Testing | 人か生成器 | 2 つの出力の関係 | 入力の組 |
| Differential Testing | 人か生成器 | 別の実装との一致 | 食い違った入力 |
Fuzzing は panic しないことを確認する使い方が多いですが、実験 3 のように性質も確認できます。
Property-Based Testing は、値の構造を知っている生成器で入力を作るので、反例を値の形で縮められます。Fuzzing は値の構造を知らない代わりに、カバレッジと入力の書き換えで、人が範囲を決めていない所まで届きます。実験 3 のように、同じ性質を両方で回すこともできます。
性質の見つけ方
性質を書けないことが、Property-Based Testing を足す時の一番の壁です。著者の OSS で反例が見つかった性質は、以下のどれかの形でした。
| 性質の形 | 書き方 | 見つかった例 |
|---|---|---|
| 単純な実装と比べる | 遅いが間違えにくい方法で答えを出す | 本記事の Distinct(filesql #354) |
| 往復 | 変換して戻すと元に戻る | geokit の zoom 0 のタイル(#20) |
| 変換の関係 | 入力を変えた時の出力の変わり方 | jsonize の wc の合計の行 |
| 壊れない | どの入力でも panic せず、上限を超えない | filesql の Parquet の読み取り |
jsonize は、コマンドの出力を JSON に変換する著者の CLI です。往復の例の geokit は、著者が Gleam という言語で書いている地図のライブラリです。地図を正方形のタイルに分け、タイルの位置を quadkey という文字列で表します。zoom は分け方の細かさで、zoom 0 は世界全体を 1 枚のタイルで表します。
geokit には「タイルを quadkey にして戻すと元のタイルになる」という往復の性質を書き、反例は zoom 0 に縮みました。Bing Maps のタイルの仕様では quadkey の桁数が zoom に等しいので、zoom 0 の quadkey は空文字列になります。仕様の表は zoom 1 から始まるので、zoom 0 は規則から導いた値です。geokit は空文字列を作る一方で、空文字列を読むとエラーを返していました。この件は geokit の Issue #20 にあります。縮小が 0 や空の方へ寄るので、端の値のバグは小さい反例になります。
変換の関係は Metamorphic Testing のノートの wc の実験で、壊れないことは Fuzzing のノートの実験で扱っています。
Property-Based Testing を足す時に決めること
性質と生成器を書くと、テストは数十行になります。本記事の実験と filesql の 2 つの Issue で結果を分けたのは、以下の 4 つでした。
| 決めること | 判断の材料 |
|---|---|
| ライブラリ | 反例を縮めるか。Go なら testing/quick は縮めず、新しい機能も入らない |
| 生成器の範囲 | 同じ値や似た値の組ができる程度に狭く、0・空・2^53 などの境界を混ぜたか |
| 正しい答え | 単純な実装、往復、関係のどれで性質を書くか |
| fuzz との併用 | 隣り合う値や壊れた形式を探すなら、同じ性質を fuzz でも回すか |
既にある関数に Property-Based Testing を足すなら、最初は文書に書かれた約束を 1 つ選び、それを性質にします。Distinct の性質は、文書の「全ての列の値が等しい行を重複とみなす」という文を数え方に書き直しただけでした。反例が見つかったら、縮めた反例を例のテストとして残し、性質の方は生成器に境界を足しながら回します。
実験のスクリプトと出力は lab に、図の生成元は figures.py にあります。