Metamorphic Testing(メタモルフィックテスト)は、出力の正解が分からない処理をテストする手法です。1 つの入力に対する正解を書く代わりに、「入力をこう変えたら、出力はこう変わるはず」という関係を書き、2 つの出力がその関係を満たすかを検証します。
以下は、コマンドの出力を JSON に変換する著者の CLI である jsonize(コマンド名は jz)で、1 つの関係を検証した結果です。関係は「2 つのファイルを 1 回で wc に渡して読んだ結果は、1 ファイルずつ読んでつないだ結果と等しいはず」です。しかし、1 回で読むと要素が 1 つ多くなりました。
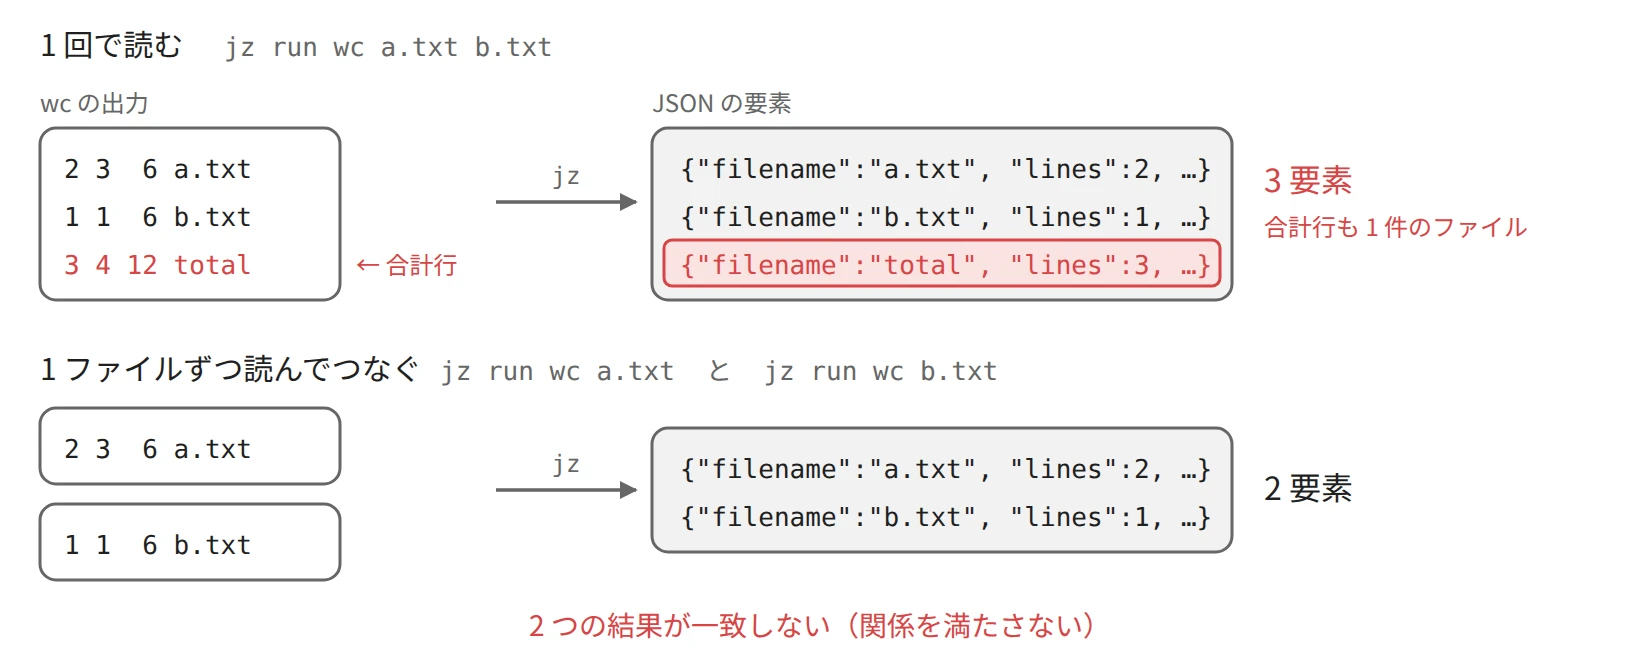
1 回で読むと、wc の合計行が total という名前のファイルとして 1 件増える
wc は引数が 2 つ以上ある時、最後に合計の行を 3 4 12 total の形で出します。この行は total という名前のファイルの行と字面が同じです。jz はコマンドごとに、出力の各行を正規表現で読む「定義」を持っています。wc の定義は全ての行を同じ形で読むので、合計行もファイルの 1 件になります。そのため、JSON を受け取ったプログラムが全要素の行数を足すと、合計を二重に数えます。
wc の出力から作るべき JSON を人が書いて比べるテストでは、書いた人が合計行に気付いていなければ、この行を期待値に含めたままテストが通ります。関係で検証すると、期待値を書かずにこの食い違いが見つかります。
本記事では、正解を書けない処理をテストする考え方と、jsonize で実際に使った関係を手元の実験で説明します。扱う疑問は以下の通りです。
- 正解を書けない処理は、何を基準にテストするのか。
- 関係とは何で、普通のテストとどう違うのか。
- 関係で、実際にどんな問題が見つかるのか。
- 関係はどうやって見つけ、どう書くのか。
- 関係を満たさなかった時、バグなのか、関係の方が間違っているのか。
正解を書けない処理
テストは普通、入力と期待値の組を書きます。例えば、add(1, 2) が 3 を返すかを確認するテストです。出力が正しいかを判定する仕組みは、テストオラクル(test oracle)と呼ばれます。上記の例では、人が書いた 3 がオラクルです。
しかし、期待値を人が書けない処理や、書いても正しいと言い切れない処理があります。検索の結果の並び、機械学習のモデルの出力、コンパイラの最適化、数値計算などです。Weyuker 氏は 1982 年の論文 On Testing Non-Testable Programs で、オラクルを用意できないプログラムを「テストできないプログラム」と呼びました。オラクルを用意できないことは、テストオラクル問題(test oracle problem)と呼ばれます。
コマンドの出力を読むパーサーも、この種類の処理です。jsonize は v0.9.1 で 280 個のコマンドの出力を読みます。定義ごとに本物の出力を fixture として保存し、期待する JSON を golden ファイルとして置いて比べています。golden は定義の出力から生成し、定義を書いた本人が差分を目で見て置きます。そのため、本人が気付かなかった値の欠落は golden にも残り、テストは通ります。golden が保証するのは「前と同じ」までで、「正しい」ではありません。
テストの種類ごとに、何を正解とみなすかを並べると以下の通りです。
| テストの種類 | 正解とみなすもの | 正解を書けない時 |
|---|---|---|
| 例を使うテスト | 人が書いた期待値 | 使えない |
| golden(snapshot)テスト | 前に保存した出力 | 前と同じことしか分からない |
| Property-Based Testing | 1 つの出力が満たす性質 | 性質が見つかれば使える |
| Metamorphic Testing | 複数の出力の間の関係 | 関係が見つかれば使える |
| Differential Testing | 別の実装の出力 | 別の実装があれば使える |
Property-Based Testing は、Haskell の QuickCheck の論文で広まった手法で、「ソートした結果は昇順に並ぶ」のような、1 つの出力だけで判定できる性質を書きます。Differential Testing は、同じ仕様の別の実装と出力を比べます。
Metamorphic Testing は、1 つの出力だけでは正しさを判定できず、比べる別の実装も無い時に使います。入力を変えて同じ処理をもう一度実行し、自分の出力どうしを比べます。
関係による検証
Metamorphic Testing は、Chen 氏らが 1998 年の技術報告 Metamorphic Testing: A New Approach for Generating Next Test Cases で提案しました。元の入力から決まった変換で次の入力を作り、2 つの出力が満たすはずの関係を検証します。この関係を metamorphic relation と呼びます。
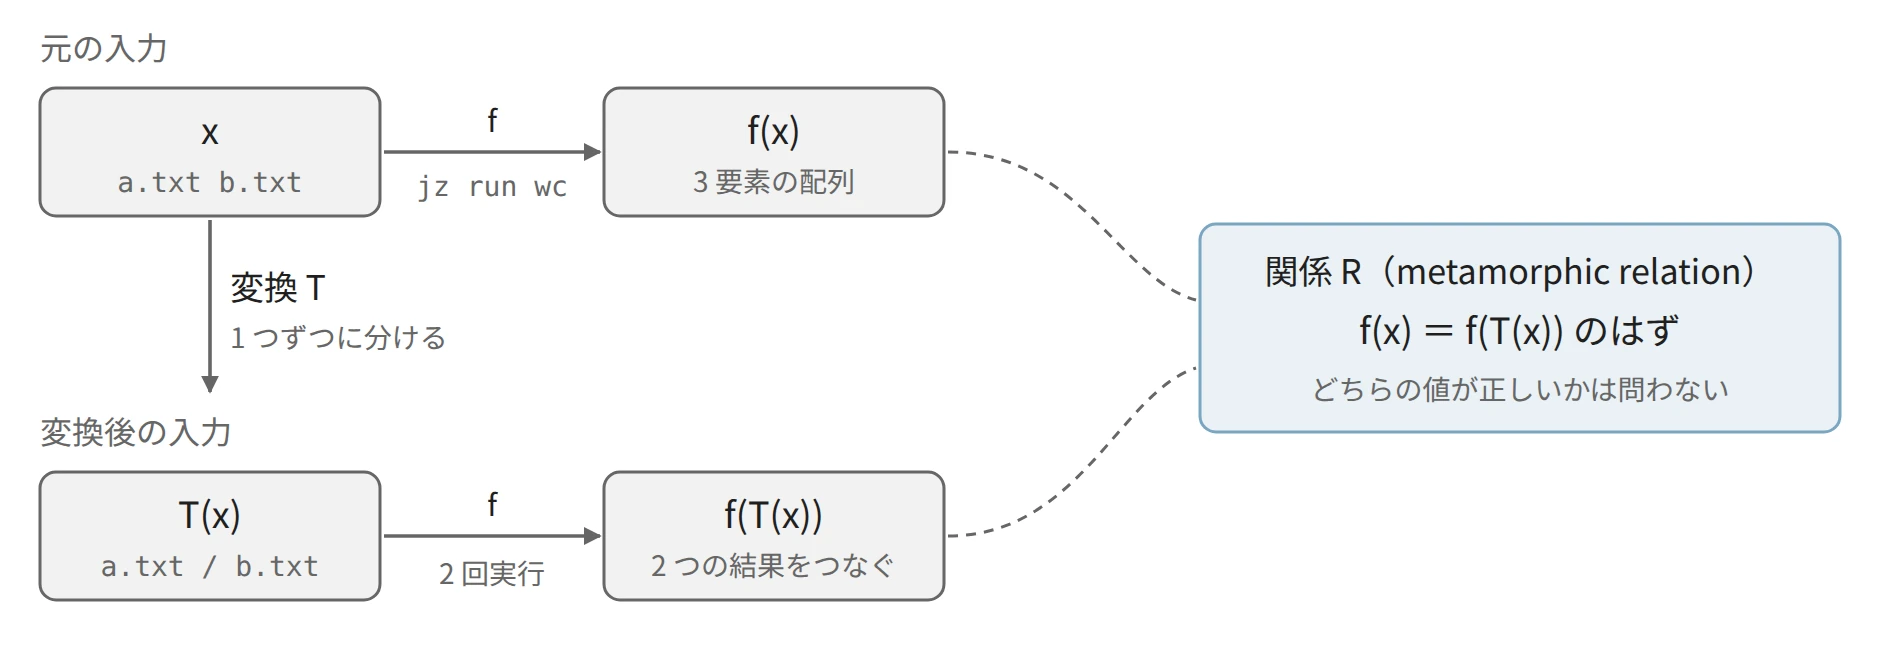
元の入力の出力と変換後の入力の出力を関係 R で比べる
上記の図の上段が元の入力、下段が変換後の入力です。冒頭の例では、f が jz run wc、変換 T が「ファイルを 1 つずつに分ける」です。f(T(x)) は 2 回実行した結果をつないだ配列で、関係 R は「f(x) と f(T(x)) が等しい」です。
関係は、どちらの出力が正しいかを問いません。a.txt が 2 行なのか 3 行なのかを知らなくても、2 つの出力が食い違えば、少なくともどちらかがおかしいと分かります。よく使われる例は三角関数です。sin(1.234) の正しい値を知らなくても、sin(x) と sin(π - x) が等しいかは検証できます。
期待値を書かなくてよいので、どの入力でも同じ関係を検証できます。手元にある全ての fixture にも、乱数で作った入力にも使えます。
実験 1: wc の合計行
冒頭の結果は、以下のスクリプトで検証しました。1 回で読んだ結果(together)と、1 ファイルずつ読んで jq の add で 1 つの配列につないだ結果(separate)を比べます。掲載したのは比べる部分の抜粋で、バージョンの表示などを含む全体は exp1_wc_concat.sh にあります。
#!/usr/bin/env bash
# 関係「jz run wc A B = jz run wc A ++ jz run wc B」を検証する。
# 2 回に分けて読んだ結果をつなげたものと、1 回で読んだ結果を比べる。
set -euo pipefail
work=$(mktemp -d)
trap 'rm -rf "$work"' EXIT
cd "$work"

printf 'a b\nc\n' > a.txt   # 2 行 3 語 6 バイト
printf 'hello\n' > b.txt    # 1 行 1 語 6 バイト
printf 'x\n'     > total    # 「total」という名前のファイル

check() {
  local together separate
  together=$(jz run wc "$@")
  separate=$(for f in "$@"; do jz run wc "$f"; done | jq -cs 'add')
  echo "\$ jz run wc $*"
  echo "together: $together"
  echo "separate: $separate"
  if [ "$together" = "$separate" ]; then echo "relation: holds"; else echo "relation: BROKEN"; fi
  echo
}

check a.txt b.txt
check a.txt total
なお、Ubuntu 26.04 の wc は、GNU coreutils から Rust 製の uutils の実装に置き換わっています。合計行の形は GNU coreutils の wc と同じです。置き換わった経緯は stdio Buffering のノートで説明しています。
1 つ目の check の結果は、冒頭の図の通りです。2 つ目の check は、total という名前のファイルを本当に置いた場合です。together の 2 つ目と 3 つ目の要素が両方とも "filename":"total" になり、JSON だけを見てどちらがファイルでどちらが合計かを見分けられません。
$ jz run wc a.txt total
together: [{"lines":2,"words":3,"bytes":6,"filename":"a.txt"},
           {"lines":1,"words":1,"bytes":2,"filename":"total"},
           {"lines":3,"words":4,"bytes":8,"filename":"total"}]
separate: [{"lines":2,"words":3,"bytes":6,"filename":"a.txt"},
           {"lines":1,"words":1,"bytes":2,"filename":"total"}]
relation: BROKEN
上記は、読みやすいように要素ごとに改行しています。実際の出力は 1 行です。
合計行の名前は、ロケールでも変わります。Ubuntu の gnu-coreutils パッケージが入れる GNU coreutils 9.7 の wc(コマンド名は gnuwc)を日本語のロケールで実行すると、合計行は 3 4 12 合計 になり、jz はそれを "filename":"合計" として読みました。字面で合計行を見分ける実装にすると、この形も漏れます。
これはバグでしょうか。jz の定義は 1 行ずつ同じ形で読むので、「最後の行だけは合計」と書く手段がありません。直すには定義の書き方を増やす必要があり、著者の作業記録では 2026-11 時点でも判断を保留しています。なお、wc を実行する人は、GNU coreutils 9.2 で入った wc --total=never を付ければ合計行が出なくなり、関係も満たします。このオプションは、実験した uutils の wc でも有効でした。関係で見つかったのは、コードの書き間違いではなく、仕様が決めていない所でした。
実験 2: 値が出力に反映されているか
2 つ目の関係は、値の欠落を探すものです。jz の定義は、正規表現の名前付きグループ((?P<server>...) の形)で値を取り出します。どの正規表現にも一致しない行があればエラーにするので、知らない行をエラーにせずに捨てることはありません。
ところが、行全体に一致していても、名前付きグループの外にある値は捨てられます。例えば、(?P<server>[^\s(]+)[^\n]* と書くと、[^\n]* が行の残りに一致し、そこにあった値は「読んだ」扱いになって出力から消えます。golden も定義の出力から生成するので、消えた値は golden にも無く、テストは通ります。
そこで、以下の関係を使います。入力の英数字のトークンを 1 つ選び、1 文字だけ変えて読み直します。そのトークンが出力の値に反映されているなら、出力が変わるか、正規表現に一致しなくなってエラーになるはずです。エラーにならず出力も同じなら、そのトークンは出力に反映されていません。著者は jsonize の作業で、この検証をトークン感度と呼んでいます。
以下は、DNS を問い合わせるコマンド dig の出力の末尾にある統計の 4 行(問い合わせにかかった時間、問い合わせ先のサーバー、日時、応答の大きさ)を読む小さなパーサーで、この関係を検証した結果です。直す前の SERVER 行の正規表現は、jsonize の dig の定義に 2026-09 まであった形を写しました。
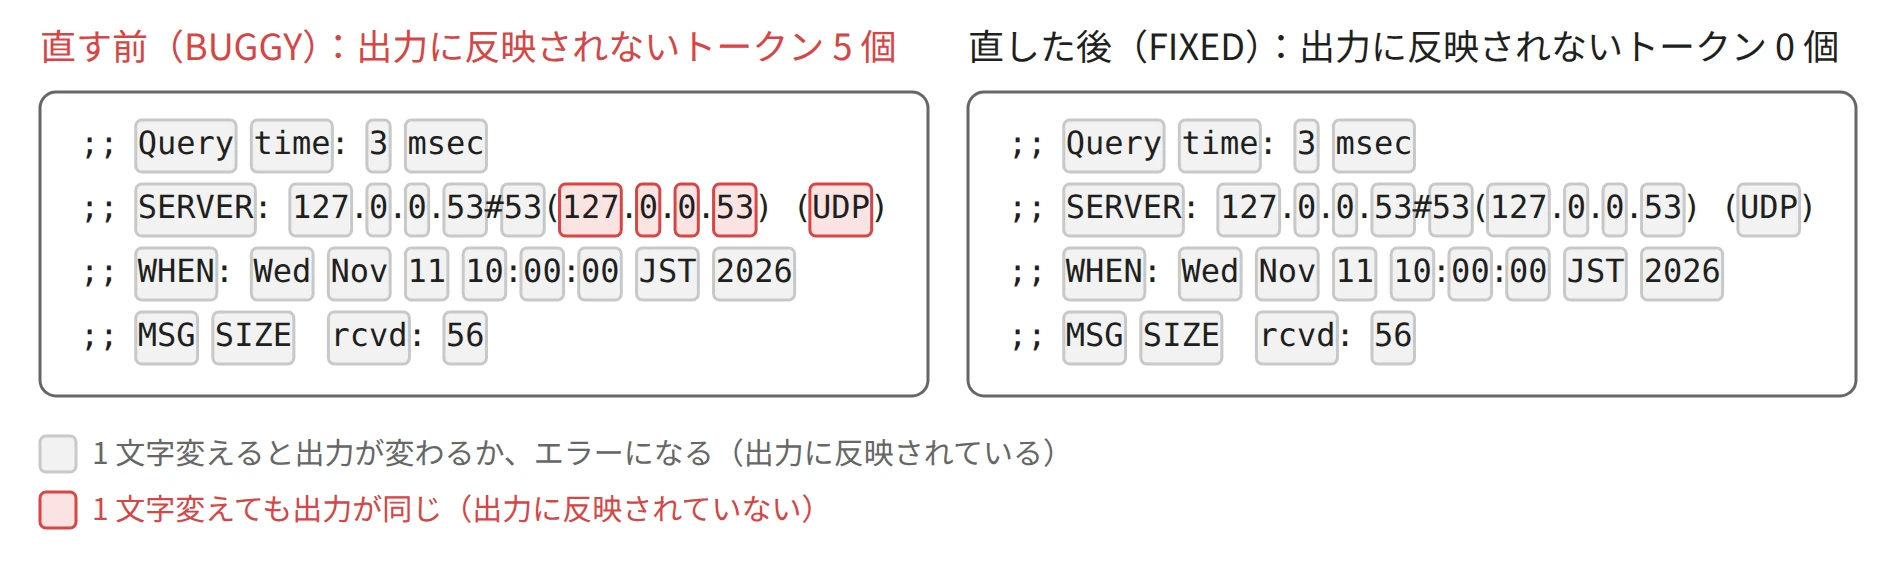
直す前は、SERVER 行の括弧の中の 5 トークンが出力に反映されていない
赤い 5 つは、括弧の中のサーバーのアドレスと、通信に使ったプロトコルの UDP です。直す前の正規表現は括弧の前までしか名前を付けていないので、ここを書き換えても出力は変わりません。直した後は、括弧の中を server_name と protocol として取り出し、28 個のトークンが全て出力に反映されました。
以下はスクリプトの抜粋です。parse が「全行がどれかの正規表現に一致しなければエラー」という jz の規則を写したもので、sweep がトークンを 1 つずつ変えて読み直します。結果を表示する部分を含む全体は exp2_token_sweep.py にあります。
import re

FIXTURE = """\
;; Query time: 3 msec
;; SERVER: 127.0.0.53#53(127.0.0.53) (UDP)
;; WHEN: Wed Nov 11 10:00:00 JST 2026
;; MSG SIZE  rcvd: 56
"""

COMMON = [
    r"^;; Query time: (?P<query_time_ms>\d+) msec$",
    r"^;; WHEN: (?P<when>.+)$",
    r"^;; MSG SIZE  rcvd: (?P<msg_size>\d+)$",
]
BUGGY = COMMON + [r"^;; SERVER: (?P<server>[^\s(]+)[^\n]*$"]
FIXED = COMMON + [
    r"^;; SERVER: (?P<server>[^\s(]+)\((?P<server_name>[^)]*)\) \((?P<protocol>\w+)\)$"
]


def parse(text, patterns):
    """各行がどれかの正規表現の全体に一致しなければ ValueError。"""
    out = {}
    for line in text.splitlines():
        for p in patterns:
            m = re.match(p, line)
            if m:
                out.update(m.groupdict())
                break
        else:
            raise ValueError(f"unread line: {line!r}")
    return out


def mutate(tok):
    """最後の 1 文字だけ変える(数字は +1、英字は別の英字)。"""
    c = tok[-1]
    if c.isdigit():
        n = str((int(c) + 1) % 10)
    elif c.lower() == "z":
        n = "a" if c.islower() else "A"
    else:
        n = chr(ord(c) + 1)
    return tok[:-1] + n


def sweep(patterns):
    base = parse(FIXTURE, patterns)
    result = []
    for m in re.finditer(r"[A-Za-z0-9]+", FIXTURE):
        changed = FIXTURE[: m.start()] + mutate(m.group()) + FIXTURE[m.end():]
        try:
            reflected = parse(changed, patterns) != base
        except ValueError:
            reflected = True  # エラーになった = そのトークンは読まれている
        result.append({"start": m.start(), "token": m.group(), "reflected": reflected})
    return base, result
== BUGGY: 28 checks, 5 not reflected
output: {"query_time_ms": "3", "server": "127.0.0.53#53", "when": "Wed Nov 11 10:00:00 JST 2026", "msg_size": "56"}
  line 2: '127' changed, output unchanged
  line 2: '0' changed, output unchanged
  line 2: '0' changed, output unchanged
  line 2: '53' changed, output unchanged
  line 2: 'UDP' changed, output unchanged

== FIXED: 28 checks, 0 not reflected
(FIXED の output 行は略)
jsonize の全 fixture での結果
jsonize では、同じ関係を Go のテストとして書き、全ての定義の全 fixture で検証しました。2026-09-10 の初回は 99,365 件の検査に 27 秒かかり、617 個のトークンが出力を変えませんでした。
617 個の大半は、意図して捨てているものでした。例えば、毎回同じ見出しやバナーの行や、同じ値が 2 回出る行の 2 つ目です。Go の正規表現は、同じ文字列が 2 回出ることを書けないので、2 つ目の値は 1 つ目と等しいかを確認できず、読まずに捨てています。本当に値を落としていたのは、dig、lspci -v、lspci -nn、stat の 4 つの定義でした。dig の修正は 834bb1b5 です。
この関係はその後も定義を足した時に実行していて、2026-09-14 には定義が増えた分を含めて 130,321 件を 30 秒で検査しました。新しく出たトークンは、新しい定義の見出しなど、意図して捨てているものだけでした。
関係の見つけ方
関係は、処理の仕様から「変えても結果が変わらないはずのもの」と「分けても合わせると同じになるはずのもの」を探すと見つかります。jsonize で使った主な関係は以下の通りです。
| 関係 | 入力の変え方 | 出力に期待すること |
|---|---|---|
| 正規化 | BOM・CRLF・末尾の改行・空行 | 変わらない |
| 連結 | 同じ出力を 2 回つなぐ | 要素が 2 倍になる |
| 経路一致 | ファイルで渡す、パイプで渡す | 同じ |
| 分割(実験 1) | ファイルを 1 つずつ渡す | つなぐと同じ |
| トークン感度(実験 2) | トークンを 1 文字変える | 変わるか、エラーになる |
連結の関係を初めて全 fixture で検証した時は、2 つ目の出力の見出し行をデータの行として読む定義が 20 個見つかりました。例えば、docker network ls の出力を 2 回つなぐと、2 つ目の見出し NETWORK ID NAME DRIVER SCOPE が {"network_id":"NETWORK","name":"ID",...} という 1 件のネットワークとして JSON に入りました。
関係は、一度書けば定義を足す度に自動で検証できます。jsonize の定義のテストは、正規化の 5 つ(先頭に BOM を付ける、改行を CRLF にする、末尾の改行を消す、末尾に空行を足す、先頭に空行を足す)と連結の関係を全 fixture で必ず実行します。利用者が自分で書いた定義を jz test でテストする時も同じです。定義を書く人は fixture と golden を置くだけで、関係のテストも通すことになります。
実験 3: 関係の方が間違っている時
関係は期待値を必要としないので、乱数で作った入力とも組み合わせられます。Go の標準ライブラリには testing/quick があり、関数の引数の型に合わせて乱数の入力を作り、渡した関数が false を返す入力を探します。この入力を反例と呼びます。
この節では、テストが失敗した原因が関係にあった例を説明します。以下は、語の数を数える関数 Words で、testing/quick を使って連結の関係を検証した実験です。
// 語数を数える関数で、連結の関係を testing/quick を使って検証する。
// 1 つ目の関係は誤りで、2 つ目が正しい関係。
package main

import (
	"fmt"
	"math/rand"
	"strings"
	"testing/quick"
)

// Words は空白で区切った語の数を返す。
func Words(s string) int { return len(strings.Fields(s)) }

func main() {
	cfg := &quick.Config{MaxCount: 1000, Rand: rand.New(rand.NewSource(1))}

	// 関係 1: Words(a+b) = Words(a) + Words(b)
	naive := func(a, b string) bool { return Words(a+b) == Words(a)+Words(b) }
	report("Words(a+b) == Words(a)+Words(b)", quick.Check(naive, cfg))

	// 関係 2: Words(a+" "+b) = Words(a) + Words(b)
	cfg.Rand = rand.New(rand.NewSource(1))
	spaced := func(a, b string) bool { return Words(a+" "+b) == Words(a)+Words(b) }
	report(`Words(a+" "+b) == Words(a)+Words(b)`, quick.Check(spaced, cfg))

	// 手で最小化した反例
	a, b := "x", "y"
	fmt.Printf("shrunk by hand: Words(%q)=%d, Words(%q)+Words(%q)=%d\n",
		a+b, Words(a+b), a, b, Words(a)+Words(b))
}

func report(name string, err error) {
	if err == nil {
		fmt.Printf("%s: holds for 1000 inputs\n", name)
		return
	}
	ce := err.(*quick.CheckError)
	a, b := ce.In[0].(string), ce.In[1].(string)
	fmt.Printf("%s: broken at input #%d\n", name, ce.Count)
	fmt.Printf("  a = %q (%d runes)\n  b = %q (%d runes)\n", a, len([]rune(a)), b, len([]rune(b)))
}
Words(a+b) == Words(a)+Words(b): broken at input #1
  a = "\U000ea123\U001052c7\U000c0806 …(略)" (31 runes)
  b = "\U00087fa1\U000dbefc𨧥 …(略)" (37 runes)
Words(a+" "+b) == Words(a)+Words(b): holds for 1000 inputs
shrunk by hand: Words("xy")=1, Words("x")+Words("y")=2
上記の反例の文字列は途中を略しています。全文は exp3_quick.txt にあります。1 つ目の関係は最初の入力で失敗し、testing/quick が報告した反例は 31 文字と 37 文字の乱数の文字列でした。
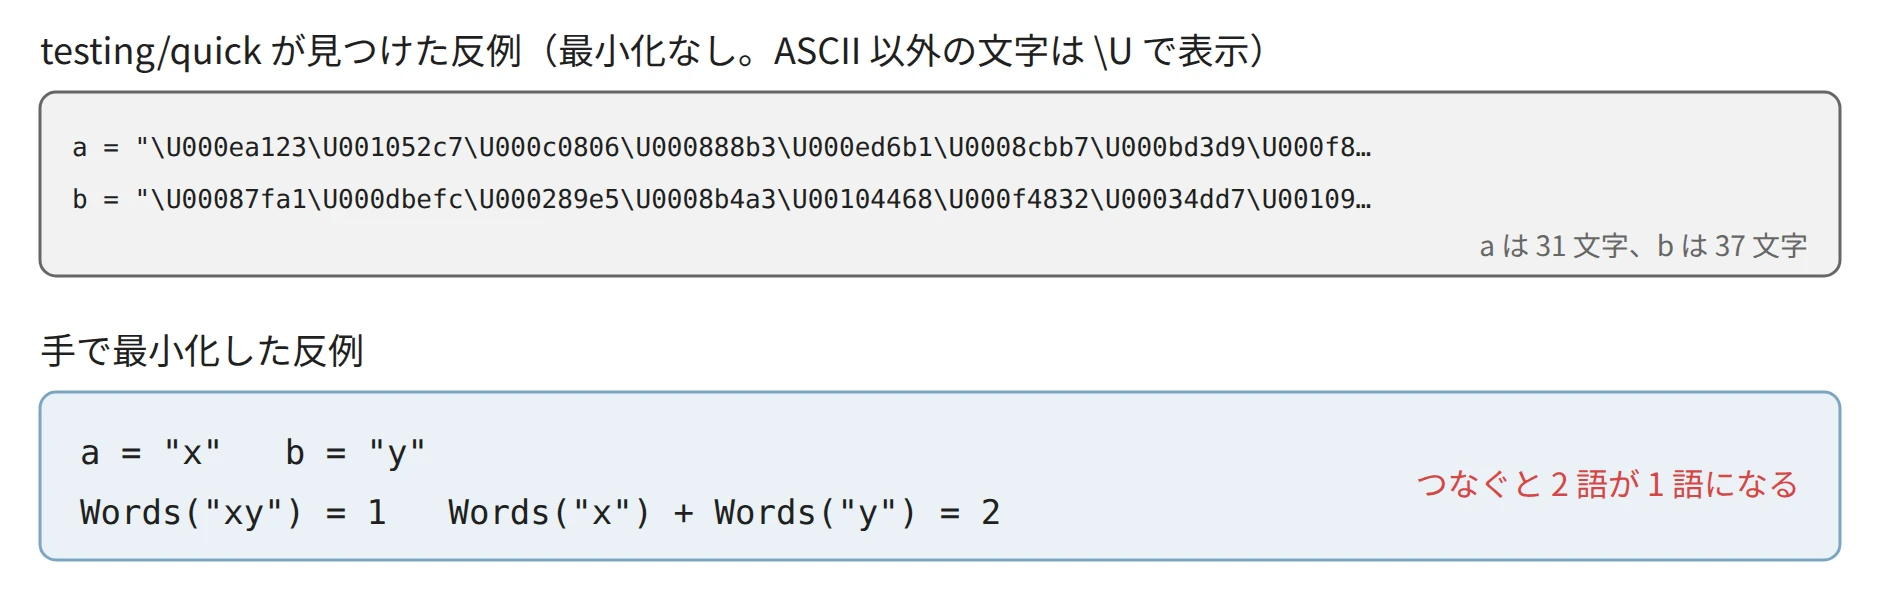
最小化していない反例からは原因が読めず、手で最小化すると 2 語がつながることが分かる
最小化していない反例からは、何が起きたのかが読めません。手で "x" と "y" まで最小化すると、a の最後の語と b の最初の語がつながって 1 語になることが分かります。間違っていたのは Words ではなく、境目を考えていなかった関係の方です。間に空白を挟んだ 2 つ目の関係は、1000 件の入力で失敗しませんでした。
jsonize でも同じことが起きています。2026-09-12 に関係のテストを実行し直した時は 13 件が失敗し、13 件とも関係の誤りでした。例えば、元から改行が CRLF の HTTP ヘッダの fixture に「改行を CRLF にする」変換をかけると、改行が \r\r\n になり、余った \r が値に入ります。改行ではなく NUL 文字で区切る出力(ls --zero)に「末尾に空行を足す」変換をかけると、足した改行が 1 件のファイル名として読まれます。どちらも jz は正しく、関係の方が入力の形式を無視していました。
反例の最小化
testing/quick は新しい機能を追加しない方針(frozen)で、反例を最小化する機能もありません。実験 3 で手で行った最小化を自動で行う機能は shrinking と呼ばれ、Property-Based Testing のライブラリの多くが持っています。
著者は、Erlang の VM と JavaScript で動く関数型言語の Gleam で、Property-Based Testing と Metamorphic Testing を同じ形で書けるライブラリ metamon を作っています。以下は README にある例で、string.trim を 2 回実行しても 1 回と同じ、という冪等の関係を書いています。
import gleam/string
import metamon
import metamon/generator
import metamon/generator/range

pub fn trim_idempotent_test() {
  let mr = metamon.idempotency_of(name: "trim_idempotent", of: string.trim)
  metamon.forall_morph(
    generator.string_ascii(range.constant(0, 16)),
    mr,
    string.trim,
  )
}
forall_morph は、生成器(generator.string_ascii)で作った入力で関係を検証し、失敗したら入力を最小化してから報告します。冪等の他に、変換しても出力が変わらない関係(invariant_under)や、入力の変換に合わせて出力も決まった形で変わる関係(equivariant_under)の型を持っています。
テストが失敗した原因の切り分け
本記事の 3 つの実験は、テストが失敗した原因がそれぞれ違いました。
- 関係が間違っていた(実験 3 の
Words)。 - 実装が間違っていた(実験 2 の dig の定義)。
- 仕様が決めていなかった(実験 1 の wc の合計行)。
失敗したら、まず反例を最小化します。最小化した入力を見て、変換が入力の形式を壊していないかを確認します。壊していれば、関係の誤りです。次に、その入力について仕様が何か決めているかを確認します。仕様が答えを決めていて実装がそれに反していれば、実装の誤りです。仕様が何も決めていなければ、直す前に決める必要があります。wc の合計行は、jsonize でまだ決まっていません。
同じものを計算する別の実装があるなら、関係より強い比較相手になります。例えば、lsblk は表の形の出力とは別に、lsblk -J で自分の JSON を出せます。jsonize が表の出力から作った JSON と lsblk -J を突き合わせると、関係では「どちらかがおかしい」までしか言えない所で、どの値が違うかまで分かります。これが Differential Testing です。
正解を書けない処理を持っているなら、まず「変えても結果が変わらないはずのもの」を 1 つ挙げて、手元の入力で試すのが始めやすいです。テストが失敗した時に、関係・実装・仕様のどれが原因かを決めること自体が、仕様を詰める作業になります。
実験のスクリプトと出力は lab に、図の生成元は figures.py にあります。