Fuzzing(ファジング)は、テスト対象に渡す入力を機械に大量に作らせ、プログラムが落ちる入力や止まらない入力を探すテスト手法です。人が思い付く入力ではなく、壊れたファイルや意味の無いバイト列を 1 秒に数万回の速さで渡し続けます。
著者のデスクトップは、2026 年の 9 月ごろ、月に 1 回ほど GUI が固まっていました。Ubuntu 26.04 が不安定なのだろうと思っていましたが、調べると原因はメモリ不足で、メモリを使っていたのは著者が書いた fuzz のテストでした。fuzz のテストは、止めるか異常が見つかるまで入力を作り続けるので、手元で何時間も回すことがあります。
例えば 2026-09-10 には、jsonize の fuzz のテストのプロセスが、システムに割り当てた 64 GB のほぼ全てに当たる 58 GB までメモリを使い、OOM Killer に止められています。OOM Killer は、メモリが尽きた時に Linux がプロセスを選んで止める仕組みです。jsonize は、コマンドの出力を JSON に変換する著者の CLI です。
原因は、jsonize が表を読む処理にありました。jsonize は、ps や df のように見出しの行と値の行が並ぶ出力を表として読みます。表の列の数には 256 の上限がありましたが、行の数には上限が無く、入力の大きさの 1 万倍を超えるメモリを保持する作りでした。
fuzz のテストは 1 MiB までの入力を受け付けるので、1 つの入力で十数 GB を保持します。Go の fuzz は複数のプロセスで並列に入力を試すので、合計はさらに増えます。
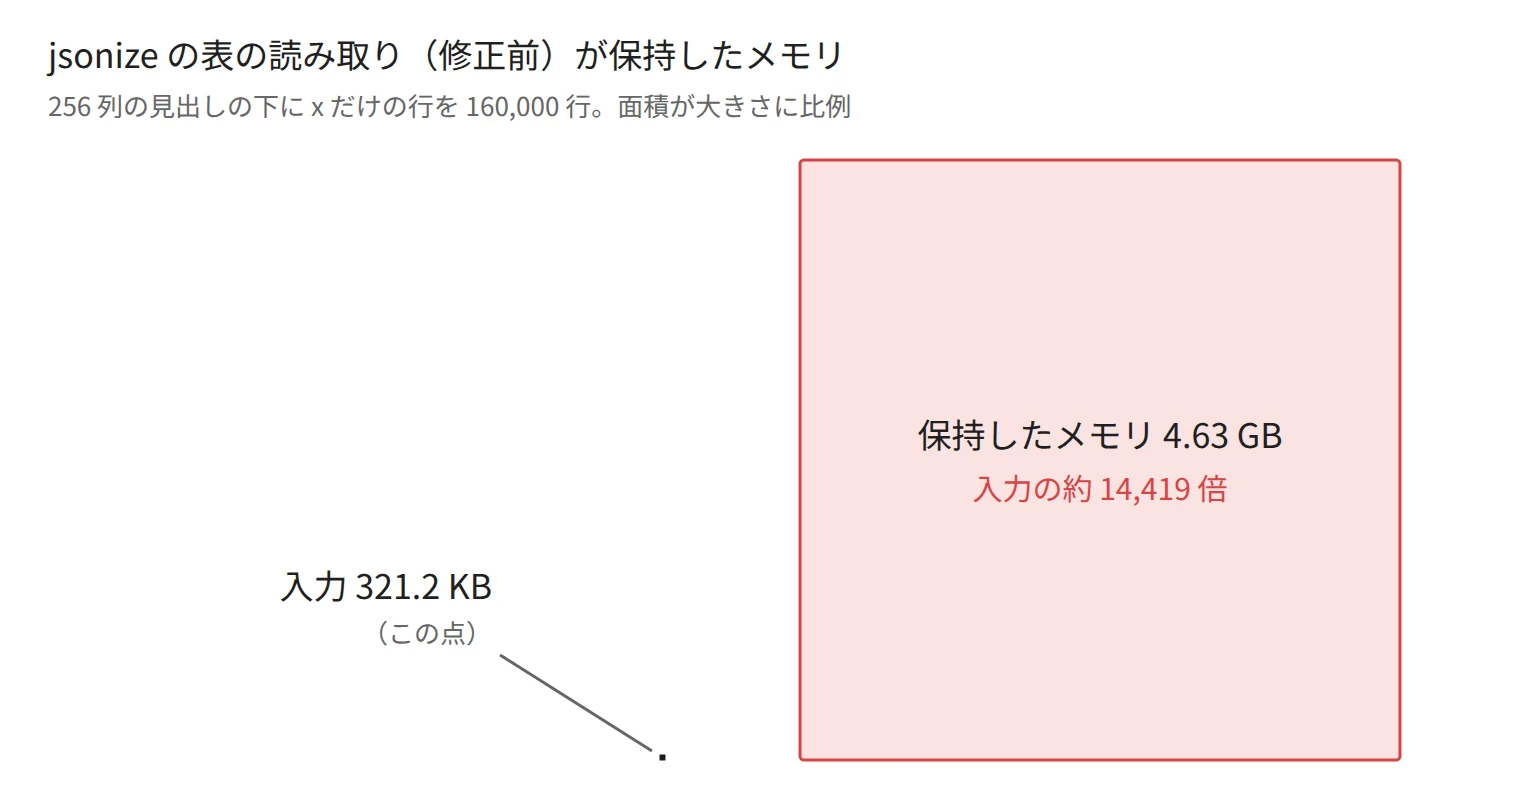
321.2 KB の入力で 4.63 GB を保持した(修正前の jsonize で測り直した値)
この時、fuzz のテストは失敗していません。テストが検査していたのは「panic しないこと」だけで、メモリの量は検査していなかったからです。異常はテストの失敗としてではなく、マシンが固まる形で現れました。
本記事では、手元の実験と、著者の OSS で fuzz が見つけたバグで、Fuzzing の仕組みと使い方を説明します。扱う疑問は以下の通りです。
- 乱数で入力を作るのと何が違うのか。
- Go ではどう書き、どれくらいで見つかるのか。
- panic しない異常(メモリや時間の使い過ぎ)は、どうすれば見つかるのか。
- 回しているつもりの fuzz が、回っていないことはあるのか。
乱数の入力から、カバレッジで導く入力へ
Fuzzing の始まりは、1988 年の雷雨の夜です。Barton Miller 氏の回想によると、同氏は自宅から電話回線で大学の UNIX にログインしていて、雷雨の雑音が入力に混ざると、普段使っているコマンドが落ちることに気付きました。
同氏はこれを大学院の授業の課題にし、ランダムな文字列を UNIX のコマンドに渡す実験に学生が取り組みました。1990 年の報告では、どの UNIX でも、テストしたコマンドの 25〜33% が落ちるか、止まらなくなりました。判定は「落ちたか、止まらなくなったか」だけです。出力の正解が不要なので、どのコマンドにも同じ方法で掛けられます。
同氏らは 2020 年に同じ方法で調べ直し、Rust で書き直した coreutils である uutils の 14 個のコマンドも試しました。そのうち comm、fold、ptx の 3 つが止まらなくなりました。
例えば ptx は、行の長さの 2 乗に比例する処理を持っていて、9300 万バイトの 1 行を 34 時間掛けても 22% しか処理できませんでした。Rust はメモリの誤った操作を防ぎますが、遅すぎる処理は防ぎません。uutils と GNU coreutils の違いは、Differential Testing のノートでも扱っています。
カバレッジを手掛かりにする
ランダムな入力は、入力の形式を確認する処理の手前で弾かれやすいです。例えば、後で取り上げる Parquet というファイル形式は先頭の 4 バイトが PAR1 で、これを確認する処理があると、ランダムな 4 バイトが一致する確率は約 43 億分の 1 なので、その先の処理には届きません。
カバレッジは、実行中にプログラムのどの分岐を通ったかの記録です。現在の主な fuzz の道具は、カバレッジを記録し、新しい分岐を通った入力を残して、それを少しずつ変えます。AFL や libFuzzer が広めた方法で、Go は 1.18 から go test に組み込んでいます。
残した入力の集まりを corpus、最初に人が渡す入力を seed と呼びます。入力を少し変えることを変異(mutation)と呼びます。
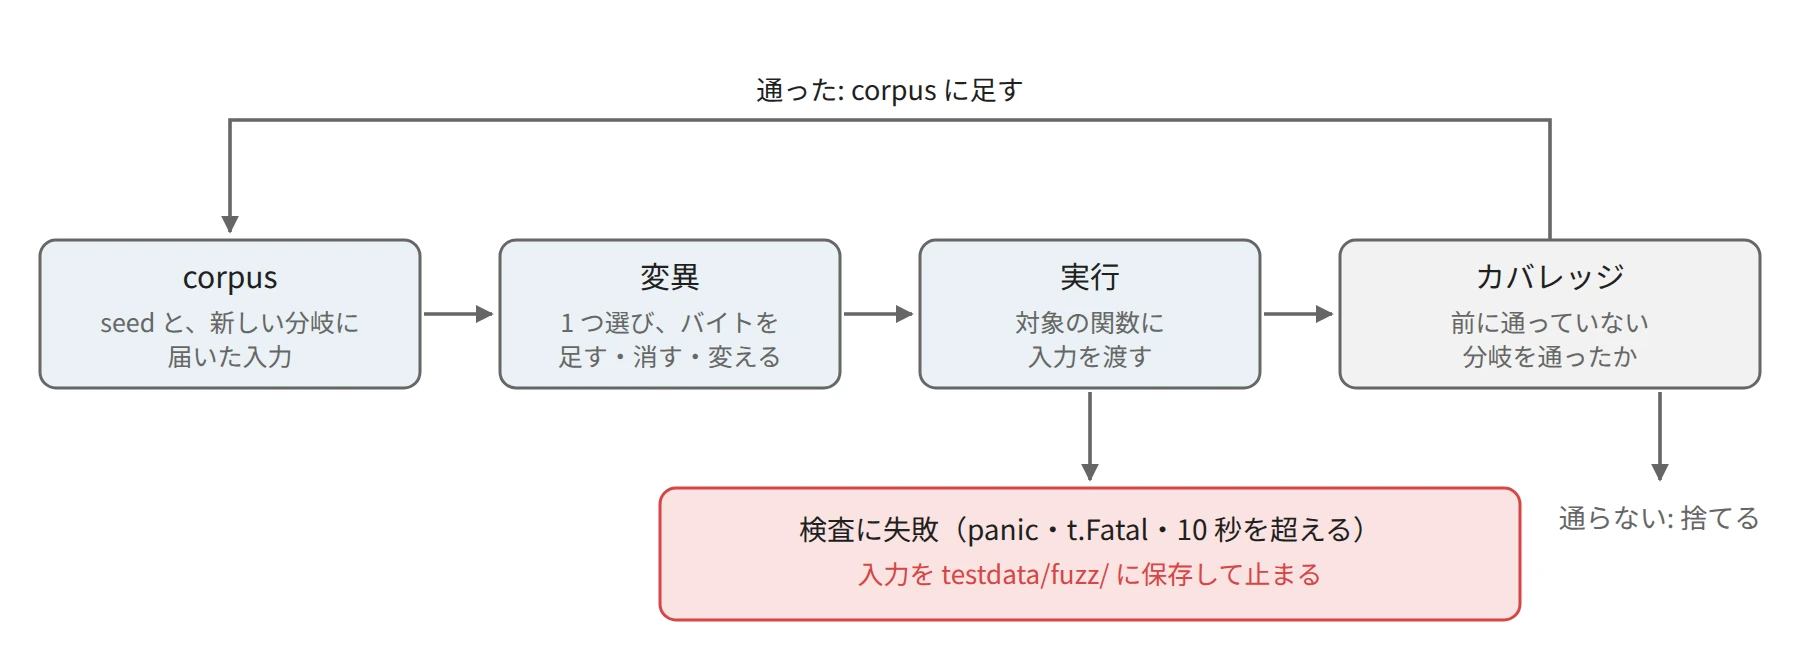
新しい分岐を通った入力を残し、それを元に次の入力を作る
新しい分岐に届いた入力が残るので、次の変異はそこから始まり、少しずつ奥の分岐へ進みます。
ただし、4 バイトを 1 回の比較でまとめて確認する処理では、3 バイトまで合っても通る分岐が変わらないので、残す手掛かりがありません。
乱数の入力、カバレッジで導く fuzz、次のノートで扱う Property-Based Testing(PBT)は、どれも入力を機械に作らせます。PBT は、型に合わせて値を作る生成器で入力を作り、「並べ替えても要素の数は変わらない」のような、どの入力でも成り立つはずの性質が破れないかを調べる手法です。違いは、入力の作り方と、見落としやすい所です。
| 手法 | 入力の作り方 | 失敗とみなすもの | 見落としやすい所 |
|---|---|---|---|
| 乱数の入力 | 毎回独立した乱数 | 落ちる、止まらない | 形式の確認より先 |
| カバレッジで導く fuzz | 残した入力の変異 | 検査の失敗、時間切れ | 一度に比べる定数 |
| PBT | 型に合わせた生成器 | 性質が破れる | 生成器が作らない値 |
カバレッジで導く fuzz が一度に比べる定数を見落とす様子は、次の実験 1 で試します。PBT の生成器の偏りは、PBT のノートの実験で扱っています。
実験 1: 1 バイトずつの比較が、段を作る
先頭が FUZZ の入力だけで panic する 2 つの関数で、カバレッジが入力をどう導くかを試しました。2 つの違いは、同じ条件を 1 バイトずつ比べるか、4 バイトをまとめて 1 回で比べるかだけです。
// ByteByByte は先頭の 4 バイトを 1 バイトずつ比べる。
func ByteByByte(b []byte) {
	if len(b) >= 4 && b[0] == 'F' {
		if b[1] == 'U' {
			if b[2] == 'Z' {
				if b[3] == 'Z' {
					panic("FUZZ")
				}
			}
		}
	}
}

// AtOnce は先頭の 4 バイトを 1 回の比較で比べる。
func AtOnce(b []byte) {
	// 0x5a5a5546 は、"FUZZ" の 4 バイトを 1 つの整数として読んだ値。
	if len(b) >= 4 && uint32(b[0])|uint32(b[1])<<8|uint32(b[2])<<16|uint32(b[3])<<24 == 0x5a5a5546 {
		panic("FUZZ")
	}
}
Go の fuzz のテストは、名前が Fuzz で始まり *testing.F を受け取る関数です。f.Add で seed を渡し、f.Fuzz に渡した関数が、変異させた入力ごとに呼ばれます。
以下は、2 つの関数の fuzz のテストと、比較のために乱数で 4 バイトを作って 1 億回渡すテスト TestRandom です。
package magic

import (
	"math/rand/v2"
	"testing"
)

func FuzzByteByByte(f *testing.F) {
	f.Add([]byte("seed"))
	f.Fuzz(func(t *testing.T, b []byte) { ByteByByte(b) })
}

func FuzzAtOnce(f *testing.F) {
	f.Add([]byte("seed"))
	f.Fuzz(func(t *testing.T, b []byte) { AtOnce(b) })
}

// TestRandom は、カバレッジを見ずに乱数で 4 バイトを作り、1 億回 ByteByByte を呼ぶ。
func TestRandom(t *testing.T) {
	b := make([]byte, 4)
	for i := 0; i < 100_000_000; i++ {
		v := rand.Uint32()
		b[0], b[1], b[2], b[3] = byte(v), byte(v>>8), byte(v>>16), byte(v>>24)
		func() {
			defer func() {
				if recover() != nil {
					t.Fatalf("found after %d inputs", i+1)
				}
			}()
			ByteByByte(b)
		}()
	}
	t.Logf("not found in 100,000,000 inputs")
}
go test -run '^$' -fuzz '^FuzzByteByByte$' で fuzz を始めます。-run '^$' は、普段のテストを走らせない指定です。TestRandom は普段の go test で走ります。条件と結果は以下の通りです。見つかるまでの回数は、ワーカーを 1 つにして(-parallel 1)数えました。
| 条件 | 実行した回数 | 結果 |
|---|---|---|
ByteByByte に fuzz | 36,709〜116,814 回 | 5 回とも見つかった |
ByteByByte に乱数の 4 バイト | 1 億回 | 見つからない |
AtOnce に fuzz | 2 分で約 1 億回を 3 回 | 見つからない |
表の回数を数えた fuzz のテスト(count_test.go)
FuzzByteByByte と同じ対象を呼び、何回目の呼び出しで見つけたかを panic のメッセージに入れます。実行は exp1_magic.sh です。
package magic

// FuzzCount は FuzzByteByByte と同じ対象を、何回目の呼び出しで見つけたかを数えて呼ぶ。
// -parallel 1 で走らせると、ワーカーが 1 つなので回数が実行回数になる。

import (
	"fmt"
	"testing"
)

var calls int

func FuzzCount(f *testing.F) {
	f.Add([]byte("seed"))
	f.Fuzz(func(t *testing.T, b []byte) {
		calls++
		defer func() {
			if r := recover(); r != nil {
				panic(fmt.Sprintf("found at call %d of this worker", calls))
			}
		}()
		ByteByByte(b)
	})
}
1 バイトずつ比べると、途中まで一致した入力が corpus に残る(実測の時刻を 0.5 倍速、段が上がる所で一時停止)
上の図は、表とは別のテスト(steps_test.go)で、先頭の何バイトが FUZZ と一致したかが初めて増えた時の回数と時刻を記録しながら、5 回走らせ直したうちの 1 回です。変異は乱数で決まるので、回数は表の 5 回と揃いません。5 回とも F、FU、FUZ、FUZZ の順に 1 段ずつ上がり、FUZZ まで 30,140〜124,683 回、0.5〜2.0 秒で、最後の Z を当てる段に最も回数がかかりました。図の \x03 のような表記は、文字として表示できない 1 バイトを 16 進で書いたもので、F\x03de は 4 バイトです。
同じ ByteByByte でも、fuzz は 13 万回以内で見つけ、乱数は 1 億回でも見つけられませんでした。違いは、途中まで一致した入力が残るかどうかです。ByteByByte では、先頭が F の入力は b[1] == 'U' の分岐に初めて届くので、corpus に残ります。次の変異はその入力から始まるので、残りの 3 バイトを 1 バイトずつ当てれば済みます。
AtOnce は fuzz でも見つかりませんでした。4 バイトを 1 回で比べるので、途中まで一致しても通る分岐が変わらず、手掛かりが残りません。
比べる値を手掛かりにする道具もある
libFuzzer には、比較の命令に渡された値を記録し、その値を入力に入れてみる Tracing CMP instructions という機能があります。この機能があれば、AtOnce の 0x5a5a5546 のような定数も入力に入ります。手元の Go 1.26 の go test -fuzz では、AtOnce は見つかりませんでした。
Go で、ファイル形式の先頭の識別子やチェックサムを確認する処理を fuzz する時は、正しいファイルを f.Add で seed に渡します。正しいファイルから始めれば、確認の処理を通った後の分岐から変異が始まります。後の実験 2 の filesql も、本物の Parquet のファイルを seed に渡しています。
見つかった入力はテストとして残る
fuzz が失敗した入力は、testdata/fuzz/<関数名>/ の下にファイルとして保存されます。中身は以下の形です。
go test fuzz v1
[]byte("FUZZ")
-fuzz を付けない普段の go test は、f.Add の seed と、このディレクトリのファイルを 1 回ずつ実行するだけです。新しい入力は探しません。見つかった入力を修正と一緒にコミットすると、以後は普段の go test が同じ入力で確認します。
panic しない異常
前の loop の図の通り、Go の fuzz が失敗とみなすのは、panic した時、t.Fatal などでテストが失敗した時、1 つの入力の実行が長すぎる時です。
公式の文書は、長すぎる時間を 1 秒と書いていますが、手元の Go 1.26.9 で試すと、8 秒眠る入力は通り、12 秒眠る入力は 10 秒で失敗になりました。試したのは以下の fuzz のテストで、環境変数 SLEEP を 3・8・12 と変えて exp3_hang.sh で 40 秒ずつ走らせました。
package hang

import (
	"os"
	"strconv"
	"testing"
	"time"
)

func FuzzSleep(f *testing.F) {
	d, _ := strconv.Atoi(os.Getenv("SLEEP"))
	f.Add([]byte("seed"))
	f.Fuzz(func(t *testing.T, b []byte) {
		if len(b) > 4 {
			time.Sleep(time.Duration(d) * time.Second)
		}
	})
}
メモリの使い過ぎは検査しないので、冒頭の jsonize のように、OS がプロセスを止めるまで動き続けます。
jsonize の問題は、1 行の入力が小さくても、読み取りが列の数だけ値を作る所にありました。256 列の見出しの下に x だけの行を並べると、各行は x と改行の 2 バイトですが、読み取りは 1 行ごとに 256 個の値を持つ JSON のオブジェクトを作ります。
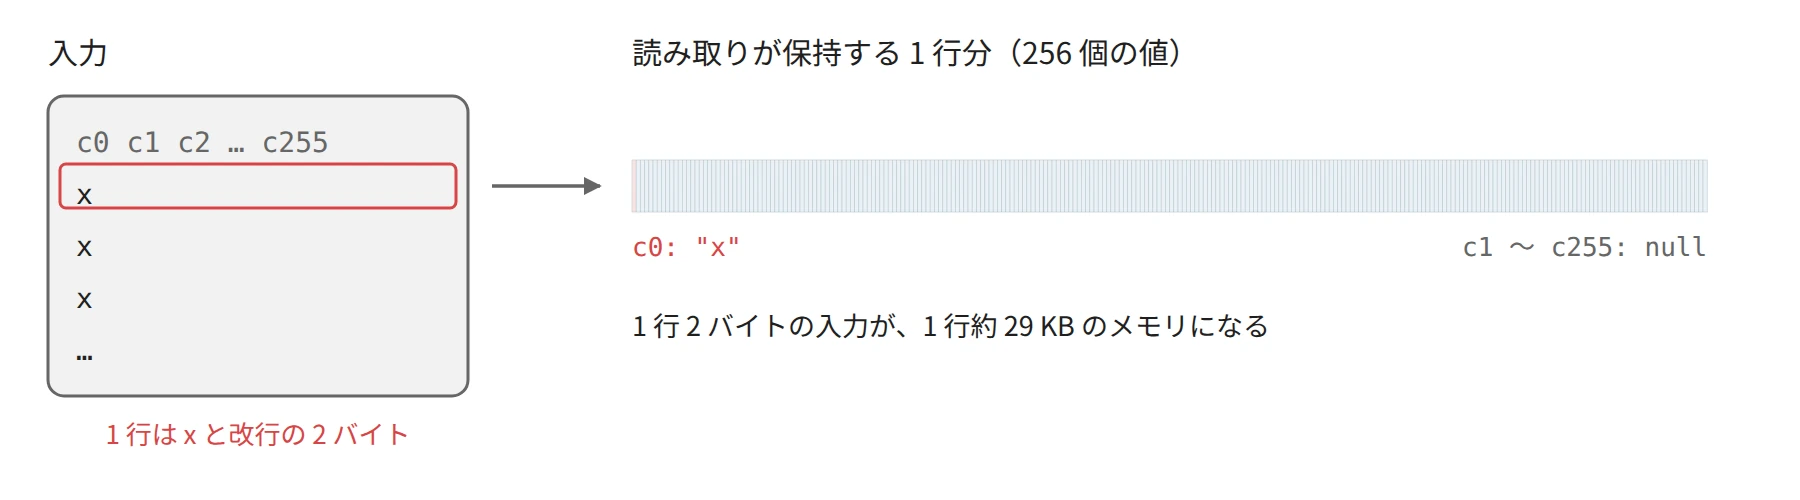
1 行 2 バイトの入力が、256 個の値になる
冒頭の図は、修正前と修正後の jsonize に計測用のプログラムを置いて測りました。exp0_jsonize_retain.sh が、行の数を 20,000 から 160,000 まで変えて走らせます。
冒頭の図を測ったプログラム(retain.go.txt)
jsonize の定義を読み込み、256 列の見出しの下に x だけの行を並べた入力を表として読み、直後のヒープの使用量(HeapAlloc)を表示します。
// exp0_jsonize_retain.sh が jsonize の cmd/zzretain/main.go に置いて走らせるプログラム。
// 256 列の見出しの下に "x" だけの行を rows 行並べ、engine.Parse の直後のヒープを表示する。
package main

import (
	"fmt"
	"os"
	"runtime"
	"strconv"
	"strings"

	"github.com/nao1215/jsonize/pkg/definition"
	"github.com/nao1215/jsonize/pkg/engine"
)

func main() {
	rows, _ := strconv.Atoi(os.Args[1])
	def, err := definition.Load([]byte("format: 1\ncommand: t\nvariant: v\nparse: {type: table, split: aligned}\n"), "repro")
	if err != nil {
		panic(err)
	}
	var b strings.Builder
	for i := range 256 {
		if i > 0 {
			b.WriteByte(' ')
		}
		fmt.Fprintf(&b, "c%d", i)
	}
	b.WriteByte('\n')
	for range rows {
		b.WriteString("x\n")
	}
	input := b.String()

	out, err := engine.Parse(def, []byte(input), engine.Options{MaxInputSize: 64 << 20})
	var m runtime.MemStats
	runtime.ReadMemStats(&m)
	fmt.Printf("rows=%d input=%.1f KB heap=%.2f GB ratio=%.0f err=%v\n", rows,
		float64(len(input))/1e3, float64(m.HeapAlloc)/1e9, float64(m.HeapAlloc)/float64(len(input)), err)
	runtime.KeepAlive(out)
}
修正では、読み取りが作った値の数を数え、4,194,304 個を超えたら入力を拒否するようにしました。修正後の jsonize に同じ入力を渡すと、16,386 行目で the input yields more than 4194304 values というエラーで止まります。入力の大きさではなく、読み取りが作るものの量に上限を置いたわけです。
実験 2: 確保の上限を検査に足す
jsonize の件は、マシンが固まって初めて分かりました。メモリの使い過ぎをテストの失敗として見つけるには、fuzz の関数の中で検査する必要があります。
filesql は、CSV などのファイルを SQLite に読み込んで SQL で問い合わせる著者の Go のライブラリです。Parquet という列指向のファイル形式も読めます。
filesql の FuzzParseBinary は、壊れたファイルで panic しないかと、行のセルの数が見出しの数と合うかを検査する fuzz で、Parquet の読み取りの中で panic が起きる入力を 3 秒未満で見つけています(Issue #413)。
この関数を元に、Parquet の読み取りが 16 MiB を超えて確保したら失敗にする fuzz を書き、後で触れる filesql の修正で確保を制限する前のコードに掛けました。seed には、filesql のテスト用の本物の Parquet のファイルを渡しています。exp2_parquet.sh が、このファイルを filesql の parser パッケージに置いて走らせます。
package parser

import (
	"bytes"
	"os"
	"path/filepath"
	"runtime"
	"testing"
)

// FuzzParquetCeiling は FuzzParseBinary の Parquet の部分に、
// 「64 KiB 以下のファイルを読むのに 16 MiB を超えて確保しないか」の検査を足したもの。
// exp2_parquet.sh fuzz が filesql の parser パッケージに置いて走らせる。
func FuzzParquetCeiling(f *testing.F) {
	if parquet, err := os.ReadFile(filepath.Join("testdata", "products.parquet")); err == nil {
		f.Add(parquet)
	}
	f.Add([]byte("PAR1"))
	f.Fuzz(func(t *testing.T, data []byte) {
		if len(data) > 1<<16 {
			t.Skip()
		}
		var before, after runtime.MemStats
		runtime.ReadMemStats(&before)
		_, _ = Parse(bytes.NewReader(data), Parquet)
		runtime.ReadMemStats(&after)
		if got, limit := after.TotalAlloc-before.TotalAlloc, uint64(16<<20); got > limit {
			t.Fatalf("%d bytes allocated %d MiB", len(data), got>>20)
		}
	})
}
runtime.MemStats の TotalAlloc は、プロセスがそれまでにヒープに確保したメモリの累計で、解放しても減りません。Parse の前後の差が、1 回の読み取りで確保した量になります。64 KiB を超える入力は飛ばすので、16 MiB は入力の 256 倍以上です。
5 分ずつ 3 回走らせると、2 回で見つかりました。57 秒で見つけた 472 バイトのファイルは、16 MiB 余りを確保しました。1 分 48 秒で見つけた 471 バイトのファイルは、44 MiB を確保しました。3 回目は 5 分で見つかりませんでした。修正後のコードには 5 分で約 1,370 万回の入力を渡し、上限を超える入力は見つかりませんでした。
473 バイトのファイルが確保した 98 MiB
filesql の修正(Issue #526)のきっかけになった 473 バイトのファイルも、FuzzParseBinary に確保の上限を足して見つけたものです。Go の fuzz は、失敗する入力を見つけると、失敗することを保ったまま、できるだけ小さく縮めてから保存します。473 バイトは、そうして縮めた後の大きさです。
473 バイトのファイルを読んだテスト(cost_test.go.txt)
page_header.b64 は、473 バイトのファイルを base64 にしたものです。
package reader

// exp2_parquet.sh が filesql の internal/reader に置いて走らせるテスト。
// fuzz が 473 バイトまで縮めた Parquet を 1 回読み、確保したメモリの合計を表示する。

import (
	"bytes"
	"encoding/base64"
	"os"
	"runtime"
	"strings"
	"testing"
)

func TestPageHeaderCost(t *testing.T) {
	b64, err := os.ReadFile(os.Getenv("PAGE_HEADER_B64"))
	if err != nil {
		t.Fatal(err)
	}
	data, err := base64.StdEncoding.DecodeString(strings.TrimSpace(string(b64)))
	if err != nil {
		t.Fatal(err)
	}

	var before, after runtime.MemStats
	runtime.GC()
	runtime.ReadMemStats(&before)
	_, readErr := readParquet(bytes.NewReader(data), Options{}, func(*Chunk) error { return nil })
	runtime.ReadMemStats(&after)

	t.Logf("%d bytes allocated %.1f KiB, err=%v", len(data),
		float64(after.TotalAlloc-before.TotalAlloc)/(1<<10), readErr)
}
修正前(8cf4dda)と修正後(bd2f9e9)で、このファイルを 1 回ずつ読んだ出力が以下です。
== filesql 8cf4dda (bd2f9e9^)
473 bytes allocated 100456.2 KiB, err=failed to read table: decoding thrift payload: ... unexpected EOF
== filesql bd2f9e9 (bd2f9e9)
473 bytes allocated 40.1 KiB, err=parquet column chunk 0 of row group 0 claims 3113 bytes at offset 42 in a file of 473
修正前も、エラーを返すという結果は正しいです。問題は、エラーを返すまでに 100456.2 KiB、つまり 98.1 MiB を確保した点にあります。
Parquet のファイルは、列ごとのデータの塊を持ちます。この塊を列のチャンクと呼び、その位置と大きさをファイルの中で宣言しています。チャンクの中はページに分かれていて、各ページの見出しも、続くデータの大きさを宣言しています。
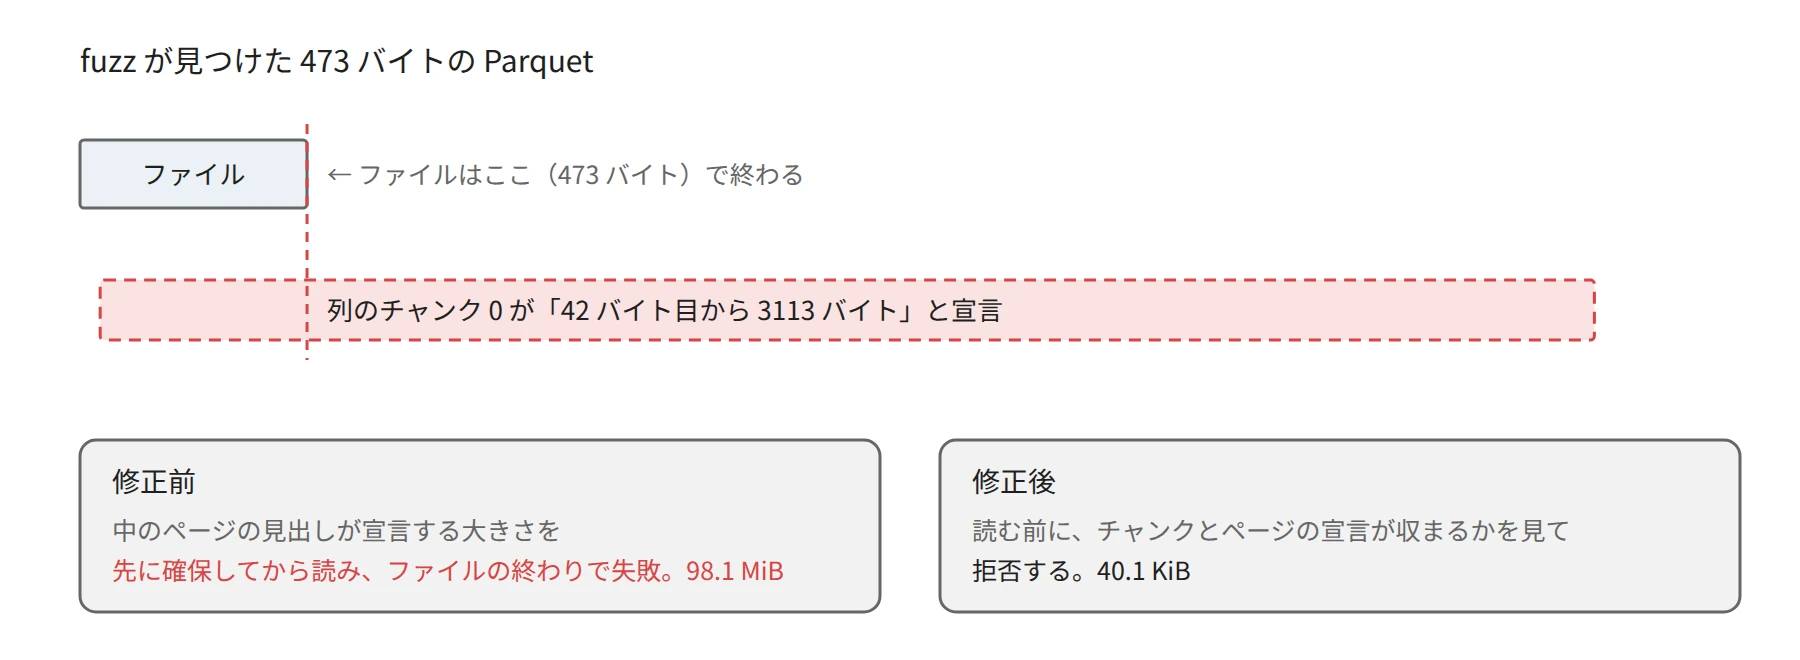
473 バイトのファイルが、ファイルに無い 3113 バイトを宣言していた
読み取りに使っている parquet-go は、ページの見出しが宣言した大きさのメモリを確保してから、その分のバイトがあるかを確認していました。そのため、同じファイルを何度も開く常駐のプロセスでは、開くたびに 98 MiB を確保します。
修正後の filesql は、ライブラリに渡す前に、各チャンクとページの宣言がファイルの大きさに収まるかを確認します。
fuzz の関数に書く検査
fuzz が見つけられるのは、fuzz の関数が検査している異常だけです。著者の OSS では、以下の検査で fuzz がバグを見つけました。
| 検査 | 失敗にする条件 | 見つけたもの |
|---|---|---|
| panic しない | panic した | filesql: Parquet の読み取りの中の panic |
| 確保の上限 | 決めた量を超えて確保した | filesql: 473 バイトのファイルで 98 MiB |
| 2 つの読み方の一致 | 全体を読んだ結果と、1 行ずつ読んだ結果が違う | jsonize: "\x1b\n" で 2 行が 1 行につながる |
| 別の実装との一致 | Go の encoding/json が読める入力を拒否した | jsonize: "\uD800"(検査の誤り) |
3 行目の \x1b は、端末の色付けの指定(エスケープ列)の始まりを表す ESC という制御文字です。全体を読む経路では、色付けを取り除く処理が、ESC の直後の改行をエスケープ列の終わりとみなして消し、2 行を 1 行につなげていました。1 行ずつ読む経路は先に行を切るので、つながりません。
この検査は、同じ入力を 2 つの経路で読んで結果を比べるもので、Metamorphic Testing のノートで扱った関係の 1 つです。4 行目は、別の実装と結果を比べる Differential Testing です。
例えば uutils の uufuzz も、ランダムな入力を GNU と uutils の両方に渡して比べています。fuzz は入力を作り、その入力で何を確認するかは、これらの手法から選べます。
4 行目は、fuzz が失敗した原因がプログラムではなく検査にあった例です。"\uD800" は、UTF-16 で 2 つ組で使う値の片方だけを書いたエスケープで、1 つの文字を表しません。Go の encoding/json は、これを U+FFFD(置換文字)に置き換えて読みます。jsonize は入力を黙って変えないことを方針にしていて、置き換えずに拒否するとテストで決めていました。
そこで、検査に「2 つ組の片方だけのエスケープは、拒否して良い」という例外を足し、見つかった入力を lone-surrogate という名前で seed に入れました。fuzz が失敗した時は、プログラムを直す前に、検査がプログラムの仕様と合っているかを確認します。
回しているつもりの fuzz
実験 1 の節で書いたように、-fuzz を付けない go test は seed を実行するだけです。そのため、新しい入力を探すには、fuzz の関数ごとに go test -fuzz を走らせる仕組みが別に必要です。filesql と jsonize は、GitHub Actions のスケジュールで毎晩動くジョブで、fuzz の関数ごとに 5〜10 分ずつ回しています。
ジョブは、パッケージのパスと関数名の組の一覧(matrix)から作ります。filesql では、v0.55.0 でパッケージを internal/ の下に移した時、この一覧を直し忘れました。
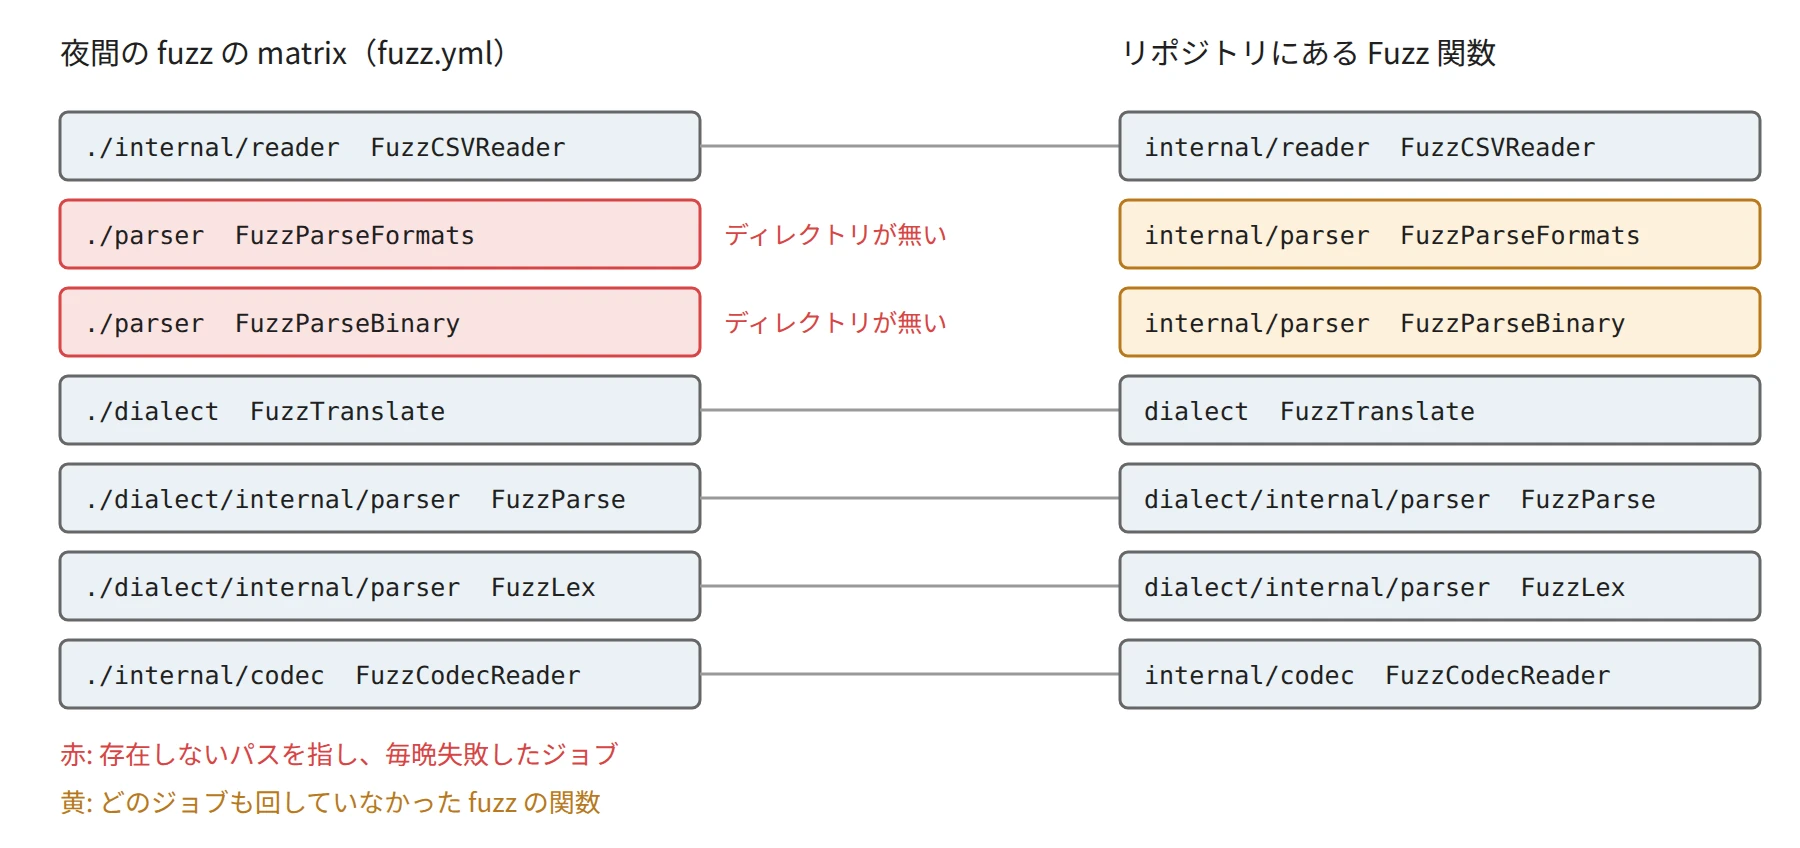
filesql v0.56.0 の時点で、2 つの fuzz の関数を誰も回していなかった
一覧の ./parser が存在しないので、2 つのジョブは毎晩、ディレクトリが無いことを示す directory not found というエラーで失敗していました。一覧には fail-fast: false を指定していたので、1 つのジョブが失敗しても他の 5 つは最後まで走ります。また、スケジュールで動くジョブの失敗は、プルリクエストの画面には出ません。そのため、誰も失敗を見ていませんでした。
回っていなかった 2 つは、外から受け取ったファイルを読む関数の fuzz で、filesql の中で最も fuzz が必要な所でした。v0.56.0 の時点でジョブの失敗に気付き、Issue #1051 で直しました。
jsonize でも、新しく書いた 2 つの fuzz の関数を一覧に足し忘れました。一覧とリポジトリの fuzz の関数を比べるジョブはありましたが、1 日 1 回の定期実行でしか動かなかったので、関数を書いたプルリクエストではなく、翌日の定期実行で報告されました。
どちらも、一覧とリポジトリの fuzz の関数を比べる確認が、プルリクエストごとに走るように直しました。リポジトリの fuzz の関数は grep '^func Fuzz' で列挙できます。fuzz を CI に入れたら、緑であることだけでなく、全ての関数が実際に回っていることを確認する必要があります。
fuzz を足す時に決めること
fuzz の関数を書くこと自体は、数行で済みます。著者の OSS で fuzz が役に立ったか、役に立たなかったかを分けたのは、以下の 4 つでした。
| 決めること | 確認すること |
|---|---|
| 対象 | ファイル、ネットワーク、コマンドの出力など、外から受け取るバイト列を読む関数か |
| 検査 | panic に加えて、メモリと時間の上限や、別の読み方・別の実装との一致を見るか |
| seed | 形式の確認を通る正しい入力を渡したか |
| 実行 | 全ての関数が、実際に毎晩回っているか |
fuzz はバイト列を作るので、形式の確認で弾かれやすく、作った入力の意味を知りません。構造のある値(日付、木、SQL の式など)を作って性質を確認する方法は、次の Property-Based Testing のノートで扱います。
実験のスクリプトと出力は lab に、図の生成元は figures.py にあります。