Differential Testing(差分テスト)は、同じ仕事をする 2 つ以上の実装に同じ入力を渡し、出力が一致するかを比べるテスト手法です。正解を人が書く代わりに、もう 1 つの実装の出力を比較の基準にします。名前は、McKeeman 氏の 1998 年の論文から広まりました。
同じ仕事をする実装が 2 つある場面は、思ったより身近にあります。Ubuntu 25.10 では、ls や sort などの基本コマンドを集めた coreutils の既定が、C で書かれた GNU coreutils から Rust で書き直した uutils coreutils に切り替わりました。経緯は Ubuntu の告知にあります。
著者の Ubuntu 26.04 には両方が入っていて、ls は uutils、gnuls は GNU です。シェルスクリプトから見ると、ある日を境に同じ名前のコマンドの中身が入れ替わったことになります。
著者はこの 2 つに、同じ 32 ケースの呼び出しを渡して比べました。26 ケースは出力も終了コードも一致し、5 ケースで違いました。残りの 1 ケースは、エラーの文面だけの差です。違った 5 ケースのうち 4 ケースは、書き込み先のディスクが一杯の時の振る舞いです。/dev/full は、書き込むと必ず「空き容量が無い」エラーを返す特殊なファイルで、ディスクが一杯の状況を再現できます。
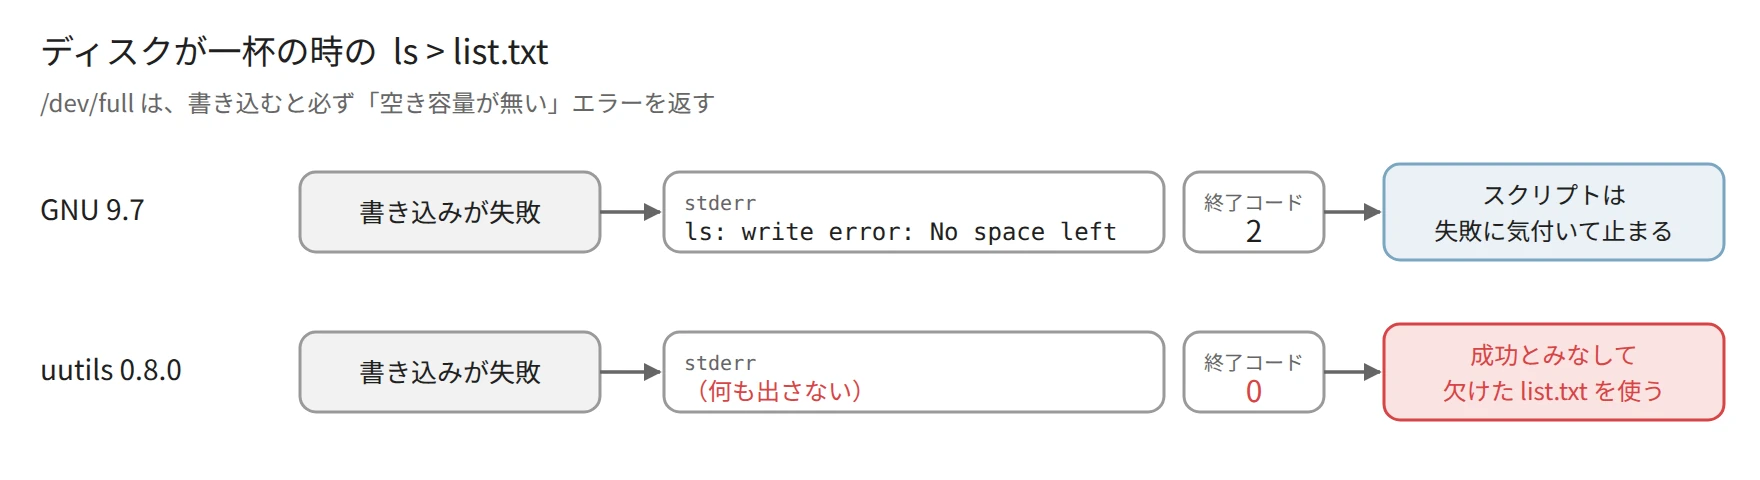
ディスクが一杯の時、uutils 0.8.0 の ls は失敗を報告しない
uutils 0.8.0 の ls は、書き込みに失敗しても何も表示せずに 0 で終わりました。ls > list.txt を実行したスクリプトは、ディスクが一杯でも成功したと判断して、中身の欠けたファイルを次の処理に渡します。残りの差は後の節で扱います。
どちらの実装にも「ディスクが一杯の時の正解」は書いてありません。2 つを並べて比べたことで、片方だけが失敗を報告していないと分かります。
本記事では、手元の 3 つの実験で、2 つの実装を比べるテストの考え方を説明します。扱う疑問は以下の通りです。
- 正解が分からない処理で、比較の相手はどこにあるのか。
- 出力の何を比べ、何を比べないのか。
- 差が出た時、どちらが正しいと決めるのか。
- 比べても見つからないものは何か。
正解の代わりに別の実装を使う
Metamorphic Testing のノートでは、入力ごとの正解(期待値)を書けない処理を扱いました。出力が正しいかを判定する手段をテストオラクルと呼び、正解を書けない問題はテストオラクル問題と呼ばれます。
Metamorphic Testing は、1 つの実装に入力を変えて 2 回渡し、2 つの出力が満たすはずの関係を検証する方法でした。例えば「2 つのファイルを 1 回で wc に渡した結果は、1 ファイルずつ渡してつないだ結果と等しい」という関係です。Differential Testing は、入力を 1 つに固定し、実装の方を 2 つにします。
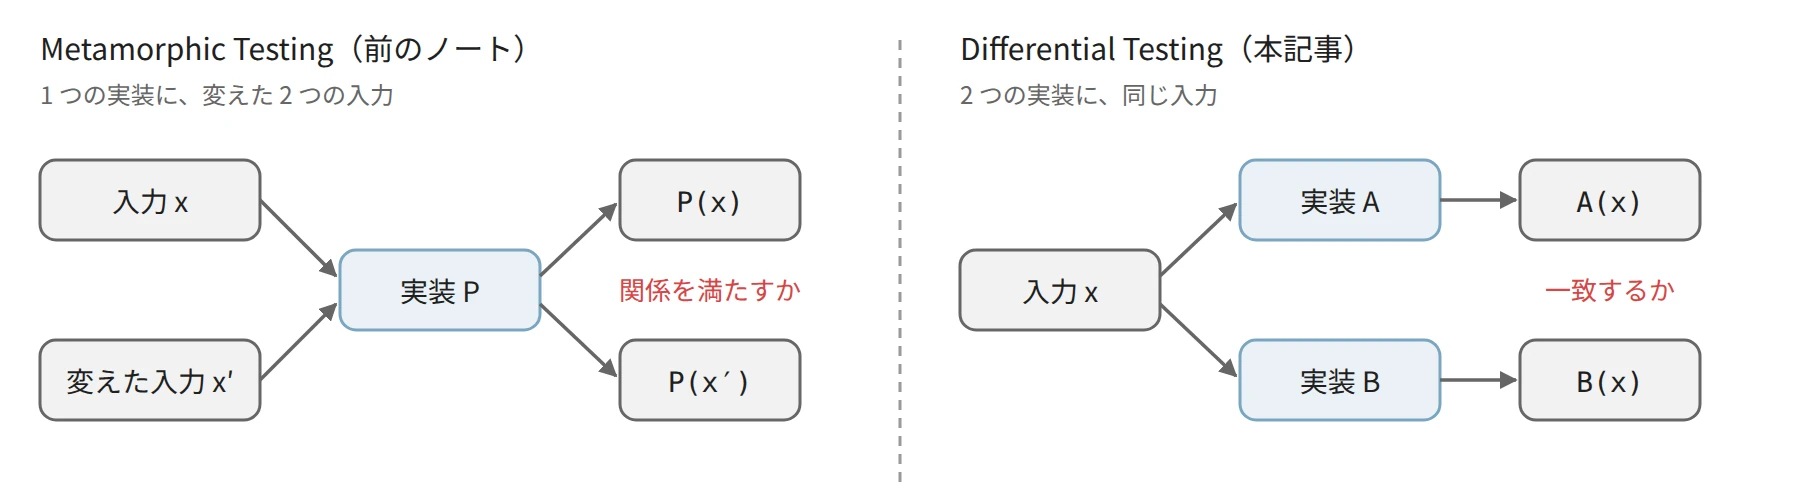
Metamorphic Testing は入力を 2 つにし、Differential Testing は実装を 2 つにする
Differential Testing で確認する関係は常に「一致する」なので、処理ごとに関係を考える必要がありません。その代わり、同じ仕事をする別の実装が必要です。
この手法で有名な成果に、C コンパイラのテストがあります。Csmith は、ランダムな C のプログラムを生成し、複数のコンパイラでビルドして実行し、出力が一致するかを比べるツールです。開発者の論文によると、3 年間で GCC や LLVM などに 325 件を超える未知のバグを報告しました。
Csmith は、C の仕様で動作が未定義になるプログラムを生成しないように作られています。未定義の動作では、コンパイラごとに出力が違っても誤りではないので、差がバグを意味しなくなるためです。
比較の相手の見つけ方
Csmith のように別の製品を用意できる場面は限られます。しかし、比較の相手は別の製品でなくても構いません。
| 比較の相手 | 例 |
|---|---|
| 同じ仕様の別の実装 | GNU coreutils と uutils、GCC と Clang |
| 同じプログラムの古いバージョン | 書き直し前のコード、リリース済みのバイナリ |
| 同じプログラムの別の経路 | パイプで渡す場合と、ファイル名で渡す場合 |
| 対象が自分で出す別の形式 | コマンドの表と JSON 出力(実験 2) |
| 対象が準拠すると約束した製品 | PostgreSQL 互換のライブラリと PostgreSQL(実験 3) |
書き直しや移行の作業では、古い実装がそのまま比較の相手になります。古い実装を消す前に、両方へ同じ入力を渡して比べておくと、書き直しで変わった振る舞いを一覧にできます。
実験 1: GNU coreutils と uutils
冒頭の結果は、以下のスクリプトで取りました。/usr/bin/gnu<コマンド名> が GNU、/usr/lib/cargo/bin/coreutils/<コマンド名> が uutils の実体です。以下は抜粋で、32 ケースの一覧の途中と、結果を表示する部分を略しています。全体は lab の exp1_gnu_uutils.py にあります。公開用の出力では ls -l の所有者の名前を伏せていて、そのための置き換えも抜粋からは略しました。
GNU = "/usr/bin/gnu{}"
UUTILS = "/usr/lib/cargo/bin/coreutils/{}"

# (ケース名, argv, リダイレクト)。"full" なら stdout を /dev/full に、ファイル名ならそのファイルを stdin にする。
CASES = [
    ("ls", ["ls"], None),
    ("ls -l(xattr 付き)", ["ls", "-l", "--time-style=+%Y", "attr.txt"], None),
    ("ls --bogus", ["ls", "--bogus"], None),
    # …(中略。全 32 ケース)
    ("ls(/dev/full へ)", ["ls"], "full"),
    ("printf(/dev/full へ)", ["printf", "x"], "full"),
    ("sort(/dev/full へ)", ["sort", "data.txt"], "full"),
    ("md5sum(/dev/full へ)", ["md5sum", "data.txt"], "full"),
]


def make_fixture(d):
    def w(name, text):
        with open(os.path.join(d, name), "w") as f:
            f.write(text)

    w("data.txt", "pear\napple\napple\nfig\n")
    w("nums.txt", "10\n9\n100\n")
    w("data.csv", "id,name\n1,pear\n2,fig\n")
    w("attr.txt", "x\n")
    os.setxattr(os.path.join(d, "attr.txt"), "user.note", b"1")
    for name in os.listdir(d):
        os.utime(os.path.join(d, name), (978307200, 978307200))  # 2001-01-01


def run(impl, argv, redirect):
    exe = (GNU if impl == "gnu" else UUTILS).format(argv[0])
    env = {"LC_ALL": "C", "PATH": "/usr/bin:/bin", "TZ": "UTC"}
    with tempfile.TemporaryDirectory() as d:
        make_fixture(d)
        stdin = subprocess.DEVNULL
        out = subprocess.PIPE
        if redirect == "full":
            out = open("/dev/full", "w")
        elif redirect:
            stdin = open(os.path.join(d, redirect))
        p = subprocess.run(argv, executable=exe, cwd=d, env=env,
                           stdin=stdin, stdout=out, stderr=subprocess.PIPE)
        return {
            "stdout": (p.stdout or b"").decode(errors="replace"),
            "stderr": p.stderr.decode(errors="replace"),
            "exit": p.returncode,
        }


for name, argv, redirect in CASES:
    g = run("gnu", argv, redirect)
    u = run("uutils", argv, redirect)
    raw = g != u
    normalized = (g["stdout"], g["exit"], bool(g["stderr"])) != \
                 (u["stdout"], u["exit"], bool(u["stderr"]))
比べる前に、2 つの実装の条件を以下のように揃えています。
| 揃える条件 | 揃え方 |
|---|---|
| 呼び出し名 | executable で実体を指定し、argv[0] は ls のままにする |
| ロケールと時刻 | LC_ALL=C と TZ=UTC を渡す |
| 入力 | ケースごとに作業ディレクトリを作り直し、同じファイルを同じ更新時刻で置く |
呼び出し名を揃えるのは、gnuls という名前で起動すると、エラーメッセージが gnuls: ... で始まり、それだけで差になるからです。ロケールを揃えるのは、日本語のロケールでは日付の表記などが実装ごとに違うからです。
何を比べるか
全てを比べる raw では、32 ケース中 6 ケースに差が出ました。stdout と終了コードを比べ、stderr は「何か表示したか」だけを比べる normalized では 5 ケースです。
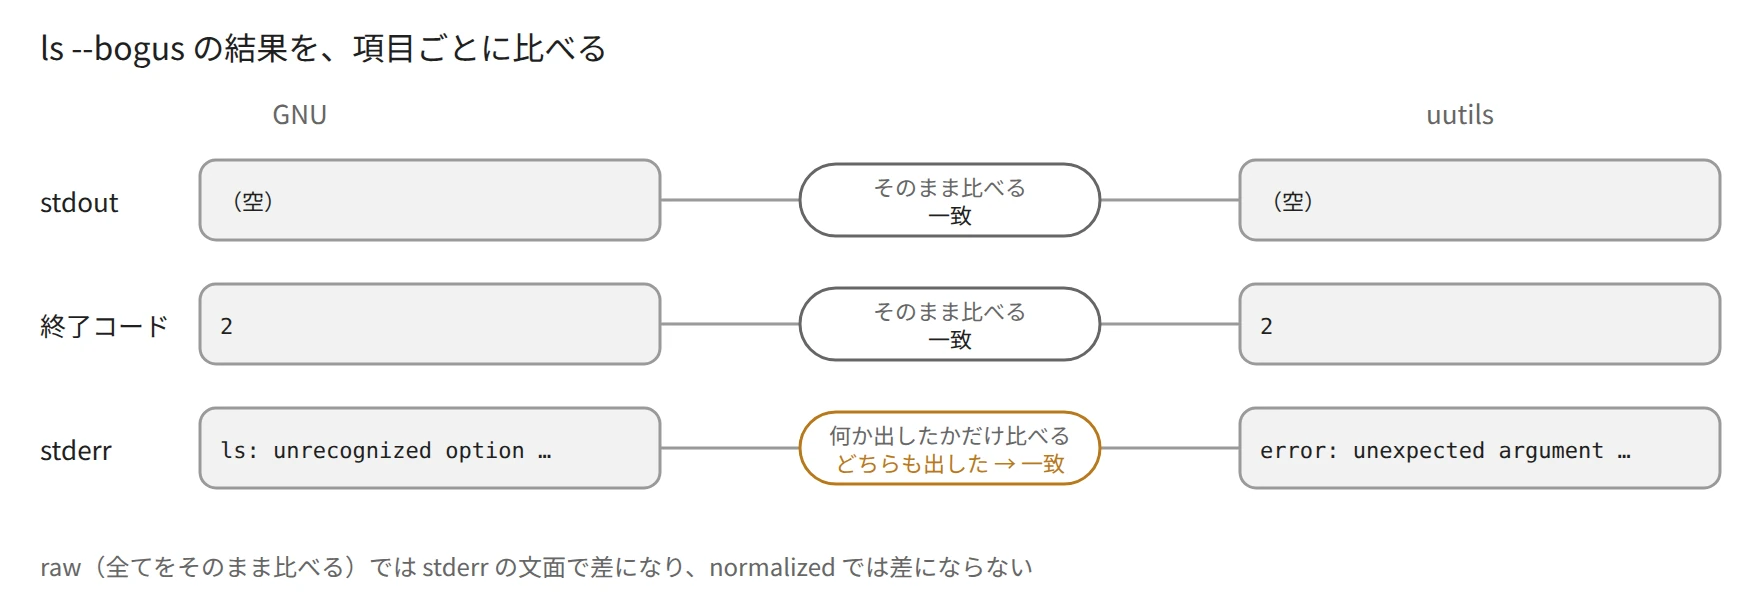
normalized は、stdout と終了コードをそのまま比べ、stderr は何か出したかだけを比べる
32 ケース、raw で差 6、normalized で差 5
[ノイズ] ls --bogus
  GNU    exit=2 stdout='' stderr="ls: unrecognized option '--bogus'\nTry 'ls --help' for more information"
  uutils exit=2 stdout='' stderr="error: unexpected argument '--bogus' found\n\n  tip: to pass '--bogus' a"
外れた 1 ケースは、知らないオプションを渡した時のエラーメッセージの文面です。uutils は引数の解析に clap というライブラリを使っていて、エラーの書式が GNU と違います。文面を読んで処理するスクリプトは稀なので、ここではこの差をノイズとして扱いました。
uutils の開発者も同じ判断をしています。uutils のリポジトリの fuzz ディレクトリには、ランダムな引数と入力を GNU と uutils の両方に渡して比べるテスト(uufuzz)があります。失敗にするのは stdout と終了コードの差で、stderr の差はほとんどの対象で表示するだけです。
uufuzz は、stderr を比べる前に両方の stderr から sort: のような最初の : までを落とし、コマンド名の違いが差として出ないようにしています。また、GNU を LC_ALL=C で起動します。
何を比べないかを決めないと、差の一覧の大半がノイズになり、本当の差を見落とします。一方で、比べない範囲を広げ過ぎると、本当の差も消えます。stderr を全く比べなければ、ls が書き込み失敗を報告しない差は終了コードでしか見えません。
同じソースから 2 回ビルドした成果物を比べる Reproducible Builds でも、時刻やファイルの所有者のように比べなくてよい差を先に取り除いてから、中身の差を調べます。
差が出た時の判断
2 つの実装の出力が違っても、どちらが正しいかは比べただけでは分かりません。実装が 3 つ以上あれば多数決を考えられますが、2 つでは決められません。そこで、両方が従うはずの文書を確認します。coreutils の場合は、UNIX 系 OS のコマンドの振る舞いを定めた標準規格である POSIX と、GNU のマニュアルです。
実験 1 で出た差を 1 つずつ判断した結果が、以下の表です。ls -l の 1 列目の末尾の + は、ACL などのアクセス制御があるファイルに付く印です。ACL(Access Control List)は、ファイルに利用者ごとの権限を付ける仕組みです。
| 差 | 確認した文書の定め | 判断 |
|---|---|---|
ls -l の + | GNU のマニュアル: ACL などがある時に付ける | uutils の誤り |
/dev/full への ls・printf が 0 | POSIX の printf と ls: エラーは 0 より大きい値 | uutils の誤り |
/dev/full への sort が 1 | POSIX の sort: エラーは 1 より大きい値 | uutils の誤り |
/dev/full への md5sum の異常終了 | 書き込みの失敗での異常終了を認める文書は無い | uutils の誤り |
| エラーの文面 | 文面を定めた文書は無い | ノイズ |
ls -l の +
実験では、ファイルに名前と値の組を付ける拡張属性(xattr)で、user.note という属性を付けました。これはアクセス制御ではないので、GNU の ls は + を付けません。
uutils 0.8.0 の has_acl 関数は、拡張属性が 1 つでもあれば ACL があるとみなすので、+ を付けました。
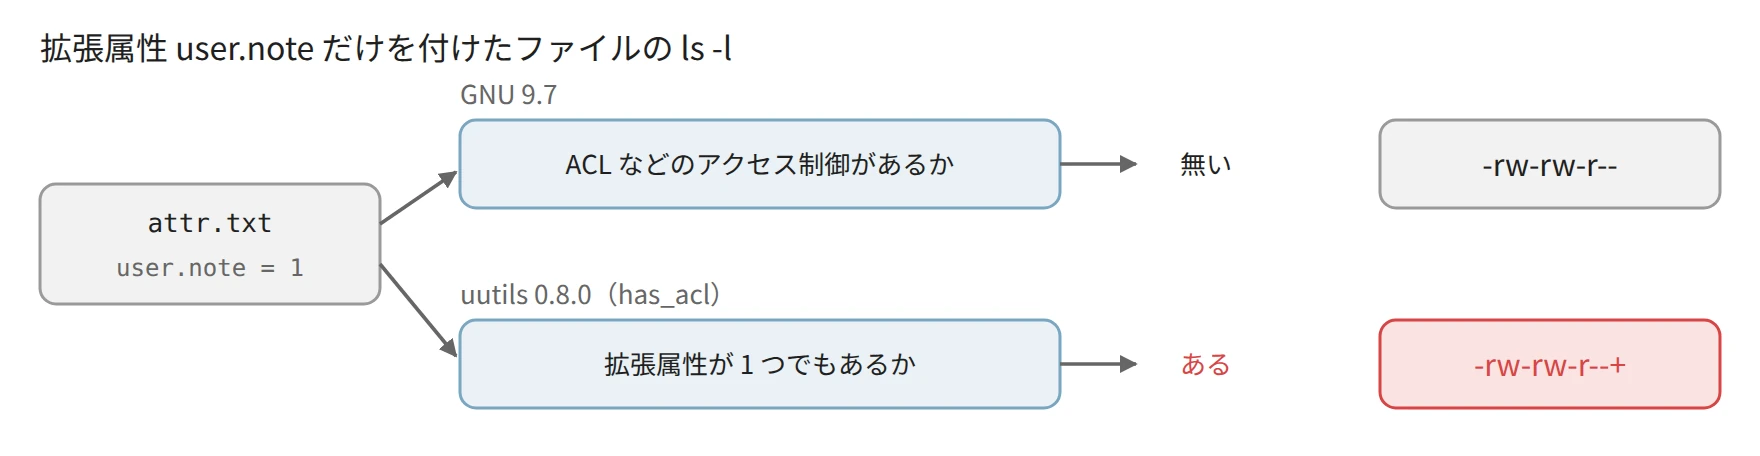
uutils 0.8.0 は、拡張属性があるだけで + を付ける
ls -l の 1 列目を正規表現で読んでいるスクリプトは、末尾の + で一致しなくなることがあります。
終了コードと panic
/dev/full へ書いた ls と printf は、冒頭の ls と同じく、失敗しても 0 で終わりました。POSIX はエラーに 0 より大きい値を求めているので、どちらも誤りです。
sort の -c は、入力が並んでいるかを確認するオプションです。POSIX は、終了コード 1 を -c で並んでいなかった時の値として取っておき、他のエラーには 1 より大きい値を求めます。GNU の 2 は「1 より大きい値」に収まり、uutils の 1 は収まりません。uutils は /dev/full への書き込みの失敗にその 1 を使ったので、終了コードで原因を分けるスクリプトは、並びの問題と取り違えます。
md5sum の異常終了は、Rust の panic です。panic は、回復できないエラーで処理を止める仕組みです。uutils は panic した時にすぐ止まる設定(panic = "abort")でビルドされているので、プロセスは SIGABRT(シグナル 6)で終わり、シェルからは 128 にシグナル番号の 6 を足した終了コード 134 に見えます。Python の returncode では -6 です。
書き込みの失敗の扱いは、同じ uutils の中でもコマンドごとに違います。stdio Buffering のノートで試した uutils の cat は、/dev/full への書き込みでエラーを表示して 1 を返しました。
バージョンを上げた時の比較
本記事を書いている途中の 2026-11-12 の朝に、著者の Ubuntu 26.04 では、更新を自動で入れる unattended-upgrades が uutils を 0.8.0 から 0.10.0 に上げました。同じスクリプトを実行し直すと、normalized の差は 5 から 4 に減りました。0.8.0 の結果は、docker の ubuntu:26.04 のイメージで同じスクリプトを実行して残しています。
| ケース | GNU 9.7 | uutils 0.8.0 | uutils 0.10.0 |
|---|---|---|---|
ls -l(xattr 付き) | -rw-rw-r-- | -rw-rw-r--+ | -rw-rw-r--+ |
ls(/dev/full へ) | 2、エラーを表示 | 0、何も表示しない | 1、エラーを表示 |
printf(/dev/full へ) | 1、エラーを表示 | 0、何も表示しない | 0、何も表示しない |
sort(/dev/full へ) | 2、エラーを表示 | 1、エラーを表示 | 1、エラーを表示 |
md5sum(/dev/full へ) | 1、エラーを表示 | panic(134) | 1、エラーを表示 |
md5sum は panic せずにエラーを表示して 1 を返すようになり、残った差は stderr の文面だけです。ls もエラーを表示するようになりましたが、終了コードは GNU の 2 に対して 1 です。
POSIX の ls は「0 より大きい値」としか定めていないので、この差は仕様の範囲内です。比較の規則に「終了コードは 0 かそれ以外かだけを比べる」を足すかは、次に決めることになります。
更新は利用者の知らない間にも入ります。比べるスクリプトを残しておけば、変わった振る舞いを 1 回の実行で一覧にできます。
実験 2: 対象が自分で出す JSON と比べる
jsonize は、コマンドの出力を JSON に変換する著者の CLI で、コマンド名は jz です。jz run ip -br link のように使うと、コマンドを実行して、その出力を JSON にします。コマンドごとに、出力の各行を正規表現で読む「定義」を持っています。
Linux のネットワークの設定を表示する ip コマンドは、-br(brief)を付けるとインターフェースを 1 行 1 つの短い表で出し、-j を付けると同じ内容を JSON で出します。以下は、docker が作った veth の行です。veth は、コンテナとホストをつなぐ仮想のネットワークインターフェースです。
$ ip -br link
veth3a8eedd@if2  UP             xx:xx:xx:xx:xx:xx <BROADCAST,MULTICAST,UP,LOWER_UP>
左から、インターフェース名、状態、MAC アドレス(ここでは伏せています)、フラグです。この表を jz で JSON にした結果と、ip -j -br link の JSON は、同じ情報のはずです。後者を比較の相手にすると、jz の定義が値を正しく読んでいるかを確認できます。
ただし、キーの名前は一致しません。jz はインターフェース名を interface に置き、ip -j は ifname に置きます。そこで、キーは比べずに、1 行に含まれる値の集まりを比べます。
def leaves(v, out):
    if isinstance(v, dict):
        for x in v.values():
            leaves(x, out)
    elif isinstance(v, list):
        for x in v:
            leaves(x, out)
    elif v is not None:
        out.append(str(v))
    return out


for o, n in zip(ours, native):
    a, b = Counter(leaves(o, [])), Counter(leaves(n, []))
    missing = b - a
    k, other = classify(a - b, missing)
上記は抜粋で、missing は ip -j にだけある値、classify は jz にだけある値を分類する関数です。集計と表示の部分は略しました。ours は jz run ip -br link の JSON、native は ip -j -br link の JSON です。ip の表と JSON は同じ順でインターフェースを並べるので、行の位置で対にできます。jz にだけある値は、jz が作った値か、誤って読んだ値の候補です。以下は、jz の修正前のバージョンと v0.9.1 で、veth の 1 行を比べた結果です。
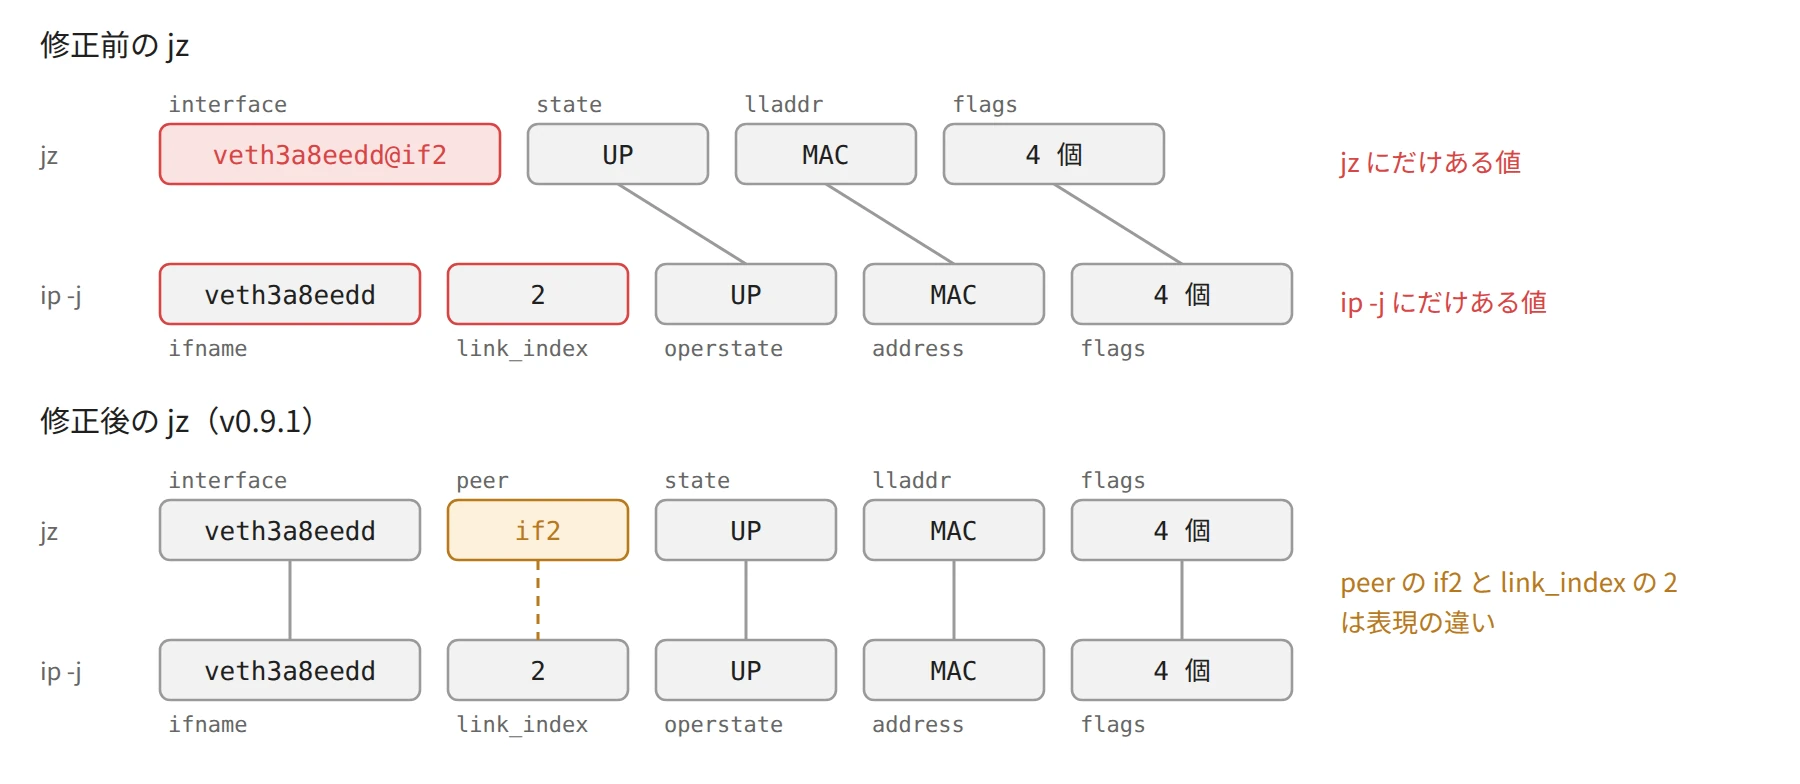
docker の veth の 1 行。修正前の jz は名前に相手の番号を含めていた
修正前の jz は、veth3a8eedd@if2 全体をインターフェース名にしていました。@ の後ろは veth の相手の番号で、ip -j では link_index という別の値です。この値をインターフェース名として次のコマンドに渡すと、ip link show dev veth3a8eedd@if2 は Device "veth3a8eedd@if2" does not exist. で失敗します。
classify は、jz にだけある値のうち、表現が違うだけと分かっている 2 種類を先に分けて数えます。1 つは「アドレスと長さ」で、jz の 127.0.0.1/8 に対して ip -j は 127.0.0.1 と 8 に分けています。もう 1 つは「ifN と N」で、jz の if2 に対して ip -j は 2 です。
def classify(extra, missing):
    """jz にだけある値を、表現の違いとその他に分ける。"""
    kinds = Counter()
    other = []
    for v in extra.elements():
        m = re.fullmatch(r"(.+)/(\d+)", v)
        if m and missing[m.group(1)] and missing[m.group(2)]:
            kinds["アドレスと長さ"] += 1
            missing[m.group(1)] -= 1
            missing[m.group(2)] -= 1
            continue
        m = re.fullmatch(r"if(\d+)", v)
        if m and missing[m.group(1)]:
            kinds["ifN と N"] += 1
            missing[m.group(1)] -= 1
            continue
        other.append(v)
    return kinds, other
どちらにも当たらない値を「その他」として表示します。全体は exp2_native_json.py にあります。手元には docker の veth が 3 本あり、修正前の「その他 3」はその 3 本の名前です。以下の出力は抜粋で、修正前の「その他」の行は 1 本分だけを載せています。
== 修正前の jz
ip -br link: 11 行、76 値、jz にだけある値 3(アドレスと長さ 0、ifN と N 0、その他 3)
  その他: jz 'veth3a8eedd@if2'、ip の JSON にだけある値 ['2', 'veth3a8eedd']
ip -br addr: 11 行、40 値、jz にだけある値 21(アドレスと長さ 18、ifN と N 0、その他 3)
== jz v0.9.1
ip -br link: 11 行、79 値、jz にだけある値 3(アドレスと長さ 0、ifN と N 3、その他 0)
ip -br addr: 11 行、43 値、jz にだけある値 21(アドレスと長さ 18、ifN と N 3、その他 0)
修正後の jz は、veth の相手を peer という値に分けるので、値が 3 個増えて 79 個になりました。jz にだけある値は 0 になりませんが、全て表現の違いに分類され、その他は 0 です。
表現の違いとバグの区別
veth3a8eedd@if2 も、ip -j の 2 つの値(veth3a8eedd と 2)をつないだ形です。字面だけで見ると、127.0.0.1/8 と同じく表現の違いに見えます。
区別したのは、値がその名前の役割を果たすかです。127.0.0.1/8 はアドレスの書き方として正しいですが、veth3a8eedd@if2 はインターフェース名として使えません。そのため、@if2 の方だけをバグとして直しました。
比べる前に表現の違いを吸収する変換(正規化)は、ノイズを減らす一方で、同じ形のバグも隠します。正規化の規則は、何の値に対して、なぜ同じとみなすかを 1 つずつ書いておく必要があります。
著者は jsonize で、表を出すコマンドとその JSON 出力の組 66 組を同じ方法で比べました。値の誤りとして直したのは、この @if2 の 1 件です。
別の機会に、ディスクの一覧を出す lsblk の -f・-m・-t の 3 つの表で、lsblk -J とキーの名前で値を対応させて比べました。空白区切りの -r の形式でも桁を揃えた表でも、3 つ合わせて 1281 個の値で差が 0 でした。差が 0 という結果も、定義が値を正しく読んでいる根拠になります。
実験 3: 比較の相手同士の結果が違う時
filesql は、CSV などのファイルを SQLite に読み込んで SQL で問い合わせる著者の Go のライブラリです。PostgreSQL や MySQL の書き方の SQL を受け取り、SQLite の SQL に変換して実行する機能も持っています。
この機能を検証する時、比較の相手の候補は 2 つあります。filesql が内部で使う SQLite と、filesql が書き方を受け付けると約束した PostgreSQL です。2 つの結果が同じなら迷いませんが、違う時はどちらかに合わせる必要があります。
以下は、同じ SQL を SQLite と PostgreSQL に渡す exp3_group_by.sh です。テーブル g には (1,10)、(2,10)、(3,20) の 3 行があり、どちらの SQL も、GROUP BY に無く集約もしていない列 a を SELECT しています。SQLite は Python の sqlite3 で、PostgreSQL は docker のコンテナで動かします。
#!/usr/bin/env bash
# 実験 3: 同じ SQL を SQLite と PostgreSQL に渡す。
#
# GROUP BY に無く、集約もしていない列 a を SELECT する。
# SQLite はグループごとに 1 行を選んで答え、PostgreSQL は拒否する。
# PostgreSQL は docker の postgres:17-alpine で一時的に起動する。
set -u

SQL_SETUP="CREATE TABLE g (a INTEGER, b INTEGER); INSERT INTO g VALUES (1,10),(2,10),(3,20);"
QUERIES=(
  "SELECT a, b FROM g GROUP BY b ORDER BY b;"
  "SELECT a, max(b) FROM g;"
)

echo "== SQLite $(python3 -c 'import sqlite3; print(sqlite3.sqlite_version)')"
for q in "${QUERIES[@]}"; do
  echo "> $q"
  python3 - "$SQL_SETUP" "$q" <<'EOF'
import sqlite3, sys
db = sqlite3.connect(":memory:")
db.executescript(sys.argv[1])
for row in db.execute(sys.argv[2]):
    print(row)
EOF
done

name="difftest-pg-$$"
docker run -d --rm --name "$name" -e POSTGRES_PASSWORD=x postgres:17-alpine >/dev/null
trap 'docker stop "$name" >/dev/null' EXIT
until docker exec "$name" pg_isready -q -U postgres; do sleep 0.5; done
sleep 1

echo "== $(docker exec "$name" postgres --version)"
docker exec "$name" psql -q -U postgres -c "$SQL_SETUP" >/dev/null
for q in "${QUERIES[@]}"; do
  echo "> $q"
  docker exec "$name" psql -q -U postgres -At -F ', ' -c "$q" 2>&1
done
実行した結果は以下の通りで、PostgreSQL のエラーの LINE 1: と ^ の行は略しています。
== SQLite 3.46.1
> SELECT a, b FROM g GROUP BY b ORDER BY b;
(1, 10)
(3, 20)
> SELECT a, max(b) FROM g;
(3, 20)
== postgres (PostgreSQL) 17.11
> SELECT a, b FROM g GROUP BY b ORDER BY b;
ERROR:  column "g.a" must appear in the GROUP BY clause or be used in an aggregate function
> SELECT a, max(b) FROM g;
ERROR:  column "g.a" must appear in the GROUP BY clause or be used in an aggregate function
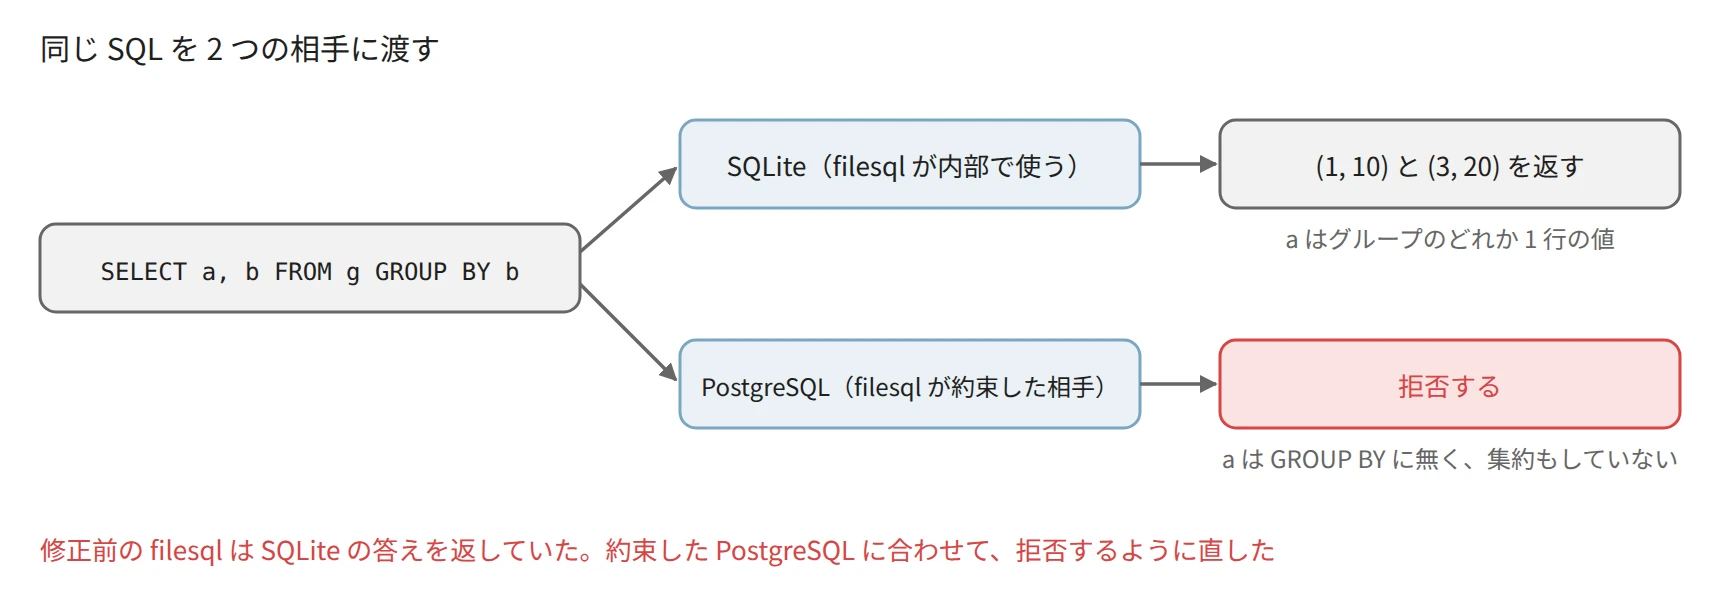
filesql にとって比較の相手の候補は 2 つあり、結果が違った
SQLite は答え、PostgreSQL は拒否しました。SQLite の答えは誤りではありません。SQLite の文書は、このような列を bare column と呼び、グループのどれか 1 行の値を返すと定めています。b = 10 のグループでは、a が 1 になるか 2 になるかは決まっていません。
2 本目の max(b) のように集約関数の max() か min() を 1 つだけ使う時は、bare column はその最大か最小の行の値を取ると、同じ文書が定めています。
修正前の filesql は、PostgreSQL の書き方の SQL を SQLite に渡し、SQLite の答えをそのまま返していました。
しかし、filesql は PostgreSQL の書き方を受け付けると約束しているので、比べる相手は PostgreSQL です。PostgreSQL の書き方で書かれた SQL に、決まっていない行を返すのは約束に反します。そこで、filesql の Issue #1095 で、変換の時点でこの SQL を拒否するように直しました。
比較の相手が 2 つあって結果が違う時は、どちらに合わせると約束したかで正しさが決まります。約束していない相手との差は、記録はしても直す理由にはなりません。
比べても見つからないもの
Differential Testing は、2 つの実装が同じ誤りを持っていると、差が出ないので見つけられません。
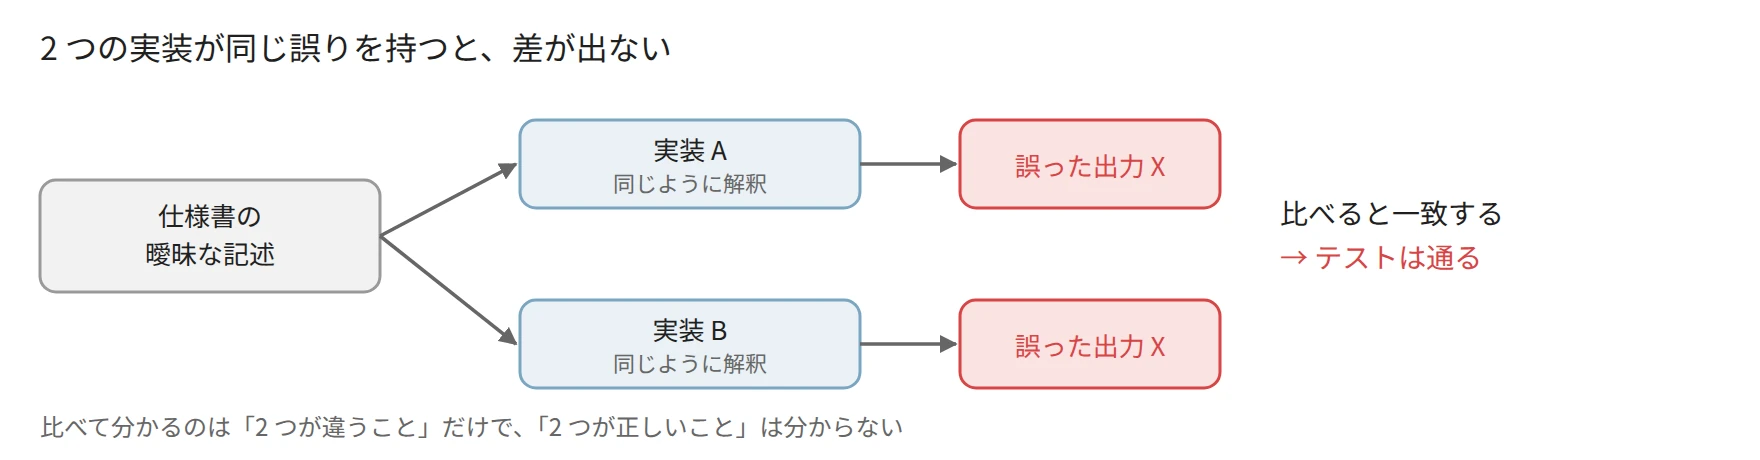
2 つの実装が同じ誤りを持つと、比べても差が出ない
jsonize の定義と ip -j は別の人が書いたので、同じ誤りを持つ可能性は低いです。しかし、2 人の開発者が、仕様書の同じ曖昧な記述で、同じ誤った解釈をすることはあります。
また、渡していない入力の差は見つかりません。実験 1 で /dev/full の 4 ケースを足したのは、書き込みの失敗が書き直しで壊れやすいと知っていたからです。思い付かなかった入力は、比べようがありません。uutils の uufuzz がランダムな引数と入力を生成しているのは、人が思い付かない入力も比べるためです。入力を機械に作らせる方法は、次の Fuzzing のノートで扱います。
実装を書き直す時や、ライブラリ・DB を移行する時は、古い実装を消す前に比較のスクリプトを用意すると、変わった振る舞いを一覧にできます。最初に決めることは 3 つです。何を比べないか(文面、時刻、並び順など)、表現の違いをどの規則で同じとみなすか、差が出た時にどの文書で判断するかです。この 3 つを決めずに比べ始めると、差の一覧を読み切れなくなります。
実験のスクリプトと出力は lab に、図の生成元は figures.py にあります。