Strangler Fig は、古いシステムの外側に新しいシステムを作り、請求や配送のような業務の機能を 1 つずつ移しながら、最終的に古いシステムを置き換える進め方です。
例えば、長年動いている注文管理のモノリス(全ての機能を 1 つのプログラムとしてデプロイするシステム)から、請求の機能を新しい請求サービスに移したいチームがあるとします。注文の受付や配送はモノリスで動かし続けます。取引先のシステムはこのチームが改修できないので、URL と応答の形は変えられません。
このチームは最初の一歩として、モノリスの手前に要求を振り分ける入口を置きます。この移行用の入口は、以降ではファサード(façade)と呼びます。下の図は、ファサードを置いてから機能を移し終えるまでの 3 段階です。
ファサードを置いてから機能を移し終えるまでの 3 段階
2 段目では、ファサードが請求の要求(GET /orders/{id}/invoice)だけを請求サービスに送ります。請求サービスは同じ URL と応答の形で答えるので、クライアントからは、どちらのシステムが応答したのかが分かりません。
請求の後も同じように機能を移し、モノリス宛ての要求と、ファサードを通らない依存(モノリスの中の関数呼び出しや、モノリスの DB(データベース)を直接読む他のシステム)が無くなった時点で、モノリスを止められます。
名前は、宿主の木の上で芽を出し、根を地面まで伸ばして自分で育つようになる絞め殺しの木(strangler fig。イチジクの仲間)から来ています。当初の呼び名だった Strangler Application には暴力的な含みがあるので、Martin Fowler 氏はブログ記事で呼び名を Strangler Fig Application に改めています。
本記事では、HTTP の要求を受けるバックエンドから、機能を 1 つずつ新システムに移す場合を説明します。答えていく疑問は次の通りです。
- なぜ一斉に切り替えず、機能を 1 つずつ移すか。
- 一斉に切り替えて戻せなかった銀行では、何が起きたのか。
- 何を単位に移すのか。
- ファサードは、要求をどのように振り分けるのか。
- データの所有者は、どのように移すのか。
- どの順で進めると、切り戻しやすいのか。
前提
以下は、以降で使う語の一覧です。
| 語 | 意味 | 冒頭の例 |
|---|---|---|
| レガシーシステム | 置き換えて、最終的に止めたい既存のシステム | 注文管理のモノリス |
| 新システム | レガシーシステムの機能を引き継ぐ新しいシステム | 請求サービス |
| 業務の機能 | 請求・配送・在庫のように、業務として提供している機能のまとまり。Strangler Fig で移す基本の単位 | 請求 |
| 経路 | URL のパスと HTTP メソッドの組。ファサードが要求を振り分ける単位 | GET /orders/{id}/invoice |
| 振り分けの規則 | どの経路やテナントの要求をどちらのシステムに送るかを決めた、ファサードの設定。変えれば次の要求から送り先が変わる | 請求書の照会は請求サービスへ |
| Transitional Architecture | 移行の間だけ置き、移行が終われば取り除く部品(Transitional Architecture) | ファサード、新旧の DB の間で値を揃える同期 |
ファサードの実装手段には、リバースプロキシ(クライアントの要求を代わりに受け、後ろのサーバーに転送するサーバー)や API Gateway(複数のサービスの手前に置き、認証や経路ごとの転送を受け持つ入口)があります。本記事でファサードと呼ぶのは実装手段ではなく、移行の間に新旧のシステムに要求を振り分ける役割です。デザインパターンの Facade とは別のものとして扱います。
Strangler Fig が必要な理由
レガシーシステムの機能を新システムで全て作り直し、ある日に一斉に切り替える進め方をビッグバン移行と呼びます。作り直しの間もレガシーシステムは業務で使われるので、税率の変更や不具合の修正が入り続けます。新システムはその変更も取り込み続けなければならず、完成の日が遠ざかります。切替日までは、新システムの成果は利用者に 1 つも届きません。
英国の銀行 TSB は 2018 年 4 月 22 日、元の親会社 Lloyds Banking Group が提供していたシステムから、新しく作ったシステムに約 520 万人の顧客を移しました。一部の機能は前年から段階的に移していたものの、データの大半は週末 1 回で移し、旧システムには戻せない移行でした。
切り替えの直後から支店・電話・オンラインで障害が続き、通常の運営に戻ったのは同年 12 月 10 日です。
データの移行そのものは成功しており、止まったのは移行先のシステムの方でした。影響は全 550 支店と顧客の大きな割合に及び、下の図の「全体を戻す」手段もありませんでした。
  %%{init: {"theme":"base","themeVariables":{"primaryColor":"#eaf1f5","primaryTextColor":"#28343b","primaryBorderColor":"#9cabb5","lineColor":"#596b76","textColor":"#28343b","actorBkg":"#eaf1f5","actorBorder":"#9cabb5","actorTextColor":"#28343b","actorLineColor":"#9cabb5","signalColor":"#596b76","signalTextColor":"#28343b","noteBkgColor":"#f7f1e5","noteBorderColor":"#c5b99b","noteTextColor":"#403c32","activationBkgColor":"#edf3ef","activationBorderColor":"#9aafa1"}}}%%
flowchart LR
    subgraph B["ビッグバン移行"]
        direction LR
        B1["全機能を<br/>作り直す"] --> B2["切替日に<br/>全機能を切り替える"]
        B2 --> B3["戻すなら<br/>全体を戻す"]
    end
    subgraph S["Strangler Fig"]
        direction LR
        S1["請求を<br/>移す"] --> S2["配送を<br/>移す"]
        S2 --> S3["レガシーシステムを<br/>止める"]
        S1 -.->|問題が出たら| R1["請求の<br/>切り替えを戻す"]
    end
    classDef default fill:#eaf1f5,stroke:#9cabb5,color:#28343b;
Strangler Fig では 1 回に切り替えるのは 1 機能なので、問題が出てもその機能の振り分けだけを戻せます。ただし、新旧が DB を共有していれば、その DB を通じて影響は移した機能の外にも広がり得ます。
並行運用や最後に捨てるコードの負担は増えますが、リスクを下げ、早くから価値を届けられる利点の方が大きい、というのが Fowler 氏の考え方です。
移す単位の選び方
1 回に移すのは、他の機能への依存ができるだけ少ない業務の機能 1 つです。移す機能を選ぶ時は、業務と技術の両面で継ぎ目(seam。システムを分けられる境目)を探し、どの業務を個別に取り出せるかで決めます(Patterns of Legacy Displacement)。
請求書の URL だけを請求サービスに向けても、モノリスの中に次の結び付きが残っていれば、請求の機能は切り離せていません。
| 確認する点 | 見ること | 冒頭の例で残り得る結び付き |
|---|---|---|
| 業務の境界 | 他の業務と規則や用語を共有せずに説明できるか | 請求書の番号・金額・発行状態が、請求の中だけで意味を持つか |
| 内部の呼び出し | モノリスの中の他の処理から直接呼ばれていないか | 注文の確定が、請求書を作る関数を呼んでいる |
| トランザクション | 他の機能のデータと、同じトランザクション(複数の書き込みを全部成功か全部失敗のどちらかにまとめる仕組み)で書かれていないか | 注文の確定と請求書の作成が、1 つのトランザクションに入っている |
| データの所有 | 他の機能がそのデータを直接読み書きしていないか | 配送が、請求書のテーブルを読んでいる |
1 つのトランザクションにまとめていた書き込みは、別々に確定しても業務上困らないかを確認してから分けます。結び付きの少ない機能から始めると、最初の切り替えで対処する問題を減らせます。
ファサードによる振り分け
ファサードは、届いた要求の中身を見て、送り先をレガシーシステムと新システムから選びます。送り先は、パスとメソッドのほか、ヘッダーやテナント(1 つのシステムを共有して使う顧客の単位。会社など)でも決められます。利用者の一定の割合だけを新システムに送ることもできます。
  %%{init: {"theme":"base","themeVariables":{"primaryColor":"#eaf1f5","primaryTextColor":"#28343b","primaryBorderColor":"#9cabb5","lineColor":"#596b76","textColor":"#28343b","actorBkg":"#eaf1f5","actorBorder":"#9cabb5","actorTextColor":"#28343b","actorLineColor":"#9cabb5","signalColor":"#596b76","signalTextColor":"#28343b","noteBkgColor":"#f7f1e5","noteBorderColor":"#c5b99b","noteTextColor":"#403c32","activationBkgColor":"#edf3ef","activationBorderColor":"#9aafa1"}}}%%
flowchart LR
    R[要求] --> P{"請求書の<br/>経路か"}
    P -->|いいえ| L[レガシーシステム]
    P -->|はい| T{"対象の<br/>テナントか"}
    T -->|いいえ| L
    T -->|はい| N[新システム]
    classDef default fill:#eaf1f5,stroke:#9cabb5,color:#28343b;
振り分けの規則に書いていない経路は、今まで通りレガシーシステムが受けます。割合で分ける時は、利用者 ID から送り先を計算するなど、同じ利用者が要求ごとに新旧を行き来しない分け方を選びます。
1 つの機能の中では、データを変えない参照の経路から移すと切り戻しやすくなります。請求書の照会(GET)の処理がデータを書かない作りなら、新システムが誤った応答を返しても DB の中身は壊れず、規則を戻せば以降の要求はレガシーシステムが受けます。ただし、既に返した誤った応答を取引先が取り込んでいれば、その影響は残ります。
ファサードが振り分けられるのは、ファサードを通る要求だけです。システムの間を伝わる更新(注文の確定を知らせるメッセージなど)を途中で受け取り、その一部を新しい部品に回すやり方は Event Interception と呼ばれます。受け取る場所には、HTTP の要求のほか、メッセージ基盤(システムの間でメッセージを受け渡す仕組み)のキューや、DB への書き込みを拾うトリガーも使えます。
CDC(Change Data Capture。DB の変更ログを順に読み、確定した変更を外に流す仕組み)も、レガシーシステムのコードを変えずに DB の変更を新システムへ届けられます。ただし、Event Interception の解説では、更新を途中で受け取るやり方とは区別しています。
一方で、注文の確定処理が請求書を作る関数を直接呼んでいる場合は、途中で受け取れる場所がありません。この場合は、呼び出し側のコードを変えて、注文が確定したことをメッセージで外に知らせるようにします。
  %%{init: {"theme":"base","themeVariables":{"primaryColor":"#eaf1f5","primaryTextColor":"#28343b","primaryBorderColor":"#9cabb5","lineColor":"#596b76","textColor":"#28343b","actorBkg":"#eaf1f5","actorBorder":"#9cabb5","actorTextColor":"#28343b","actorLineColor":"#9cabb5","signalColor":"#596b76","signalTextColor":"#28343b","noteBkgColor":"#f7f1e5","noteBorderColor":"#c5b99b","noteTextColor":"#403c32","activationBkgColor":"#edf3ef","activationBorderColor":"#9aafa1"}}}%%
sequenceDiagram
    participant F as ファサード
    participant L as レガシーシステム
    participant N as 新システム
    F->>L: POST /orders
    L->>L: 注文を確定する
    Note over L,N: 変更前はここで<br/>請求書を作る関数を<br/>直接呼んでいた
    L-)N: 「注文が確定した」を流す
    N->>N: 請求書を作る
    L-->>F: 201 Created
元の呼び出しを残したままだと、請求書は新旧の両方で作られます。
振り分けの条件と認証
テナントで送り先を変える時は、振り分けに使う情報を信頼できるかが問題になります。例えば、クライアントが送った X-Tenant-Id ヘッダーの値をそのまま信じると、A 社の利用者が値を B 社に書き換えるだけで、B 社の要求として振り分けられます。新システムが同じヘッダーを所属の根拠にしていれば、B 社の請求書を読めることにもなります。
移行の間は、要求を処理するシステムもデータの置き場所も新旧の 2 つになるので、次の点を確認します。
| 対象 | 行うこと |
|---|---|
| 振り分けの条件 | テナントは、認証結果とサーバー側の所属情報から確定するか、信頼できる上流が付与した値だけを使う。上流が付与する構成では、外部から届いた同名のヘッダーを上流で取り除き、ファサードや新システムには上流を通った要求だけが届くようにする |
| 新旧の認可 | 同じ利用者と同じ請求書に対して、許可と拒否の判定を新旧のシステムで揃える |
| 新システムに届く本番データ | 要求を送り始める前に、アクセス制御・暗号化・監査の記録を整える。後述の並行稼働で複製した要求のように、利用者に応答を返さない要求でも、新システムには本番のデータが届く |
| 規則の変更と記録 | 規則を変えられる人を限り、変更の履歴を残す。比較や同期のログに、トークンや調査に不要な個人情報を残さない |
互換 API
互換 API は、クライアントから見た契約をレガシーシステムと同じに保った、新システムの API です。契約は、URL、要求と応答の形、状態コードとエラーの意味のように、クライアントが前提にしている取り決めを指します。契約を変えると、古い契約で呼ぶクライアントの改修が終わるまで経路を移せません。冒頭の取引先のように改修できない相手がいれば、移行の日程をその相手に合わせることになります。
| 契約の項目 | レガシーシステムの応答(例) | 新システムでの扱い |
|---|---|---|
| 項目名 | inv_no・amt | 内部では請求書番号・金額として持ち、応答で元の名前に戻す |
| 金額の表し方 | 文字列の "1000" | 内部では整数で持ち、応答で文字列に戻す |
| 存在しない注文 | 404 と {"error":"NOT_FOUND"} | 同じ状態コードと本文を返す |
内部までレガシーシステムの項目名や表し方に合わせると、移行が終わった後もその設計が新システムに残ります。そのため、変換は新システムの入口に置きます。相手の表し方を入口で自分の表し方に変換する点で、Anticorruption Layer に近い考え方です。
移行の途中は、請求サービスがモノリスに残る注文の明細を問い合わせるように、新旧が互いを呼び出す箇所も残ります。この時は、新システムとモノリスの間に、モノリスが元々期待している呼び方とデータの形でやり取りする変換の部品を挟みます。
レガシーシステムに変更を気付かせずにやり取りするこのやり方を Legacy Mimic と呼びます。この部品も、移行の間だけ置く Transitional Architecture です。
全ての機能を移し終えた後は、ファサードを外してクライアントを新システムに直接繋ぐか、古いクライアントのためのアダプターとしてファサードを残すかを選べます(Azure Architecture Center)。
データの所有者
照会の経路は、新システムがレガシーの DB を読むだけなら、データを動かさずに移せます。しかし、新システムが最終的に自分の DB を持つとしても、移行の間はモノリスに残る配送などがレガシーの DB の請求書を読み続けるので、しばらくは両方の DB に値が必要です。
素朴には、1 つの要求を処理する中で 2 つの DB に順に書けば済むように見えます。このやり方を二重書き込み(dual write)と呼びます。2 つの書き込みは、通常は 1 つのトランザクションとして確定できません。以下は、同じ請求書の金額を 2 本の要求がほぼ同時に変え、書き込みが割り込んだ場合の一例です。
  %%{init: {"theme":"base","themeVariables":{"primaryColor":"#eaf1f5","primaryTextColor":"#28343b","primaryBorderColor":"#9cabb5","lineColor":"#596b76","textColor":"#28343b","actorBkg":"#eaf1f5","actorBorder":"#9cabb5","actorTextColor":"#28343b","actorLineColor":"#9cabb5","signalColor":"#596b76","signalTextColor":"#28343b","noteBkgColor":"#f7f1e5","noteBorderColor":"#c5b99b","noteTextColor":"#403c32","activationBkgColor":"#edf3ef","activationBorderColor":"#9aafa1"}}}%%
sequenceDiagram
    participant A as 要求 A の処理
    participant B as 要求 B の処理
    participant L as レガシーの DB
    participant N as 新しい DB
    A->>L: 金額を 1,200 円にする
    B->>L: 金額を 1,500 円にする
    B->>N: 金額を 1,500 円にする
    A->>N: 金額を 1,200 円にする
    Note over L,N: レガシーの DB は 1,500 円<br/>新しい DB は 1,200 円
4 回の書き込みは全て成功するため、2 つの DB の値を比較するまで不一致に気付けません。2 回目の書き込みの前にプロセスが止まった場合も、片方の DB だけが更新されます。
どちらの値が正しいか分からなくなる状態を避けるには、請求書や注文のようなデータの集合ごとに、書き込みを受け付け、その値を正しいものとして扱う DB を 1 つ決めます。以降は、この DB を「所有者」と呼びます。
もう一方の DB には、所有者で確定した変更を後から流します。流す手段には、CDC や、後で送るメッセージを変更と同じトランザクションで書いておく Transactional Outbox があります。
  %%{init: {"theme":"base","themeVariables":{"primaryColor":"#eaf1f5","primaryTextColor":"#28343b","primaryBorderColor":"#9cabb5","lineColor":"#596b76","textColor":"#28343b","actorBkg":"#eaf1f5","actorBorder":"#9cabb5","actorTextColor":"#28343b","actorLineColor":"#9cabb5","signalColor":"#596b76","signalTextColor":"#28343b","noteBkgColor":"#f7f1e5","noteBorderColor":"#c5b99b","noteTextColor":"#403c32","activationBkgColor":"#edf3ef","activationBorderColor":"#9aafa1"}}}%%
flowchart LR
    A[請求書を扱う処理] -->|書き込み| O[("所有者である DB")]
    O --> T["変更を流す<br/>CDC または Outbox"]
    T -->|"同じ変更が<br/>2 回届き得る"| R[冪等な受け手]
    R --> P[("もう一方の DB")]
    classDef default fill:#eaf1f5,stroke:#9cabb5,color:#28343b;
受け手は冪等(同じ変更を何回適用しても、1 回適用した時と結果が同じになる性質)にしておきます。ただし、再送や受け手の並列処理で後の変更が先に届く入れ替わりは、冪等にしても防げません。
入れ替わりへの対策の例は、所有者で請求書ごとに更新番号を振り、受け手が最後に適用した番号より古い変更を捨てる方法です。この方法は、変更が「金額を 1,500 円にする」のように変更後の値を運ぶ場合に使えます。「300 円増やす」のような差分を運ぶ変更では、古い変更を捨てると、その差分が失われます。
後から流す方式でも、反映が終わるまでは 2 つの DB の値が一時的に食い違います。所有者を 1 つに定めて避けられるのは、どちらが正しいか分からなくなることで、値の差そのものではありません。
所有者の段階的な移行
所有者は、戻しやすい段階から順に移します。Azure Architecture Center の例は、データを 3 段階で移します。新システムがモノリスの DB を読み書きする段階、分離した DB へ同期しながら新システムが新しい DB にも書き込む段階、新しい DB が所有者になる段階です。以下はこの大枠を土台に、請求書の例に合わせて変えた構成例です。
| 段階 | 書き込み先 | 同期の向き | 切り戻しの操作 |
|---|---|---|---|
| 共有(新システムもレガシーの DB を読み書きする) | レガシーの DB | なし | 振り分けの規則を戻す |
| 追従と突き合わせ | レガシーの DB | 旧 → 新 | 振り分けの規則を戻す |
| 新が所有者 | 新しい DB | 新 → 旧 | 同期と突き合わせを済ませてから所有者を戻す |
| 旧データ削除 | 新しい DB | なし | バックアップの復元と、その後の変更の再適用が必要 |
Azure の例と違い、二重書き込みを避けるために、追従の段階では新システムの書き込みもレガシーの DB だけで受けます。切り戻しやすくするために、新から旧への逆方向の同期も足します。
既存のデータを新しい DB に一括でコピーした後、レガシーの DB の変更を流し続けます。所有者を切り替える前に、2 つの DB の件数やチェックサム(内容が 1 か所でも違えば高い確率で値が変わる短い値)を比べる突き合わせで食い違いを探します。
所有者を切り替える時は、請求書への書き込みを止め、旧から新への同期が最後の変更まで反映されたことを確認してから、書き込み先を新しい DB にします。止める書き込みには、ファサードを通る要求だけでなく、モノリスの中の呼び出しやバッチ処理も含みます。反映を待たずに新しい DB で書き込みを受けると、後から届いた同期の変更がその書き込みを上書きし得ます。
逆方向の同期は、旧から新への同期を止めてから始めます。止めないと、新から旧へ流した変更が拾われて新しい DB に戻ってきます。
切り戻す時は同じ手順を逆向きに進めます。この時は、新から旧への同期が新しい DB の変更を読み終えたかだけでなく、その変更をレガシーの DB に書き終えたかまで確認します。旧から新への同期を再開する時は、前回止めた位置からではなく、切り戻した時点以降の変更から読みます。前回の位置から読むと、逆方向の同期がレガシーの DB に書いた変更を読み直すからです。
更新番号で順序を守っている場合、所有者を切り替えると番号を振る DB も変わります。レガシーの DB の請求書には、切り替え前にレガシーの DB が振った大きな番号が残っています。新しい DB が 1 番から振ると、その番号の方が小さいので、古い変更と判定されて捨てられます。
所有者を切り替える度に 1 つ増やす番号(epoch)を先に比べれば、新しい epoch の小さい番号の方を新しいと判定できます。以下は、2 つの比べ方を並べた模式図です。
所有者の切り替えをまたぐ更新番号の比べ方(模式図)
番号の値は説明用です。切り替えをまたいで 1 つの採番元から番号を振る方法もあります。
逆方向の同期があっても、次のような変更は戻せないことがあります。
| 戻せない変更 | 冒頭の例 |
|---|---|
| 新旧のスキーマの差 | 新しい DB だけに、分割払いの内訳を持たせた |
| 削除と集約 | 複数の請求書を 1 枚にまとめ、元の請求書を消した |
| 採番 | 新しい DB で振った請求書番号が、レガシーの採番規則と衝突する恐れがある |
| 外部への副作用 | 請求書のメールを送った |
このような変更があるなら、戻すと失われる情報を前もって別に保存し、採番の範囲を新旧で分けておきます。送信済みのメールなど、取り消せない処理への対応手順も決めておきます。レガシーの DB から請求書のテーブルを消すのは、新システムの検証が済んでから、最後の一歩として行います。
切り戻しやすい順序
1 つの機能を移す時は、戻す操作が軽い段階から順に進めます。最初に置く並行稼働(Parallel Run)は、新旧に同じ入力を処理させて結果を比べるやり方です。Sam Newman 氏の書籍『モノリスからマイクロサービスへ』では、3 章の「パターン:同時実行」として取り上げられています。
  %%{init: {"theme":"base","themeVariables":{"primaryColor":"#eaf1f5","primaryTextColor":"#28343b","primaryBorderColor":"#9cabb5","lineColor":"#596b76","textColor":"#28343b","actorBkg":"#eaf1f5","actorBorder":"#9cabb5","actorTextColor":"#28343b","actorLineColor":"#9cabb5","signalColor":"#596b76","signalTextColor":"#28343b","noteBkgColor":"#f7f1e5","noteBorderColor":"#c5b99b","noteTextColor":"#403c32","activationBkgColor":"#edf3ef","activationBorderColor":"#9aafa1"}}}%%
flowchart TB
    subgraph R["規則を戻せば以降の要求はレガシーシステムに届く"]
        direction LR
        P1["照会を並行稼働し<br/>応答を比べる"] --> P2["照会を一部の<br/>利用者に広げる"]
        P2 --> P3["発行も新システムに<br/>(共有・追従)"]
    end
    subgraph D["逆方向の同期と確認で戻す"]
        P4["所有者を<br/>新しい DB に"]
    end
    subgraph X["復元と再適用が必要"]
        P5["旧データを<br/>削除"]
    end
    R --> D --> X
    classDef default fill:#eaf1f5,stroke:#9cabb5,color:#28343b;
ファサードが要求を複製して並行稼働する場合、利用者にはレガシーシステムの応答を返し、新システムの応答は比較の記録にだけ使います。更新の経路を複製すると、新システムも請求書を発行し、通知のメールが 2 通出るような副作用が起き得るので、複製するのは主に参照の経路です。
| 気を付ける点 | 行うこと |
|---|---|
| 新システム側の副作用 | 複製した要求では、メールの送信・外部のシステムの更新・共有キャッシュへの書き込みを無効にする |
| 意味の無い差 | 生成時刻・要求 ID・JSON の項目の順序のように、正しくても新旧で違う値は、比べる前に揃える |
| 新システムの遅延と障害 | 比較は利用者への応答と切り離して非同期で行い、複製の要求には上限時間を設ける |
段階を進めるか戻すかは、経路ごと・新旧ごとのエラー率と遅延、並行稼働で応答が食い違った割合、同期の遅れ、突き合わせの不一致件数で判断します。レガシーシステムの経路を廃止する前には、ファサードに届く要求数だけでなく、モノリスの中の呼び出しや DB を直接読む他のシステムからのアクセスも数えます。
エラー率を合計だけで見ると、移した経路の悪化は他の経路の数字に紛れます。
シミュレーションでは、20 本の経路のトラフィックを Zipf 分布(s = 1、合計で毎分 1,000 件)とし、全体の 2.8% を占める 10 番目の経路だけを 30 分の時点で新システムに移しました。エラー率はレガシーシステムが 0.5%、新システムが 8%(後半では 0.5〜30% と変える)です。
警報は直近 5 分のエラー率で判定し、閾値は全経路の合計が 1%、移した経路の新システム側が 3% です。以下は lab/route_alert.py から警報を判定する部分の抜粋です。
    for t in range(MINUTES):
        lo = max(0, t - WINDOW + 1)
        tr = sum(tot_err[lo:t + 1]) / sum(tot_req[lo:t + 1])
        n = sum(rt_req[lo:t + 1])
        rr = sum(rt_err[lo:t + 1]) / n if n else None
        ...
        if tr > TOTAL_LIMIT and first["total"] is None:
            first["total"] = t
        if n >= MIN_REQ and rr > ROUTE_LIMIT and first["route"] is None:
            first["route"] = t
lab/ で python3 route_alert.py を実行した結果のうち、新システムのエラー率が 8% の時の時系列です。seed を変えた 200 回の試行で 60 分以内に警報が鳴った割合(sweep の表)は、次の図の右に描きました。全体の出力は lab/output.txt にあります。
routes=20 total=1000 req/min migrated=rank 10 (2.8% of traffic, 28 req/min)
time series (new error 8%, seed 0):
  total error rate after switch: max 0.96%
  total alert: never, failed requests until then: None
  route alert: minute 2 after switch, failed requests until then: 8
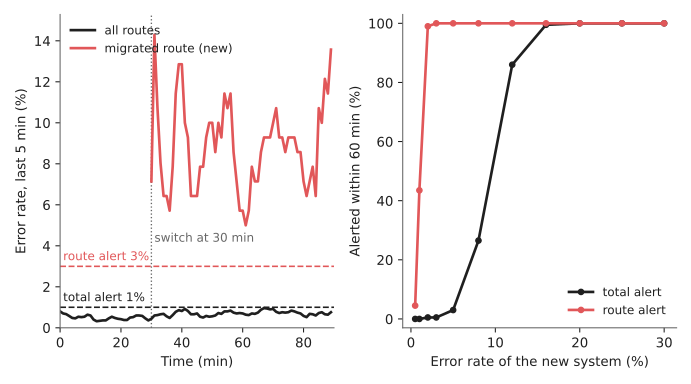
合計の警報と経路ごとの警報の鳴り方(シミュレーション)
新システムのエラー率が 8% の左の図では、合計(all routes)は最大 0.96% に留まり、経路ごとの警報(route alert)は切り替えから 2 分で鳴りました。200 回の試行では、8% で合計の警報が鳴ったのは 26.5% で、経路ごとの警報は 2% 以上なら 99% 以上鳴っています。ただし欠陥の無い 0.5% でも 4.5% の試行で鳴るので、件数の少ない経路では閾値の調整が必要です。
利点
- 1 回の切り替えで直接変わる範囲が、移した機能とそのデータに絞られやすい
- 移し終えた機能から順に、利用者が新システムを使い始められる
- 互換 API で受ければ、クライアントは URL と契約を変えずに呼び続けられる
- 移行の途中で、移す順序や優先度を見直せる
欠点
- 移行期間中は、新旧のシステム・ファサード・同期処理を並行して運用する
- 全ての要求を 1 つのファサードで受ける構成では、ファサードが止まると全経路が応答できなくなり、ファサードで増えた遅延も全経路に加わる。複数台で動かす、振り分けの判定を軽くするといった対策が必要になる
- ファサード・変換の部品・同期のように、最後に捨てるコードを書く。消し忘れると移行後も運用し続ける
- 新旧の両方が同じ振る舞いを担当している間は、仕様変更や修正を両方に入れなければならないことがある
適さないケース
Azure Architecture Center は、次の場合にはこのパターンが適さないことがある、としています。
- レガシーシステムへの要求を途中で受け取れない
- レガシーシステムのソースを変更できず、DB のように手を入れられる他の接点も無い
- システムが小さく、全体を一度に置き換える方が簡単
- 元のシステムを急いで完全に廃止する必要がある