Kubernetes の Job(完了したら終わるバッチ処理)に、ログを送るコンテナを 1 つ足しただけで、Job が終わらなくなることがあります。処理のコンテナは 5 秒で終わっているのに、kubectl get jobs の完了の数は 0 のままです。以下は、手元の Kubernetes v1.34.0 で、同じ処理の Job を 3 通りの置き方で動かした結果です。
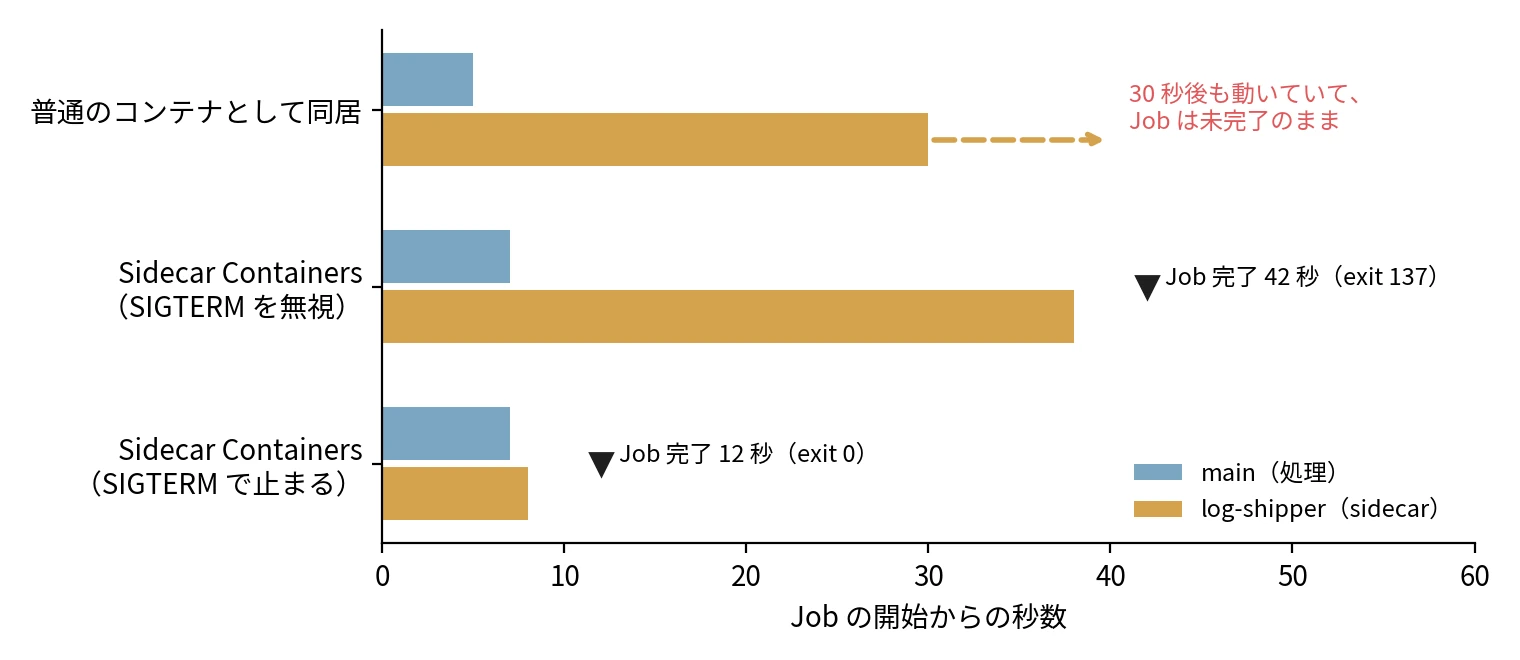
同じ Job を 3 通りの置き方で動かした時の、main と sidecar の終わり方
足したコンテナのように、主となるアプリケーションと同じ実行単位に置き、ログの転送や通信の仲介のような共通の機能を足す補助コンテナを Sidecar と呼びます。実行単位とは、同じマシンにまとめて置かれ、まとめて作られ消されるコンテナの集まりで、Kubernetes の Pod や Amazon ECS の Task です。
図の 2・3 段目の Sidecar Containers は、sidecar を扱うために Kubernetes に入った機能の名前で、2 段目と 3 段目の違いは、sidecar が停止の合図(SIGTERM)に従って止まるかどうかだけです。図の 1 段目の Job が終わらないのも、2 段目が 42 秒も掛かるのも、sidecar がいつ止まるかを誰が決めるのか、という問題です。
本記事では、sidecar をこれから足す人と、既存のシステムで sidecar に出会った人に向けて、次の疑問に答えます。
- 機能をライブラリや同じコンテナに入れず、なぜ別のコンテナに置くのか。
- 同じ Pod のコンテナは、何を共有し、何を分けるのか。
- sidecar を足した Job が終わらないのは、なぜか。
- Kubernetes の Sidecar Containers で、何が直り、何が残るのか。
- 起動の直後に、sidecar 経由の通信が失敗するのは、なぜか。
- sidecar をやめて、ノード(マシン)ごとに置く構成は、何を解決するのか。
実験には、kind(Docker の上で Kubernetes を動かすツール)で作った 1 台のクラスタを使いました。
機能を足す 4 つの置き場所
ログの転送のような共通の機能は、sidecar の他にも置き場所があります。以下は、Go・Java・Python で書いた 3 つのアプリケーションにログの転送を足す場合の比較です。
| 置き場所 | 実装の数 | 資源の上限 | 更新するもの | 動く数 |
|---|---|---|---|---|
| ライブラリ | 言語の数(3) | アプリと共有 | 各アプリ | アプリと同じ |
| 同じコンテナに同梱 | 1 | アプリと共有 | アプリのイメージ | アプリと同じ |
| sidecar | 1 | コンテナごと | sidecar のイメージ | Pod ごとに 1 つ |
| ノードごとに 1 つ | 1 | コンテナごと | そのコンテナだけ | ノードごとに 1 つ |
表の「同じコンテナに同梱」は、1 つのコンテナの中で 2 つのプロセスを動かす方式です。「ノードごとに 1 つ」は、マシン(Kubernetes ではノード)ごとに 1 つ置く方式で、Kubernetes では DaemonSet で置きます。資源の上限は CPU とメモリの上限で、sidecar のイメージを入れ替える時は、後の節で見るように Pod の作り直しが要ります。
sidecar の強みは「実装の数」と「資源の上限」の列です。実装は 1 つで済み、言語を問わず同じイメージを付けられます。資源の上限もコンテナごとに分かれるので、転送先が止まってログ転送のプロセスがメモリを使い切っても、メモリの上限を超えたプロセスは OOM Killer に止められますが、止められるのはログ転送のコンテナだけで、上限を共有していないアプリケーションまでは及びません。同梱の方式では、2 つのプロセスが 1 つの上限を分け合います。cgroup v2 で動く Kubernetes の既定では、上限を超えるとコンテナの中のプロセスがまとめて止められるので、原因はログの転送なのにアプリケーションも止まります。資源を用途ごとに区切って、1 つの用途の失敗を他に広げない考え方は、Bulkhead と同じです。
一方で、最後の列が弱みです。Pod を 100 個動かせば sidecar も 100 個動き、それぞれに確保しておく CPU とメモリの量(requests)を指定すれば、その枠が Pod の数だけ予約されます。この弱みは、後の節の「sidecar をやめる構成」につながります。
共有するものと分けるもの
余談: Sidecar という名前とパターン
Kubernetes の文脈では、Brendan Burns 氏が 2015 年 6 月に公開したブログ「The Distributed System ToolKit: Patterns for Composite Containers」が、よく見かける 3 つのパターンとして、メインのコンテナを拡張し強化する Sidecar、通信を仲介する Ambassador、出力の形を揃える Adapter を紹介しました。翌年の論文「Design Patterns for Container-based Distributed Systems」でも、同じ 3 つに分けています。sidecar という語自体は、それより前の 2014 年に Netflix が公開した Prana(「A Sidecar for your Netflix PaaS based Applications」)にも出てきます。今の Kubernetes の周辺では、通信を仲介するプロキシも含めて、同居する補助コンテナ全般を sidecar と呼ぶことが多く、本記事もその広い意味で使っています。
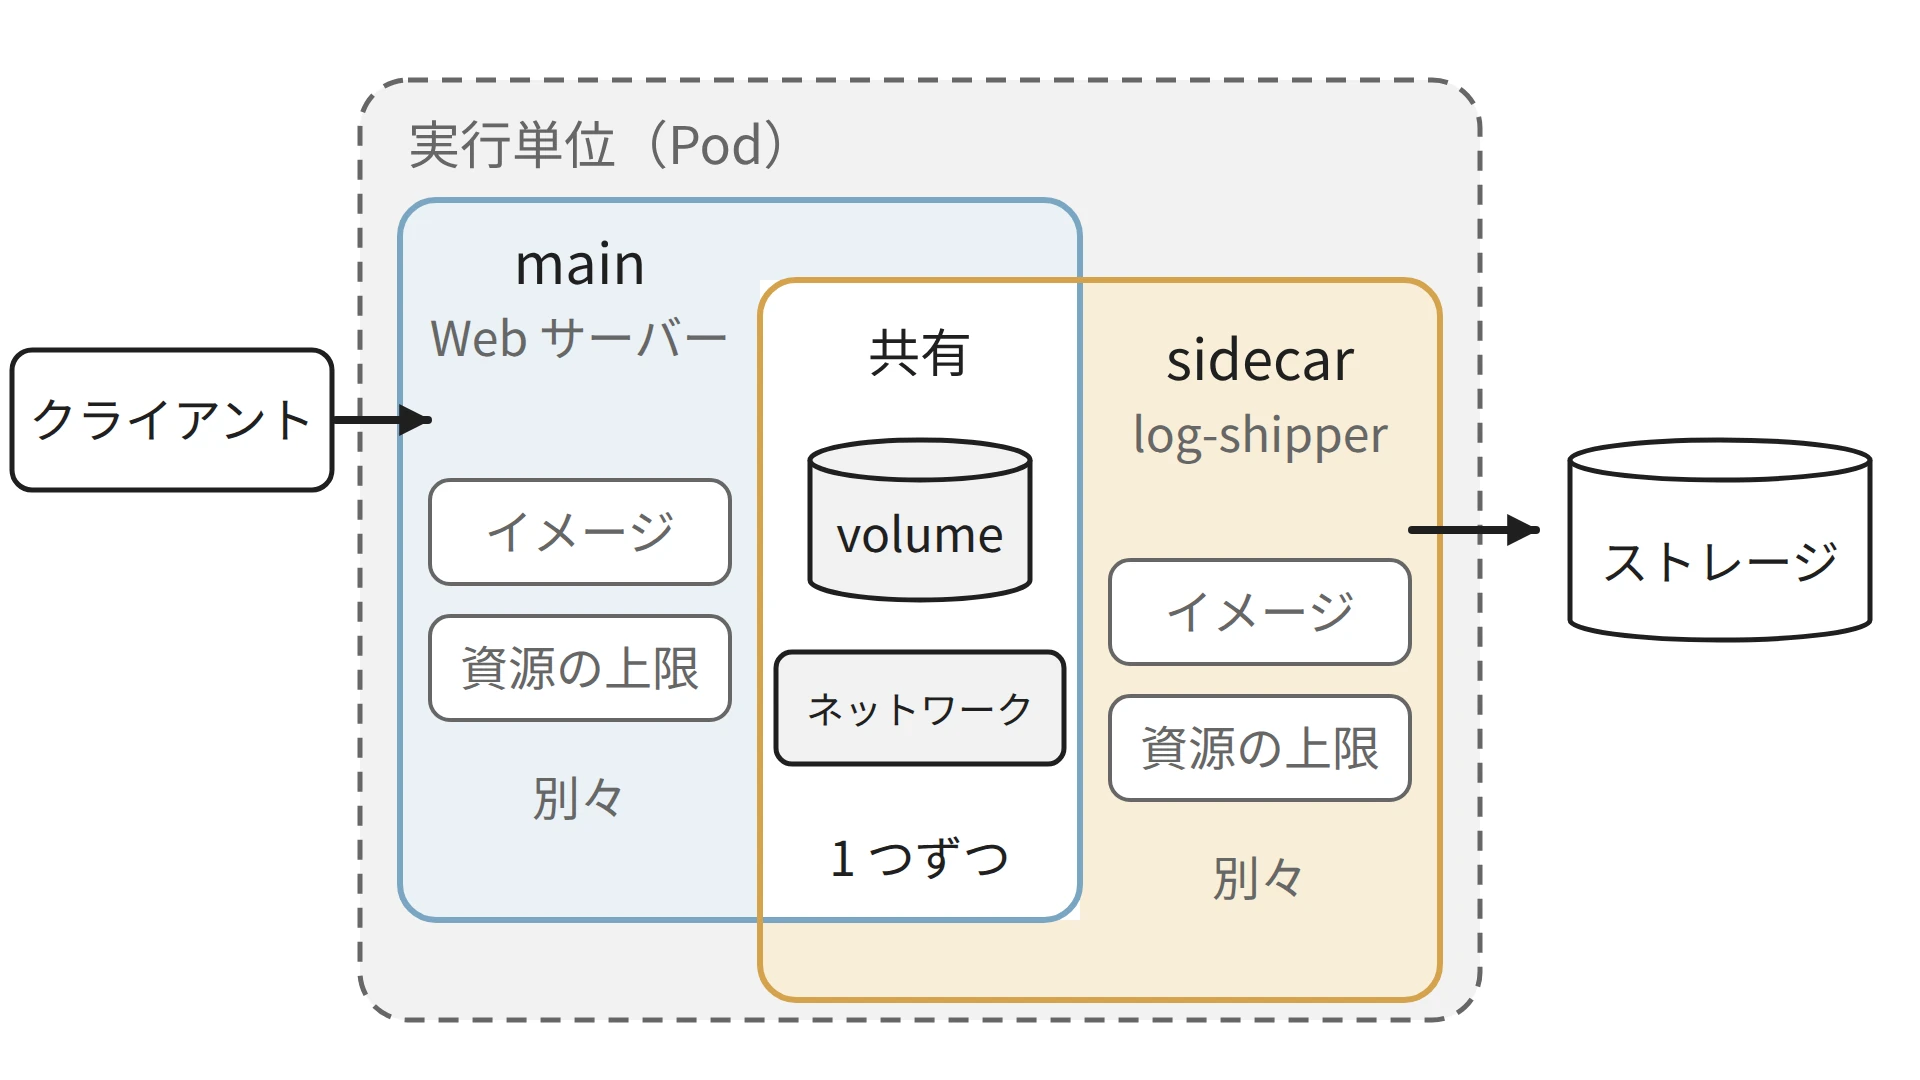
sidecar が隣のアプリケーションに機能を足せるのは、同じ Pod のコンテナが一部の資源を共有するからです。以下は、Web サーバーのログを転送する構成で、2 つのコンテナが共有するものと分けるものを描いた図です。
main と sidecar が共有するものと分けるもの
Kubernetes の Pod では、コンテナはネットワークを共有するので、互いを localhost の別のポートとして呼べます。ファイルは volume で共有します。volume は Pod に宣言するファイルの置き場で、双方のコンテナがマウントすれば同じ内容が見えます。Web サーバーはログをファイルに書くだけで、転送先も再試行も知りません。
イメージと資源の上限は、図のようにコンテナごとに分かれます。落ちたコンテナの再起動も、コンテナごとです。何をどこまで分けられるかは実行基盤ごとに違い、既定が分離とは限りません。Amazon ECS には、コンテナの停止を Task の全体に波及させるかを決める essential という設定があり、公式ドキュメントによると既定は true です。そのままでは sidecar が止まると Task ごと止まるので、切り離したい sidecar は明示的に false にします。
sidecar を足した Job が終わらない理由
冒頭の図の 1 段目は、次のマニフェストです。処理のコンテナ main は 5 秒で終わり、ログを送る想定の log-shipper は動き続けます。backoffLimit: 0 と restartPolicy: Never は、失敗しても再実行しない設定です。
apiVersion: batch/v1
kind: Job
metadata:
  name: job-plain
spec:
  backoffLimit: 0
  template:
    spec:
      restartPolicy: Never
      containers:
      - name: main
        image: busybox:1.37
        command: ["sh", "-c", "echo work; sleep 5; echo done"]
      - name: log-shipper
        image: busybox:1.37
        command: ["sh", "-c", "while true; do sleep 1; done"]
30 秒後に Job と Pod のコンテナを見ると、次の通りでした(出力は抜粋)。
succeeded:   active: 1  start: 2026-11-11T14:11:19Z
log-shipper: {"running":{"startedAt":"2026-11-11T14:11:19Z"}}
main: {"terminated":{"exitCode":0,"finishedAt":"2026-11-11T14:11:24Z","reason":"Completed",...}}
main は 5 秒で正常に終わっていますが、成功した Pod の数(succeeded)は空のままで、active が 1 です。Job が完了するのは Pod が成功で終わった時で、Pod は中のコンテナが全て終わるまで終わりません。log-shipper は main が終わったことを知らないので動き続け、Job はいつまでも終わりません。
この問題は、2016 年 5 月に Kubernetes の Issue として報告されました。当時の対処は、sidecar に main の終了を検知させ、自分で止まるように改造することでした。共有 volume に終了の印のファイルを置く、のような回避策です。
Sidecar Containers で直る所
Kubernetes の Sidecar Containers は、1.29 以降は既定で使え、1.33 で正式な機能になりました。initContainers は本来、main より前に順に動いて終わる準備用のコンテナを書く所です。そこに restartPolicy: Always を付けて置くと、終わらずに動き続ける sidecar として扱われます。Kubernetes は sidecar を main より先に起動し、main が終わったら sidecar を止めに行くので、sidecar が Pod の完了を妨げません。冒頭の図で main の棒が 7 秒まで伸びているのは、sidecar の起動を待つ分だけ遅れて始まるからです。先ほどのマニフェストとの違いは、log-shipper の置き場所だけです。
      initContainers:
      - name: log-shipper
        image: busybox:1.37
        restartPolicy: Always
        command: ["sh", "-c", "while true; do sleep 1; done"]
      containers:
      - name: main
        image: busybox:1.37
        command: ["sh", "-c", "echo work; sleep 5; echo done"]
この Job は完了しました。ただし、冒頭の図の 2 段目のように、完了までに 42 秒掛かりました。
succeeded: 1  start: 2026-11-11T14:11:49Z  completion: 2026-11-11T14:12:31Z
main: finished 2026-11-11T14:11:56Z exit 0
log-shipper: finished 2026-11-11T14:12:27Z exit 137
log-shipper が止まったのは main の約 30 秒後で、終了コード 137 は、128 にシグナルの番号 9 を足した値で、強制終了の SIGKILL で止められたことを表します。Job の完了が記録されたのは、さらに 4 秒後でした。Kubernetes は、main が止まった後に sidecar へ SIGTERM を送り、止まるのを待ちます。待つ長さは Pod の terminationGracePeriodSeconds で、既定は 30 秒です。docker stop が SIGTERM の後に 10 秒待って SIGKILL を送るのと同じ形です。
実験の log-shipper は、コンテナの最初のプロセス(PID 1)として動くシェルの無限ループです。PID 1 のプロセスは、自分で受け取る処理を書いていないシグナルを無視するので、SIGTERM を受けても止まらず、30 秒待たされた後に強制終了されました。
残る所: sidecar が止まり方を知っていること
SIGTERM を受けたら止まるように、trap を 1 行足しました。
command: ["sh", "-c", "trap 'echo got SIGTERM; exit 0' TERM; while true; do sleep 1; done"]
succeeded: 1  start: 2026-11-11T14:12:31Z  completion: 2026-11-11T14:12:43Z
main: finished 2026-11-11T14:12:38Z exit 0
log-shipper: finished 2026-11-11T14:12:39Z exit 0
log-shipper は main の 1 秒後に終了コード 0 で止まり、Job は冒頭の図の 3 段目のとおり 12 秒で完了しました。Sidecar Containers が決めるのは「いつ止めるか」で、「止まれるか」は sidecar 自身の作りに残ります。実際のログ転送のソフトウェアなら、SIGTERM を受けた時に、溜めたログを送り切ってから止まるかどうかも確認しておきたい所です。
起動の直後に通信が失敗する理由
止める時と同じく、起動する時にも、どちらが先かを決める者がいないと問題が起きます。普通のコンテナとして並べたコンテナは、隣が待ち受けの準備を終えたかを待たずに起動します。通信を仲介するプロキシを sidecar に置き、アプリケーションは localhost のプロキシ経由で外と話す構成では、プロキシが待ち受けを始める前にアプリケーションが接続すると失敗します。
実験では、main が起動するとすぐ localhost:8080 に接続し、プロキシ役のコンテナは待ち受けを始めるまで 3 秒掛かるようにしました。2 つを普通のコンテナとして並べると、次の通りでした。
main: restarts=2 ready=true
proxy: restarts=0 ready=true
-- main の直前(2 回目)の失敗のログ(--previous)
wget: can't connect to remote host (127.0.0.1): Connection refused
main は接続を拒否されて落ち、2 回再起動した後でやっと繋がりました。以下は、Pod の作成からの時刻で、この結果と、次に試す置き方を並べた図です。
プロキシの置き方ごとの、Pod の作成から接続まで(コンテナの開始と接続は実測、待ち受けの開始は sleep 3 から計算。2 倍速で再生)
プロキシは 1 秒後に起動し、マニフェストの sleep 3 の分を足すと 4 秒後には待ち受けていたはずです。それでも main が繋がったのは 17 秒後でした。失敗を繰り返したコンテナは、再起動の前に待たされるからです。この待ちを back-off と呼びます。外部サービスの障害でも自身の不具合でもなく、同じ Pod の隣のコンテナの起動が遅れただけで、アプリケーションの再起動の回数と起動の時間が増えます。監視では「起動直後にだけ時々落ちるアプリ」に見えます。
プロキシを Sidecar Containers として置き、待ち受けを始めたかを startupProbe の TCP の接続で確認するようにすると、次の通りでした。
  initContainers:
  - name: proxy
    image: busybox:1.37
    restartPolicy: Always
    command: ["sh", "-c", "sleep 3; mkdir -p /www; echo ok > /www/index.html; httpd -f -p 8080 -h /www"]
    startupProbe:
      tcpSocket:
        port: 8080
      periodSeconds: 1
      failureThreshold: 30
proxy: restarts=0 ready=true
main: restarts=0 ready=true
-- コンテナの開始時刻
pod created 2026-11-11T14:13:24Z
proxy started 2026-11-11T14:13:24Z
main started 2026-11-11T14:13:28Z
Kubernetes は、sidecar の startupProbe が通るまで main を起動せず、上の図の下の段のとおり、main はプロキシの 4 秒後に起動して、1 回目で繋がりました。止める時は向きが逆で、公式ドキュメントによると、main が止まってから sidecar を止めます。
他の実行基盤にも、同じことを宣言する手段があります。Amazon ECS では Task 定義の dependsOn に condition: HEALTHY を書き、補助コンテナに health check を設定しておくと、それが通るまでメインを起動させません。
service mesh は、サービス間の通信を各 Pod に置いたプロキシで仲介し、暗号化や計測をする仕組みです。その実装の 1 つの Istio には、プロキシが通信を受けられるまでアプリケーションの起動を待たせる holdApplicationUntilProxyStarts という設定がありますが、既定は false です。どの手段も無い実行基盤では、アプリケーションのコードに接続の再試行を書くことになり、その間隔は Retry and Backoff の考え方で決めます。
sidecar をやめる構成
sidecar の弱みは、最初の節の表の最後の列でした。Pod ごとに 1 つ動くので、Pod の数だけ資源を予約し、sidecar を入れ替えるには Pod を作り直す必要があります。以下は、プロキシを Pod ごとに置く場合と、ノードごとに 1 つ置く場合を並べた図です。
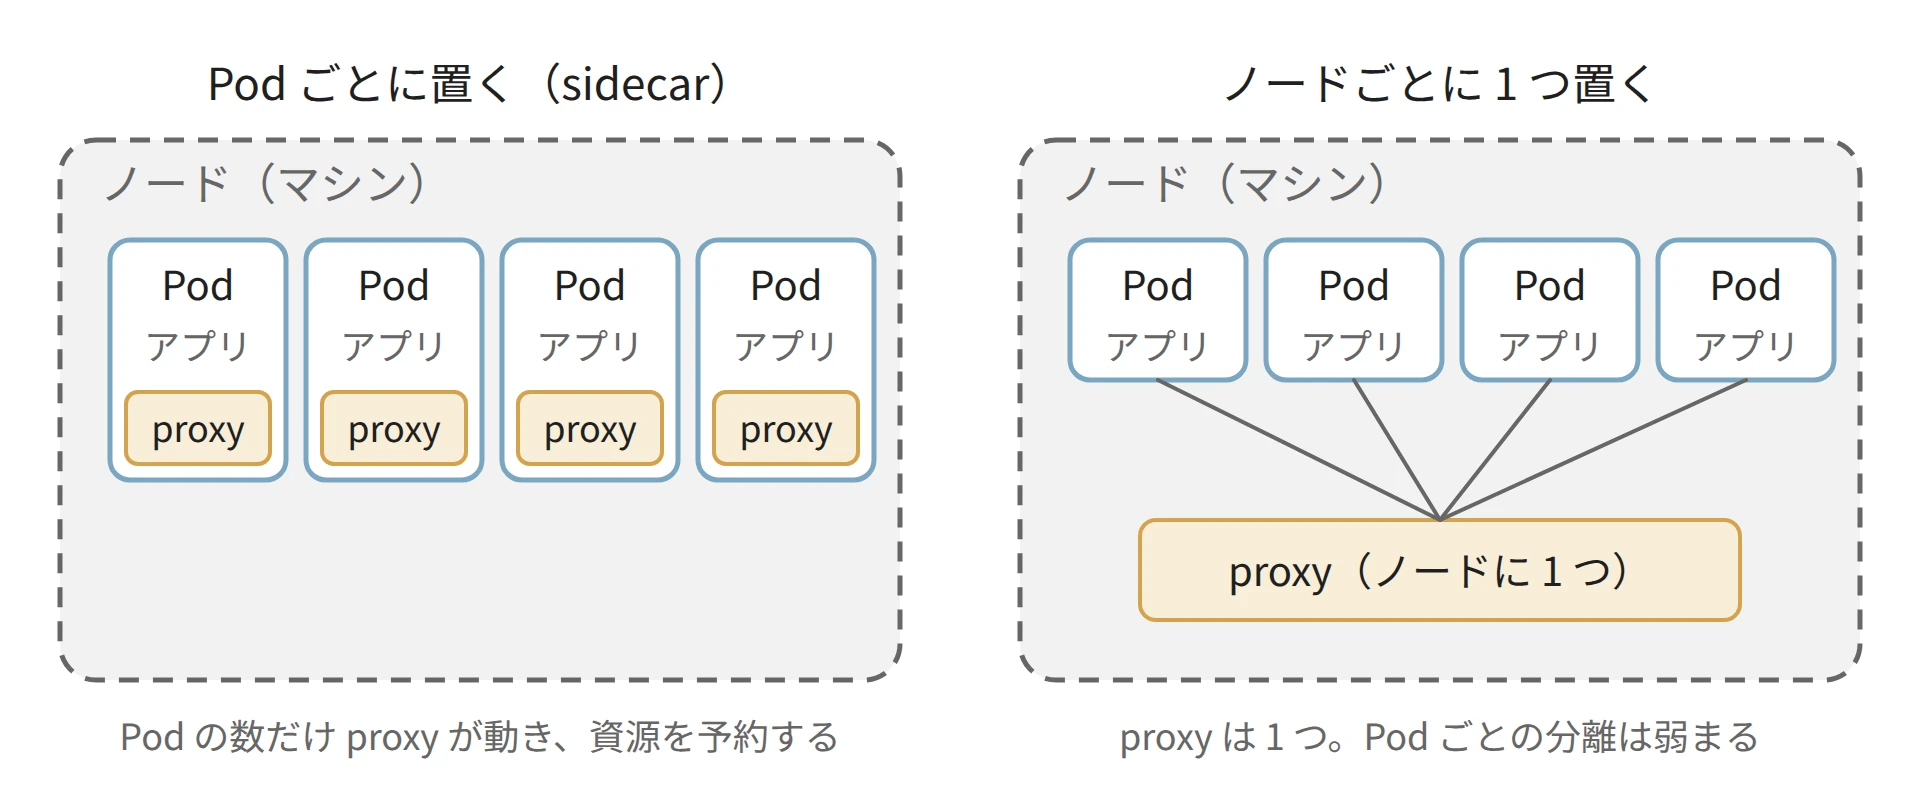
プロキシを Pod ごとに置く場合と、ノードごとに 1 つ置く場合
service mesh の Istio は、プロキシの Envoy を sidecar として全ての Pod に置く方式を長く使ってきました。2022 年 9 月に ambient mesh として発表した方式(今の名前は ambient mode)の発表の記事は、sidecar の限界として次の 3 つを挙げています。
- 入れる・更新するたびに、Pod を作り直す必要がある
- Pod ごとに最悪の負荷に合わせて予約するので、資源が余る
- 通信の捕捉と HTTP の処理が重く、規格外の通信を壊すことがある
3 つ目の通信の捕捉は、Pod の通信を横取りしてプロキシへ回すことです。HTTP の実装が規格に沿わないアプリケーションでは、プロキシが HTTP として解釈し直す所で通信が壊れることがあります。
ambient mode は、暗号化のような基本の処理をノードごとに 1 つのプロキシにまとめ、HTTP の処理が要る時だけ別のプロキシを通します。2 つの方式の違いは、Istio のデータプレーンの比較にまとまっています。ログの転送で DaemonSet を使うのも、同じ考え方です。どちらも、資源の上限と障害の範囲が Pod ごとに独立するという利点を一部手放して、数を減らしています。
sidecar を足す前に確認すること
sidecar をこれから足す人も、既に動いている sidecar に出会った人も、確認することは 4 つです。
Job やバッチのように終わる処理に足すなら、Kubernetes 1.29 以降では Sidecar Containers で、initContainers に restartPolicy: Always を付けて置きます。そのうえで、sidecar が SIGTERM を受けて止まるかを確認します。止まらなければ、Job は完了しても、終わるたびに 30 秒待たされます。
通信を仲介する sidecar なら、待ち受けを始めたことを startupProbe や dependsOn で実行基盤に伝えます。伝えないと、起動の直後にアプリケーションが落ち、再起動の回数として現れます。
sidecar が止まった時にアプリケーションも止めるべきかを決めます。ログの転送なら止めない方がよく、通信の仲介なら sidecar の停止は通信の停止そのものです。Amazon ECS では essential の既定が true なので、止めないなら明示します。
最後に、本当に全ての Pod に 1 つずつ要るのかを考えます。言語が 1 つで足したい機能も 1 つならライブラリの方が軽く、全 Pod に同じ処理を置くならノードごとに 1 つ置く方式も候補です。
実験のマニフェスト・実行用のスクリプト・出力の全体は lab/ にあります。