通販サイトで、商品ページの価格は新しいのに、商品一覧の価格だけが古いまま、という症状が起こり得ます。全ての商品ではなく 200 商品のうち数個だけで、再読み込みしても直らず、エラーのログも出ません。以下は、この症状を手元で再現した実験の結果です。一覧に価格を反映する処理を並行して進めるスレッド(worker)が 1 つの時は出ず、4 つにして 1 つのキューを共有させると毎回出ました。
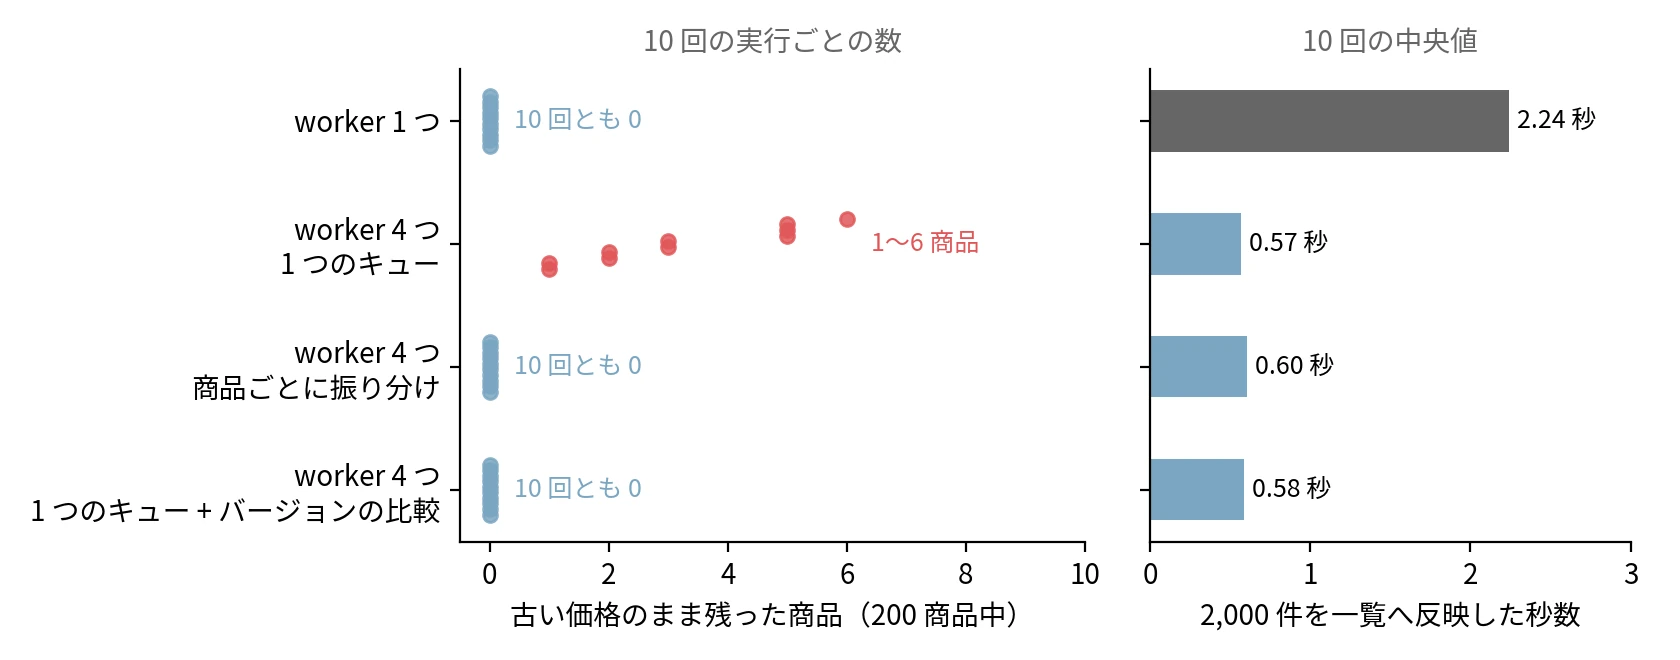
worker の置き方ごとの、古い価格のまま残った商品の数と、反映に掛かった時間
worker を 4 つにすると、2,000 件の価格変更を反映する時間は 2.24 秒から 0.57 秒に縮みました。その代わり、1 つのキューを共有した段では、10 回とも 1〜6 個の商品が古い価格のまま残りました。同じ 4 つでも、置き方を変えた下の 2 段は 0 個です。
商品ページと商品一覧が別々の表から価格を読んでいるのは、システムが CQRS(Command Query Responsibility Segregation)で作られているからです。CQRS は、データを書き換える処理と読む処理で、別々のモデルを持つ設計です。ここでのモデルは、要求を処理するコードと、それが前提にするデータ形式の組です。保存先の DB(データベース)とは別の話で、共有しても分けても構いません。書き換えの要求をコマンド、読む要求をクエリと呼びます。
書き込む側のモデルを書き込みモデル、読む側のモデルを読み取りモデルと呼びます。書き込みモデルで起きた変更から読み取りモデルを作る処理をプロジェクション(projection)と呼び、上の実験で増やした worker は、この処理を動かします。
本記事では、CQRS をこれから入れる人と、既存のシステムで出会った人に向けて、次の疑問に答えます。
- CQRS は何と何を分けるのか。
- read replica やキャッシュと何が違うのか。
- 保存した直後の一覧に、自分の変更が無いのはなぜか。
- 一部の商品だけが古い価格で止まるのはなぜか。
- 入れる前に何を決めておくのか。
実験は Python 3.14 と SQLite 3.46 を使い、手元の 1 台で動かしました。SQLite はファイル 1 つで動く DB です。
書き込みと読み取りでモデルを分ける
以下は、通販サイトで価格を変える処理と商品一覧を CQRS で分けた図です。利用者から見ると、コマンドの入口とクエリの入口が別々にあります。
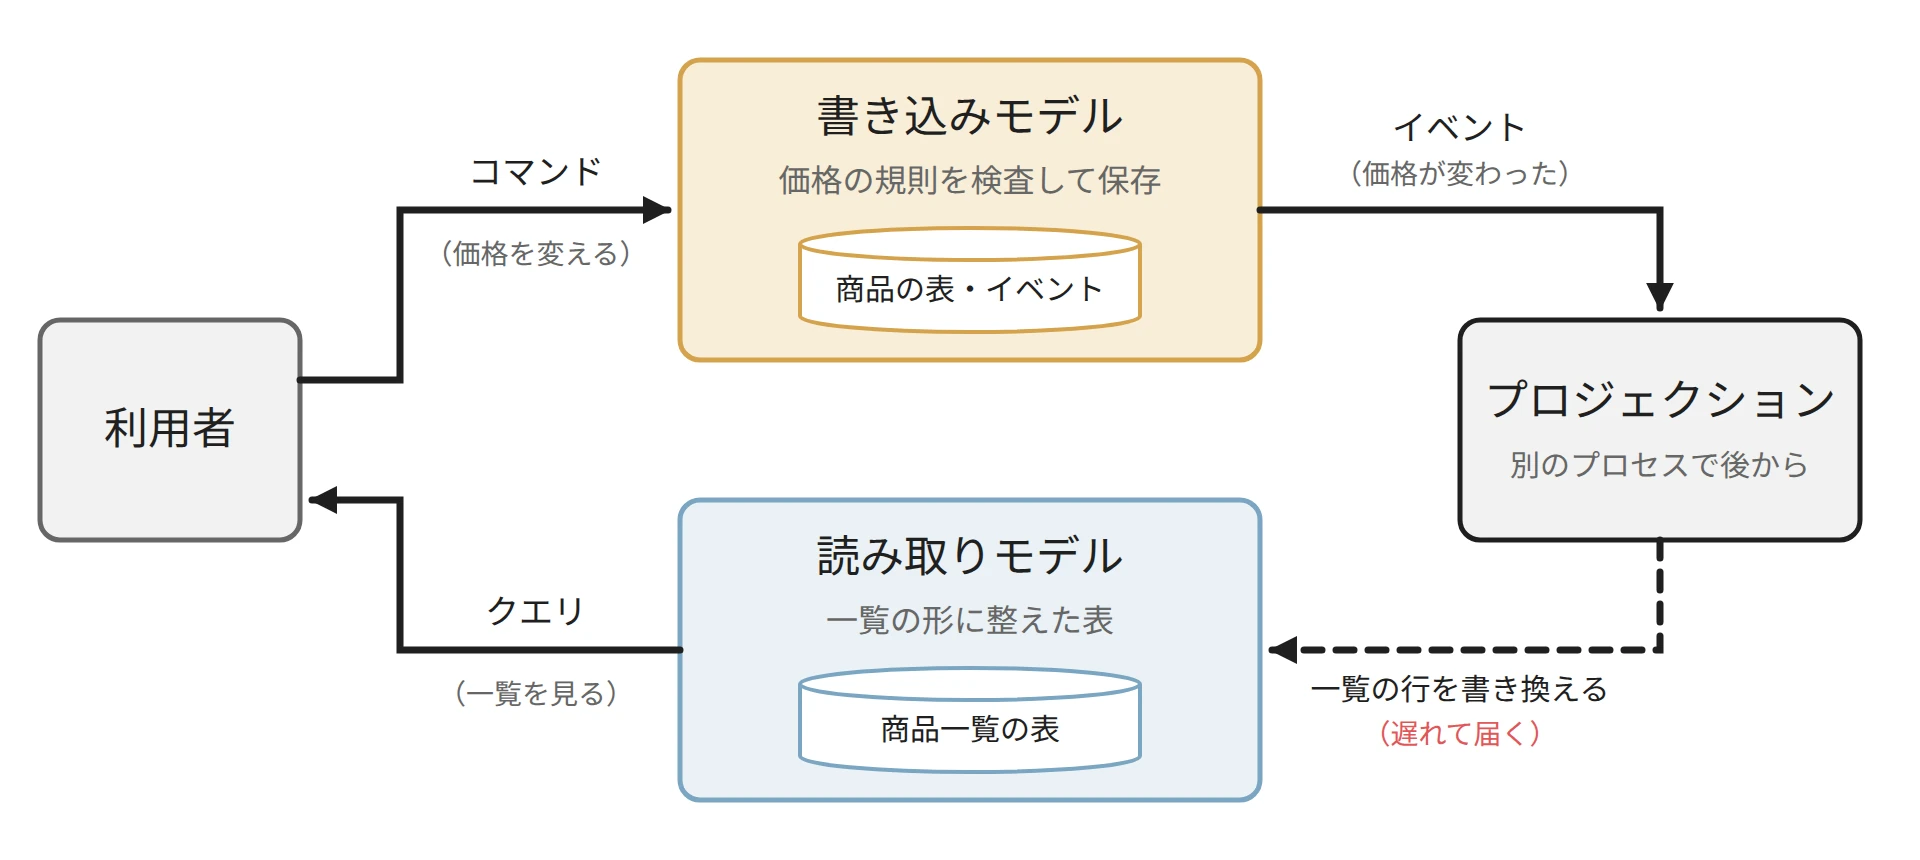
CQRS の書き込みモデル・プロジェクション・読み取りモデル
書き込みモデルは、価格を変えてよいかを決める規則を持ちます。例えば、原価を下回る価格を拒む、セール中は値上げを拒む、といった規則です。規則を一緒に守るオブジェクトのまとまりを Aggregate と呼び、書き込みモデルは Aggregate を単位に読み書きします。
商品一覧は、商品名・価格・在庫・レビューの平均点を 1 行に並べ、価格の順に並べ替えたり絞り込んだりします。規則は要らず、欲しいのは画面にそのまま出せる形です。1 つのモデルで両方に応えると、一覧のために Aggregate を何十個も組み立てるか、規則を通らずに表を直接読む経路が増えます。Repository のノートでは、Aggregate を通らずに一覧を返す照会の経路を扱いました。この経路を別のモデルとして正式に設計したものが CQRS の読み取りモデルです。
コマンドとクエリの役割
コマンドは成否だけを返し、変更後の画面に出す内容はクエリで読み取りモデルから取り直します。逆に、読み取りモデルのデータを直接書き換えて DB に戻すと、書き込みモデルの規則を通らない変更になります。一覧で選んだ商品の番号をコマンドに渡すのは構いませんが、状態を変える時は必ずコマンドとして書き込みモデルに送ります。
CQRS という名前の由来
コマンドとクエリという語は、Bertrand Meyer 氏が著書『Object-Oriented Software Construction』で示した Command Query Separation から来ています。Command Query Separation はメソッドごとに守る規則で、状態を変えるメソッドは値を返さず、値を返すメソッドは状態を変えない、というものです。
この区別をモデルの単位に広げたのが Greg Young 氏の CQRS で、考え方は 2010 年の CQRS Documents にまとまっています。CQRS Documents は、後で触れる Event Sourcing と組み合わせる理由に、複数の Aggregate をまたぐ検索を挙げています。
イベントから作る読み取りモデル
読み取りモデルは、書き込みモデルの変更を受けて作り直します。書き込みモデルは、価格が変わったという出来事をイベントとして残し、プロジェクションがそれを読んで一覧の行を書き換えます。
このイベントは Domain Event とも呼ばれ、起きた事実なので「価格が変わった」のように過去形で名付けます。イベントを確実に残す方法には Transactional Outbox があり、業務の変更と同じトランザクションで、送るイベントを表に書きます。イベントを書かずに、DB の変更を捕まえて外へ流す CDC(Change Data Capture)で読み取りモデルを作ることもできます。
イベントそのものを記録の本体にする Event Sourcing と組み合わせることも多いですが、CQRS にイベントの保存は必須ではありません。逆に Event Sourcing では現在の状態を保存しないので、複数の Aggregate をまたぐ検索に答えるには読み取りモデルが必要です。
read replica・materialized view・キャッシュとの違い
読む処理を書き込みから切り離す仕組みは、CQRS の他にもあります。以下は、商品一覧を速く読みたい場合の比較です。
| 仕組み | 読む側の形 | 反映する処理 | 遅れの元 |
|---|---|---|---|
| 同じ DB の view | 1 つの問い合わせの結果 | 無し(読む度に計算) | 無し |
| read replica | 書き込み側と同じ表 | DB の複製 | 複製の遅れ |
| materialized view | 1 つの問い合わせの結果 | DB の REFRESH | REFRESH の方式による |
| キャッシュ | 読んだ結果そのまま | アプリが読んだ時に保存 | 有効期限まで |
| CQRS の読み取りモデル | 画面ごとに自由 | アプリのコード | プロジェクションの処理 |
モデルを分けることと、保存先を分けることは別の判断です。1 行目の view は、書き込みモデルの表を SELECT の定義で一覧の形に見せるだけなので、反映する処理も遅れも要りません。その代わりに、読む度に結合と集計を計算し、その負荷は書き込みと同じ DB に載ります。
read replica は、DB の複製に読む処理を逃がす仕組みで、表の形は変わりません。複製の遅れは Leader and Followers で扱っています。Materialized View は、問い合わせの結果を DB が表として持ち、反映する処理を自分で書かずに済みます。PostgreSQL では REFRESH MATERIALIZED VIEW を実行するまで古い結果のままですが、Oracle の ON COMMIT のように、コミットの時に反映する DB もあります。
CQRS の読み取りモデルは、置き場所まで自由に選べます。一覧は全文検索のエンジンに、ランキングはキーと値を持つストアに、と画面ごとに選べます。その代わりに、反映する処理をアプリケーションで書き、遅れも順番も自分で面倒を見ることになります。表の形を変えずに読む負荷を逃がしたいだけなら、read replica か materialized view で足ります。
保存した直後の一覧に無い
プロジェクションが別のプロセスで後から動く以上、書いた直後の読み取りモデルには、まだその変更がありません。投稿したコメントが、直後に開いた一覧に無い、という形で見えます。このように、いずれ一致するものの、ある瞬間を切り取るとずれを許す性質を結果整合性(eventual consistency)と呼びます。
Martin Fowler 氏が 2011 年に書いた CQRS のページによると、別々のモデルを持つこと自体が、2 つのモデルをどれだけ厳密に一致させ続けるかという問いを生み、結果整合性を使う可能性を高めます。
価格の変更でも同じことが起きますが、書いた本人が気付きやすく数えやすいので、この節はコメントの一覧で測りました。
手元で、コメントを保存してから一覧を読むまでの時間を変えて、自分のコメントが一覧に無かった回数を数えました。プロジェクションは、0.5 秒ごとに新しいイベントをまとめて読み取りモデルに反映します。以下は実験の要となる関数で、コード全体は read_after_write.py にあります。
POLL = 0.5  # プロジェクションがイベントを読みに行く間隔(秒)


def projector(stop):
    con = connect()
    while not stop.is_set():
        pos = con.execute("SELECT pos FROM checkpoint").fetchone()[0]
        rows = con.execute("SELECT seq, body FROM events WHERE seq > ?", (pos,)).fetchall()
        if rows:
            con.execute("BEGIN")
            con.executemany("INSERT INTO comment_list VALUES (?, ?)", rows)
            con.execute("UPDATE checkpoint SET pos = ?", (rows[-1][0],))
            con.execute("COMMIT")
        time.sleep(POLL)


def post(con, body):  # 書き込み側: イベントを追記し、その位置(seq)を返す
    return con.execute("INSERT INTO events(body) VALUES (?)", (body,)).lastrowid


def list_comments(con, wait_for=None, timeout=2.0):  # 参照側
    start = time.monotonic()
    while wait_for is not None and time.monotonic() - start < timeout:
        if con.execute("SELECT pos FROM checkpoint").fetchone()[0] >= wait_for:
            break
        time.sleep(0.005)
    rows = con.execute("SELECT seq FROM comment_list").fetchall()
    return {r[0] for r in rows}, time.monotonic() - start
checkpoint の表は、プロジェクションがどのイベントまで反映したかを持ちます。保存はイベントの番号 seq を返し、list_comments に wait_for を渡すと、checkpoint がその番号に届くまで待ってから読みます。それぞれ 200 回試した結果が、次の通りです。
保存の 0ms 後に読む	載っていない 200/200
保存の 100ms 後に読む	載っていない 164/200
保存の 250ms 後に読む	載っていない 104/200
保存の 500ms 後に読む	載っていない 0/200
seq まで待って読む	載っていない 0/200	待ち時間 中央値 239ms 最大 499ms
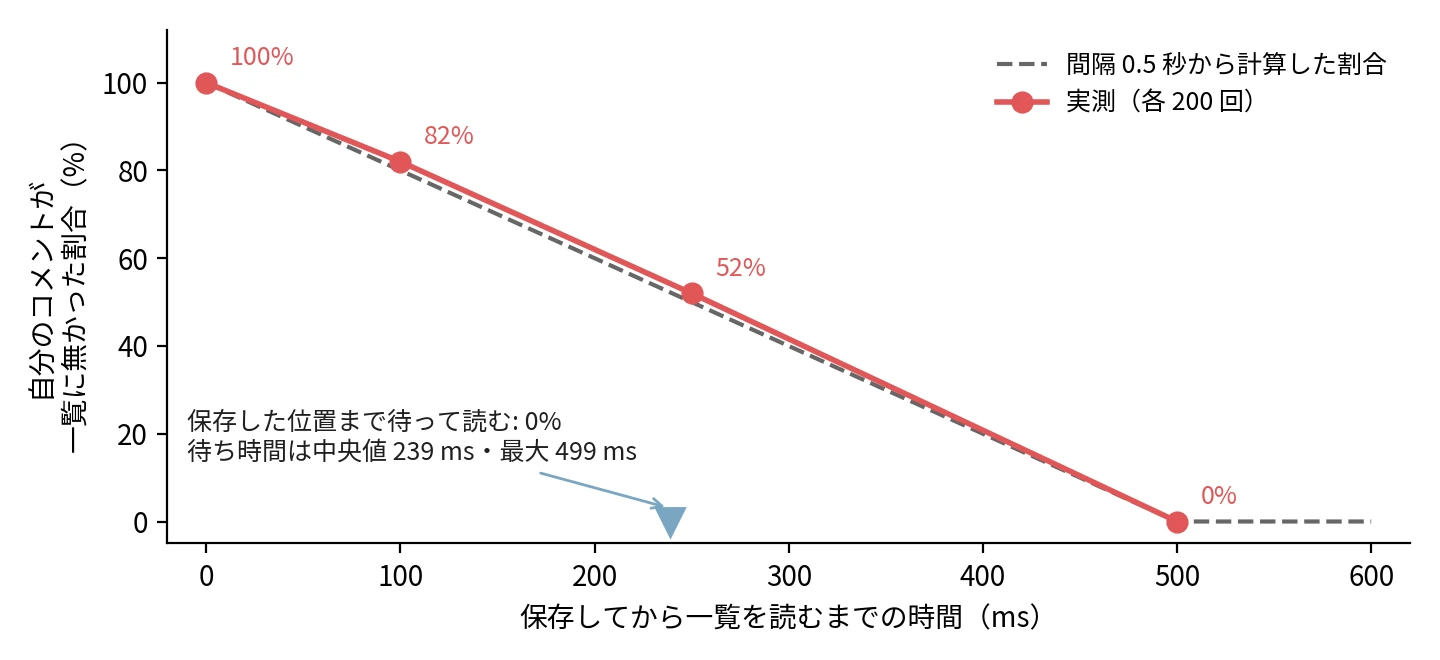
保存から一覧を読むまでの時間と、自分のコメントが無かった割合
無かった割合は、反映の間隔 0.5 秒から計算した直線にほぼ乗りました。保存の直後に読むと 200 回とも無く、間隔と同じ 0.5 秒待つと 200 回とも載っていました。保存で返した番号まで待ってから読めば毎回載りますが、その分だけ応答が遅れ、最大で間隔とほぼ同じ 499ms 待ちました。
反映の遅れが伸びた Netflix の例
Netflix のファン向けサイト Tudum は、CMS(Content Management System)の書き込み用の DB と、ページを返す読み取り用の DB を Kafka でつなぐ CQRS の構成でした。
Netflix が 2025 年 7 月に公開した技術ブログによると、遅れの元は、読み取り用 DB の手前に置いたキャッシュでした。キャッシュは裏でキーを 1 つずつ作り直す作りで、60 個のキーを 60 秒の間隔で作り直すなら、1 秒に 1 キーしか新しくなりません。
コンテンツが増えるほど作り直しの一巡が長くなり、編集者が書いた変更をプレビューで見るまでの時間が伸びました。Netflix は Kafka と読み取り用の DB を外し、データをメモリに持つ自社の RAW Hollow に置き換え、ブログによると、プレビューまでの時間は分の単位から秒の単位に縮みました。上の実験で 0.5 秒の間隔が待ち時間になったのと同じく、反映する処理の作りが、そのまま書いた人の待ち時間になった例です。
書いた人に見せる方法
全ての画面で遅れを消す必要はありません。多くの場合に困るのは、書いた本人が直後に見る画面だけです。実験の wait_for のように、コマンドの応答で返した位置まで読み取りモデルが進むのを待つ方法の他に、本人が保存の直後に見る表示だけは書き込みモデルから読む方法や、送信した内容を画面側でそのまま一覧に足しておく方法があります。
MediaWiki は、書き込みを受け付ける primary の DB と、読み取りの大半を返す複製を分けていて、編集した本人の投稿履歴に、保存した編集がすぐには出ないことがあります。ChronologyProtector は、書き込んだ要求の終わりに primary の位置を記録し、約 10 秒以内に同じ利用者から来た要求では、複製がその位置に追い付くまで最大で数秒待ちます。追い付かなければ待つのを打ち切り、古い値を返します。実験の wait_for と同じ考え方で、read replica の遅れを扱う例です。
どれを選ぶにしても、画面ごとに許せる遅れを先に決めておくと、後から「保存したのに無い」という問い合わせに答えられます。
一部の商品だけ古い価格で止まる
冒頭の症状に戻ります。実験では、200 商品の価格を 10 回ずつ変え、2,000 件のイベントを書き込み側に追記しました。プロジェクションは、イベントを追記した順に取り出してキューに入れ、worker がキューから取って一覧の表 price_view を書き換えます。以下は要となる関数で、コード全体は projector.py にあります。
def apply(q, guard, seed, worker, t0):
    con = sqlite3.connect(DB, isolation_level=None, timeout=30)
    con.execute("PRAGMA synchronous=OFF")  # 実験を速くするため、ディスクへの同期を省く
    rng = random.Random(seed)
    sql = "UPDATE price_view SET version = ?, price = ? WHERE product_id = ?"
    if guard:
        sql += " AND version < ?"  # 自分より新しいバージョンが入っていれば書かない
    while (ev := q.get()) is not None:
        p, v, price = ev
        got = time.monotonic() - t0
        time.sleep(rng.uniform(0, 0.002))  # 画面用の整形などに掛かる時間
        con.execute(sql, (v, price, p, v) if guard else (v, price, p))
        with lock:
            applied[0] += 1
            trace.append((p, v, worker, got, time.monotonic() - t0))


def project(con, workers, route, guard, seed):
    events = con.execute("SELECT product_id, version, price FROM events ORDER BY seq").fetchall()
    shared = queue.Queue()
    qs = [shared] * workers if route == "shared" else [queue.Queue() for _ in range(workers)]
    # ...(worker のスレッドを起動する)
    for p, v, price in events:  # イベントは seq の順に配る
        qs[0 if route == "shared" else p % workers].put((p, v, price))
    # ...(終了の印を入れて、全ての worker を待つ)
    assert applied[0] == len(events)  # 取りこぼしたイベントは無い
各イベントは、商品ごとに 1 から 10 まで増えるバージョンを持ちます。worker は書き込む前に 0〜2ms 眠り、画面用の整形のような処理の時間を模しています。route が "shared" なら 4 つの worker が 1 つのキューを取り合い、"partition" なら商品の番号を worker の数で割った余りで振り分けます。guard は、後で使う直し方です。
以下は、worker 4 つで 1 つのキューを共有した 10 回のうち、最初の 3 回の出力です。右端の列は、古いバージョンを後から書いた回数です。
4 つで 1 つのキュー	seed=0	0.58 秒	古い値の商品 1/200	順番の逆転 15 回
4 つで 1 つのキュー	seed=1	0.57 秒	古い値の商品 6/200	順番の逆転 21 回
4 つで 1 つのキュー	seed=2	0.56 秒	古い値の商品 5/200	順番の逆転 13 回
遅れでも取りこぼしでもない
古い価格が残る原因として、最初に思い付くのは、前の節で測った遅れです。しかし、この実験ではプロジェクションが全てのイベントを処理し終えた後に数えていて、1 秒足らずで処理を終えた後の表に古い価格が残っています。待っても直らないのは、反映する処理がもう何もしていないからです。
次に疑うのは、イベントの取りこぼしです。project の最後にある assert は、worker が処理したイベントの数が 2,000 件と一致することを見ていて、10 回とも通りました。全てのイベントが一覧の表に書かれていて、それでも価格が古いということは、書かれた順番が違うということです。
書いた順番の逆転
以下は、seed=0 の実行で古い価格のまま残った商品 170 について、最後に来た 4 つの変更が一覧の表に書かれるまでを実測した時刻で動かした図です。
商品 170 で最後に来た 4 つの変更が一覧の表に書かれる順(実測した時刻を実時間より 2500 倍ゆっくり再生)
キューから取り出す順番は追記の順のままで、バージョン 9 はバージョン 10 より先に worker 3 が受け取っています。ところが、worker 3 の整形はバージョン 10 を受け取った worker 0 より長く掛かり、バージョン 10 を書いた 1.1ms 後にバージョン 9 で上書きしました。UPDATE は今の値が何であれ書き換えるので、一覧の表には最後に書かれたバージョン 9 が残ります。
出力で右端の列に数えた逆転は 1 回の実行で 11〜21 回起きていますが、古い価格が残ったのは 1〜6 商品でした。途中の逆転は、同じ商品に次の変更が来ると上書きされて消えるからです。図の商品 170 でも、バージョン 6 はバージョン 7 の後に書かれましたが、バージョン 8 が上書きしています。
残るのは最後の変更より古い変更が後から書かれた時だけで、次にその商品の価格が変わるまで直りません。
順番を保つ 2 つの方法
直し方は、冒頭の図で下にある 2 段です。1 つ目は、同じ商品のイベントを同じ worker に振り分けることです。worker の中では受け取った順に書くので、同じ商品に来た変更は順番が入れ替わりません。
Kafka は、イベントをパーティションという複数の列に分けて持ち、同じキーを持つイベントを同じパーティションに書きます。1 つのパーティションのイベントは、書いた順に読めることを保証しています。商品の番号をキーにすれば同じ形になります。
Kafka で振り分けても順番が入れ替わる場合
1 つのパーティションを読む側(consumer)が中でスレッドを増やすと、実験の 1 つのキューと同じ形に戻ります。イベントを DB から Kafka へ送る処理を増やした時にも、同じ注文に属するイベントの順番が入れ替わり得ます。その測定と、振り分けによる同じ直し方は、Transactional Outbox のノートにあります。
2 つ目は、書く前にバージョンを比べることです。guard を有効にすると、worker は次の UPDATE を使います。
UPDATE price_view SET version = ?, price = ?
 WHERE product_id = ? AND version < ?
最後の条件により、一覧の表に新しいバージョンが既に入っていれば何も書きません。この置き方でも逆転は 10〜17 回起きていましたが、古いバージョンの書き込みは 1 行も更新せずに終わり、残った商品は 10 回とも 0 でした。同じイベントが 2 回届いても結果が変わらないので、イベントが重複して届くことへの備えにもなります。重複への備えは Idempotency のノートで扱っています。
どちらも、worker 1 つの 2.24 秒に対して 0.6 秒前後で、worker 4 つの速さは保っています。振り分けは、特定の商品に変更が集中するとその worker だけが詰まります。バージョンの比較は、イベントにバージョンを持たせ、読み取りモデルにもそれを保存しておく必要があります。
CQRS を入れる前に決めること
CQRS は、多くのシステムでは、複雑さが増えて危険になる設計でもあります。先に挙げた Fowler 氏のページによると、氏が出会った事例の大半は良い結果にならず、CQRS はシステムを深刻な困難に追い込んだ大きな要因と見なされていました。
使いどころに挙がっているのは、一部の複雑なドメインと、読み書きの負荷を分けて別々に増やしたい高性能なアプリケーションの 2 つです。使うならシステムの全体ではなく、Bounded Context のような特定の部分に限るべきだ、というのが Fowler 氏の注意です。
これから入れるなら、まず読み取りモデルの形が書き込みモデルと本当に違うかを考えます。同じ形で読むだけなら、read replica か materialized view で足ります。分けるのは、形と規則が大きく違う一部に限ります。注文は CQRS、会員情報は CRUD(Create / Read / Update / Delete)の 1 つのモデル、と分けて構いません。同じ情報を 2 つのモデルが別の形で持つので、一覧に出す項目を 1 つ足すなら、最大で、書き込みモデル・イベント・プロジェクション・読み取りモデルの 4 か所を直すことになります。
分けると決めたら、画面ごとに許せる遅れと、書いた本人に何を見せるかを決めます。本人の画面は、書き込みモデルから読むか、保存の応答で返した位置まで待つかを選びます。
プロジェクションの worker を増やす時は、同じ商品に来た変更が順番を入れ替えない仕組みを先に入れます。商品の番号で振り分けるか、バージョンを比べてから書くかのどちらかです。
一部の行だけ古いと気付いたら
既存のシステムで CQRS の読み取りモデルに出会い、一部の行だけが古いまま直らないなら、待つ前に、その行のバージョンと書き込みモデルのバージョンを並べてみてください。読み取り側の方が小さく、そのバージョンより新しいイベントが既に処理済みなら、遅れより先に、冒頭の図で 2 段目に起きた順番の入れ替わりを疑います。
実験のコードと出力の全体は lab/ にあります。