Bulkhead(隔壁)は、スレッドや接続のような限られた資源を用途ごとに区切り、1 つの用途が資源を使い切っても、他の用途の分が残るようにするパターンです。名前は船の隔壁から来ています。船体を区画に仕切っておけば、穴の開いた区画だけが浸水し、船全体は沈みません。Microsoft の設計パターンの解説も、この船の例で説明しています。
ソフトウェアで区切る対象は、多くの場合、呼び出し側のサーバーが持つスレッドや接続です。以下は、スレッド 40 本を持つサーバーで、呼び出し先の 1 つが応答しなくなって 15 秒後のスレッドの使われ方を描いた図です。数値は、後で説明するシミュレーションの値です。
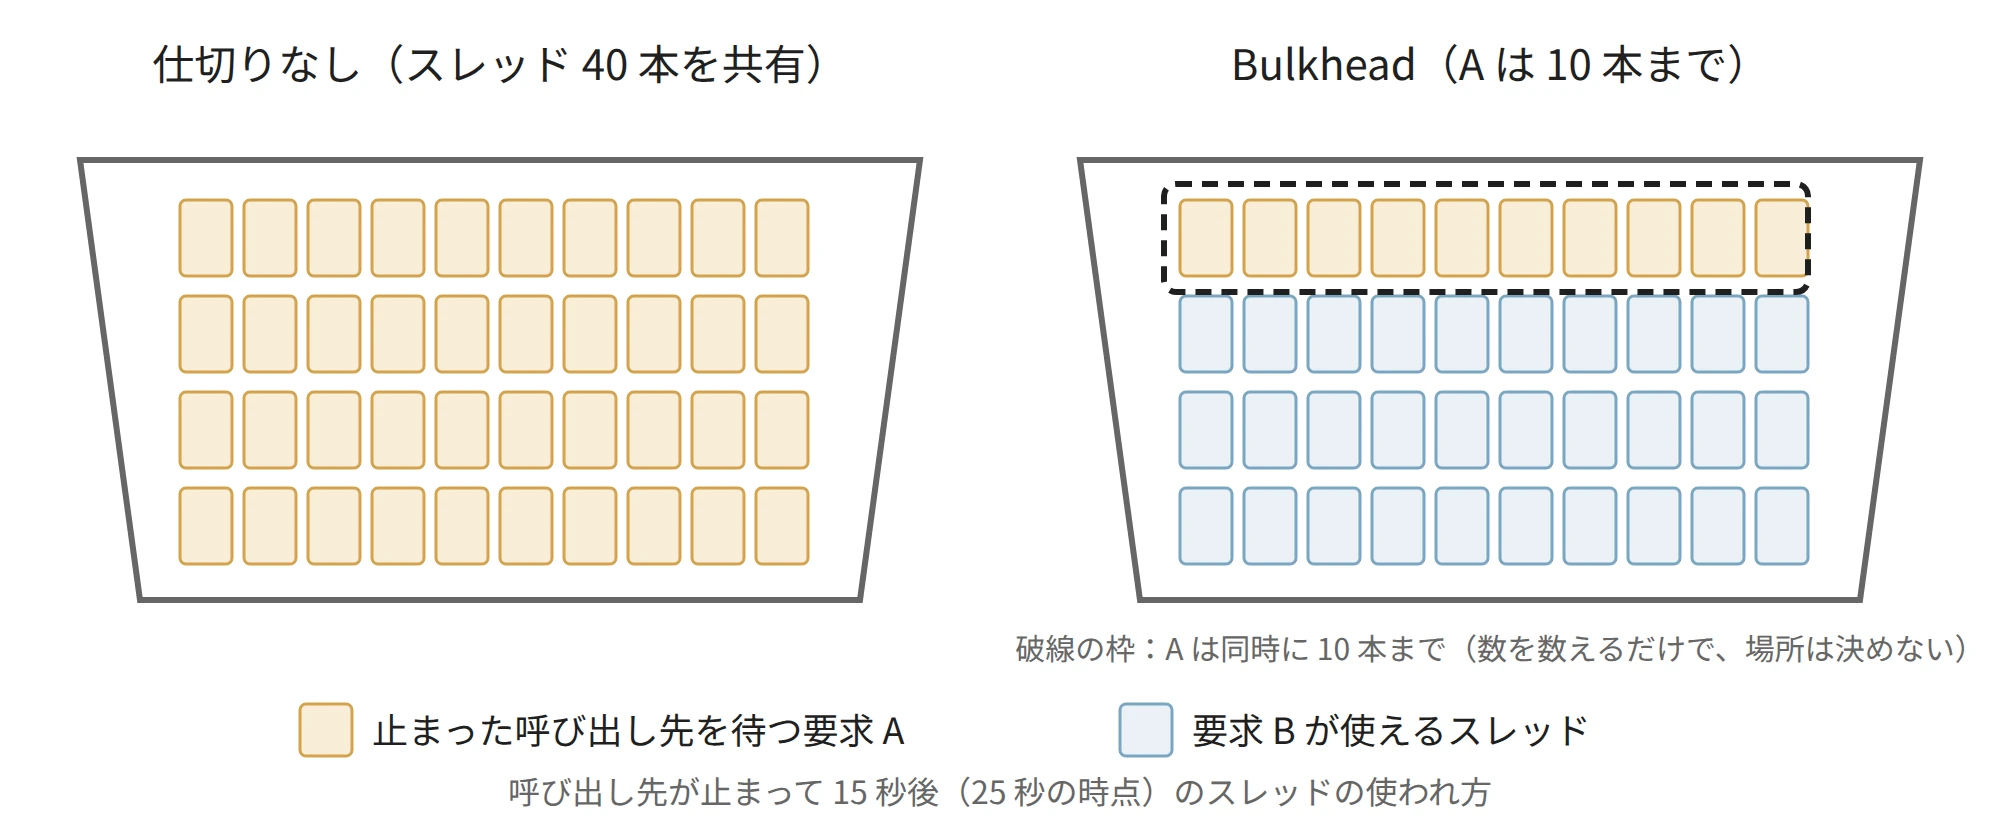
呼び出し先が止まって 15 秒後のスレッドの使われ方
仕切りが無いと、止まった呼び出し先を待つ要求がスレッドを埋め、その呼び出し先とは関係の無い要求まで処理できなくなります。A が同時に使える本数を 10 本までに区切ると、A が待たされても、残りの 30 本は B が使えます。
本記事では、Circuit Breaker のノートと同じ条件のシミュレーションで、Bulkhead が何を守り、何を守らないのかを説明します。扱う疑問は次の通りです。
- 呼び出し先の 1 つが止まると、なぜ関係の無い要求まで失敗するのか。
- 隔壁で区切ると、何がどれだけ変わるのか。
- 区画の大きさは、何から決めるのか。
- Circuit Breaker や timeout(待つ時間の上限)とは、どう役割を分けるのか。
- 区切る単位には、どんな種類があるのか。
1 つの呼び出し先の停止が広がる理由
例として、注文を受け付けるサーバーを考えます。要求には 2 種類あり、要求 A は在庫サービスを呼び、要求 B は在庫サービスを呼ばずに自分だけで答えます。どちらも、サーバーが持つ 40 本のスレッドの 1 本を借りて処理します。空いているスレッドが無い時に届いた要求は、すぐに断ります(503 を返す想定)。
在庫サービスが応答しなくなると、要求 A はスレッドを掴んだまま応答を待ちます。待つのは、呼び出し側で打ち切る時間(timeout)の 2 秒です。在庫サービスを呼ぶ要求が毎秒 50 件届けば、待っている A の数は平均で「毎秒 50 件 × 2 秒 = 100 本」に向かって増えます(待ち行列の理論で Little の法則 と呼ばれる関係)。スレッドは 40 本しかないので、すぐに全てが A で埋まります。
そうなると、在庫サービスを呼ばない B も、借りるスレッドが無いので断られます。在庫サービスの停止が、在庫サービスを使わない機能の停止に広がるわけです。障害が呼び出しの連鎖で広がることを、カスケード障害(cascading failure)と呼びます。
30 秒止まる呼び出し先のシミュレーション
Bulkhead の効果は、Python の標準ライブラリだけで書いた 1 ミリ秒刻みのシミュレーションで確かめます。条件は Circuit Breaker のノートと同じで、ネットワークは使いません。
- サーバーはスレッド 40 本を持ち、空きが無い時に届いた要求はすぐに断る
- 要求 A は在庫サービスを呼び、要求 B は呼ばずに 5 ms で終わる。どちらも平均毎秒 50 件で、到着の間隔はランダム(ポアソン到着。乱数の種は固定)
- 在庫サービスは通常 50 ms で応答し、10 秒から 40 秒までは応答を返さない。呼び出し側は 2 秒で打ち切る
Bulkhead は、A が同時に使えるスレッドの上限(a_limit)として入れます。上限に達している時に届いた A は、スレッドが余っていても、待たずにすぐ断ります。以下は、シミュレーションの本体です。1 ミリ秒ごとに、(1) 応答が返ってきた呼び出しのスレッドを返し、(2) 届いた要求を受け付けるか断り(隔壁は a_limit の条件の 1 行)、(3) 1 秒ごとに使用中のスレッドの数を記録します(到着の列を作る arrivals() と、結果を表示する部分は lab/sim.py にあります)。
END, OUTAGE = 60_000, (10_000, 40_000)  # milliseconds
POOL, TIMEOUT, LATENCY, LOCAL = 40, 2_000, 50, 5


def run(a_limit=None, outage=OUTAGE):
    """a_limit: max threads A may hold at once (None = no bulkhead)."""
    events, seq = [], 0
    busy = {"A": 0, "B": 0}
    st = {"a_ok": 0, "a_timeout": 0, "a_rejected": 0,
          "a_rejected_normal": 0, "a_normal": 0,
          "b_ok": [0] * 60, "b_rejected": [0] * 60, "busy_a": [0] * 60, "busy_b": [0] * 60}
    for now in range(END):
        while events and events[0][0] == now:
            _, _, kind, ok = heapq.heappop(events)
            busy[kind] -= 1
            if kind == "B":
                st["b_ok"][now // 1000] += 1
            else:
                st["a_ok" if ok else "a_timeout"] += 1
        for kind in arrivals_cache.get(now, []):
            in_outage = outage[0] <= now < outage[1]
            # normal: before the outage, or after the last timed-out call has returned
            normal = now < outage[0] or now >= outage[1] + TIMEOUT
            if kind == "A" and normal:
                st["a_normal"] += 1
            full = busy["A"] + busy["B"] >= POOL
            if kind == "A":
                if full or (a_limit is not None and busy["A"] >= a_limit):
                    st["a_rejected"] += 1
                    if normal:
                        st["a_rejected_normal"] += 1
                    continue
                busy["A"] += 1
                ok = not in_outage  # the outage never answers
                seq += 1
                heapq.heappush(events, (now + (LATENCY if ok else TIMEOUT), seq, "A", ok))
            else:
                if full:
                    st["b_rejected"][now // 1000] += 1
                    continue
                busy["B"] += 1
                seq += 1
                heapq.heappush(events, (now + LOCAL, seq, "B", True))
        if now % 1000 == 999:
            st["busy_a"][now // 1000] = busy["A"]
            st["busy_b"][now // 1000] = busy["B"]
    return st


arrivals_cache = arrivals()  # the same arrivals for every run (Poisson, seed 1)
実際のサーバーなら、A の処理の入口でセマフォ(同時に通れる数を数える仕組み)を取り、取れなければ断る、という形になります。
結果は次の通りでした。
shared 40          B ok during outage  39.5%  B ok 2108  B rejected 968  A ok 1494  A timeout 600  A rejected 972  busy A at 20s 33
bulkhead A<=10     B ok during outage 100.0%  B ok 3076  B rejected 0  A ok 1499  A timeout 150  A rejected 1417  busy A at 20s 10
shared 40 が仕切りなし、bulkhead A<=10 が A を 10 本までにした場合です。在庫サービスが止まっている 10〜40 秒に届いた B のうち、仕切りなしでは 39.5% しか処理できず、948 件を断りました(出力の B rejected 968 は、停止が明けた直後の 20 件を含む 60 秒全体の数です)。上限を置くと、B は 1 件も断られませんでした。以下は、1 秒ごとの B の処理できた割合と、A が使っているスレッドの数です。
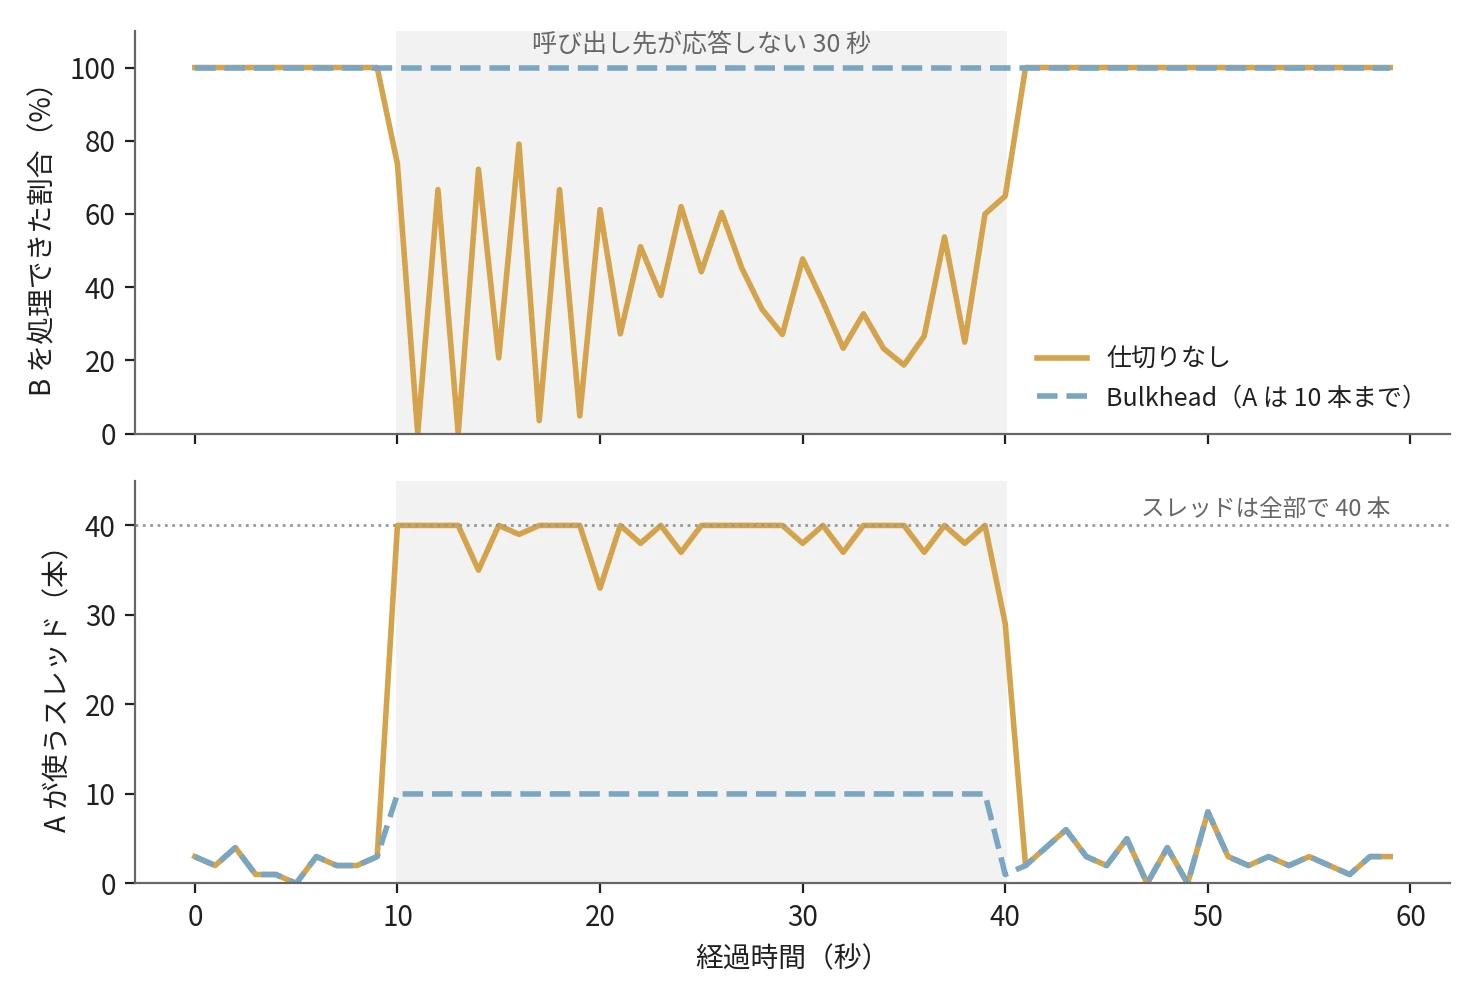
在庫サービスが止まった時の、B の処理と A のスレッド(1 秒ごと)
下のグラフで、仕切りなしの A は停止の直後から 40 本近くを埋めています。Bulkhead の A は 10 本で止まり、残りの 30 本は B のために空いています。
上のグラフで、仕切りなしの B が 1 秒ごとに大きく上下するのは、A が 2 秒の周期でスレッドを埋めるからです。停止の直後に 40 本が一斉に埋まり、2 秒後の timeout で一斉に空き、空いた所にまた A が入ります。空いた直後の短い間だけ、B が入れます。到着の間隔はランダムなので、時間が経つと A の揃いが少しずつ崩れ、上下の幅は小さくなります。
隔壁は A を救わない
上の結果で、B は守られましたが、A は守られていません。停止中の A は、仕切りなしでも Bulkhead でも全て失敗しています。違うのは失敗の仕方です。
| A の timeout | A の拒否 | |
|---|---|---|
| 仕切りなし | 600 件 | 972 件 |
| Bulkhead(A は 10 本まで) | 150 件 | 1,417 件 |
Bulkhead では、A の多くは区画が埋まっているのですぐに断られ、2 秒待たされた末の timeout は 150 件に減りました。区画の 10 本が 2 秒ずつ埋まるので、毎秒 5 件、30 秒で 150 件だけが在庫サービスを待ったことになります。仕切りなしの 600 件も同じ計算で、40 本が 2 秒ずつ埋まり、毎秒 20 件、30 秒で 600 件です。利用者から見ると、A は 2 秒待たされる代わりにすぐエラーになります。
それでも、10 本のスレッドは 30 秒間ずっと、応答しない在庫サービスを待ち続けています。この 10 本と、待たせる 2 秒を無くすのは、Bulkhead ではなく Circuit Breaker の役割です。失敗が続いた呼び出し先をしばらく呼ばずに、すぐ失敗させます(呼ばない状態を Open と呼びます)。2 つを組み合わせると、失敗を数えて Open になるまでの間に使い切るスレッドの数を Bulkhead が抑え、Open になった後は Circuit Breaker が待ち時間を無くします。
timeout は、1 回の呼び出しが 1 本のスレッドを掴む時間の上限です。上の計算の通り、待っている A の数は「到着率 × timeout」で決まるので、timeout を短くすれば区画が埋まりにくくなります。ただし、短くしすぎると、遅いだけで正常な応答まで打ち切ります。Bulkhead は本数を、timeout は 1 本あたりの時間を、Circuit Breaker は呼ぶかどうかを制限する、という分担です。
区画の大きさの決め方
A の上限を小さくすれば B は守りやすくなりますが、在庫サービスが正常な時の A まで断ってしまいます。上限を 1 本から 20 本まで変えて、停止の前後の平常時に A が断られた割合を数えました(停止の直後、待っていた A が 2 秒の timeout で返るまでの 40〜42 秒は除いています)。
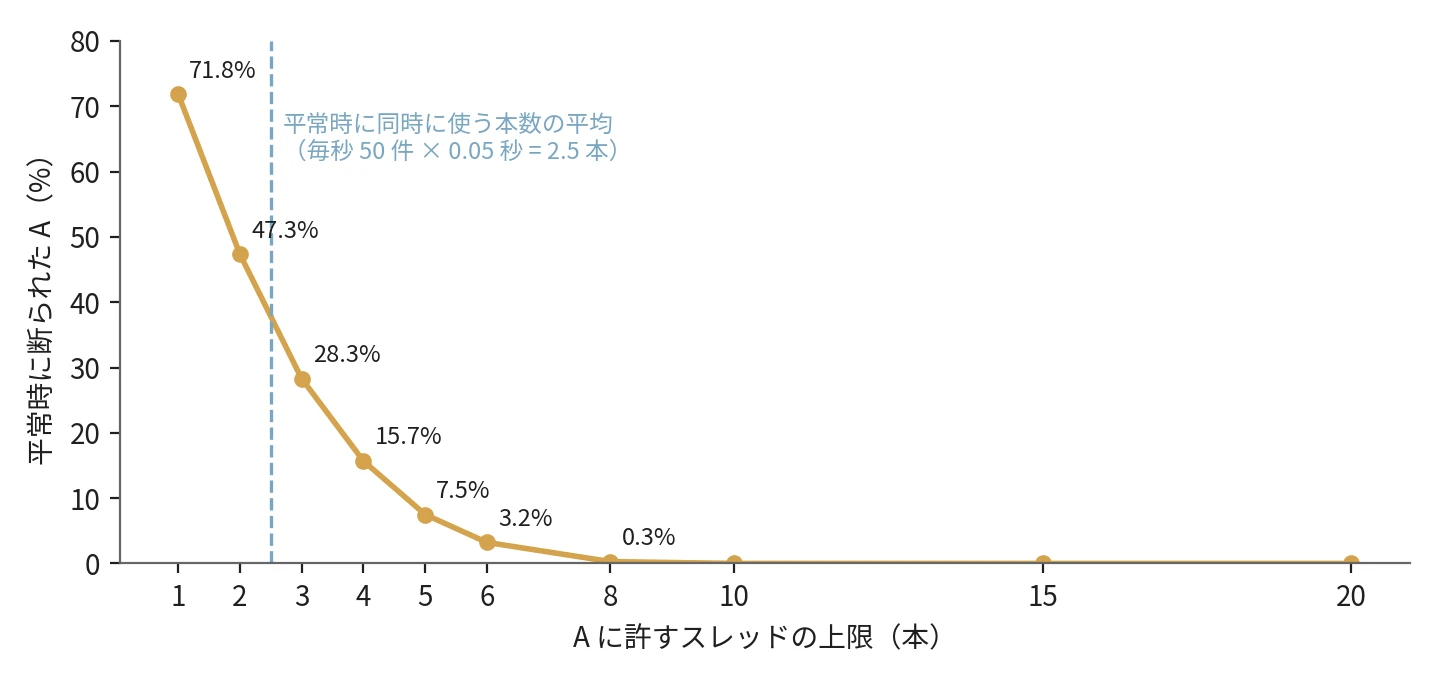
A の上限を変えた時の、平常時に断られた A の割合
平常時の A は、平均で「毎秒 50 件 × 0.05 秒 = 2.5 本」のスレッドを使います。上限を平均に近い本数にすると、到着が重なった時にあふれて、平均をわずかに超える 3 本でも 28.3% の A を断りました。平均の 3〜4 倍の 8〜10 本にすると、平常時に断る A はほぼ無くなりました。
一方、停止中に B を守れるかどうかは、上限が 30 本以下ならどれも 100% で、上限を置かない(40 本)時だけ 39.5% に落ちました。B は 5 ms で終わるので、平均で「毎秒 50 件 × 0.005 秒 = 0.25 本」しか使わず、10 本残れば足りるからです。B も重い処理なら、A の上限をもっと絞る必要があります。
区画の大きさは、平常時の「到着率 × 応答時間」に、到着の揺れの分を上乗せして決めます。上限を大きくしすぎると、止まった時に他の用途から奪う本数が増えます。小さくしすぎると、平常時の要求を断ります。実際のサービスでは、到着率も応答時間も時間帯で変わるので、平常時の同時実行数の推移を測ってから決めます。
区切り方の種類
セマフォとスレッドプール
区切り方は大きく 2 つあります。Java の耐障害性のライブラリ Resilience4j も、この 2 つを用意しています。
- セマフォ(SemaphoreBulkhead): 呼び出しの数だけを数え、上限を超えたら断るか、決めた時間だけ待たせる。実行するのは呼び出した側のスレッドのまま
- 専用のスレッドプール(FixedThreadPoolBulkhead。API の名前は ThreadPoolBulkhead): 呼び出し先ごとに別のスレッドプールと上限のある待ち行列(プールが埋まった時に少しだけ待たせる場所)を用意し、そこで実行する
本記事のシミュレーションは、セマフォの方式です。専用のスレッドプールは、呼び出した側のスレッドを待たせずに済み、timeout の時は呼び出した側が待つのをやめて戻れる代わりに、プールの数だけスレッドとその切り替えが増えます。Netflix の Hystrix は呼び出し先ごとのスレッドプールを既定にしていましたが、2018 年の 1.5.18 を最後に開発を止め、保守だけの状態になっています。
共有の上限と、固定の分割
本記事のシミュレーションでは、A に上限を置くだけで、B には上限を置いていません。B は、A が使っていないスレッドを全て使えます。
もう 1 つの区切り方は、40 本を A の 10 本と B の 30 本のように固定で分けるものです。B が急に増えた時でも A の 10 本は残りますが、A が暇な時でも B は 30 本までしか使えません。守りたいのがどちらの用途かで選びます。
何を単位に区切るか
区切る資源はスレッドに限りません。DB の接続プールを、管理画面とユーザー向けの API で分ける例や、呼び出し先ごとに HTTP クライアントの接続の上限を分ける例もあります。DB の接続数の上限そのものは、Connection Pool のノートで扱います。
区切る単位も、呼び出し先ごと(上の例)に限りません。提供する側が、顧客やテナントごとに資源を区切ることもあります。顧客ごとに独立した環境の組(cell)を並べる Cell-Based Architecture は、この考えをサービスの全体に広げたものです。Microsoft の解説も、Bulkhead は cell-based architecture とも呼ばれる、と書いています。
利点
- 1 つの呼び出し先の停止が、その呼び出し先を使わない機能に広がらない
- 止まった呼び出し先への要求が、timeout を待たずにすぐ失敗する(区画が埋まっている時)
- 上限を置くだけなら、実装はセマフォ 1 つで済む
欠点
Bulkhead は、資源を区切ることで、1 つの用途の失敗が他の用途に広がらないようにします。その代わりに、次の制約があります。
- 区切った用途そのもの(上の A)は救わない
- 区画が埋まっている間も、区画の中のスレッドは止まった呼び出し先を待ち続ける
- 区画の大きさを決めるには平常時の同時実行数を測る必要があり、小さすぎると平常時の要求を断る
- 固定で分けると、暇な区画の資源を他の用途が使えない
- 区切る用途が増えるほど、上限の設定と監視が増える
Bulkhead の効果が小さくなりやすいケース
- 呼び出し先が 1 つしかなく、守るべき別の用途が無いサーバー
- 全ての要求が同じ呼び出し先を必ず通る構成(区切っても、全ての機能がその呼び出し先に依存している)
- スレッドを持たずに待つ非同期の実装で、待っている呼び出しがスレッドを塞がない場合(ただし、接続やメモリの上限は残る)
最後のケースでも、待っている呼び出しの数だけ接続やメモリを使います。区切る対象をスレッドから、同時に待つ呼び出しの数に変えれば、同じ考え方が使えます。
実験のコードと出力の全体は lab/ にあります。