注文の画面にも、値引きの条件にも、請求書にも「合計」が出てきます。どれも同じ注文に付く同じ語なので、注文のモデルに total を 1 つ持てば足りるように見えます。
OSS で EC の基盤を作る Saleor の注文もそうでした。値引きの条件を判定するには税抜きの合計が、請求には税込みの合計が要り、Saleor はどちらも total 列に書いていました。2026 年 9 月に直された不具合は、下書きの注文を確定する前に税を計算し直している間に、別の処理が注文を触ると、税抜きの合計のまま注文が確定する、というものです。以下は、その仕組みを SQLite と 2 つのスレッドで小さく再現し、実測した時刻で動かした図です。
税を計算している間に、別の処理が注文を触った場合(lab/race.py で実測した時刻を 0.5 倍速で再生)
上の段では、税込みの 88 を保存する直前に、古い計算で上書きしないための確認が保存を止めました。total には値引きの判定のために書いた税抜きの 80 が残り、そのまま確定しています。下の段のように、税抜きの合計を base_total という別の列に書くと、同じ順番でも total は税込みの 88 のままで、確定は拒否され、もう一度実行すれば通ります。
DDD(Domain-Driven Design、ドメイン駆動設計)でいうモデルは、業務の概念を表す型と、その概念が守る規則の集まりです。1 つの語が場所によって違う意味を持つ時、その意味が 1 つに定まる範囲を明示した境界を Bounded Context(境界づけられたコンテキスト)と呼びます。DDD を提唱した Eric Evans 氏の DDD Reference は、Bounded Context を「特定のモデルが定義され、適用される境界の記述」とし、多くはサブシステムか、あるチームが受け持つ範囲になると書いています。
1 つの語が部署ごとに違う意味を持つ状況は、DDD を採用しているかどうかに関わらず現れます。
本記事では、注文や請求のモデルを設計する人と、既存のコードで base_ の付いた列や「境界づけられたコンテキスト」という語に出会った人に向けて、次の疑問に答えます。
- 同じ語を 1 つの列や型で共有すると、何が起きるのか。
- Bounded Context は、何をどこまで区切るのか。
- 境界は、どこに引けば良いのか。
- 境界をまたぐ時、何を渡すのか。
- マイクロサービスやモジュールと、何が違うのか。
1 つの列に 2 つの意味
Saleor は、Python と Django で書かれた EC の基盤で、注文を Order というモデルで表します。2024 年 4 月の PR「Calculate order promotions in draft order」で、下書きの注文に値引きを計算する処理が入りました。
値引きの条件は「合計が一定の額以上」のような形で、Saleor はこの判定を SQL で行います。判定の前に税抜きの合計を DB(データベース)へ保存しておく必要があり、その書き先が、税を計算した結果も入れる subtotal と total でした。どちらも税抜き(net)と税込み(gross)の 2 つの列の組で、値引きの処理は税抜きの合計を両方の列に書いていました。以下は、直す前と後で、2 つの処理がどの列に書くかを並べた図です。
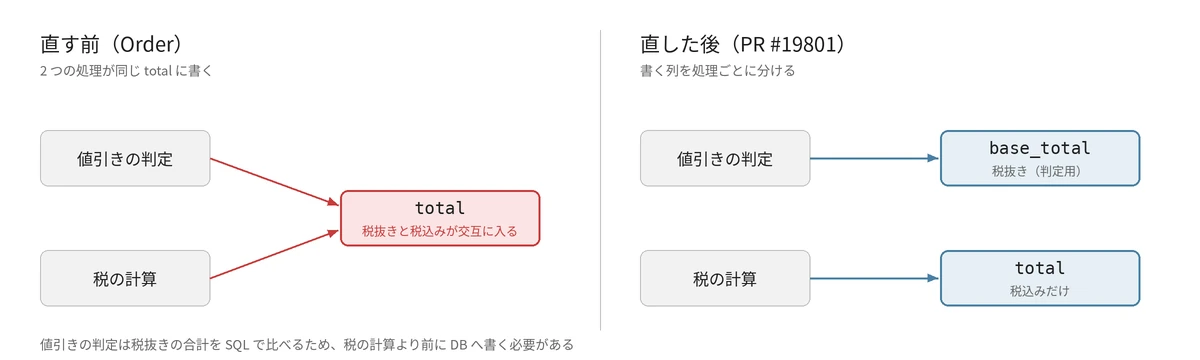
PR #19801 の前と後で、合計を書く列
図の左では、1 つの列に 2 つの処理が、それぞれ違う意味の値を書いています。直した PR「Store order base prices in dedicated columns so a dropped tax calculation cannot leave untaxed totals」に足された回帰テストの説明によると、価格の再計算は次の順に合計を 2 回書いていました。
- 値引きの処理が、税抜きの合計を
subtotalとtotalの税抜き・税込みの列に保存する。 - 税の計算が終わると、税込みの値でそれらを上書きする。
- 2 の前に、計算の間に他の処理が注文を変えたかを
updated_atで見る。 - 変わっていれば、2 の保存をやめる。
4 で保存をやめると、1 で書いた税抜きの値が残ります。明細と送料は前回に計算した税込みの値のままなので、注文の中で合計だけが合わなくなり、下書きを確定する API はその注文をそのまま確定していました。
PR は、税抜きの合計を新しい base_subtotal と base_total の列へ移し、保存されなかった計算がある注文の確定を TAX_ERROR で拒否するようにしました。2026 年 9 月 17 日に 3.23 の系列へ、9 月 30 日に main へ入っています。
Order の「合計」が 2 つの意味を持ったのは、これが初めてではありません。以下は、Order に合計の列が足された時期を並べた図です。日付は、DB の定義を変える手順のファイルである migration と PR から取りました。
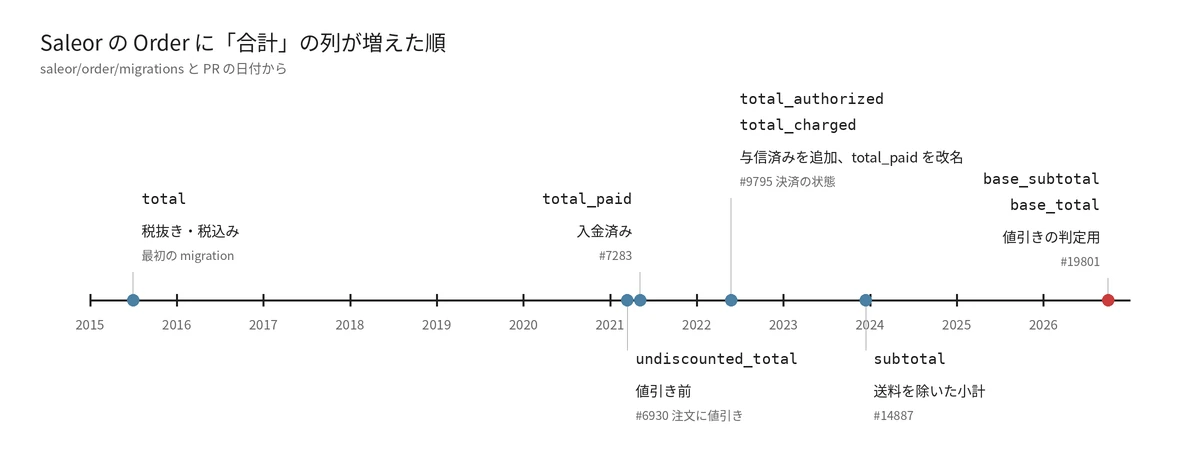
Saleor の Order に「合計」の列が足された時期
値引き前の合計、入金済みの額、送料を除いた小計のように、意味が増える度に undiscounted_ や paid を付けた別の列が足されています。2026 年 11 月の main では、合計と小計を表す金額の列が、税抜きと税込みを別に数えて 10 個あります。意味ごとに名前を分けている間は、どの列に何が入るかが名前で分かります。不具合が入ったのは、判定用の合計という新しい意味に名前を付けず、既にある total を使った所でした。
PR で足されたコードのコメントには、Checkout と同じ持ち方にした、とあります。Checkout は注文になる前のカートを表すモデルで、2024 年 2 月に値引きの判定を入れた時から base_total を別の列に持っていました。同じリポジトリの中で、カートでは判定用の合計を別の語として扱い、注文では total の 1 語に 2 つの意味を持たせていたことになります。
手元で再現する
Saleor を動かすには PostgreSQL などの環境が要るので、仕組みだけを Python の標準ライブラリで真似ました。Saleor のコードではありません。
注文は小計 70・送料 10・税率 10% で、前回の計算で税込みの 88 が total に入っている下書きです。税の計算は外部のアプリへ問い合わせる想定で 2 秒待ち、別の処理は 1 秒後に注文の備考を変えます。以下は、再計算を行う関数の抜粋で、全体は lab/race.py にあります。
def recalculate(db, shared, log, crash=False):
    """値引きの判定 → 税の計算 → 保存。保存の前に、他の処理が注文を変えていないかを見る。"""
    (seen,) = db.execute("SELECT updated_at FROM orders WHERE id=1").fetchone()
    base = SUBTOTAL + SHIPPING  # 80(税抜き)
    # 1. 値引きの条件を SQL で判定するので、税抜きの合計を先に DB へ書く
    col = "total" if shared else "base_total"
    db.execute(f"UPDATE orders SET {col}=? WHERE id=1", (base,))
    log("値引きの判定用に税抜きの合計を書く")
    db.execute(f"SELECT count(*) FROM orders WHERE id=1 AND {col} >= 75").fetchone()
    # 2. 税の計算(外部のアプリへの問い合わせ)
    log("税の計算を始める")
    time.sleep(TAX_CALL)
    if crash:
        log("税の計算の途中で処理が落ちる")
        raise RuntimeError("tax app timeout")
    taxed = round(base * (1 + TAX_RATE))  # 88
    # 3. 計算の間に他の処理が注文を変えていたら、古い計算で上書きしないよう保存をやめる
    (now,) = db.execute("SELECT updated_at FROM orders WHERE id=1").fetchone()
    if now != seen:
        if not shared:
            db.execute("UPDATE orders SET should_refresh=1 WHERE id=1")
        log("他の処理が注文を変えていたので、税込みの合計の保存をやめる")
        return
    db.execute("UPDATE orders SET total=? WHERE id=1", (taxed,))
    log("税込みの合計を保存する")
shared が真なら税抜きの合計を total に、偽なら base_total に書きます。確定の処理は total を読み、base_total に分けた設計では should_refresh が立っていれば確定を拒否します。次の 3 つの場面で、2 つの設計を実行しました。
| 場面 | total を共有 | base_total に分ける |
|---|---|---|
| 何も起きない | 88 で確定 | 88 で確定 |
| 計算中に別の処理が注文を触る | 80 で確定 | 確定を拒否する |
| 計算中に落ち、後で確定する | 80 で確定 | 88 で確定 |
共有する設計では、3 つのうち 2 つで税抜きの 80 のまま確定しました。どちらの場合も例外は確定の処理まで届かず、出力にも誤りを示す行はありません。分ける設計では、total に入るのは税込みの値だけで、別の処理が触った場合は確定を拒否し、もう一度実行すれば通ります。
何も起きなくても 2 秒は税抜き
出力の時刻を見ると、何も起きない場合でも、共有する設計の total は 0.001 秒から 2.005 秒まで 80 でした。
normal shared 確定した合計: 88
     0.001s  total= 80 base_total=  0  値引きの判定用に税抜きの合計を書く
     0.001s  total= 80 base_total=  0  税の計算を始める
     2.005s  total= 88 base_total=  0  税込みの合計を保存する
     2.009s  total= 88 base_total=  0  注文を確定する(total=88)
この 2 秒の間に、注文を一覧で返す API や Webhook が total を読めば、税抜きの額を受け取ります。確定した値が正しくても、列を共有する限り、途中の値は 2 つの意味を行き来します。税の計算のように外部を呼ぶ処理を 1 つのトランザクションに入れない理由は、Transaction Scope で扱っています。
上書きを防ぐ確認が税抜きを残す
別の処理が注文を触った場合に 80 を残したのは、手順 3 の確認です。この確認は、計算を始めた後に他の処理が書いた値を古い計算で上書きしないための仕組みで、lost update を防ぐ正しい作りです。確認が保存を止めた時、total に残るのは前回に計算した税込みの値のはずでした。
実際には、手順 1 で値引きの処理が同じ列に判定用の値を書いていたので、残ったのは税抜きの値です。同時実行の仕組みは列の意味まで見ないので、1 つの列に 2 つの意味を持たせると、正しい確認が誤った値を守ってしまいます。分ける設計では、値引きの処理は total に書かないので、確認が止めた時に残るのは前回に計算した税込みの値です。
Bounded Context が区切るもの
Saleor の直し方は列の名前を分けただけで、境界を引いたわけではありません。それでも「この場所で、この語はどの意味か」を決める判断は同じで、Bounded Context はそれをモデルの単位で行います。
DDD Reference は、境界をチームの体制、アプリケーションのどの部分で使うか、コードベースや DB のスキーマのような物理的な形で明示し、その中ではモデルの概念と用語を厳密に揃えるよう勧めています。境界の中で揃える語の集まりは、ユビキタス言語(ubiquitous language)と呼ばれ、モデルの型名や列名がそのままこの言語の語になります。
揃え続ける手段として、DDD Reference はコードを頻繁に統合し、チームで用語とモデルの解釈を突き合わせ続けることを挙げています。
Evans 氏の書籍『Domain-Driven Design』(2003 年)の第 14 章は、大規模なシステムでモデルを完全に統一するのは難しく、コストにも見合わないとしています。統一を諦める代わりに置くのが境界で、その大きさに決まりはありません。
DDD は、モデルを組み立てる部品にも名前を付けています。ID で同じものを追い続ける Entity と、まとめて整合を保つ単位の Aggregate、保存と取得を受け持つ Repository、起きた事実を表す Domain Event です。どれも 1 つの Bounded Context の中で定義するので、同じ「注文」の型でも、コンテキストが違えば持つ値と名前が変わります。
以下は、注文の「合計」の意味ごとに、別の Bounded Context を置いた場合の図です。
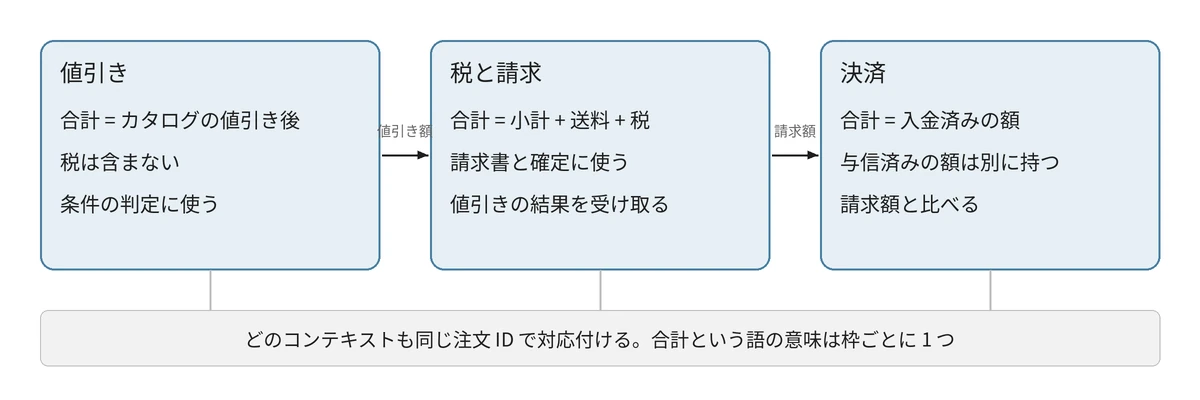
「合計」の意味ごとに分けた 3 つの Bounded Context
値引きのモデルには税込みの合計を入れる場所が無いので、Saleor の不具合のように判定用の値を税込みの置き場に書く、という間違いは起きません。税と請求のコンテキストは、値引きの結果を額として受け取り、自分の合計を計算します。
同じ語が部署ごとに少し違う意味を持つ状況は、EC に限りません。Martin Fowler 氏は BoundedContext(2014 年)で、電力会社で「メーター」という語が、送電網と場所のつながり、送電網と顧客のつながり、壊れたら取り替える機器の 3 つの意味で使われていた経験を挙げています。
同じ語が場所によって別のものを指すこの状態は、多義語(polyseme)と呼ばれます。会話では吸収できる違いも、コンピュータの上では吸収できません。Fowler 氏は、「Customer」と「Product」で同じ混乱が繰り返されるとも書いています。
同じ綴りを 2 つの意味で読んで壊れた有名な例が、表計算ソフトによる遺伝子名の変換です。遺伝学では SEPT2 は Septin 2 という遺伝子の記号ですが、Excel は既定の設定で、この文字列を日付と解釈して「2-Sep」に変えます。2005〜2015 年に 18 誌が載せた補足ファイルを機械で調べた研究では、遺伝子の一覧を Excel で添付した論文の 19.6% に、日付などへの変換による誤りがありました。
境界を引く場所
境界を引く手掛かりは、語の意味が変わる所です。Saleor の total には、値引きを判定する処理と税を計算する処理という、2 つの書き込む処理がありました。1 つの列や型に、違う意図で書く処理が 2 つ以上あれば、その間に境界の候補があります。
変更の理由も手掛かりになり、1 つの要求が 1 つの境界の中で完結するなら、その切り方は業務の形と合っています。要求のたびに複数の境界を触るなら、境界の位置を疑います。境界を引き直す時は、コードだけでなく用語と会話も変わります。
語の意味が衝突していなくても、1 つの型に、いくつもの業務から要求が集まると変更が重くなります。決済の都合で注文の状態に「一部入金済み」を足しただけで、同じ状態を見て分岐する値引きと請求のコードまで読み直すことになるからです。共有した型に手を入れるたびに、業務ごとの検証が全部要り、変更を出す速さは最も慎重な業務に揃います。境界を分けると、この変更は決済の境界内で止まります。
逆に、画面やメニューの単位で境界を引くと、語の意味が変わる所と合わないことがあります。弁護士ドットコムの「弁護士ドットコムサービスでモノリスをマイクロサービス化しようとして失敗した原因を振り返る」(2022 年 11 月)は、認証決済やニュースの機能を 1 つのアプリケーションから分けた時の振り返りです。当時のチームは見かけ上の機能を分割の境目と考えていましたが、800 以上あるカテゴリの管理が、データとコードの両方で多くの機能に入り込んでいました。
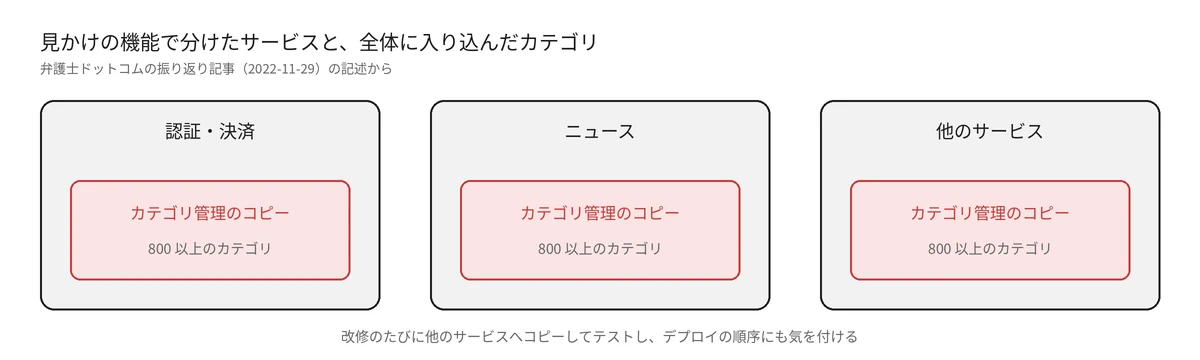
機能で分けたサービスのそれぞれに、カテゴリ管理のコピーを持たせた構図(振り返りの記述から作図)
分けた各サービスにカテゴリ管理のモジュールをコピーして持たせた結果、改修のたびに他のサービスへコピーしてテストする必要があり、デプロイの順序を誤ると障害を招くこともあったそうです。開発速度はモノリスの時より遅くなりました。
振り返りは反省として、書籍『マイクロサービスアーキテクチャ』の「境界づけられたコンテキストが優れた接合部になります。」という一文を引いています。どのサービスでもカテゴリが同じ意味で使われていたなら、カテゴリは機能ごとにコピーするものではなく、それ自体を 1 つのコンテキストにして、他から参照される側に置く候補だったと考えられます。
業務の区分とは 1 対 1 にならない
業務の区分(サブドメイン)がそのまま Bounded Context になるとも限りません。Mathias Verraes 氏の「Domains and Bounded Contexts Don’t Map 1 on 1」(2025 年 8 月)は、価格を決める 1 つの業務の中に、Web から価格を集める処理、機械学習で価格を出す処理、規則で決める処理、人が決める処理があり、語もモデルも違うので 4 つに分ける例を挙げています。
同じ文章には、新しい価格の決め方を試すために、隔離した Bounded Context を置く例もあります。組織図に合わせるのではなく、語とモデルを分けたい所で引く、というのが Verraes 氏の主張です。
全てを細かく分ける必要もありません。DDD Reference は、モデルが混ざって境界がはっきりしない部分を Big Ball of Mud と呼び、その全体を 1 つの境界で囲んで、中では凝ったモデル化をしないよう勧めています。分けるのは、Saleor の total のように、意味の混ざりが不具合や変更の衝突として現れている所からで十分です。
境界をまたぐ
境界を引くと、境界の間で情報を渡す方法を決める必要が出ます。上の 3 つのコンテキストの図で渡していた ID と値に、起きた事実を足した 3 種類が基本です。
- 同じものを指すための ID(注文 ID)
- 相手の語に翻訳した値(値引き額、請求額)
- 起きた事実(「注文が確定した」)
境界の間で ID しか渡してはいけない、という決まりはありません。相手が必要とする値は、相手の語に翻訳して渡します。ID を受け取る側は、ID を比較と受け渡しだけに使い、書式を解析したり自分で採番したりしません。解析すると、相手が決めた採番の規則に依存するからです。
翻訳のコードは、どちらの境界の型も知ってよい 1 箇所に集めます。どちらかの境界が相手の型を import すると、その境界に相手の語が入り込むので、両方を import して翻訳だけを受け持つ第三のパッケージに置きます。後のコンテキストマップのように上流と下流がある関係でも、下流が上流の型を直接使わないなら、この形が使えます。以下は、値引きと税と請求の間に置いた場合の形で、説明用に書いたものです。
// Package translate は値引きと税と請求の間の翻訳だけを受け持ちます。
package translate

import (
	"example.com/shop/billing"
	"example.com/shop/discount"
)

// ToBillingDiscount は値引きの判定結果を、請求が使う値引き額に翻訳します。
// 判定に使った条件は請求に意味が無いので、ここで捨てます。
func ToBillingDiscount(r discount.Result) billing.Discount {
	return billing.Discount{
		Order:  billing.OrderRef(r.OrderID),
		Amount: r.Amount,
	}
}
translate は discount と billing の両方を import しますが、discount と billing はどちらも translate と相手を import しません。相手の型を知るパッケージが 1 つに限られるので、2 つのモデルは相手の語を持たずに済みます。片方が一方的に自分を守る場合は、この翻訳を守る側の入口に置きます。
ID の型まで共有すると、後で挙げる Shared Kernel になります。共有を小さく保ち、変える時に相手の同意を取る仕組みが無いと、型を変えるたびに 2 つの境界が同時に動きます。
境界を分けると、そのためのコストも生じます。同じ注文の情報が 3 つのコンテキストに散るので、注文全体を一覧で見る問い合わせは複数の箇所を引くことになります。似た型と、上のような翻訳のコードも、境界の数だけ増えます。
境界を独立したサービスや DB に置くと、境界をまたぐ更新を 1 つのトランザクションにまとめにくくなります。その場合は、ある瞬間はずれていても、いずれ一致する結果整合性(eventual consistency)を選ぶことが多くなります。
事実の伝え方は Domain Event で、外から来る語を自分の語に翻訳する層は Anticorruption Layer で扱っています。どれを選ぶかは、境界の両側を持つチームの関係で変わります。DDD Reference は、その判断が相手の成否を左右する側を上流、左右される側を下流と呼び、両者の関係を次の名前で並べています。
| 関係 | 何をするか |
|---|---|
| Partnership | 両チームが計画と統合を一緒に管理する |
| Shared Kernel | 小さく共有するモデルを決め、相談なしに変えない |
| Customer/Supplier | 下流の要求を上流の計画に入れる |
| Conformist | 翻訳をやめ、上流のモデルにそのまま従う |
| Anticorruption Layer | 下流が翻訳の層を置き、上流の語を中へ入れない |
| Open-host Service | 上流が誰でも使える取り決め(プロトコル)を公開する |
| Published Language | 文書化した共通の形式でやり取りする |
| Separate Ways | つながず、それぞれ単純に作る |
これらの関係と境界を 1 枚に描いた図は、コンテキストマップ(context map)と呼ばれます。DDD Reference は同じ並びに Big Ball of Mud も置いていますが、関係ではなく境界の中が混ざった状態なので、表から外しました。以下は、本記事の 3 つのコンテキストに、渡すものと関係を書き込んだ一例です。
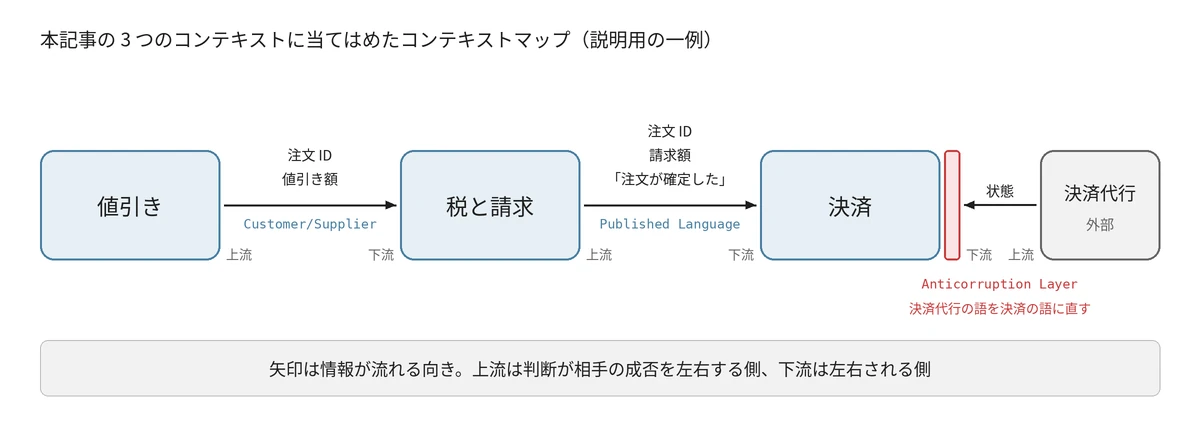
本記事の 3 つのコンテキストに当てはめたコンテキストマップ(説明用の一例)
税と請求は、値引きの結果が無いと請求額を出せないので下流で、必要な値引き額の形を値引き側の計画に入れてもらいます。決済は、確定の事実を文書化した形式で受け取ります。外部の決済代行は決済のチームが動かせない上流なので、決済が翻訳の層を置き、決済代行が使う状態の名前を自分の語に直します。
関係は 1 つに決める必要はありません。上流が Open-host Service と Published Language を出し、下流の一部は Conformist として従い、残りは Anticorruption Layer を作る、という組み合わせもあります。上流を動かせない下流が自分だけで選べるのは、主に Conformist か Anticorruption Layer です。2 つの選び分けの基準と実験は、上で挙げた Anticorruption Layer のノートで扱っています。
マイクロサービスやモジュールとの違い
Bounded Context は、語とモデルの範囲です。デプロイの単位やコードの置き場所とは別の軸なので、次の言葉と混ざりやすくなります。
| 言葉 | 何の単位か | Bounded Context との関係 |
|---|---|---|
| サブドメイン | 業務の区分 | 1 対 1 とは限らない |
| モジュール | コードの置き場所 | 1 つのコンテキストを 1 つに置くことが多い |
| マイクロサービス | デプロイの単位 | 1 つのコンテキストを複数に分けて良い |
| DB のスキーマ | データの置き場所 | 境界を物理的に示す手段の 1 つ |
Microsoft の「Identify microservice boundaries」は、マイクロサービスの機能は一般に 1 つの Bounded Context をまたがないとしています。ドローンで荷物を届ける例では、配送を扱う 1 つの Bounded Context が、依頼の受け付け・配送の計画・荷物・配送の履歴などの複数のサービスに分かれています。逆向きの、1 つのサービスが 2 つのコンテキストのモデルを混ぜる形は、ドメインの分析をやり直す合図だとしています。
デプロイの単位を 1 つに保ったまま、コードの中にコンテキストの境界を作る構成は Modular Monolith で、サービスを分けたのに境界が合わず、まとめてしか変更できなくなった構成は Distributed Monolith で扱っています。弁護士ドットコムの例は、サービスを先に分け、カテゴリの境界を後に残した形でした。
境界を引く前に見ること
Bounded Context を導入するかを決める前に、手元のコードで見ることは 3 つです。
まず、同じ語に接頭辞や接尾辞を付けた列や型を数えます。Saleor の Order には、合計と小計を表す金額の列が 10 個ありました。それ自体は、意味ごとに名前を分けた結果で悪いことではありません。問題になるのは、名前の付いていない意味が、既にある名前に同居している所です。
次に、1 つの列や型に書く処理を数えます。冒頭の図で、上の段にある total には、値引きの判定と税の計算という 2 つの処理が、それぞれ自分が考える合計を書いていました。書き込む処理が 2 つ以上あり、それぞれの意図が違うなら、少なくとも名前を分け、チームも違うなら境界の候補です。
最後に、その語を関係する人に「ここでは何を指すか」と聞きます。答えが揃わなければ、その語は既に 2 つのコンテキストにまたがっています。境界を引いた後に何を渡すかは、両側のチームがどの関係にあるかで決めます。
意味の混ざりによる不具合や変更の衝突が、境界をまたぐ節で挙げたコストより重い所で引きます。逆に、扱う業務が 1 つで主な語の意味が最初から定まっているシステムや、参照だけの小さなツール、語の意味が変わるかを判断できるだけの知識がまだ無い段階では、境界を引いても名前が増えるだけです。境界が働いているかは、境界の中で 1 つの語が 1 つの意味に定まっているかと、境界をまたぐ所に翻訳があるかで判断できます。
再現に使ったコード・出力・Saleor の履歴を出すスクリプトは lab/ にあります。