監視用の補助コンテナを古いバージョンのままにして、PostgreSQL を 16 から 17 に上げると、ダッシュボードで checkpoint 回数のグラフだけが途切れます。DB は動いていて、接続を表す pg_up は 1 のままで、DB が落ちた時に鳴らすアラートも鳴りません。補助コンテナを新しいバージョンに上げると、エラーは消えますが、グラフは途切れたままです。
以下は、この流れを手元の Docker で 240 秒の間に再現し、Prometheus が 5 秒ごとに集めた値を並べた結果です。
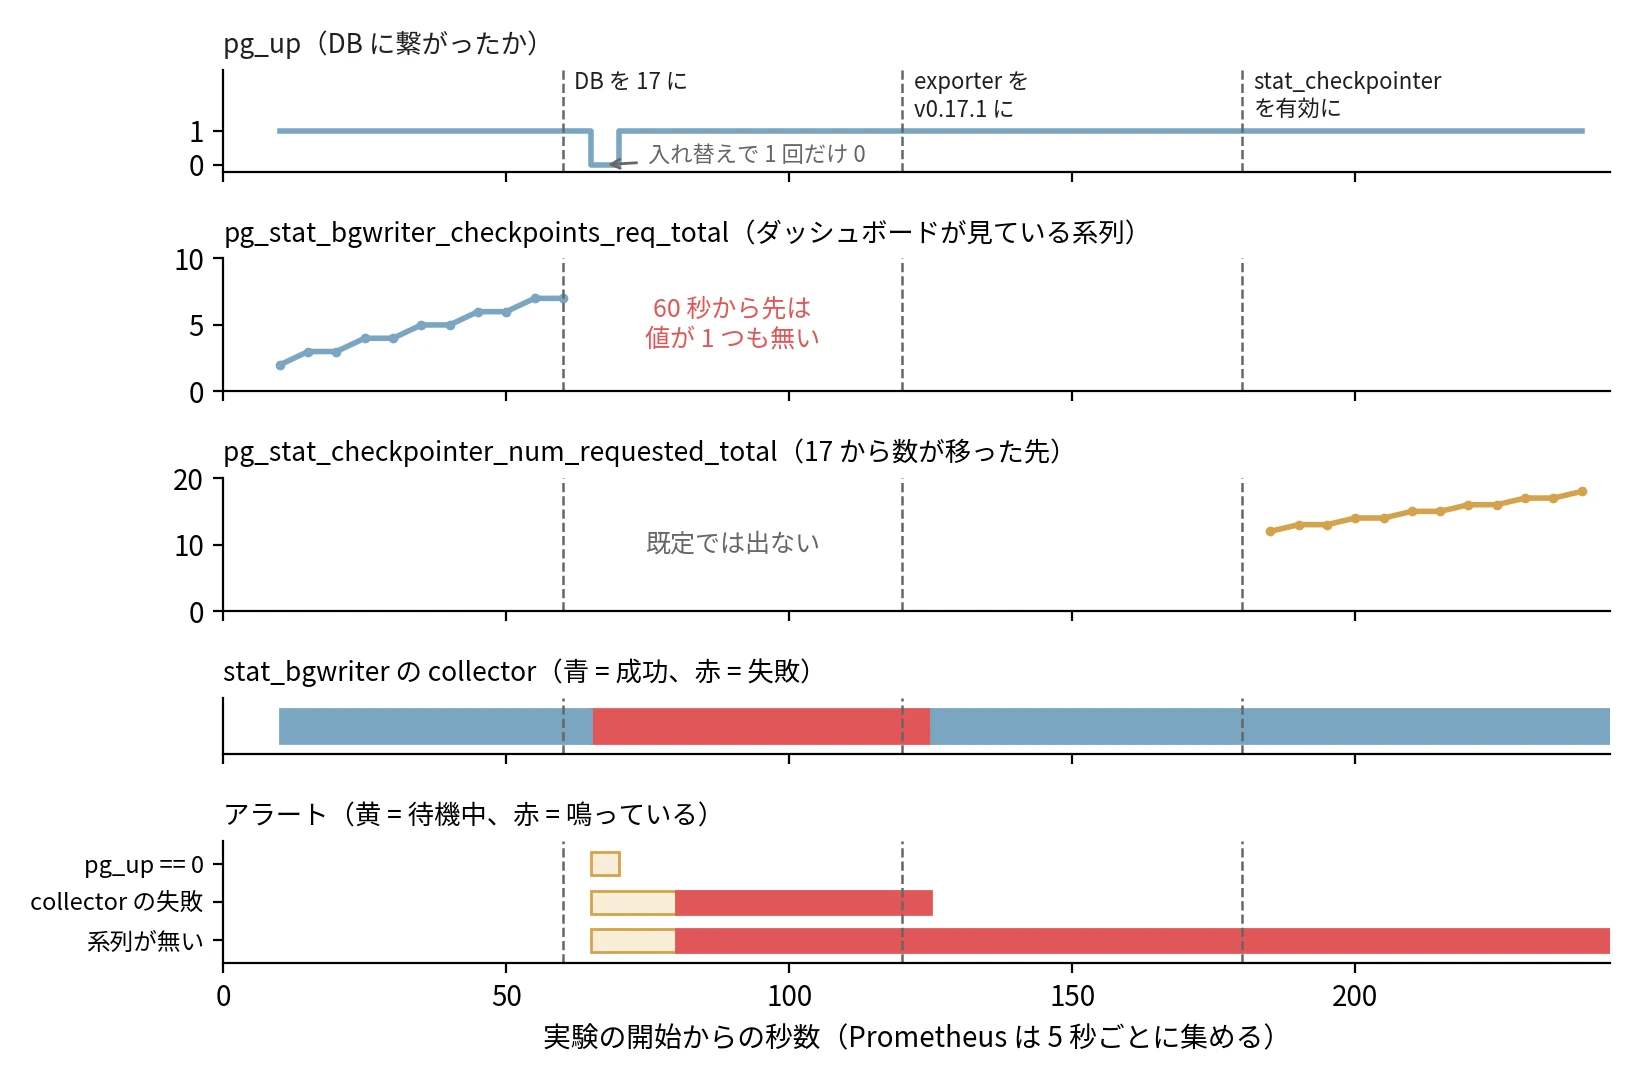
DB を 17 に上げ、exporter を上げ、新しい collector を有効にした 240 秒
上記の図で、2 段目がダッシュボードが見ている系列です。系列は、Prometheus で時系列(time series)と呼ばれるもので、同じ名前とラベルを持つ値を時刻の順に並べた、グラフの線 1 本に当たります。60 秒で DB を入れ替えてから最後まで、値は 1 つも届いていません。一方で 1 段目の pg_up は、入れ替えた瞬間の 1 回を除いて 1 です。3〜5 段目は、後の節で順に読みます。
この監視用の補助コンテナが、本記事で扱う Adapter です。PostgreSQL は自分の統計を SQL で読めるビューとして持っていますが、Prometheus が読める形では出しません。その間に立って、DB の統計を Prometheus の形に変換するのが postgres_exporter です。README も、DB の隣に置く使い方を基本にしています。
本記事では、exporter のような adapter をこれから置く人と、既存の監視で adapter に出会った人に向けて、次の疑問に答えます。
- 変換を adapter に置くのは、他の置き場所と比べて何が違うのか。
- exporter は DB から何を読み、Prometheus に何を出しているのか。
- DB を上げただけで、なぜ一部のメトリクスだけが消えるのか。
- なぜ
pg_upのアラートでは気付けないのか。 - exporter を上げても、なぜグラフは戻らないのか。
- DB や adapter を上げる前に、何を見ておけばよいのか。
変換を置く 4 つの場所
実行単位とは、同じマシンにまとめて置かれ、まとめて作られ消されるコンテナの集まりで、Kubernetes の Pod や Amazon ECS の Task です。隣に置いて機能を足すコンテナ全般は Sidecar と呼ばれ、Adapter はそのうち出力とインターフェースの形を揃える役のものを指します。アプリごとに出し方が違っても、adapter が実行単位の縁で 1 つの形に変えて外へ見せるので、外の監視基盤が知る形式は 1 つで済みます。
Adapter が揃える向きは、出力だけではありません。
| 向き | adapter がすること | 例 |
|---|---|---|
| 中から外へ | アプリの出力を外が読める形にする | 本記事の postgres_exporter |
| 外から中へ | 外から来た要求をアプリが受ける形にする | 古い形式しか受けないアプリの前に立つ受け口 |
どちらも外に揃った姿を見せる点は同じなので、Adapter と Ambassador は通信の向きではなく、誰に何を見せるかで分かれます。メトリクスの他に、書き方がまちまちなログを 1 つの構造に揃える用途や、生死を判定する窓口を共通にする用途もあります。
余談: Adapter という名前
Brendan Burns 氏は 2015 年 6 月の Kubernetes ブログ「The Distributed System ToolKit」で、同じ Pod に置く補助コンテナを Sidecar・Ambassador・Adapter の 3 つに分けました。翌年に David Oppenheimer 氏と書いた論文「Design Patterns for Container-based Distributed Systems」も同じ分け方です。
論文の 4.3 節によると、Ambassador は外の世界を単純にしてアプリに見せ、Adapter は出力とインターフェースを揃えて均質な姿を外に見せます。
書籍『オブジェクト指向における再利用のためのデザインパターン』にも同じ名前のパターンがありますが、書籍のパターンはクラスで、コンテナの Adapter は別のプロセスです。コードの設計で外のモデルを翻訳する層は Anti-Corruption Layer と呼ばれます。
監視基盤が読める形に揃える変換は、adapter の他にも置き場所があります。以下は、PostgreSQL の統計を Prometheus で集める場合の比較です。
| 置き場所 | PostgreSQL での例 | 変換を直す人 | 動く数 |
|---|---|---|---|
| アプリが直接出す | 無い | 自分たち | アプリと同じ |
| 同じ実行単位の adapter | postgres_exporter を DB の隣に置く | exporter の開発者 | DB ごとに 1 つ |
| 離れた所に 1 つ | exporter の multi-target | exporter の開発者 | 全体で 1 つ |
| 集める所で変換 | OpenTelemetry Collector の receiver | receiver の開発者 | Collector の数 |
表の 1 行目のように、自分たちで書いたアプリなら、Prometheus の client library を組み込んで、最初から Prometheus の形で出せます。変換は必要ありません。PostgreSQL や Redis のように中を変えられないソフトウェアでは、この行が使えないので、残りの 3 つのどれかになります。Prometheus の公式サイトには、こうした exporter の一覧があります。
Brendan Burns 氏らが 2016 年に書いた論文「Design Patterns for Container-based Distributed Systems」によると、Google 社内ではコードの規約で監視の形を揃えていますが、それはソフトウェアを一から作る場合にしかできません。既存のシステムやオープンソースのソフトウェアを改変せずに揃えるために、論文は Adapter を挙げています。
2 行目に置く adapter の強みは、DB ごとに独立することです。Prometheus が取りに来る形なので、DB は自分がどう監視されているかを知らず、監視基盤を替えても DB には手を入れません。adapter が、Prometheus の形式を元に標準にした OpenMetrics の形で出していて、新しい監視基盤も読めるなら、adapter も変えずに済みます。同じ exporter を全ての PostgreSQL に使い回せます。DB の種類が違っても同じです。
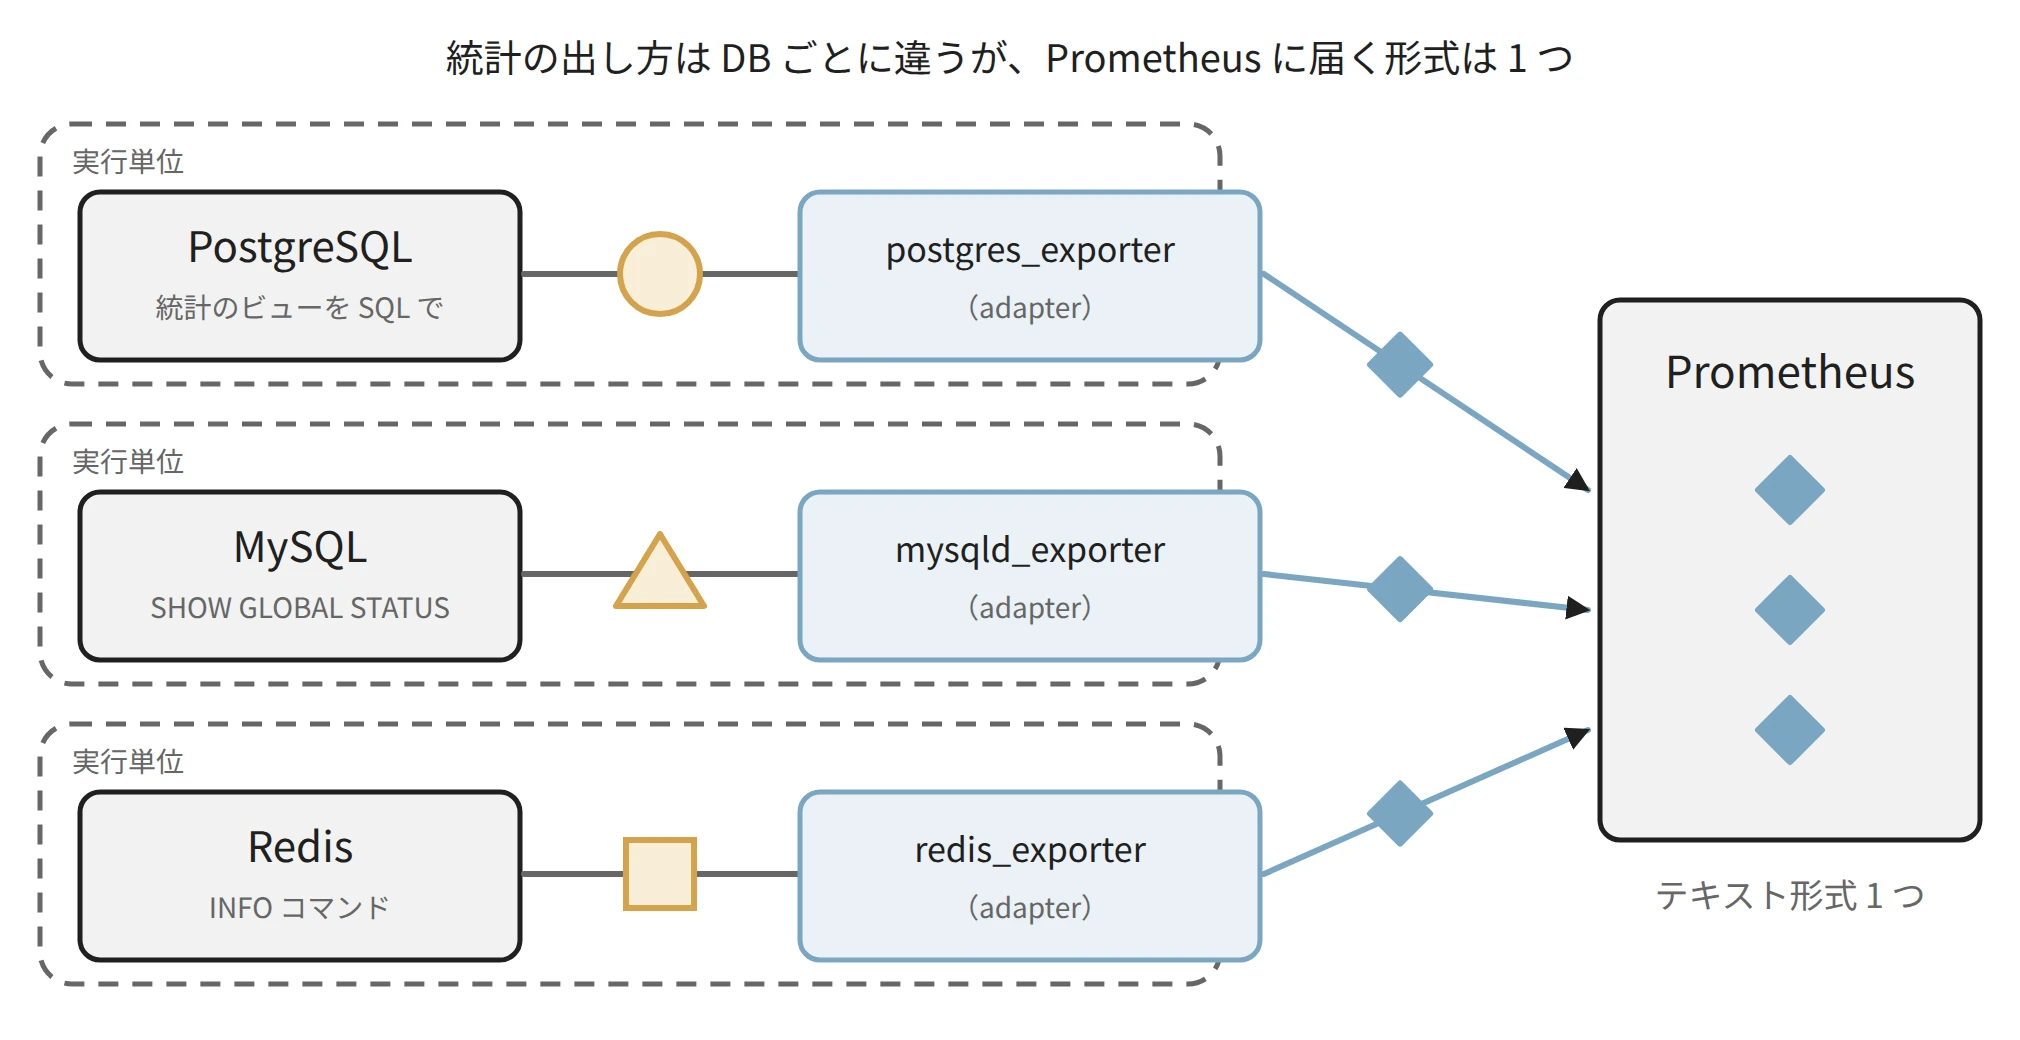
隣の exporter が、出し方の違う DB を 1 つの形式に揃える
上記の図のように、MySQL の隣に mysqld_exporter、Redis の隣に redis_exporter を置けば、Prometheus は統計の出し方が違う DB でも 1 つの形式で読めます。違いを吸収するのは各実行単位の adapter で、Prometheus は DB の種類を知りません。論文が 4.3 節で Adapter を「複数のコンテナにまたがって出力とインターフェースを標準化すること」と定義しているのは、この揃え方のことです。
1 個あたりの重さも小さく済みます。PostgreSQL 17 に exporter を繋いで 10 秒ごとに 6 回読ませた後、docker stats でメモリを見ると次の通りでした。
exporter v0.15.0: 9.805MiB / 61.43GiB
exporter v0.20.1: 8.449MiB / 61.43GiB
postgres 17: 24.98MiB / 61.43GiB
exporter 1 個は 10MiB 足らずで、何も処理していない PostgreSQL 17 の 25MiB より小さい量です。ただし DB の数だけ動くので、数百の DB を持つ環境では総量が効いてきます。
3 行目の multi-target は、1 つの exporter が、要求ごとに /probe?target= で指定された DB を読む方式です。postgres_exporter の README は、sidecar として置けないクラウドの管理サービス向けと説明しています。
4 行目は、OpenTelemetry Collector の postgresql receiver のように、値を集める部品が DB を読む方式です。監視する DB の種類が増えるたびに、集める側の設定と receiver に手を入れることになり、変換の誤りや重さは、全ての値を集める部品そのものに及びます。論文は、監視の仕組みにアプリごとのコードを抱えさせる構成について、関心の分離がきれいでないと指摘しています。
表に無い置き場所もあります。Java のアプリは、監視の値を JMX(Java Management Extensions)という窓口で出します。jmx_exporter は、別のコンテナから JMX を読むとリモート接続の設定が必要なので、同じ JVM(Java の実行環境)に Java Agent として読み込ませる形を勧めています。jmx_exporter 1.5.0 の文書にある起動例は次の通りで、アプリの java コマンドにエージェントの指定を足し、9404 番のポートで /metrics を出します。
java -javaagent:jmx_prometheus_javaagent-1.5.0.jar=9404:exporter.yaml -jar your-application.jar
これはアプリと同じプロセスに入れる形で、コンテナを分けないので Adapter からは外れます。変換をプロセスの中に入れるか別のコンテナに出すかは、このリモート接続の手間と、アプリと別に更新できることや資源を分けられることとの兼ね合いで決めます。
どこに置いても、変わらないことがあります。PostgreSQL のバージョンごとにどの列を何という名前で出すか、という対応の知識が、DB の開発者とも自分たちとも違う人のコードにあることです。DB 側のテストは exporter を通らないので、この対応が崩れても DB のテストでは気付けません。冒頭の図で起きたのは、DB が形を変え、その対応が追い付かなかった時の話です。
exporter が読むものと出すもの
postgres_exporter が何をしているかは、Prometheus が取りに来た時の流れで見ると分かります。以下は、DB と exporter を同じ Pod に置いた構成の図です。
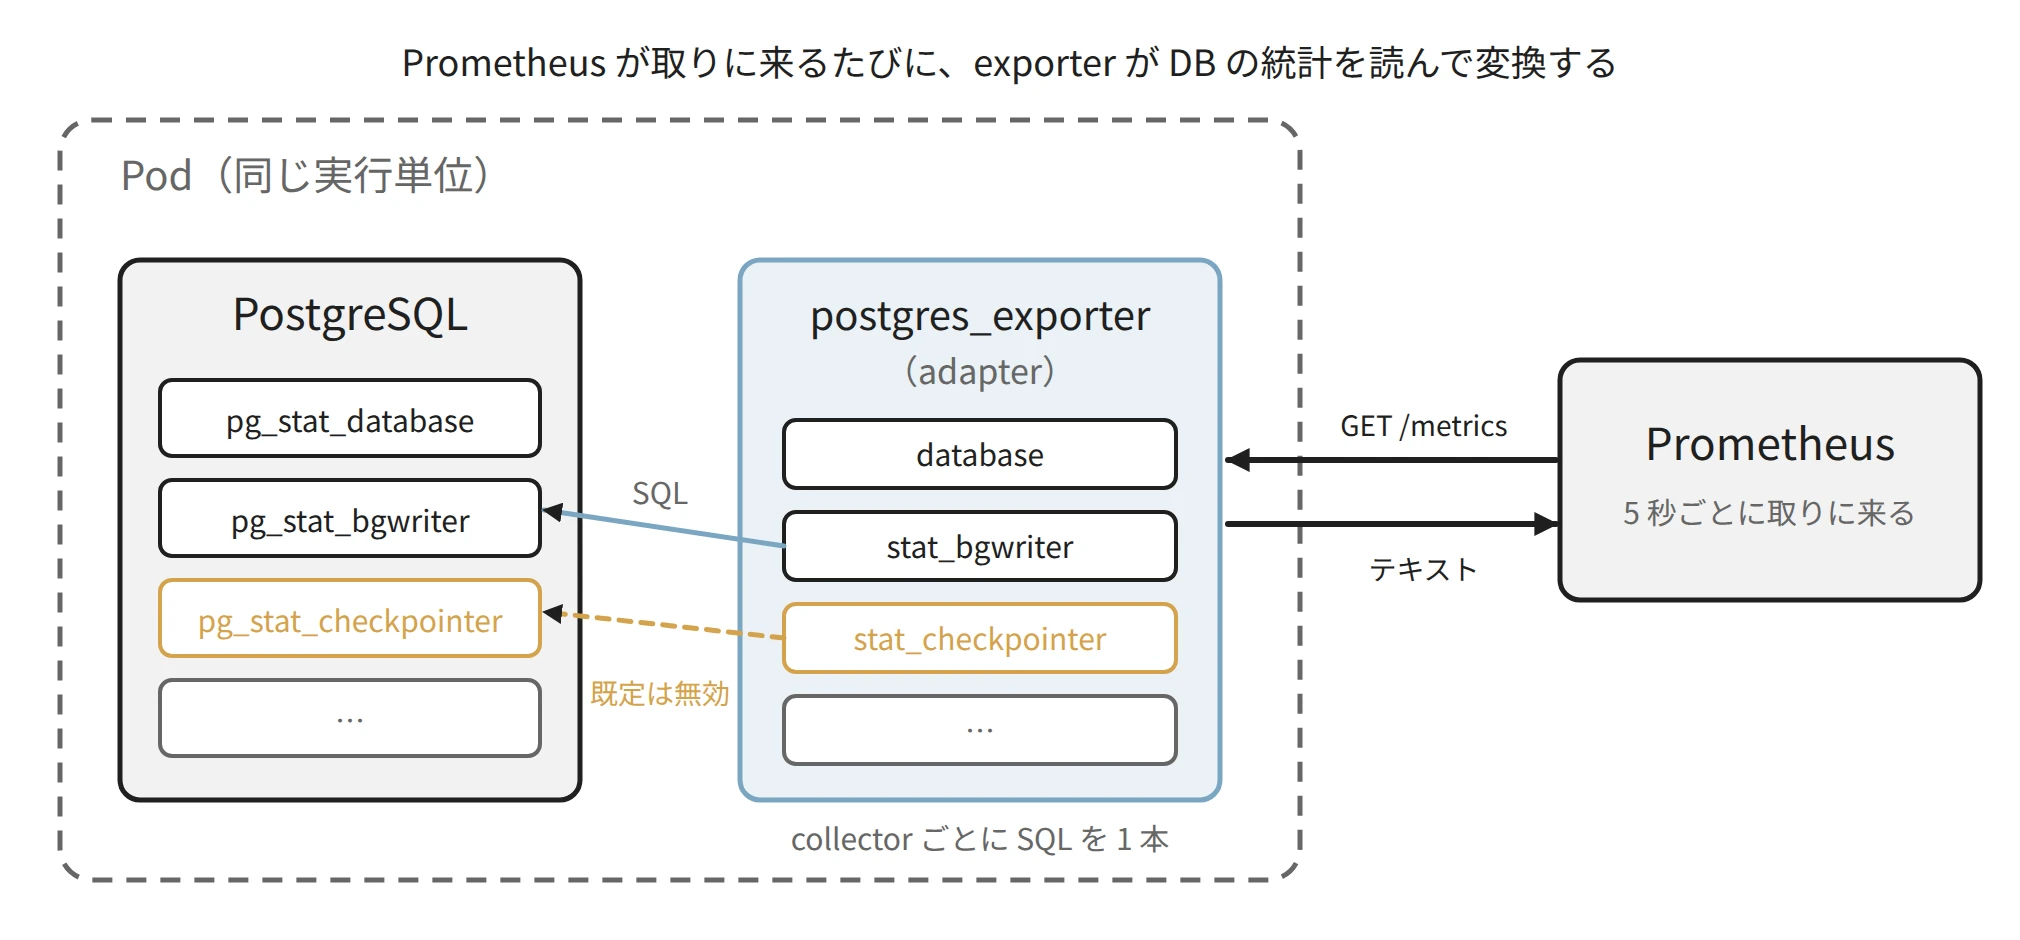
DB の隣に置いた exporter と、取りに来る Prometheus
同じ Pod のコンテナはネットワークを共有するので、exporter は localhost で DB に繋がります。論文も、本体と adapter の間は localhost か共有の volume で繋ぐとしています。共有の volume は、同じ実行単位に置いた複数のコンテナから同じ内容が見えるファイルの置き場です。
本記事の exporter は DB に問い合わせて取りに行く形ですが、繋ぎ方はアプリの出し方で決まります。StatsD は、値を短いテキスト 1 行で一定間隔に送る形の例です。
| アプリの出し方 | 繋ぎ方 | adapter がすること | アプリの設定 |
|---|---|---|---|
| 問い合わせに答える | localhost | 取りに行き、形を変える | 変えない |
| ファイルに書く | 共有の volume | 読み取り、形を変える | 変えない |
| 一定間隔で送る | localhost | 受け取り、変えて送り直す | 送信先を変える |
送る形だけは、アプリの送信先を localhost の adapter に変える設定が必要です。アプリを全く触らずに揃えられるのは、取りに行く形とファイルの形です。
Prometheus は、exporter の /metrics に HTTP の GET を送ります。exporter はその都度、collector と呼ばれる部品ごとに SQL を 1 本ずつ DB に投げ、結果を Prometheus が決めたテキスト形式にして返します。集めに来るたびに SQL を投げるので、DB の値が外から見えるのは、この変換を挟んだ分だけ遅れます。
collector の多くは、PostgreSQL が持つ統計のビューに 1 つずつ対応します。例えば stat_bgwriter の collector は pg_stat_bgwriter を読みます。
pg_stat_bgwriter は、変更されたデータをディスクに書き出すバックグラウンド処理の統計です。PostgreSQL 16 までは、checkpoint の回数もここにありました。checkpoint は、溜まった変更をデータファイルへ書き出し、障害から復旧する時に WAL を読み直す起点を進める処理です。
回数が急に増えるのは、書き込みが増えた時や設定が合っていない時の兆候なので、ダッシュボードによく置かれます。
PostgreSQL 17 に postgres_exporter v0.15.0 を繋いだ時、/metrics の一部は次の通りでした。
# HELP pg_up Whether the last scrape of metrics from PostgreSQL was able to connect to the server (1 for yes, 0 for no).
pg_up 1
# HELP pg_scrape_collector_success postgres_exporter: Whether a collector succeeded.
pg_scrape_collector_success{collector="database"} 1
pg_scrape_collector_success{collector="stat_bgwriter"} 0
pg_scrape_collector_success{collector="stat_database"} 1
pg_up の説明文は「最後に集めた時に DB に繋がったか」です。繋がった後に投げた SQL が失敗したかどうかは、pg_up には入りません。SQL ごとの成否は、collector ごとの pg_scrape_collector_success に分かれています。冒頭の図で pg_up が 1 のままだったのは、この分け方のためです。
消えたのは 1 つの collector だけ
冒頭の図で見た症状について、疑わしい所から順に外していきます。最初に疑うのは exporter そのものが止まった可能性ですが、pg_up が 1 で返ってくる以上、exporter は動いていて DB にも繋がっています。次に疑うのは DB の権限ですが、同じ DB を読む database や stat_database の collector は成功しています。
残るのは stat_bgwriter の collector だけの問題で、exporter のログに理由が出ていました。
ts=2026-11-13T13:10:43.186Z caller=collector.go:202 level=error msg="collector failed" name=stat_bgwriter duration_seconds=0.001976976 err="pq: column \"checkpoints_timed\" does not exist"
checkpoints_timed という列が無い、というエラーです。PostgreSQL 17 のリリースノートには、新しいビュー pg_stat_checkpointer を作り、関係する列を pg_stat_bgwriter から移した、と書かれています。exporter v0.15.0 は、移される前の列名で SQL を書いていました。
この組み合わせがどこまで続くかを見るため、PostgreSQL の 4 つのバージョンと exporter の 4 つのバージョンを全て組み合わせ、それぞれで /metrics を 1 回読みました。公式イメージで DB を立て、exporter を繋いで 3 秒待ち、pg_up と collector ごとの成否を抜き出すスクリプトです。実験は全て Docker 29.2.1 の上で動かしました。
for pg in 15 16 17 18; do
  docker run -d --rm --name "pg$pg" --network "$NET" \
    -e POSTGRES_PASSWORD=secret "postgres:$pg" >/dev/null
  until docker exec "pg$pg" pg_isready -U postgres >/dev/null 2>&1; do sleep 1; done
  sleep 2
  for ex in v0.15.0 v0.16.0 v0.17.1 v0.20.1; do
    docker run -d --rm --name exporter --network "$NET" -p 9187:9187 \
      -e DATA_SOURCE_NAME="postgresql://postgres:secret@pg$pg:5432/postgres?sslmode=disable" \
      "prometheuscommunity/postgres-exporter:$ex" >/dev/null
    sleep 3
    echo "## postgres $pg / exporter $ex"
    curl -s localhost:9187/metrics | grep -E '^(pg_up|pg_scrape_collector_success)' || true
    docker logs exporter 2>&1 | grep -m1 'collector failed' || true
    docker rm -f exporter >/dev/null
  done
  docker rm -f "pg$pg" >/dev/null
done
$NET は事前に docker network create で作ったネットワークの名前です。DB と exporter は localhost ではなくこのネットワーク上のホスト名で繋いでいるので、同じ Pod を真似た近似です。stat_bgwriter が成功したかどうかで、結果をマス目に並べました。
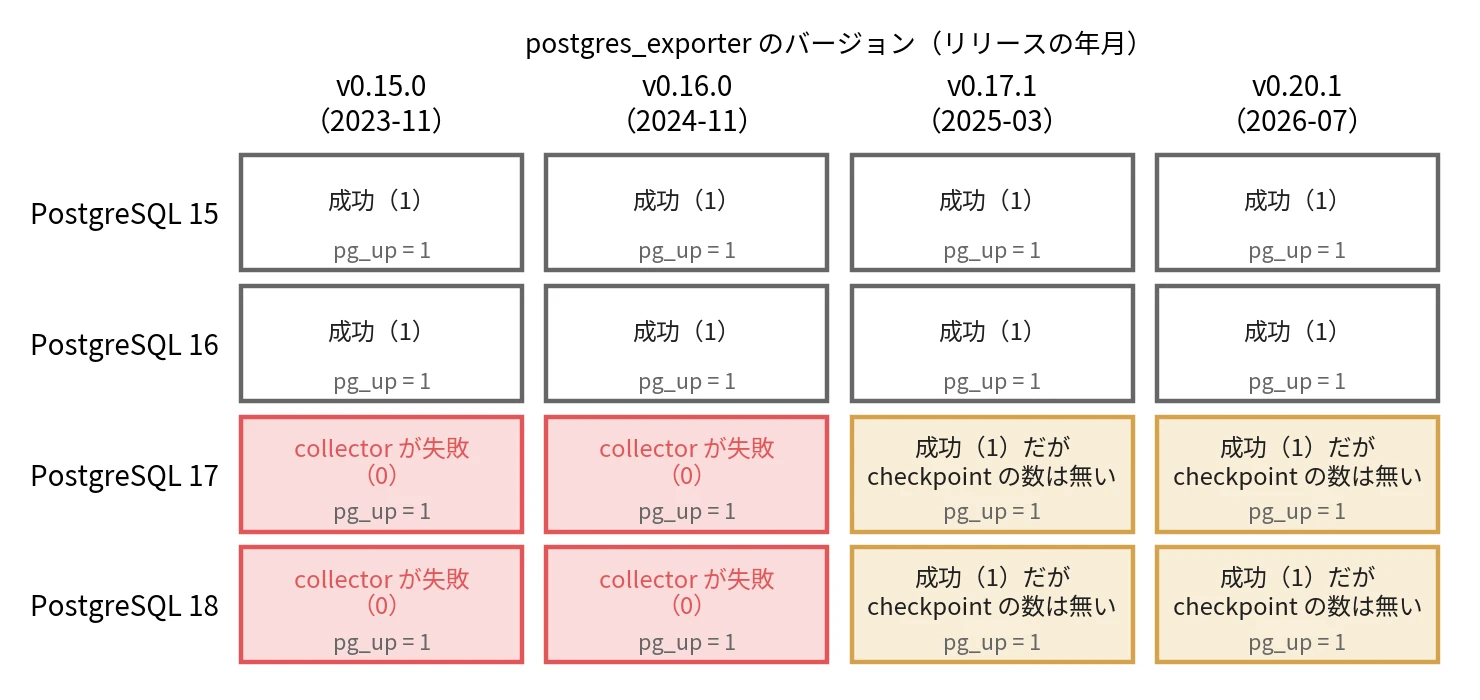
PostgreSQL と exporter のバージョンごとに見た stat_bgwriter の成否
上記の図で、赤いマスが collector の失敗する組み合わせです。16 マスの全てで pg_up は 1 でした。黄色いマスは collector が成功しているのに中身が足りない組み合わせで、2 つ後の節で扱います。赤いマスで気になるのは v0.16.0 で、PostgreSQL 17 が出た 2024 年 9 月 26 日より後の、2024 年 11 月に出たバージョンでも失敗します。
この不具合は、PostgreSQL 17 がベータだった 2024 年 8 月 18 日に Issue #1060 として報告されています。報告者は「16 から 17beta3 に上げた」と書いており、ログのエラーも上記と同じです。直した PR #1072 は 2025 年 1 月 1 日に取り込まれ、2025 年 2 月の v0.17.0 で出ました。DB の正式リリースから exporter の対応まで、約 5 か月の間がありました。
DB を上げる前に読む所にも、落とし穴がありました。PostgreSQL のリリースノートには、上げる時に注意が要る非互換の変更をまとめた「Migration to Version 17」(バージョン 17 への移行)の節があります。
17 のその節に載っている pg_stat_bgwriter の変更は、buffers_backend と buffers_backend_fsync の 2 列の削除だけです。checkpoint 関係の列を移したことは、後ろの「Monitoring」の項に新しい機能として書かれています。非互換の節だけを読んで上げると、この変更は目に入りません。
pg_up のアラートが鳴らない理由
冒頭の図で 5 段目に並べたのは、次の 3 つのアラートの規則が、どの時刻に待機中になり、どの時刻に鳴ったかです。for: 15s は、条件が 15 秒続いたら鳴らす、という指定です。条件を満たしてからこの 15 秒を待つ間が待機中で、Prometheus の画面では pending と表示され、鳴っている間は firing と表示されます。Prometheus は 5 秒ごとに値を集め、5 秒ごとに規則を評価しました。
groups:
  - name: postgres
    rules:
      # よく見る形: DB に繋がらない時に鳴らす
      - alert: PostgresDown
        expr: pg_up == 0
        for: 15s
      # collector ごとの失敗で鳴らす
      - alert: CollectorFailed
        expr: pg_scrape_collector_success == 0
        for: 15s
      # グラフに使っている系列が消えたら鳴らす
      - alert: CheckpointSeriesAbsent
        expr: absent(pg_stat_bgwriter_checkpoints_req_total)
        for: 15s
PostgresDown は、DB を入れ替えた直後の 65 秒に 1 回だけ待機中になり、鳴りませんでした。DB が止まっていたのは数秒で、15 秒続かなかったからです。その後の 175 秒間、checkpoint のグラフは空でしたが、pg_up は 1 なので、この規則は二度と条件を満たしません。
CollectorFailed は 80 秒に鳴り、120 秒に exporter を v0.17.1 に上げると消えました。CheckpointSeriesAbsent は、absent() で系列が 1 つも無いことを条件にしたもので、80 秒に鳴り、最後まで消えませんでした。2 つの規則が分かれた 120 秒から先は、次の節で扱います。
実験の全体は次のスクリプトです。DB を同じホスト名 db のまま入れ替えるので、exporter の設定は変えていません。checkpoint の回数が動くように、DB の中で 10 秒ごとに CHECKPOINT を打ちます。手で打った checkpoint は「要求された checkpoint」として数えられるので、グラフには checkpoints_req の系列を使いました。
db() { docker rm -f db >/dev/null 2>&1 || true
  docker run -d --rm --name db --network "$NET" -e POSTGRES_PASSWORD=secret "postgres:$1" >/dev/null
  until docker exec db pg_isready -U postgres >/dev/null 2>&1; do sleep 1; done
  docker exec -d db sh -c 'while true; do psql -U postgres -qc CHECKPOINT; sleep 10; done'; }
exporter() { docker rm -f exporter >/dev/null 2>&1 || true
  docker run -d --rm --name exporter --network "$NET" -e DATA_SOURCE_NAME="$DSN" \
    "prometheuscommunity/postgres-exporter:$1" "${@:2}" >/dev/null; }

db 16; exporter v0.15.0
T0=$(date +%s)
at 60 "db -> postgres:17"; db 17
at 120 "exporter -> v0.17.1"; exporter v0.17.1
at 180 "exporter -> v0.17.1 --collector.stat_checkpointer"; exporter v0.17.1 --collector.stat_checkpointer
at 240 "end"
$DSN は exporter が DB に繋ぐ接続文字列で、ホスト名に db を指定しています。at は、開始から指定の秒数まで待つ関数です。Prometheus の起動、prometheus.yml、240 秒後に query_range の API で値を読み出す部分を含む完全なスクリプトは、lab/timeline.sh にあります。
exporter を上げても戻らない理由
v0.17.1 に上げた後、stat_bgwriter の collector は成功に戻りました。それでもグラフが戻らないのは、成功した collector が返す中身が変わったからです。PostgreSQL 17 に v0.17.1 を繋いだ時、pg_stat_bgwriter_ で始まるメトリクスは次の 4 つだけでした。
pg_stat_bgwriter_buffers_alloc_total 87
pg_stat_bgwriter_buffers_clean_total 0
pg_stat_bgwriter_maxwritten_clean_total 0
pg_stat_bgwriter_stats_reset_total 1.794577808e+09
v0.17.0 で取り込まれた修正は、PostgreSQL 17 以降では pg_stat_bgwriter に残った列だけを読み、checkpoint の数は新しい collector の stat_checkpointer に移しました。
この collector は既定で無効で、--collector.stat_checkpointer を付けて起動した時だけ動きます。冒頭の図で 3 段目に 180 秒より後の値しか無いのは、このためです。
移った後のメトリクスは、名前も変わっています。DB を上げる前にダッシュボードが見ていた系列と、移った先の系列は次のように対応します。
| PostgreSQL 16 まで | PostgreSQL 17 以降 |
|---|---|
pg_stat_bgwriter_checkpoints_timed_total | pg_stat_checkpointer_num_timed_total |
pg_stat_bgwriter_checkpoints_req_total | pg_stat_checkpointer_num_requested_total |
pg_stat_bgwriter_checkpoint_write_time_total | pg_stat_checkpointer_write_time_total |
pg_stat_bgwriter_checkpoint_sync_time_total | pg_stat_checkpointer_sync_time_total |
pg_stat_bgwriter_buffers_checkpoint_total | pg_stat_checkpointer_buffers_written_total |
collector を有効にしても、ダッシュボードとアラートの式をこの名前に書き換えるまで、グラフは戻りません。冒頭の図で CheckpointSeriesAbsent が最後まで鳴り続けたのは、古い名前の系列が二度と現れないからです。
この collector が README に載ったのは、2025 年 12 月に取り込まれた PR #1226 で、2026 年 2 月の v0.19.0 からです。PR の説明には「bgwriter のメトリクスを使う人の時間を大きく省く」とあります。それまでの約 1 年間は、v0.17.0 の変更履歴にある 1 行と、--help に並ぶフラグの名前から辿るしかありませんでした。
adapter が形を変える時
形が変わるのは DB だけではありません。adapter 自身が、出す名前を変えることもあります。
2026 年 6 月の v0.20.0 は、変更履歴の BREAKING CHANGES で、collector の replication_slot を replication_slots に改め、pg_replication_slot_ で始まるメトリクスを pg_replication_slots_ に変えたと告知しています。
手元で取ったマス目の出力でも、v0.20.1 では collector の名前が replication_slots でした。collector="replication_slot" で書いたアラートは、バージョンを上げると黙って空になります。
Kubernetes でも同じ形の変更がありました。kubelet に組み込まれた cAdvisor は、コンテナが使った資源の量を Prometheus の形にして出す部品です。Kubernetes 1.16 は、そのメトリクスのラベル pod_name と container_name を消し、pod と container に揃えました。この変更は PR #80376 で入っています。
1.16 の変更履歴は、これらのラベルを使う Prometheus の問い合わせを書き換えるよう求めています。
上げる前に見ておくこと
adapter を置く人も、既に動いている exporter に出会った人も、冒頭の図で 2 段目のような途切れ方を防ぐために見ておくことは 4 つです。
DB を上げる時は、exporter の変更履歴を DB のバージョン名で検索します。「PostgreSQL 17」「PG17」で引けば、今回の件は v0.17.0 の 1 行に当たります。DB のリリースノートは、非互換の節に加えて、監視(Monitoring)の項まで読みます。
アラートは、pg_up == 0 だけにしません。collector ごとの pg_scrape_collector_success == 0 と、ダッシュボードで大事な系列ごとの absent() を足しておくと、冒頭の図で 5 段目にあるように、DB を上げてから 20 秒で鳴りました。3 つの規則のうち、名前が変わった後まで鳴り続けたのは absent() だけでした。
DB と exporter のどちらかを上げる前後で、/metrics に出る名前の集合を比べます。マス目の黄色いマスのように、collector が成功していても中身が減っていることがあるからです。前後の /metrics からメトリクス名だけを抜き出し、comm で差を取ります。1 行目は、DB と exporter のバージョンを引数の $1 と $2 に取り、pg16-v0.15.0 のような名前のファイルに保存します。
curl -s localhost:9187/metrics | grep -E '^pg_' | sed -E 's/[{ ].*//' | sort -u > "pg$1-$2"
comm -23 pg16-v0.15.0 pg17-v0.17.1   # 左にあり右に無い名前
PostgreSQL 16 と v0.15.0 の組から、17 と v0.17.1 の組に上げた前後で比べると、消えた名前は 9 個でした。7 個は pg_stat_bgwriter_ で始まる名前です。前の節で表に並べた 5 個に、PostgreSQL 17 で列ごと削除された buffers_backend と buffers_backend_fsync の 2 個が加わります。
残る 2 個は PostgreSQL 17 で無くなった設定の db_user_namespace と old_snapshot_threshold です。この一覧が、そのまま書き換えるダッシュボードとアラートの一覧になります。
最後に、adapter が本当に必要かを考えます。自分たちで書いたアプリなら、client library で直接出せば、変換の知識を他人のコードに預けずに済みます。出力の形式が既に 1 つに揃っている時や、変換の規則が複雑で対応表の保守がアプリの改変より重い時も、adapter を置く利益は小さくなります。統一された形式に無い項目は、捨てるか独自の名前で載せることになる点も見ておきます。
adapter が必要なのは PostgreSQL のように中を変えられないソフトウェアを監視する時で、その時は exporter も DB と同じく、バージョンを上げる対象として扱います。
実験のスクリプト、Prometheus の設定、出力の全体は lab/ にあります。