アップスケール(upscale)は、画像や動画の画素数を増やして大きくする処理です。画素の間を計算で埋める補間のほかに、学習したモデルが足りない細部を推測して描き足す超解像(super-resolution)があります。画像生成では、小さく生成した絵を Real-ESRGAN のような拡大モデルで大きくし、さらに拡散モデルで弱く描き直して仕上げる流れがよく使われます。
以下は、元の動画を縮めてノイズを乗せ、3 通りの方法で 1 枚ずつ 4 倍に戻して、元の動画(正解)と並べ、隣り合う 2 フレームの差を一部の範囲で白黒に描いた図です。差が大きい画素ほど白く光ります。
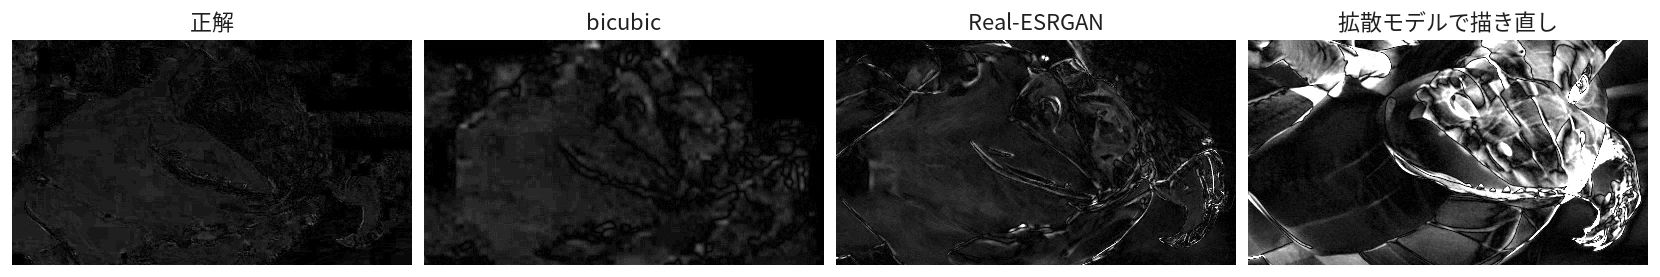
隣り合う 2 フレーム(20 と 21 フレーム目)の差。ノイズ有りの入力で、明るいほど差が大きく、8 倍に強調。Real-ESRGAN は x4plus_anime_6B のモデル
左端の正解は、ドラゴンが動いた輪郭がわずかに光るだけです。補間(bicubic)と拡大モデル(Real-ESRGAN)は輪郭の周りが少し光る程度ですが、拡大した後に拡散モデルで 1 枚ずつ描き直したものは、切り出した範囲のほぼ全体が光っています。後で載せる動画を再生すると、止まっているはずの所がざわざわと動いて見えます。描き足された細部が、フレームごとに別のものになっているからです。
本記事では、画像生成を使うエンジニアに向けて、1 枚ずつ拡大した動画がちらつく理由を説明します。手元で拡大した結果を数値と画像で比べます。扱う疑問は次の通りです。
- 補間と超解像は、何が違うのか。
- 1 枚ずつ拡大すると、なぜフレームの間で細部がずれるのか。
- 拡大モデルと、拡散モデルでの描き直しで、ちらつきはどれだけ違うのか。
- 入力のノイズや、先にノイズを除く処理は、何を変えるのか。
- 動画用の超解像は、何をしてちらつきを抑えているのか。
拡大モデルの学習方法の詳細や、拡大を提供するサービスの比較は説明しません。
補間と超解像の違い
縦横 4 倍に拡大すると、画素の数は 16 倍になります。元の 1 画素に対して、新しい 15 画素の値を決めなければなりません。
補間(bicubic など)は、周りの画素の値から、間の値を滑らかな式で計算します。元に無かった細部は作らないので、拡大した画像はぼやけますが、同じ入力からは必ず同じ出力が出ます。入力が少し変われば、出力も少しだけ変わります。
超解像のモデルは、高解像度の画像と、それを縮めて劣化させた画像の組で学習し、劣化した画像から元の画像らしいものを描くように作られています。Real-ESRGAN の論文(2021 年)は、ぼかし・縮小・ノイズ・JPEG の圧縮の組を 2 回重ねて劣化させた画像を学習に使い、実際の写真のノイズや圧縮の跡も消せるようにしました。Real-ESRGAN は GAN(Generative Adversarial Network)の一種で、描いた画像を本物と見分ける別のモデルと競わせて、本物らしい細部を描くように学習します。
ただし、小さい画像から大きい画像は 1 つに決まりません。縮めると同じ小さい画像になる大きい画像は、無数にあります。超解像のモデルは、その中から「それらしい 1 枚」を選んで描きます。毛糸の編み目や鱗の模様のように、入力に写っていない細部は、学習したものから推測した創作です。
1 枚ずつ拡大するとちらつく理由
動画を 1 枚ずつ拡大すると、モデルはフレームごとに別々に「それらしい 1 枚」を選びます。隣のフレームで何を描いたかは知りません。同じ人物を何枚も描く時に顔や服が揃わないのと同じ理由です(Character Consistency のノート)。
入力が隣のフレームとまったく同じなら、同じ細部が描かれます。しかし実際の動画の入力には、撮影や生成で乗ったノイズと圧縮の跡があり、それはフレームごとに違います。補間なら小さな違いは小さなままですが、超解像のモデルは、ノイズの粒を細部の手掛かりとして読み、模様の向きや位置を変えて描くことがあります。こうして、止まった物の表面で、フレームごとに模様が入れ替わって見えます。
拡散モデルで描き直す場合は、描き足す量がずっと多くなります。img2img の描き直しでは、入力の絵にノイズを足してから、拡散モデルがノイズを取り除きながら描き直します。denoise はどれだけノイズを足すかの割合(0〜1)で、0.35 なら元の絵をかなり残します。それでも、モデルはノイズを足した画像から顔や鱗を描き直すので、入力のわずかな違いが、目の形や模様の配置の違いにまで広がります。足すノイズを決める乱数の種(seed)を全フレームで同じにしても、入力の画像そのものがフレームごとに違うので、同じ絵にはなりません。
Upscale-A-Video の論文(2023 年)も、拡散モデルを動画の超解像に使う時に時間方向の一貫性を保つのが難しい理由として、拡散モデルが本来持つランダムさを挙げています。
実験: 縮めた動画を 4 倍に戻す
1 枚ずつの拡大がどれだけちらつくかを確かめるために、2026 年 11 月に、高解像度の動画を縮めて劣化させ、4 倍に戻して元の動画と比べました。素材は、Blender Foundation のオープンムービー『Sintel』の予告編(1080p、CC BY 3.0、© copyright Blender Foundation | durian.blender.org)です。34.0 秒からの 48 フレーム(2 秒)で、鱗のあるドラゴンと、毛糸の手袋をはめた手が写っています。
| 名前 | 作り方 |
|---|---|
| 正解 | 中央の 1280×720 を切り出し、1024×576 に縮めた 48 フレーム |
| ノイズ無し | 正解を 256×144 に縮めただけの入力 |
| ノイズ有り | ノイズ無しに、フレームごとに独立なガウスノイズ(標準偏差 σ=4。画素値は 0〜255)を足し、H.264(CRF 26。値が大きいほど強く圧縮)で圧縮した入力 |
| 除去後 | ノイズ有りに、FFmpeg の 3 次元(縦・横・時間)のノイズ除去(hqdn3d。時間方向を強め、空間方向にも弱く掛けた)を掛けた入力 |
ノイズ有りは、撮影や生成で乗るノイズと、配信で掛かる圧縮をまねたものです。以下は、拡大する前の 2 つの入力の同じ範囲で、画素をそのまま 4 倍に引き伸ばして並べています。ノイズは 1 枚ではにじみとしか見えませんが、フレームごとに違う粒で乗っています。
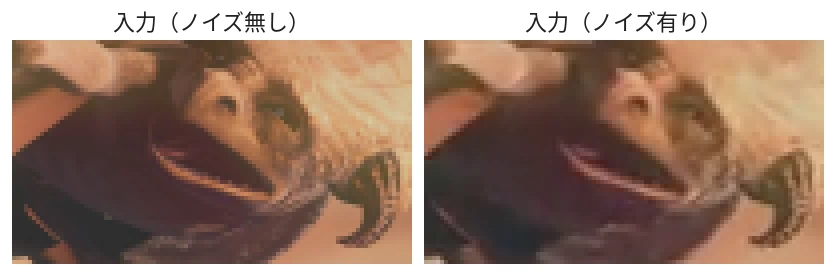
拡大する前の入力(左: ノイズ無し、右: ノイズ有り。20 フレーム目)
次の 4 つの方法で、この入力を 4 倍の 1024×576 に戻しました。冒頭の図の Real-ESRGAN は x4plus_anime_6B、拡散モデルで描き直したものは 6B + 描き直しです。
| 方法 | 中身 |
|---|---|
| bicubic | Pillow の bicubic 補間 |
| animevideov3 | Real-ESRGAN のアニメ動画向けの小さなモデル(realesr-animevideov3)。動画向けだが、前後のフレームは使わず 1 枚ずつ拡大する |
| x4plus_anime_6B | Real-ESRGAN のアニメ画像向けのモデル(RealESRGAN_x4plus_anime_6B) |
| 6B + 描き直し | x4plus_anime_6B で拡大した後、ComfyUI で画像生成の拡散モデル(Stable Diffusion XL、略して SDXL の系統)に denoise 0.35 の img2img で描き直させる(seed は全フレームで同じ) |
拡大モデルは、spandrel(拡大モデルの重みを読み込むライブラリ)で読み、CPU で 1 枚ずつ動かしました。素材は CG の映像ですが、2 つともアニメ向けのモデルです。冒頭の図では、animevideov3 を省いています。
描き直しは、hires fix と同じ「拡大してから弱く描き直す」手順で、モデルは Illustrious 系(SDXL から派生し、アニメ絵を多く学習したモデルの系統)の中で写実寄りのモデルです。
描き直しの設定
- モデル: Civitai で配布されている Illustrious Realism by klaabu の V1.0 + VAE 版(手元のファイル名 illustriousRealismBy_v10VAE から判断)
- サンプラー euler、20 ステップ、CFG 5、denoise 0.35
- プロンプトには場面を説明する語を入れた
全体の手順は lab/run.sh にあります。以下は、1 枚ずつ拡大する lab/upscale.py の中心です。
# lab/upscale.py から抜粋。フレームを 1 枚ずつ読み、前後のフレームを見ずに 4 倍にする
for p in sorted(src.glob("*.png")):
    img = Image.open(p).convert("RGB")
    if method == "bicubic":
        out = img.resize((img.width * 4, img.height * 4), Image.Resampling.BICUBIC)
    else:
        x = torch.from_numpy(np.asarray(img, dtype=np.float32) / 255).permute(2, 0, 1)[None]
        with torch.no_grad():
            y = model(x)[0].clamp(0, 1).permute(1, 2, 0).numpy()
        out = Image.fromarray((y * 255).round().astype(np.uint8))
    out.save(dst / p.name)
ちらつきは、2 つの数で測りました(lab/metrics.py)。1 つは、正解で隣のフレームとほとんど変わらない画素(輝度の差が 1.5 未満。全画素の 52%)だけを取り出し、拡大した動画で隣のフレームとの輝度がどれだけ変わったかの平均です。止まっている所がどれだけ動いて見えるかを表します。
もう 1 つは全画素が対象で、隣のフレームとの差が、正解の隣のフレームとの差からどれだけずれたかの平均で、カメラや物の動きでは説明できない変化の量です。式で書くと、|(拡大の t − t−1)−(正解の t − t−1)| の平均です。どちらも 0〜255 の輝度の単位で、小さいほど正解に近い動きです。
以下は、2 つの数を方法と入力ごとに並べた図です。描き直しは、ノイズ無しとノイズ有りの入力だけで試しました。
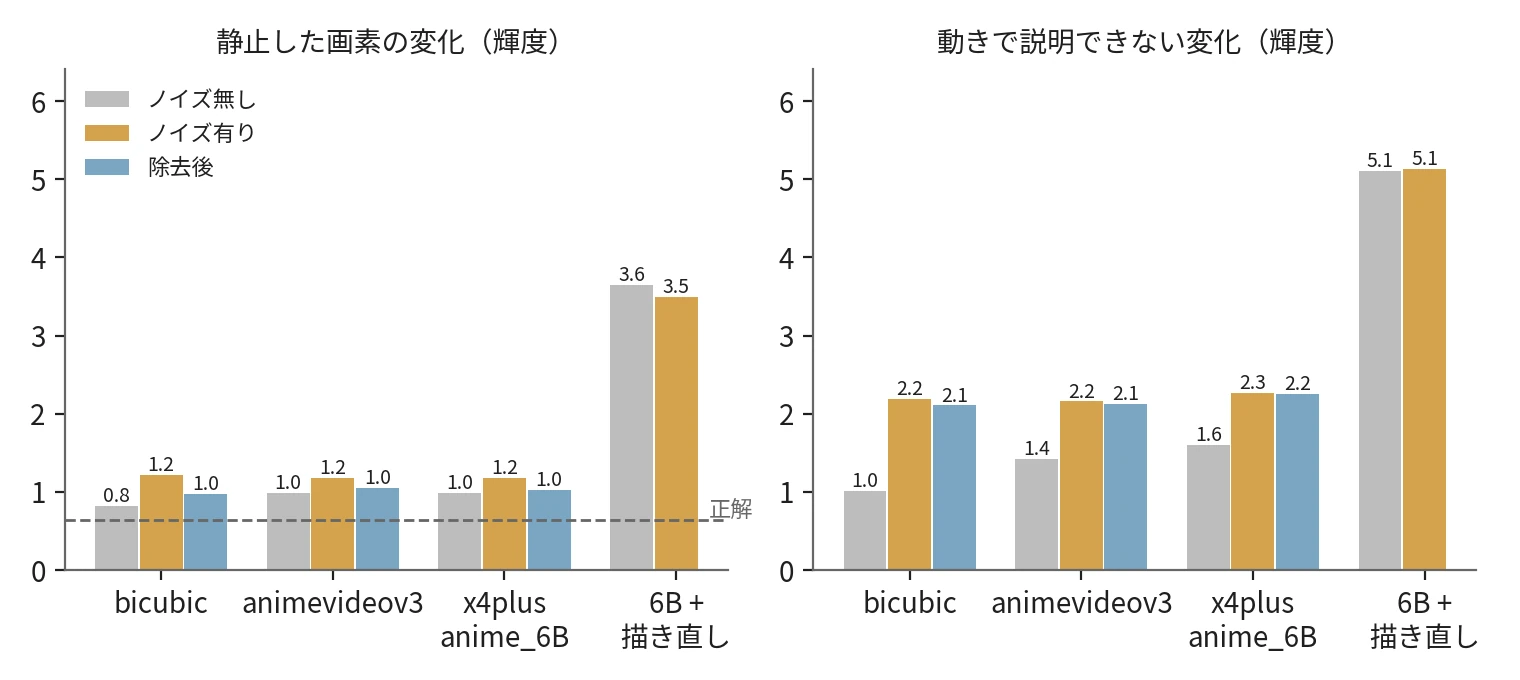
方法と入力ごとのちらつき(48 フレーム、輝度 0〜255 の単位。左の破線は正解の値で、右は正解なら 0。描き直しは除去後を試していない)
一番大きな差は、描き直したかどうかです。静止した画素の変化は、正解の 0.64 に対して、拡大モデルは 1.0〜1.2 でしたが、描き直したものは 3.5〜3.6 と、正解の 5 倍を超えました。入力のノイズの有無はほとんど関係なく、ノイズ無しの入力でも描き直しは大きく揺れています。
拡大モデル(animevideov3 と x4plus_anime_6B)の静止した画素の変化は、ノイズ有りでは bicubic とほとんど変わらず、ノイズ無しでも 0.8 から 1.0 に増えただけでした。動きで説明できない変化は少し大きくなっています(ノイズ無しで 1.0 に対して 1.4〜1.6)。2 秒の CG 映像 1 本にアニメ向けのモデルを掛けたこの条件では、GAN の拡大モデルを 1 枚ずつ掛けること自体は、描き直しと比べると大きなちらつきを生んでいません。
以下は、同じフレームの同じ範囲を並べたものです。
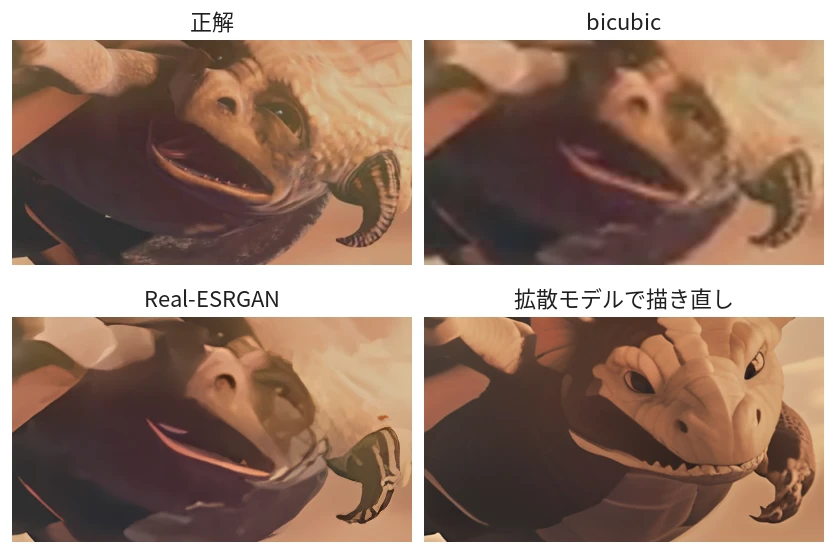
同じフレームの比較(ノイズ有りの入力、20 フレーム目。Real-ESRGAN は x4plus_anime_6B、拡散モデルで描き直しは 6B + 描き直し)
描き直したものは、ドラゴンの顔が別の顔に描き変わっています。denoise 0.35 でも顔の形まで変わりました。描き直しに使ったモデルは、アニメ絵を多く学習した Illustrious 系なので、学習した絵柄に寄せて描くことも効いていると見ています。こうした創作が 48 フレームで少しずつ違うので、再生すると顔の模様が泳ぎます。以下は、4 つを並べて動かしたアニメーションです(繰り返し再生します)。
ノイズ有りの入力から作った 4 つを並べて動かしたもの(24 fps、2 秒で繰り返す)
入力のノイズは、拡大モデルと bicubic のどちらでも、ちらつきを増やしました。静止した画素の変化は 0.8〜1.0 から 1.2 に、動きで説明できない変化は 1.0〜1.6 から 2.2〜2.3 に増えています。拡大モデルだけが特に増えたわけではなく、ノイズが拡大の前からフレームごとに違うことの影響です。前の節で書いた「ノイズの粒を手掛かりに模様を変えて描く」効果は、今回のアニメ向けのモデルでは目立ちませんでした。写実向けのモデルでは結果が変わる可能性があります。
先に hqdn3d でノイズを除くと、静止した画素の変化は 1.2 から 1.0 前後に下がりました。一方で、動きで説明できない変化はほとんど下がらず(2.2〜2.3 から 2.1〜2.2)、正解との近さを表す PSNR(dB。高いほど正解に近い)は bicubic で 35.2 dB から 34.2 dB に下がっています。
hqdn3d の時間方向の除去は、前のフレームを混ぜてノイズをならします。止まった所は落ち着きますが、動いた所には前のフレームの絵が混ざるので、正解から離れやすくなります。PSNR が下がったのは、これが効いていると見ています(動いた所だけの誤差は測っていません)。全ての値は lab/output_metrics.txt にあります。
動画用の超解像
1 枚ずつの拡大がちらつくのは、フレームを互いに知らないまま描くからでした。動画用の超解像(VSR、Video Super-Resolution)は、隣のフレームの情報を使って描くことで、この問題を扱います。
BasicVSR(2020 年)は、光学フロー(フレーム間で画素がどう動いたかの推定)で前後のフレームから得た特徴(モデルが画像から取り出した中間の数値の表現)の位置を合わせ、動画の前向きと後ろ向きに順に伝えながら拡大します。同じ物の表面は、何枚ものフレームで見た情報を合わせて描くので、フレームごとに模様が入れ替わりにくくなります。
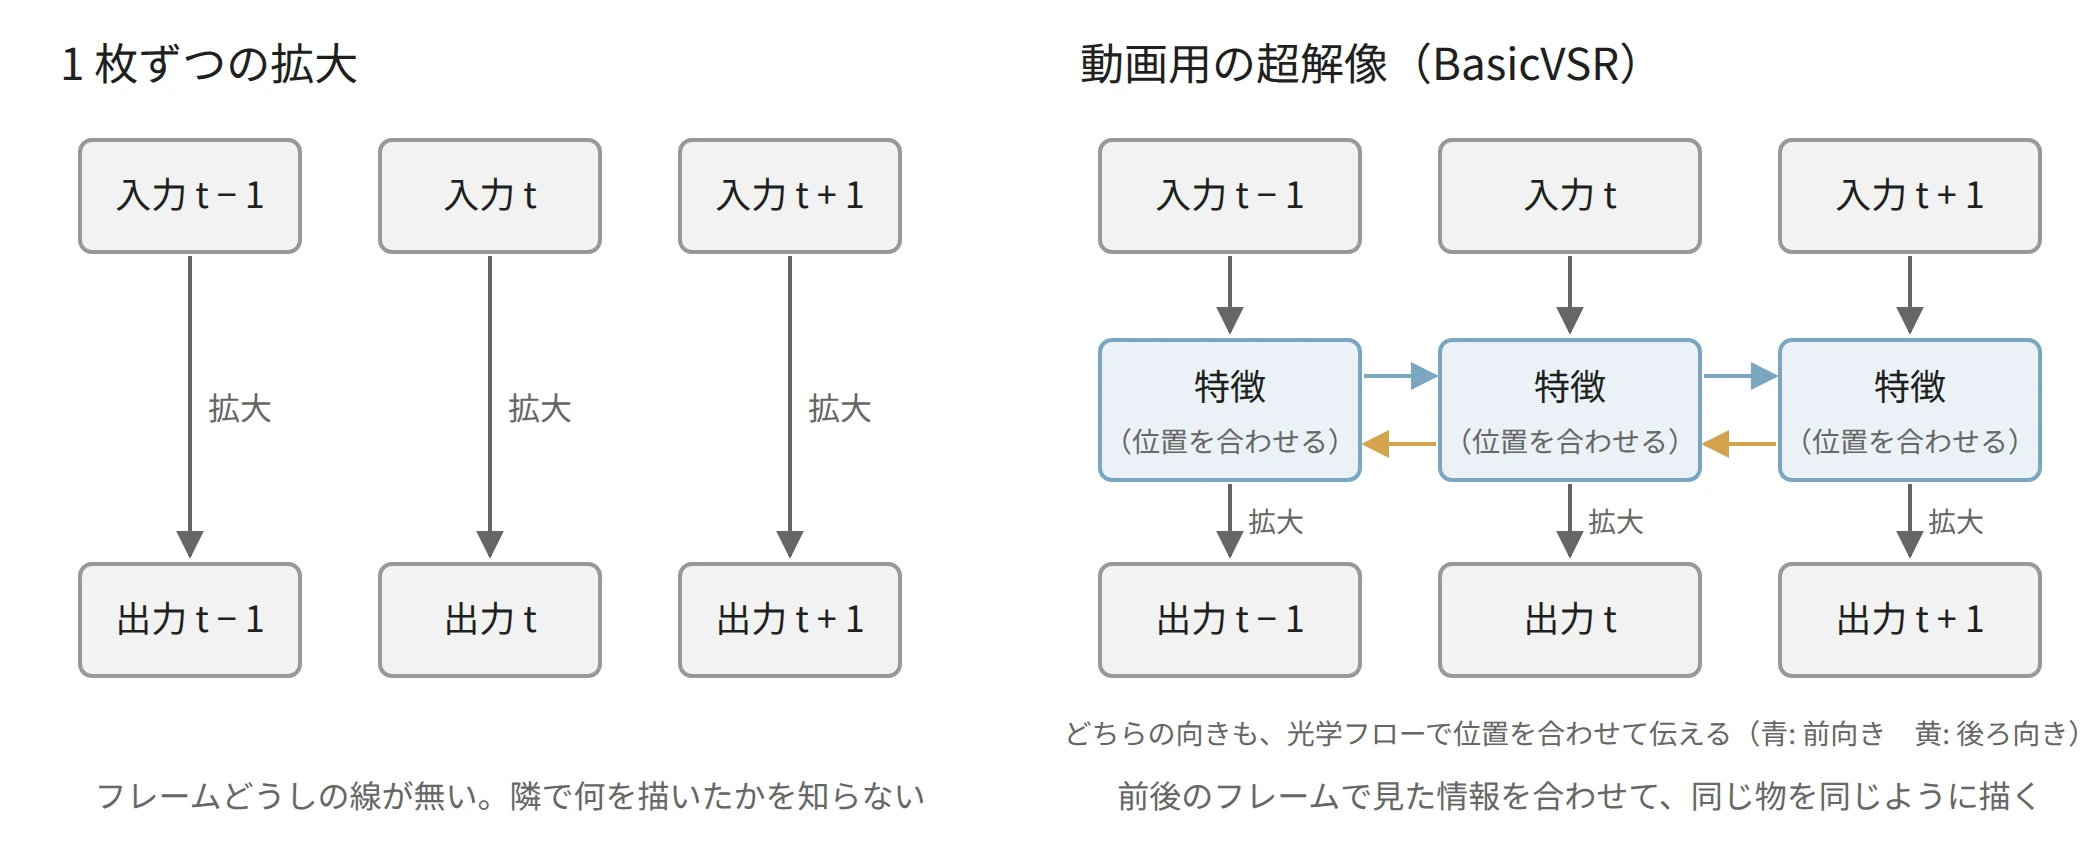
1 枚ずつの拡大と、前後の情報を双方向に伝える動画用の超解像(BasicVSR の論文の構成を縮めた概念図)
ただし、伝える情報にノイズが混じっていると、ノイズも一緒に伝わります。BasicVSR の筆頭著者らによる RealBasicVSR(2021 年)は、実際の動画の強い劣化は伝えるうちに強調されることがあるとして、伝える前に画像を掃除する段が欠かせないと書いています。
To balance the tradeoff between detail synthesis and artifact suppression, we found an image pre-cleaning stage indispensable to reduce noises and artifacts prior to propagation.
(細部の合成とアーティファクト(圧縮の跡などの人工的な乱れ)の抑制を両立させるには、伝える前にノイズとアーティファクトを減らす、画像の前掃除の段が欠かせないことが分かった。)
拡散モデルを使う方法も、フレームの間をつなぐ仕組みを足しています。Upscale-A-Video、SeedVR(2025 年)、それを速く描けるように学習し直した SeedVR2(2025 年)は、どれも複数のフレームをまとめてモデルに入れ、フレームの間を揃える層を持ちます。この点が、1 枚ずつの拡大と違います。
利点
ここまで実験した、動画を 1 枚ずつ画像用の拡大モデルで拡大する方法の利点です。
- 画像用の拡大モデルや画像生成のワークフローがそのまま使える
- フレームを互いに独立に処理するので、並列に分けやすく、途中から再開しやすい
- GAN の拡大モデルなら、この実験ではちらつきの増え方は bicubic と大きく変わらない
- 今回のような小さなモデルなら、手元の CPU でも動かせる
欠点
1 枚ずつの拡大は、フレームの間のつながりをモデルに渡さない代わりに、扱いやすさを取っています。そのため、次の制約があります。
- 描き足した細部がフレームごとに違うので、拡散モデルで描き直すと、止まった所まで揺れる
- 入力のノイズや圧縮の跡がフレームごとに違うと、拡大した後もちらつきとして残る
- 時間方向のノイズ除去で抑えると、動いた所に前のフレームが混ざり、正解から離れやすい(今回は PSNR が下がった)
- 拡大モデルが描き足すのは推測なので、元の映像に無い形(顔や模様)が生まれることがある
1 枚ずつの拡大が適さないケース
- 拡大した後に、拡散モデルで細部を描き直して仕上げたい動画
- 撮影や生成でノイズが多く乗り、しかもフレームごとに粒が違う動画
- 人の顔や文字のように、細部が少し変わるだけで違和感が大きい被写体
- 長いカットで、同じ物の表面が長く画面に映り続ける動画
静止画で効く「拡大してから弱く描き直す」仕上げは、動画では 1 枚ずつ掛けた途端に、描き直した分だけ揺れになります。動画で細部を足したい時は、複数のフレームをまとめて扱う動画用の超解像を選ぶか、描き直しをやめて拡大モデルだけで止める方が、違和感は小さくなります。