トークナイザー(tokenizer)は、テキストを LLM(Large Language Model、大規模言語モデル)が扱える断片の列に分けるプログラムです。この断片をトークン(token)と呼び、LLM はテキストを文字ではなくトークンの列として読み書きします。API の料金、一度に入力できる量、生成の速さも、文字数ではなくトークン数で計算されます。
以下は、同じ意味の日本語と英語の 1 文について、文字・バイト(文字を 1〜4 バイトで表す符号化方式の UTF-8 で表した時のバイト)・トークンの 3 段で区切りの位置を描いた図です。トークンの区切りには、OpenAI の GPT-4 で使われた cl100k_base というトークナイザーを使いました。
同じ意味の日本語と英語の、文字・バイト・トークンの数
英語は 1 語が 1 トークンにまとまり、28 文字が 5 トークンになりました。一方で、日本語の「秘」と「鍵」は文字の途中で切られ、1 文字が 2〜3 個のトークンに割れています(黄土色の箱)。同じ意味の文でも、トークン数は 13 対 5 です。
本記事では、トークナイザーの代表的な方式である BPE(Byte Pair Encoding)の仕組みと、トークン数が言語や内容でどれだけ変わるかを説明します。小さな BPE を標準ライブラリで学習させる実験と、公開されているトークナイザーで同じ内容の文を数える実験を通して、次の疑問に答えます。
- LLM は、なぜ文字や単語ではなくトークンを単位にするのか。
- BPE は、どうやって語の切れ目を決めるのか。
- 日本語・英語・コード・数字・絵文字で、トークン数はどれだけ違うのか。
- トークン数は、料金・コンテキスト・生成の速さにどう効くのか。
トークンから先の処理(トークンをベクトルに変換して、次のトークンを予測する計算)は説明しません。
トークナイザーが必要な理由
LLM の入力と出力は、決まった大きさの語彙(vocabulary)の中の番号です。モデルは語彙の数だけ選択肢を持ち、「次に来るのはどの番号か」を確率で予測します。そのため、学習の前に、テキストのどの単位を語彙に登録するか決めておく必要があります。
単位の候補は、大きく 3 つあります。
| 単位 | 語彙の大きさ | 列の長さ | 困ること |
|---|---|---|---|
| 単語 | 数十万〜無制限 | 短い | 新語・固有名詞・typo が語彙に無いと扱えない。日本語は単語の切れ目が空白で分からない |
| 文字 | Unicode 全体で 15 万字以上 | 中間 | 英語は 1 文字ずつになり列が長い。学習に出なかった文字を扱えない |
| バイト | 256 | 最も長い | どんな入力も表せるが、日本語の 1 文字が 3 バイトになり、列が 3 倍に伸びる |
列が長いほど、モデルは 1 回の処理で多くの番号を読み、生成では多くの回数を繰り返します。一方で、語彙を大きくすると、モデルの入口と出口にある語彙の数だけの行列が大きくなります。トークンは、この間を取る単位です。よく出る文字の並びは 1 トークンにまとめて列を短くし、まれな並びはバイトまで分解して、どんな入力も語彙の中で表せるようにします。
BPE が語を切る仕組み
BPE は、もともとデータ圧縮の手法で、Sennrich 氏らの論文(2015 年)が機械翻訳の語彙作りに持ち込みました。考え方は単純で、学習用の文章の中で最も多く隣り合っている 2 つの記号は、1 つの新しい記号に結合します。これを決めた回数だけ繰り返し、結合の記録(merges)と、できた記号の一覧(語彙)を残します。
GPT-2 の論文(2019 年)は、文字ではなくバイトから始める byte-level BPE を使いました。後の実験 2 で使う o200k_base・cl100k_base・Qwen3 も byte-level BPE です。最初の語彙が 256 種類のバイトなので、どんなテキストも必ず表せます。日本語の文字は UTF-8 でほとんどが 3 バイトなので、学習用の文章によく出る文字だけが、結合を経て 1 トークンになります。冒頭の図で「秘」が割れたのは、cl100k_base の学習データで「秘」の 3 バイトが結合されるほど出てこなかったからだと考えられます。
新しいテキストを区切る時は、学習で早く覚えた結合から順に当てはめます。学習用の文章に多かった並びほど、まとまったトークンになります。
前処理による区切り
BPE の結合は、テキスト全体に対して無制限に行うわけではありません。実験 2 の tiktoken と Qwen3 のトークナイザーは、先に正規表現でテキストを単語・数字・記号・空白の断片に分け(pre-tokenization)、断片の中だけで結合します。例えば、tiktoken の o200k_base と cl100k_base は数字を最大 3 桁ずつの断片にし、Qwen3 は数字を 1 桁ずつの断片にします。この規則の違いは、後の実験の数字の結果にそのまま現れます。
実験 1: 小さな BPE を学習する
結合が進む様子を見るために、byte-level BPE を Python の標準ライブラリだけで書き、debimate の Wallet ノート(37,097 文字、67,916 バイト)を学習用の文章にして 1,000 回結合しました。前処理は、\w+(文字と数字の並び)・記号の並び・空白の 3 種類で断片に分ける簡単な正規表現です。以下は学習と区切りの部分の抜粋です。全体は下に折りたたんでいます。
# lab/bpe_train.py から抜粋(全体は下の折りたたみ)
def train(text, n):
    # 空白・記号で区切った断片の中だけで結合する(断片をまたぐトークンは作らない)
    pieces = Counter(re.findall(r"\w+|[^\w\s]+|\s+", text))
    words = {tuple(p.encode()): c for p, c in pieces.items()}  # 最初は 1 バイト = 1 記号
    vocab = {i: bytes([i]) for i in range(256)}
    merges = []
    for _ in range(n):
        counts = Counter()
        for w, c in words.items():
            for p in pairs_of(w):
                counts[p] += c
        if not counts:
            break
        # 最も多く隣り合う組を 1 つの新しい記号にする(同数なら記号の番号が小さい組)
        pair = min(counts, key=lambda p: (-counts[p], p))
        new = len(vocab)
        vocab[new] = vocab[pair[0]] + vocab[pair[1]]
        merges.append((pair, new, counts[pair]))
        words = {merge(w, pair, new): c for w, c in words.items()}
    return vocab, merges


def encode(s, merges):
    rank = {pair: (r, new) for r, (pair, new, _) in enumerate(merges)}
    out = []
    for piece in re.findall(r"\w+|[^\w\s]+|\s+", s):
        w = tuple(piece.encode())
        while True:  # 学習で早く覚えた組から順に結合する
            cands = [rank[p] for p in pairs_of(w) if p in rank]
            if not cands:
                break
            r, new = min(cands)
            w = merge(w, merges[r][0], new)
        out.extend(w)
    return out
bpe_train.py と texts.py の全体
"""バイト単位の小さな BPE を学習し、結合が進む様子を表示する(標準ライブラリだけ)。

使い方:
    git show 9bbbeb23:content/notes/blockchain-systems/wallet/index.md > wallet.md
    python3 bpe_train.py wallet.md [結果の JSON]
"""
import json
import re
import sys
from collections import Counter

from texts import SHORT, TEXTS

MERGES = 1000
CHECKPOINTS = [0, 10, 50, 100, 300, 1000]


def pairs_of(word):
    return zip(word, word[1:])


def merge(word, pair, new):
    out, i = [], 0
    while i < len(word):
        if i + 1 < len(word) and (word[i], word[i + 1]) == pair:
            out.append(new)
            i += 2
        else:
            out.append(word[i])
            i += 1
    return tuple(out)


def train(text, n):
    # 空白・記号で区切った断片の中だけで結合する(断片をまたぐトークンは作らない)
    pieces = Counter(re.findall(r"\w+|[^\w\s]+|\s+", text))
    words = {tuple(p.encode()): c for p, c in pieces.items()}  # 最初は 1 バイト = 1 記号
    vocab = {i: bytes([i]) for i in range(256)}
    merges = []
    for _ in range(n):
        counts = Counter()
        for w, c in words.items():
            for p in pairs_of(w):
                counts[p] += c
        if not counts:
            break
        # 最も多く隣り合う組を 1 つの新しい記号にする(同数なら記号の番号が小さい組)
        pair = min(counts, key=lambda p: (-counts[p], p))
        new = len(vocab)
        vocab[new] = vocab[pair[0]] + vocab[pair[1]]
        merges.append((pair, new, counts[pair]))
        words = {merge(w, pair, new): c for w, c in words.items()}
    return vocab, merges


def encode(s, merges):
    rank = {pair: (r, new) for r, (pair, new, _) in enumerate(merges)}
    out = []
    for piece in re.findall(r"\w+|[^\w\s]+|\s+", s):
        w = tuple(piece.encode())
        while True:  # 学習で早く覚えた組から順に結合する
            cands = [rank[p] for p in pairs_of(w) if p in rank]
            if not cands:
                break
            r, new = min(cands)
            w = merge(w, merges[r][0], new)
        out.extend(w)
    return out


def show(b):
    return b.decode("utf-8", "backslashreplace")


def main():
    text = open(sys.argv[1], encoding="utf-8").read()
    vocab, merges = train(text, MERGES)
    print(f"corpus: {len(text):,} chars, {len(text.encode()):,} bytes")
    print("first merges (new symbol <- pair, count)")
    for k, (pair, new, c) in enumerate(merges[:12], 1):
        a, b = (show(vocab[x]) for x in pair)
        print(f"  #{k:<3} [{show(vocab[new])}] <- [{a}] + [{b}]  ({c})")
    for m in CHECKPOINTS:
        print(f"\nafter {m} merges")
        for key in ("ja", "en"):
            ids = encode(SHORT[key], merges[:m])
            print(f"  {key} {len(ids):>3}  " + "|".join(show(vocab[i]) for i in ids))
    # グラフ用: Wallet の 2 文と英訳のトークン数を、結合の回数ごとに数える
    steps = list(range(0, MERGES + 1, 25))
    curve = {k: [len(encode(TEXTS[k], merges[:m])) for m in steps] for k in ("ja", "en")}
    print("\nWallet passage: " + ", ".join(
        f"{k} {v[0]} -> {v[-1]} tokens" for k, v in curve.items()))
    if len(sys.argv) > 2:
        with open(sys.argv[2], "w") as f:
            json.dump({"merges": steps, "tokens": curve}, f)


if __name__ == "__main__":
    main()
"""count_tokens.py と bpe_train.py が使う文。"""
# 日本語は debimate の Wallet ノート冒頭の 2 文。英語は本記事のために作った訳。
TEXTS = {
"ja": "ウォレット(wallet)は、Bitcoin などの暗号資産を受け取り、残高を確認し、"
"他の相手に送るためのソフトウェアです。PC やスマートフォンの画面で操作するタイプと、"
"コマンドを入力して操作するタイプがあります。",
"en": "A wallet is software for receiving crypto assets such as Bitcoin, checking "
"the balance, and sending them to others. Some wallets are operated on the "
"screen of a PC or smartphone, and others by typing commands.",
# LoRA ノートの lab/count_params.py の関数
"code": 'def read_header(path):\n'
' with open(path, "rb") as f:\n'
' (length,) = struct.unpack("<Q", f.read(8))\n'
' header = json.loads(f.read(length))\n'
' metadata = header.pop("__metadata__", {})\n'
' return length, header, metadata\n',
"digits": "2026-11-10 14:05:09 load average: 100.70, 226.82, 290.79 "
"size 6938040682 bytes",
"emoji": "👍 👍🏽 👨👩👧 🇯🇵 🦉",
}
# 冒頭の図に使う短い文(区切りの位置を出力する)
SHORT = {"ja": "秘密鍵を安全に保管する", "en": "Store the private key safely",
"digits": "6938040682", "emoji": "👍🏽👨👩👧"}
以下が実行結果の抜粋です。\xe3 のような表記は、1 文字に満たないバイトの断片です。
$ python3 bpe_train.py wallet.md bpe.json
corpus: 37,097 chars, 67,916 bytes
first merges (new symbol <- pair, count)
  #1   [\xe3\x81] <- [\xe3] + [\x81]  (4631)
  #2   [\xe3\x82] <- [\xe3] + [\x82]  (2324)
  #3   [\xe3\x83] <- [\xe3] + [\x83]  (1718)
  #4   [\xe3\x80] <- [\xe3] + [\x80]  (929)
  #5   [の] <- [\xe3\x81] + [\xae]  (687)
  #6   [、] <- [\xe3\x80] + [\x81]  (487)
  ...
Wallet passage: ja 290 -> 66 tokens, en 209 -> 136 tokens
短い文「秘密鍵を安全に保管する」が、結合の回数ごとにどう区切られたかを並べると以下のようになります。
結合の回数ごとの「秘密鍵を安全に保管する」の区切り
実行結果の全体(output_bpe.txt)
$ python3 bpe_train.py wallet.md bpe.json
corpus: 37,097 chars, 67,916 bytes
first merges (new symbol <- pair, count)
  #1   [\xe3\x81] <- [\xe3] + [\x81]  (4631)
  #2   [\xe3\x82] <- [\xe3] + [\x82]  (2324)
  #3   [\xe3\x83] <- [\xe3] + [\x83]  (1718)
  #4   [\xe3\x80] <- [\xe3] + [\x80]  (929)
  #5   [の] <- [\xe3\x81] + [\xae]  (687)
  #6   [、] <- [\xe3\x80] + [\x81]  (487)
  #7   [す] <- [\xe3\x81] + [\x99]  (477)
  #8   [  ] <- [ ] + [ ]  (448)
  #9   [を] <- [\xe3\x82] + [\x92]  (437)
  #10  [or] <- [o] + [r]  (380)
  #11  [。] <- [\xe3\x80] + [\x82]  (374)
  #12  [で] <- [\xe3\x81] + [\xa7]  (349)

after 0 merges
  ja  33  \xe7|\xa7|\x98|\xe5|\xaf|\x86|\xe9|\x8d|\xb5|\xe3|\x82|\x92|\xe5|\xae|\x89|\xe5|\x85|\xa8|\xe3|\x81|\xab|\xe4|\xbf|\x9d|\xe7|\xae|\xa1|\xe3|\x81|\x99|\xe3|\x82|\x8b
  en  28  S|t|o|r|e| |t|h|e| |p|r|i|v|a|t|e| |k|e|y| |s|a|f|e|l|y

after 10 merges
  ja  27  \xe7|\xa7|\x98|\xe5|\xaf|\x86|\xe9|\x8d|\xb5|を|\xe5|\xae|\x89|\xe5|\x85|\xa8|\xe3\x81|\xab|\xe4|\xbf|\x9d|\xe7|\xae|\xa1|す|\xe3\x82|\x8b
  en  27  S|t|or|e| |t|h|e| |p|r|i|v|a|t|e| |k|e|y| |s|a|f|e|l|y

after 50 merges
  ja  23  \xe7|\xa7|\x98|\xe5|\xaf|\x86|\xe9|\x8d|\xb5|を|\xe5|\xae|\x89|\xe5\x85|\xa8|に|\xe4|\xbf|\x9d|\xe7|\xae|\xa1|する
  en  27  S|t|or|e| |t|h|e| |p|r|i|v|a|t|e| |k|e|y| |s|a|f|e|l|y

after 100 merges
  ja  19  \xe7|\xa7|\x98|\xe5\xaf|\x86|鍵|を|\xe5\xae|\x89|\xe5\x85|\xa8|に|\xe4|\xbf|\x9d|\xe7|\xae|\xa1|する
  en  26  S|t|or|e| |t|h|e| |p|r|i|v|a|te| |k|e|y| |s|a|f|e|l|y

after 300 merges
  ja  13  \xe7|\xa7\x98密|鍵|を|\xe5\xae|\x89|\xe5\x85|\xa8|に|保|\xe7|\xae\xa1|する
  en  23  S|t|or|e| |th|e| |pr|i|v|a|te| |k|e|y| |s|af|e|l|y

after 1000 merges
  ja   8  秘密鍵|を|\xe5\xae|\x89|全|に|保管|する
  en  19  S|t|or|e| |the| |pr|i|v|a|te| |ke|y| |safe|l|y

Wallet passage: ja 290 -> 66 tokens, en 209 -> 136 tokens
最初の 4 回の結合は、どれも 1 文字に満たない 2 バイトの組です。ひらがなは UTF-8 で E3 81 xx か E3 82 xx、カタカナの多くは E3 82 xx か E3 83 xx で始まるので、この 2 バイトが文章の中で最も多く隣り合っていました。5 回目で、助詞の「の」が 1 トークンになります。
「秘密鍵」は学習に使った Wallet ノートのファイルに 25 回出てくるので、1,000 回の結合で 1 トークンにまとまりました。一方で「安」は文章にほとんど無く、1,000 回の後も 2 つに割れたままです。300 回の時点には、「秘」の後半 2 バイトと「密」を結合した \xa7\x98密 という、文字の境界をまたぐトークンもできています。BPE はバイトの並びの頻度だけを見るので、文字の切れ目を知りません。
以下は、Wallet ノート冒頭の 2 文と、その英訳(本記事で作った訳)について、結合の回数ごとにトークン数を数えたグラフです。
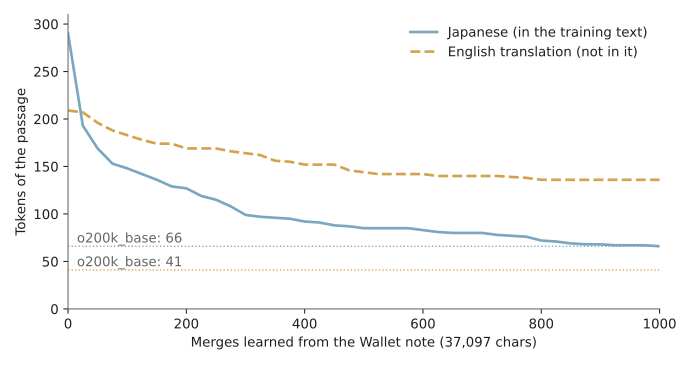
自作の BPE での、結合の回数とトークン数
日本語の 2 文は 290 トークンから 66 トークンまで減りましたが、英訳は 136 トークンで止まりました。学習用の文章が日本語のノートなので、日本語の並びばかりが結合されたからです。ただし、日本語の 2 文は学習用の文章そのものに含まれているので、66 という値は覚えた文を区切り直した結果で、未知の日本語でここまで減るわけではありません。トークナイザーが得意な言語は、学習データの言語の比率で決まります。
実験 2: 同じ内容のトークン数を比べる
公開されている 4 つのトークナイザーで、実験 1 と同じ日本語の 2 文と英訳、Python のコード、数字、絵文字を数えました。取得したのはトークナイザーのファイル(語彙と結合の記録)だけで、モデルの重みは使っていません。
| トークナイザー | 使われているモデル | 方式 | 語彙の数(特殊トークンを除く) |
|---|---|---|---|
| o200k_base | GPT-4o・GPT-4.1・o1・GPT-5 など(tiktoken 0.12.0 の対応表による) | byte-level BPE | 199,998 |
| cl100k_base | GPT-4・GPT-3.5-turbo(同上) | byte-level BPE | 100,256 |
| Qwen3 | Qwen3(Alibaba の公開モデル) | byte-level BPE | 151,643 |
| LLM-jp-3 | LLM-jp-3(国立情報学研究所の日本語 LLM) | Unigram、未知の文字はバイトに分解 | 99,566 |
語彙の数は、tokenizer.json などに登録された番号から、<|endoftext|> や <s> のような特殊トークン(Qwen3 は <think> などの追加トークンも)を除いた数です。特殊トークンや空き番号を含めた番号の数は、o200k_base が 200,019、cl100k_base が 100,277、Qwen3 が 151,669、LLM-jp-3 が 99,574 です。
LLM-jp-3 は BPE ではなく、SentencePiece の Unigram という方式です。Unigram は、大きな語彙の候補から、文章を最も確率の高い分け方で表せる語彙を残していく方式で、結合を積み上げる BPE とは逆向きに語彙を作ります。LLM-jp-3 は事前学習のトークンの約半分が日本語のモデルで、日本語に強いトークナイザーの例として入れました。
スクリプトは、OpenAI の tiktoken と Hugging Face の tokenizers を使います。以下は、各トークナイザーで区切った結果から、元のバイト列の断片を取り出す部分の抜粋です。
# lab/count_tokens.py から抜粋(全体は下の折りたたみ)
def load(root):
    inv = byte_level_table()

    def tk(enc):
        def f(s):
            ids = enc.encode(s, disallowed_special=())
            return [enc.decode_single_token_bytes(i) for i in ids]
        return f

    def qwen(t):  # ByteLevel: トークンの文字列を元のバイト列に戻す
        def f(s):
            toks = t.encode(s, add_special_tokens=False).tokens
            return [bytes(inv[c] for c in tok) for tok in toks]
        return f

    def spm(t):  # SentencePiece 形式: <0xE3> はバイト、▁ は空白
        def f(s):
            out = []
            for tok in t.encode(s, add_special_tokens=False).tokens:
                m = re.fullmatch(r"<0x([0-9A-F]{2})>", tok)
                out.append(bytes([int(m[1], 16)]) if m else tok.replace("\u2581", " ").encode())
            return out
        return f

    return {
        "o200k_base": tk(tiktoken.get_encoding("o200k_base")),
        "cl100k_base": tk(tiktoken.get_encoding("cl100k_base")),
        "Qwen3": qwen(Tokenizer.from_file(f"{root}/qwen3/tokenizer.json")),
        "LLM-jp-3": spm(Tokenizer.from_file(f"{root}/llmjp3/tokenizer.json")),
    }
count_tokens.py と fetch.sh の全体
"""同じ内容の文を 4 つのトークナイザーで区切り、文字数・バイト数・トークン数を比べる。

使い方:
    TIKTOKEN_CACHE_DIR=<保存先>/tiktoken \
      uv run --with tiktoken==0.12.0 --with tokenizers==0.22.1 \
      python count_tokens.py <fetch.sh の保存先> [結果の JSON]
"""
import json
import re
import sys

import tiktoken
from tokenizers import Tokenizer

from texts import SHORT, TEXTS


def byte_level_table():
    """GPT-2 系の ByteLevel が 1 バイトを 1 文字に写す表の逆引き。"""
    bs = list(range(33, 127)) + list(range(161, 173)) + list(range(174, 256))
    cs = bs[:]
    n = 0
    for b in range(256):
        if b not in bs:
            bs.append(b)
            cs.append(256 + n)
            n += 1
    return {chr(c): b for b, c in zip(bs, cs)}


def load(root):
    inv = byte_level_table()

    def tk(enc):
        def f(s):
            ids = enc.encode(s, disallowed_special=())
            return [enc.decode_single_token_bytes(i) for i in ids]
        return f

    def qwen(t):  # ByteLevel: トークンの文字列を元のバイト列に戻す
        def f(s):
            toks = t.encode(s, add_special_tokens=False).tokens
            return [bytes(inv[c] for c in tok) for tok in toks]
        return f

    def spm(t):  # SentencePiece 形式: <0xE3> はバイト、▁ は空白
        def f(s):
            out = []
            for tok in t.encode(s, add_special_tokens=False).tokens:
                m = re.fullmatch(r"<0x([0-9A-F]{2})>", tok)
                out.append(bytes([int(m[1], 16)]) if m else tok.replace("\u2581", " ").encode())
            return out
        return f

    return {
        "o200k_base": tk(tiktoken.get_encoding("o200k_base")),
        "cl100k_base": tk(tiktoken.get_encoding("cl100k_base")),
        "Qwen3": qwen(Tokenizer.from_file(f"{root}/qwen3/tokenizer.json")),
        "LLM-jp-3": spm(Tokenizer.from_file(f"{root}/llmjp3/tokenizer.json")),
    }


def main():
    root = sys.argv[1]
    out_path = sys.argv[2] if len(sys.argv) > 2 else None
    toks = load(root)
    result = {"counts": {}, "short": {}}

    print(f"{'text':<7}{'chars':>6}{'bytes':>6}  " +
          "".join(f"{n:>12}" for n in toks))
    for key, s in TEXTS.items():
        row = {"chars": len(s), "bytes": len(s.encode())}
        for name, fn in toks.items():
            row[name] = len(fn(s))
        result["counts"][key] = row
        print(f"{key:<7}{row['chars']:>6}{row['bytes']:>6}  " +
              "".join(f"{row[n]:>12}" for n in toks))

    print("\nchars per token")
    for key in ("ja", "en"):
        row = result["counts"][key]
        print(f"{key:<7}" + "".join(f"{row['chars'] / row[n]:>12.2f}" for n in toks))

    print("\nsplit of short sentences ('|' = token boundary, \\xNN = part of a char)")
    for key, s in SHORT.items():
        for name, fn in toks.items():
            ps = fn(s)
            shown = "|".join(p.decode("utf-8", "backslashreplace") for p in ps)
            result["short"].setdefault(key, {})[name] = [list(p) for p in ps]
            print(f"{key} {name:<12}{len(ps):>3}  {shown}")

    if out_path:
        with open(out_path, "w") as f:
            json.dump(result, f, indent=1, ensure_ascii=False)


if __name__ == "__main__":
    main()
#!/bin/sh
# トークナイザーのファイルだけを取得する(モデルの重みは取得しない)。
# 使い方: sh fetch.sh <保存先>
set -eu
D=${1:?保存先のディレクトリを指定する}
mkdir -p "$D/qwen3" "$D/llmjp3" "$D/tiktoken"
# Qwen3(Qwen/Qwen3-4B、revision 1cfa9a7208912126459214e8b04321603b3df60c)
curl -sSL -o "$D/qwen3/tokenizer.json" \
  https://huggingface.co/Qwen/Qwen3-4B/resolve/1cfa9a7208912126459214e8b04321603b3df60c/tokenizer.json
# LLM-jp-3(llm-jp/llm-jp-3-1.8b、revision 60acda32e07c72b82ce5a73d60b21b3d65e0c810)
curl -sSL -o "$D/llmjp3/tokenizer.json" \
  https://huggingface.co/llm-jp/llm-jp-3-1.8b/resolve/60acda32e07c72b82ce5a73d60b21b3d65e0c810/tokenizer.json
# tiktoken はこの置き場所をキャッシュとして使い、無ければ自分で取得してハッシュを検証する
echo "TIKTOKEN_CACHE_DIR=$D/tiktoken"
sha256sum "$D/qwen3/tokenizer.json" "$D/llmjp3/tokenizer.json"
以下が実行結果です。文字数は Python の len()(Unicode のコードポイントの数)、バイト数は UTF-8 での長さです。先頭の <s> のような特殊トークンは数えていません。
$ TIKTOKEN_CACHE_DIR=<保存先>/tiktoken uv run --with tiktoken==0.12.0 \
--with tokenizers==0.22.1 python count_tokens.py <保存先> counts.json
text chars bytes o200k_base cl100k_base Qwen3 LLM-jp-3
ja 108 290 66 95 64 43
en 209 209 41 41 41 43
code 232 232 57 58 58 76
digits 78 78 36 36 58 35
emoji 15 46 19 29 19 34
chars per token
ja 1.64 1.14 1.69 2.51
en 5.10 5.10 5.10 4.86
split of short sentences ('|' = token boundary, \xNN = part of a char)
ja o200k_base 8 秘密|鍵|を|安全|に|保|管|する
ja cl100k_base 13 \xe7\xa7|\x98|密|\xe9|\x8d|\xb5|を|安|全|に|保|管|する
ja Qwen3 8 秘密|\xe9\x8d|\xb5|を|安全|に|保管|する
ja LLM-jp-3 7 秘密|鍵|を|安全|に|保管|する
en o200k_base 5 Store| the| private| key| safely
en cl100k_base 5 Store| the| private| key| safely
en Qwen3 5 Store| the| private| key| safely
en LLM-jp-3 5 Store| the| private| key| safely
digits o200k_base 4 693|804|068|2
digits cl100k_base 4 693|804|068|2
digits Qwen3 10 6|9|3|8|0|4|0|6|8|2
digits LLM-jp-3 6 6|93|80|40|68|2
emoji o200k_base 11 👍|\xf0\x9f\x8f|\xbd|\xf0\x9f\x91|\xa8||\xf0\x9f\x91|\xa9||\xf0\x9f\x91|\xa7
emoji cl100k_base 19 \xf0\x9f|\x91|\x8d|\xf0\x9f|\x8f|\xbd|\xf0\x9f|\x91|\xa8|\xe2\x80|\x8d|\xf0\x9f|\x91|\xa9|\xe2\x80|\x8d|\xf0\x9f|\x91|\xa7
emoji Qwen3 9 👍|🏽|👨|\xe2\x80|\x8d|👩|\xe2\x80|\x8d|👧
emoji LLM-jp-3 17 |👍|🏽|\xf0|\x9f|\x91|\xa8||\xf0|\x9f|\x91|\xa9||\xf0|\x9f|\x91|\xa7
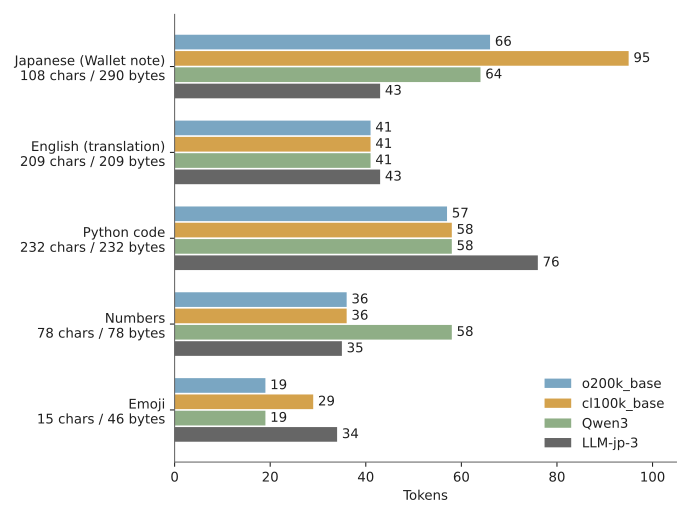
4 つのトークナイザーで数えた、5 種類の文のトークン数
英訳は、どのトークナイザーでも 41〜43 トークンで、1 トークンあたり約 5 文字です。日本語は差が大きく、同じ内容に cl100k_base は 95 トークン、o200k_base は 66 トークン、LLM-jp-3 は 43 トークンを使いました。英語を基準にすると、cl100k_base は 2.3 倍、o200k_base は 1.6 倍、LLM-jp-3 はほぼ同じです。GPT-4 から GPT-4o への世代交代で語彙が 10 万から 20 万に増え、この例では日本語のトークン数が 3 割減りました。
コード・数字・絵文字
コードは、どのトークナイザーでも 1 トークンあたり 3〜4 文字でした。インデントの空白の並びや (path): のような記号の並びも、語彙に 1 トークンとして入っています。日本語の多いデータに合わせた LLM-jp-3 だけは 76 トークンと多めです。
数字は、前処理の規則がそのまま出ます。o200k_base は、6938040682 を 693|804|068|2 と左から 3 桁ずつに分けます。桁区切りの 6,938,040,682 とは位置がずれていて、モデルが受け取る「693」と「804」は、区切りが桁の位と揃わない断片です。Qwen3 は 1 桁ずつ分けるので、数字の多い文では最もトークン数が増えました(78 文字で 58 トークン)。
絵文字は、1 つに見えても複数のコードポイントの組み合わせです。👨👩👧(家族)は、男性・女性・女の子の 3 つの絵文字をゼロ幅接合子(U+200D)でつないだ 5 コードポイント、18 バイトです。o200k_base でも、この 1 つの絵文字は 8 トークンに割れました。なお、LLM-jp-3 の行の先頭にある空白だけのトークンは、SentencePiece が文頭に足す空白の記号(▁)です。日本語や英語の行で先頭のトークンに空白が付いているのも同じ理由です。
Claude のトークナイザー
2026 年 11 月時点で、Anthropic は Claude 3 以降のモデルのトークン数を正確に数えられるトークナイザーを公開していません。古いモデル用の anthropic-tokenizer-typescript は、README に Claude 3 以降では正確でない(As of the Claude 3 models, this algorithm is no longer accurate)と書かれ、2026 年 9 月にアーカイブされました。そのため、本記事の実験のように手元で区切りを見ることはできません。
トークン数を知る方法は、API の token counting の /v1/messages/count_tokens に、使うモデルの ID と送る予定のメッセージを渡すことです。トークン数は、指定したモデルのトークナイザーで数えられます。無料で使えますが、返る値は推定で、実際の入力トークン数と少し違う場合があります。また、Anthropic がシステムのために自動で足したトークンが数に入ることがありますが、その分は課金されません。
ちなみに、同じページ(2026 年 11 月時点)には、Claude 4.7 以降のモデルと Claude Mythos Preview が新しいトークナイザーを使い、同じテキストが以前のモデルより約 30% 多いトークンになると書かれています。ただし、増え方は内容によって変わるとの但し書きがあるので、日本語の文章にそのまま当てはめることはできません。同じ会社のモデルでも、世代が変わるとトークン数が変わるわけです。料金や上限の見積もりは、使うモデルで数え直す必要があります。
トークン数が効く所
LLM を API で使う時の料金、入力できる量、生成の速さは、どれもトークン数を単位にしています。実験 2 の日本語の 2 文と英訳を例に、同じ内容を日本語で扱うと何倍になるかを並べると、以下の通りです。
| 効く所 | 単位 | o200k_base | cl100k_base | LLM-jp-3 |
|---|---|---|---|---|
| 料金 | 入力・出力のトークン数 × 単価 | 1.6 倍 | 2.3 倍 | 1.0 倍 |
| コンテキスト | 入力と出力を合わせたトークン数の上限 | 入る量が 0.62 倍 | 0.43 倍 | 1.0 倍 |
| 生成の時間 | 1 トークンずつ生成する回数 | 1.6 倍 | 2.3 倍 | 1.0 倍 |
2026 年 11 月時点の OpenAI と Anthropic の価格表では、料金は 100 万トークンあたりの単価で、入力と出力で別々に決まっています。単価が同じなら、同じ内容でも日本語の方が高くなります。
コンテキスト長(context length)は、モデルが一度に扱えるトークン数の上限です。長い資料を渡す時、日本語は英語より少ない内容で上限に達します。上限までのトークンをモデルがどうやって保持しているかは KV キャッシュのノートで説明しています。資料の全体ではなく、質問に近い断片だけを検索して渡す方法は RAG のノートで説明しています。
生成は、通常 1 トークンずつ行います。1 回の計算で次の 1 トークンを選び、それを入力に足して次のトークンを選ぶ、の繰り返しです。そのため、1 秒あたりのトークン数が同じでも、同じ内容を出力し終えるまでの時間は、トークン数の比の分だけ長くなります。
上記の倍率は、Wallet ノートの 2 文という 1 つの例での値です。専門用語の多い文章、会話文、カタカナ語の多い文章では、倍率は変わります。自分の用途の倍率は、手元の文章を使うモデルのトークナイザーで数えて確かめる必要があります。
トークン単位で起きる問題
文字を数えられない
モデルが見ているのはトークンの番号で、文字ではありません。例えば、o200k_base では safely(先頭の空白を含む)が 1 トークンで、モデルは s・a・f… という文字の並びを直接は見ていません。「この単語に e は何個あるか」「この文を 20 文字以内に縮めて」のような指示は、モデルにとって学習から推測するしかない問いです。文字数の上限を守らせたい時は、生成後にプログラムで数えて確かめます。
数字の区切りが桁と一致しない
実験 2 の通り、o200k_base は数字を左から 3 桁ずつ区切り、桁区切りとはずれます。モデルが受け取るのは、区切りが桁の位と揃わない断片の組み合わせです。計算や数の大小の比較は、LLM に暗算させずに、ツール呼び出しで計算機能を持つプログラムに任せる方が確実です。
トークナイザーはモデルと一体
語彙の番号は、モデルの入口と出口の行列の行と 1 対 1 で対応しています。そのため、学習済みのモデルのトークナイザーだけを日本語に強い別のものに取り替えることは、そのままではできません。日本語の語彙を足すには、語彙の拡張に加えて、モデルの続きの事前学習(継続事前学習)が必要です。例えば、Swallow は Llama 2 の語彙に日本語の文字を足し、日本語の Web コーパスで継続事前学習したモデルです。自分で学習し直さずに日本語のトークン数を減らしたい時は、トークナイザーを日本語の多いデータで作ったモデル(実験 2 の LLM-jp-3 など)を選ぶことになります。
言語によって負担が違う
同じ内容でも、トークナイザーの学習データに少ない言語ほど多くのトークンを使います。実験 2 の cl100k_base では、日本語の利用者は英語の利用者より 2.3 倍の料金を払い、コンテキストに入る内容も半分以下です。モデルを選ぶ時は、性能や単価だけでなく、自分の言語で同じ内容が何トークンになるかも比べる必要があります。
実験のスクリプト・出力・取得したトークナイザーのバージョンは lab/README.txt に、図の生成コードは figures.py にあります。