サブエージェント(subagent)は、AI エージェントが作業の一部を別のエージェントに任せる時の、任される側のエージェントです。本記事では、任せる側を親、任される側を子と呼びます。子は親とは別のコンテキスト(モデルに渡す入力の全体)で動き、ファイルを読む・検索するといったツール呼び出しを自分で繰り返し、終わったら結果の要約だけを親に返します。
親のエージェントも、ツールを呼べば同じファイルを読めます。では、なぜわざわざ子に任せるのでしょうか。答えは、子が何をするかよりも、親のコンテキストに何を入れずに済むかにあります。以下は、1 つのコンテキストで全部を読む形と、子に読ませる形で、コンテキストの中身の量を比べた図です。
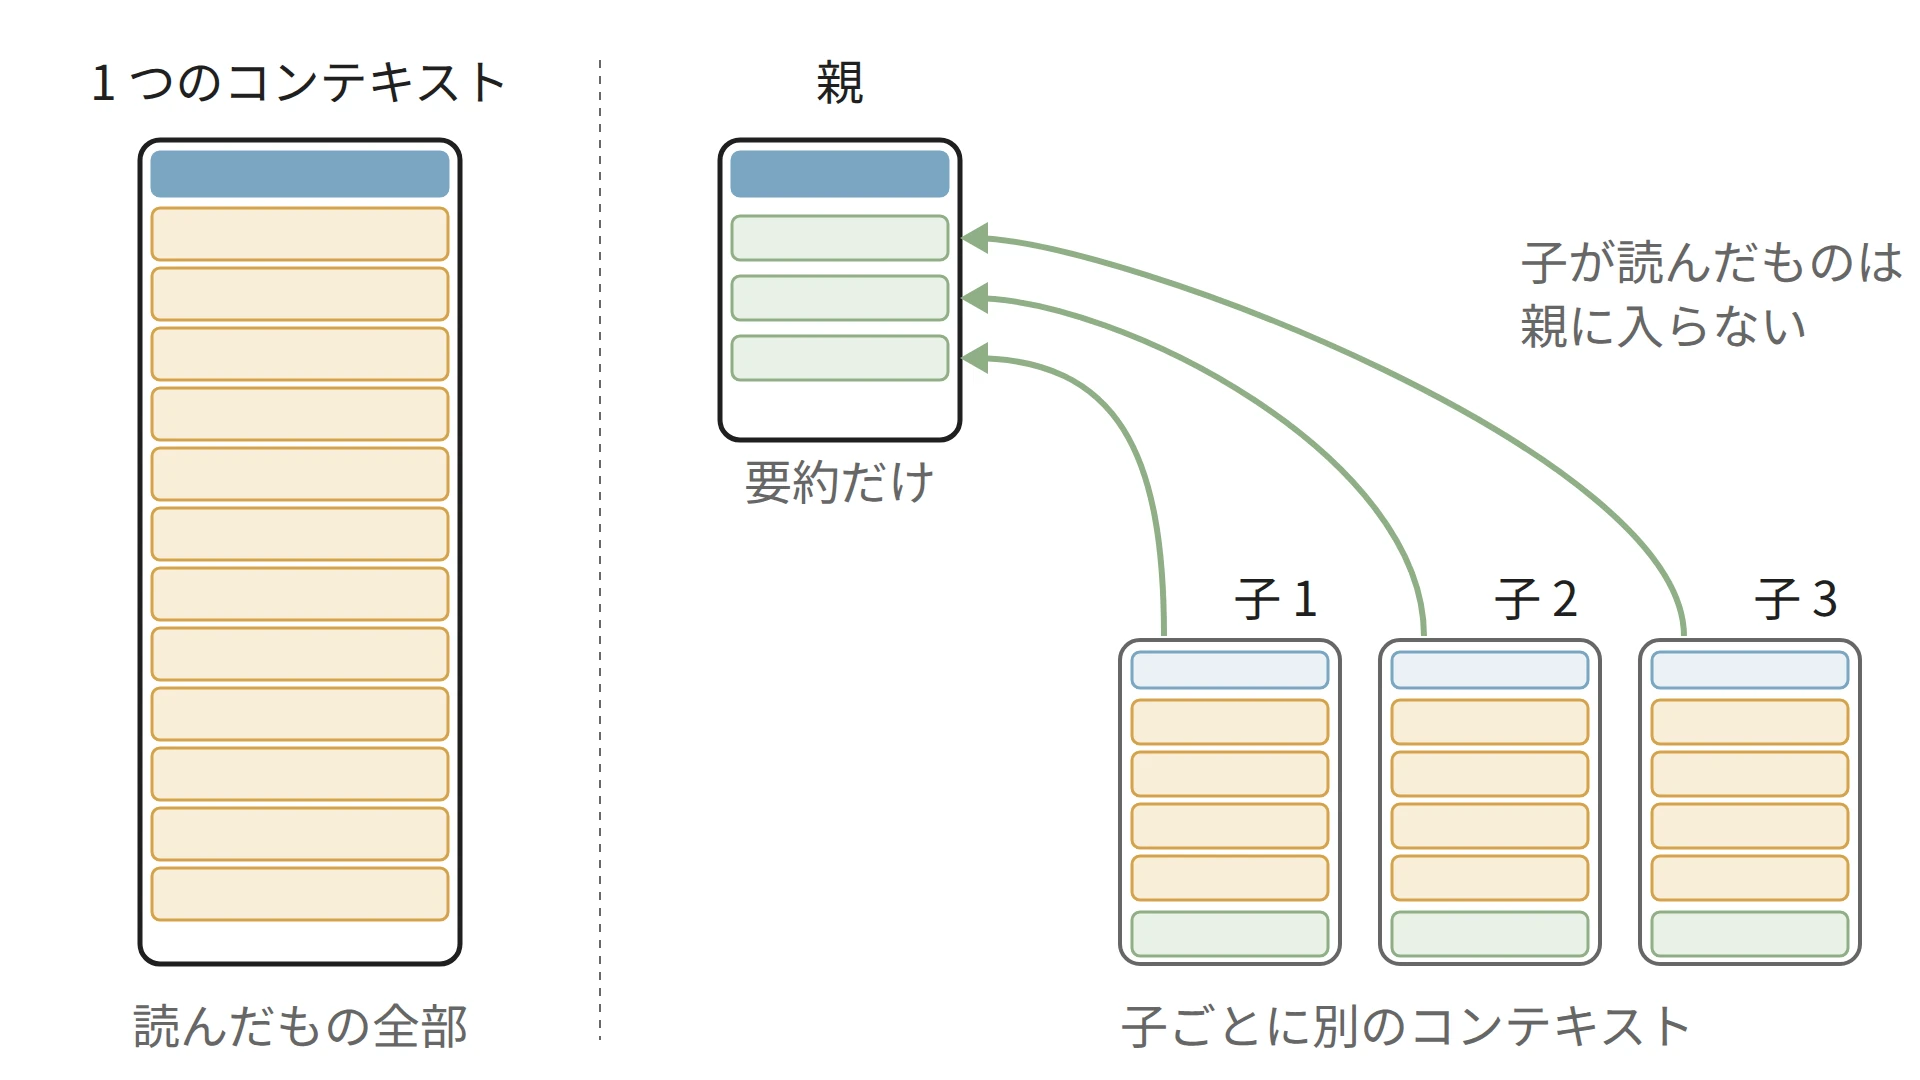
子が読んだものは子のコンテキストに残り、親には要約だけが戻る
濃い青の箱はユーザーの質問、淡い青の箱は親が子に書いた指示、黄土の箱は読んだファイルやツールの出力のような途中経過です。左の形では、途中経過が全て 1 つのコンテキストに積まれます。右の形では、途中経過は子のコンテキストに置かれたまま捨てられ、親には緑の要約だけが戻ります。
本記事では、エージェントのループを知っているエンジニアに向けて、サブエージェントが何のためにあるのかを説明します。手元の 8B のモデルで行った実験と、Anthropic などの公開資料を材料にします。扱う疑問は次の通りです。
- 1 つのエージェントに読ませ続けると、何が起きるのか。
- 子に任せると、親のコンテキストには何が残るのか。
- 子への指示が足りないと、何が落ちるのか。
- トークンと時間は、どれだけ増えるのか。
- どんな作業なら、分ける価値があるのか。
製品ごとの設定方法や、子同士が直接やり取りする構成は説明しません。
サブエージェントが必要な理由
エージェントは、モデルの応答にツール呼び出しの要求があればそれを実行し、結果を会話に足して、もう一度モデルを呼びます。このループでは、ツールの結果が全て会話に残ります。ファイルを 10 個読めば 10 個分の本文が、テストを流せばそのログが、次の呼び出しの入力になります。
困るのは、その大半が最終的な答えに要らないことです。設定ファイルの 1 行を探すために読んだ 9 個の無関係なファイルも、エラーの 1 行を探すために流した数千行のログも、作業が終わるまでコンテキストに残り続けます。
入力が長くなり、紛らわしい情報が混ざるほど、LLM(Large Language Model、大規模言語モデル)の答えは崩れやすくなります(Long Context のノート)。
Chroma の報告「Context Rot」(2025 年 7 月)では、会話の履歴から答えを探す課題で、関係する部分だけを渡した約 300 トークンの入力の方が、無関係な部分を含む約 113K トークンの入力より、試した全てのモデルで成績が上でした。親のエージェントが自分で全部を読むと、親の入力はこの 113K の側に近づいていきます。
親と子のコンテキストを分ける
サブエージェントは、この途中経過の置き場所を親から子へ移します。親は、子に頼む作業を文章で書いて渡します。子は、その指示だけを持った新しいコンテキストで始め、ツールを呼び、途中経過を自分のコンテキストに積みます。作業が終わると、子は結果を短くまとめて返し、子のコンテキストは捨てられます。
親のコンテキストに入るのは、自分が書いた指示と、子から戻った要約だけです。子が何十個のファイルを読んでも、親の入力はほとんど伸びません。
ここで言う子は、親の会話を引き継ぐ相手とは違います。例えば、OpenAI Agents SDK の handoff は、2026 年 11 月時点のドキュメントでは、引き継いだエージェントが、既定ではそれまでの会話の履歴を全て見る仕組みです(input_filter で渡す履歴を絞ることはできます)。答えを書くのは親のままで、子をツールとして呼ぶ形は、同じ SDK では agents as tools と呼ばれています。
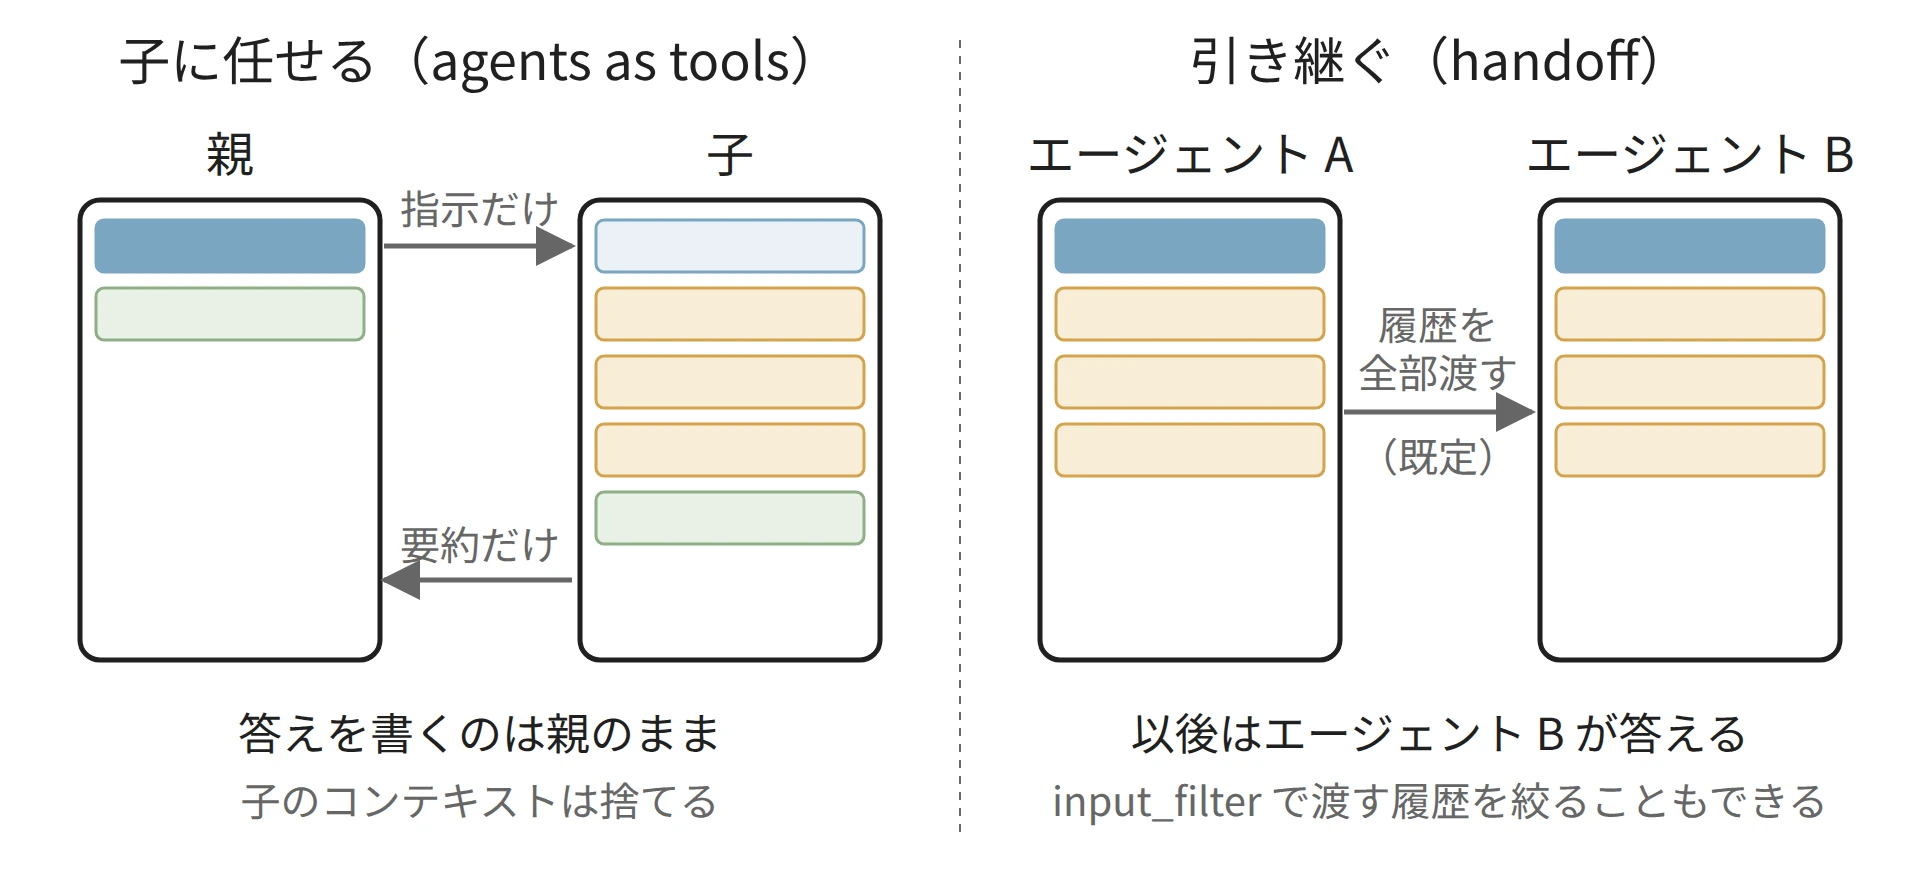
子に任せる形と、会話の履歴ごと引き継ぐ形
図の右の形では、途中経過も履歴ごと次のエージェントに渡ります。本記事の子は左の形で、指示と要約のほかは親とやり取りしません。
Anthropic のマルチエージェントの調査システムの記事(2025 年 6 月)は、子の役割を次のように説明しています。
Subagents facilitate compression by operating in parallel with their own context windows, exploring different aspects of the question simultaneously before condensing the most important tokens for the lead research agent.
(サブエージェントは、それぞれ自分のコンテキストウィンドウを持って並列に動き、問いの別々の側面を同時に調べ、最も重要なトークンに凝縮してから親の調査エージェントに渡すことで、圧縮を助ける。)
Claude Code のサブエージェントのドキュメントも、2026 年 11 月時点で、使いどころを「検索結果・ログ・ファイルの中身で会話が埋まる脇の作業」とし、子はその作業を自分のコンテキストで行って要約だけを返す、と書いています。
並列に動かすこと
並列に動かせることは、サブエージェントの説明でよく前に出ます。Anthropic の記事でも、親が 3〜5 個の子を並列に立て、子もツールを 3 つ以上並列に呼ぶようにしたことで、複雑な問いの調査時間が最大 90% 縮んだとしています。ただし、並列は子が別のコンテキストを持つことの結果の 1 つです。手元の GPU が 1 つで、子を 1 つずつ順に動かしても、親のコンテキストが短く保たれる効き目は変わりません。次の実験は、全て順に動かしています。
実験: 6 つの資料から数を集める
親のコンテキストを短く保つと答えが変わるのかを確かめるために、2026 年 11 月 11 日に、手元の Ollama(0.22.1)で Qwen3 の 8B(qwen3:8b、Q4_K_M)を動かして比べました。
機材は AMD Ryzen AI Max+ 395 と Radeon 8060S で、RAM 128GB のうち 64GB を GPU に割り当てています。答えの前に考えを書き出す思考モードは切り、temperature は 0、seed は 1、コンテキストの長さは 32,768 トークンです。
課題は、支店ごとの古い書類の束から、10 月に報告された在庫の数を集めることです。書類の束は、Project Gutenberg のパブリックドメインの小説 6 冊(シャーロック・ホームズの冒険、フランケンシュタイン、高慢と偏見、不思議の国のアリス、白鯨、二都物語)から 14,000 字ずつ切り出したもので、1 つが約 3,400 トークンです。その途中に、次の 3 文を埋めました。
Inventory note: the Harbor branch reported 352 crates of tea in September.
Inventory note: the Harbor branch reported 412 crates of tea in October.
Planning memo: the Harbor branch had forecast 502 crates of tea for October.
正解は 2 文目の 412 で、前月の実績と 10 月の予測は紛らわしい数として置いています。資料 1 つが支店 1 つ分で、支店ごとに数は違います。親への質問では、支店ごとの 10 月の数を「Harbor: 412」の形で 1 行ずつ答え、最後に「Total:」の行で合計を書くよう頼みました。
品目(tea・salt・copper・wool)と数を変えた 4 組を用意し、資料の数を 1・2・4・6 と変えました。比べた方式は次の 3 つです。
| 方式 | 親のコンテキストに入るもの |
|---|---|
| 1 つのコンテキストに積む | 質問と、read_file で読んだ全資料の本文 |
| 子に抽出させる(指示あり) | 質問と、子が返した「Harbor: 412」のような 1 行 |
| 子に要約させる(指示なし) | 質問と、子が返した 3 文の要約 |
どの方式でも、ツールを呼ぶ順番はモデルに選ばせず、プログラムで固定しました。1 つのコンテキストに積む方式は、親が全てのファイルを read_file で読み終えた形の会話を作り、最後の答えだけをモデルに書かせています。
子の方式では、資料ごとに別の呼び出し(子)を立て、子の返事だけを delegate というツールの結果として親の会話に入れました。以下は、lab/subagent_bench.py から、子への 2 種類の指示と、子の返事だけを親に渡す部分の抜粋です。
# lab/subagent_bench.py から抜粋
def child_brief(branch, item):
    return (f"You are a subagent. The parent agent needs one number from the file below: "
            f"the number of crates of {item} that the {branch} branch actually reported for "
            "October. Ignore forecasts and other months. Reply with exactly one line "
            f"'{branch}: <number>', or '{branch}: not found'.")

CHILD_VAGUE = "You are a subagent. Summarize the file below in 3 sentences."

for b, d in docs:                                   # 子は 1 つずつ順に動かす
    sys_msg = child_brief(b, item) if mode == "sub_brief" else CHILD_VAGUE
    kids.append(chat([{"role": "system", "content": sys_msg},
                      {"role": "user", "content": f"File {b.lower()}.txt:\n\n{d}"}]))
# 親の会話には、子の返事(text)だけが delegate の結果として入る
r = chat([{"role": "system", "content": PARENT_SYSTEM}, {"role": "user", "content": q}]
         + tool_turns("delegate", [(b, c["text"]) for (b, _), c in zip(docs, kids)]))
chat() は、Ollama の /api/chat を 1 回呼び、入力と出力のトークン数と時間を返す関数です。どの呼び出しにも先頭に別の ID を入れ、前の呼び出しのプロンプトキャッシュを使わせていません。
以下が、4 組の平均と件数です。左は最後の行の合計まで正しく答えた組の数、右は親が最後に答えを書いた呼び出しの入力の長さです。
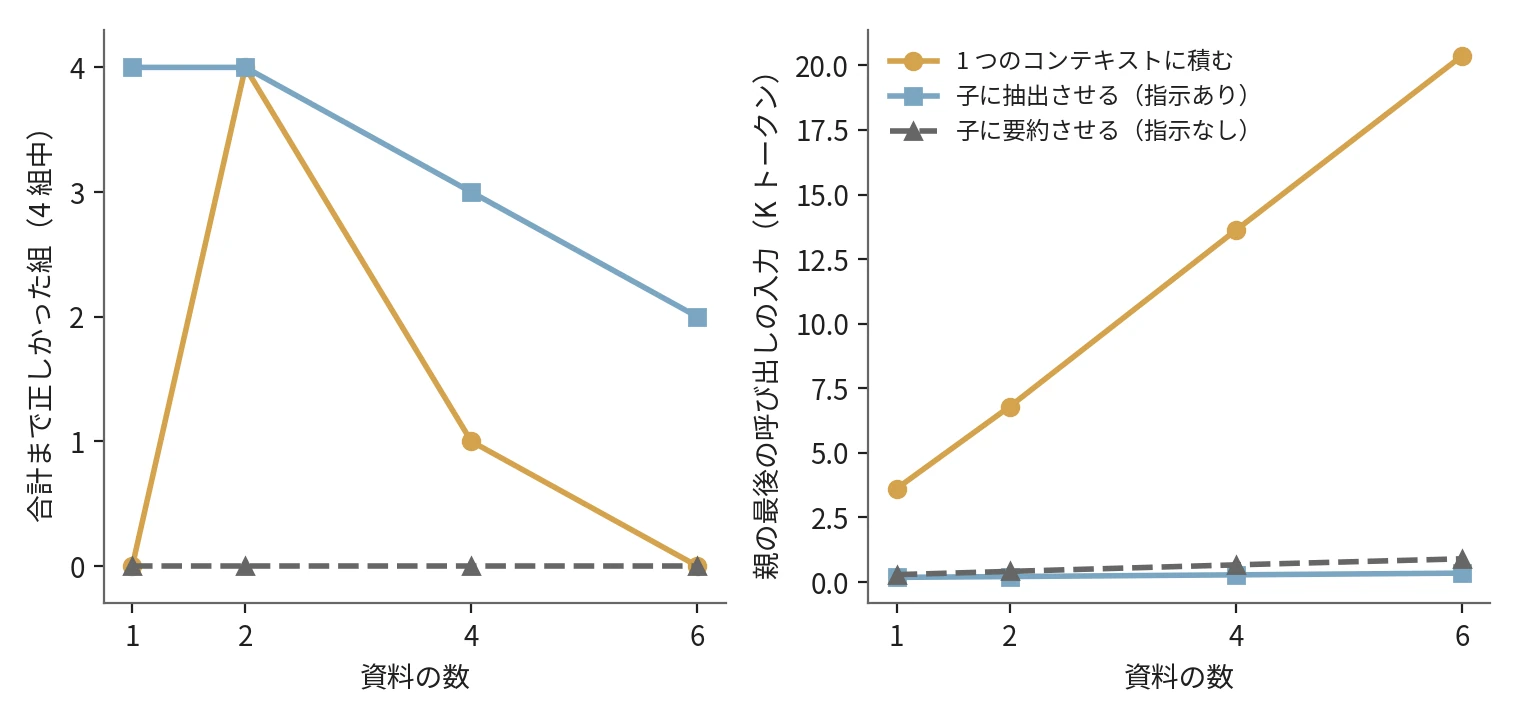
合計まで正しかった組の数と、親の最後の入力の長さ(qwen3:8b、2026-11-11)
支店ごとの行に書いた数は、1 つのコンテキストに積む方式でも全て正しく抜き出せました。資料 6 個・約 20K トークンの入力でも、支店の行で前月の実績や予測の数を書いたものはありません。差が出たのは、その数を足した最後の合計の行です。
# 資料 6 個、品目ごとの合計(正解 → 答え)
1 つのコンテキストに積む   tea 2334 → 2435   salt 2857 → 2917   copper 2939 → 2937   wool 2745 → 2125
子に抽出させる(指示あり) tea 2334 → 2330   salt 2857 → 2867   copper 2939 → 2939   wool 2745 → 2745
同じ 6 つの数を足すだけなのに、親の入力が約 20K トークンの時は 4 組とも外れ、wool では 620 も違いました。親の入力が約 350 トークンの時は 2 組が正しく、外れた 2 組も差は 4 と 10 です。全ての結果は lab/output_run.txt にあります。
ただし、積む方式の合計の正答は、資料 1 個から順に 0・4・1・0 組で、長さに比例していません。資料 1 個(約 3.6K トークン)でも、4 組とも支店の行には正しい数を書きながら、合計には 9 月の数を足して外れました(tea なら 412 + 352 = 764)。
子に抽出させる方式は、資料 1 個では 4 組とも正解です。崩れの原因は入力の長さだけでなく、紛らわしい数が親の入力に残ることにもあると考えられます。4 組しか試していないので、この差を一般的な割合として読むことはできません。
指示の無い子は数を落とす
子に「要約して」とだけ頼んだ方式は、資料の数によらず、支店ごとの数を 1 つも正しく答えられませんでした(4 組 × 支店 13 個。13 は資料 1・2・4・6 個の合計で、0/52)。以下は、資料 6 個・品目 tea の時に、Orchard 支店の資料を読んだ子が返した要約です。
The file "orchard.txt" contains an excerpt from a collection of old papers from the Orchard
branch, including a narrative involving Alice, a Pigeon, and a Cheshire Cat, reminiscent of
"Alice's Adventures in Wonderland." It also includes inventory notes about tea crates reported
by the Orchard branch in September and October. Additionally, there is a planning memo
forecasting tea crates for October, suggesting the text blends fictional narrative with
administrative records.
子は、10 月の茶箱の報告があることに気付いています。それでも、数そのもの(153)は要約に入れませんでした。子は親の質問を知らないので、どの数が大事かを判断できず、本文の大半を占める小説の筋を中心に 3 文にまとめています。
親は、この要約だけを受け取り、6 支店とも「0」、合計も「0」と答えました。数が無いことを「分からない」と返さず、0 で埋めています。子のコンテキストは既に捨てられているので、親が読み直すこともできません。
同じ資料・同じモデルで、子への指示に支店名・品目・10 月の実績・予測を無視すること・返す形を書いただけで、支店ごとの数は全て正しく戻りました。Anthropic の記事も、子への指示には目的・出力の形・使うツールや情報源・作業の境界が要るとし、短く曖昧な指示では子が同じ調査を重複させたり、必要な情報を見つけられなかったりしたと書いています。サブエージェントの答えの質は、親が書く指示の質で上限が決まります。
トークンと時間
子に分けると、親のコンテキストは短くなりますが、全体で読むトークンは減りません。資料 6 個の時の 4 組の平均は次の通りです。
| 方式 | 親の最後の入力 | 全ての呼び出しの合計 | 時間(順に実行) |
|---|---|---|---|
| 1 つのコンテキストに積む | 20,358 トークン | 20,412 トークン | 49.4 秒 |
| 子に抽出させる(指示あり) | 347 トークン | 21,212 トークン | 34.4 秒 |
| 子に要約させる(指示なし) | 900 トークン | 22,071 トークン | 59.2 秒 |
子に抽出させる方式は、子が資料を 1 回ずつ読み、親が子の返事を読むので、合計は 1 つのコンテキストより約 4% 多くなりました。今回は親が最後に 1 回答えるだけなので、差は小さく済んでいます。実際のエージェントは、ツールを呼ぶたびに会話全体を入力し直すので、どちらの方式でも合計はループの回数に応じて増えます。
時間は、子を 1 つずつ順に動かしても、子に抽出させる方式の方が短くなりました。この環境では、約 3,400 トークンの入力を 6 回処理する方が、約 20,000 トークンの入力を 1 回処理するより速かったことになります。ただし、プロンプトキャッシュを使わせない条件での測定なので、キャッシュが効く環境では結果が変わりえます。
規模の大きいシステムでは、トークンの増え方はもっと大きくなります。Anthropic の記事は、自社のデータで、エージェントはチャットの約 4 倍、マルチエージェントのシステムは約 15 倍のトークンを使うとしています。
同じ記事は、Claude Opus 4 を親、Claude Sonnet 4 を子にした構成が、Claude Opus 4 単体より社内の調査の評価で 90.2% 良い成績だったと報告しつつ、ブラウジングの評価(BrowseComp)の成績のばらつきの 80% はトークンの使用量だけで説明できたとしています。分けたことで賢くなったというより、別々のコンテキストに分けることで、1 つのコンテキストには収まらない量のトークンを使えるようになった、という読み方です。
分けても親は膨らむ
子に任せて親のコンテキストを短く保てるのは、親が受け持つ作業の範囲が絞られている間だけです。
著者は、LLM での開発を工程ごとの手順書(Claude Code のスキル)に分け、各工程の担当とレビュアーをサブエージェントに任せています(2026 年 11 月 9 日の weeknotes)。この形でも、ゲームとフレームワークと画像生成のワークフローという 3 つの開発を 1 つのセッションで進めた時は、親のコンテキストが膨大になりました。
LLM は次第にワークフローを守らなくなり、レビュアーの指摘を場当たり的に直すようになりました。子の読んだものが親に入らなくても、子から戻る要約やユーザーとのやり取りは、親のコンテキストに積まれていきます。
サブエージェントは、途中経過を親から外す仕組みであって、親の受け持つ範囲そのものを小さくする仕組みではありません。範囲が広すぎれば、要約だけでも親のコンテキストは埋まります。その時は、セッションを機能ごとに分けるように、親の単位から切り直す必要があります。
利点
- 子が読んだファイルやツールの出力が親のコンテキストに入らず、親の入力が短く保たれる
- 親が答えを組み立てる時に、無関係な文や紛らわしい文に引きずられにくい
- 子ごとに指示・使えるツール・権限を絞れる
- 互いに依存しない作業なら、子を並列に動かして待ち時間を縮められる
欠点
サブエージェントは、途中経過を子に閉じ込めることで親を短く保ちます。その代わりに、次の制約があります。
- 子の要約に入らなかった情報は、親から見えない。後で要ると分かっても、子のコンテキストは残っていない
- 子は親の会話を知らない。何を探し、何を無視し、どの形で返すかは、親が指示に書く必要がある
- 子ごとに指示と資料を読み直すため、トークンの総量は 1 つのコンテキストより増える
- 子の作業が互いに依存すると、親を介したやり取りが増え、分けた意味が薄れる
適さないケース
- 1〜2 個のファイルを読めば済む作業。子を立てる指示と要約の往復の方が長くなる
- 後の工程が前の工程の細部を参照する作業。要約で細部が落ちると、子に読み直させることになる
- 全員が同じ文脈を共有する必要がある作業。Anthropic の記事も、多くのコーディングの作業は調査ほど並列に分けられないとしている
- 待ち時間が問題になる対話。子は空のコンテキストから始めるため、資料を集め直す時間が掛かる