```json
{
  "person": "松本彩",
  "date": "2024-03-19",
  "amount_yen": 120000
}
```
上記は、文章から人物・日付・金額を取り出して「出力は JSON だけにしてください」と頼んだ時の、qwen3:1.7b の応答です。中身は正しいのですが、Markdown(見出しやコードを記号で書く文書の記法)のコードブロックの囲み(```)が付いているので、Python の json.loads() は 1 文字目で失敗します。手元の 40 件の入力では、25 件がこの形でした。
構造化出力(structured output)は、LLM(Large Language Model、大規模言語モデル)の応答を JSON のような決まった形に揃える仕組みです。プロンプトで頼むだけでは形は保証されません。そこで、生成の途中で次のトークン(LLM が文字列を扱う単位)の候補から、文法に合わない候補を外す方法が使われます。以下は、上記と同じ入力で、モデルが応答の 1 トークン目に付けた確率の上位です。
1 トークン目の候補と、文法で外される候補
モデルは 76% の確率で囲みを書こうとしています。スキーマ(JSON の形の定義)から作った文法で縛ると、囲みの候補は外され、残った候補の中で最も確率の高い {" が選ばれます。この方法を制約付きデコード(constrained decoding)と呼びます。
本記事では、手元の Ollama(LLM を手元の PC で動かす OSS)での実験を通して、LLM に決まった形で答えさせる 3 つの方式の違いを説明します。次の疑問に答えます。
- LLM は、なぜ頼んだ形を崩すのか。
- プロンプトで頼む、JSON モード、JSON Schema で縛る、の 3 つは何が違うのか。
- 制約付きデコードは、生成のどこで何をしているのか。
- 形を縛ると、取り出した値の正しさや生成時間はどう変わるのか。
- 制約付きデコードで保証されないことは何か。
ツール呼び出し(LLM に関数の引数を JSON で返させる仕組み)も同じ制約を使う場合がありますが、本記事では単体の応答の形だけを説明します。
LLM が形を崩す理由
LLM は、応答を 1 トークンずつ作ります。それまでの文字列から、語彙の全てのトークンについて「次に来る確率」を計算し、その中から 1 つを選んで末尾に足します。これを応答の終わりまで繰り返します。トークンは単語や文字の断片で、実験で使う Qwen3(Alibaba の Qwen チームが公開している LLM)の語彙は約 15 万個あります(詳しくは トークナイザーのノート)。
この手順のどこにも「JSON の文法を守る」という処理はありません。プロンプトで「JSON だけを出力して」と頼むと、{ で始まる候補の確率は上がります。しかし、冒頭の図の通り、頼んでも囲みの確率の方が高い場合があります。チャット向けに調整されたモデルは、コードを Markdown の囲みに入れて示す応答を多く学習しているからだと考えられます(推測です)。
形を崩す原因は囲みだけではありません。例えば、次の崩れ方があります。
- 説明の文を JSON の前後に付ける(「以下が抽出結果です」)。
- 閉じ括弧を書く前に、生成の上限のトークン数に達する。
- キー名を変える(
amount_yenではなくamount)、数値を文字列にする("12万円")。
1 トークンでも外れると、パーサー(文字列を解析してデータに変換するプログラム)が失敗します。確率で選ぶ以上、頼み方を工夫しても崩れる確率は 0 になりません。
形を守らせる 3 つの方式
LLM の API は、応答の形を指定する引数を持っている場合があります。Ollama では、/api/chat の format 引数に "json" か JSON Schema を渡します。ChatGPT を提供する OpenAI の API にも、2026 年 11 月時点で JSON モードと、スキーマを守らせる Structured Outputs があります。整理すると、以下の通りです。
| 方式 | Ollama での指定 | 保証される形 |
|---|---|---|
| プロンプトで頼むだけ | format を付けない | 無し |
| JSON モード | "format": "json" | JSON の構文(括弧・引用符・カンマ) |
| JSON Schema で縛る | "format": { スキーマ } | 構文に加えて、キー・型・必須項目・文字列の形 |
JSON Schema は、JSON のデータの形を JSON で書く仕様です。例えば、実験で使ったスキーマは次の形です。person は文字列、date は YYYY-MM-DD の形の文字列、amount_yen は整数で、3 つとも必須、他のキーは許しません。
{
  "type": "object",
  "properties": {
    "person": {"type": "string"},
    "date": {"type": "string", "pattern": "^[0-9]{4}-[0-9]{2}-[0-9]{2}$"},
    "amount_yen": {"type": "integer"}
  },
  "required": ["person", "date", "amount_yen"],
  "additionalProperties": false
}
JSON モードは、構文が正しい JSON なら中身を問いません。キー名が違っても、数値が文字列になっていても通ります。
制約付きデコード
Ollama では、JSON モードとスキーマの方式は、どちらも制約付きデコードで実現されています。生成の各ステップで、ここまでに出力した文字列に続けても文法に違反しない候補だけを残し、それ以外の確率を 0 にしてから選びます。
Ollama(v0.22.1)は、受け取った format を GBNF(llama.cpp の文法の記法)の文法に変換します(llm/server.go)。"json" の時は固定の JSON の文法を使い、スキーマの時は llama.cpp の変換関数で文法を作ります。固定の文法の開始規則は root ::= object なので、JSON モードでも応答は必ずオブジェクト({ で始まる形)になります。
候補を外す処理は、sample/samplers.go にあります。以下は、その抜粋です。
// sample/samplers.go(Ollama v0.22.1)から抜粋
t, err := s.sample(tokens) // まず文法を見ずに 1 つ選ぶ

if s.grammar != nil {
    // optimization: first check if the max logit is accepted by the grammar
    // if the max logit is rejected, apply the grammar to all logits (slower)
    top := []token{t}
    s.grammar.Apply(top)
    if !math.IsInf(float64(top[0].value), -1) {
        s.grammar.Accept(top[0].id) // 文法の状態を 1 トークン進める
        return top[0].id, nil
    }
    // (tokens を元の値に戻す処理は省略)
    s.grammar.Apply(tokens) // 文法に合わない候補を -∞(確率 0)にする
    t, err = s.sample(tokens)
    s.grammar.Accept(t.id)
}
先に文法を見ずに 1 つ選び、それが文法に合えばそのまま使います。合わない時だけ、語彙の全ての候補に文法を当てて選び直します。全ての候補を調べるのは重い処理なので、モデルが自分から文法に合うトークンを選ぶ間は、その処理を省いています。冒頭の図は、選び直しが起きる場面です。
図の確率は、format を付けずに、qwen3:1.7b に同じプロンプトを送り("think": false の時のチャットテンプレートと同じく、末尾に /no_think を付けた文字列)、1 トークン目の確率の上位 10 個を Ollama の logprobs で受け取ったものです(lab/probe.py)。各候補が文法に合うかは、スキーマの先頭({、空白、"person" の順)に合うかで判定しました。
$ python3 probe.py qwen3:1.7b-q4_K_M 3 logprobs.json
input 3: 2024年3月19日に開かれた勉強会で、幹事の松本彩さんが参加者12名分の会場費12万円を立て替えた。
greedy first token: '```'
         '```'  p=0.7619  rejected
          '{"'  p=0.2255  allowed
         '{\n'  p=0.0123  allowed
           '{'  p=0.0002  allowed
          "{'"  p=0.0001  rejected
          '``'  p=0.0001  rejected
         '[\n'  p=0.0000  rejected
           '`'  p=0.0000  rejected
          '以下'  p=0.0000  rejected
         '以下の'  p=0.0000  rejected
確率は、同じ入力でも実行ごとに変わりました。同じ日に 4 回取ると、囲みは 60〜76%、{" は 23〜35% の幅でした。図は最後の 1 回の値です。どの回でも囲みが首位で、外した後に {" が選ばれる点は同じでした。
probe.py の全体(59 行)
"""応答の 1 トークン目について、モデルが付けた確率の上位を Ollama から取り出す(冒頭の図の元データ)。

format を付けずに、chat と同じ形のプロンプトを raw で /api/generate に送り、
logprobs と top_logprobs で 1 トークン目の候補の確率を受け取る。
各候補が、スキーマから作った文法の先頭("{" の後に空白、続けて "person" のキー)に合うかも判定する。

使い方:
    OLLAMA_HOST=127.0.0.1:11435 python3 probe.py <モデル> <入力の番号> [出力の JSON]
"""
import json
import math
import os
import re
import sys
import urllib.request

from run import PROMPT
from texts import make_items

# 文法が 1 トークン目に許す文字列: "{"、空白、'"person"' の先頭部分の順
ALLOWED = re.compile(r'^\{[ \t\n]*(?:"(?:p(?:e(?:r(?:s(?:o(?:n(?:")?)?)?)?)?)?)?)?$')


def main():
    model, idx = sys.argv[1], int(sys.argv[2])
    out_path = sys.argv[3] if len(sys.argv) > 3 else None
    host = os.environ.get("OLLAMA_HOST", "127.0.0.1:11434")
    text = make_items()[idx]["text"]
    # qwen3 のチャットテンプレートで think: false を指定した時と同じ並び
    # (テンプレートは最後のユーザー発言の末尾に " /no_think" を足す。
    #   /api/chat に "_debug_render_only": true を付けて描画した結果と照合した)
    prompt = ("<|im_start|>user\n" + PROMPT.format(text=text) + " /no_think<|im_end|>\n"
              "<|im_start|>assistant\n<think>\n\n</think>\n\n")
    body = {"model": model, "prompt": prompt, "raw": True, "stream": False,
            "logprobs": True, "top_logprobs": 10,
            "options": {"temperature": 0, "seed": 42, "num_predict": 1}}
    req = urllib.request.Request(f"http://{host}/api/generate", data=json.dumps(body).encode(),
                                 headers={"Content-Type": "application/json"})
    with urllib.request.urlopen(req, timeout=900) as r:
        res = json.load(r)
    print(f"input {idx}: {text}")
    print(f"greedy first token: {res['response']!r}")
    cands = []
    for t in res["logprobs"][0]["top_logprobs"]:
        p = math.exp(t["logprob"])
        ok = bool(ALLOWED.match(t["token"]))
        cands.append({"token": t["token"], "p": p, "allowed": ok,
                      "shown": t["token"].replace("\n", "\\n")})
        print(f"  {t['token']!r:>12}  p={p:.4f}  {'allowed' if ok else 'rejected'}")
    if out_path:
        with open(out_path, "w") as f:
            json.dump({"model": model, "input": idx, "candidates": cands,
                       "prefix_shown": "1 トークン目",
                       "caption": f"点線はスキーマの文法に合わない候補({model}、入力 {idx})"},
                      f, indent=2, ensure_ascii=False)


if __name__ == "__main__":
    main()
なお、スキーマはプロンプトには入りません。Ollama は format を生成の制約にだけ使い、モデルにはスキーマが見えません。Ollama のドキュメントは、スキーマを文字列としてプロンプトにも入れることを勧めています。
実験: 同じ抽出を 3 方式で解かせる
文章から、取引の当事者の名前・日付・金額を取り出す課題を作りました。入力は、本記事のために作った架空の文 40 件です。8 種類のテンプレートに名前・日付・金額を差し込んで作るので、正解は作る時点で決まります(lab/texts.py)。日付は西暦・スラッシュ・和暦(令和)、金額はカンマ・「万」・円記号の書き方を混ぜ、関係の無い人物(「山田さんの代わりに」)や数字(部屋番号、参加者数)も入れました。以下は入力の例です。
令和8年5月1日に開かれた勉強会で、幹事の佐藤花子さんが参加者12名分の会場費¥12,800を立て替えた。
  正解: {"person": "佐藤花子", "date": "2026-05-01", "amount_yen": 12800}
山田さんの代わりに、高橋健太さんが2024年4月9日に家賃135,000円を振り込んだ。部屋番号は204号室。
  正解: {"person": "高橋健太", "date": "2024-04-09", "amount_yen": 135000}
条件は以下の通りです。3 方式とも、プロンプトの文は同じで、キー名と日付の形式をプロンプトにも書いています。違いは format だけです。
| 項目 | 値 |
|---|---|
| Ollama | 0.22.1(GPU は AMD Radeon 8060S、他の作業と共有) |
| モデル | qwen3:1.7b(タグは qwen3:1.7b-q4_K_M)、qwen3:4b、qwen3:8b。量子化は全て Q4_K_M |
| 思考モード | "think": false で無効にする(qwen3:4b は無効にならない。後述) |
| 生成の設定 | temperature 0、seed 42、最大 512 トークン |
| 入力 | 40 件(qwen3:4b は先頭の 20 件)。qwen3:1.7b には、時間を測るために先頭の 20 件をさらに 2 回解かせた |
採点は 3 段です。応答の文字列全体が json.loads() で読めるか(パース)、読めた JSON がスキーマに合うか(Python の jsonschema で検証)、スキーマに合った上で 3 つの値が全て正解と一致するか、の順に数えます。前の段で落ちたものは、後の段も不合格です。
lab/run.py は、Python の標準ライブラリだけで /api/chat に要求を送ります。以下は、1 件を送る関数です。方式ごとの違いは、format を付けるかどうかと、その値だけです。
# lab/run.py から抜粋(PROMPT はキー名と日付の形式を書いた指示文、fmt は None / "json" / SCHEMA)
def chat(host, model, text, fmt, prompt=PROMPT):
    body = {
        "model": model,
        "messages": [{"role": "user", "content": prompt.format(text=text)}],
        "stream": False,
        "think": False,  # qwen3 の思考モードを切る(qwen3:4b は切れない。本文参照)
        "options": {"temperature": 0, "seed": 42, "num_predict": 512},
    }
    if fmt is not None:
        body["format"] = fmt
    req = urllib.request.Request(f"http://{host}/api/chat", data=json.dumps(body).encode(),
                                 headers={"Content-Type": "application/json"})
    t0 = time.perf_counter()
    with urllib.request.urlopen(req, timeout=1800) as r:
        res = json.load(r)
    res["wall_s"] = time.perf_counter() - t0
    return res
入力文を作る texts.py と、run.py の全体は以下の通りです。
texts.py の全体(70 行)
"""抽出課題の入力文と正解を作る。文は全て本記事のために作った架空のもので、人物も実在しない。

テンプレートに名前・日付・金額を差し込むので、正解は作る時点で決まる。
日付と金額は、書き方(西暦・スラッシュ・和暦、カンマ・万・円記号)を変えて混ぜる。
"""
import random

NAMES = ["佐藤花子", "鈴木一郎", "高橋健太", "田中美咲", "伊藤翔", "渡辺由美",
         "山本大輔", "中村さくら", "小林拓也", "加藤陽子", "吉田誠", "松本彩"]

TEMPLATES = [
    "{date}、{name}さんは書店で技術書を3冊、合計{amt}で購入した。",
    "{name}様より、{date}付けで{amt}のご入金を確認いたしました。請求書番号は INV-{num} です。",
    "経費精算 申請者: {name} / 利用日: {date} / 金額: {amt}(タクシー代、乗車人数2名)",
    "{date}に開かれた勉強会で、幹事の{name}さんが参加者12名分の会場費{amt}を立て替えた。",
    "山田さんの代わりに、{name}さんが{date}に家賃{amt}を振り込んだ。部屋番号は204号室。",
    "{name}さんから{date}の午後3時に連絡があり、修理代として{amt}を支払うとのことだった。",
    "Receipt: {date} 支払者 {name} 合計 {amt}",
    "{date}締めの請求として、{name}さんに{amt}(税込、送料500円を含む)を請求した。",
]


def date_text(rng, y, m, d):
    kind = rng.choice(["kanji", "slash", "wareki", "kanji"])
    if kind == "kanji":
        return f"{y}年{m}月{d}日"
    if kind == "slash":
        return f"{y}/{m}/{d}"
    return f"令和{y - 2018}年{m}月{d}日"  # 2019 年が令和元年


def amount_text(rng, a):
    kinds = ["comma", "yen_sign", "plain"]
    if a >= 10000 and a % 1000 == 0:
        kinds += ["man", "man"]
    if a >= 10000 and a % 10000 == 5000:
        kinds.append("man_decimal")
    kind = rng.choice(kinds)
    if kind == "comma":
        return f"{a:,}円"
    if kind == "yen_sign":
        return f"¥{a:,}"
    if kind == "plain":
        return f"{a}円"
    if kind == "man_decimal":
        return f"{a / 10000:g}万円"
    man, rest = divmod(a, 10000)
    sen = rest // 1000
    return f"{man}万" + (f"{sen}千" if sen else "") + "円"


def make_items(n=40, seed=20261110):
    rng = random.Random(seed)
    items = []
    for i in range(n):
        name = rng.choice(NAMES)
        y, m, d = rng.choice([2024, 2025, 2026]), rng.randint(1, 12), rng.randint(1, 28)
        a = rng.choice([980, 1500, 3200, 4500, 12800, 15000, 25000, 32000, 48000,
                        65000, 120000, 135000])
        tpl = TEMPLATES[i % len(TEMPLATES)]
        text = tpl.format(name=name, date=date_text(rng, y, m, d),
                          amt=amount_text(rng, a), num=rng.randint(1000, 9999))
        items.append({"id": i, "text": text, "answer": {
            "person": name, "date": f"{y:04d}-{m:02d}-{d:02d}", "amount_yen": a}})
    return items


if __name__ == "__main__":
    for it in make_items():
        print(it["id"], it["text"], it["answer"])
run.py の全体(103 行)
"""同じ抽出課題を 3 つの方式で Ollama の /api/chat に解かせ、応答と時間を JSON Lines に保存する。

方式:
  prompt : プロンプトで JSON を頼むだけ(format を付けない)
  json   : format: "json"(JSON の構文だけを守らせる)
  schema : format: <JSON Schema>(スキーマから作った文法で生成を縛る)
  schema_bare : schema と同じ format で、プロンプトにはキーも形式も書かない(追加の比較)

使い方:
    OLLAMA_HOST=127.0.0.1:11435 python3 run.py <出力の .jsonl> <モデル> <繰り返し回数> [方式,...]
方式の既定は prompt,json,schema。
1 回目は 40 件全て、2 回目以降は時間を測るために先頭の 20 件だけを解かせる。
出力に既にある組(モデル・回・入力・方式)は飛ばすので、途中で止めても続きから再開できる。
Python 標準ライブラリだけで動く。
"""
import json
import os
import sys
import time
import urllib.request

from texts import make_items

SCHEMA = {
    "type": "object",
    "properties": {
        "person": {"type": "string"},
        "date": {"type": "string", "pattern": "^[0-9]{4}-[0-9]{2}-[0-9]{2}$"},
        "amount_yen": {"type": "integer"},
    },
    "required": ["person", "date", "amount_yen"],
    "additionalProperties": False,
}
FORMATS = {"prompt": None, "json": "json", "schema": SCHEMA, "schema_bare": SCHEMA}
N_ITEMS, TIMING_ITEMS = 40, 20

PROMPT = """次の文から、取引の当事者(お金を払った・受け取った・請求された人)の名前、日付、金額を取り出してください。
出力は JSON だけにしてください。キーは person(敬称を付けない名前)、date(YYYY-MM-DD 形式)、amount_yen(円単位の整数)の 3 つです。

文: {text}"""

# schema_bare 用: 何を取り出すかだけを書き、キー名・日付の形式・JSON で答えることは書かない
PROMPT_BARE = """次の文から、取引の当事者の名前、日付、金額を取り出してください。

文: {text}"""


def chat(host, model, text, fmt, prompt=PROMPT):
    body = {
        "model": model,
        "messages": [{"role": "user", "content": prompt.format(text=text)}],
        "stream": False,
        "think": False,  # qwen3 の思考モードを切る(qwen3:4b は切れない。本文参照)
        "options": {"temperature": 0, "seed": 42, "num_predict": 512},
    }
    if fmt is not None:
        body["format"] = fmt
    req = urllib.request.Request(f"http://{host}/api/chat", data=json.dumps(body).encode(),
                                 headers={"Content-Type": "application/json"})
    t0 = time.perf_counter()
    with urllib.request.urlopen(req, timeout=1800) as r:
        res = json.load(r)
    res["wall_s"] = time.perf_counter() - t0
    return res


def main():
    out_path, model, repeats = sys.argv[1], sys.argv[2], int(sys.argv[3])
    names = sys.argv[4].split(",") if len(sys.argv) > 4 else ["prompt", "json", "schema"]
    host = os.environ.get("OLLAMA_HOST", "127.0.0.1:11434")
    items = make_items(N_ITEMS)
    done = set()
    if os.path.exists(out_path):
        for line in open(out_path):
            r = json.loads(line)
            done.add((r["model"], r["rep"], r["id"], r["method"]))
    with open(out_path, "a") as f:
        for rep in range(repeats):
            for it in items if rep == 0 else items[:TIMING_ITEMS]:
                k = (it["id"] + rep) % len(names)  # 方式の順番を回して、負荷の偏りを散らす
                for method in names[k:] + names[:k]:
                    if (model, rep, it["id"], method) in done:
                        continue
                    prompt = PROMPT_BARE if method == "schema_bare" else PROMPT
                    res = chat(host, model, it["text"], FORMATS[method], prompt)
                    f.write(json.dumps({
                        "model": model, "rep": rep, "id": it["id"], "method": method,
                        "content": res["message"]["content"],
                        "thinking": res["message"].get("thinking", ""),
                        "done_reason": res.get("done_reason"),
                        "eval_count": res.get("eval_count"),
                        "eval_s": res.get("eval_duration", 0) / 1e9,
                        "prompt_eval_s": res.get("prompt_eval_duration", 0) / 1e9,
                        "load_s": res.get("load_duration", 0) / 1e9,
                        "total_s": res.get("total_duration", 0) / 1e9,
                        "wall_s": res["wall_s"],
                    }, ensure_ascii=False) + "\n")
                    f.flush()
            print(f"{model} rep {rep} done", flush=True)


if __name__ == "__main__":
    main()
採点は lab/evaluate.py で行いました。中心は次の関数です。
# lab/evaluate.py から抜粋
def score(content, answer):
    """3 段の判定。前の段を通らなければ後の段は False。"""
    try:
        obj = json.loads(content)
    except json.JSONDecodeError:
        return {"parse": False, "schema": False, "value": False, "fields": {}}
    ok_schema = jsonschema.Draft202012Validator(SCHEMA).is_valid(obj)
    fields = {k: ok_schema and obj.get(k) == v for k, v in answer.items()}
    return {"parse": True, "schema": ok_schema, "value": all(fields.values()),
            "fields": fields}
evaluate.py の全体(103 行)
"""run.py の結果(JSON Lines)を、パース・スキーマ・値の 3 段で採点し、時間をまとめる。

使い方:
    uv run --with jsonschema==4.25.1 python3 evaluate.py <結果の .jsonl>... [集計の .json]
"""
import json
import statistics
import sys
from collections import defaultdict

import jsonschema

from run import N_ITEMS, SCHEMA, TIMING_ITEMS
from texts import make_items

METHODS = ["prompt", "json", "schema", "schema_bare"]


def score(content, answer):
    """3 段の判定。前の段を通らなければ後の段は False。"""
    try:
        obj = json.loads(content)
    except json.JSONDecodeError:
        return {"parse": False, "schema": False, "value": False, "fields": {}}
    ok_schema = jsonschema.Draft202012Validator(SCHEMA).is_valid(obj)
    fields = {k: ok_schema and obj.get(k) == v for k, v in answer.items()}
    return {"parse": True, "schema": ok_schema, "value": all(fields.values()),
            "fields": fields}


def fenced(content):
    """```json ... ``` で囲まれていて、囲みを外せばパースできるか。"""
    t = content.strip()
    if not t.startswith("```"):
        return False
    t = t.split("\n", 1)[-1].rsplit("```", 1)[0]
    try:
        json.loads(t)
        return True
    except json.JSONDecodeError:
        return False


def main():
    paths = [a for a in sys.argv[1:] if a.endswith(".jsonl")]
    outs = [a for a in sys.argv[1:] if a.endswith(".json")]
    out_path = outs[0] if outs else None
    answers = {it["id"]: it["answer"] for it in make_items(N_ITEMS)}
    rows = [json.loads(line) for path in paths for line in open(path)]
    models = list(dict.fromkeys(r["model"] for r in rows))
    summary = {}
    for model in models:
        print(f"[{model}]")
        print(f"  {'method':<11} {'fence':>5} {'parse':>6} {'schema':>7} {'value':>6}"
              f" {'person':>7} {'date':>5} {'amount':>7}  {'tokens':>6} {'sec/call':>8}"
              f"  {'tok/s':>5}  {'rep spread':>10}  same")
        summary[model] = {}
        for method in METHODS:
            rs = [r for r in rows if r["model"] == model and r["method"] == method]
            if not rs:
                continue
            first = [r for r in rs if r["rep"] == 0]
            n = len(first)
            sc = [score(r["content"], answers[r["id"]]) for r in first]
            cnt = {k: sum(s[k] for s in sc) for k in ("parse", "schema", "value")}
            cnt["fenced"] = sum(fenced(r["content"]) for r in first)
            fld = {k: sum(s["fields"].get(k, False) for s in sc)
                   for k in ("person", "date", "amount_yen")}
            # 時間: 他のモデルとの入れ替えで毎回読み込みが入るので、total_duration ではなく
            # プロンプトの処理と生成の時間(prompt_eval + eval)を使う。
            # 繰り返しごとに 1 呼び出しの中央値を出し、その中央値と幅を見る
            # 繰り返したのは先頭の TIMING_ITEMS 件だけなので、時間はその件数で比べる
            timed = [r for r in rs if r["id"] < TIMING_ITEMS]
            per_rep = defaultdict(list)
            for r in timed:
                per_rep[r["rep"]].append(r)
            med = [statistics.median(x["prompt_eval_s"] + x["eval_s"] for x in v)
                   for v in per_rep.values()]
            tps = statistics.median(r["eval_count"] / r["eval_s"] for r in timed if r["eval_s"])
            toks = statistics.median(r["eval_count"] for r in first)
            # 繰り返した入力のうち、応答の文字列が全ての回で同じだった件数
            by_id = defaultdict(set)
            for r in timed:
                by_id[r["id"]].add(r["content"])
            same = sum(len(v) == 1 for v in by_id.values())
            n_timed = len(by_id)
            spread = f"{min(med):.2f}-{max(med):.2f}" if len(med) > 1 else "-"
            same_s = f"{same}/{n_timed}" if len(med) > 1 else "-"
            print(f"  {method:<11} {cnt['fenced']:>5} {cnt['parse']:>3}/{n} {cnt['schema']:>4}/{n} {cnt['value']:>3}/{n}"
                  f" {fld['person']:>7} {fld['date']:>5} {fld['amount_yen']:>7}  {toks:>6.0f}"
                  f" {statistics.median(med):>8.2f}  {tps:>5.1f}  {spread:>10}  {same_s}")
            summary[model][method] = {"n": n, **cnt, **fld, "tokens": toks,
                                      "sec_median": statistics.median(med),
                                      "sec_reps": med, "tok_per_s": tps, "same": same, "n_timed": n_timed,
                                      "length_stop": sum(r["done_reason"] == "length" for r in first)}
        print()
    if out_path:
        with open(out_path, "w") as f:
            json.dump(summary, f, indent=2, ensure_ascii=False)


if __name__ == "__main__":
    main()
形と値の結果
形の崩れ方
以下が採点の結果です。3 つのモデルについて、方式ごとにパースできた率、スキーマに合った率、3 つの値が全て正解だった率を並べています。
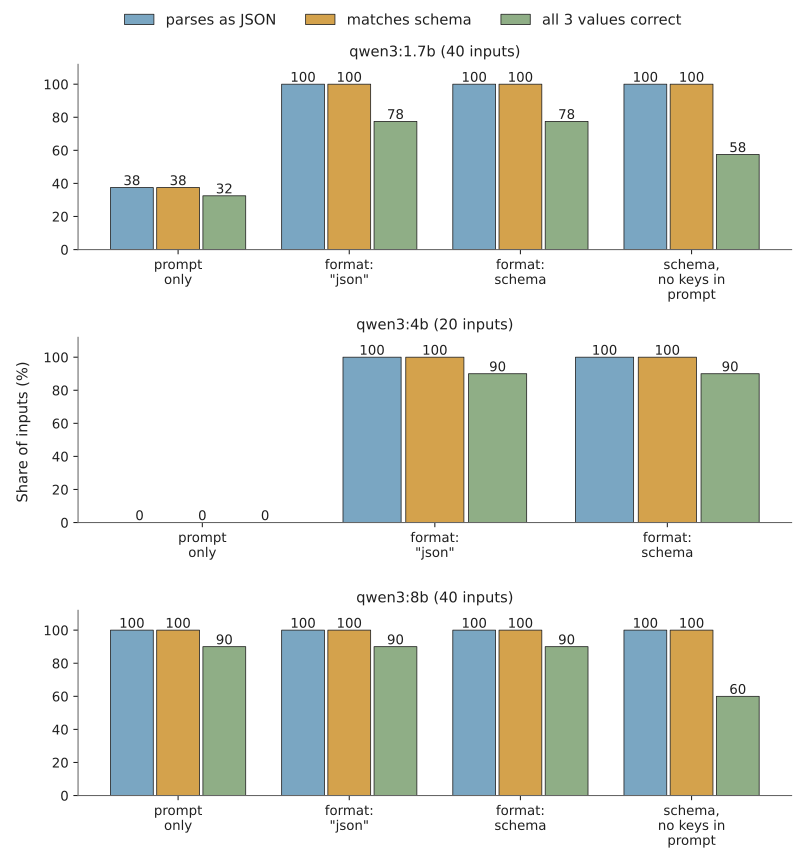
方式ごとのパース・スキーマ・値の正解率
採点の出力
出力のファイルは output_evaluate.txt です。fence は Markdown の囲みを外せば読めた件数、parse・schema・value は 3 段の判定を通った件数、person・date・amount は値ごとに正解と一致した件数です。tokens は生成したトークン数の中央値です。sec/call から右は時間とぶれの列で、生成時間の節で使います。
$ uv run --with jsonschema==4.25.1 python3 evaluate.py results.jsonl summary.json
[qwen3:1.7b-q4_K_M]
  method      fence  parse  schema  value  person  date  amount  tokens sec/call  tok/s  rep spread  same
  prompt         25  15/40   15/40  13/40      14    14      15      44     0.93   46.6   0.79-1.91  13/20
  json            0  40/40   40/40  31/40      36    35      40      37     0.76   48.6   0.72-1.46  20/20
  schema          0  40/40   40/40  31/40      36    35      40      37     0.77   49.2   0.69-1.66  20/20
  schema_bare     0  40/40   40/40  23/40      28    32      40      38     0.87   52.5           -  -
[qwen3:4b]
  method      fence  parse  schema  value  person  date  amount  tokens sec/call  tok/s  rep spread  same
  prompt          0   0/20    0/20   0/20       0     0       0     512    11.52   44.8           -  -
  json            0  20/20   20/20  18/20      20    18      20      42     1.16   42.3           -  -
  schema          0  20/20   20/20  18/20      20    18      20      42     0.82   56.6           -  -
[qwen3:8b]
  method      fence  parse  schema  value  person  date  amount  tokens sec/call  tok/s  rep spread  same
  prompt          0  40/40   40/40  36/40      40    38      37      42     1.84   23.8           -  -
  json            0  40/40   40/40  36/40      40    38      37      42     1.93   22.9           -  -
  schema          0  40/40   40/40  36/40      40    38      37      42     1.76   25.5           -  -
  schema_bare     0  40/40   40/40  24/40      27    36      40      42     1.82   25.4           -  -
プロンプトで頼むだけの場合、パースできた率はモデルで大きく違いました。qwen3:1.7b は 40 件中 15 件で、失敗した 25 件は全て Markdown の囲みでした(採点の出力の fence の 25)。囲みを外せば全て読めたので、中身の JSON は書けています。
qwen3:8b は、同じプロンプトで 40 件全てを囲み無しで返しました。qwen3:4b が 20 件中 0 件なのは、形の問題ではなく思考の文が応答に混ざったからです(後述)。
JSON モードとスキーマは、3 つのモデルとも全ての応答がパースでき、スキーマにも合いました。qwen3:1.7b と qwen3:8b では、JSON モードとスキーマの応答の文字列が 40 件全てで同じでした(qwen3:8b は、プロンプトだけの応答も同じでした)。
プロンプトにキー名と日付の形式を書いてあるので、モデルは JSON モードでもスキーマ通りの形を選んでいたわけです。スキーマで縛る効果は、この課題では JSON モードとの差として現れませんでした。
一方で、値が全て正解だった件数は、スキーマでも qwen3:1.7b が 40 件中 31 件、qwen3:8b が 36 件、qwen3:4b が 20 件中 18 件でした。誤りは、例えば次の通りです。いずれもスキーマには合っています。
| 入力の一部 | 応答 | 正解 |
|---|---|---|
| 令和8年5月1日に開かれた勉強会で | "date": "2023-05-01"(qwen3:1.7b と qwen3:8b) | 2026-05-01 |
| 渡辺由美様より、…ご入金を確認 | "person": "渡辺由美様"(qwen3:1.7b) | 渡辺由美 |
| 12,800円(税込、送料500円を含む)を請求 | "amount_yen": 13300(qwen3:8b) | 12800 |
| 参加者12名分の会場費980円を立て替えた | "amount_yen": 11760(qwen3:8b) | 980 |
qwen3:1.7b は、和暦の 8 件のうち 5 件で年を間違えました。qwen3:8b は、送料を足したり、12 人分を掛けたりと、文に無い計算をしています。プロンプトで「敬称を付けない」と頼んでも、qwen3:1.7b は 4 件で「様」「さん」を残しました。
スキーマをプロンプトに書かない場合
前述の通り、スキーマはモデルに見えません。そこで、プロンプトからキー名・日付の形式・「JSON で答えて」という指示を消し、「名前、日付、金額を取り出してください」とだけ書いて、同じスキーマで縛りました(schema_bare)。
採点の出力の schema_bare の行と、上記の図の右端の棒が、その結果です。キー名をプロンプトに書いていなくても、全ての応答がスキーマに合いました。文法が { の後に "person" しか許さないので、モデルはそのキーを書くしかありません。日付も、pattern に縛られて全て YYYY-MM-DD の形になりました。
しかし、値が全て正解だった件数は、qwen3:1.7b が 31 件から 23 件、qwen3:8b が 36 件から 24 件に下がりました。主に下がったのは名前で、「敬称を付けない」という指示が消えたので、2 つのモデルとも 12〜13 件で「さん」「様」が付いたままになりました。形はスキーマで縛れても、値の決まりごとは、モデルに伝えなければ守られません。
生成時間
時間は、qwen3:1.7b で先頭の 20 件を 3 回ずつ解かせて測りました。計測中は同じ Ollama と GPU を他の作業も使っており、モデルの入れ替えで毎回読み込みが入りました。そのため、読み込みを含む total_duration ではなく、プロンプトの処理と生成の時間(prompt_eval_duration と eval_duration の和)で比べています。
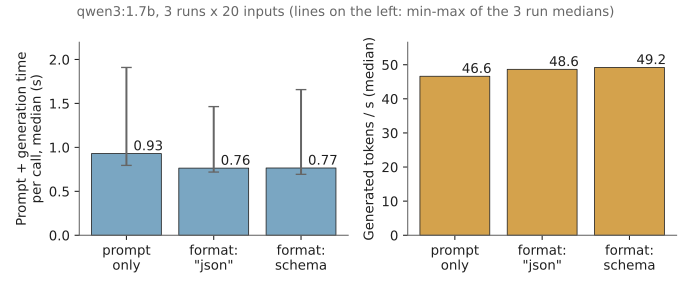
qwen3:1.7b の方式ごとの生成時間と速さ
3 回の中央値は、同じ方式でも最大で 2.4 倍ぶれました(左のグラフの線)。このぶれの中で、方式による差は見えません。1 秒あたりの生成トークン数も、プロンプトだけが 46.6、JSON モードが 48.6、スキーマが 49.2 で、文法の判定で遅くなった様子はありませんでした。プロンプトだけの方が少し長いのは、囲みの分だけトークン数が多い(中央値 44.5 と 37)からです。
文法の判定が軽く済むのは、前述の通り、モデルが選んだトークンが文法に合う間は、語彙全体を調べないからだと考えられます。この課題は、モデルが自分から形を守る場面が大半でした。モデルが文法に合わない候補を選び続ける課題(例えば、プロンプトに書いていない深い入れ子の形)では、語彙全体の判定が毎トークン走るので、結果は変わる可能性があります。
なお、temperature 0 と seed を固定しても、プロンプトだけの方式では、20 件中 7 件で 3 回の応答が一致しませんでした。囲みの有無や、和暦から変換した年が変わっています。JSON モードとスキーマは、20 件とも 3 回同じ応答でした。
思考モードと format
qwen3:4b は、モデルのメタデータ(ollama show の general.finetune)が Thinking のモデルです。チャットテンプレートは応答の頭に必ず <think> を置くので、"think": false を指定しても思考は止まりません。Ollama は、その思考の文を thinking に分けずに content に入れて返しました。
実験の 512 トークンの上限では、プロンプトだけの 20 件全てが、英語の思考(“Okay, let’s tackle this problem.” で始まる文)の途中で切れています。
思考と format の関係を見るために、qwen3:1.7b と qwen3:4b に、同じ入力を think と format の組み合わせで解かせました(lab/think.py、上限は 4,096 トークン)。
以下は、qwen3:4b の 4 つの組の出力です。
qwen3:4b think=false format=none   thinking=    0 chars  tokens=2387  eval=  89.7 s  wall= 301.4 s  done=stop
    content: Okay, let's tackle this problem. So, I need to extract the names of th
    ...末尾: </think> {"person": "松本彩", "date": "2024-03-19", "amount_yen": 120000}
qwen3:4b think=false format=schema thinking=    0 chars  tokens=  42  eval=   1.3 s  wall=  16.5 s  done=stop
    content: { "person": "松本彩", "date": "2024-03-19", "amount_yen": 120000 }
qwen3:4b think=true  format=none   thinking= 7964 chars  tokens=2387  eval=  80.7 s  wall=  83.1 s  done=stop
    content: {"person": "松本彩", "date": "2024-03-19", "amount_yen": 120000}
qwen3:4b think=true  format=schema thinking= 7964 chars  tokens=  37  eval=   1.4 s  wall=  89.1 s  done=stop
    content: {"person": "松本彩", "date": "2024-03-19", "amount_yen": 120000}
qwen3:1.7b を含む出力の全体
全体は output_think.txt にもあります。
$ python3 think.py qwen3:1.7b-q4_K_M 3; python3 think.py qwen3:4b 3
qwen3:1.7b-q4_K_M think=false format=none   thinking=    0 chars  tokens=  46  eval=   1.1 s  wall=  12.0 s  done=stop
    content: ```json { "person": "松本彩", "date": "2024-03-19", "amount_yen": 120000
qwen3:1.7b-q4_K_M think=false format=schema thinking=    0 chars  tokens=  37  eval=   0.9 s  wall=   1.1 s  done=stop
    content: {"person": "松本彩", "date": "2024-03-19", "amount_yen": 120000}
qwen3:1.7b-q4_K_M think=true  format=none   thinking= 1168 chars  tokens= 463  eval=   7.4 s  wall=   7.7 s  done=stop
    content: { "person": "松本彩", "date": "2024-03-19", "amount_yen": 120000 }
qwen3:1.7b-q4_K_M think=true  format=schema thinking= 1116 chars  tokens=  42  eval=   1.7 s  wall=  13.6 s  done=stop
    content: { "person": "松本彩", "date": "2024-03-19", "amount_yen": 120000 }
qwen3:4b think=false format=none   thinking=    0 chars  tokens=2387  eval=  89.7 s  wall= 301.4 s  done=stop
    content: Okay, let's tackle this problem. So, I need to extract the names of th
    ...末尾: </think> {"person": "松本彩", "date": "2024-03-19", "amount_yen": 120000}
qwen3:4b think=false format=schema thinking=    0 chars  tokens=  42  eval=   1.3 s  wall=  16.5 s  done=stop
    content: { "person": "松本彩", "date": "2024-03-19", "amount_yen": 120000 }
qwen3:4b think=true  format=none   thinking= 7964 chars  tokens=2387  eval=  80.7 s  wall=  83.1 s  done=stop
    content: {"person": "松本彩", "date": "2024-03-19", "amount_yen": 120000}
qwen3:4b think=true  format=schema thinking= 7964 chars  tokens=  37  eval=   1.4 s  wall=  89.1 s  done=stop
    content: {"person": "松本彩", "date": "2024-03-19", "amount_yen": 120000}
think.py の全体(50 行)
"""think(思考モード)と format の組み合わせで、思考の文がどこに返るかを見る。

同じ入力 1 件を、think: false / true と format 無し / スキーマの組で解かせ、
content の先頭、thinking の長さ、生成したトークン数と時間を出す。
tokens と eval は Ollama の応答の eval_count と eval_duration、wall は要求を送ってから応答が返るまでの時間。

使い方:
    OLLAMA_HOST=127.0.0.1:11435 python3 think.py <モデル> <入力の番号> [think の値,...]
"""
import json
import os
import sys
import time
import urllib.request

from run import PROMPT, SCHEMA
from texts import make_items


def main():
    model, idx = sys.argv[1], int(sys.argv[2])
    thinks = [v == "true" for v in sys.argv[3].split(",")] if len(sys.argv) > 3 else [False, True]
    host = os.environ.get("OLLAMA_HOST", "127.0.0.1:11434")
    text = make_items()[idx]["text"]
    for think in thinks:
        for name, fmt in (("none", None), ("schema", SCHEMA)):
            body = {"model": model, "stream": False, "think": think,
                    "messages": [{"role": "user", "content": PROMPT.format(text=text)}],
                    "options": {"temperature": 0, "seed": 42, "num_predict": 4096}}
            if fmt is not None:
                body["format"] = fmt
            req = urllib.request.Request(f"http://{host}/api/chat",
                                         data=json.dumps(body).encode(),
                                         headers={"Content-Type": "application/json"})
            t0 = time.perf_counter()
            with urllib.request.urlopen(req, timeout=1800) as r:
                res = json.load(r)
            wall = time.perf_counter() - t0
            msg = res["message"]
            flat = " ".join(msg["content"].split())
            print(f"{model} think={str(think).lower():<5} format={name:<6} "
                  f"thinking={len(msg.get('thinking', '')):>5} chars  "
                  f"tokens={res['eval_count']:>4}  eval={res['eval_duration'] / 1e9:6.1f} s  "
                  f"wall={wall:6.1f} s  done={res['done_reason']}\n    content: {flat[:70]}")
            if len(flat) > 140:
                print(f"    ...末尾: {flat[-70:]}")


if __name__ == "__main__":
    main()
"think": false の qwen3:4b は、2,387 トークンの思考を content に書き、</think> の後に JSON を置きました。</think> より後を切り出せば読めますが、生成に 90 秒近くかかる思考の分の時間は払っています。
同じ "think": false でスキーマを付けると、思考は消えました。文法が 1 トークン目に { しか許さないので、モデルは Okay と書き出せず、42 トークンで JSON を返しています。
Ollama は、"think": true の時だけ、応答から <think> と </think> の間を thinking に切り分けるパーサーを用意します(server/routes.go)。さらに、その時は思考の間だけ format を外して生成し(同じファイル)、本文が始まったところで format を付けて生成をやり直します(本文の始まりの検出、やり直し)。
モデルの定義に専用のパーサー(Modelfile の PARSER)が無い今回の qwen3 では、"think": false の時はどちらも行わないので、文法は 1 トークン目から掛かり、思考を書く余地がありません。PARSER を持つモデルでは、"think": false でも思考の間に format を外す場合があります。
"think": true にすると、思考は thinking に、JSON は content に分かれて返りました。スキーマを付けても思考の長さ(7,964 文字)は同じで、content だけが文法に従っています。この時の tokens の 37 は、やり直した後の生成だけの数です。思考を含めた待ち時間は wall の 89 秒で、スキーマを付けない時と変わりません。
保証されること・されないこと
3 方式が保証するものを実験の結果と合わせて整理すると、以下の通りです。
| 項目 | プロンプトだけ | JSON モード | JSON Schema |
|---|---|---|---|
| 応答全体が JSON として読める | 保証しない | 保証する(上限で切れない限り) | 保証する(同左) |
| キー名・型・必須項目 | 保証しない | 保証しない | 保証する(文法に変換できた範囲で) |
| 値が正しい | 保証しない | 保証しない | 保証しない |
制約付きデコードが守るのは、文字列が文法に合うことだけです。文法から見ると、"2023-05-01" と "2026-05-01" はどちらも正しい日付の形です。どちらを選ぶかはモデルの確率で決まり、和暦を読み違えたモデルは、間違った年を正しい形で書きます。そのため、取り出した値は、アプリケーション側で検証する必要があります。例えば、日付が実在するか、金額が入力の文字列に現れる数と一致するか、といった検証です。
「上限で切れない限り」も重要な条件です。生成の上限のトークン数に達すると、文法の途中で生成が止まり、閉じ括弧の無い JSON が返ります。Ollama の応答では、done_reason が length になります。OpenAI のドキュメントも、上限に達した場合と、モデルが安全上の理由で答えを拒否した場合は、スキーマに合わない応答が返り得ると断っています。
欠点と注意点
書かれていない値を作る
スキーマで amount_yen を必須の整数にすると、モデルは必ず整数を書きます。入力に金額が書かれていない場合も同じです。金額の無い文で試すと、以下の通りでした(lab/missing.py)。
text: 佐藤花子さんから2025年6月1日に、先月の請求書について問い合わせの電話があった。
qwen3:1.7b-q4_K_M  integer           -> {"person": "佐藤花子さん", "date": "2025-06-01", "amount_yen": 0}
qwen3:1.7b-q4_K_M  integer|null      -> {"person": "佐藤花子さん", "date": "2025-06-01", "amount_yen": 0}
qwen3:1.7b-q4_K_M  integer|null+ask  -> {"person": "佐藤花子さん", "date": "2025-06-01", "amount_yen": null}
qwen3:8b           integer           -> {"person": "佐藤花子", "date": "2025-06-01", "amount_yen": 0}
qwen3:8b           integer|null      -> {"person": "佐藤花子", "date": "2025-06-01", "amount_yen": 0}
qwen3:8b           integer|null+ask  -> { "person": "佐藤花子", "date": "2025-06-01", "amount_yen": null }
missing.py の全体(35 行)
"""金額が書かれていない文を、スキーマで縛って解かせる(値を作ってしまうかを見る)。

amount_yen を必須の整数にしたスキーマ(run.py の SCHEMA)、null も許すスキーマ、
null も許した上でプロンプトに「書かれていない項目は null」と足した場合(integer|null+ask)の 3 つで、同じ文を解かせる。

使い方:
    OLLAMA_HOST=127.0.0.1:11435 python3 missing.py <モデル>...
"""
import copy
import os
import sys

from run import PROMPT, SCHEMA, chat

TEXT = "佐藤花子さんから2025年6月1日に、先月の請求書について問い合わせの電話があった。"

NULLABLE = copy.deepcopy(SCHEMA)
NULLABLE["properties"]["amount_yen"] = {"type": ["integer", "null"]}
PROMPT_NULL = PROMPT.replace("\n\n文:", "\n文に書かれていない項目は null にしてください。\n\n文:")


def main():
    host = os.environ.get("OLLAMA_HOST", "127.0.0.1:11434")
    print(f"text: {TEXT}")
    for model in sys.argv[1:]:
        for name, schema, prompt in (("integer", SCHEMA, PROMPT),
                                     ("integer|null", NULLABLE, PROMPT),
                                     ("integer|null+ask", NULLABLE, PROMPT_NULL)):
            res = chat(host, model, TEXT, schema, prompt)
            out = " ".join(res["message"]["content"].split())  # 改行と字下げを詰めて 1 行で表示
            print(f"{model:<18} {name:<17} -> {out}")


if __name__ == "__main__":
    main()
どちらのモデルも、金額を 0 円としました。スキーマで null を許しても、プロンプトに書かなければ 0 のままです。モデルにはスキーマが見えないので、null を選べることを知りません。プロンプトに「文に書かれていない項目は null」と足すと、2 つのモデルとも null を返しました。0 円の取引と「金額の記載が無い」を区別したい場合は、スキーマとプロンプトの両方に逃げ道を書く必要があります。
スキーマの全ての機能は使えない
Ollama は、llama.cpp の変換関数でスキーマを文法に変換します。llama.cpp の文法のドキュメント(Ollama v0.22.1 が取り込んでいるコミット)によると、変換できるのは JSON Schema の一部です。例えば、minimum と maximum は整数にしか効かず、uniqueItems や条件分岐(if / then)は変換されません。変換できない指定は、エラーにならずに無視される場合があります。また、pattern は ^ と $ で囲む必要があります。
そのため、スキーマに書いた制約が生成で守られたと決め付けず、受け取った後に同じスキーマで検証します。実験の jsonschema による検証が、これに当たります。
形の制約が推論の邪魔になる場合がある
冒頭の図で、モデルが最も書きたかったのは囲みでした。文法はその候補を外し、確率が 23% しかなかった候補を選ばせます。この課題は答えが短いので値への影響は見えませんでしたが、Tam 氏らの論文(2024 年)は、JSON などの形式を強く縛るほど、推論が必要な課題の正答率が下がったと報告しています。
考える過程が必要な課題では、先に自由な文章や思考モードで考えさせ、最後の答えだけを縛る方が、この影響を避けやすいと考えられます。Ollama が思考モードのモデルで行っている「思考の後に縛る」動きも、この形です。