量子化(quantization)は、モデルの重みを FP16 などの浮動小数点数から、8 bit や 4 bit の小さな整数に丸めて保存する手法です。丸めた整数と、整数を元の大きさに戻すための係数(スケール)だけを持つので、ファイルもメモリも小さくなります。その代わり、元の値との間に丸めの誤差が入ります。
例えば、Ollama(手元で LLM を動かす OSS)で配られている Qwen3(Alibaba の Qwen チームが公開している LLM)の 1.7B(17 億パラメータ)のモデルは、2026 年 11 月 10 日時点で FP16 のモデルが 4.07 GB、8 bit のモデル(q8_0)が 2.22 GB、4 bit のモデル(q4_K_M)が 1.36 GB です。
以下は、同じ 8 個の重みを 16・8・4 bit で持った時の図です。左は重み 1 個が使うビットの幅、右は元の値(白丸)と、丸めてから戻した値(色付きの丸)の位置です。
同じ 8 個の重みを 16・8・4 bit で持った時の幅と丸め
本記事では、LLM の推論で使われる量子化の基本について、手元の Ollama で測った値と一緒に説明します。次の疑問に答えます。
- なぜ重みを小さくすると、ファイルとメモリだけでなく生成も速くなるのか。
- ブロックごとのスケールと整数への丸めは、どう計算するのか。
- GGUF(llama.cpp や Ollama が使うモデルのファイル形式)の Q8_0 と Q4_K_M は何が違い、ファイルの中で何 bit になっているのか。
- 4 bit に詰めると、答えの正しさはどれだけ落ちるのか。
学習しながら量子化する手法(量子化を意識した学習)や、GPTQ のように較正用のデータで丸め方を最適化する手法の細部は説明しません。
前提: 重みと 1 トークンの生成
LLM は、多数の線形層(入力のベクトルに重み行列を掛ける層)を重ねたネットワークです。重み行列の値はパラメータと呼ばれ、qwen3:1.7b では約 17 億個あります。FP16(16 bit の浮動小数点数)なら 1 個 2 バイトなので、重みだけで 3〜4 GB です。
文章の生成は、1 トークン(単語や単語の一部。トークナイザーのノートを参照)ずつ進みます。次の 1 トークンを出すたびに、全ての層の重み行列を 1 回ずつ読み、入力のベクトルを掛けます。
一方で、プロンプトの処理は、入力の数百トークンをまとめて行列に並べ、重みを 1 回読む間に数百本のベクトルを掛けます。同じ重み行列でも、掛ける相手の本数が違います。
生成とプロンプト処理で、重み 1 個あたりの計算回数
重みを小さく持ちたい理由
重みを 4 bit に詰めると、FP16 の 4 分の 1 になります。小さくなって助かる場面は 3 つあります。
- ダウンロードとディスクの量が減ります。
- GPU(行列の計算を並列に行う装置)のメモリに載せる量が減り、より大きなモデルや長い文脈を同じ機材で扱えます。
- 1 トークンごとに読む量が減るので、メモリ帯域で決まる生成が速くなります。
LoRA のノートでは、追加学習した差分を細長い 2 つの行列にして小さく配る LoRA(Low-Rank Adaptation)を説明しました。LoRA が小さくするのは追加分で、ベースモデルの重みはそのままです。量子化は、ベースモデルの重み本体を小さくします。2 つは組み合わせられ、4 bit に量子化したベースモデルに LoRA を学習させる QLoRA という手法もあります。
ただし、何も考えずに 4 bit の整数にすると、値の範囲が合いません。重みの多くは 0 付近の小さな値で、行列によって大きさの幅も違います。そこで、少数の重みごとに「整数 1 目盛りがいくつか」を表すスケールを持ちます。
ブロックごとのスケールと丸め
llama.cpp(Ollama が内部で使う推論エンジン)の Q8_0 は、重みを 32 個ずつのブロックに分けて丸めます。計算は次の通りです。
d   = (ブロック内の |x| の最大値) / 127      ← スケール。FP16 で 1 個持つ
q_i = round(x_i / d)                        ← -127〜127 の整数。int8 で 32 個持つ
x_i ≈ d × q_i                               ← 使う時に戻す
1 ブロックは FP16 のスケール 2 バイトと整数 32 バイトで 34 バイトなので、重み 1 個あたり 8.5 bit です。最大の値がちょうど 127 に乗るようにスケールを選ぶので、ブロック内のどの値もはみ出しません。
4 bit の Q4_0 も形は同じで、整数が -8〜7 の 16 段になります。絶対値が最大の値を -8 に合わせて d を決め、1 ブロックは 2 + 16 = 18 バイト、重み 1 個あたり 4.5 bit です。
例えば、qwen3:1.7b の 1 層目の重み行列(blk.0.ffn_gate.weight)の最初のブロックで計算すると、後ろの 8 個は次のようになります(実験 2 の出力の抜粋)。
  FP16        : [-0.0034  0.0422 -0.0659 -0.0288 -0.0198  0.0025 -0.0334 -0.0898]
  Q8_0  d=0.000708  ints: [-5, 60, -93, -41, -28, 4, -47, -127]
        restored: [-0.0035  0.0425 -0.0658 -0.0290 -0.0198  0.0028 -0.0333 -0.0899]
  Q4_0  d=0.011230  ints: [0, 4, -6, -3, -2, 0, -3, -8]
        restored: [ 0.0000  0.0449 -0.0674 -0.0337 -0.0225  0.0000 -0.0337 -0.0898]
最後の -0.0898 がこのブロックで絶対値が最大の値で、Q8_0 では -127、Q4_0 では -8 になります。Q4_0 では目盛りの幅が 0.0112 もあるので、-0.0034 と 0.0025 はどちらも 0 に、-0.0288 と -0.0334 はどちらも -0.0337 に潰れます。冒頭の図は、この 8 個を描いたものです。
ブロックを小さく切るのは、大きな値の影響をそのブロックの中に閉じ込めたいからです。行列全体で 1 つのスケールにすると、どこかに極端に大きな値が 1 個あるだけで目盛りが粗くなり、残りの小さな値がほとんど 0 に潰れます。32 個ごとなら、粗くなるのはその値を含むブロックだけです。
Q4_K と Q4_K_M
Q4_K は、2023 年に llama.cpp に入った k-quants の 1 つで、4 bit の型です。256 個の重みを 1 つの大ブロックにし、その中を 32 個ずつ 8 つの小ブロックに分けます。小ブロックごとにスケールと最小値を 6 bit で持ち、重みを次の形で戻します。
x ≈ (d × sc_j) × q − (dmin × m_j)    q: 0〜15、sc_j と m_j: 小ブロック j の 6 bit の値
                                     d と dmin: 大ブロックに 1 個ずつの FP16
最小値を引く分だけ、正と負に偏ったブロックでも 16 段を無駄なく使えます。ggml-common.h の block_q4_K は、FP16 が 2 個(4 バイト)、6 bit の値 16 個(12 バイト)、4 bit の整数 256 個(128 バイト)の計 144 バイトで、重み 1 個あたり 4.5 bit です。
256 個の重みで Q8_0・Q4_0 と並べると、Q4_K は Q4_0 と同じ 144 バイトのまま、小ブロックごとに最小値も持っていることが分かります。帯の長さはバイト数に比例しています。
256 個の重みのバイト配置(Q8_0・Q4_0・Q4_K)
2026 年 11 月 10 日時点の llama.cpp の master(コミット 3837bf0)の llama-quant.cpp では、Q4_K_M を選ぶと大半の行列を Q4_K にし、出力の層(output.weight)と、FFN(各層で注意機構の後に置かれた全結合のネットワーク)の出口の行列(ffn_down)の半分ほどの層を 6 bit の Q6_K にします。誤差が答えに響きやすい行列にだけビットを足す考え方です。
実験 1: GGUF のヘッダーから型を数える
実験は全て、2026 年 11 月 10 日に Ollama 0.22.1 で行いました。モデルの digest などは lab/README.txt に記録しています。
Ollama のモデルは、llama.cpp の GGUF 形式のファイルとして保存されています。GGUF は、先頭にマジック GGUF、形式のバージョン、テンソルの数、メタデータの数を置き、続けてメタデータ(キーと値)とテンソルの一覧(名前・形・型・データの位置)を並べた形式です。ヘッダーだけを読めば、4 GB のファイルでも中身を読まずに、型ごとの個数とバイト数を数えられます。
lab/gguf_header.py は、Python の標準ライブラリだけでこれを数えます。以下はヘッダーを読む部分の抜粋です。型番号とブロックの大きさの表、集計と表示を含む全体は、下に折りたたんでいます。
# lab/gguf_header.py から抜粋(Reader は struct で数値と文字列を読む小さなクラス)
def read_gguf(path):
    """GGUF のヘッダー(メタデータとテンソルの一覧)を返す。"""
    with open(path, "rb") as f:
        r = Reader(f)
        if f.read(4) != b"GGUF":
            raise ValueError(f"{path} is not GGUF")
        version = r.unpack("<I")
        n_tensors, n_kv = r.unpack("<Q"), r.unpack("<Q")
        meta = {}
        for _ in range(n_kv):
            key = r.string()
            meta[key] = r.value(r.unpack("<I"))
        tensors = []
        for _ in range(n_tensors):
            name = r.string()
            n_dims = r.unpack("<I")
            shape = [r.unpack("<Q") for _ in range(n_dims)]
            ttype = r.unpack("<I")
            offset = r.unpack("<Q")
            tensors.append({"name": name, "shape": shape, "type": ttype, "offset": offset})
        align = meta.get("general.alignment", 32)
        data_start = (f.tell() + align - 1) // align * align
    return version, meta, tensors, data_start
gguf_header.py の全体(136 行)
"""GGUF ファイルのヘッダーだけを読み、テンソルの型ごとの個数とバイト数を数える。

テンソルの中身は読まない。Python 標準ライブラリだけで動く。

使い方:
    python3 gguf_header.py <名前>=<GGUF のパス> [<名前>=<GGUF のパス> ...] [--json 結果.json]
"""
import json
import os
import struct
import sys
from collections import defaultdict

# ggml の型番号 -> (名前, 1 ブロックの要素数, 1 ブロックのバイト数)
# 値は llama.cpp の ggml/src/ggml.c の type_traits と ggml-common.h の構造体の大きさ
GGML_TYPES = {
    0: ("F32", 1, 4),
    1: ("F16", 1, 2),
    2: ("Q4_0", 32, 18),
    3: ("Q4_1", 32, 20),
    6: ("Q5_0", 32, 22),
    7: ("Q5_1", 32, 24),
    8: ("Q8_0", 32, 34),
    10: ("Q2_K", 256, 84),
    11: ("Q3_K", 256, 110),
    12: ("Q4_K", 256, 144),
    13: ("Q5_K", 256, 176),
    14: ("Q6_K", 256, 210),
    30: ("BF16", 1, 2),
}

# GGUF のメタデータの値の型番号 -> struct の書式(8: 文字列、9: 配列は別に処理する)
SCALAR = {0: "<B", 1: "<b", 2: "<H", 3: "<h", 4: "<I", 5: "<i", 6: "<f",
          7: "<?", 10: "<Q", 11: "<q", 12: "<d"}


class Reader:
    def __init__(self, f):
        self.f = f

    def unpack(self, fmt):
        size = struct.calcsize(fmt)
        return struct.unpack(fmt, self.f.read(size))[0]

    def string(self):
        n = self.unpack("<Q")
        return self.f.read(n).decode("utf-8", errors="replace")

    def value(self, vtype):
        if vtype == 8:
            return self.string()
        if vtype == 9:
            itype, count = self.unpack("<I"), self.unpack("<Q")
            return [self.value(itype) for _ in range(count)]
        return self.unpack(SCALAR[vtype])


def read_gguf(path):
    """GGUF のヘッダー(メタデータとテンソルの一覧)を返す。"""
    with open(path, "rb") as f:
        r = Reader(f)
        if f.read(4) != b"GGUF":
            raise ValueError(f"{path} is not GGUF")
        version = r.unpack("<I")
        n_tensors, n_kv = r.unpack("<Q"), r.unpack("<Q")
        meta = {}
        for _ in range(n_kv):
            key = r.string()
            meta[key] = r.value(r.unpack("<I"))
        tensors = []
        for _ in range(n_tensors):
            name = r.string()
            n_dims = r.unpack("<I")
            shape = [r.unpack("<Q") for _ in range(n_dims)]
            ttype = r.unpack("<I")
            offset = r.unpack("<Q")
            tensors.append({"name": name, "shape": shape, "type": ttype, "offset": offset})
        align = meta.get("general.alignment", 32)
        data_start = (f.tell() + align - 1) // align * align
    return version, meta, tensors, data_start


def tensor_bytes(t):
    _, block, nbytes = GGML_TYPES[t["type"]]
    n = 1
    for d in t["shape"]:
        n *= d
    return n, n // block * nbytes


def summarize(label, path):
    version, meta, tensors, data_start = read_gguf(path)
    by_type = defaultdict(lambda: {"tensors": 0, "params": 0, "bytes": 0})
    for t in tensors:
        n, b = tensor_bytes(t)
        s = by_type[GGML_TYPES[t["type"]][0]]
        s["tensors"] += 1
        s["params"] += n
        s["bytes"] += b
    params = sum(s["params"] for s in by_type.values())
    weight_bytes = sum(s["bytes"] for s in by_type.values())
    size = os.path.getsize(path)
    print(f"[{label}] {os.path.basename(path)[:19]}...")
    print(f"  file size        : {size:,} bytes")
    print(f"  GGUF version     : {version}, metadata keys: {len(meta)}, tensors: {len(tensors)}")
    print(f"  general.file_type: {meta.get('general.file_type')}")
    print(f"  params           : {params:,}")
    print(f"  weight bytes     : {weight_bytes:,} ({weight_bytes * 8 / params:.2f} bits/param)")
    print(f"  header + padding : {data_start:,} bytes")
    for name, s in sorted(by_type.items(), key=lambda x: -x[1]["bytes"]):
        print(f"    {name:5s} tensors {s['tensors']:4d}  params {s['params']:13,}"
              f"  bytes {s['bytes']:13,}  ({s['bytes'] * 8 / s['params']:.4f} bits/param)")
    return {"file_size": size, "params": params, "weight_bytes": weight_bytes,
            "file_type": meta.get("general.file_type"), "by_type": dict(by_type),
            "tensor_types": {t["name"]: GGML_TYPES[t["type"]][0] for t in tensors}}


def main():
    args = sys.argv[1:]
    out = None
    if "--json" in args:
        i = args.index("--json")
        out = args[i + 1]
        del args[i:i + 2]
    result = {}
    for a in args:
        label, path = a.split("=", 1)
        result[label] = summarize(label, path)
        print()
    if out:
        with open(out, "w") as f:
            json.dump(result, f, indent=1)


if __name__ == "__main__":
    main()
Ollama は、モデルのファイルを <モデルの置き場所>/blobs/sha256-<ダイジェスト> という名前で保存しています(どの blob が本体かの調べ方は lab/README.txt に書きました)。q4_K_M の blob を渡した結果は次の通りです。q8_0 と fp16 を含む全体は lab/output_gguf.txt にあります。
[q4_K_M] sha256-3d0b790534fe...
  file size        : 1,359,279,776 bytes
  params           : 2,031,739,904
  weight bytes     : 1,353,328,640 (5.33 bits/param)
  header + padding : 5,951,136 bytes
    Q4_K  tensors  155  params 1,485,570,048  bytes   835,633,152  (4.5000 bits/param)
    Q6_K  tensors   15  params   487,325,696  bytes   399,759,360  (6.5625 bits/param)
    F16   tensors   28  params    58,720,256  bytes   117,440,512  (16.0000 bits/param)
    F32   tensors  113  params       123,904  bytes       495,616  (32.0000 bits/param)
ollama list の表示(1.4 GB・2.2 GB・4.1 GB)と、ファイルの大きさは一致しました。ファイルの大きさは、トークナイザーの語彙などが入ったヘッダー(約 6 MB)と、重みのバイト数の合計とぴったり同じです。3 つのファイルで型ごとのバイト数を積み上げると、以下の通りです。
qwen3:1.7b の 3 つの型のファイルの大きさと中身の型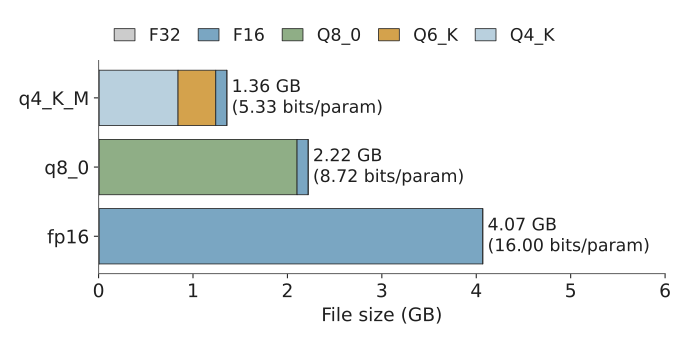
ffn_down)と、F16 のまま残った attn_v(注意機構の値の行列)が足されているからです。
attn_v は、q8_0 でも F16 のままでした。2026 年 11 月 10 日時点の llama.cpp の master では、Q4_K_M なら attn_v の一部の層を Q6_K にします(llama-quant.cpp の該当行)。
Ollama も llama.cpp の規則を Go に移した自前の量子化のコード(Ollama 0.22.1 の server/quantization.go)を持っており、その規則も同じです。このファイルを作った時の規則は、どちらとも違うことになります。理由はファイルからは分かりません。
ちなみに、パラメータ数は 1.7B ではなく 20.3 億個と出ました。Qwen3-1.7B の config.json は tie_word_embeddings: true で、入力の埋め込み(token_embd)と出力の層で同じ行列を共有しています。GGUF では 2 つが別のテンソルとして入っているので、151,936 × 2,048 ≈ 3.1 億個を 2 回数えています。差し引くと約 17.2 億個で、モデル名と合います。
実験 2: 1 つの行列を自分で丸める
ファイルの型が分かったので、丸めの誤差を 1 つの行列で測ります。lab/block_error.py は、FP16 のファイルから blk.0.ffn_gate.weight(2,048 × 6,144、約 1,258 万個)を読み、NumPy(Python の数値計算ライブラリ)で Q8_0 と Q4_0 に丸めて戻します。
あわせて、Ollama の q8_0 と q4_K_M のファイルに入っている同じ行列も、llama.cpp と同じ計算で戻して並べます。
誤差は、FP16 との差の二乗平均の平方根(RMSE)を重みの二乗平均の平方根で割った相対値(relative RMSE)で比べます。8 bit と 4 bit で何倍違うかを見るのが目的です。
以下が丸める部分です。Q4_K の小ブロックと同じ「最小値と幅」で丸める関数、Ollama のファイルを戻す関数を含む全体は、下に折りたたんでいます。
# lab/block_error.py から抜粋
def roundf(x):
    """C の roundf と同じく、ちょうど 0.5 は 0 から遠い側に丸める(np.round は偶数側)。"""
    t = np.trunc(x)
    return t + np.where(np.abs(x - t) >= 0.5, np.sign(x), 0)


def quant_q8_0(x):
    """32 個ごとに d = max|x| / 127 を求め、x / d を -127〜127 の整数に丸める。
    llama.cpp の quantize_row_q8_0_ref と同じく、丸めには FP32 の d の逆数を使い、
    d を FP16 にするのはファイルに書く時だけ。"""
    b = x.reshape(-1, 32)
    d32 = np.abs(b).max(axis=1) / np.float32(127)
    inv = np.divide(np.float32(1), d32, out=np.zeros_like(d32), where=d32 != 0)
    q = roundf(b * inv[:, None]).astype(np.int8)
    d = d32.astype(np.float16)                                 # ファイルには FP16 で入る
    return q, d, (q * d.astype(np.float32)[:, None]).reshape(-1)


def quant_q4_0(x):
    """32 個ごとに、絶対値が最大の値を -8 に合わせた d を持ち、-8〜7 の整数に丸める。"""
    b = x.reshape(-1, 32)
    idx = np.abs(b).argmax(axis=1)
    mx = b[np.arange(len(b)), idx]                           # 符号付きの最大値
    d32 = mx / np.float32(-8)
    inv = np.divide(np.float32(1), d32, out=np.zeros_like(d32), where=d32 != 0)
    q = np.clip(np.floor(b * inv[:, None] + 8.5), 0, 15).astype(np.int8) - 8   # (int8_t)(x + 8.5f)
    d = d32.astype(np.float16)                                 # Q8_0 と同じく FP16 は保存用
    return q, d, (q * d.astype(np.float32)[:, None]).reshape(-1)
block_error.py の全体(168 行)
"""1 つの重み行列を自分で Q8_0 と 4 bit に丸め、FP16 との誤差を測る。

Ollama の q8_0・q4_K_M のファイルに入っている同じ行列も復元して並べる。

使い方:
    python3 block_error.py <fp16 の GGUF> <q8_0 の GGUF> <q4_K_M の GGUF> [結果の JSON]
"""
import json
import sys

import numpy as np

from gguf_header import read_gguf

TENSOR = "blk.0.ffn_gate.weight"   # 2048 x 6144。どちらの量子化でも整数に丸められている層


def load_raw(path, name):
    """GGUF から 1 つのテンソルのバイト列を、行(ne0 方向)ごとに読み出す。"""
    _, _, tensors, data_start = read_gguf(path)
    t = next(x for x in tensors if x["name"] == name)
    return t, np.memmap(path, mode="r", offset=data_start + t["offset"], dtype=np.uint8)


def load_f16(path, name):
    t, raw = load_raw(path, name)
    n = int(np.prod(t["shape"]))
    return raw[: n * 2].view(np.float16).astype(np.float32)


# --- 自分で丸める ------------------------------------------------------------

def roundf(x):
    """C の roundf と同じく、ちょうど 0.5 は 0 から遠い側に丸める(np.round は偶数側)。"""
    t = np.trunc(x)
    return t + np.where(np.abs(x - t) >= 0.5, np.sign(x), 0)


def quant_q8_0(x):
    """32 個ごとに d = max|x| / 127 を求め、x / d を -127〜127 の整数に丸める。
    llama.cpp の quantize_row_q8_0_ref と同じく、丸めには FP32 の d の逆数を使い、
    d を FP16 にするのはファイルに書く時だけ。"""
    b = x.reshape(-1, 32)
    d32 = np.abs(b).max(axis=1) / np.float32(127)
    inv = np.divide(np.float32(1), d32, out=np.zeros_like(d32), where=d32 != 0)
    q = roundf(b * inv[:, None]).astype(np.int8)
    d = d32.astype(np.float16)                                 # ファイルには FP16 で入る
    return q, d, (q * d.astype(np.float32)[:, None]).reshape(-1)


def quant_q4_0(x):
    """32 個ごとに、絶対値が最大の値を -8 に合わせた d を持ち、-8〜7 の整数に丸める。"""
    b = x.reshape(-1, 32)
    idx = np.abs(b).argmax(axis=1)
    mx = b[np.arange(len(b)), idx]                           # 符号付きの最大値
    d32 = mx / np.float32(-8)
    inv = np.divide(np.float32(1), d32, out=np.zeros_like(d32), where=d32 != 0)
    q = np.clip(np.floor(b * inv[:, None] + 8.5), 0, 15).astype(np.int8) - 8   # (int8_t)(x + 8.5f)
    d = d32.astype(np.float16)                                 # Q8_0 と同じく FP16 は保存用
    return q, d, (q * d.astype(np.float32)[:, None]).reshape(-1)


def quant_q4_min(x):
    """32 個ごとに最小値 m と幅 d を持ち、(x - m) / d を 0〜15 の整数に丸める(Q4_K の小ブロックと同じ形)。"""
    b = x.reshape(-1, 32)
    lo, hi = b.min(axis=1), b.max(axis=1)
    d = ((hi - lo) / 15).astype(np.float16).astype(np.float32)
    lo = lo.astype(np.float16).astype(np.float32)
    inv = np.divide(1.0, d, out=np.zeros_like(d), where=d != 0)
    q = np.clip(np.round((b - lo[:, None]) * inv[:, None]), 0, 15).astype(np.int8)
    return q, d, (q * d[:, None] + lo[:, None]).reshape(-1)


# --- Ollama のファイルを復元する(llama.cpp の dequantize_row_q8_0 / q4_K と同じ計算)--

def dequant_q8_0(raw, n):
    blocks = raw[: n // 32 * 34].reshape(-1, 34)
    d = blocks[:, :2].copy().view(np.float16).astype(np.float32)   # (nb, 1)
    q = blocks[:, 2:].copy().view(np.int8).astype(np.float32)
    return (q * d).reshape(-1)


def dequant_q4_k(raw, n):
    """256 個の大ブロック = FP16 の d と dmin、6 bit の scale と min が 8 組、4 bit の整数 256 個。"""
    blocks = raw[: n // 256 * 144].reshape(-1, 144)
    d = blocks[:, 0:2].copy().view(np.float16).astype(np.float32)[:, 0]
    dmin = blocks[:, 2:4].copy().view(np.float16).astype(np.float32)[:, 0]
    s = blocks[:, 4:16].astype(np.int32)
    qs = blocks[:, 16:144]
    sc = np.empty((len(blocks), 8), np.int32)
    mn = np.empty((len(blocks), 8), np.int32)
    for j in range(8):                                   # get_scale_min_k4()
        if j < 4:
            sc[:, j] = s[:, j] & 63
            mn[:, j] = s[:, j + 4] & 63
        else:
            sc[:, j] = (s[:, j + 4] & 0xF) | ((s[:, j - 4] >> 6) << 4)
            mn[:, j] = (s[:, j + 4] >> 4) | ((s[:, j] >> 6) << 4)
    out = np.empty((len(blocks), 256), np.float32)
    for k in range(4):                                   # 64 個ずつ: 下位 4 bit が前半 32 個、上位が後半
        q = qs[:, k * 32:(k + 1) * 32]
        for half, vals in ((0, q & 0xF), (1, q >> 4)):
            j = 2 * k + half
            out[:, j * 32:(j + 1) * 32] = (d * sc[:, j])[:, None] * vals - (dmin * mn[:, j])[:, None]
    return out.reshape(-1)


def rel_rmse(x, y):
    return float(np.sqrt(np.mean((x - y) ** 2)) / np.sqrt(np.mean(x ** 2)))


def main():
    fp16_path, q8_path, q4_path = sys.argv[1:4]
    out_path = sys.argv[4] if len(sys.argv) > 4 else None
    w = load_f16(fp16_path, TENSOR)
    n = w.size

    # 1 ブロック(32 個)の数値例。絶対値が最大の値(32 個目)を含む後ろの 8 個を表示する
    blk = w[:32]
    q8, d8, r8 = quant_q8_0(blk)
    q4, d4, r4 = quant_q4_0(blk)
    print(f"{TENSOR}: {n:,} weights, first block (32 weights), last 8 shown")
    print(f"  FP16        : {np.array2string(blk[24:], precision=4, floatmode='fixed')}")
    print(f"  Q8_0  d={float(d8[0]):.6f}  ints: {q8[0, 24:].tolist()}")
    print(f"        restored: {np.array2string(r8[24:], precision=4, floatmode='fixed')}")
    print(f"  Q4_0  d={float(d4[0]):.6f}  ints: {q4[0, 24:].tolist()}")
    print(f"        restored: {np.array2string(r4[24:], precision=4, floatmode='fixed')}")
    print(f"  max |error| in this block: Q8_0 {np.abs(blk - r8).max():.5f}, "
          f"Q4_0 {np.abs(blk - r4).max():.5f}  (max |w| {np.abs(blk).max():.5f})")

    # 行列全体の誤差
    _, raw8 = load_raw(q8_path, TENSOR)
    _, raw4 = load_raw(q4_path, TENSOR)
    mine8 = quant_q8_0(w)[2]
    olla8 = dequant_q8_0(raw8, n)
    rows = {
        "Q8_0 (mine)": mine8,
        "Q8_0 (Ollama q8_0 file)": olla8,
        "Q4_0 (mine)": quant_q4_0(w)[2],
        "Q4 scale+min (mine)": quant_q4_min(w)[2],
        "Q4_K (Ollama q4_K_M file)": dequant_q4_k(raw4, n),
    }
    print(f"\nwhole matrix ({n:,} weights), error relative to FP16")
    result = {"tensor": TENSOR, "n": n, "rel_rmse": {}}
    for k, v in rows.items():
        e = rel_rmse(w, v)
        result["rel_rmse"][k] = e
        print(f"  {k:27s} relative RMSE {e * 100:6.3f} %   max |error| {np.abs(w - v).max():.5f}")
    same = int(np.sum(mine8 == olla8))
    print(f"\nQ8_0 mine vs Ollama: {same:,} / {n:,} weights identical ({same / n * 100:.4f} %)")
    result["q8_identical"] = same

    # 誤差のヒストグラム用(図に使う)
    hist = {}
    edges = np.linspace(-0.02, 0.02, 81)
    for k in ("Q8_0 (Ollama q8_0 file)", "Q4_K (Ollama q4_K_M file)"):
        h, _ = np.histogram(rows[k] - w, bins=edges)
        hist[k] = h.tolist()
    result["hist_edges"] = edges.tolist()
    result["hist"] = hist
    result["block"] = {"w": blk.tolist(), "q8": r8.tolist(), "q4": r4.tolist()}
    if out_path:
        with open(out_path, "w") as f:
            json.dump(result, f, indent=1)


if __name__ == "__main__":
    main()
行列全体の誤差は次の通りです。左は relative RMSE、右は戻した値と元の値の差が、どれだけの重みでどの大きさだったかの分布です(右の 2 本は Ollama のファイルの値)。出力の全体は lab/output_block.txt にあります。
丸めた重みの誤差(relative RMSE と差の分布)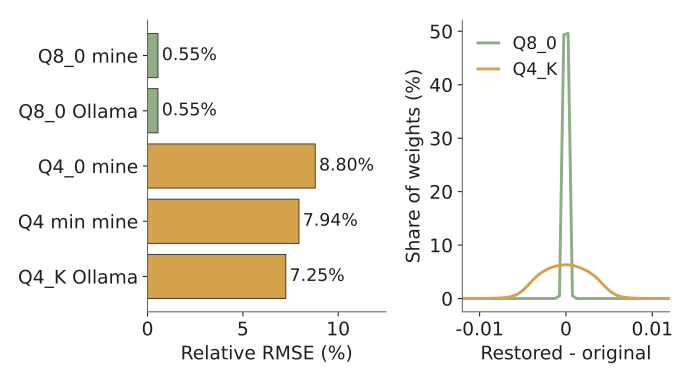
自分で丸めた Q8_0 は、Ollama の q8_0 のファイルと 12,582,912 個の全ての重みで同じ値になりました。llama.cpp の quantize_row_q8_0_ref と同じく、整数への丸めには FP32 のままのスケールの逆数を使い、ちょうど 0.5 は絶対値が大きくなる向きに丸め(C の roundf)、スケールを FP16 にするのはファイルに書く時だけにしています。
最初に書いたコードは、FP16 に丸めた後のスケールの逆数と、ちょうど 0.5 を偶数に丸める NumPy の np.round を使っており、一致は 99.2% でした。Q4_0 も、quantize_row_q4_0_ref と同じく FP32 のスケールで丸めています。
実験 3: 生成とプロンプト処理の速さ
前提の節の通り、生成の 1 トークンごとに重みを全て読むなら、生成の速さは読むバイト数にほぼ反比例する筈です。実験 1 の重みのバイト数から、入力の埋め込み(1 トークンにつき 1 行しか読まない)を除くと、1 トークンあたりに読む量は q4_K_M が約 1.18 GB、q8_0 が約 1.88 GB、FP16 が約 3.44 GB です。
生成では重みのほかに KV キャッシュ(過去のトークンの計算結果。KV キャッシュのノートを参照)も読み、950 トークンの入力では約 0.11 GB が 3 つのモデルに同じだけ足されます。FP16 に比べて、q8_0 は 1.8 倍、q4_K_M は 2.8 倍速くなる計算です。
lab/bench_speed.py は、Ollama の /api/chat に同じ依頼を送り、応答に入っている値から速さを出します。prompt_eval_count と prompt_eval_duration がプロンプト処理のトークン数とナノ秒、eval_count と eval_duration が生成のトークン数とナノ秒です。
プロンプトはチャットの書式を含めて 950 トークン、生成は 128 トークンで打ち切ります。Ollama 0.22.1 は直前のプロンプトと先頭が同じ部分の計算を使い回すので、毎回先頭に違う文字列を置いています。
# lab/bench_speed.py から抜粋
def generate(model, tag):
    # 先頭に毎回違う文字列を置き、前回のプロンプトのキャッシュを使わせない
    prompt = f"Request {tag}.\n{NOTES}\n\n{TASK}"
    return post("/api/chat", {
        "model": model,
        "messages": [{"role": "user", "content": prompt}],
        "think": False,
        "stream": False,
        "keep_alive": "10m",
        "options": {"temperature": 0, "seed": 1, "num_predict": 128, "num_ctx": 4096},
    })
bench_speed.py の全体(106 行)
"""3 つのモデルで、プロンプト処理と生成の速さ(tokens/s)を繰り返し測る。

Ollama の応答の prompt_eval_count / prompt_eval_duration と
eval_count / eval_duration から速さを出す。思考モードは "think": false で無効にする。
マシンの負荷がぶれるので、モデルを 1 回ずつ順に回す周回を ROUNDS 回繰り返し、中央値を採る。
各回の前後で /api/ps(ollama ps と同じ情報)と負荷平均を記録する。

使い方:
    OLLAMA_HOST=127.0.0.1:11435 python3 bench_speed.py speed.json
"""
import json
import os
import statistics
import sys
import time
import urllib.request

MODELS = ["qwen3:1.7b-q4_K_M", "qwen3:1.7b-q8_0", "qwen3:1.7b-fp16"]
ROUNDS = 9
BASE = "http://" + os.environ.get("OLLAMA_HOST", "127.0.0.1:11435")

# プロンプト処理を測るための長めの入力(チャットの書式を含めて 950 トークン)
NOTES = "\n".join(
    f"Log {i}: at {i % 24:02d}:{(i * 7) % 60:02d} the keeper checked lamp {i % 5}, "
    f"wrote the wind speed {(i * 13) % 40} knots, and refilled {(i * 3) % 9} liters of oil."
    for i in range(1, 25))
TASK = "Using the logs above, write a long story of at least 300 words about the lighthouse keeper."


def post(path, body):
    req = urllib.request.Request(BASE + path, data=json.dumps(body).encode(),
                                 headers={"Content-Type": "application/json"})
    with urllib.request.urlopen(req, timeout=3600) as r:   # 他の作業の待ち行列で長く待つことがある
        return json.load(r)


def loaded():
    with urllib.request.urlopen(BASE + "/api/ps", timeout=60) as r:
        return [m["name"] for m in json.load(r)["models"]]


def generate(model, tag):
    # 先頭に毎回違う文字列を置き、前回のプロンプトのキャッシュを使わせない
    prompt = f"Request {tag}.\n{NOTES}\n\n{TASK}"
    return post("/api/chat", {
        "model": model,
        "messages": [{"role": "user", "content": prompt}],
        "think": False,
        "stream": False,
        "keep_alive": "10m",
        "options": {"temperature": 0, "seed": 1, "num_predict": 128, "num_ctx": 4096},
    })


def main():
    out_path = sys.argv[1]
    runs = []
    for model in MODELS:                       # 読み込みの時間を計測から外す
        generate(model, f"warmup-{model}")
    for rnd in range(ROUNDS):
        for model in MODELS:
            before = loaded()
            load1 = os.getloadavg()[0]
            res = generate(model, f"{rnd}-{model}-{time.time_ns()}")
            after = loaded()
            run = {
                "round": rnd, "model": model, "loadavg_1m": round(load1, 1),
                "ps_before": before, "ps_after": after,
                "prompt_tokens": res["prompt_eval_count"],
                # キャッシュから読んだトークン(返す版だけ)を除き、計算したトークンだけで割る
                "prompt_cached": res.get("prompt_eval_cached_count", 0),
                "prompt_tps": (res["prompt_eval_count"] - res.get("prompt_eval_cached_count", 0))
                / res["prompt_eval_duration"] * 1e9,
                "eval_tokens": res["eval_count"],
                "eval_tps": res["eval_count"] / res["eval_duration"] * 1e9,
                # 思考の文が混ざっていないか(混ざると eval_count に思考のトークンが入る)
                "thinking_chars": len(res["message"].get("thinking", "")),
                "think_tag": "<think>" in res["message"]["content"],
            }
            runs.append(run)
            others = sorted(set(before + after) - set(MODELS))
            print(f"round {rnd} {model:18s} prompt {run['prompt_tokens']:4d} tok "
                  f"(cached {run['prompt_cached']:3d}) "
                  f"{run['prompt_tps']:8.1f} tok/s | gen {run['eval_tokens']:4d} tok "
                  f"{run['eval_tps']:6.1f} tok/s | thinking {run['thinking_chars']} chars"
                  f"{' <think>!' if run['think_tag'] else ''} | load {load1:6.1f} | other models: "
                  f"{', '.join(others) or '-'}", flush=True)
    print()
    summary = {}
    for model in MODELS:
        rs = [r for r in runs if r["model"] == model]
        p = [r["prompt_tps"] for r in rs]
        g = [r["eval_tps"] for r in rs]
        summary[model] = {"prompt_median": statistics.median(p), "prompt_min": min(p),
                          "prompt_max": max(p), "eval_median": statistics.median(g),
                          "eval_min": min(g), "eval_max": max(g)}
        s = summary[model]
        print(f"{model:18s} prompt median {s['prompt_median']:7.1f} tok/s "
              f"({s['prompt_min']:.1f}-{s['prompt_max']:.1f}) | gen median "
              f"{s['eval_median']:5.1f} tok/s ({s['eval_min']:.1f}-{s['eval_max']:.1f})")
    with open(out_path, "w") as f:
        json.dump({"runs": runs, "summary": summary}, f, indent=1)


if __name__ == "__main__":
    main()
計測したマシンは他の作業にも使われており、各回の直前の負荷平均(1 分)は 4.6〜21.7 でした。同じ Ollama を他のエージェントも使っています。
そこで、3 つのモデルを 1 回ずつ順に回す周回を 9 回繰り返して中央値を採り、各回の前後に /api/ps(ollama ps と同じ情報)で読み込まれているモデルを記録しました。思考モードはここでも "think": false で無効にし、各回の思考の文の長さ(thinking)も記録しています。結果は次の通りです。棒が 9 回の中央値、黒い点が各回の値です。
9 周回で測った、生成とプロンプト処理の速さ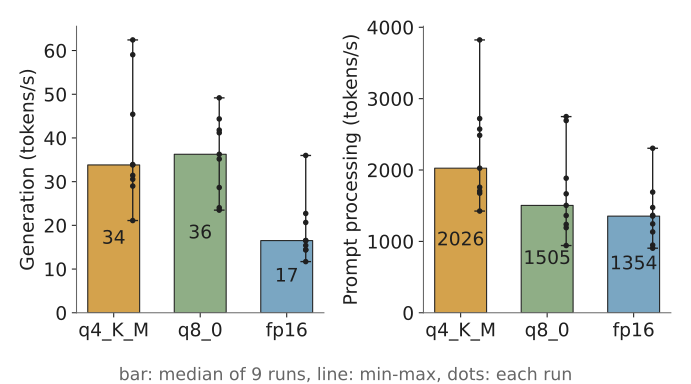
生成の中央値を FP16 との比にして、読む量から計算した比と並べると、q4_K_M だけが計算に届いていません。
FP16 に対する生成の速さの比(計算と実測)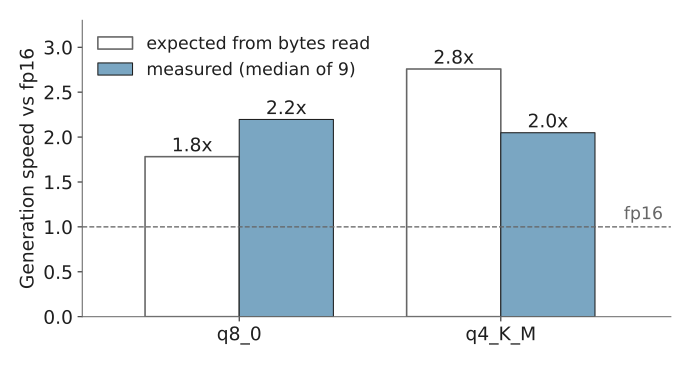
ただし、9 回の値は 21〜62 tokens/s と大きく散らばっており、q4_K_M と q8_0 の差はぶれの中に埋もれています。同じ q8_0 は、KV キャッシュのノートの実験 2 では約 540 トークンの入力で 92.0 tokens/s 出ており、本記事の中央値 36.3 の約 2.5 倍です。生成の速さが条件によって倍以上変わる環境なので、この結果から、q4_K_M が q8_0 より速くならないとまでは言えません。
1 秒に読む重みの量に直すと、q4_K_M の中央値は 33.8 × 1.18 ≈ 40 GB/s、q8_0 は 36.3 × 1.88 ≈ 68 GB/s です。帯域だけで決まるなら、どちらも同じ値に近づく筈です。
q4_K_M は q8_0 と同じ読み出しの速さに届いていないので、この環境では、4 bit の整数を戻す計算や、同じ GPU で動いていた他の作業のモデルなど、帯域以外のものが生成の速さを抑えていると考えられます(推測です。GPU の使用率までは測っていません)。全ての回で、他の作業の qwen3:4b が読み込まれていました。
プロンプト処理は、中央値では q4_K_M が最も速く出ましたが、最小と最大の幅が中央値の 2 倍近くあり、順位を言える精度ではありません。前提の節の通り、プロンプト処理は計算の速さで決まりやすいので、重みを小さくしても生成ほどの差は出にくい処理です。
なお、思考モードが本当に無効になっているかは、lab/check_thinking.py でも確かめました。実験 4 の 1 問と、実験 3 のプロンプトを同じ指定で送り、思考の文(message.thinking)の長さと、返答に <think> が含まれるかを表示します。比較のため、1 問だけは "think": true でも送っています。
以下は q4_K_M の結果で、3 つのモデルの全体は lab/output_check_thinking.txt にあります。
qwen3:1.7b-q4_K_M
  quiz, think=False      thinking     0 chars | <think> in content: False | eval_count    4 | content: "São Paulo"
  quiz, think=True       thinking   404 chars | <think> in content: False | eval_count   99 | content: "Rio de Janeiro"
  bench, think=False     thinking     0 chars | <think> in content: False | eval_count  128 | content: "The lighthouse keeper, a man of steady hands and u"
"think": false では、思考の文は 0 文字で、ブラジルの首都の答えは 4 トークンでした。"think": true にすると 99〜160 トークンに増え、その分が eval_count に入ります。実験 3 と実験 4 の値には、思考のトークンは入っていません。
ちなみに、q4_K_M は思考させるとブラジルの首都を Rio de Janeiro と答え、思考させなくても São Paulo と答えました。
実験 4: 同じ問題集の正答率
速くなっても、答えが変わっては困ります。そこで、答えが 1 つに決まる問題を本記事のために 100 問作り、3 つのモデルに解かせました。算数 40 問(3 桁の足し算、4 桁の引き算、2 桁の掛け算、箱とりんごの文章題を 10 問ずつ)は乱数の seed を固定して生成し、常識 60 問(首都、元素記号、作曲者など)は手で書いています。問題文は英語です。
Qwen3 は、答える前に考えを書き出す思考モード(thinking)を持っています。思考モードのままだと、答えの前に長い考えが出力され、比べたい答えの部分が埋もれるうえに時間もかかります。そこで、Ollama の API に "think": false を渡して思考モードを無効にし、system のメッセージで答えだけを出すよう指示しました。全ての返答で、思考の出力が空だったことも確かめています。
温度は 0、seed は 1 に固定しています(Qwen3-1.7B のモデルカードが勧める非思考モードの温度は 0.7 ですが、比べやすさを優先しました)。
# lab/eval_accuracy.py から抜粋
def chat(model, question):
    body = {
        "model": model,
        "messages": [{"role": "system", "content": SYSTEM},
                     {"role": "user", "content": question}],
        "think": False,                       # qwen3 の思考モードを無効にする
        "stream": False,
        "options": {"temperature": 0, "seed": 1, "num_predict": 128, "num_ctx": 4096},
    }
    req = urllib.request.Request(BASE + "/api/chat", data=json.dumps(body).encode(),
                                 headers={"Content-Type": "application/json"})
    with urllib.request.urlopen(req, timeout=600) as r:
        res = json.load(r)
    return res["message"]["content"], res["message"].get("thinking", "")


def is_correct(kind, reply, answers):
    text = reply.lower().replace(",", "")
    if kind == "math":
        nums = re.findall(r"-?\d+", text)
        return bool(nums) and nums[-1] == answers[0]       # 最後に出た整数で判定する
    return any(re.search(r"(?<![a-z0-9])" + re.escape(a) + r"(?![a-z0-9])", text)
               for a in answers)
make_problems.py(問題の一覧)と eval_accuracy.py の全体
"""答えが 1 つに決まる問題を 100 問作り、problems.json に書く(本記事のために自作した問題集)。

算数 40 問は乱数の seed を固定して生成し、常識 60 問は手で書いた。
使い方: python3 make_problems.py problems.json
"""
import json
import random
import sys

KNOWLEDGE = [
    # (問題, 正解として認める表記)
    ("What is the capital city of Australia?", ["canberra"]),
    ("What is the capital city of Canada?", ["ottawa"]),
    ("What is the capital city of Brazil?", ["brasilia", "brasília"]),
    ("What is the capital city of Turkey?", ["ankara"]),
    ("What is the capital city of Egypt?", ["cairo"]),
    ("What is the capital city of Kenya?", ["nairobi"]),
    ("What is the capital city of Peru?", ["lima"]),
    ("What is the capital city of Norway?", ["oslo"]),
    ("What is the capital city of Vietnam?", ["hanoi", "ha noi"]),
    ("What is the capital city of New Zealand?", ["wellington"]),
    ("What is the capital city of Morocco?", ["rabat"]),
    ("What is the capital city of Argentina?", ["buenos aires"]),
    ("What is the capital city of South Korea?", ["seoul"]),
    ("What is the capital city of Thailand?", ["bangkok"]),
    ("What is the capital city of Nigeria?", ["abuja"]),
    ("What is the chemical symbol for gold?", ["au"]),
    ("What is the chemical symbol for silver?", ["ag"]),
    ("What is the chemical symbol for sodium?", ["na"]),
    ("What is the chemical symbol for potassium?", ["k"]),
    ("What is the chemical symbol for iron?", ["fe"]),
    ("What is the chemical symbol for tungsten?", ["w"]),
    ("What is the chemical symbol for lead?", ["pb"]),
    ("What is the chemical symbol for mercury?", ["hg"]),
    ("Which chemical element has atomic number 1?", ["hydrogen"]),
    ("Which chemical element has atomic number 6?", ["carbon"]),
    ("Which chemical element has atomic number 10?", ["neon"]),
    ("Which planet is the largest in the Solar System?", ["jupiter"]),
    ("Which planet is closest to the Sun?", ["mercury"]),
    ("Which planet is known as the Red Planet?", ["mars"]),
    ("How many legs does a spider have?", ["8", "eight"]),
    ("How many sides does a hexagon have?", ["6", "six"]),
    ("At sea level, what is the boiling point of water in degrees Celsius?", ["100"]),
    ("What is the freezing point of water in degrees Fahrenheit?", ["32"]),
    ("Who wrote the play Romeo and Juliet?", ["shakespeare"]),
    ("Who wrote the novel Pride and Prejudice?", ["austen"]),
    ("Who wrote the novel Nineteen Eighty-Four?", ["orwell"]),
    ("Who painted the Mona Lisa?", ["leonardo", "da vinci"]),
    ("Who painted The Starry Night?", ["van gogh"]),
    ("Who composed the Moonlight Sonata?", ["beethoven"]),
    ("What is the largest ocean on Earth?", ["pacific"]),
    ("What is the longest river in South America?", ["amazon"]),
    ("What is the tallest mountain on Earth above sea level?", ["everest"]),
    ("What is the largest hot desert in the world?", ["sahara"]),
    ("What is the hardest natural mineral?", ["diamond"]),
    ("Which gas do plants absorb from the air for photosynthesis?", ["carbon dioxide", "co2"]),
    ("How many days are in a leap year?", ["366"]),
    ("What is the smallest prime number?", ["2", "two"]),
    ("What is the main language spoken in Brazil?", ["portuguese"]),
    ("What is the currency of Japan?", ["yen"]),
    ("Who developed the theory of general relativity?", ["einstein"]),
    ("Who formulated the three laws of motion published in the Principia?", ["newton"]),
    ("Which organ pumps blood through the human body?", ["heart"]),
    ("How many bones are in the adult human body?", ["206"]),
    ("In which year did humans first land on the Moon?", ["1969"]),
    ("In which year did the Berlin Wall fall?", ["1989"]),
    ("What is the fastest land animal?", ["cheetah"]),
    ("Which programming language was created by Guido van Rossum?", ["python"]),
    ("What is the largest country in the world by area?", ["russia"]),
    ("How many keys does a standard piano have?", ["88"]),
    ("What is the longest bone in the human body?", ["femur"]),
]


def arithmetic(rng):
    items = []
    for _ in range(10):
        a, b = rng.randint(100, 999), rng.randint(100, 999)
        items.append((f"What is {a} + {b}?", [str(a + b)]))
    for _ in range(10):
        a, b = rng.randint(1000, 9999), rng.randint(100, 999)
        items.append((f"What is {a} - {b}?", [str(a - b)]))
    for _ in range(10):
        a, b = rng.randint(11, 99), rng.randint(11, 99)
        items.append((f"What is {a} * {b}?", [str(a * b)]))
    for _ in range(10):
        boxes, per = rng.randint(12, 40), rng.randint(6, 24)
        sold = rng.randint(10, boxes * per - 10)
        items.append((f"A shop has {boxes} boxes with {per} apples in each box. "
                      f"It sells {sold} apples. How many apples are left?",
                      [str(boxes * per - sold)]))
    return items


def main():
    rng = random.Random(20261110)
    problems = []
    for i, (q, a) in enumerate(arithmetic(rng)):
        problems.append({"id": f"math{i:02d}", "kind": "math", "question": q, "answers": a})
    for i, (q, a) in enumerate(KNOWLEDGE):
        problems.append({"id": f"know{i:02d}", "kind": "knowledge", "question": q, "answers": a})
    with open(sys.argv[1], "w") as f:
        json.dump(problems, f, indent=1, ensure_ascii=False)
    print(f"{len(problems)} problems")


if __name__ == "__main__":
    main()
"""同じ問題集を 3 つのモデルに解かせ、正答率を数える。

思考モード(thinking)は "think": false で無効にし、答えだけを出させる。
温度 0・seed 固定なので、同じ環境なら同じ答えが返る想定。

使い方:
    OLLAMA_HOST=127.0.0.1:11435 python3 eval_accuracy.py problems.json accuracy.json
"""
import json
import os
import re
import sys
import urllib.request

MODELS = ["qwen3:1.7b-q4_K_M", "qwen3:1.7b-q8_0", "qwen3:1.7b-fp16"]
SYSTEM = "Answer with only the final answer. Do not explain."
BASE = "http://" + os.environ.get("OLLAMA_HOST", "127.0.0.1:11435")


def chat(model, question):
    body = {
        "model": model,
        "messages": [{"role": "system", "content": SYSTEM},
                     {"role": "user", "content": question}],
        "think": False,                       # qwen3 の思考モードを無効にする
        "stream": False,
        "options": {"temperature": 0, "seed": 1, "num_predict": 128, "num_ctx": 4096},
    }
    req = urllib.request.Request(BASE + "/api/chat", data=json.dumps(body).encode(),
                                 headers={"Content-Type": "application/json"})
    with urllib.request.urlopen(req, timeout=600) as r:
        res = json.load(r)
    return res["message"]["content"], res["message"].get("thinking", "")


def is_correct(kind, reply, answers):
    text = reply.lower().replace(",", "")
    if kind == "math":
        nums = re.findall(r"-?\d+", text)
        return bool(nums) and nums[-1] == answers[0]       # 最後に出た整数で判定する
    return any(re.search(r"(?<![a-z0-9])" + re.escape(a) + r"(?![a-z0-9])", text)
               for a in answers)


def main():
    problems = json.load(open(sys.argv[1]))
    out_path = sys.argv[2]
    result = {"models": {}}
    for model in MODELS:
        rows = []
        for p in problems:
            reply, thinking = chat(model, p["question"])
            ok = is_correct(p["kind"], reply, p["answers"])
            rows.append({"id": p["id"], "kind": p["kind"], "reply": reply.strip(),
                         "thinking_chars": len(thinking), "correct": ok})
        result["models"][model] = rows
        for kind in ("math", "knowledge"):
            sub = [r for r in rows if r["kind"] == kind]
            print(f"{model:20s} {kind:9s} {sum(r['correct'] for r in sub):3d} / {len(sub)}")
        total = sum(r["correct"] for r in rows)
        print(f"{model:20s} {'total':9s} {total:3d} / {len(rows)}"
              f"   (replies with thinking: {sum(r['thinking_chars'] > 0 for r in rows)})")
    # fp16 と答え(文字列)が一致した問題の数
    ref = result["models"][MODELS[-1]]
    for model in MODELS[:-1]:
        same = sum(a["reply"] == b["reply"] for a, b in zip(result["models"][model], ref))
        print(f"same reply as fp16: {model:20s} {same} / {len(ref)}")
    with open(out_path, "w") as f:
        json.dump(result, f, indent=1, ensure_ascii=False)


if __name__ == "__main__":
    main()
結果は次の通りです。出力は lab/output_accuracy.txt、各問の返答と採点は lab/accuracy.json にあります。
100 問(算数・常識)の正答の数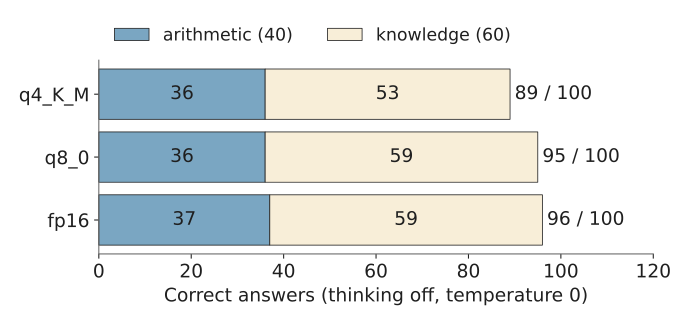
FP16 と q8_0 が正しく答え、q4_K_M だけが外した問題は次の通りです。
| 問題 | q4_K_M の答え | 正解 |
|---|---|---|
| ブラジルの首都 | São Paulo | Brasília |
| ペルーの首都 | Cusco | Lima |
| モロッコの首都 | Tangier | Rabat |
| 光合成で植物が取り込む気体 | Oxygen | Carbon dioxide |
| うるう年の日数 | 69 | 366 |
| 最小の素数 | 3 | 2 |
首都の 3 問は、どれも同じ国の別の有名な都市を答えています。サンパウロはブラジル最大の都市で、Cusco はペルーの古都です。重みの小さなずれが積み重なり、僅差で並んでいた候補の順位が入れ替わったと考えられます(推測です。各候補の確率までは測っていません)。
算数は 3 つとも 36〜37 問で、差が出ませんでした。ただし、中身は同じではありません。文章題では、q4_K_M だけが売った数をそのまま答えた問題が 2 問あり、逆に q8_0 が間違えた 2 問(そのうち 1 問は FP16 も間違えた)を q4_K_M は正しく解いています。
1.7B のモデルは思考モードなしでは文章題が安定しないので、量子化の差より問題ごとのぶれの方が大きく出ています。100 問では 1〜2 問の差は誤差の範囲で、6 問の差も、別の問題集で同じ大きさになるとは限りません。
利点と欠点
量子化の利点は、ここまでの実験で見た通り、同じモデルを小さく持てることです。ファイルの大きさ・生成の速さ・正答の数を 3 つの型で並べると、q8_0 は FP16 とほぼ同じ正答のまま、約半分の大きさになっています。
大きさ・生成の速さ・正答の数の並び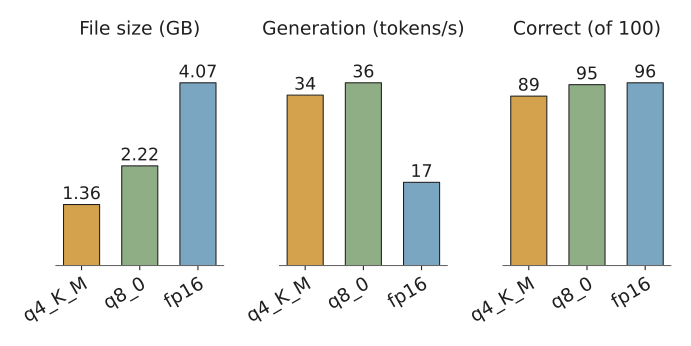
一方で、4 bit では答えが変わります。実験 4 では、算数より、首都のような知識を問う問題で取りこぼしました。100 問は少ないので、差の大きさは目安です。
速くなるのは、主にメモリ帯域で決まる生成です。実験 3 では、他の作業と GPU を取り合う環境で 4 bit と 8 bit の差がぶれに埋もれ、ビット数を半分にした分が速さに出るかまでは確かめられませんでした。プロンプトの処理は計算の速さで決まりやすいので、生成ほどの差は出にくくなります。
また、重みを量子化しても、文脈の長さに比例して増える KV キャッシュは小さくなりません。例えば、q4_K_M のファイルは 1.36 GB ですが、文脈の長さを 40,960 トークンで読み込んだ時、ollama ps の SIZE は 6.2 GB でした(num_ctx 4096 では 1.9 GB)。
誤差の出方は、モデルや層によって違います。本記事で測ったのは 1.7B の 1 つのモデルと 1 つの行列だけです。
どの型を選ぶかは、載せたい機材のメモリと、許せる答えの変化で決まります。8 bit はファイルを約半分にしながら答えがほとんど変わらず、4 bit はさらに小さい代わりに、答えが変わる問題が出ます。同じ 4 bit でも、Q4_K_M は一部の層にだけビットを足す型で、実験 1 の通り、その分だけファイルは 4.5 bit の計算より大きくなります。