Ollama は、手元の PC で LLM(Large Language Model、大規模言語モデル)を動かすソフトウェアです。Ollama でモデルを読み込む時には、モデルが一度に扱えるトークン数の上限(コンテキスト長)を num_ctx というオプションで決めます。トークンは、LLM が文章を読み書きする単位です(トークナイザーのノート)。
num_ctx は、Ollama が KV キャッシュのために用意する枠の数でもあります。KV キャッシュは、LLM が読んだトークンの計算結果(K と V と呼ばれる 2 種類のベクトル。以下 K・V)を取っておくメモリで、1 トークンにつき決まった大きさを使います(仕組みと大きさの計算は KV キャッシュのノート)。本記事では、この 1 トークン分の置き場所を枠と呼びます。
以下は、同じモデル(Qwen3-1.7B の重みを主に 4 ビットに詰めた q4_K_M)を num_ctx 4,096 と、num_ctx を指定せずに読み込んだ時の size の内訳です。size は、Ollama が報告する、読み込んだモデルが使うメモリの量です。
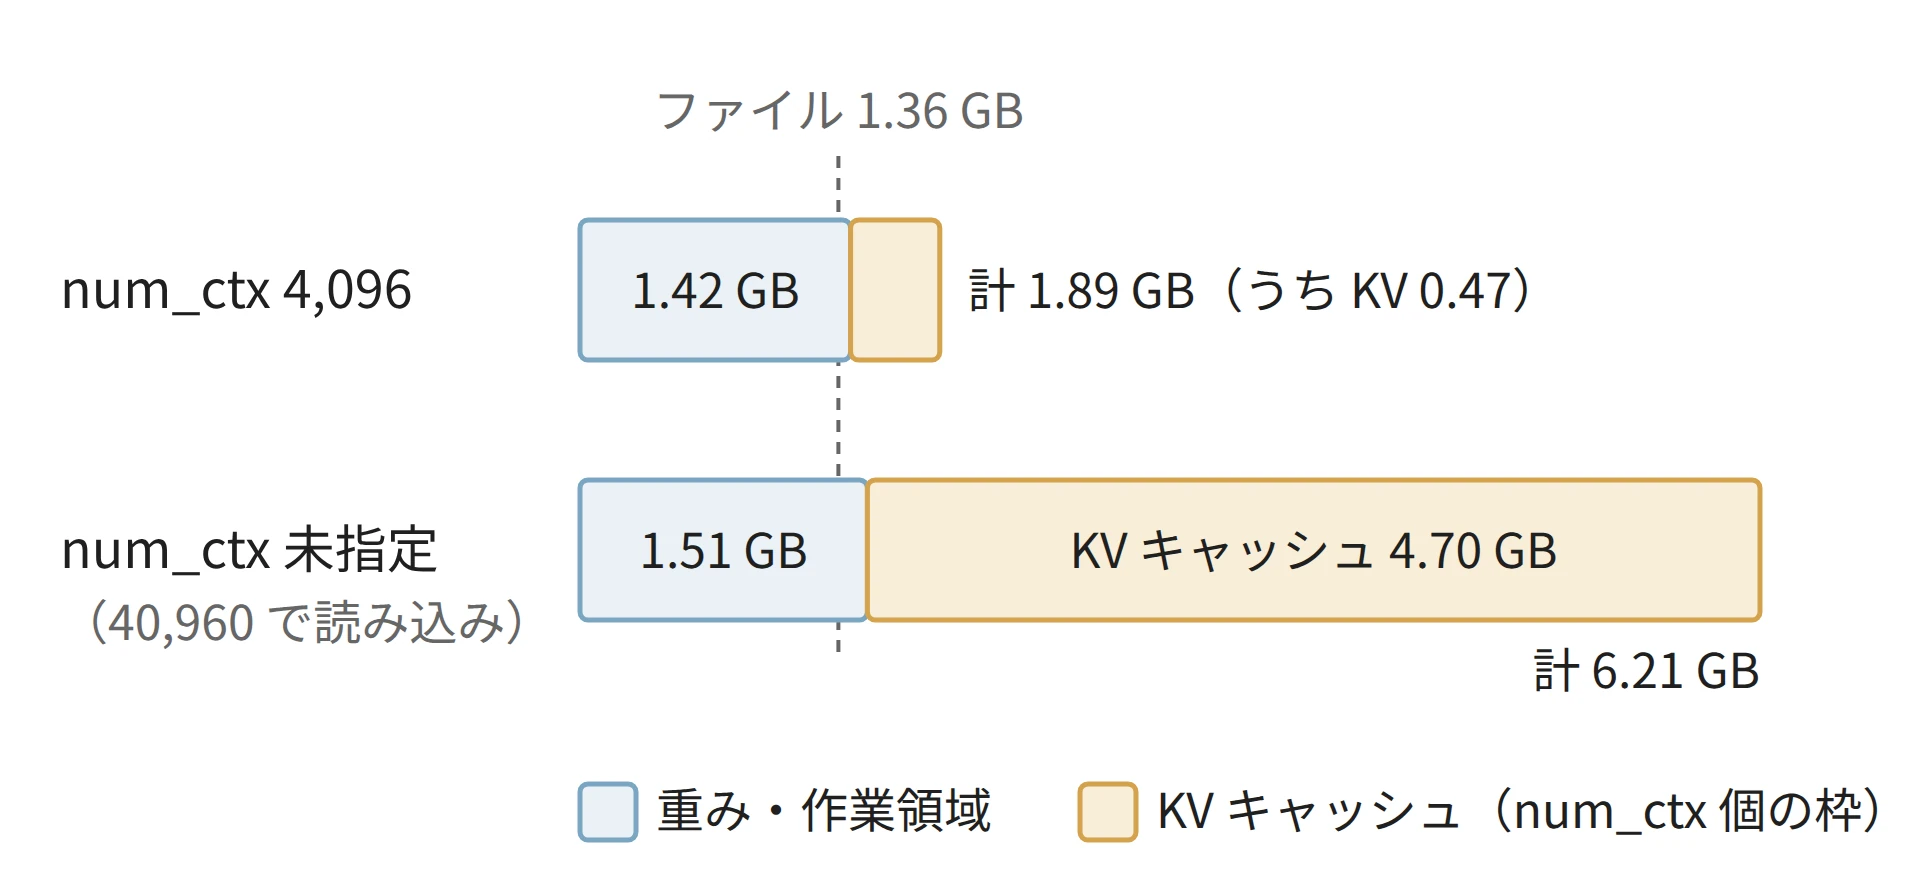
qwen3:1.7b-q4_K_M の size の内訳(KV キャッシュとそれ以外)
青の部分は、モデルの重み(学習で決まった数値で、ファイルの大部分)と計算用の作業領域です。ファイルが 1.36 GB のモデルでも、num_ctx を指定しないと 6.21 GB のメモリを使いました。増えた分のほとんどは、短い質問では使われない KV キャッシュの枠です。
本記事では、Ollama 0.22.1(2026 年 11 月)で num_ctx がどう決まり、メモリと入力にどう効くかを手元の実験で確かめます。
- num_ctx を指定しない時に、どの長さで読み込まれるか。
- 読み込んだモデルのメモリのうち、どれだけが KV キャッシュか。
- num_ctx より長い入力を送ると、何が起きるか。
- KV キャッシュのメモリを減らす設定と、前置きの使い回しが効いたかの確かめ方。
実験は KV キャッシュのノートと同じ時に、同じ環境で行いました。コードと出力は、そのノートの lab にあります。挙動は Ollama の版で変わり得るので、本記事の観察は全て 0.22.1 の時点のものです。また、実験のサーバーは他の作業と共有しており、設定は既定のまま変えていません。
num_ctx を指定しない時の長さ
num_ctx を指定しない時の既定値は、2026 年 11 月時点の Ollama のコンテキスト長のドキュメントによると、GPU のメモリの量で変わります。
| GPU のメモリ | 既定の num_ctx |
|---|---|
| 24 GiB 未満 | 4k(4,096) |
| 24 GiB 以上 48 GiB 未満 | 32k(32,768) |
| 48 GiB 以上 | 256k(262,144) |
ただし、既定値がモデルの上限(モデルが扱えるように作られた最大のコンテキスト長)より大きい時は、上限で頭打ちになります。
FAQ との食い違いと、0.22.1 のコード
同じ時点の FAQ(よくある質問のページ)には「既定は 4096 トークン」と書かれており、2 つのページは食い違っています。0.22.1 のコードでは、既定値は GPU のメモリの量で 4,096・32,768・262,144 から選ばれ(server/routes.go)、モデルの上限より大きければ上限まで下げられます(llm/server.go)。表の方がコードと合っています(コードの境目は、誤差を見込んで 47 GiB と 23 GiB)。
手元の GPU は CPU とメモリを共有するタイプ(AMD の Ryzen AI Max+ 395 に内蔵された Radeon 8060S)で、Ollama は 94.7 GiB を GPU のメモリと見なしていました。そのため既定値は 262,144 になり、上限が 40,960 の Qwen3-1.7B は 40,960 で読み込まれました。冒頭の図の下の棒が、この場合です。以下は、手元の 2 つのモデルで、この既定値がどう効いたかを描いた図です。
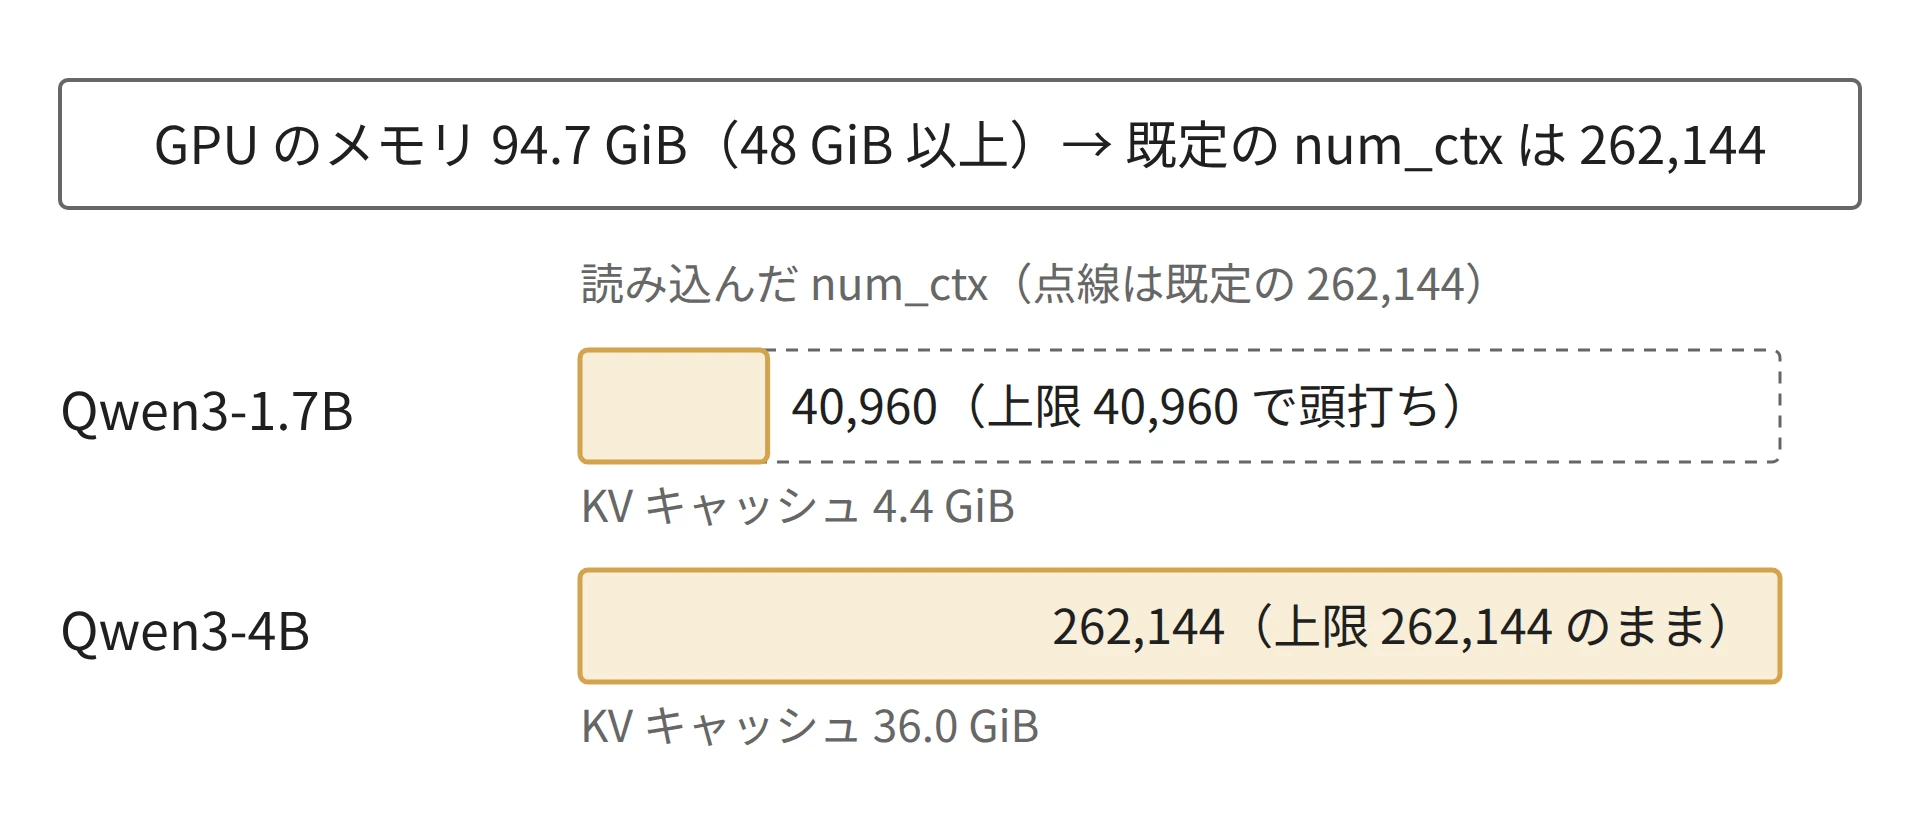
既定の num_ctx とモデルの上限(手元の 2 つのモデル)
図の GiB は 2 の 30 乗バイトで、Qwen3-1.7B の 4.4 GiB は、冒頭の図の 4.70 GB(10 の 9 乗バイト単位)と同じ量です。
上限が 262,144 のモデルでは、頭打ちになりません。手元で他の作業が読み込んでいた qwen3:4b(Qwen3-4B-Thinking-2507)は、262,144 で読み込まれ、size は 42.31 GB でした。
Qwen3-4B は 36 層・KV ヘッド 8・ヘッドの次元 128 なので、KV キャッシュのノートの式で 1 トークンあたり 2(K と V)× 36 × 8 × 128 × 2 バイト(f16)= 147,456 バイトになり、KV キャッシュだけで 262,144 × 147,456 バイト = 36 GiBになります。ファイルが 2.5 GB のモデルでも、num_ctx を指定しないと 40 GB を超えるメモリを使うことがあります。
読み込み時に確保されるメモリ
冒頭の図の size は、実行中のモデルを返す /api/ps(ollama ps と同じ情報)の値です。KV キャッシュの部分は、1 トークンあたりの大きさ(Qwen3-1.7B では 114,688 バイト)に num_ctx を掛けて計算しました。
KV キャッシュ以外の部分(重みと計算用の作業領域)は、num_ctx を 10 倍にしても 1.42 GB と 1.51 GB で、ほとんど変わりません。差の大部分は KV キャッシュの枠です。量子化のノートで見た「q4_K_M のファイルは 1.36 GB なのに、ollama ps は 6.2 GB」という差も、この枠の分です。
枠は、読み込んだ時点で num_ctx の分だけ全部確保されます。入力が短くても長くても size は変わりません(KV キャッシュのノートの実験 1)。
num_ctx を超えた入力
Ollama 0.22.1 では、num_ctx より長い入力を送ると、既定ではエラーを返さずに入力の一部を捨てます(以下、切り詰めと呼びます)。要求に "truncate": false を付けた時だけ、エラーが返ります(runner.go。API のドキュメントには載っていません)。
qwen3:1.7b-q8_0(8 ビットの型)で、先頭に合言葉を置いた約 3,100 トークンの入力を作り、最後に合言葉を尋ね、num_ctx 2,048(足りない)と 8,192(足りる)で比べました。
generate は Ollama の /api/generate を temperature 0(最も確率の高いトークンを選ぶ設定)で呼ぶ補助関数、filler は数えやすい詰め物の文章を作る関数で、どちらも kvlab.py にあります。
# lab/exp_truncate.py から抜粋(全体は下の折りたたみ)
PROMPT = ("The secret code is BLUE-FALCON-42. Remember it.\n" + filler(120, seed=7) +
          "\nWhat is the secret code given at the very beginning? Answer with the code only.")
for ctx in (2048, 8192):
    r = generate(MODEL, PROMPT, num_ctx=ctx, num_predict=32)
exp_truncate.py の全体
"""実験 4: 入力が num_ctx を超えた時に何が起きるか。

先頭に合言葉を置き、約 3,000 トークンの詰め物の後で合言葉を尋ねる(入力の全体は約 3,100 トークン)。
num_ctx 2048(足りない)と 8192(足りる)で比べる。
"""
import json
import subprocess
import sys

from kvlab import LOG_UNIT, filler, generate, ps, ps_line

MODEL = "qwen3:1.7b-q8_0"
PROMPT = ("The secret code is BLUE-FALCON-42. Remember it.\n" + filler(120, seed=7) +
          "\nWhat is the secret code given at the very beginning? Answer with the code only.")

rows = []
for ctx in (2048, 8192):
    print(f"## num_ctx={ctx}  ps before: {ps_line(ps())}", flush=True)
    # 送る直前のログの位置(cursor)を覚え、その後に出た行だけを見る
    cur = subprocess.run(["journalctl", "--user", "-u", LOG_UNIT, "-n", "0", "--show-cursor"],
                         capture_output=True, text=True).stdout.split("cursor: ")[-1].strip()
    try:
        r = generate(MODEL, PROMPT, num_ctx=ctx, num_predict=32)
        row = {"num_ctx": ctx, "prompt_eval_count": r["prompt_eval_count"],
               "done_reason": r.get("done_reason"), "thinking_chars": r["thinking_chars"],
               "response": r["response"]}
    except Exception as e:  # エラーで返る版もあるので、その時は本文を記録する
        body = e.read().decode() if hasattr(e, "read") else str(e)
        row = {"num_ctx": ctx, "error": body}
    # サーバーのログに切り詰めの警告が出たかを見る
    log = subprocess.run(["journalctl", "--user", "-u", LOG_UNIT, f"--after-cursor={cur}",
                          "--no-pager", "-o", "cat"], capture_output=True, text=True).stdout
    row["server_log"] = [ln.split("source=")[1] for ln in log.splitlines()
                         if "truncating input prompt" in ln]
    rows.append(row)
    print(json.dumps(row, ensure_ascii=False), flush=True)
    print(f"   ps after: {ps_line(ps())}", flush=True)

json.dump(rows, open(sys.argv[1] if len(sys.argv) > 1 else "truncate.json", "w"), indent=1,
          ensure_ascii=False)
以下が実行結果です(ps の行は省略。全体は output_truncate.txt)。
{"num_ctx": 2048, "prompt_eval_count": 2048, "done_reason": "stop", "thinking_chars": 0, "response": "1234567890", "server_log": ["runner.go:187 msg=\"truncating input prompt\" limit=2048 prompt=3084 keep=4 new=2048"]}
{"num_ctx": 8192, "prompt_eval_count": 3084, "done_reason": "stop", "thinking_chars": 0, "response": "BLUE-FALCON-42", "server_log": []}
num_ctx 2,048 では、応答は done_reason: stop の正常な終わり方で、答えは合言葉ではなく 1234567890 でした(thinking_chars は、Qwen3 が答える前に出力する考えの文字数です。実験では "think": false で切っているので 0 です)。
サーバーのログには truncating input prompt limit=2048 prompt=3084 keep=4 new=2048 という警告が出ています。
num_ctx 8,192 では、同じ入力で BLUE-FALCON-42 と答えました。以下は、ログの数から、どこが捨てられたかを描いた図です。
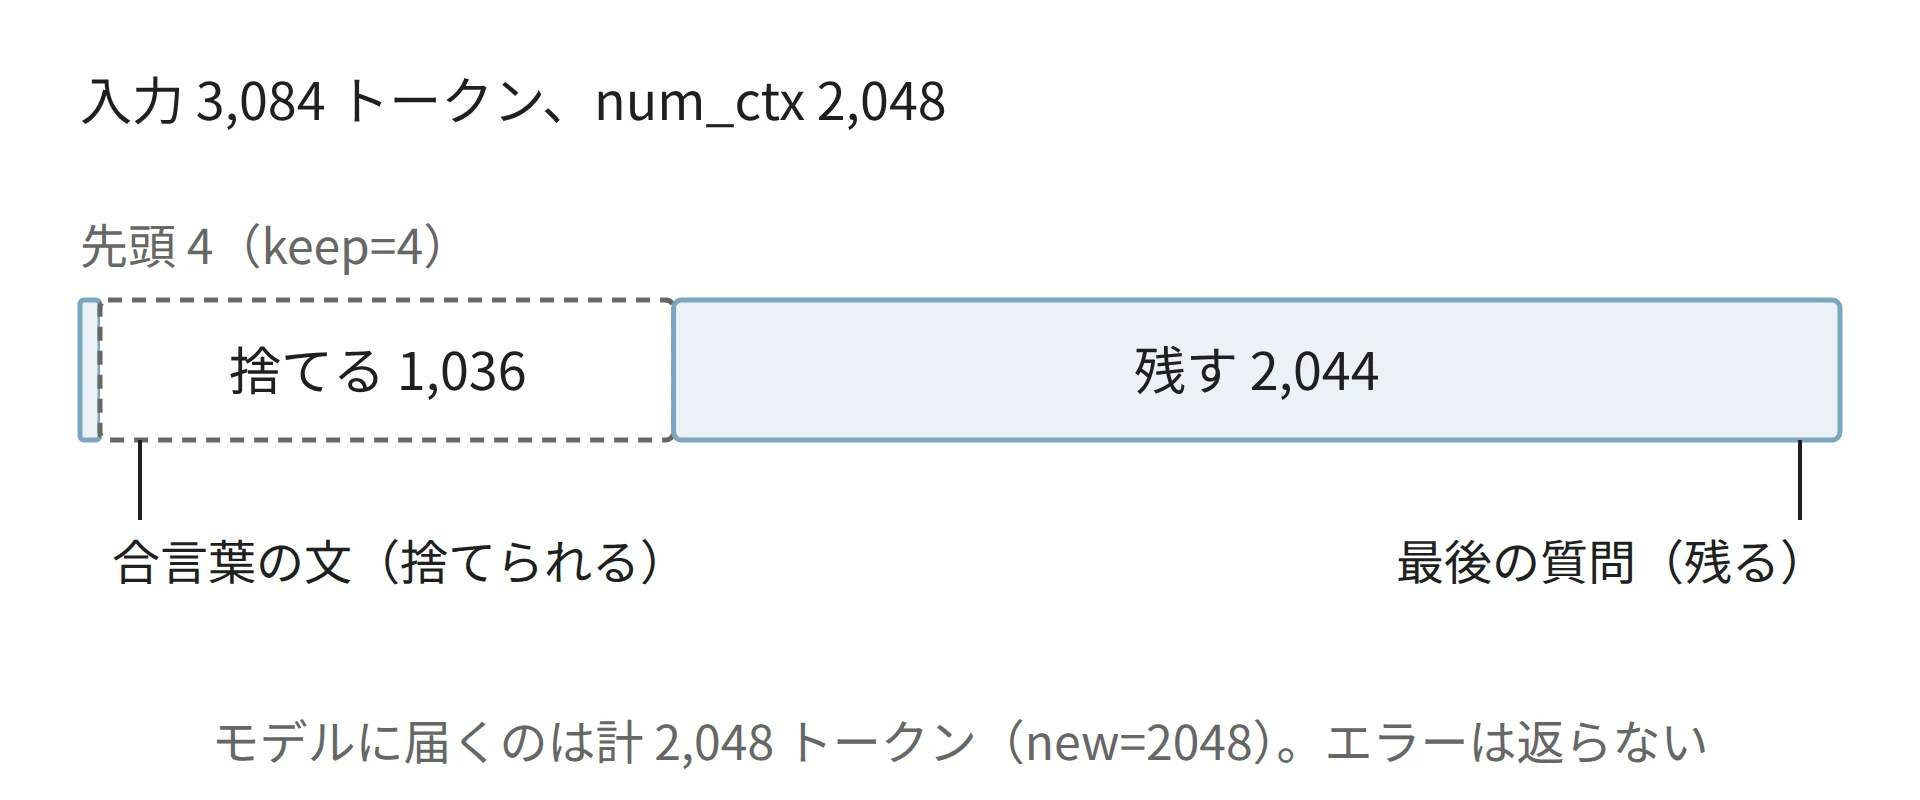
num_ctx 2,048 で 3,084 トークンの入力を切り詰めた範囲
入力 3,084 トークンのうち、先頭の 4 トークン(keep=4。中身は確かめていません)を残して、その後ろの 1,036 トークンが捨てられます(runner.go)。モデルに届いたトークン列は確かめていませんが、ログの数とこの切り詰め方から、先頭の文にある合言葉は捨てた範囲に入ったと考えられます。最後の質問は残っているので、モデルは合言葉を知らないまま答えています。
API の応答で気付ける手がかりは、prompt_eval_count(モデルに届いた入力のトークン数。切り詰めた後の数)が num_ctx と同じ 2,048 になっていることだけです。ただし、これは疑うきっかけで、確かな判定ではありません。入力がちょうど num_ctx の長さで切り詰められていない場合も、同じ値になります。
長い資料や長い会話を渡す時は、入力のトークン数と num_ctx を比べてから送る必要があります。切り詰めを確実に知りたい時は、要求に "truncate": false を付けてエラーで返させるか、サーバーのログの truncating input prompt を見ます。
KV キャッシュのメモリを減らす設定
KV キャッシュの大きさは、1 トークンあたりの大きさ × num_ctx です。Ollama の使う側で変えられるのは、次の 4 つです。
| 設定 | 何が変わるか | 代わりに失うもの |
|---|---|---|
要求ごとの num_ctx | 枠の数 | 超えた入力は切り詰められる |
サーバーの環境変数 OLLAMA_CONTEXT_LENGTH | num_ctx を指定しない要求の枠の数 | 同上 |
サーバーの環境変数 OLLAMA_KV_CACHE_TYPE | K・V の数値 1 個のバイト数。既定の f16(16 ビット)に対し、q8_0 で約半分、q4_0 で約 4 分の 1 | 精度が少し落ちる。全てのモデルに効く |
サーバーの環境変数 OLLAMA_NUM_PARALLEL | 同時に処理する要求の数。要求ごとに num_ctx 個の枠の組を用意するので、その数だけ確保する量が増える | 減らすと同時に処理できる要求が減る |
要求ごとの num_ctx は、/api/generate や /api/chat の options に書きます。
{"model": "qwen3:1.7b-q8_0", "prompt": "...", "options": {"num_ctx": 8192}}
FAQ によると、OLLAMA_KV_CACHE_TYPE の既定値は f16 で、Flash Attention(メモリの読み書きを減らす順序で注意機構を計算する手法)が有効な時だけ使えます。本記事の環境では、サーバーのログに Flash Attention を有効にしたと出ていました。KV キャッシュの型と並列数は既定(f16 と 1)のままで、変えた時の効果は試していません。
前置きの使い回しの確かめ方
前回と同じ前置き(プレフィックス)を送り直すと、Ollama はキャッシュに残った K・V を使い回し、一致した部分の計算を省きます(KV キャッシュのノートの実験 3)。使い回しが効いたかを見る時は、応答のどの値を見るかに注意が要ります。
0.22.1 の prompt_eval_count は、使い回した回でも入力の全トークン数(実験 3 では 8,325 など)を返しました。API のドキュメントでも、prompt_eval_count は入力のトークン数、prompt_eval_duration はキャッシュに無かった分を処理した時間とされています。0.22.1 の応答には、キャッシュから読んだトークン数のフィールドがありません(api/types.go)。
そのため、0.22.1 でキャッシュが効いたかを見る時は、prompt_eval_count ではなく prompt_eval_duration を見ます。実験 3 では、同じ前置きを送り直した回で 2.6 秒から 0.016 秒に縮みました。
2026 年 11 月時点の API のドキュメントには、キャッシュから読んだ数を返す prompt_eval_cached_count が載っており、このフィールドを返す版なら、その値で確かめられます。
並列数が 1 のサーバーでは、枠の組(要求 1 つ分のキャッシュ)も 1 組だけです。以下は、複数のアプリや会話が交互に使うサーバーで、要求 A の間に、先頭の前置き(同じシステムプロンプトなど)だけが共通する要求 B が挟まった時の模式図です(0.22.1 のコードから描きました)。
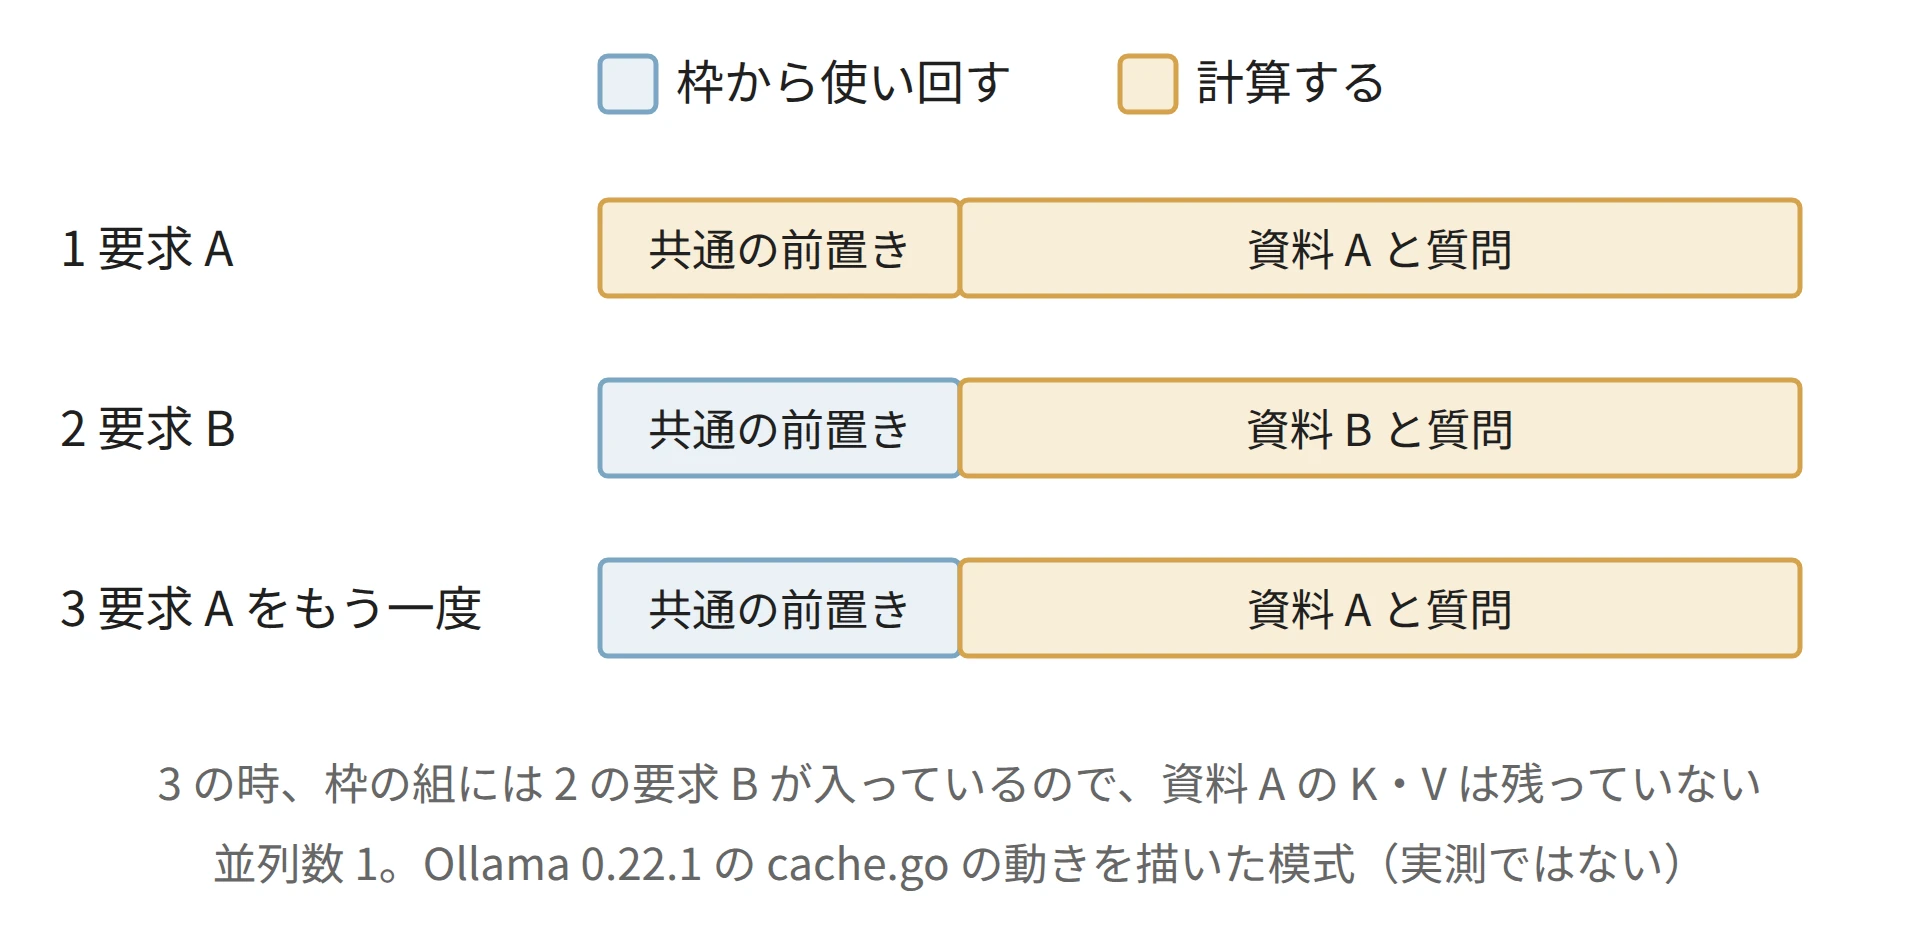
枠が 1 組の時に別の要求が挟まると、共通の前置きだけが残る(模式図)
別の要求が間に入ると、枠の組の中身はその要求のものに置き換わり、使い回せる部分は減ります。ただし、全てが消えるとは限りません。0.22.1 のコードは、枠の組に残ったトークン列と新しい入力を先頭から比べ、一致した数だけ使い回すからです(cache.go の LoadCacheSlot)。図の 3 で使い回せるのは要求 B と共通の前置きだけで、資料 A の部分は計算し直しになります(本記事では実測していません)。
num_ctx の決め方
num_ctx は、大きくするほど長い入力を扱える代わりに、メモリで払う設定です。速さについて実験で確かめたのは、num_ctx を固定したまま、実際に読ませた入力が長いほど遅くなることです(KV キャッシュのノートの実験 2)。num_ctx を大きくしただけで速さが変わるかは測っていません。決める時は、次の順で確かめます。
- 送る入力と出力の長さを足したトークン数を見積もり、num_ctx をそれより少し大きくする。指定しないと、GPU のメモリが多い環境ではモデルの上限まで確保される。
- 読み込んだ後に
/api/psのsizeとcontext_length(読み込んだ num_ctx)を見て、想定した num_ctx で読み込まれたかを確かめる。 - 応答の
prompt_eval_countが、読み込まれた num_ctx(/api/psのcontext_length)と同じになっていたら、切り詰めを疑う。確かめるには、"truncate": falseを付けて送り直すか、サーバーのログのtruncating input promptを見る。
本記事の数字は 1.7B と 4B のモデルと、1 台の GPU での値です。手元のモデルでは、/api/ps の size とサーバーのログの kv cache の行を見て確かめてください。