MoE(Mixture of Experts、専門家の混合)は、LLM(Large Language Model、大規模言語モデル)の層の一部を「専門家(expert)」と呼ぶ小さなネットワークの束に分け、トークン(文を区切った単位で、LLM はこの単位で読み書きします)ごとにその一部だけを動かす作りです。どの専門家を動かすかは、ルーター(router。原論文では gating network)と呼ぶ小さな層がトークンごとに決めます。そのため、MoE のモデルには、全ての専門家を足した総パラメーター(学習で決まる重みの数値)の数と、1 トークンを処理する時に実際に動くパラメーター数(active parameters)の 2 つの数があります。
例えば、Qwen3-Coder-30B-A3B-Instruct の名前の「30B」は総パラメーター数(305 億)で、「A3B」は 1 トークンで動く数(33 億)です。では、手元の PC で動かす時、305 億パラメーターのこのモデルは、82 億パラメーターの dense(全パラメーターを毎回動かす、MoE でない作り)の Qwen3-8B より遅く、メモリも多く使うのでしょうか。
以下は、2026 年 11 月に Ollama 0.22.1 で 2 つの MoE と 1 つの dense のモデルを動かし、重みのバイト数と生成の速さを並べたグラフです。重みは 4 bit 前後に量子化されているので、1 パラメーターは約 0.5〜0.6 バイトです。図の「MoE 4/32」は、32 個の専門家から 4 個を選ぶという意味です。生成では 1 トークンごとに、動く部分の重みをメモリから読み直します。
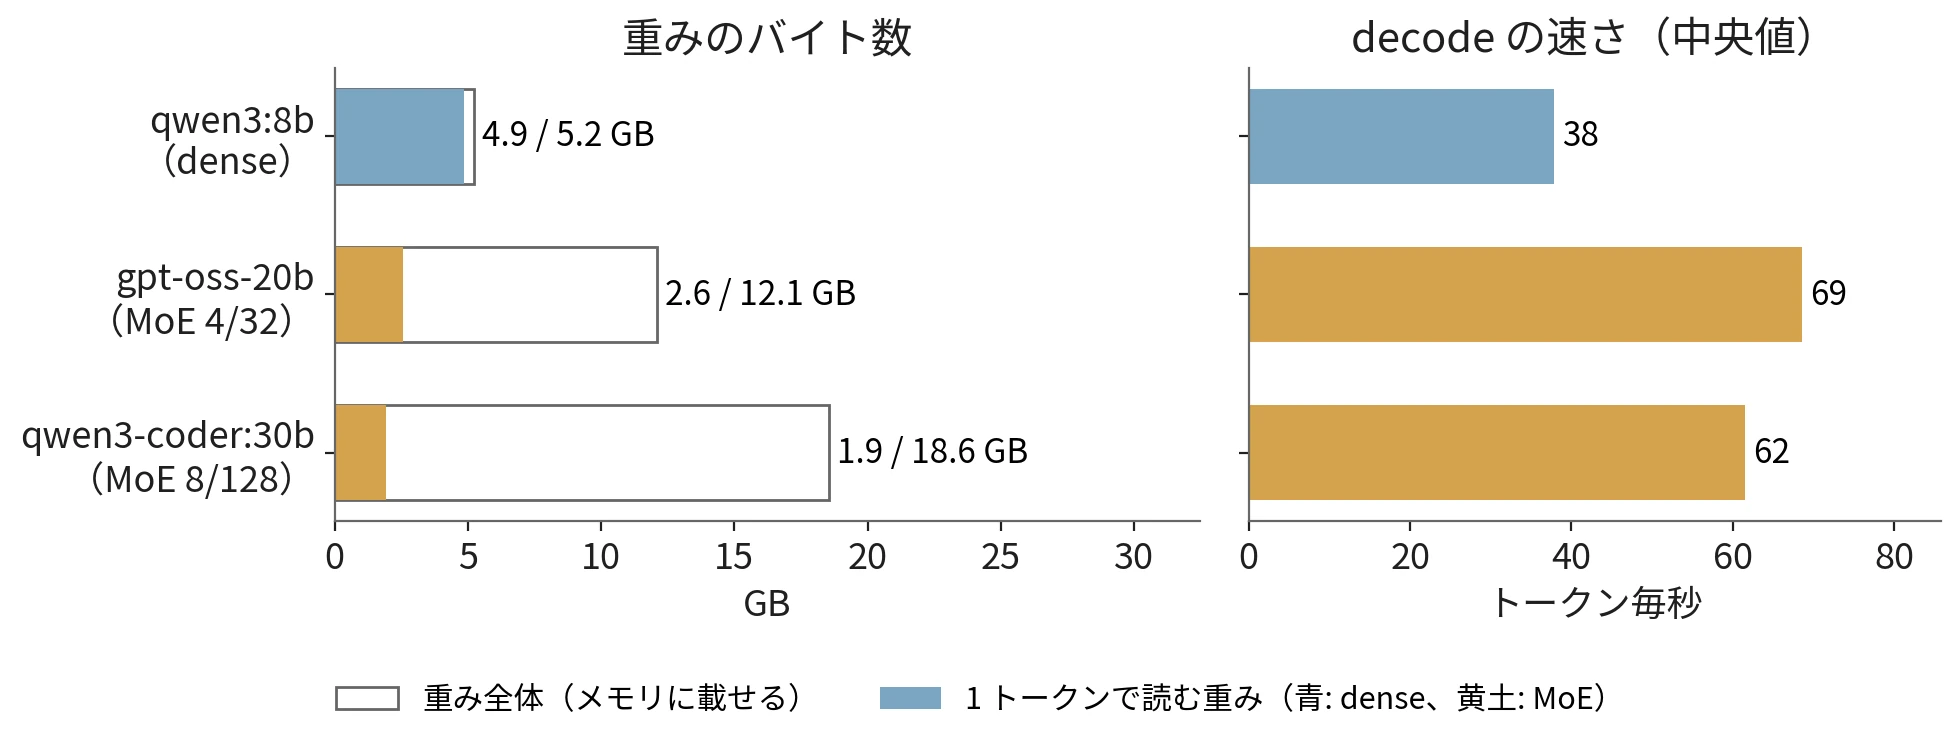
重み全体と 1 トークンで読む重み、生成の速さ(入力 約 500 トークン、3 回の中央値)
答えは、速さとメモリで逆になりました。qwen3-coder:30b は qwen3:8b の 1.6 倍の速さで生成(図の decode)しましたが、メモリに載せる重み全体は 3 倍以上です。生成の速さを左右するのは 1 トークンで動くパラメーターで、メモリの量を左右するのは総パラメーターです。
本記事では、MoE が何を分けているのか、Ollama で動かした 3 つのモデルの実測で説明します。扱う疑問は次の通りです。
- ルーターは、どうやって専門家を選ぶのか。
- 総パラメーター数と active パラメーター数は、モデルカードのどこに書かれ、どう数えられるのか。
- 生成の速さは、active パラメーターのバイト数でどこまで説明できるのか。
- メモリの使用量は、どちらの数で決まるのか。
- MoE を選ぶと、何を得て何を払うのか。
MoE の学習の安定化(専門家の負荷を揃える補助の損失など)や、複数の GPU に専門家を分けて置く分散の仕組みは説明しません。
前提: 層の中の FFN
LLM は、同じ形の層を数十段重ねたネットワークです。1 つの層は、他のトークンを参照する注意機構(attention。KV キャッシュのノートを参照)と、トークンごとに独立に計算する FFN(Feed-Forward Network、全結合の層を 2〜3 枚重ねた多層パーセプトロン)の 2 つの部分からなります。
パラメーターの大半は FFN にあります。例えば、gpt-oss のモデルカードの表では、gpt-oss-20b の総パラメーター 209.1 億のうち、FFN(表では MLP)が 191.2 億、注意機構は 6.4 億です。MoE が専門家に分けるのは、この FFN です。注意機構は、MoE のモデルでも全てのトークンで毎回動きます。
ルーターが専門家を選ぶ
MoE の層では、1 つの大きな FFN の代わりに、小さな FFN(専門家)を数十〜百数十個並べます。ルーターは、トークンのベクトルに重み行列を 1 回掛けて専門家ごとの点数を出し、点数の高い上位 k 個の専門家だけにトークンを渡します。選ばれた専門家の出力は、点数を Softmax で配分の割合に直し、その割合を掛けて足し合わせ、その層の出力にします。選ばれなかった専門家は、そのトークンでは計算もせず、重みも読みません。
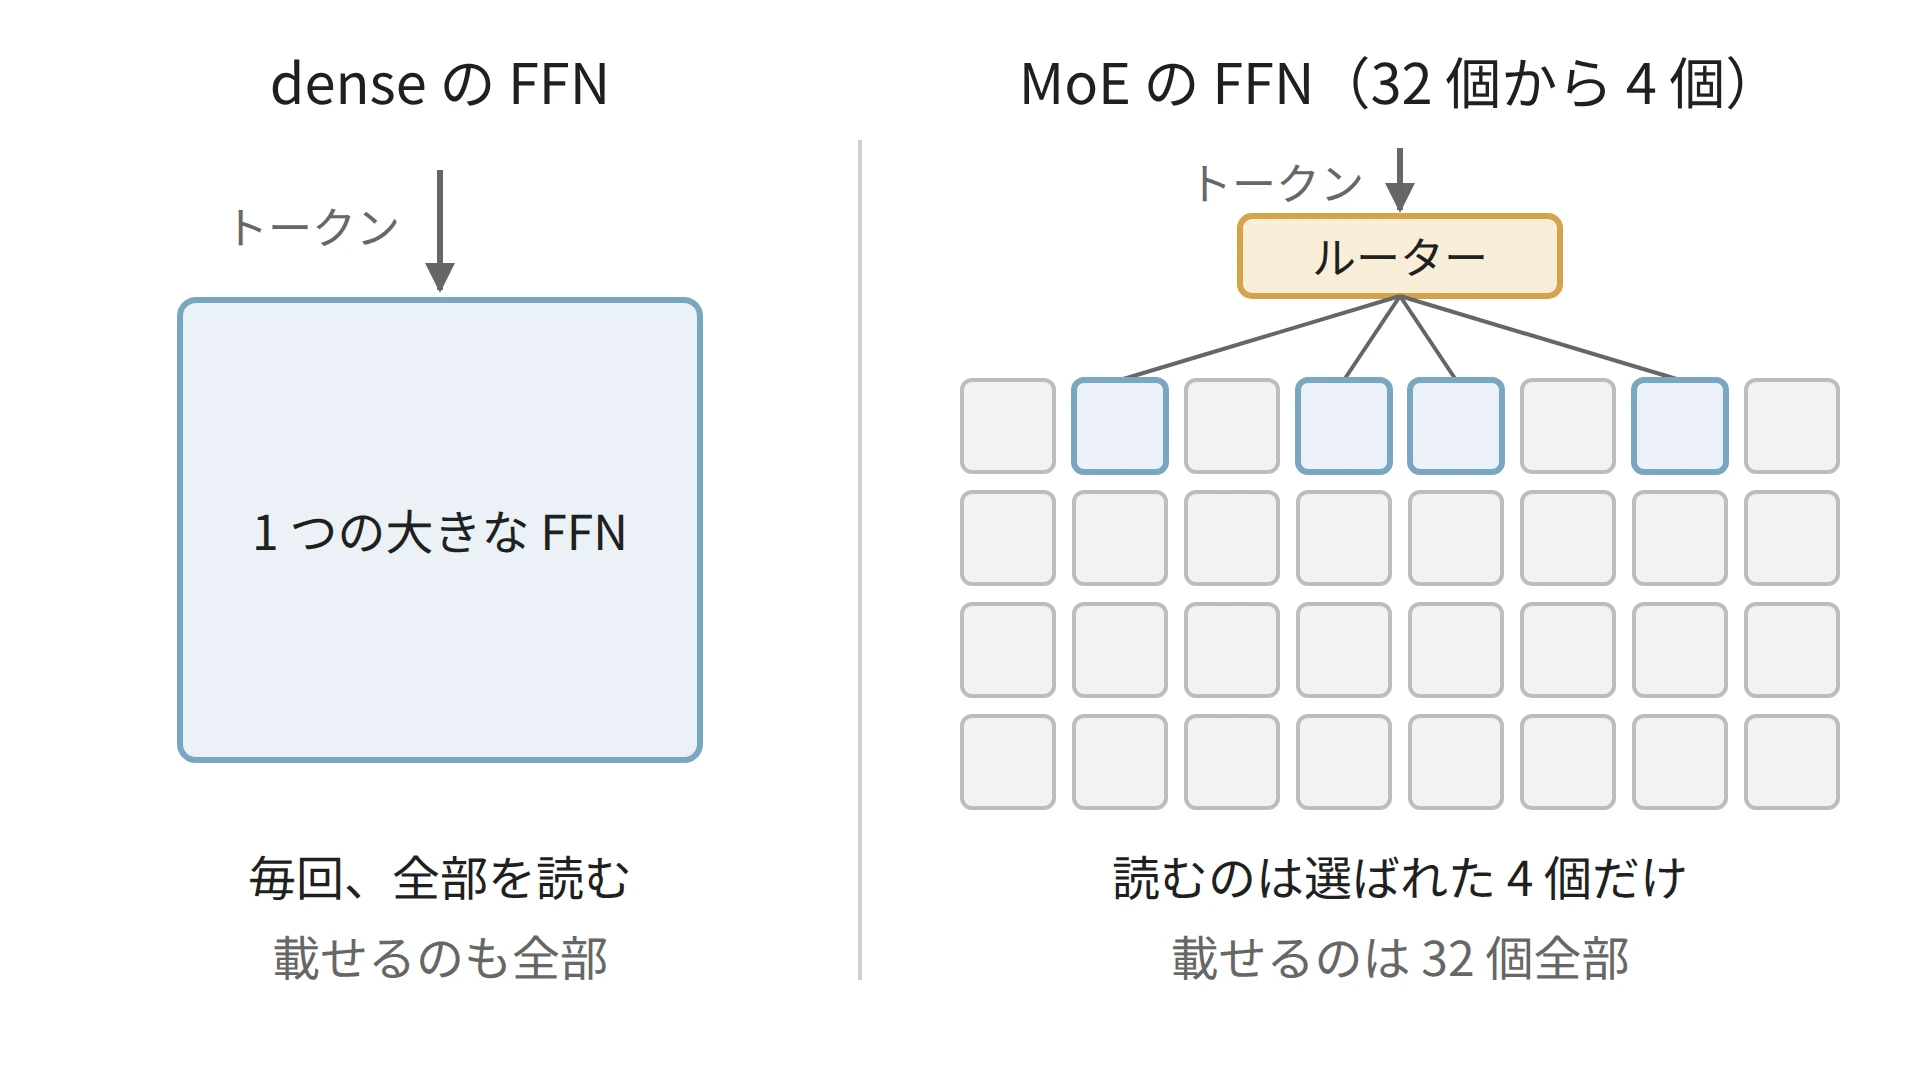
dense の FFN と、32 個から 4 個を選ぶ MoE の FFN(gpt-oss-20b の数)
この仕組みは、Shazeer らの 2017 年の論文(Outrageously Large Neural Networks)が、LSTM の層の間に最大で数千個の専門家を置く形で示しました。論文は、学習するゲート(ルーター)が例ごとに専門家の疎な組み合わせを選ぶことで、計算の効率をわずかに落とすだけでモデルの容量を 1000 倍以上にできたと報告しています。
その後、GShard が Transformer の FFN の位置に専門家を置き、1 トークンに 2 個を選ぶ形で翻訳のモデルを大きくしました。Switch Transformer は、これを 1 トークンに 1 個だけを選ぶ(top-1)形に単純化しました。Mixtral 8x7B は 8 個から 2 個を選びます。
専門家という名前から、「数学の専門家」「コードの専門家」のように話題ごとに分かれていると思うかもしれません。しかし、Mixtral の論文は、専門家の割り当てに話題による明らかな傾向は見られなかったと報告しています。どの専門家が何を受け持つかは学習で決まり、人が役割を割り振るわけではありません。ルーターも専門家と一緒に誤差逆伝播法で学習される層の 1 つです。
選ぶのは層ごと、トークンごとです。同じ文の中でもトークンが変われば選ばれる専門家は変わり、同じトークンでも層が変われば別の組み合わせになります。そのため、生成を続けるうちに、どの専門家もいつかは使われます。全ての専門家の重みは、使われる時に備えてメモリに載せておく必要があります。
総パラメーターと active パラメーター
以下は、本記事で動かした 3 つのモデルの数を公式のモデルカードから写した表です。gpt-oss-20b は OpenAI のモデルカード(論文)の表 1 と Hugging Face の config.json、Qwen の 2 つは Hugging Face のモデルカード(Qwen3-8B、Qwen3-Coder-30B-A3B-Instruct)の値です。
| モデル | 総パラメーター | 1 トークンで動く | 層 | 専門家の数 | 1 トークンで選ぶ数 |
|---|---|---|---|---|---|
| Qwen3-8B(dense) | 8.2B | 8.2B(全部) | 36 | なし | なし |
| gpt-oss-20b(MoE) | 20.9B | 3.6B | 24 | 32 | 4 |
| Qwen3-Coder-30B-A3B(MoE) | 30.5B | 3.3B | 48 | 128 | 8 |
1 トークンで動く数は、毎回動く部分(注意機構・ルーター・出力層など)に、専門家の重みのうち選ぶ割合の分を足したものです。例えば、Qwen3-Coder は専門家 128 個から 8 個を選ぶので、専門家の重みは 16 分の 1 だけが動きます。
この数え方は、Ollama が保存しているモデルのファイル(GGUF 形式)でも確かめました。ローカル LLM の速さのノートの lab/gguf_bytes.py は、ファイルのヘッダーからテンソル(重みの配列)ごとの形と型を読み、名前に _exps を含む専門家の重みだけは選ぶ割合で数えます。入力の埋め込み(トークンの番号で 1 行を引く表)は 1 行分だけを数えます。
$ python3 gguf_bytes.py qwen3-8b=... qwen3-coder-30b=... gpt-oss-20b=...(抜粋)
[qwen3-coder-30b] arch=qwen3moe  layers=48 experts=8/128
  experts  params  28,991,029,248  bytes  17,553,162,240
  total    params  30,532,122,624  bytes  18,550,716,416
  active params per token ~ 3,041,869,824
  bytes read per decoded token (weights only) ~ 1,919,597,696
[gpt-oss-20b] arch=gpt-oss  layers=24 experts=4/32
  total    params  20,914,757,184  bytes  12,096,558,336
  active params per token ~ 3,608,310,144
  bytes read per decoded token (weights only) ~ 2,574,705,396
gpt-oss-20b は、総パラメーター 209.1 億、1 トークンで動く 36.1 億で、モデルカードの表 1 の 20.91B・3.61B と一致しました。Qwen3-Coder は 30.4 億で、モデルカードの 3.3B より少し少なく出ます。このスクリプトは埋め込みの表を 1 行分しか数えないので、表の全体(約 3 億)を数えるかどうかの違いだと考えられます。全体の出力は lab/output_gguf.txt にあります。
生成の速さは読むバイト数で決まる
LLM が 1 トークンずつ生成する段(decode)は、1 トークンごとに重みをメモリから読み直すので、速さはメモリから読み出す速さ(メモリ帯域)に縛られます。仕組みと見積もりの式はローカル LLM の速さのノートで説明しています。MoE のモデルでは、選ばれなかった専門家の重みを読まないので、読む量は総パラメーターではなく、1 トークンで動くパラメーターのバイト数になります。
測り方は、そのノートの実験と同じです。2026 年 11 月 11 日に、AMD Ryzen AI Max+ 395(内蔵 GPU は Radeon 8060S、RAM 128GB のうち 64GB を GPU に割り当て)の Ollama 0.22.1 へ、約 500 トークンの入力を送って 128 トークンを生成させ、応答の eval_count と eval_duration から速さを出しました。条件ごとに 3 回の中央値です。gpt-oss-20b の取得元と注意点は、速さのノートの実験の条件にあります。
| モデル | 1 トークンで読む重み | 256 GB/s での上限 | 実測 | 上限との比 |
|---|---|---|---|---|
| qwen3:8b(dense) | 4.87 GB | 53 トークン毎秒 | 37.8 トークン毎秒 | 72% |
| gpt-oss-20b(MoE) | 2.57 GB | 99 トークン毎秒 | 68.7 トークン毎秒 | 69% |
| qwen3-coder:30b(MoE) | 1.92 GB | 133 トークン毎秒 | 61.5 トークン毎秒 | 46% |
上限は、機材(GMKtec の NucBox EVO-X2)の公式ブログにある LPDDR5X-8000 と 256 ビットのメモリの幅から計算したメモリ帯域 256 GB/s ÷ 読む重みのバイト数の値です(KV キャッシュの分は除いています)。
順位は、総パラメーター数とは逆になりました。総パラメーターが最も多い qwen3-coder:30b は、qwen3:8b の 1.6 倍、gpt-oss-20b は 1.8 倍の速さです。読む量で並べると、qwen3:8b の 4.87 GB に対して、2 つの MoE は 2 GB 前後で、速さの順と合います。
ただし、比例はしていません。qwen3-coder:30b は gpt-oss-20b より読む量が少ないのに、生成は遅く、上限の 46% にとどまりました。qwen3-coder:30b は 48 層のそれぞれで 128 個から 8 個を選び、小さな行列の掛け算を何度も行います。gpt-oss-20b は 24 層で、32 個から 4 個です。層と専門家ごとの処理の切り替えが多いほど、読む量以外の時間が増えると考えられます(推測です。GPU の内部の時間の内訳は測っていません)。active パラメーターのバイト数で分かるのは速さの上限で、実際の速さはその 5 割弱〜7 割強でした。
メモリは総パラメーターで決まる
次に、3 つのモデルを読み込んだ時のメモリの量を、実行中のモデルを返す /api/ps の size(ollama ps の SIZE の列)で比べました。KV キャッシュ(読んだトークンの計算結果の保存場所)の分を小さくするため、コンテキスト長(num_ctx、一度に扱えるトークン数)は 4,096 で読み込んでいます(lab/mem.py)。
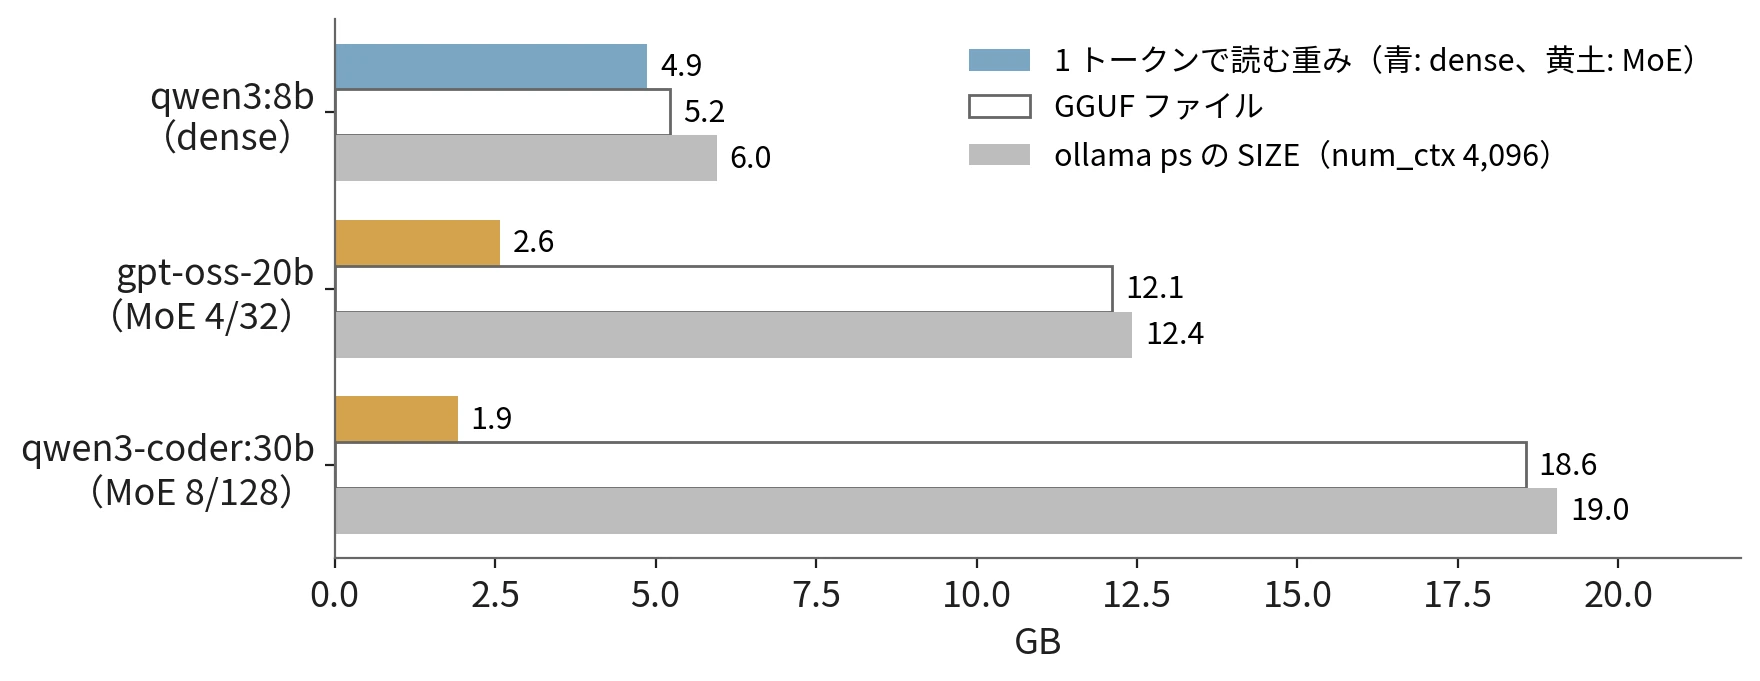
1 トークンで読む重み、モデルのファイル、読み込んだ時のメモリ(num_ctx 4,096)
読み込んだ時のメモリは、どのモデルもファイルの大きさに 1 GB 未満を足した程度で、1 トークンで読む重みとは関係しませんでした。qwen3-coder:30b は 19.0 GB で、1 トークンで読む 1.9 GB の 10 倍です。前の節の通り、どの専門家が選ばれるかはトークンと層ごとに変わるので、全ての専門家を載せておく必要があります。
「MoE は動く部分が少ないので、メモリも小さくて済む」とはなりません。コンテキスト長を 36,864 にすると、KV キャッシュが加わって qwen3:8b が 10.8 GB、qwen3-coder:30b が 22.3 GB、gpt-oss-20b が 13.3 GB になりました(lab/mem.json)。
この機材は、128GB の RAM のうち 64GB を GPU に割り当てられるので、19 GB の qwen3-coder:30b も GPU に収まりました。GPU のメモリが 16GB や 24GB の機材では、総パラメーターの分が収まらず、一部を CPU 側に置くことになります。CPU 側に置いた重みは CPU とそのメモリで計算するので、1 トークンで読む量が少ない MoE でも生成は遅くなります。
著者は weeknotesで、この機材で Qwen3-Coder 30B と gpt-oss 20B を使い、さらに大きな 35B のモデルも試しました。速さだけを見れば、MoE はこの規模のモデルを手元で動かす現実的な選択肢です。メモリの容量が、どこまで大きなモデルを選べるかの上限になります。
利点
- 1 トークンで動く重みが少ないので、同じ総パラメーターの dense のモデルより速く生成できる
- 総パラメーターを増やしても、1 トークンの計算量は選ぶ専門家の数でほぼ決まる
- メモリ帯域が狭く、容量が大きい機材(CPU と GPU がメモリを共有する機材など)で効果が大きい
欠点
MoE は、全ての専門家を持っておき、トークンごとに一部だけを使います。その代わりに、次の制約があります。
- メモリは総パラメーターの分だけ要る。動く部分が少なくても、載せる量は減らない
- 速さは、active パラメーターのバイト数から計算した上限に届きにくい。本記事の 2 つの MoE では 46〜69% だった
- MoE にしても、入力を読む段(prefill)の注意機構の計算は減らない。層の多い qwen3-coder:30b は 3.6 万トークンで qwen3:8b より prefill が遅かった一方、半分の層が sliding window(直近のトークンだけを見る注意機構)の gpt-oss-20b は、どの長さでも最も速かった(ローカル LLM の速さのノート)
- ルーターの学習が偏ると一部の専門家ばかり使われるため、学習の工夫が要る(本記事では扱わない)
適さないケース
- GPU のメモリが総パラメーターの分に足りず、専門家の一部が CPU 側に置かれる機材
- 注意機構の重い MoE で、長い入力を読む時間が待ち時間の大半を占める使い方
- 同じメモリで、より多くの総パラメーターより、より長いコンテキストを持たせたい場合
本記事の数値は、2026 年 11 月時点、Ollama 0.22.1、この機材での値です。モデルや実行環境の版が違えば、上限に対する比も違ってきます。