LoRA(Low-Rank Adaptation)は、学習済みモデルの重み行列 W を書き換えずに、W に足す差分だけを 2 つの細長い行列 B と A の積として学習する手法です。Hu 氏らの論文(2021 年)は大規模言語モデルの追加学習を対象にしていましたが、現在は画像生成モデルに画風やキャラクターを足すファイルの形式としても広く使われています。
例えば、手元の画像生成のベースモデルは 6.9 GB ありますが、本記事の説明用に用意した独自の画風 LoRA(example_style_lora.safetensors)は 170 MB です。プロンプトでは、この LoRA を効かせるための語(起動語)を <trigger> と書きます。この 170 MB をベースモデルに重ねて読み込むと、同じプロンプトでも絵柄が変わります。
以下は、1 つの重み行列について、凍結した W と、学習する B・A の大きさを面積で比べた図です。
凍結した W と、学習する細長い B・A の大きさ
B と A を掛けると W と同じ形の差分 ΔW ができますが、保存するのは細い 2 本だけです。差分の大きさは、強さ(weight)と呼ばれる係数で読み込む時に変えられます。
本記事では、拡散モデルの細部を知らないエンジニアに向けて、LoRA の仕組みを説明します。手元の LoRA ファイルの中身を数える実験と、強さだけを変えて画像を生成する実験を通して、次の疑問に答えます。
- 重みを直接追加学習すると、何が困るのか。
- なぜ細長い 2 つの行列で、画風のような変化を足せるのか。
- LoRA ファイルには何が入っていて、ベースモデルの何割の大きさなのか。
- 強さを 0 から 1.0 に変えると、画像に何が起きるのか。
- LoRA が向かない場面はどこか。
LoRA の学習の手順(学習画像の準備や学習率の調整)は説明しません。
前提: 画像生成モデルと重み
Stable Diffusion XL(SDXL)系の画像生成モデルは、ノイズだけの画像から少しずつノイズを取り除いて絵を作る拡散モデルです。各ステップで「どこがノイズか」を予測するのが UNet と呼ばれるネットワークで、プロンプトの文字列を UNet が使える数値に変換するのが text encoder です。
どちらも内部は多数の線形層でできています。線形層は、入力のベクトル x に重み行列 W を掛けて y = Wx を返す層です(行列の積は「ベクトルと行列の演算」を参照)。モデルが描ける対象や絵柄は、この W の値の組み合わせとして保存されています。モデルのファイルは、W などの数値の配列(テンソル)をまとめたもので、実験 1 のベースモデルには 2,515 個のテンソルが入っています。
学習とは、出力と正解のずれが小さくなる方向に W の値を少しずつ動かす処理です(勾配降下法)。つまり、画風を足すとは「画風が出る方向にベースモデルの W を動かすこと」です。
重みを直接追加学習する時の問題
追加の画像で学習済みモデルの全ての W を学習し直す方法をフルファインチューニング(full fine-tuning)と呼びます。素直な方法ですが、画風を 1 つ足すたびに次の問題が出ます。
- 出来上がるのはベースモデルと同じ大きさのファイルです。画風を 10 種類作ると、6.9 GB のファイルが 10 個できます。
- 学習中は、全てのパラメータについて勾配と最適化アルゴリズムの状態を保持します。広く使われる Adam は、パラメータ 1 個につき 2 個の値を持ちます。そのため、学習するパラメータが多いほど GPU のメモリが必要になります。
- 学習後の
Wには、ベースモデルの値と画風の変化が混ざっています。画風だけを取り出したり、弱めたり、他の画風と組み合わせたりできません。
必要なのは、ベースモデルの W は変えずに、変化の分だけを小さく持ち運ぶ方法です。差分の行列の形を制限して、これを実現したのが LoRA です。
低ランクの差分
LoRA は、学習後の重みを次の式で表します。W は凍結して学習せず、B と A だけを学習します。
W' = W + (α / r) · B A

W : d × k(ベースモデルの重み。変えない)
B : d × r(学習する)
A : r × k(学習する)
r : ランク。d や k よりずっと小さい値(例: 32)
α : 差分の大きさを調整する定数(alpha)
B は縦に長く、A は横に長い行列です。積 BA は d × k になり、W と同じ形の差分になります。冒頭の図の層(d = k = 1280、r = 32)では、W の 1,638,400 個に対して、B と A は合わせて 32 × (1280 + 1280) = 81,920 個です。保存する量は d × k から r × (d + k) に減ります。
ランクの意味
行列のランクは、その行列が出力できる方向の数です。A は入力の k 次元のベクトルを r 次元に縮め、B はそれを d 次元に戻します。途中で r 次元を通るので、BA が作れる変化は r 種類の方向の組み合わせに限られます。
この制限で困らない理由について、論文は「追加学習で起きる重みの変化は、もともと低いランク(intrinsic rank)で表せる」という仮説を置いています。GPT-3(OpenAI の 1,750 億パラメータの言語モデル)で、注意機構のクエリと値の重み行列(Wq と Wv)の両方に LoRA を入れた実験では、r を 1 にしても r = 64 とほぼ同じ精度が出たと報告しています。Wq だけに入れた場合は、r を大きくする必要がありました。
画風の追加でも同じ仮説が成り立つかは、論文の範囲外です。後の実験は、画風の変化が 32 の方向で十分に表せることの証明ではなく、表せた結果の 1 例として読んでください。
学習の始まりと α
論文では、A を乱数、B を 0 で初期化します。BA は 0 から始まるので、学習の開始時はベースモデルと同じ出力になります。画像生成の LoRA の学習によく使われる sd-scripts も、networks/lora.py で lora_up(B)を 0 で初期化しています。
α / r は、r を変えても学習率などを調整し直さずに済むようにする係数です。sd-scripts では alpha を学習時に指定し、alpha / dim(dim は r)を掛けます。
強さを掛けて足す
画像を生成する時は、LoRA ファイルの B と A から差分を計算し、強さを掛けてベースモデルの W に足します。ComfyUI(ノードをつないで画像生成の処理を組む OSS)では、comfy/weight_adapter/lora.py の次の 1 行が、この加算をしています。
weight += function(((strength * alpha) * lora_diff).type(weight.dtype))
lora_diff は B と A の積、alpha はファイルの alpha を r で割った値、strength が画面で指定する強さです。強さ 0 なら W のまま、1.0 なら学習した差分がそのまま足されます。足し終えた後の W' は普通の重み行列なので、1 ステップあたりの計算量はベースモデルと変わりません。論文が「推論の遅延が増えない」と述べているのは、この足し込みができるからです。
実験 1: LoRA ファイルの中身を数える
LoRA とベースモデルは、どちらも safetensors 形式で配布されています。safetensors は、先頭 8 バイトにヘッダーの長さ(リトルエンディアンの符号なし 64 ビット整数)を置き、続けて JSON のヘッダー、その後にテンソルの中身を並べた形式です。ヘッダーには、テンソルごとの名前・型(dtype)・形(shape)・データの位置が入っています。__metadata__ という特別なキーには、文字列の組を自由に入れられます。
そのため、ヘッダーだけを読めば、6.9 GB のファイルでも中身を読まずにパラメータ数を数えられます。スクリプト(lab/count_params.py)は、Python の標準ライブラリだけで、LoRA の対象の層・ランク・パラメータ数と、ベースモデルの部品ごとのパラメータ数を出します。
以下は、ヘッダーを読む関数と、LoRA の層・ランク・パラメータ数を数える部分の抜粋です。ベースモデルを数える部分を含む全体は、抜粋の下に折りたたんでいます。sd-scripts の形式では、B が lora_up.weight、A が lora_down.weight という名前で保存されています。
# lab/count_params.py から抜粋(全体は下の折りたたみ)
def read_header(path):
    """先頭 8 バイト(リトルエンディアンの u64)がヘッダー長、続く JSON がヘッダー。"""
    with open(path, "rb") as f:
        (length,) = struct.unpack("<Q", f.read(8))
        header = json.loads(f.read(length))
    metadata = header.pop("__metadata__", {})
    return length, header, metadata

# LoRA のヘッダー(lora)から、対象の層・ランク・パラメータ数を数える
downs = {k[: -len(".lora_down.weight")]: v for k, v in lora.items()
         if k.endswith(".lora_down.weight")}
ranks = Counter(v["shape"][0] for v in downs.values())
targets = Counter(name.split("_")[1] for name in downs)  # lora_unet_... / lora_te1_...
print(f"  target layers   : {len(downs)} {dict(targets)}")
print(f"  ranks           : {dict(ranks)}")

# alpha は層ごとのスカラー(学習しない係数)なので数えない
lora_params = sum(numel(v["shape"]) for k, v in lora.items() if k.endswith(".weight"))
# 差分を足す先の W の大きさ: up が [out, r]、down が [r, in] なので W は [out, in]
full_params = 0
for name, down in downs.items():
    up = lora[name + ".lora_up.weight"]
    full_params += up["shape"][0] * numel(down["shape"][1:])
count_params.py の全体(103 行)
"""safetensors のヘッダーだけを読み、LoRA とベースモデルのパラメータ数を数える。

テンソルの中身は読まない。Python 標準ライブラリだけで動く。

使い方:
    python3 count_params.py <LoRA の .safetensors> <ベースモデルの .safetensors> [結果の JSON]
"""
import json
import math
import os
import struct
import sys
from collections import Counter


def read_header(path):
    """先頭 8 バイト(リトルエンディアンの u64)がヘッダー長、続く JSON がヘッダー。"""
    with open(path, "rb") as f:
        (length,) = struct.unpack("<Q", f.read(8))
        header = json.loads(f.read(length))
    metadata = header.pop("__metadata__", {})
    return length, header, metadata


def numel(shape):
    return math.prod(shape)  # 0 次元(スカラー)の shape [] は 1 になる


def main():
    lora_path, base_path = sys.argv[1], sys.argv[2]
    out_path = sys.argv[3] if len(sys.argv) > 3 else None

    # --- LoRA ---
    hlen, lora, meta = read_header(lora_path)
    print(f"[LoRA] {os.path.basename(lora_path)}")
    print(f"  file size       : {os.path.getsize(lora_path):,} bytes (header {hlen:,} bytes)")
    print(f"  tensors         : {len(lora):,}")
    print(f"  dtype           : {dict(Counter(t['dtype'] for t in lora.values()))}")
    print(f"  network_dim (r) : {meta.get('ss_network_dim')}")
    print(f"  network_alpha   : {meta.get('ss_network_alpha')}")
    print(f"  trained on      : {meta.get('ss_sd_model_name')}")
    print(f"  base SHA-256    : {meta.get('ss_new_sd_model_hash')}")

    downs = {k[: -len(".lora_down.weight")]: v for k, v in lora.items()
             if k.endswith(".lora_down.weight")}
    ranks = Counter(v["shape"][0] for v in downs.values())
    targets = Counter(name.split("_")[1] for name in downs)  # lora_unet_... / lora_te1_...
    print(f"  target layers   : {len(downs)} {dict(targets)}")
    print(f"  ranks           : {dict(ranks)}")

    # alpha は層ごとのスカラー(学習しない係数)なので数えない
    lora_params = sum(numel(v["shape"]) for k, v in lora.items() if k.endswith(".weight"))
    # 差分を足す先の W の大きさ: up が [out, r]、down が [r, in] なので W は [out, in]
    full_params = 0
    for name, down in downs.items():
        up = lora[name + ".lora_up.weight"]
        full_params += up["shape"][0] * numel(down["shape"][1:])
    print(f"  LoRA params     : {lora_params:,}")
    print(f"  W of targets    : {full_params:,} (same layers, full matrices)")

    # --- ベースモデル ---
    hlen, base, _ = read_header(base_path)
    groups = Counter()
    for k, v in base.items():
        if k.startswith("model.diffusion_model."):
            g = "UNet"
        elif k.startswith("conditioner.embedders.0."):
            g = "Text encoder 1 (CLIP ViT-L)"
        elif k.startswith("conditioner.embedders.1."):
            g = "Text encoder 2 (OpenCLIP ViT-bigG)"
        elif k.startswith("first_stage_model."):
            g = "VAE"
        else:
            g = "other"
        groups[g] += numel(v["shape"])
    total = sum(groups.values())
    print(f"\n[Base] {os.path.basename(base_path)}")
    print(f"  file size       : {os.path.getsize(base_path):,} bytes (header {hlen:,} bytes)")
    print(f"  tensors         : {len(base):,}")
    for g, n in sorted(groups.items(), key=lambda x: -x[1]):
        print(f"  {g:<34}: {n:>13,}")
    print(f"  {'total':<34}: {total:>13,}")

    unet = groups["UNet"]
    te = groups["Text encoder 1 (CLIP ViT-L)"] + groups["Text encoder 2 (OpenCLIP ViT-bigG)"]
    print("\n[Ratio]")
    print(f"  LoRA / UNet          : {lora_params / unet:.3%}")
    print(f"  LoRA / text encoders : {lora_params / te:.3%}")
    print(f"  LoRA / whole model   : {lora_params / total:.3%}")
    print(f"  LoRA / W of targets  : {lora_params / full_params:.3%}")

    if out_path:
        with open(out_path, "w") as f:
            json.dump({
                "rank": sorted(ranks), "alpha": meta.get("ss_network_alpha"),
                "target_layers": len(downs), "lora_params": lora_params,
                "target_full_params": full_params, "base_groups": groups,
                "base_total": total,
            }, f, indent=2, ensure_ascii=False)


if __name__ == "__main__":
    main()
ベースモデルは、LoRA の学習にも使った WAI-illustrious-SDXL の v17.0(Civitai で配布されている、Illustrious 系のイラスト向けのモデル。アーキテクチャは SDXL)です。以下は、実行結果のうち LoRA の部分です。ベースモデルの部品ごとの数と比率を含む全体は lab/output_count.txt にあり、後のグラフにも描いています。
[LoRA] example_style_lora.safetensors
  file size       : 170,570,692 bytes (header 339,480 bytes)
  tensors         : 2,166
  dtype           : {'BF16': 2166}
  network_dim (r) : 32
  network_alpha   : 16.0
  trained on      : waiIllustriousSDXL_v170.safetensors
  base SHA-256    : f116b0c78ff441467b0cdc8f1936e1ed18ea31e9997c7b132b1b8db533f0bd04
  target layers   : 722 {'unet': 722}
  ranks           : {32: 722}
  LoRA params     : 85,114,880
  W of targets    : 2,207,744,000 (same layers, full matrices)
この LoRA は、UNet の 722 層に、全て同じランク 32 の B と A を持っています。text encoder の層は 1 つも含まれていません。2,166 個のテンソルは、722 層それぞれの lora_up・lora_down・alpha の 3 個です。alpha が 16 なので、差分に掛かる α / r は 0.5 になります。
パラメータは 85,114,880 個で、BF16(1 個 2 バイト)なら 170,229,760 バイトです。ここに先頭の 8 バイト、ヘッダーの 339,480 バイト、alpha 722 個の 1,444 バイトを足すと、ファイルの大きさ 170,570,692 バイトと一致します。以下は、ベースモデルの部品と LoRA のパラメータ数を並べたグラフです。
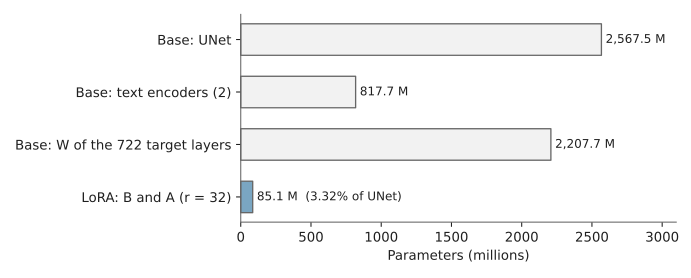
ベースモデルの部品と LoRA のパラメータ数
LoRA が差分を足す 722 層の W は、UNet のパラメータの 86% を占めます。つまり、この LoRA は UNet の大部分の層に手を入れていながら、その層の 3.9% の量で済んでいます。層の内訳は、UNet の中にある 70 個の Transformer ブロック(注意機構と全結合層を組み合わせた単位)ごとに、注意機構(attention)の行列 8 個と全結合の行列 2 個、それに入口と出口の行列 22 個です。
メタデータの trained on と base SHA-256 は、sd-scripts が学習時に記録したベースモデルのファイル名と SHA-256(ファイルの中身から計算するハッシュ値)です。ファイル名と、SHA-256 が配布ページの v17.0 の値と一致することから、学習に使ったのは WAI-illustrious-SDXL v17.0 だと分かります。差分は、このベースモデルとの差として学習された値です。
実験 2: 強さを 0 から 1.0 に変える
手元の ComfyUI(v0.35.0、GPU は AMD Radeon 8060S)の API に、同じワークフローを 5 回送りました。変えたのは LoRA の強さだけで、seed・プロンプト・解像度・サンプラーは固定しています。ベースモデルは、実験 1 と同じく LoRA の学習に使った WAI-illustrious-SDXL v17.0 です。題材は、本の積まれた机の上のフクロウの置物です。表の CFG は、生成をプロンプトにどれだけ強く従わせるかの係数です。
| 項目 | 値 |
|---|---|
| ベースモデル | WAI-illustrious-SDXL v17.0(waiIllustriousSDXL_v170.safetensors) |
| LoRA と強さ | 説明用の画風 LoRA、0 / 0.25 / 0.5 / 0.75 / 1.0 |
| seed・ステップ数・CFG | 20261110・28・5.5 |
| サンプラー | euler_ancestral(対照として euler) |
| 解像度 | 1024 × 1024 |
ワークフローは、ComfyUI の API 形式の JSON(lab/workflow_api.json)です。LoraLoader がチェックポイントのモデルと text encoder に LoRA を重ね、KSampler が画像を生成します。以下は、強さを指定する LoraLoader のノードだけを抜き出したもので、9 ノードの全体は折りたたんでいます。
  "2": {"class_type": "LoraLoader",
        "inputs": {"model": ["1", 0], "clip": ["1", 1],
                   "lora_name": "example_style_lora.safetensors",
                   "strength_model": 1.0, "strength_clip": 1.0}},
workflow_api.json の全体(9 ノード)
{
  "1": {"class_type": "CheckpointLoaderSimple",
        "inputs": {"ckpt_name": "waiIllustriousSDXL_v170.safetensors"}},
  "2": {"class_type": "LoraLoader",
        "inputs": {"model": ["1", 0], "clip": ["1", 1],
                   "lora_name": "example_style_lora.safetensors",
                   "strength_model": 1.0, "strength_clip": 1.0}},
  "3": {"class_type": "CLIPSetLastLayer",
        "inputs": {"clip": ["2", 1], "stop_at_clip_layer": -2}},
  "4": {"class_type": "CLIPTextEncode",
        "inputs": {"clip": ["3", 0],
                   "text": "<trigger>, masterpiece, best quality, no humans, still life, owl figurine, stack of books, wooden desk, desk lamp, indoors"}},
  "5": {"class_type": "CLIPTextEncode",
        "inputs": {"clip": ["3", 0],
                   "text": "lowres, worst quality, bad quality, low quality, jpeg artifacts, blurry, text, signature, watermark, logo, 1girl, person"}},
  "6": {"class_type": "EmptyLatentImage",
        "inputs": {"width": 1024, "height": 1024, "batch_size": 1}},
  "7": {"class_type": "KSampler",
        "inputs": {"model": ["2", 0], "positive": ["4", 0], "negative": ["5", 0],
                   "latent_image": ["6", 0], "seed": 20261110, "steps": 28,
                   "cfg": 5.5, "sampler_name": "euler_ancestral",
                   "scheduler": "normal", "denoise": 1.0}},
  "8": {"class_type": "VAEDecode",
        "inputs": {"samples": ["7", 0], "vae": ["1", 2]}},
  "9": {"class_type": "SaveImage",
        "inputs": {"images": ["8", 0], "filename_prefix": "debimate_lora/weight"}}
}
送信には lab/run_sweep.py を使いました。以下は、その main() から、強さを書き換えて /prompt に 5 本積む部分の抜粋です。/history で終わりを待って /view で画像を取り出す続きは、折りたたんでいます。post_json() と get_json() は urllib.request で JSON を送受信するだけの関数です。引数の処理、ComfyUI 側の保存ファイル名の設定、進み具合と所要時間の表示は省きました。
# lab/run_sweep.py の main() から抜粋
WEIGHTS = [0.0, 0.25, 0.5, 0.75, 1.0]

jobs = []
for w in WEIGHTS:
    wf = copy.deepcopy(workflow)              # workflow_api.json を読んだ dict
    wf["2"]["inputs"]["strength_model"] = w   # UNet に掛ける強さ
    wf["2"]["inputs"]["strength_clip"] = w    # text encoder に掛ける強さ
    if sampler:                               # 対照の euler の時だけ差し替える
        wf["7"]["inputs"]["sampler_name"] = sampler
    res = post_json(base, "/prompt", {"prompt": wf, "client_id": "debimate-lora"})
    jobs.append((w, res["prompt_id"]))        # 自分の依頼の ID だけを控える
完了を待って画像を取り出す部分
# 続き: 送った依頼の完了を待ち、ノード 9(SaveImage)の画像を取り出す
for w, pid in jobs:
    while True:
        hist = get_json(base, f"/history/{pid}")
        if pid in hist:
            break
        time.sleep(3)
    status = hist[pid].get("status", {})
    if status.get("status_str") != "success":
        print(f"weight={w:.2f} failed: {status}")
        sys.exit(1)
    img = hist[pid]["outputs"]["9"]["images"][0]   # ノード 9(SaveImage)の出力
    q = urllib.parse.urlencode({"filename": img["filename"],
                                "subfolder": img["subfolder"], "type": img["type"]})
    dst = os.path.join(out_dir, f"weight_{w:.2f}.png")
    with urllib.request.urlopen(f"{base}/view?{q}") as r, open(dst, "wb") as f:
        f.write(r.read())
ComfyUI の LoraLoader は、強さが 2 つとも 0 の時に LoRA を読まずにベースモデルをそのまま返します。また、実験 1 の通り、この LoRA は text encoder の層を持たないので、効くのは strength_model だけです(strength_clip は効きません)。
1 枚あたり 23.5〜26.0 秒で生成できました。以下が、euler_ancestral で生成した 5 枚です。画像の下の数字が強さです。
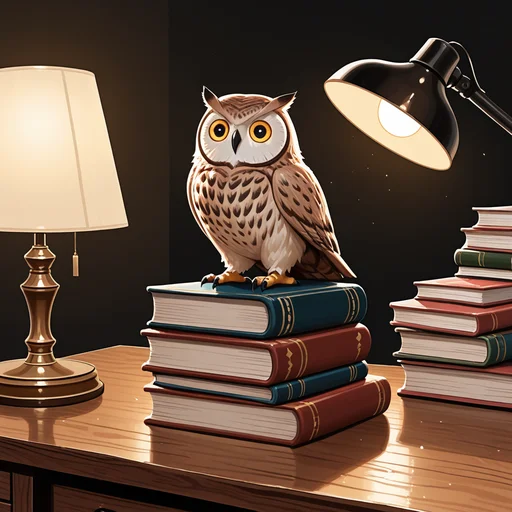
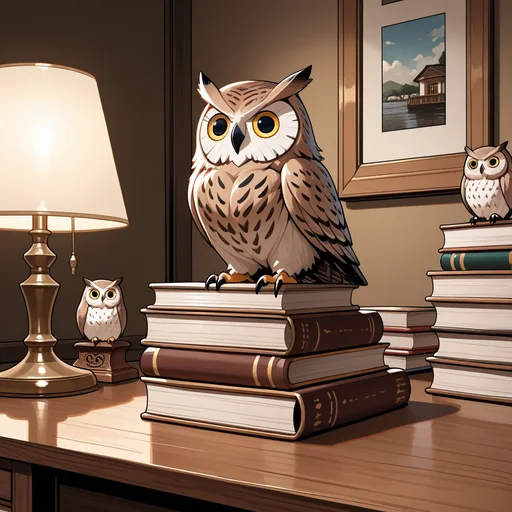
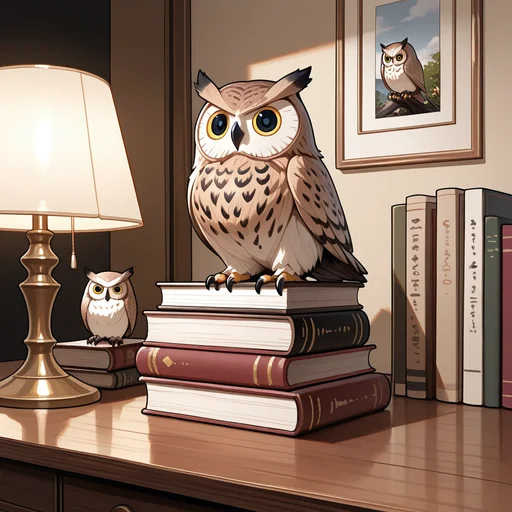
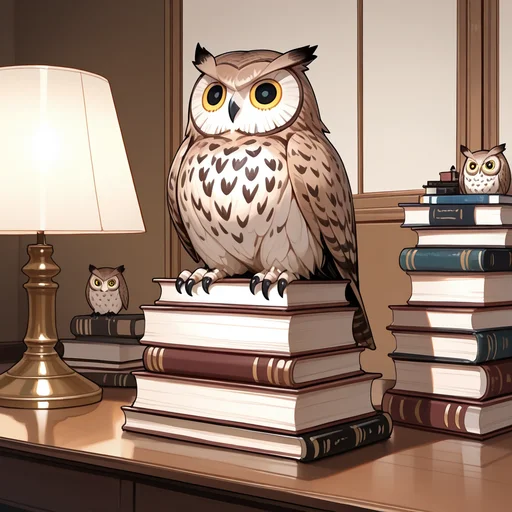
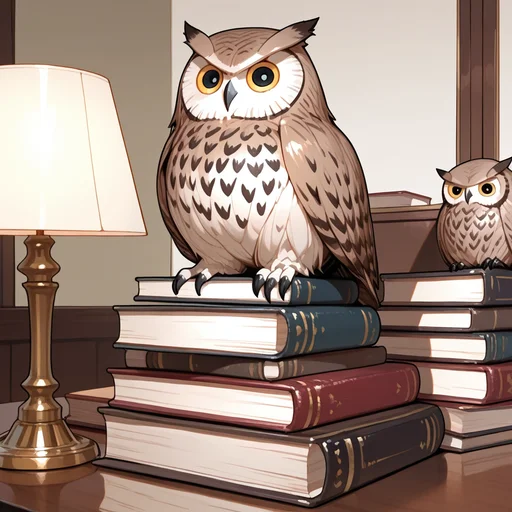
強さ 0 は、黒い卓上ライトが光る暗い部屋の絵です。強さ 0.25 で部屋が明るくなり、壁の額と小さなフクロウの置物が描き足されました。強さを上げるほど、色は淡く、主役のフクロウは大きくなります。一方で、本の山の上にフクロウが座る構図は、どの強さでも残りました。
euler_ancestral は、ステップごとに新しいノイズを足しながら画像を作ります。途中の画像が少しずれると、その後に足されるノイズとの組み合わせが変わり、差が積み重なる可能性があります。そこで、ステップの途中でノイズを足さない euler でも同じ 5 枚を生成しました。
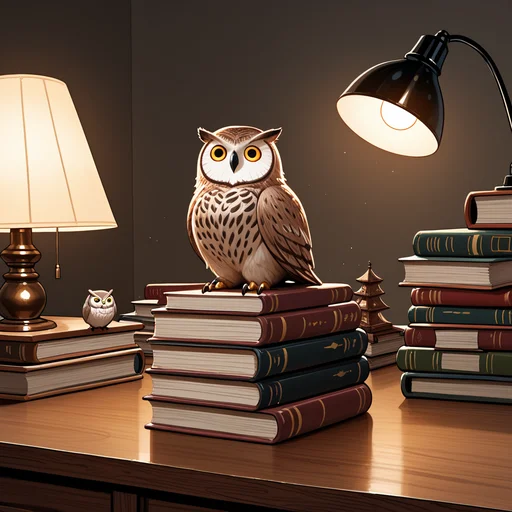
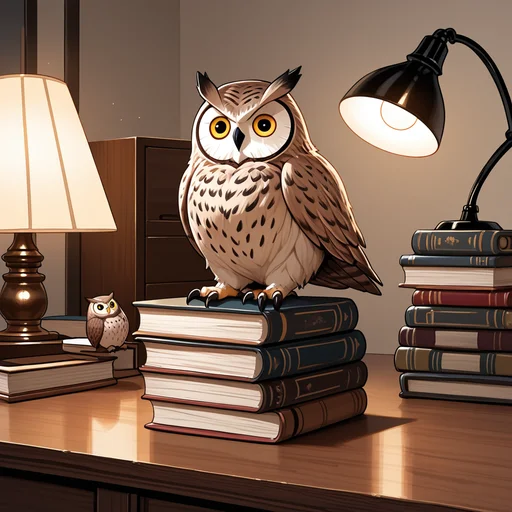
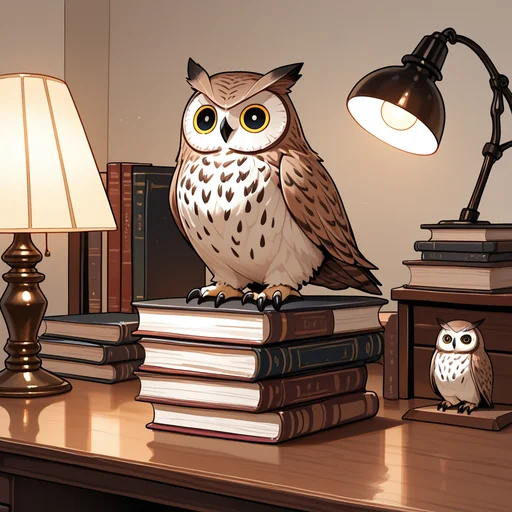
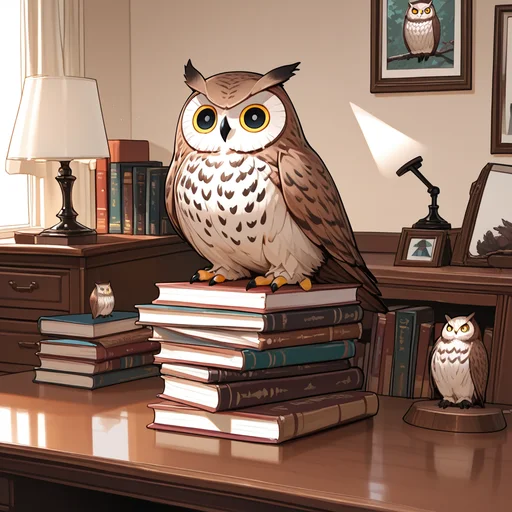
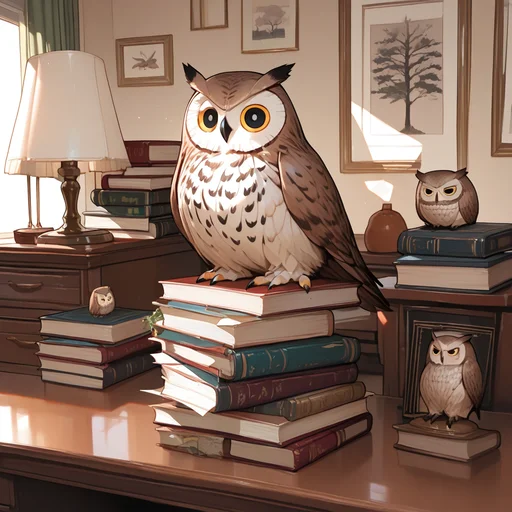
euler でも、構図を保ったまま、強さを上げるほど部屋が明るくなり、置物と額が増えました。1.0 では黒い卓上ライトが消え、窓の光が入る昼の部屋になっています。
この LoRA の学習画像は、ほとんどが人物のイラストです(メタデータのタグの集計による)。人物の無い題材でも、差分は部屋の明るさや小物の数まで変えました。差分が人物の描き方だけでなく、画面全体の描き方を動かしていると考えられます。ここは推測で、層ごとの差分を調べたわけではありません。
画素の差で見る変化
実験 2 の画像の変化を数値でも見るために、lab/to_webp.py で、強さ 0 の画像との画素の差(RGB の値の差の絶対値の平均、0〜255)も数えました。diff_from_prev は 1 つ前の強さの画像との差、brightness は画像をグレースケールにした時の画素の平均(明るさ)です。to_webp.py の出力は、以下に折りたたんでいます。
to_webp.py の出力(強さごとの差と明るさ)
$ python3 to_webp.py <PNG のディレクトリ> ../images ancestral
weight=0.00  diff_from_0=  0.00  diff_from_prev=  0.00  brightness=  83.3
weight=0.25  diff_from_0= 53.77  diff_from_prev= 53.77  brightness= 108.8
weight=0.50  diff_from_0= 66.86  diff_from_prev= 38.68  brightness= 122.9
weight=0.75  diff_from_0= 74.48  diff_from_prev= 47.37  brightness= 134.3
weight=1.00  diff_from_0= 87.87  diff_from_prev= 46.65  brightness= 141.9
$ python3 to_webp.py <PNG のディレクトリ> ../images euler
weight=0.00  diff_from_0=  0.00  diff_from_prev=  0.00  brightness=  82.5
weight=0.25  diff_from_0= 40.35  diff_from_prev= 40.35  brightness= 104.8
weight=0.50  diff_from_0= 57.36  diff_from_prev= 34.05  brightness= 120.3
weight=0.75  diff_from_0= 65.44  diff_from_prev= 36.86  brightness= 121.1
weight=1.00  diff_from_0= 60.45  diff_from_prev= 28.11  brightness= 115.8
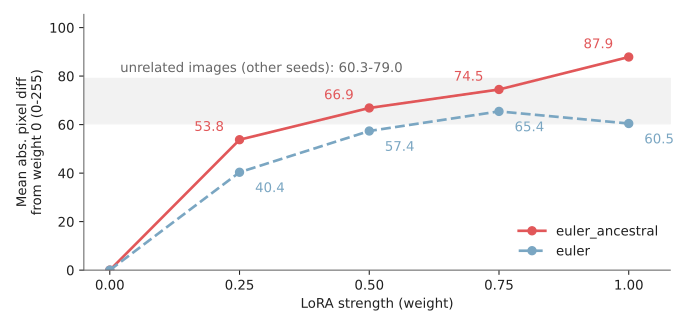
強さごとの、強さ 0 の画像との画素の差
W に足す差分は強さに比例しますが、画像の変化は比例しません。euler_ancestral では、0.25 で 1.0 の時の 6 割の差が出ています。euler では 0.75 の 65.4 が最大で、1.0 では少し下がりました。差分は数百の層に同時に足され、28 ステップの生成で繰り返し使われるので、小さな強さでも出力が大きく動くと考えられます。
この差の大きさを読むには、比べる基準が必要です。そこで、LoRA を使わずに seed だけを変えた 5 枚を生成し、全ての組(10 組)の差を数えました(lab/seed_baseline.py)。生成部分は run_sweep.py と同じなので、差を数える部分だけを抜粋します。
# lab/seed_baseline.py の main() から抜粋(paths は seed ごとの PNG のパス)
arrs = [np.asarray(Image.open(p).convert("RGB"), dtype=np.int16) for p in paths]
diffs = []
for (i, a), (j, b) in itertools.combinations(enumerate(arrs), 2):
    d = float(np.abs(a - b).mean())
    diffs.append(d)
    print(f"seed {SEEDS[i]} vs {SEEDS[j]}: {d:6.2f}")
$ python3 seed_baseline.py <PNG の保存先>
...(10 組の内訳は下の折りたたみ)
min=60.32  mean=69.20  max=79.04
10 組の内訳
$ python3 seed_baseline.py <PNG の保存先>
seed 20261110 vs 20261111:  60.32
seed 20261110 vs 20261112:  65.88
seed 20261110 vs 20261113:  71.23
seed 20261110 vs 20261114:  79.04
seed 20261111 vs 20261112:  64.44
seed 20261111 vs 20261113:  60.35
seed 20261111 vs 20261114:  79.00
seed 20261112 vs 20261113:  72.08
seed 20261112 vs 20261114:  66.06
seed 20261113 vs 20261114:  73.54
min=60.32  mean=69.20  max=79.04
5 枚とも題材は同じですが、フクロウ・ライト・本の山の位置が違う、別の構図の絵です。このような絵どうしの差は 60.3〜79.0 でした。グラフの灰色の帯がこの範囲です。
euler_ancestral の強さ 0.5 以上と euler の 0.75 以上は、別の構図の絵どうしと同じか、それ以上の値です。ただし、画像を見ると構図は残っています。差の多くは構図ではなく、画面全体が明るくなった分だと考えられます。brightness は、euler_ancestral では強さ 0 の 83.3 から 1.0 の 141.9 まで上がりました。画素の差の平均だけでは「別の絵になった」のか「同じ絵が明るくなった」のかを区別できないので、画像と並べて読む必要があります。
なお、同じ環境で euler_ancestral の 5 枚をもう一度生成すると、5 枚とも 1 画素も違わない画像になりました。つまり、上記の変化は生成のたびに出るぶれではなく、強さを変えた結果です。
LoRA の利点
実験の結果とフルファインチューニングを比べると、以下の通りです。
| 観点 | フルファインチューニング | LoRA |
|---|---|---|
| 配るファイル | ベースモデルと同じ大きさ(6.9 GB) | 差分だけ(実験では 170 MB) |
| ベースモデル | 書き換わる | 変わらない。複数の LoRA で共有できる |
| 効き方の調整 | できない | 読み込む時の強さで変えられる |
| 生成の速さ | ベースモデルと同じ | W に足し込めば同じ |
学習中に勾配と最適化の状態を持つのも B と A だけなので、学習に必要な GPU のメモリも減ります。論文は、GPT-3 175B の追加学習で、学習するパラメータを 1 万分の 1、GPU のメモリを 3 分の 1 に減らせたと報告しています。
複数の LoRA は、それぞれの差分を同じ W に足すだけで重ねられます。例えば、画風の LoRA とキャラクターの LoRA を同時に読み込めます。
LoRA の欠点と向かない場面
差分は特定のベースモデルを前提にする
LoRA は「あるベースモデルからの差」なので、層の名前と形が違うモデルには足せません。例えば、SDXL 用の LoRA は、層の数や形が違う前の世代のモデルには読み込めません。同じアーキテクチャの別のモデルには読み込めますが、効き方は変わります。
実験 2 と同じ LoRA・設定で、学習に使っていない Illustrious-XL v1.0(OnomaAI Research が公開した、SDXL のアーキテクチャのイラスト向けのモデル)に重ねると、euler_ancestral では強さ 0.25 で構図が変わり(強さ 0 との差 36.2)、1.0 では主役のフクロウが机の上から消えました(同 42.9)。ベースモデルを更新すると、手持ちの LoRA の効き方も変わります。
ランクで表せる変化には上限がある
差分は r 種類の方向の組み合わせに限られます。画風や特定の小物のように、ベースモデルが描ける範囲の延長にある変化は表しやすい一方で、ベースモデルにほとんど無い知識を大量に足す追加学習では、ランクが足りなくなる場合があります。論文も、小さい r が全てのタスクやデータで通用するとは考えていない、と断っています。
強さと組み合わせは画像で確かめる
実験 2 の通り、強さと画像の変化は比例しません。学習時のベースモデルでも、0.25 で部屋の明るさが大きく変わり、頼んでいない置物が増えました。複数の LoRA を重ねる場合も、足し算は独立でも、それぞれの差分が画像に与える影響は独立とは限りません。強さの値は、使う題材とサンプラーで生成して決める必要があります。生成した画像を人が見る前に機械の検査で振り分ける方法は Image Linting のノートで説明しています。
ライセンスはベースモデルから引き継ぐ
LoRA だけを配っても、使うにはベースモデルが必要です。そのため、まず学習に使ったベースモデルのライセンスを確認します。WAI-illustrious-SDXL の配布ページ(Civitai)は、ライセンスとして Illustrious License(Fair AI Public License 1.0-SD)を示し、生成した画像の商用利用も許可しています。
このライセンスは、生成した画像(output)をライセンスの対象外とする一方で、モデルと派生モデルの使い方の禁止(違法な用途、他人を害する偽情報など)を定めています。変更したモデルを配る時は、同じライセンスか、同じ範囲以上を許すライセンスで配る必要があります。
別のベースとして触れた Illustrious-XL v1.0 のモデルカードは、SDXL の CreativeML Open RAIL++-M License を示しています。このライセンスも生成した画像の権利を主張しませんが、派生物(Derivatives of the Model)を配る時も、使い方の制限(Attachment A)を条件として引き継ぐよう求めています。LoRA がこれらの派生モデルに含まれるかも含めて、配る前にベースモデルのライセンスの条件を確認する必要があります。