LLM(Large Language Model、大規模言語モデル)が一度に受け取れる入力の長さを、コンテキストウィンドウ(context window)と呼びます。2026 年には 100 万トークン(1M)を受け取れるモデルも珍しくなくなり、リポジトリのコード一式や数百ページの資料を、そのまま 1 回の入力に入れられるようになりました。トークンの数え方は Tokenizer のノートで説明しています。
入力が長いと LLM は真ん中を読み落とす、という話を聞いたことがあるかもしれません。2023 年の論文「Lost in the Middle」が示した現象です。逆に、1M 入るなら全部入れておけば安心だ、と考える人もいます。しかし、2026 年 11 月時点の資料を読むと、どちらも半分しか当たっていません。以下は、2023 年の論文で、検索で集めた 20 個の文書を渡して質問に答えさせ、正解を含む文書を 20 個のどこに置いたかによって、正答率がどう変わったかを描いた図です。
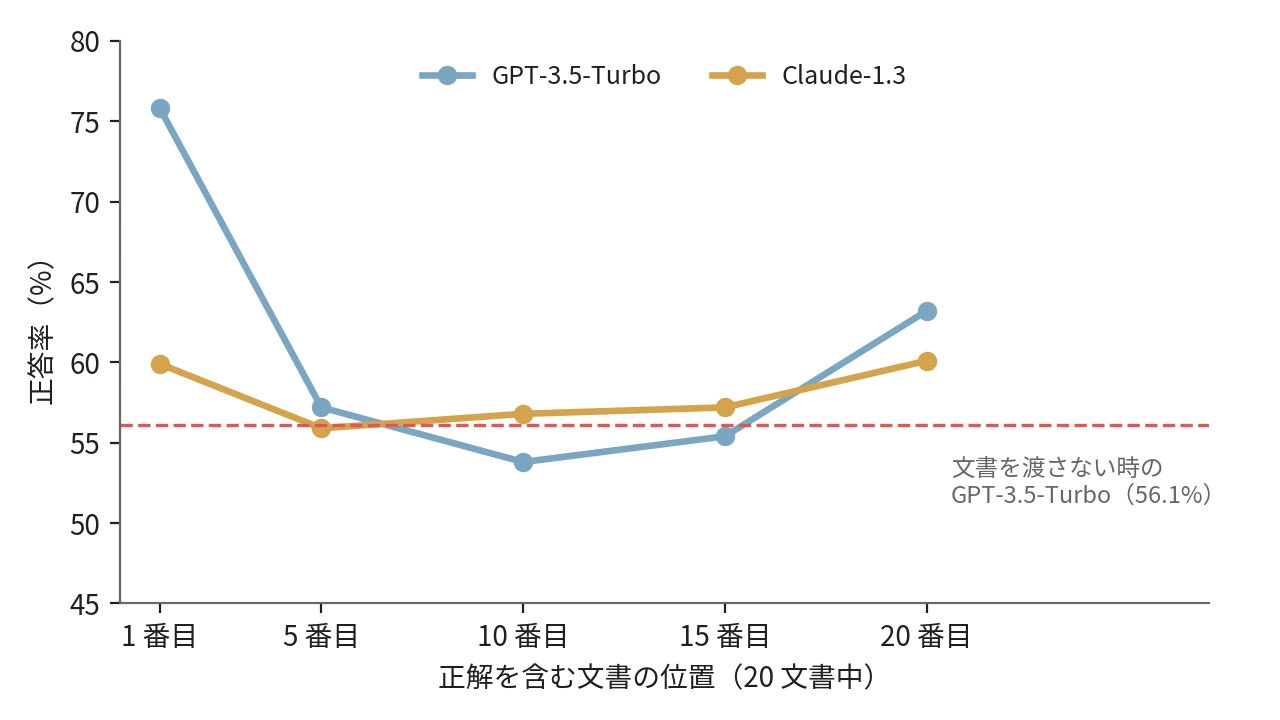
正解の文書の位置と正答率(Lost in the Middle の論文の付録 Table 6 から作図)
当時の GPT-3.5-Turbo は、正解の文書が先頭にあれば 75.8% 答えられたのに、真ん中に置くと 53.8% まで下がりました。文書を 1 つも渡さず、モデルが学習で覚えた知識だけで答えさせた時の 56.1% より低い値です。この U 字の形が「Lost in the Middle」の名前の由来です。
本記事では、この 2023 年の問題が、2026 年 11 月までにどこまで解けたかを、論文・各社の公開資料・手元の実験で説明します。扱う疑問は次の通りです。
- 2023 年に見つかった「真ん中を読み落とす」問題とは何だったのか。
- 公称のコンテキストウィンドウと、実際に使える長さは同じなのか。
- 2025〜2026 年のモデルで、何が改善し、何が残ったのか。
- 手元の 8B(80 億パラメータ)のモデルでは、位置・長さ・紛らわしさがどう効くのか。
- 長い入力を渡す時、何に気を付ければよいのか。
長い入力を速く処理するための KV キャッシュや、位置の符号化(RoPE など)を伸ばして学習の長さを超えさせる手法の中身は説明しません。
長い入力が必要になる場面
長い入力が要るのは、答えに必要な情報が、どこにあるか事前に分からない時です。例えば、AI エージェントにリポジトリのバグを直させる時、原因がどのファイルにあるかは読むまで分かりません。数十回のやり取りが続いた会話で、最初の方に決めた方針を守らせる時も、会話の全体を入力に残しておく必要があります。
必要な部分だけを検索して渡す RAG は、この「どこにあるか」を検索に任せる方法です。一方で、検索が外れれば答えに必要な文が入力に入りません。コンテキストウィンドウが長くなるほど、検索を挟まずに全部を渡す選択肢が現実的になります。その時に問題になるのが、全部を渡した入力の中から、LLM が必要な所を本当に使えるかです。
2023 年の Lost in the Middle
Liu 氏らの論文(2023 年、学会誌 TACL の 2024 年の号に掲載)は、2 つの課題で LLM が長い入力をどう使うかを測りました。1 つは、検索で集めた 10〜30 個の文書を渡し、そのうち 1 つだけに含まれる答えを返させる多文書の質問応答です。もう 1 つは、ランダムな UUID のキーと値の組を 75〜300 個並べ、指定したキーの値を返させる課題です。対象は GPT-3.5-Turbo、Claude-1.3、MPT-30B-Instruct、LongChat-13B などでした。
論文の結論は、次の 1 文です。
performance is often highest when relevant information occurs at the beginning or end of the input context, and significantly degrades when models must access relevant information in the middle of long contexts, even for explicitly long-context models.
(関連する情報が入力の先頭か末尾にある時に性能が最も高くなることが多く、長い入力の真ん中にある情報を使わなければならない時は、長い入力向けのモデルであっても性能が大きく下がる。)
論文によると、20 文書の時の入力は約 4K トークンです。今の感覚では短い入力でも、真ん中の情報は読み落とされていました。
公称の長さと使える長さ
長い入力を測る試験として広く使われてきたのが、針探し(Needle in a Haystack)です。長い無関係な文章(干し草)の中に 1 文(針)を埋め、その内容を問います。2024〜2025 年には、この試験が易しすぎることも分かってきました。「針」の文と質問に同じ単語が入っていれば、モデルは意味を理解しなくても、単語の一致で針を見つけられるからです。
RULER(2024 年)は、針を複数にする、針を追跡させる、集計させるなど 13 種類の課題を用意しました。そして、4K トークンでの Llama2-7B の成績(85.6%)を下回らない最大の長さを「有効な長さ」と定義しました(基準は RULER の著者が選んだものです)。
結果は、32K トークン以上を公称する 17 個のモデルのうち、32K で満足な性能を保てたのは半分だけでした。GPT-4 は公称 128K に対して有効な長さが 64K、Llama 3.1 の 70B も 128K に対して 64K でした。
NoLiMa(2025 年)は、針と質問から共通の単語をなくしました。例えば、針は「実はユキはゼンパー・オペラ座の隣に住んでいる」、質問は「ドレスデンに行ったことがある登場人物は誰か」です。ゼンパー・オペラ座がドレスデンにあることを知っていないと、針を見つけられません。
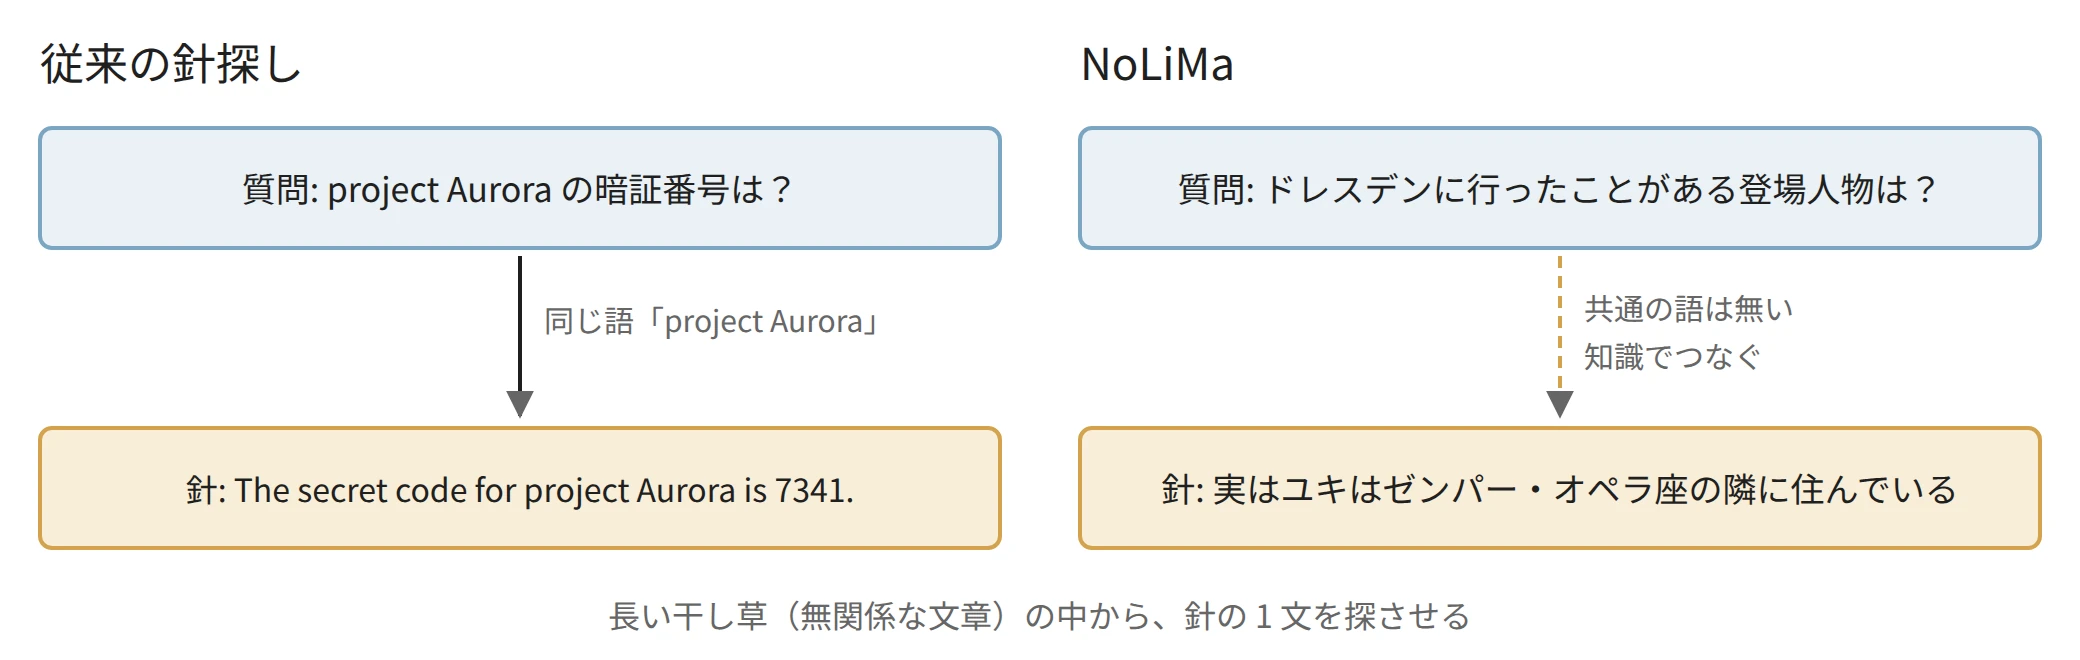
従来の針探しと NoLiMa の違い(左は本記事の後の実験の針、右は NoLiMa の論文の例)
この形にすると、13 個のモデルのうち 11 個が、32K トークンで短い入力の時の半分未満まで成績を落としました。例外として上位に残った GPT-4o でも、ほぼ満点の 99.3% から 69.7% に下がっています。
つまり、2025 年の初めの時点では、単語の一致で探せる針は長い入力でも見つかる一方で、意味でつなぐ必要のある情報は、公称の長さよりずっと手前で拾えなくなっていました。
2025〜2026 年に変わったこと
2025 年の報告: 位置より長さが効く
まず、位置の問題は、単純な検索では目立たなくなりました。ベクトル DB の会社 Chroma が 2025 年 7 月に公開した Context Rot の報告は、Claude Opus 4・GPT-4.1・Gemini 2.5 Pro・Qwen3 など 18 個のモデルを試し、単純な針探しの課題で針の位置を 11 通りに変えても「no notable variation in performance」(性能に目立った差は無い)と書いています。
2025 年の Veseli 氏らの論文も、重みを公開したモデルで U 字が強く出るのは入力がコンテキストウィンドウの半分以下の時で、それを超えると先頭の有利さが薄れて U 字は消え、末尾に近いほど有利な偏りが残ると報告しています。
ただし、同じ Chroma の報告は、位置の代わりに長さそのものが効くことも示しました。18 個のどのモデルも、入力が長くなるほど成績が下がりました。似た偽の針(distractor)を 1 つ足すだけでも成績は下がり、4 つ足すとさらに下がりました。
同じ報告の、会話の記憶を問う LongMemEval を使った比較では、関係する部分だけの約 300 トークンの入力の方が、関係の無い会話も含む約 113K トークンの入力より、全モデルで成績が上でした。意外な結果として、文章として筋の通った干し草より、文の順序をばらばらにした干し草の方が、全モデルで針を見つけやすくなっています。
2026 年の各社の資料: 似たものの区別とつなげて読むこと
2026 年の各社の資料は、Chroma が示した「似た偽物の区別」と、NoLiMa が示した「意味でつなげて読むこと」を測る 2 つの課題で、大きな改善を示しています。まず、2 つの課題の形を説明します。
MRCR v2(Multi-round Co-reference Resolution)は、OpenAI が公開したデータセットです。長い会話の中に「バクの詩を書いて」のような同じ依頼が 2・4・8 回隠れていて、「2 番目のバクの詩を返して」のように、何番目かを区別させます。針と偽の針が同じ書き方で作られているので、単語の一致だけでは何番目かを区別できません。
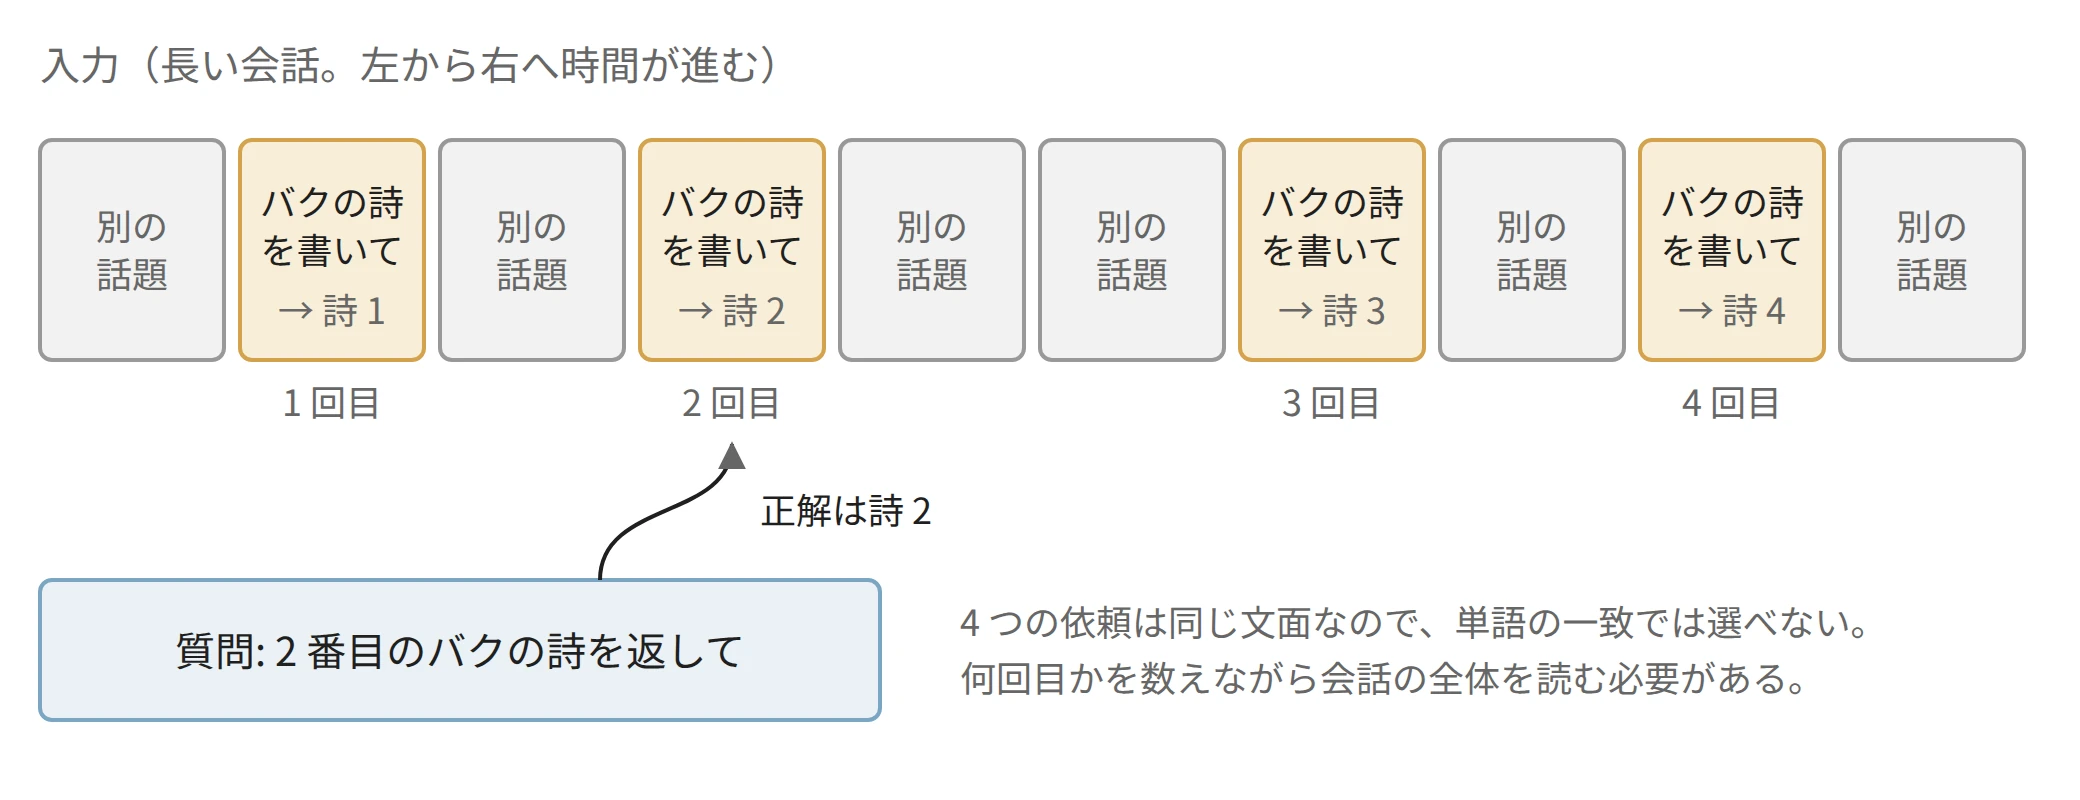
MRCR の課題の形(依頼を 4 回に縮めた概念図。8-needle は同じ依頼が 8 回)
GraphWalks は、16 進数のハッシュを節点にした有向グラフの辺を入力いっぱいに並べ、ある節点から幅優先探索(BFS)で一定の深さにある節点を全て挙げさせる課題です。1 つの針を探すのではなく、入力のあちこちにある辺をつなげて読む必要があります。
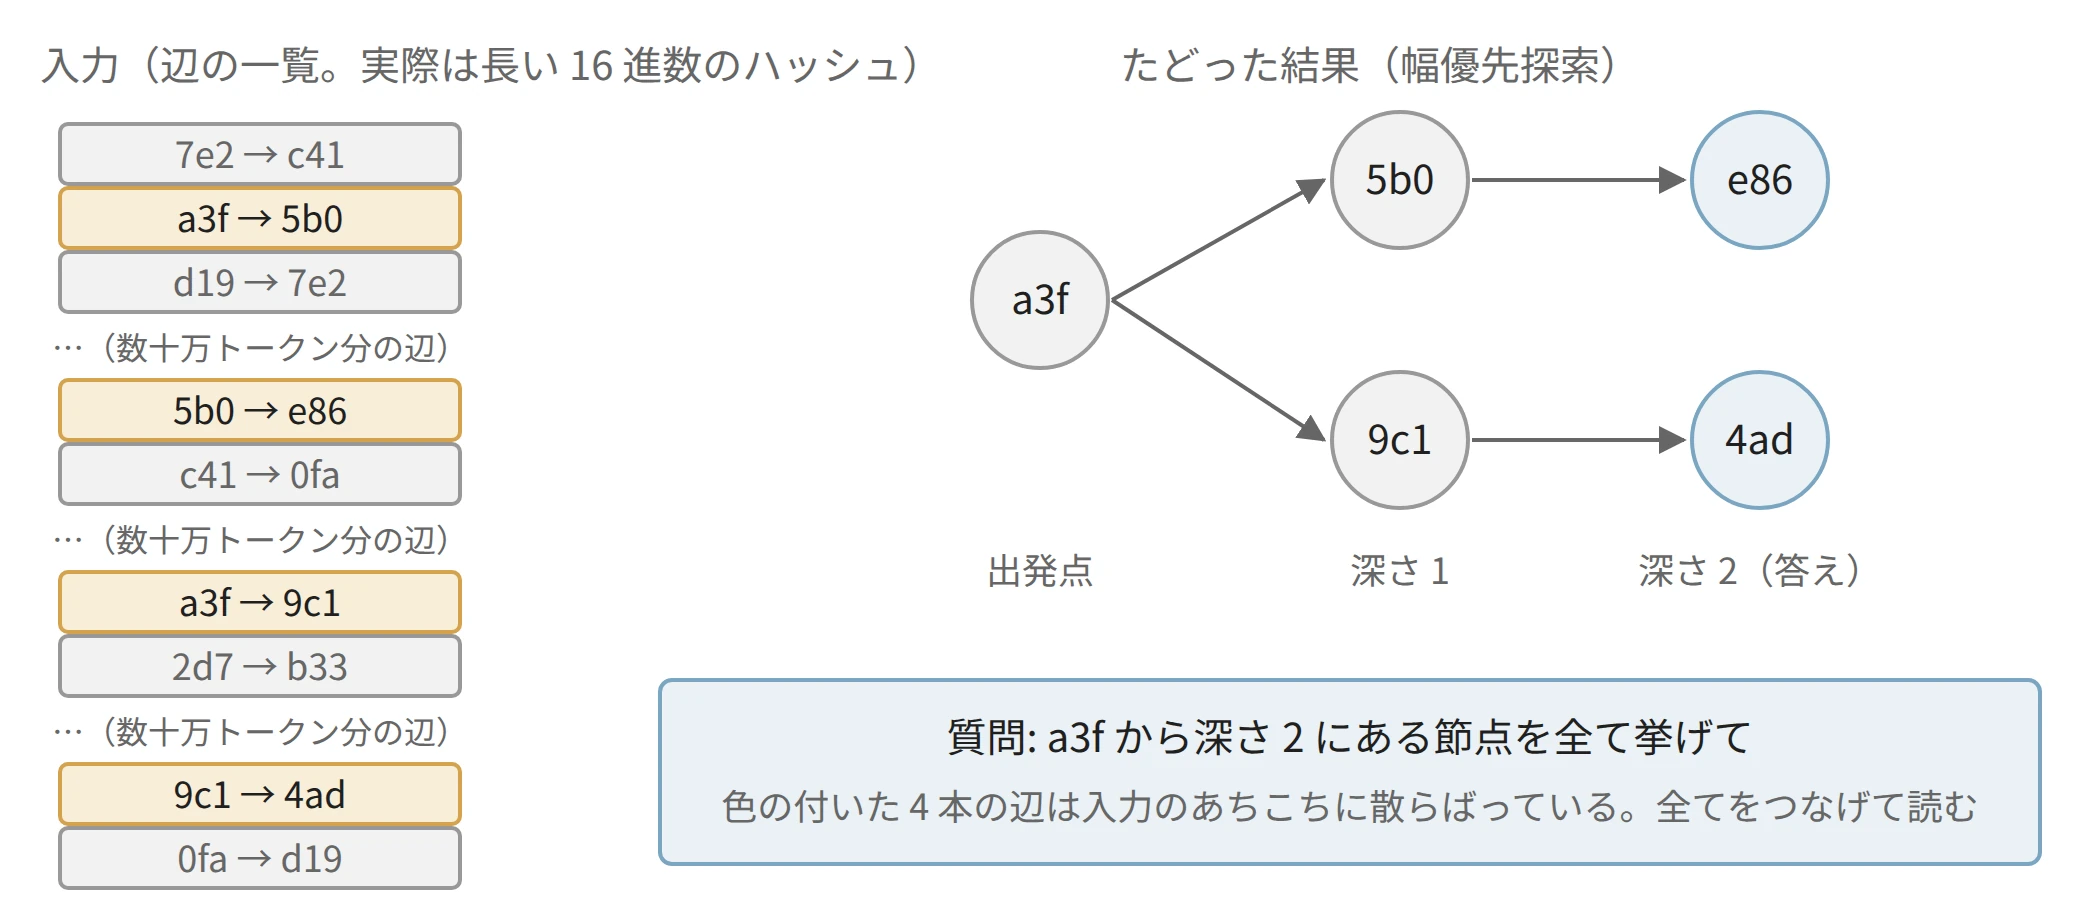
GraphWalks の課題の形(節点の名前を 3 文字に縮めた概念図)
以下は、Anthropic のシステムカード(モデルの公開時に出す、性能と安全性の報告書)に載った 2 つの課題の数値で、同じ会社のモデルの間でだけ並べています。
GraphWalks の F1 は、挙げた節点の正しさと漏れの少なさを合わせた 0〜100 の点です。「入力 256K の問題」「入力 1M の問題」は入力の長さの違いで、MRCR v2 は 524K〜1024K トークンの区間の平均です。
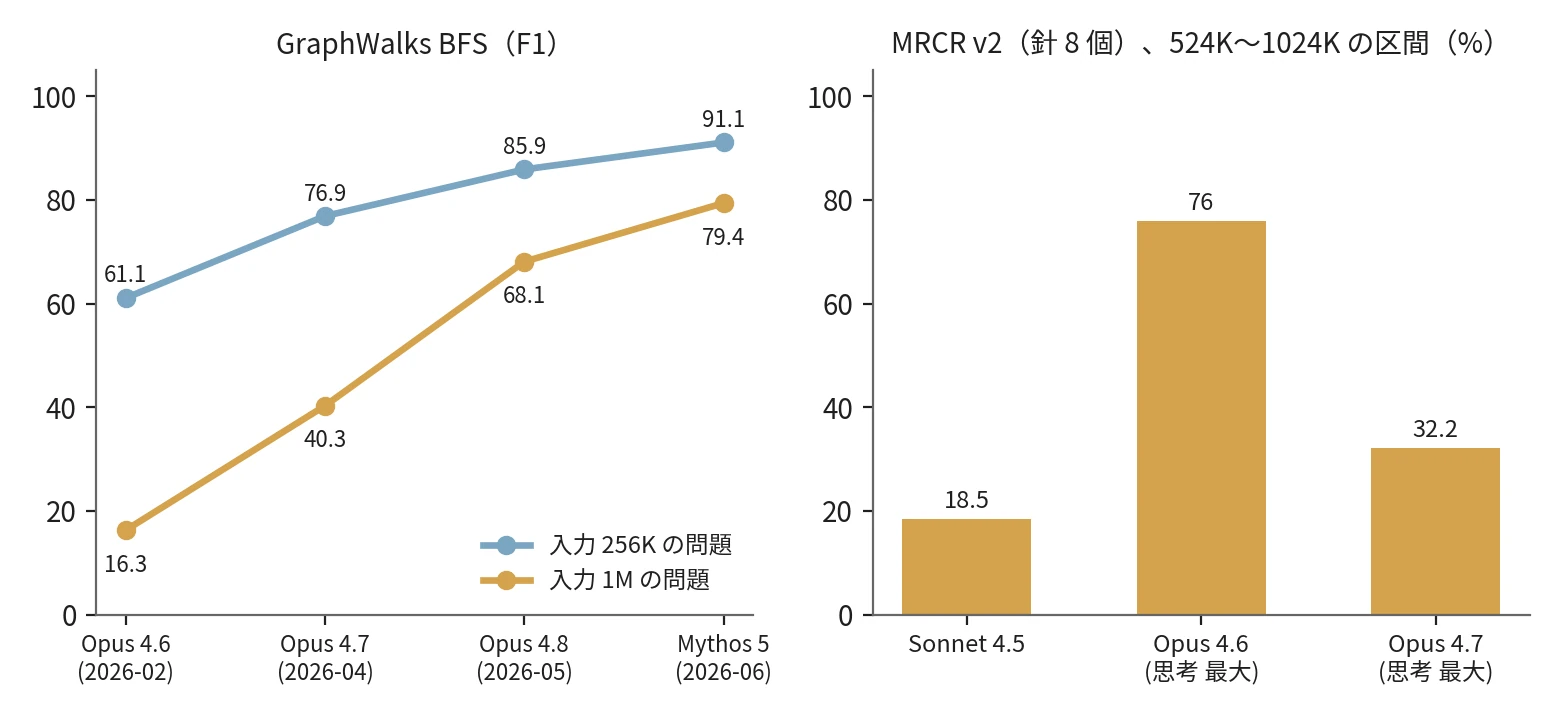
Anthropic の発表とシステムカードに載った長い入力での成績(左の括弧は公開月。右は Opus 4.6 と 4.7 のカードに載った区間の値)
左の GraphWalks では、1M の問題での F1 が、Opus 4.6 の 16.3 から 4 か月で 79.4 まで上がりました。値は Opus 4.8 と Mythos 5(一般向けの Fable 5 と同じモデルで、システムカードは共通)のシステムカードの表から取りました。
右の MRCR v2 について、Opus 4.6 の発表(2026 年 2 月)は context rot に触れたうえで、8 個の針・1M の区間で Opus 4.6 が 76%、Sonnet 4.5 が 18.5% だったと書いています。76% は、答える前に考える量(思考、extended thinking)を最大にした時の値で(システムカードの表)、図の Opus 4.7 の 32.2 も同じく最大の時の値です。
残った問題
それでも、問題が無くなったわけではありません。図と資料から読めることが 3 つあります。
- どの版でも、1M の問題は 256K の問題より低い。差は 44.8 ポイントから 11.7 ポイントまで縮んだが、0 にはなっていない。
- 新しい版が常に上とは限らない。Opus 4.7 のカードでは、MRCR v2 の 1M の区間が 32.2% で、同じく思考の量を最大にした Opus 4.6 の 76% から大きく下がった。
- 1M の結果は、公開 API で受け付ける入力の長さを超える問題を含むため、カード自身が「公開 API では再現できない」と断っている。
各社の数値をまたいで比べるのも危険です。同じ MRCR v2 でも、Google の Gemini 3.1 Pro のモデルカードは 1M ちょうどの長さでの値(pointwise)として 26.3% を載せ、Anthropic は入力の長さが 524K〜1024K トークンの問題をまとめた平均(区間の値)で載せています。同じ名前の数値でも、測った長さの範囲が違います。
Anthropic のカードの MRCR の他社の値は、主に第三者の評価サイト(Context Arena)の値で、一部は各社の自己申告です。例えば Gemini 3.1 Pro の 1M は、Opus 4.7 のカードでは 25.9% と載っていて、Google 自身の 26.3% と一致しません。数値は、同じ資料の中で比べる時にだけ使うのが安全です。
手元の 8B のモデルで確かめる
各社の数値は、手元で再現できません。そこで 2026 年 11 月に、手元の ollama で Qwen3 の 8B(qwen3:8b)に 2 種類の問いを解かせました。思考は切り、出力の揺らぎを決める temperature は 0 です。
実行環境
- PC: AMD Ryzen AI Max+ 395、Radeon 8060S
- ollama 0.22.1、
qwen3:8b(Q4_K_M の量子化) - コンテキストウィンドウは 40,960 トークンで、実行時は 32,768 に設定(超えた入力は既定でエラーにならず一部が捨てられる。Ollama のコンテキスト長)
干し草には、Project Gutenberg の『シャーロック・ホームズの冒険』(パブリックドメイン)の本文を使い、先頭から 8,000・32,000・96,000 文字を切り出しました。トークンに直すと約 1.9K・7.6K・22.6K です。
1 文を探す問い
1 つ目は、干し草の文の切れ目に「The secret code for project Aurora is 7341.」のような 1 文を埋め、「project Aurora の今の暗証番号は」と問う課題です。置く位置を先頭・25%・50%・75%・末尾の 5 通り、プロジェクトを 4 つ変えました。さらに、名前の似た別のプロジェクトの番号や、「去年廃止した古い番号」の文を 3 つ混ぜた条件も用意しました。
以下は、送信に使った lab/needle.py から、紛らわしい文と針を差し込んで問う部分の抜粋です。hay は切り出した本文、sentences は文の切れ目の一覧を返す補助関数、insert は指定した割合の位置に近い切れ目へ文を差し込む補助関数です。
# lab/needle.py の main() から抜粋
TRIALS = [("Aurora", "7341", ["The secret code for project Aurelia is 7314.",
                              "The old secret code for project Aurora, retired last year, was 7431.",
                              "The secret code for project Aurore is 1347."]), ...]

text = hay
if cond == "with_distractors":       # 紛らわしい文を 10%・40%・85% の位置へ(後ろから差し込む)
    for d, s in sorted(zip(DISTRACTOR_DEPTHS, distractors), reverse=True):
        text = insert(text, sentences(text), d, s)
text = insert(text, sentences(text), depth, f"The secret code for project {name} is {code}.")
prompt = (text + f"\n\nQuestion: What is the current secret code for project {name}? "
          "Answer with the number only.")
結果は、120 回のうち 119 回が正解でした。紛らわしい文が無い条件は、22.6K トークンの真ん中に置いても全問正解で、位置による差は見えません。唯一の誤りは、22.6K トークン・紛らわしい文ありで、針を 25% の位置に置いた時です。「project Dynamo」の番号を問われて、名前の似た「project Dinamo」の番号 8642 を答えました。
2023 年の GPT-3.5-Turbo が約 4K トークンで真ん中を落としたのに対し、2026 年 11 月時点の 8B のモデルは、単語の一致で探せる 1 文なら、2 万トークンを超えても位置に関係なく見つけます。Chroma の報告と同じ傾向です。崩れ始めたのは、似た名前の偽物が混ざった時でした。
2 文をつなげる問い
2 つ目は、1 文だけでは答えられない問いです。「Project Aurora is managed by the team in Room 214.」(文 A)と「The team in Room 214 uses the access code 7341.」(文 B)を埋め、「project Aurora を管理するチームの暗証番号は」と問います。A で部屋を知り、B でその部屋の番号を引く、2 段の参照です。
紛らわしい文として、似た部屋番号(241 や 412)の暗証番号と、名前の似たプロジェクトの担当部屋の 3 文を、30%・70%・95% の位置に混ぜました。
A と B の置き方は、隣り合わせで先頭付近(10% と 12%)・真ん中(50% と 52%)・末尾付近(88% と 90%)に置く 3 通りと、10% と 90% に離す 1 通りです。プロジェクトを 4 つ変え、4 通りの置き方と 3 通りの長さで 48 回問いました(lab/twohop.py)。以下は、1 つ目の問いと合わせた正答率です。
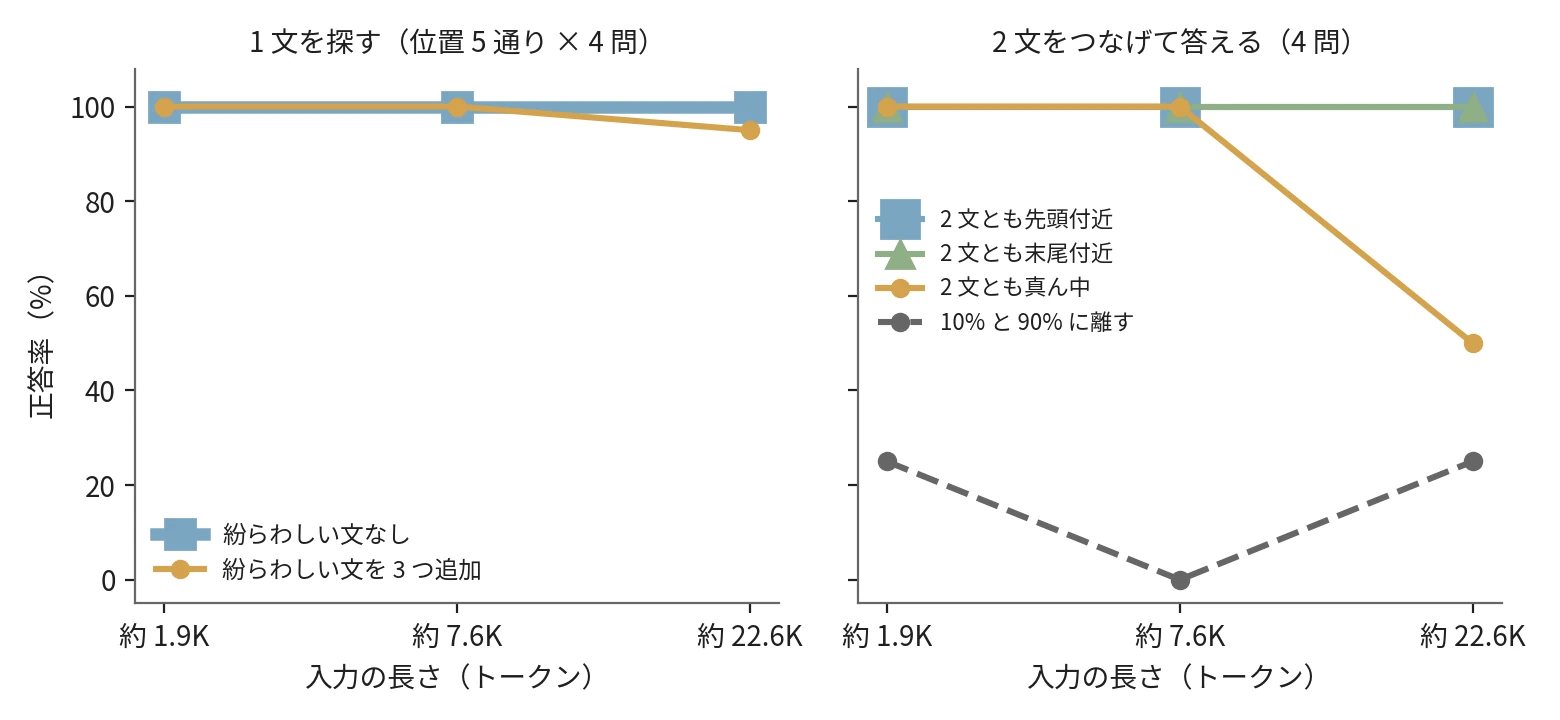
手元の qwen3:8b での正答率(ollama 0.22.1、2026 年 11 月。重なる線は形と大きさを変えて描いた)
2 文が隣り合っていれば、先頭付近と末尾付近は 22.6K トークンでも全問正解でした。真ん中だけは 22.6K で 4 問中 2 問に下がっています。目立つのは、2 文を離した条件です。約 1.9K トークンという短い入力でも 4 問中 1 問しか正解せず、誤答はどれも、紛らわしい文の番号でした。例えば Aurora の問いには、部屋 214 ではなく部屋 241 の 7314 を答えています。
以下は、離した条件での文の置き場所と、誤答がたどった連鎖です。
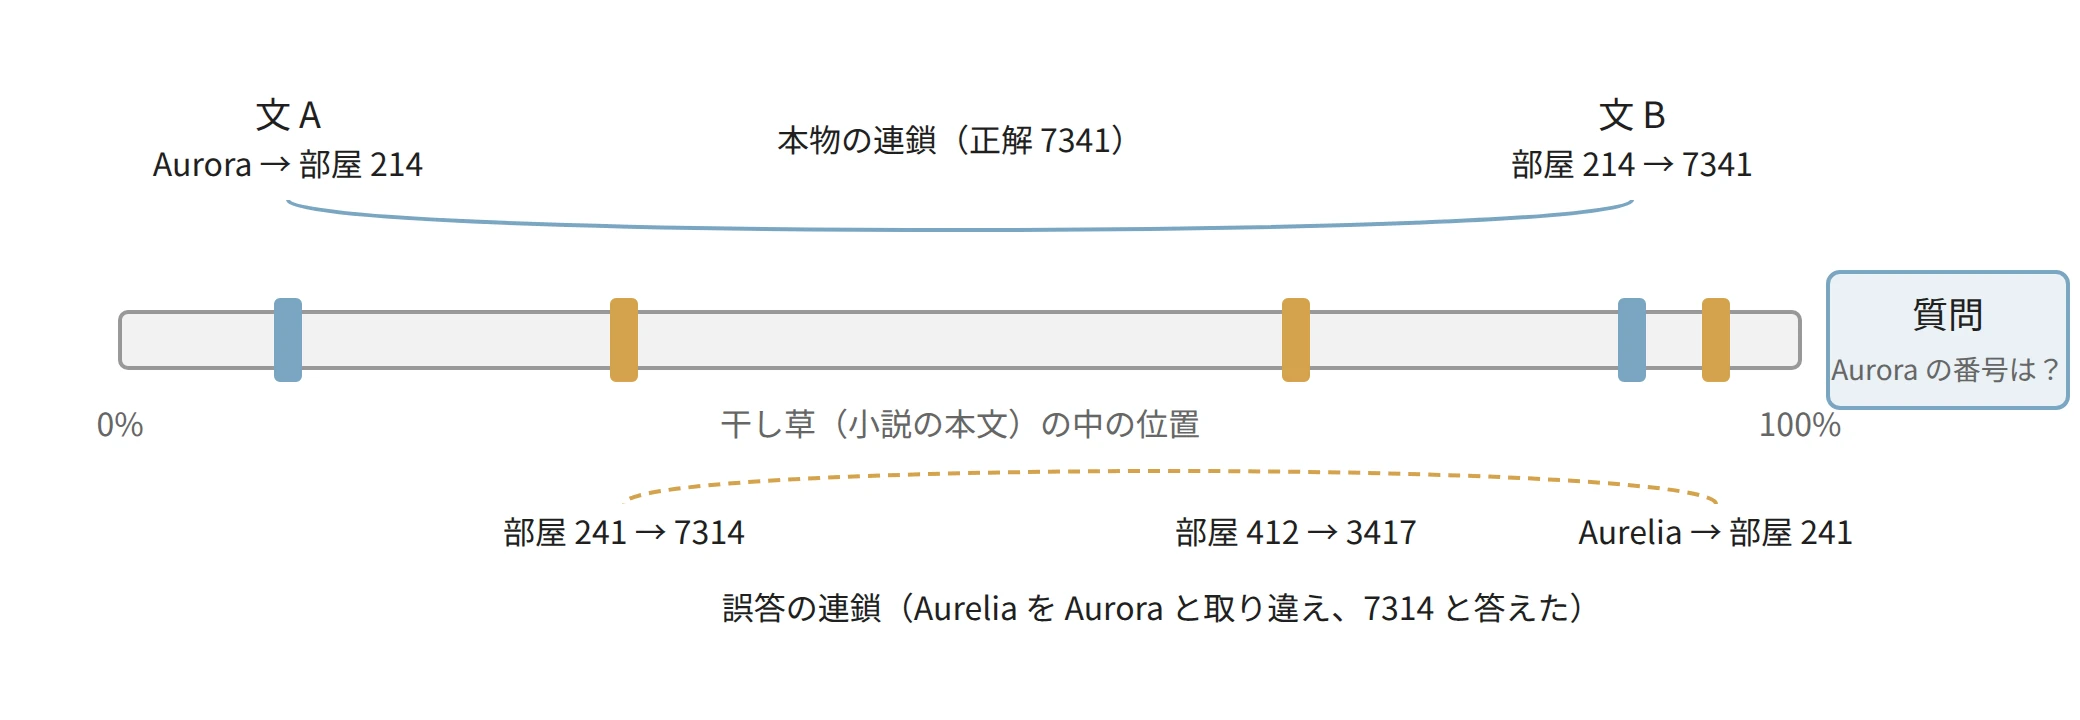
2 文をつなげる問いの置き方(10% と 90% に離した条件。プロジェクト Aurora の例)
誤答の 12 件(離した条件の 10 件と、真ん中・22.6K の 2 件)は、どれも同じ形をしていました。95% の位置にある「Project Aurelia is managed by the team in Room 241.」のような、名前の似たプロジェクトの文を本物の文 A と取り違え、部屋 241 から 7314 へと偽の連鎖を最後までたどっています。離した条件では、本物の文 A(10%)より偽の文(95%)の方が末尾の近くにあります。末尾に近い文を選びやすい偏りに引かれた可能性があります。各条件は 4 問ずつしかなく、7.6K で 0% に落ちた揺れも、この少なさによるものと見ています。
LongPiBench の論文(ACL Findings 2025)は、関係する情報どうしの間隔が偏りを生むと報告しています。手元の 48 回は、この間隔の効果と、末尾に近い偽物に引かれる効果を切り分けられていません。言えるのは、離れた情報をつなげる問いでは、似た偽物が少し混ざるだけで、短い入力でも答えが崩れることまでです。
まとめると、2026 年 11 月時点の 8B のモデルでは、単純な検索で位置の問題はほぼ見えなくなりました。一方で、離れた情報をつなげる問いと、似た偽物の混ざった入力では、2 万トークンに届かない長さでも崩れます。各社の大きなモデルが GraphWalks や MRCR で示した改善も、この 2 つの難しさに向けたものです。
長い入力を渡す時の判断
ここまでの資料と実験から、長い入力を渡す時に気を付けることは 4 つにまとまります。
1 つ目は、関係する部分に絞れるなら絞ることです。Chroma の LongMemEval の比較では、関係する部分だけの約 300 トークンの入力が、約 113K トークンの入力を全モデルで上回りました。入るから全部入れる、ではなく、絞れない時に長い入力に頼る、という順で考えます。資料ごとに読む作業を別の呼び出しに任せ、要るところだけを受け取るサブエージェントも、この絞り方の 1 つです。
2 つ目は、紛らわしい情報を入れないことです。手元の実験で唯一崩れたのも、名前の似た偽物を混ぜた時でした。実務では、古い版の仕様書、廃止した設定、名前の似たファイルが、この偽物にあたります。
3 つ目は、置き場所です。2026 年 11 月時点の Anthropic のプロンプトの手引きは、長い資料をプロンプトの先頭に置き、質問を末尾に置くよう勧めています。手引きは、質問を末尾に置くと、テストで回答の質が最大 30% 上がったと書いています。単純な検索で位置の差が消えても、資料と指示の並べ方まで無意味になったわけではありません。
4 つ目は、自分の用途で測ることです。各社の数値は集計の仕方が違い、1M の結果は公開 API で再現できないと断られている場合もあります。Opus 4.7 のように、版が上がって長い入力の成績が下がることもあります。モデルや版を変える時は、自分の資料と問いで、本記事の実験のような小さな試験を一度回すと安全です。
利点
長いコンテキストに必要な資料をまとめて渡す方法の利点です。
- 検索の外れが無く、答えに必要な文が必ず入力に入る
- 資料を分割して索引を作る前処理が要らない
- 資料の離れた場所をまたぐ関係を、検索を挟まずに扱える
- 2026 年 11 月時点のモデルでは、単純な検索なら位置をほとんど気にしなくてよい
欠点
長い入力は、検索で絞る手間を省く代わりに、モデルが読む量を増やします。そのため、次の制約があります。
- 2026 年のモデルでも、入力が長いほど、紛らわしい情報が多いほど成績が下がる
- 入力のトークン数に応じて、料金と応答までの時間が増える(入力を読む段の速さは Local LLM Speed のノートで説明。手元の実験では 1.9K トークンで約 3.5 秒、22.6K トークンで約 98 秒。いずれも 1 文を探す問いでの中央値)
- モデルの版が上がると、長い入力の成績が変わり、下がることもある
- 公称の上限近くの成績は、公開 API で再現できない条件で示されていることがある
長い入力に頼る効果が小さくなりやすいケース
- 必要な部分が検索ではっきり絞れる質問応答
- 版違いの仕様書や、名前の似た設定が多く混ざる資料
- 応答の速さが重要な対話の用途
- 長い会話の中で、古い決定と新しい決定が混ざっている場面
最後の項目は、長い入力そのものより、入力の中身の問題です。会話が長く続いた時は、決まった方針だけを短くまとめて新しい会話に渡すと、紛らわしい古い決定を入力から外せます。