ローカル LLM(手元の PC で動かす Large Language Model、大規模言語モデル)が質問に答えるまでの時間は、2 つの段に分かれます。1 つは、入力のトークン(文を区切った単位で、LLM はこの単位で読み書きします)をまとめて読む段で、prefill と呼びます。もう 1 つは、答えを 1 トークンずつ生成する段で、decode と呼びます。Ollama では、ollama run --verbose の表示の prompt eval rate が prefill、eval rate が decode の速さです。
以下は、2026 年 11 月に手元の機材(AMD Ryzen AI Max+ 395、内蔵 GPU の Radeon 8060S)で 3 つのモデルに 500〜3.6 万トークンの入力を渡し、2 つの段の速さを分けて測った結果です。
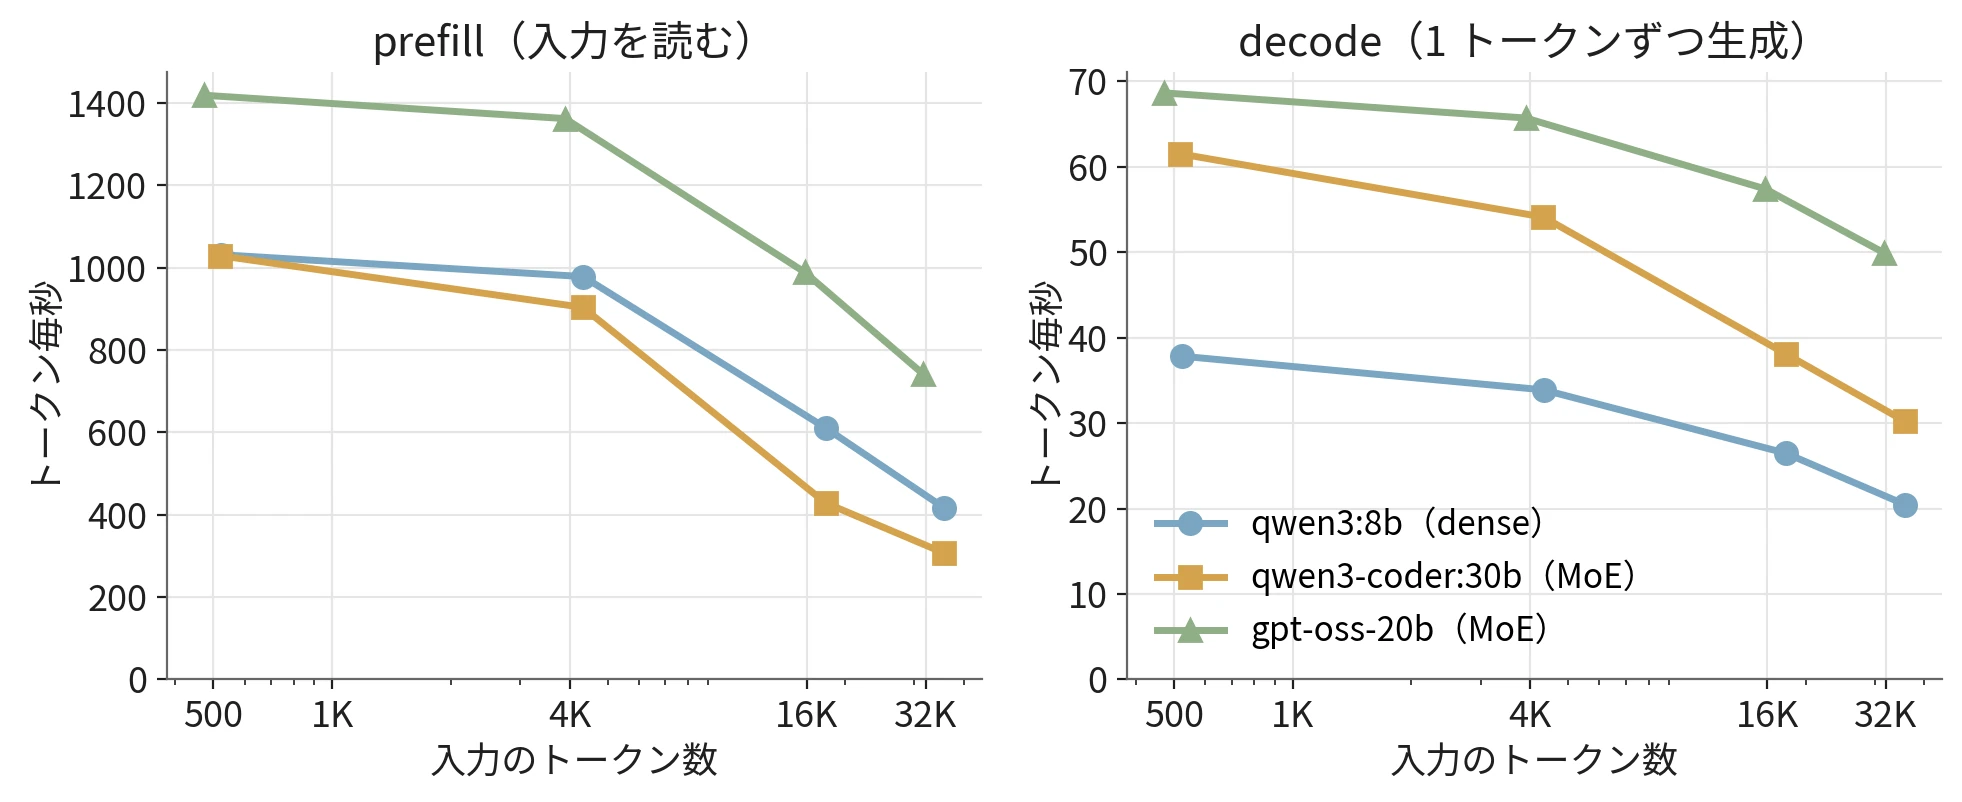
入力の長さと、prefill・decode の速さ(Ollama 0.22.1、3〜4 回の中央値。縦軸の目盛りは左右で 20 倍違う)
prefill は 1 秒に 300〜1,400 トークンを読みますが、decode は 1 秒に 20〜70 トークンしか出せません。しかも、decode の順位は prefill と違い、パラメーター(学習で決まる重みの数値)の数が最も多い qwen3-coder:30b が、最も少ない qwen3:8b より速く生成しています。モデル名の 8b・30b は、パラメーターが 80 億・300 億個という意味です。凡例の MoE(Mixture of Experts)は、層の一部を専門家と呼ぶ小さな層の束に分け、トークンごとに一部だけを動かすモデル、dense は全てのパラメーターを毎回動かすモデルで、違いは後の節で触れます。
本記事では、この 2 つの段の速さを左右するものは何か、手元の計測と計算で説明します。扱う疑問は次の通りです。
- prefill と decode は、なぜ速さが 1 桁以上違うのか。
- decode の上限は、メモリ帯域とモデルのファイルからどう見積もれるのか。
- 見積もりと実測は、どれだけ合うのか。
- 入力が長くなると、なぜ両方の段が遅くなるのか。
- 答えを待つ時間を短くしたい時に、どこを変えると効くのか。
複数のユーザーの依頼をまとめて処理するサーバーの速さ(バッチ処理)と、小さなモデルの予測を使って生成を速める投機的デコードのような手法は説明しません。
2 つの段で、重み 1 個あたりの計算の回数が違う
LLM は同じ形の層を数十段重ねたもので、各層は学習済みの数値(重み)を行列の形で持ちます。層の計算の大半は、入力のベクトルに重み行列を掛ける計算です。prefill では、入力の全てのトークンが最初から分かっているので、数千本のベクトルを束ねて行列にし、重み行列を 1 回読む間に全部を掛けます。読んだ重み 1 個が、トークンの数だけの計算に使われます。
decode では、次のトークンは前のトークンが決まるまで計算できません。1 トークンを出すたびに、全ての層の重み行列を読み直し、ベクトル 1 本だけを掛けます。読んだ重み 1 個につき、掛け算と足し算は 1 回ずつです。この違いを図にすると、次のようになります。
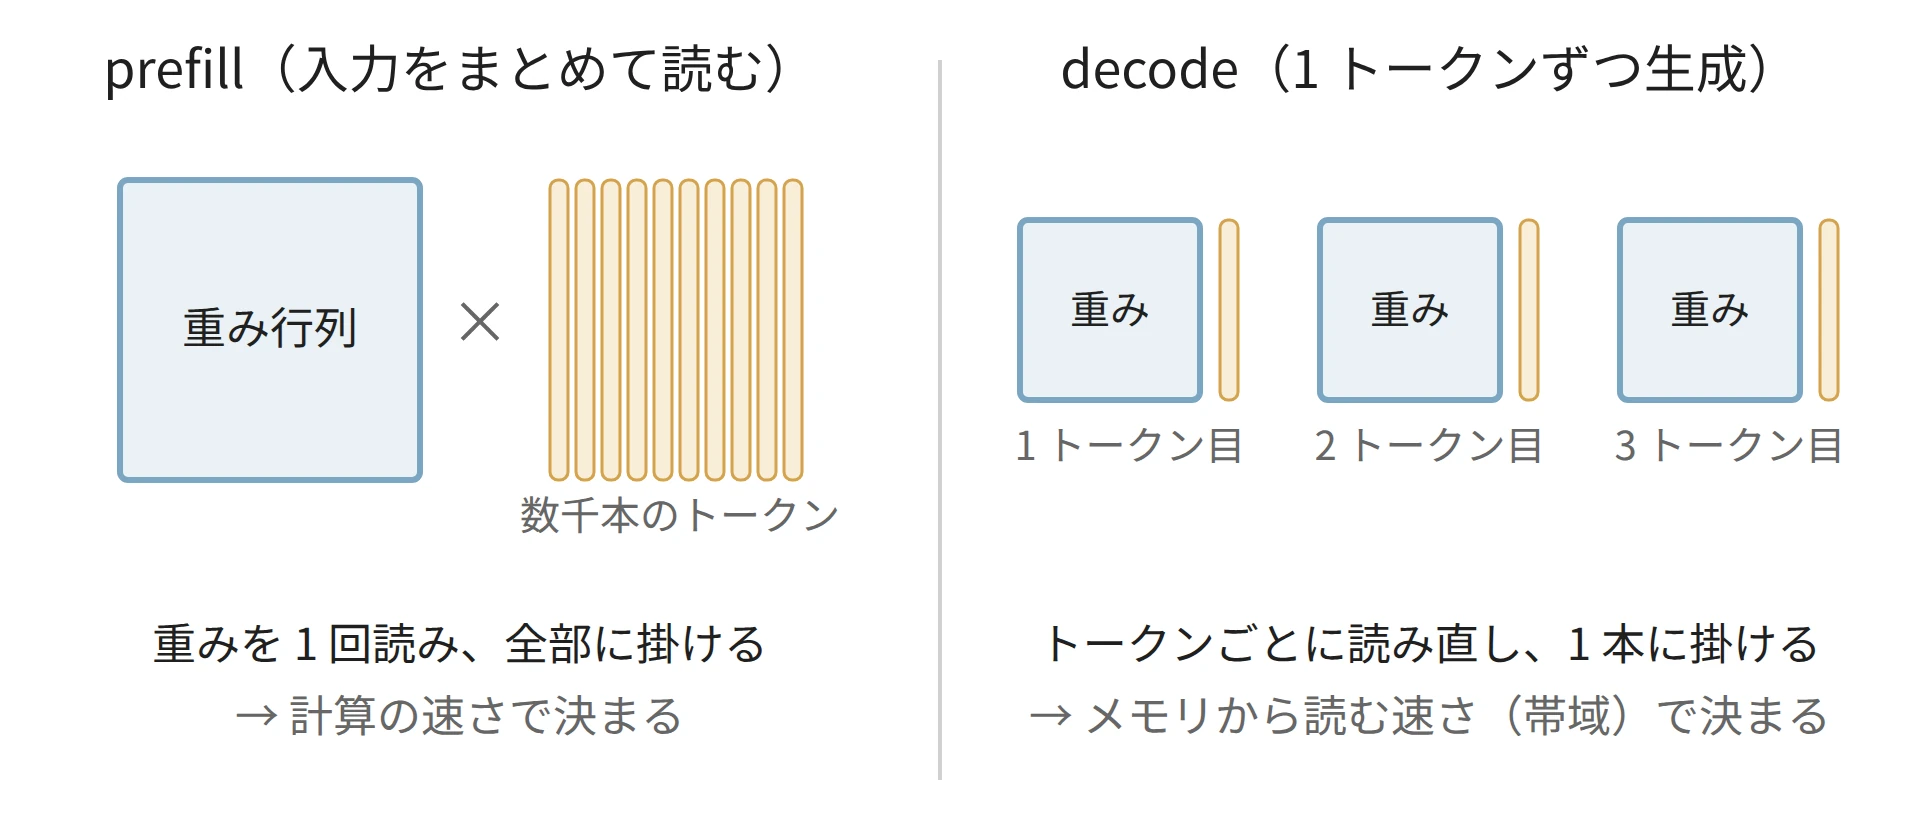
読んだ重みを、何本のトークンに掛けるか
そのため、重みを何度も使う prefill は GPU(行列の計算を並列に行う装置)の計算の速さで決まり、重みを 1 回ずつしか使わない decode は、メモリから重みを読み出す速さ(メモリ帯域)に縛られます。decode のこの性質から、1 秒に生成できるトークン数の上限は、次の式でおおよそ見積もれます。
decode の上限(トークン毎秒) ≒ メモリ帯域(バイト毎秒) ÷ 1 トークンで読むバイト数
1 トークンで読むバイト数     ≒ 重みのバイト数 + それまでのトークンの KV キャッシュのバイト数
KV キャッシュは、既に読んだトークンの計算結果(注意機構の K と V)です。注意機構は、各トークンがそれより前のトークンを参照する層の部分で、K と V はその参照のために各トークンから作るベクトルです。KV キャッシュは、decode の 1 トークンごとに、それまでの全てのトークンの分を読みます。仕組みと大きさの計算は KV キャッシュのノートにあります。入力が長いほど、この項が増えます。
decode の上限を見積もる
式の 2 つの値のうち、メモリ帯域は機材の仕様から計算できます。手元の機材は Ryzen AI Max+ 395 を載せた GMKtec の小型 PC、NucBox EVO-X2 です。
EVO-X2 は、GMKtec の公式ブログ(2025 年 6 月 27 日)の説明では、LPDDR5X-8000(毎秒 80 億回の転送)のメモリを 32 ビットのメモリコントローラ 8 個(合計 256 ビット幅)でつないでいます。理論上の帯域は、256 ビット × 8,000 MT/s ÷ 8 = 256 GB/s です。
この機材は CPU と GPU が同じメモリを共有するので、GPU に割り当てた 64GB の領域にある重みも、この帯域で読みます。手元の機材のメモリが実際に 8000 で動いているかは確かめておらず、本記事では仕様の上限の 256 GB/s を使います。
1 トークンで読む重みのバイト数は、Ollama が保存しているモデルのファイル(GGUF 形式)のヘッダーから数えました。lab/gguf_bytes.py は、テンソル(重みの配列)ごとの形と型からバイト数を出し、次のように足し合わせます。
# lab/gguf_bytes.py の summarize() から抜粋
g = "embed" if name == "token_embd.weight" else "experts" if "_exps" in name else "other"
...
frac = n_used / n_exp if n_exp else 1.0          # MoE なら、全専門家のうち 1 トークンで選ぶ割合
read_b = groups["other"]["bytes"] + groups["experts"]["bytes"] * frac + embed_row
入力の埋め込み(token_embd)は、トークンの番号で 1 行を引くだけなので、1 行分しか数えません。qwen3-coder と gpt-oss は、専門家(expert)と呼ぶ小さな層の束から一部だけを選んで動かす MoE(Mixture of Experts)のモデルで、専門家の重みは選ぶ割合だけを数えます。MoE の仕組みは MoE のノートで説明しています。
| モデル | ファイル | 1 トークンで読む重み | 256 GB/s での上限 |
|---|---|---|---|
| qwen3:8b(Q4_K_M) | 5.2 GB | 4.87 GB | 53 トークン毎秒 |
| gpt-oss-20b(MXFP4 / Q8_0) | 12.1 GB | 2.57 GB | 99 トークン毎秒 |
| qwen3-coder:30b(Q4_K_M) | 18.6 GB | 1.92 GB | 133 トークン毎秒 |
表のモデル名の括弧(Q4_K_M など)は量子化の形式で、重みは 4 bit 前後に量子化されています。計算の全体は lab/output_gguf.txt にあります。
実験の条件
2026 年 11 月 11 日に、Ollama 0.22.1 の /api/chat へ同じ形の依頼を送り、応答の prompt_eval_count と prompt_eval_duration から prefill、eval_count と eval_duration から decode の速さを出しました。
機材は AMD Ryzen AI Max+ 395、Radeon 8060S、RAM 128GB(うち 64GB を GPU に割り当て)です。以下は lab/bench.py で依頼を送る部分です。
# lab/bench.py から抜粋
NUM_CTX = 36864
TAIL = "\nIgnore the records above. Write the integers from 1 to 400 separated by commas."

def chat(model, think, prompt, num_predict=128):
    return api(HOST, "/api/chat", {
        "model": model,
        "messages": [{"role": "user", "content": prompt}],
        "think": think,          # qwen3 系は False、gpt-oss は "low"
        "stream": False,
        "options": {"temperature": 0, "seed": 1, "num_predict": num_predict, "num_ctx": NUM_CTX},
    })

# 先頭に毎回違う札を置き、前回のプロンプトのキャッシュを使わせない
prompt = f"Session {uuid.uuid4().hex}\n" + filler(n, seed=rnd) + TAIL
入力は、灯台守の記録(数字だけが行ごとに変わる英文)を 12〜900 行並べたもので、qwen3 系では 520〜35,700 トークン、トークナイザーの違う gpt-oss では 470〜31,600 トークンになります。最後に「1 から 400 まで数字を書け」と頼み、生成は 128 トークンで打ち切ります。KV キャッシュの確保量を揃えるため、コンテキスト長(num_ctx、一度に扱える最大のトークン数)は全ての条件で 36,864 にしました。
この GPU は画像生成の ComfyUI と共有しているので、生成と重なった回などを除き、条件ごとに 3〜4 回の中央値を使っています。除いた回を戻しても結論は変わりません。gpt-oss は Hugging Face の GGUF を使いました。どちらも詳細は次の折りたたみにあります。
除いた回と、gpt-oss の取得元
各回の前に ComfyUI の待ち行列が空になり、GPU の使用率が 3 秒続けて 10% 以下になるまで待ち、各回の最中も 0.5 秒ごとに待ち行列を見ました。それでも重なった回は、次の図のように decode が遅く出ました。
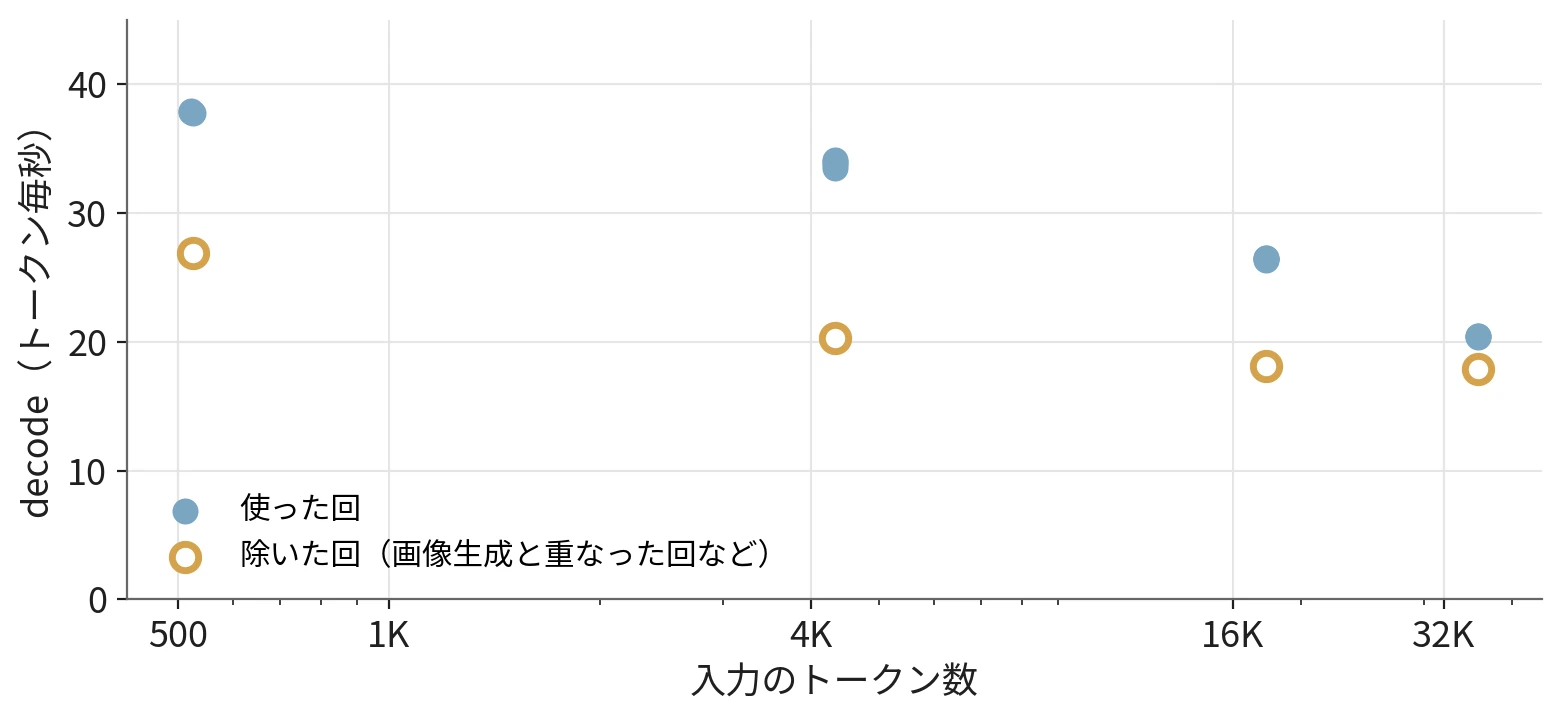
qwen3:8b の各回の decode の速さと、除いた 4 回
全 42 回のうち、ComfyUI の生成と重なった 3 回と、生成の合間に挟まれて decode が同じ条件の他の回より 3 割遅かった 1 回を除き、条件ごとに 3〜4 回の中央値を使っています。除いた 4 回を戻しても、qwen3:8b の decode の中央値は 37.8・33.8・26.5・20.4 トークン毎秒で、結論は変わりません。各回の値は lab/runs.jsonl、手順は lab/README.txt にあります。
gpt-oss は、Ollama のライブラリの gpt-oss:20b が 0.22.1 では取得できなかった(新しい版の Ollama が必要というエラー)ので、Hugging Face の ggml-org/gpt-oss-20b-GGUF を使いました。
この組み合わせでは、128 トークンを生成しても返答の本文と思考の欄(thinking)はどちらも空で返りました(lab/output_check_gptoss.txt)。生成したトークンの数と時間は返るので速さは測れますが、答えの中身は確かめていません。
decode は上限の 5 割弱〜7 割強
以下は、いちばん短い入力(約 500 トークン)での decode の中央値と、上限を並べたグラフです。図の上限は、前の節の重みに、入力 約 500 トークン分の KV キャッシュも足して計算しています。
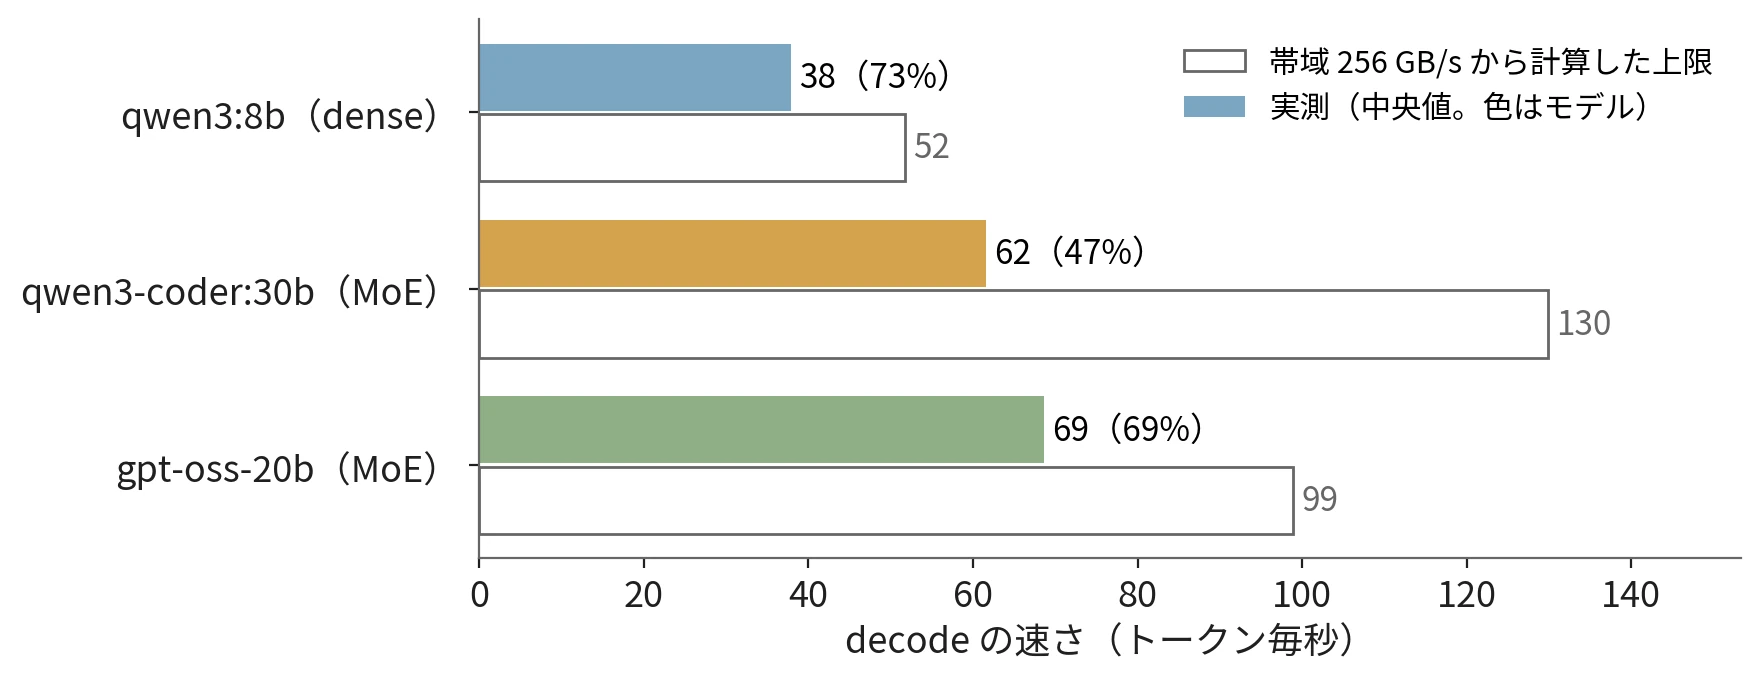
帯域から計算した decode の上限と実測(入力 約 500 トークン、上限は KV キャッシュ込み)
qwen3:8b は上限の 73%、gpt-oss-20b は 69% でした。1 秒に読んだバイト数に直すと、qwen3:8b は 37.8 × 4.95 GB ≈ 187 GB/s で、256 GB/s の帯域の 7 割を使っています。
decode が計算の速さで決まっていないことは、prefill と比べると分かります。qwen3:8b の 1 トークンの計算は、重み 1 個につき掛け算と足し算の 2 回なので、約 2 × 76 億(埋め込みを除いた重みの数)= 150 億回です。
約 4K トークンの prefill(978 トークン毎秒)では、この GPU は 1 秒に約 15 兆回の計算をこなしていました。decode の 37.8 トークン毎秒は 1 秒に約 0.6 兆回で、prefill でこなした量の 25 分の 1 しか使っていません。
qwen3-coder:30b は、上限の 47% にとどまりました。この MoE は 48 層のそれぞれで 128 個から 8 個の専門家を選び、小さな行列を何度も掛けます。読む量のほかに、層や専門家ごとの処理の切り替えにかかる時間が効いていると考えられます(推測です。GPU の内部の時間の内訳は測っていません)。
それでも、qwen3-coder:30b は qwen3:8b の 1.6 倍の速さで生成しました。decode の速さを決めるのは総パラメーター数ではなく、主に 1 トークンで読むバイト数です。
入力が長いほど両方の段が遅くなる
decode の 1 トークンの時間と、重みと KV キャッシュを足した読む量の関係を描くと、どのモデルもほぼ直線に乗りました。KV キャッシュは、Ollama の既定の f16(1 個 2 バイト)として、モデルの層の数と K・V の幅から 1 トークンあたりのバイト数を計算し(qwen3:8b は 147,456 バイト)、入力のトークン数を掛けています。
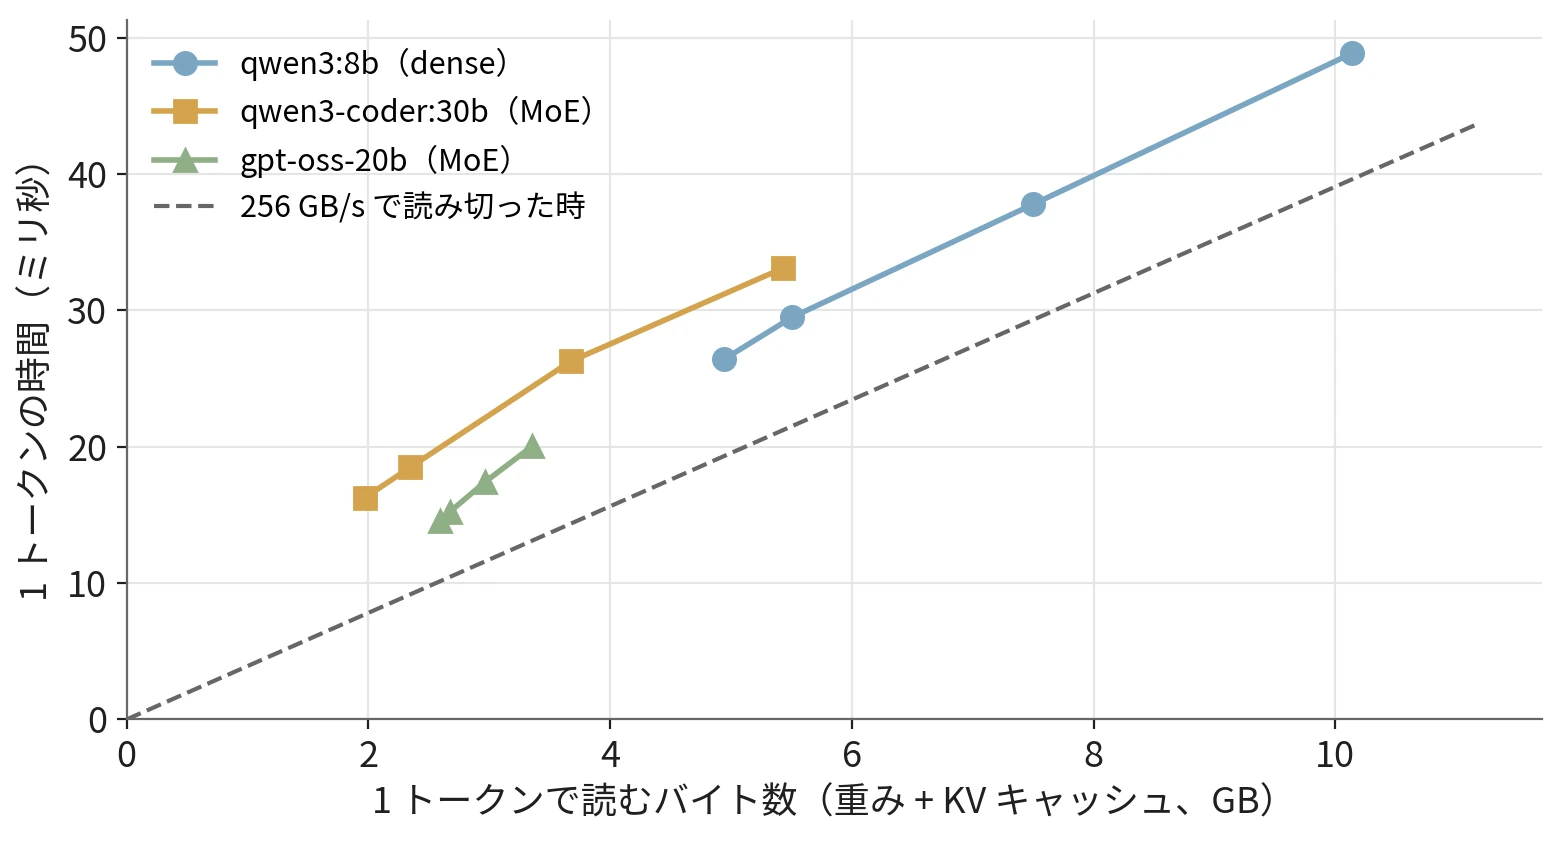
1 トークンで読むバイト数と、decode の 1 トークンの時間(各線の点は左から入力 約 500・4K・16K・32K トークン)
qwen3:8b では、入力が約 3.6 万トークンの時、KV キャッシュが 5.3 GB になり、重みの 4.87 GB を超えます。読む量は約 2 倍になり、decode は 37.8 から 20.5 トークン毎秒に落ちました。破線は 256 GB/s で読み切った時の理論上の最短で、実測は全てその上にあります。直線の傾きは 1 GB あたり 4.3 ミリ秒(約 234 GB/s)で、増えた分はほぼ帯域いっぱいの速さで読まれています。
gpt-oss-20b の線が右に伸びないのは、24 層の半分が直近 128 トークンだけを見る作り(sliding window)で、各トークンの K・V のベクトルの長さの合計も qwen3:8b の半分だからです。残りの 12 層で数えると、1 トークンあたりの KV キャッシュは qwen3:8b の 6 分の 1 です。3.2 万トークンでも KV キャッシュは計算上 約 0.8 GB で、decode は 69 から 50 トークン毎秒にしか落ちませんでした。
prefill も、入力が長いほど遅くなりました。重みの行列を掛ける計算はトークン数に比例しますが、注意機構は各トークンがそれより前の全てのトークンと比べるので、計算はトークン数の 2 乗で増えます。
qwen3:8b の prefill は、約 500 トークンで 1,032 トークン毎秒、約 1.8 万トークンで 611、約 3.6 万トークンで 416 トークン毎秒でした。3.6 万トークンを読み終えて最初のトークンを出すまでに、86 秒かかっています。
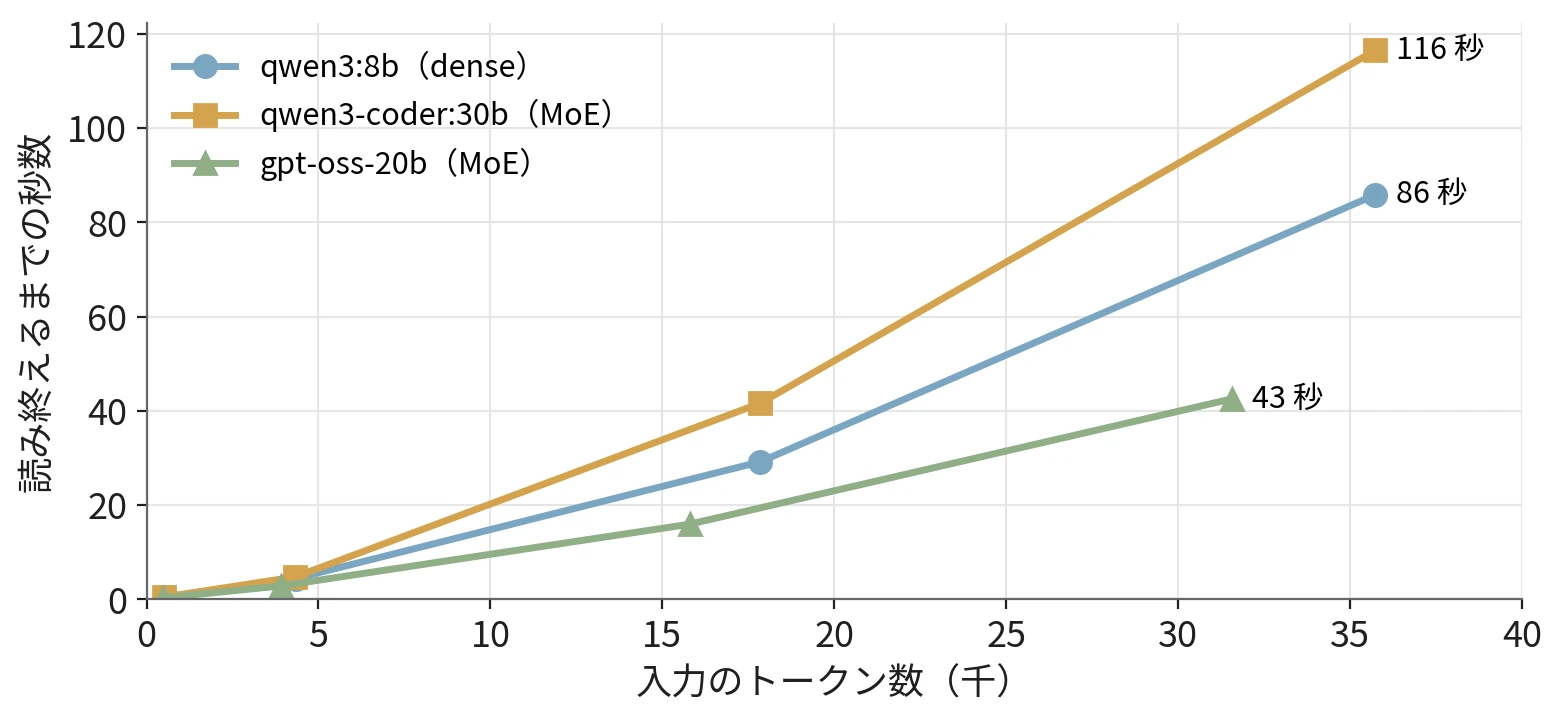
入力を読み終えるまでの時間(prefill、3〜4 回の中央値)
入力が 2 倍になると、読み終えるまでの時間は 2 倍より長くなります。
48 層の qwen3-coder:30b は、長い入力では qwen3:8b より prefill が遅く、3.6 万トークンで 116 秒でした。MoE で減るのは FFN(各トークンを独立に計算する全結合の層)の計算で、注意機構の計算は層の数と幅で決まるからです。
体験に当てはめる
著者は、weeknotesで、この機材の Ollama に Qwen3 8B・gpt-oss 20B・Qwen3-Coder 30B を用途で使い分け、コンテキスト長を 128K にしたが、受け答えが遅く実用的ではなかったと書きました。長いコンテキストのノートの実験でも、同じ機材の qwen3:8b に約 2.26 万トークンを入れると、応答まで約 99 秒(中央値)かかりました。
本記事の計測から 2.26 万トークンの prefill を見積もると 40 秒台で、99 秒はその 2 倍強です。ただし、その計測は num_ctx や送り方が本記事と違い、回ごとの値も 59〜195 秒とばらつき、計測時の負荷も記録していないので、参考に留めます。
答えを待つ時間は、おおよそ「入力のトークン数 ÷ prefill の速さ + 出力のトークン数 ÷ decode の速さ」です。ファイルを読み書きさせるエージェントのように、毎回数万トークンの入力を送る使い方では、待ち時間の大半は prefill です。この場合に効くのは、入力を短くすることと、同じ前置きの計算を使い回すこと(KV キャッシュのノートの実験 3)です。
短い質問に長い答えを返させる使い方では、decode が待ち時間の大半を占めます。こちらに効くのは、1 トークンで読むバイト数を減らすことで、重みを小さく量子化するか、1 トークンで動かすパラメーターの少ない MoE のモデルを選ぶかです。GPU の計算の速さを上げても、decode は速くなりにくいはずです。
見積もりが外れやすいケース
- 重みと KV キャッシュが GPU のメモリに収まらず、一部を CPU で計算する時(
ollama psの SIZE と、GPU に載った量を比べる) - 他の GPU の作業と同時に動かす時。本記事の計測でも、除いた回(画像生成と重なった回など)は decode が 1〜4 割遅かった
- 思考(thinking)を有効にしたモデル。答えの前に生成する思考のトークンも decode の時間に入る
- 複数の依頼をまとめて処理するサーバー。1 回読んだ重みを複数の依頼で使うので、合計の速さは帯域の上限を超えられる
- MoE のモデル。読む量が少なくても、本記事の qwen3-coder:30b のように上限の半分ほどにとどまることがある
本記事の数値は、2026 年 11 月時点、Ollama 0.22.1、この機材での値です。版や機材が違えば値も違いますが、decode は読むバイト数に、prefill は計算に縛られるという関係は同じです。