KV キャッシュ(key-value cache)は、LLM(Large Language Model、大規模言語モデル)が文章を生成する時に、既に読んだトークンの計算結果(K と V と呼ばれるベクトル)をメモリに取っておく仕組みです。LLM は 1 トークンずつ文章を生成し、次のトークンを選ぶたびに、それまでの全てのトークンを参照します。KV キャッシュがあれば、過去のトークンを毎回計算し直さずに済みます。
その代わりに、KV キャッシュはトークンの数に比例してメモリを使います。モデルが一度に扱えるトークン数の上限をコンテキスト長(context length)と呼び、手元で LLM を動かす Ollama では、num_ctx というオプションで決めます。以下は、Ollama がモデルを読み込む時に KV キャッシュをどう確保し、どう埋めていくかを描いた図です。
num_ctx 個の枠を先に確保し、前から埋める KV キャッシュ
Ollama(本記事で使った 0.22.1)では、枠は読み込んだ時点で num_ctx の分だけ全部確保されます。プロンプトが短くても、空きの枠の分のメモリは使われたままです。
本記事では、KV キャッシュの仕組みと、コンテキスト長がメモリと速さに与える影響を説明します。Ollama で num_ctx と入力の長さを変えて測る実験を通して、次の疑問に答えます。
- KV キャッシュが無いと、生成の何が遅くなるのか。
- KV キャッシュの大きさは、モデルのどの設定から計算できるのか。
- num_ctx を大きくすると、メモリはどれだけ増えるのか。プロンプトの長さで変わるのか。
- 入力が長いと、最初のトークンまでの時間と生成の速さはどう変わるのか。
- 同じ前置きを送り直した時に、計算はどれだけ省けるのか。
注意機構の計算の細部(Softmax の数値の扱いや位置の埋め込み)は説明しません。
前提: 注意機構の Q・K・V
LLM は、テキストをトークン(単語や単語の一部。トークナイザーのノートを参照)の列として読み、次に来るトークンを予測するモデルです。本記事で扱う Qwen3 は、Transformer というネットワークの構造を使い、同じ形の層(Qwen3-1.7B では 28 層)を積み重ねています。
各層の中心にある注意機構(attention)は、トークンごとに 3 種類のベクトルを作ります。Q(query)は「自分はどんな情報を探しているか」、K(key)は「自分はどんな情報を持っているか」、V(value)は「実際に渡す中身」を表します。あるトークンの Q と、それまでの全トークンの K を比べて重みを決め、その重みで V を混ぜたものが、その層の出力になります。
文章の生成では、後ろのトークンが前のトークンを参照することはあっても、前のトークンが後ろを参照することはありません(causal attention)。そのため、一度計算したトークンの K と V は、後ろにトークンが増えても変わりません。KV キャッシュは、この性質を使っています。
KV キャッシュが必要な理由
生成は、次の 1 トークンを選び、それを入力の末尾に足して、また次の 1 トークンを選ぶ、の繰り返しです。KV キャッシュが無い場合、1,000 トークン目を選ぶ時には、1〜999 トークン目の K と V を全ての層で計算し直す必要があります。1 トークン目から n トークン目まで生成すると、K と V の計算は合わせて 1 + 2 + … + n 回、つまり n の 2 乗に比例して増えます。
KV キャッシュがあれば、新しいトークンについて計算するのは、そのトークンの Q・K・V だけです。K と V はキャッシュの末尾に足し、Q は過去の K・V と比べるために使います。そのため、生成は次の 2 つの段階に分かれます。
| 段階 | 何をするか | Ollama の応答の値 |
|---|---|---|
| プロンプトの処理(prefill) | 入力の全トークンの K・V をまとめて計算し、キャッシュに入れる | prompt_eval_count、prompt_eval_duration |
| 生成(decode) | 1 トークンずつ、Q を過去の全ての K・V と比べ、新しい K・V を足す | eval_count、eval_duration |
プロンプトの処理は、最初のトークンが出るまでの待ち時間になります。生成の速さは、1 トークンを出すたびに読むメモリの量で決まりやすくなります(理由は量子化のノートの前提の節を参照)。生成のたびに読むのは重みだけでなく、キャッシュに溜まった K・V もです。
キャッシュの大きさ
KV キャッシュの大きさは、モデルの構成から計算できます。1 トークンあたりのバイト数は次の式です。
1 トークンあたり = 2(K と V)× 層の数 × KV ヘッドの数 × ヘッドの次元 × 1 個のバイト数
全体            = 1 トークンあたり × num_ctx
Qwen3-1.7B の config.json では、層の数(num_hidden_layers)が 28、KV ヘッドの数(num_key_value_heads)が 8、ヘッドの次元(head_dim)が 128 です。
Ollama は KV キャッシュを既定で f16(1 個 2 バイト)で持つので、1 トークンあたり 2 × 28 × 8 × 128 × 2 = 114,688 バイト(112 KiB)になります。num_ctx が 4,096 なら 448 MiB(MiB は 2 の 20 乗バイト)、Qwen3-1.7B の上限の 40,960 なら 4.375 GiB です。
ヘッド(head)は、注意機構を並列に何組持つかの単位です。Qwen3-1.7B は Q を 16 ヘッド持ちますが、K と V は 8 ヘッドしか持ちません。Q ヘッドをいくつかの組に分け、組ごとに 1 組の K・V を共有する方式を GQA(Grouped-Query Attention)と呼びます。Qwen3-1.7B では 2 つの Q ヘッドが 1 組を共有します。以下は、通常の注意機構・GQA・MQA で、Q ヘッドと K・V の組の対応を並べた図です。
Q ヘッドと K・V の組の対応(通常・GQA・MQA)
組の数が Q ヘッドの数と同じなら、共有しない通常の注意機構と同じです。Q と同じ 16 ヘッド分の K・V を持つと、KV キャッシュは 2 倍の 224 KiB / トークンになります。組が 1 つになるまで共有するのが MQA(後述)です。GQA は、精度をなるべく落とさずに KV キャッシュを減らすための方式です。
重みの量子化(量子化のノート)は、この式のどこにも入っていません。q4_K_M でも fp16 でも、KV キャッシュの大きさは同じです。
実験 1: num_ctx とメモリ
2026 年 11 月 10 日に、手元の Ollama 0.22.1 と qwen3:1.7b の 3 つの型(q8_0・fp16・q4_K_M)で、上記の式が成り立つか確かめました。digest などの環境は lab/README.txt に記録しています。
モデルを一度降ろしてから num_ctx を指定して読み込み直し、/api/ps(ollama ps と同じ情報)の size を記録します。あわせて、読み込み時にサーバーのログに出る KV キャッシュの大きさを拾い、同じ num_ctx のまま約 1,800 トークンの入力を送った後の size も記録します。
思考モード(thinking)は全ての要求で "think": false を指定して無効にし、出力された思考の文字数が 0 であることを確かめています。
以下は、Ollama の API を呼ぶ補助関数と、実験 1 の繰り返しの部分です。ログを拾う関数などを含む全体は、下の折りたたみに置いています。
# lab/kvlab.py から抜粋
def generate(model, prompt, num_ctx=None, num_predict=64, keep_alive="10m"):
    opts = {"temperature": 0, "seed": 1, "num_predict": num_predict}
    if num_ctx is not None:
        opts["num_ctx"] = num_ctx
    body = {"model": model, "prompt": prompt, "stream": False, "think": False,
            "options": opts, "keep_alive": keep_alive}
    t0 = time.time()
    r = api("/api/generate", body)
    r["wall"] = time.time() - t0
    r["thinking_chars"] = len(r.get("thinking") or "")
    return r

# lab/exp_memory.py から抜粋(unload は keep_alive 0 で降ろして消えるまで待つ関数、
# load_log は読み込み時のログから "kv cache" などの行を拾う関数)
for model, ctx in CASES:
    print(f"## {model} num_ctx={ctx}", flush=True)
    print("  ps before:", ps_line(ps()), flush=True)
    gone = unload(model)
    t0 = time.time() - 2
    r = generate(model, "Say hi.", num_ctx=ctx, num_predict=1, keep_alive="5m")
    time.sleep(1)
    after = ps()
    mine = [x for x in after if x["name"] == model]
    log = load_log(model, t0)
    row = {"model": model, "num_ctx": ctx, "unloaded_first": gone,
           "ps": mine[0] if mine else None, "log": log,
           "load_duration_s": r["load_duration"] / 1e9, "thinking_chars": r["thinking_chars"]}
    # 同じ num_ctx のまま長い入力(約 1,800 トークン)を送り、size が変わるかを見る
    r2 = generate(model, filler(70) + "\nHow many records are listed above? Answer with a number.",
                  num_ctx=ctx, num_predict=8, keep_alive="5m")
    mine2 = [x for x in ps() if x["name"] == model]
kvlab.py と exp_memory.py の全体
"""KV キャッシュの実験で共通に使う道具(Python 標準ライブラリだけ)。

- Ollama の HTTP API を呼ぶ
- /api/ps を記録する
- サーバーのログ(systemd の journal)から、読み込み時の "kv cache" などの行を拾う
- 長さを変えられる詰め物の文章を作る
"""
import json
import os
import subprocess
import time
import urllib.request

HOST = os.environ.get("OLLAMA_HOST", "127.0.0.1:11435")
# ログを読むコマンド。著者の環境では Ollama を systemd のユーザーサービス local-llm で動かしている
LOG_UNIT = os.environ.get("KVLAB_LOG_UNIT", "local-llm")
MODELS_DIR = os.environ.get("OLLAMA_MODELS", os.path.expanduser("~/.ollama/models"))


def api(path, body=None, timeout=900):
    data = None if body is None else json.dumps(body).encode()
    req = urllib.request.Request(f"http://{HOST}{path}", data=data,
                                 headers={"Content-Type": "application/json"})
    with urllib.request.urlopen(req, timeout=timeout) as r:
        return json.loads(r.read())


def ps():
    """/api/ps を短い形にする(名前・size・size_vram・context_length)。"""
    out = []
    for m in api("/api/ps")["models"]:
        out.append({"name": m["name"], "size": m["size"], "size_vram": m["size_vram"],
                    "context_length": m.get("context_length")})
    return out


def ps_line(rows):
    return "; ".join(f'{r["name"]} size={r["size"]/1e9:.2f}GB vram={r["size_vram"]/1e9:.2f}GB '
                     f'ctx={r["context_length"]}' for r in rows) or "(none)"


def blob_of(model):
    """モデル名から重みの blob(sha256-...)を引く。ログの "starting runner" 行と照合するため。"""
    name, tag = model.split(":")
    path = os.path.join(MODELS_DIR, "manifests/registry.ollama.ai/library", name, tag)
    with open(path) as f:
        man = json.load(f)
    for layer in man["layers"]:
        if layer["mediaType"] == "application/vnd.ollama.image.model":
            return layer["digest"].replace(":", "-")
    raise RuntimeError(model)


def load_log(model, since_epoch):
    """since_epoch 以降のログから、model を読み込んだ時の行(KvSize と device.go の内訳)を返す。"""
    try:
        txt = subprocess.run(["journalctl", "--user", "-u", LOG_UNIT, "--since", f"@{since_epoch:.0f}",
                              "--no-pager", "-o", "cat"], capture_output=True, text=True,
                             timeout=30).stdout
    except Exception as e:  # ログが読めない環境では空で返す
        return {"error": str(e)}
    blob = blob_of(model)
    lines = txt.splitlines()
    found = None
    for i, ln in enumerate(lines):
        if "starting runner" in ln and blob in ln:
            found = i
    if found is None:
        return {}
    info = {}
    for ln in lines[found:found + 80]:
        if "KvSize:" in ln and "Operation:commit" in ln:
            info["KvSize"] = int(ln.split("KvSize:")[1].split()[0])
            info["KvCacheType"] = ln.split("KvCacheType:")[1].split(" ")[0] or "(empty)"
        if "source=device.go" in ln:
            msg = ln.split('msg="')[1].split('"')[0]
            dev = ln.split("device=")[1].split()[0] if "device=" in ln else "-"
            size = ln.split('size="')[1].split('"')[0]
            info[f"{msg} {dev}"] = size
            if msg == "total memory":
                break
    return info


def unload(model):
    try:
        api("/api/generate", {"model": model, "keep_alive": 0})
    except Exception:
        pass
    # 実際に消えるまで待つ(他の作業の都合で長引いた時は記録して先へ進む)
    for _ in range(60):
        if all(r["name"] != model for r in ps()):
            return True
        time.sleep(1)
    return False


def filler(n_lines, seed=0):
    """数えやすい詰め物。1 行はおよそ 25 トークン(qwen3 で prompt_eval_count を見て調整)。"""
    rows = []
    for i in range(n_lines):
        k = (i * 7919 + seed * 104729) % 100000
        rows.append(f"Record {i + 1}: sensor S{k % 97:02d} reported {k % 1000} units "
                    f"at hour {k % 24} on day {k % 31 + 1}.")
    return "\n".join(rows)


def generate(model, prompt, num_ctx=None, num_predict=64, keep_alive="10m"):
    opts = {"temperature": 0, "seed": 1, "num_predict": num_predict}
    if num_ctx is not None:
        opts["num_ctx"] = num_ctx
    body = {"model": model, "prompt": prompt, "stream": False, "think": False,
            "options": opts, "keep_alive": keep_alive}
    t0 = time.time()
    r = api("/api/generate", body)
    r["wall"] = time.time() - t0
    r["thinking_chars"] = len(r.get("thinking") or "")
    return r
"""実験 1: num_ctx を変えて読み込み、/api/ps の size と、ログの KV キャッシュの大きさを記録する。

同じ num_ctx で短いプロンプトと長いプロンプトを送り、size が入力の長さで変わるかも見る。
"""
import json
import sys
import time

from kvlab import filler, generate, load_log, ps, ps_line, unload

CASES = [
    ("qwen3:1.7b-q8_0", None), ("qwen3:1.7b-q8_0", 2048), ("qwen3:1.7b-q8_0", 4096),
    ("qwen3:1.7b-q8_0", 8192), ("qwen3:1.7b-q8_0", 16384), ("qwen3:1.7b-q8_0", 32768),
    ("qwen3:1.7b-q8_0", 40960),
    # 重みの形式だけを変える(KV キャッシュは同じ大きさになるはず)
    ("qwen3:1.7b-fp16", 4096), ("qwen3:1.7b-fp16", 32768),
    ("qwen3:1.7b-q4_K_M", None), ("qwen3:1.7b-q4_K_M", 4096),
]

results = []
for model, ctx in CASES:
    print(f"## {model} num_ctx={ctx}", flush=True)
    print("  ps before:", ps_line(ps()), flush=True)
    gone = unload(model)
    t0 = time.time() - 2
    r = generate(model, "Say hi.", num_ctx=ctx, num_predict=1, keep_alive="5m")
    time.sleep(1)
    after = ps()
    mine = [x for x in after if x["name"] == model]
    log = load_log(model, t0)
    row = {"model": model, "num_ctx": ctx, "unloaded_first": gone,
           "ps": mine[0] if mine else None, "log": log,
           "load_duration_s": r["load_duration"] / 1e9, "thinking_chars": r["thinking_chars"]}
    # 同じ num_ctx のまま長い入力(約 1,800 トークン)を送り、size が変わるかを見る
    r2 = generate(model, filler(70) + "\nHow many records are listed above? Answer with a number.",
                  num_ctx=ctx, num_predict=8, keep_alive="5m")
    mine2 = [x for x in ps() if x["name"] == model]
    row["long_prompt_eval_count"] = r2["prompt_eval_count"]
    row["ps_after_long"] = mine2[0] if mine2 else None
    row["long_load_duration_s"] = r2["load_duration"] / 1e9
    print("  ps after :", ps_line(after), flush=True)
    print("  log      :", json.dumps(log, ensure_ascii=False), flush=True)
    print(f"  long prompt {r2['prompt_eval_count']} tok -> size "
          f"{(mine2[0]['size'] / 1e9) if mine2 else float('nan'):.3f} GB", flush=True)
    results.append(row)
    unload(model)

json.dump(results, open(sys.argv[1] if len(sys.argv) > 1 else "memory.json", "w"),
          indent=1, ensure_ascii=False)
記録した memory.json は、lab/summarize_memory.py で表に整形しました(計測の前後の /api/ps を含む生の出力は lab/output_memory.txt)。
num_ctx ごとの size とログの KV キャッシュの表
ps size は読み込んだ直後、after 1.8k は約 1,800 トークンを送った後の size(バイト)、calc kv cache は前の節の式で計算した値です。
model              num_ctx  loaded        ps size     after 1.8k log kv cache calc kv cache
qwen3:1.7b-q8_0       None   40960  7,070,831,488  7,070,831,488      4.4 GiB     4.375 GiB
qwen3:1.7b-q8_0       2048    2048  2,517,914,496  2,517,914,496    224.0 MiB     224.0 MiB
qwen3:1.7b-q8_0       4096    4096  2,754,892,672  2,754,892,672    448.0 MiB     448.0 MiB
qwen3:1.7b-q8_0       8192    8192  3,237,237,632  3,237,237,632    896.0 MiB     896.0 MiB
qwen3:1.7b-q8_0      16384   16384  4,189,344,640  4,189,344,640      1.8 GiB     1.750 GiB
qwen3:1.7b-q8_0      32768   32768  6,106,141,568  6,106,141,568      3.5 GiB     3.500 GiB
qwen3:1.7b-q8_0      40960   40960  7,070,831,488  7,070,831,488      4.4 GiB     4.375 GiB
qwen3:1.7b-fp16       4096    4096  4,605,426,560  4,605,426,560    448.0 MiB     448.0 MiB
qwen3:1.7b-fp16      32768   32768  7,956,675,456  7,956,675,456      3.5 GiB     3.500 GiB
qwen3:1.7b-q4_K_M     None   40960  6,210,022,272  6,210,022,272      4.4 GiB     4.375 GiB
qwen3:1.7b-q4_K_M     4096    4096  1,894,083,456  1,894,083,456    448.0 MiB     448.0 MiB
読み込み時のログの KV キャッシュは、num_ctx 2,048 で 224.0 MiB、4,096 で 448.0 MiB、40,960 で 4.4 GiB でした。前の節の式で計算した 224 MiB・448 MiB・4.375 GiB と一致します。num_ctx を指定しない時は、Qwen3-1.7B の上限の 40,960 で読み込まれました。以下は、num_ctx と size の関係をグラフにしたものです。
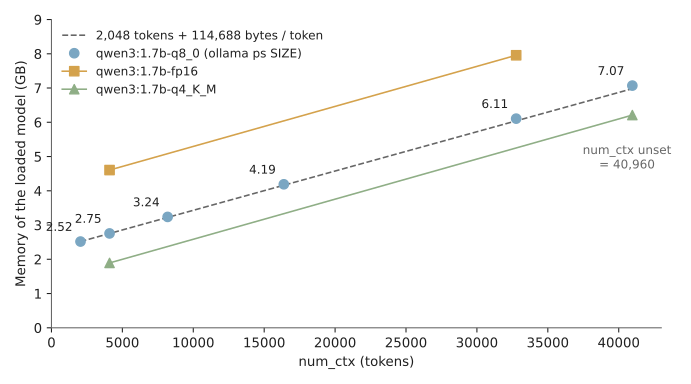
num_ctx と読み込んだモデルの size(qwen3:1.7b の 3 つの型)
上記のグラフを見て分かる通り、3 つの型は重みの分だけ上下にずれていますが、傾きは同じです。num_ctx を 4,096 から 32,768 に上げた時の増え方は、q8_0 と fp16 のどちらも 3,351,248,896 バイトで、1 バイトも違いませんでした。
このうち 3,288,334,336 バイトは、増えた 28,672 トークン分の KV キャッシュ(28,672 × 114,688)です。残りの約 63 MB は、ログに出る計算用の作業領域(compute graph)が num_ctx に合わせて大きくなった分です。
もう 1 つ分かるのは、size が入力の長さで変わらないことです。約 1,800 トークンを送った後の size は、全ての行で読み込み直後と同じでした。
ただし、/api/ps の size は読み込み時に Ollama が割り当てとして計算した量で、その後の使用量を測り直した値ではありません。KV キャッシュが読み込み時に num_ctx 個の枠の分だけ確保されたことは、ログの kv cache ROCm0(num_ctx 32,768 で 3.5 GiB など。上の表の log kv cache)で確かめています。
num_ctx を指定しないと、短い質問しか送らなくても 40,960 トークン分のメモリが使われます。量子化のノートで見た「q4_K_M のファイルは 1.36 GB なのに、ollama ps は 6.2 GB」という差は、この空きの枠の分です。以下は、この実験の q4_K_M の size について、前の節の式で計算した KV キャッシュとそれ以外の内訳を描いた図です。
q4_K_M の size の内訳(KV キャッシュとそれ以外)
KV キャッシュ以外の部分は、num_ctx を 10 倍にしても 1.4〜1.5 GB でほとんど変わりません。差の大部分は、使われていない枠の分です。
num_ctx の既定値は、2026 年 11 月時点の Ollama のコンテキスト長のドキュメントによると GPU のメモリの量で変わり、24 GiB 未満なら 4k、24〜48 GiB なら 32k、48 GiB 以上なら 256k です。同じ時点の FAQ には「既定は 4096 トークン」と書かれており、2 つのページは食い違っています。
手元の GPU は CPU とメモリを共有するタイプ(AMD の Ryzen AI Max+ 395 に内蔵された Radeon 8060S)で、Ollama 0.22.1 は 94.7 GiB を GPU のメモリと見なしていました。実測はコンテキスト長のページと合いました。
0.22.1 のコードでも、既定値は GPU のメモリで 4,096・32,768・262,144 から選ばれ(server/routes.go)、モデルの上限より大きければ上限に切り詰められます(llm/server.go)。そのため、Qwen3-1.7B は 262,144 を上限の 40,960 に切り詰めた長さで読み込まれました。
上限が 262,144 の qwen3:4b(Qwen3-4B-Thinking-2507)は、同じ時間に他の作業が 262,144 で読み込んでいたものが /api/ps に残っており、size は 42.31 GB でした。Qwen3-4B は 36 層・KV ヘッド 8 なので、KV キャッシュだけで 262,144 × 147,456 バイト = 36 GiB になります。ファイルが 2.5 GB のモデルでも、num_ctx を指定しないと 40 GB を超えるメモリを使うことがあります。
実験 2: 入力の長さと速さ
次に、num_ctx を 32,768 に固定し、入力の長さだけを約 540 トークンから約 30,800 トークンまで 7 段階に変えて、プロンプトの処理の時間(prompt_eval_duration)と生成の速さ(eval_count / eval_duration)を測りました。毎回、入力の先頭に違う文字列を置いて、前の回の KV キャッシュを使わせないようにしています。生成は最大 64 トークンで、1〜300 の数を書かせて途中で止めます。
マシンには他の作業の負荷が掛かっており、実験 2 と実験 3 を通して、他の作業の qwen3:4b(42.31 GB)が同じ GPU に読み込まれたままでした。そこで、7 段階を 3 巡して、長さごとに中央値を採りました。
# lab/exp_prefill.py から抜粋(全体は下の折りたたみ)
MODEL = "qwen3:1.7b-q8_0"
NUM_CTX = 32768
LINES = [19, 39, 79, 159, 319, 639, 1170]  # およそ 512〜30,000 トークン
ROUNDS = 3
TAIL = "\nIgnore the records. Write the integers from 1 to 300 separated by commas."

generate(MODEL, "Say hi.", num_ctx=NUM_CTX, num_predict=1)  # 読み込みを先に済ませる
rows = []
for rnd in range(ROUNDS):
    for n in LINES:
        before = ps()
        prompt = f"Session {uuid.uuid4().hex}\n" + filler(n, seed=rnd) + TAIL
        r = generate(MODEL, prompt, num_ctx=NUM_CTX, num_predict=64)
exp_prefill.py の全体
"""実験 2: num_ctx を 32768 に固定し、入力の長さだけを変えて、
最初のトークンまでの時間(prompt_eval_duration)と生成の速さを測る。

毎回、先頭に違う札(nonce)を置き、前回の KV キャッシュを使い回させない。
3 巡して、長さごとに中央値と最小・最大を出す。
"""
import json
import statistics
import sys
import time
import uuid

from kvlab import filler, generate, ps, ps_line

MODEL = "qwen3:1.7b-q8_0"
NUM_CTX = 32768
LINES = [19, 39, 79, 159, 319, 639, 1170]  # およそ 512〜30,000 トークン
ROUNDS = 3
TAIL = "\nIgnore the records. Write the integers from 1 to 300 separated by commas."

generate(MODEL, "Say hi.", num_ctx=NUM_CTX, num_predict=1)  # 読み込みを先に済ませる
rows = []
for rnd in range(ROUNDS):
    for n in LINES:
        before = ps()
        prompt = f"Session {uuid.uuid4().hex}\n" + filler(n, seed=rnd) + TAIL
        r = generate(MODEL, prompt, num_ctx=NUM_CTX, num_predict=64)
        after = ps()
        row = {"round": rnd + 1, "lines": n,
               "prompt_eval_count": r["prompt_eval_count"],
               "prompt_eval_s": r["prompt_eval_duration"] / 1e9,
               "eval_count": r["eval_count"], "eval_s": r["eval_duration"] / 1e9,
               "load_s": r["load_duration"] / 1e9, "thinking_chars": r["thinking_chars"],
               "ps_before": before, "ps_after": after, "time": time.strftime("%H:%M:%S")}
        rows.append(row)
        print(f"round {rnd + 1} prompt {row['prompt_eval_count']:6d} tok "
              f"prefill {row['prompt_eval_s']:7.3f} s ({row['prompt_eval_count'] / row['prompt_eval_s']:7.1f} tok/s) "
              f"| gen {row['eval_count']} tok {row['eval_count'] / row['eval_s']:5.1f} tok/s "
              f"| load {row['load_s']:.2f} s | thinking {row['thinking_chars']} chars", flush=True)
        print("    ps after:", ps_line(after), flush=True)

print("\n# median (min - max) over rounds")
for n in LINES:
    rs = [x for x in rows if x["lines"] == n]
    pe = [x["prompt_eval_s"] for x in rs]
    gen = [x["eval_count"] / x["eval_s"] for x in rs]
    print(f"prompt {statistics.median(x['prompt_eval_count'] for x in rs):6.0f} tok  "
          f"prefill {statistics.median(pe):7.3f} s ({min(pe):.3f}-{max(pe):.3f})  "
          f"gen {statistics.median(gen):5.1f} tok/s ({min(gen):.1f}-{max(gen):.1f})")

json.dump(rows, open(sys.argv[1] if len(sys.argv) > 1 else "prefill.json", "w"), indent=1)
以下は、3 巡の中央値をグラフにしたものです(縦の線は最小から最大の幅)。各回の load_duration は 0.07〜0.16 秒で、途中でモデルが読み込み直された回はありませんでした。
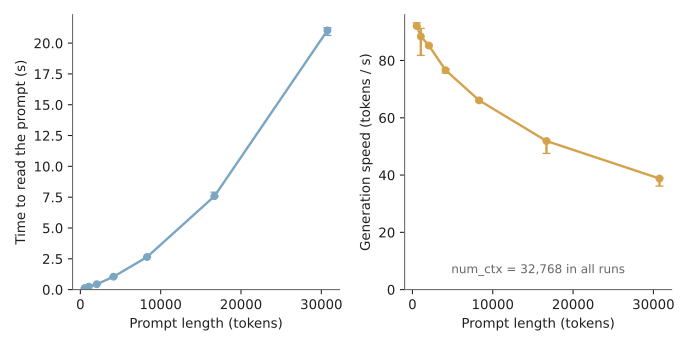
入力の長さと、プロンプトの処理の時間・生成の速さ
3 巡の中央値(括弧内は最小と最大)の出力
各回の値は lab/output_prefill.txt にあります。
# median (min - max) over rounds
prompt    542 tok  prefill   0.122 s (0.120-0.122)  gen  92.0 tok/s (91.9-93.2)
prompt   1047 tok  prefill   0.236 s (0.235-0.276)  gen  88.4 tok/s (81.8-91.2)
prompt   2046 tok  prefill   0.435 s (0.435-0.450)  gen  85.2 tok/s (84.8-85.6)
prompt   4129 tok  prefill   1.048 s (1.035-1.067)  gen  76.6 tok/s (75.6-77.1)
prompt   8305 tok  prefill   2.647 s (2.632-2.666)  gen  66.1 tok/s (65.6-66.5)
prompt  16692 tok  prefill   7.581 s (7.550-7.905)  gen  51.9 tok/s (47.6-52.2)
prompt  30759 tok  prefill  21.030 s (20.626-21.253)  gen  38.8 tok/s (36.2-39.0)
プロンプトの処理の時間は、入力の長さに比例するより速く増えました。1 秒あたりに処理したトークン数は、2,000 トークン前後の約 4,700 から、30,759 トークンでは約 1,460 まで落ちています。注意機構では、各トークンの Q をそれより前の全ての K と比べるので、比べる回数は入力の長さの 2 乗に比例します。入力が短いうちは重みの掛け算が時間の大半を占め、長くなるとこの 2 乗の部分が効いてきます。
生成の速さも、入力が長いほど落ちました。KV キャッシュがあっても、新しい 1 トークンを出すたびに、それまでの全てのトークンの K・V を読む必要があるからです。
30,759 トークンの K・V は 30,759 × 114,688 バイト ≒ 3.5 GB で、q8_0 のファイル(約 2.2 GB)より大きくなります。生成がメモリの読み出しで決まるなら、1 トークンあたりに読む量は約 1.95 GB から約 5.41 GB になり、速さは 2.8 分の 1 程度になる計算です。以下は、この読む量と実測の速さを並べた図です。
1 トークンの生成ごとに読む量と、実測の速さ
図の重みは、量子化のノートと同じく 1 トークンにつき 1 行しか読まない入力の埋め込みを除いた約 1.88 GB です(ログの model weights CPU 315.3 MiB は、この埋め込みの分です)。実測は 92.0 から 38.8(2.4 分の 1)で、見積もりより少し小さい落ち方でした(読み出し以外の要因を分けて測ったわけではないので、ずれの理由は分かっていません)。
実験 3: 同じ前置きの再利用
KV キャッシュは、1 回の生成の中だけでなく、次の要求にも使い回せます。チャットで会話を続ける時や、同じ長い資料に別の質問をする時、要求の先頭の部分(プレフィックス)は前回と同じです。前回の K・V がキャッシュに残っていれば、一致した部分の計算を省けます。K・V はそれより前のトークンにだけ依存するので、使い回せるのは先頭から一致している部分だけです。
これを確かめるために、約 8,300 トークンの前置き(実験 2 と同じ詰め物)に対して、次の 5 通りの送り方を順に試しました。num_ctx は 32,768 で、3 巡しています。
# lab/exp_prefix.py から抜粋(全体は下の折りたたみ)
head = f"Session {uuid.uuid4().hex}\n"
lines = filler(320, seed=10 + rnd).split("\n")
base = head + "\n".join(lines)
mid = len(lines) // 2
changed_mid = head + "\n".join(lines[:mid] + ["Record X: this line was edited."] + lines[mid + 1:])
cases = [
    ("1 first send", base + Q1),
    ("2 same prompt again", base + Q1),
    ("3 same prefix, new question", base + Q2),
    ("4 one line edited in the middle", changed_mid + Q1),
    ("5 one char added at the head", "X" + base + Q1),
]
for label, prompt in cases:
    r = generate(MODEL, prompt, num_ctx=NUM_CTX, num_predict=16)
exp_prefix.py の全体
"""実験 3: 同じプレフィックスを送り直した時に、KV キャッシュが使い回されるかを見る。

Ollama 0.22.1 の prompt_eval_count は、使い回した分も含めた入力の全トークン数を返す。
使い回せたかどうかは、prompt_eval_duration(キャッシュに無かった分を計算した時間)で見る。
"""
import json
import sys
import uuid

from kvlab import filler, generate, ps, ps_line

MODEL = "qwen3:1.7b-q8_0"
NUM_CTX = 32768
Q1 = "\nWhich sensor appears in Record 5? Answer briefly."
Q2 = "\nWhich sensor appears in Record 9? Answer briefly."

rows = []
generate(MODEL, "Say hi.", num_ctx=NUM_CTX, num_predict=1)
for rnd in range(3):
    head = f"Session {uuid.uuid4().hex}\n"
    lines = filler(320, seed=10 + rnd).split("\n")
    base = head + "\n".join(lines)
    mid = len(lines) // 2
    changed_mid = head + "\n".join(lines[:mid] + ["Record X: this line was edited."] + lines[mid + 1:])
    cases = [
        ("1 first send", base + Q1),
        ("2 same prompt again", base + Q1),
        ("3 same prefix, new question", base + Q2),
        ("4 one line edited in the middle", changed_mid + Q1),
        ("5 one char added at the head", "X" + base + Q1),
    ]
    for label, prompt in cases:
        r = generate(MODEL, prompt, num_ctx=NUM_CTX, num_predict=16)
        row = {"round": rnd + 1, "case": label, "prompt_eval_count": r["prompt_eval_count"],
               "prompt_eval_s": r["prompt_eval_duration"] / 1e9, "load_s": r["load_duration"] / 1e9,
               "thinking_chars": r["thinking_chars"], "response": r["response"], "ps": ps()}
        rows.append(row)
        print(f"round {rnd + 1} {label:34s} prompt {row['prompt_eval_count']:5d} tok "
              f"prompt_eval {row['prompt_eval_s']:6.3f} s | load {row['load_s']:.2f} s "
              f"| thinking {row['thinking_chars']} chars | {r['response'].strip()[:40]!r}", flush=True)
    print("    ps:", ps_line(ps()), flush=True)

json.dump(rows, open(sys.argv[1] if len(sys.argv) > 1 else "prefix.json", "w"), indent=1,
          ensure_ascii=False)
以下は 3 巡目の結果です(ps の行は省略。3 巡の全体は lab/output_prefix.txt)。
round 3 1 first send                       prompt  8325 tok prompt_eval  2.604 s | load 0.07 s | thinking 0 chars | 'Sensor S57.'
round 3 2 same prompt again                prompt  8325 tok prompt_eval  0.016 s | load 0.08 s | thinking 0 chars | 'Sensor S57.'
round 3 3 same prefix, new question        prompt  8325 tok prompt_eval  0.033 s | load 0.07 s | thinking 0 chars | 'Sensor S21.'
round 3 4 one line edited in the middle    prompt  8307 tok prompt_eval  1.573 s | load 0.07 s | thinking 0 chars | 'Sensor S57.'
round 3 5 one char added at the head       prompt  8326 tok prompt_eval  2.607 s | load 0.07 s | thinking 0 chars | 'Sensor S57.'
次の図は、3 巡の中央値と、先頭からどこまでキャッシュを使えたかを並べたものです。帯の塗り分けは、送った内容から見た模式です。
5 通りの送り方で、使い回せた範囲と処理の時間
前回と同じ前置きを送った 2 と 3 では、プロンプトの処理が 2.6 秒から 0.016〜0.033 秒に縮みました。3 は質問の 1 文だけが違うので、その分だけを計算しています。
真ん中の 1 行を変えた 4 は約 1.6 秒で、変えた行より前の半分だけが使い回されました。時間が半分より多くかかったのは、後ろの半分のトークンほど比べる相手(前の K)が多いからです。先頭に 1 文字足した 5 は、中身がほとんど同じでも、1 回目と同じ時間がかかりました。
prompt_eval_count は、使い回した回でも入力の全トークン数(8,325 など)を返しました。API のドキュメントでも、prompt_eval_count は入力のトークン数、prompt_eval_duration はキャッシュに無かった分を処理した時間とされています。Ollama 0.22.1 の応答には、キャッシュから読んだトークン数のフィールドがありません(api/types.go)。
そのため、0.22.1 でキャッシュが効いたかを見る時は、prompt_eval_count ではなく prompt_eval_duration を見る必要があります。2026 年 11 月時点の API のドキュメントには、キャッシュから読んだ数を返す prompt_eval_cached_count が載っており、このフィールドを返すバージョンなら、その値で確かめられます。
この結果から、長い前置きを持つプロンプトでは、毎回変わる値(日時、要求ごとの ID など)を先頭に置かず、変わらない部分を前に、変わる部分を後ろに置くのが良いことが分かります。
なお、実験のサーバーは同時に処理する要求の数(OLLAMA_NUM_PARALLEL)が既定の 1 で、KV キャッシュの枠も 1 組だけです。そのため、別の要求が間に入ると、前回の K・V は残らない筈です(本記事では確かめていません)。並列数を増やすと、その数だけ枠を確保するのでメモリも増えます。
コンテキスト長を超えた入力
Ollama 0.22.1 では、num_ctx より長い入力を送ると、エラーを返さずに入力を切り詰めます。先頭に合言葉を置いた約 3,100 トークンの入力で、最後に合言葉を尋ねると、次のようになりました。
# lab/exp_truncate.py から抜粋(全体は下の折りたたみ)
PROMPT = ("The secret code is BLUE-FALCON-42. Remember it.\n" + filler(120, seed=7) +
          "\nWhat is the secret code given at the very beginning? Answer with the code only.")
for ctx in (2048, 8192):
    r = generate(MODEL, PROMPT, num_ctx=ctx, num_predict=32)
exp_truncate.py の全体
"""実験 4: 入力が num_ctx を超えた時に何が起きるか。

先頭に合言葉を置き、約 3,000 トークンの詰め物の後で合言葉を尋ねる。
num_ctx 2048(足りない)と 8192(足りる)で比べる。
"""
import json
import subprocess
import sys

from kvlab import LOG_UNIT, filler, generate, ps, ps_line

MODEL = "qwen3:1.7b-q8_0"
PROMPT = ("The secret code is BLUE-FALCON-42. Remember it.\n" + filler(120, seed=7) +
          "\nWhat is the secret code given at the very beginning? Answer with the code only.")

rows = []
for ctx in (2048, 8192):
    print(f"## num_ctx={ctx}  ps before: {ps_line(ps())}", flush=True)
    # 送る直前のログの位置(cursor)を覚え、その後に出た行だけを見る
    cur = subprocess.run(["journalctl", "--user", "-u", LOG_UNIT, "-n", "0", "--show-cursor"],
                         capture_output=True, text=True).stdout.split("cursor: ")[-1].strip()
    try:
        r = generate(MODEL, PROMPT, num_ctx=ctx, num_predict=32)
        row = {"num_ctx": ctx, "prompt_eval_count": r["prompt_eval_count"],
               "done_reason": r.get("done_reason"), "thinking_chars": r["thinking_chars"],
               "response": r["response"]}
    except Exception as e:  # エラーで返る版もあるので、その時は本文を記録する
        body = e.read().decode() if hasattr(e, "read") else str(e)
        row = {"num_ctx": ctx, "error": body}
    # サーバーのログに切り詰めの警告が出たかを見る
    log = subprocess.run(["journalctl", "--user", "-u", LOG_UNIT, f"--after-cursor={cur}",
                          "--no-pager", "-o", "cat"], capture_output=True, text=True).stdout
    row["server_log"] = [ln.split("source=")[1] for ln in log.splitlines()
                         if "truncating input prompt" in ln]
    rows.append(row)
    print(json.dumps(row, ensure_ascii=False), flush=True)
    print(f"   ps after: {ps_line(ps())}", flush=True)

json.dump(rows, open(sys.argv[1] if len(sys.argv) > 1 else "truncate.json", "w"), indent=1,
          ensure_ascii=False)
以下が実行結果です(ps の行は省略。全体は lab/output_truncate.txt)。
{"num_ctx": 2048, "prompt_eval_count": 2048, "done_reason": "stop", "thinking_chars": 0, "response": "1234567890", "server_log": ["runner.go:187 msg=\"truncating input prompt\" limit=2048 prompt=3084 keep=4 new=2048"]}
{"num_ctx": 8192, "prompt_eval_count": 3084, "done_reason": "stop", "thinking_chars": 0, "response": "BLUE-FALCON-42", "server_log": []}
num_ctx 2,048 では、応答は done_reason: stop の正常な終わり方で、答えは合言葉ではなく 1234567890 でした。サーバーのログには truncating input prompt limit=2048 prompt=3084 keep=4 new=2048 という警告が出ています。
入力 3,084 トークンのうち、先頭の 4 トークン(keep=4)を残して、その後ろから古い部分が捨てられ、合言葉の文はモデルに届いていません。API の応答で気付ける手がかりは、prompt_eval_count が num_ctx と同じ 2,048 になっていることだけです。num_ctx 8,192 では、同じ入力で BLUE-FALCON-42 と答えました。
長い資料や長い会話を渡す時は、入力のトークン数と num_ctx を比べてから送るか、応答の prompt_eval_count が num_ctx に張り付いていないかを確かめる必要があります。
KV キャッシュを小さくする方法
ここまでの通り、KV キャッシュはトークン数に比例して大きくなり、長い入力では生成も遅くします。小さくする方法は、式のどの項を減らすかで分けられます。
| 減らす項 | 方法 | 代わりに失うもの |
|---|---|---|
| KV ヘッドの数 | GQA、全ての Q ヘッドで 1 組の K・V を共有する MQA(Multi-Query Attention) | モデルの構造で決まるので、使う側では変えられない。共有するほど精度が落ちやすい |
| 1 個のバイト数 | KV キャッシュの量子化。Ollama ではサーバーの環境変数 OLLAMA_KV_CACHE_TYPE に q8_0(f16 の約半分)や q4_0(約 4 分の 1)を指定する | 精度が少し落ちる。Ollama ではサーバー全体の設定で、Flash Attention が有効な時だけ使える |
| トークン数 | num_ctx を必要な長さに絞る | 超えた入力は切り詰められる |
GQA と MQA はモデルを作る側の選択で、Qwen3 は GQA を採っています。使う側で選べるのは、下の 2 行です。
Ollama の FAQ(よくある質問のページ。2026 年 11 月時点)には、OLLAMA_KV_CACHE_TYPE の既定値は f16 で、指定すると全てのモデルに効くと書かれています。本記事の実験では、他の作業と共有しているサーバーの設定を変えられないので、KV キャッシュの量子化は試していません。
入力のトークン数そのものを減らすには、文書の全体ではなく質問に近い断片だけを渡す方法があります。この方法は RAG のノートで説明しています。
KV キャッシュの置き方を変えて無駄を減らす方法もあります。Ollama 0.22.1 は num_ctx 個の枠を先に確保しますが、vLLM の PagedAttention は、KV キャッシュを固定長のブロックに分け、使った分だけブロックを割り当てます。多数の要求を同時に処理するサーバーで、空きの枠に使われないメモリを減らすための方式です。
利点と欠点
KV キャッシュの利点は、過去のトークンの K・V を一度だけ計算すればよいことです。生成の 1 ステップで計算するのは新しいトークンの分だけになり、同じ前置きを送り直した時も、実験 3 の通りプロンプトの処理をほぼ省けます。
一方で、次の欠点と注意点があります。
- メモリはトークン数に比例して増えます。Qwen3-1.7B では 1 トークン 112 KiB で、上限の 40,960 トークンでは KV キャッシュ(4.4 GiB)が q8_0 の重み(約 2.1 GiB)の 2 倍になりました。重みを量子化しても、この部分は小さくなりません。
- Ollama 0.22.1 は num_ctx 個の枠を読み込み時に確保します。num_ctx を指定しないと、GPU のメモリが多い環境ではモデルの上限で読み込まれ、短い質問でもその分のメモリを使います。
- 入力が長いほど、最初のトークンまでの時間と生成の 1 トークンあたりの時間が延びます。実験 2 では、約 30,800 トークンの入力で、プロンプトの処理に 21 秒かかり、生成は 2.4 分の 1 の速さになりました。
- Ollama 0.22.1 では、num_ctx を超えた入力はエラーにならずに切り詰められます。
num_ctx は、大きくするほど長い入力を扱える代わりに、メモリと速さで払う設定です。実験の数字は 1.7B のモデル 1 つと、他の作業と共有した 1 台の GPU での値なので、手元のモデルでは /api/ps の size とサーバーのログの kv cache を見て確かめてください。