再試行(retry)は、失敗した要求を同じ内容でもう一度送る処理です。HTTP や gRPC のクライアント、クラウドの SDK、メッセージの配送は、一時的な失敗を再試行で隠しています。バックオフ(backoff)は再試行の前に待つ時間のことで、失敗のたびに待ち時間を倍にしていく形を指数バックオフ(exponential backoff)、その待ち時間を乱数でばらつかせることをジッター(jitter)と呼びます。
再試行は、サーバーの調子が悪い時ほど回数が増えます。同じ時刻に失敗した大勢のクライアントが同じ間隔で送り直すと、起動し直したばかりのサーバーに要求の山が繰り返し届き、そのたびにサーバーが再び落ちます。
以下は、1,000 のクライアントが同時に失敗した後に、サーバーへ届いた要求の数をシミュレーションで数えた結果です。サーバーは最初の 1 s は起動中で全て失敗し、その後は毎秒 500 件まで処理でき、到着が多すぎると落ちて 1 s 止まると仮定しています(縦軸は 100 ms ごとの集計)。
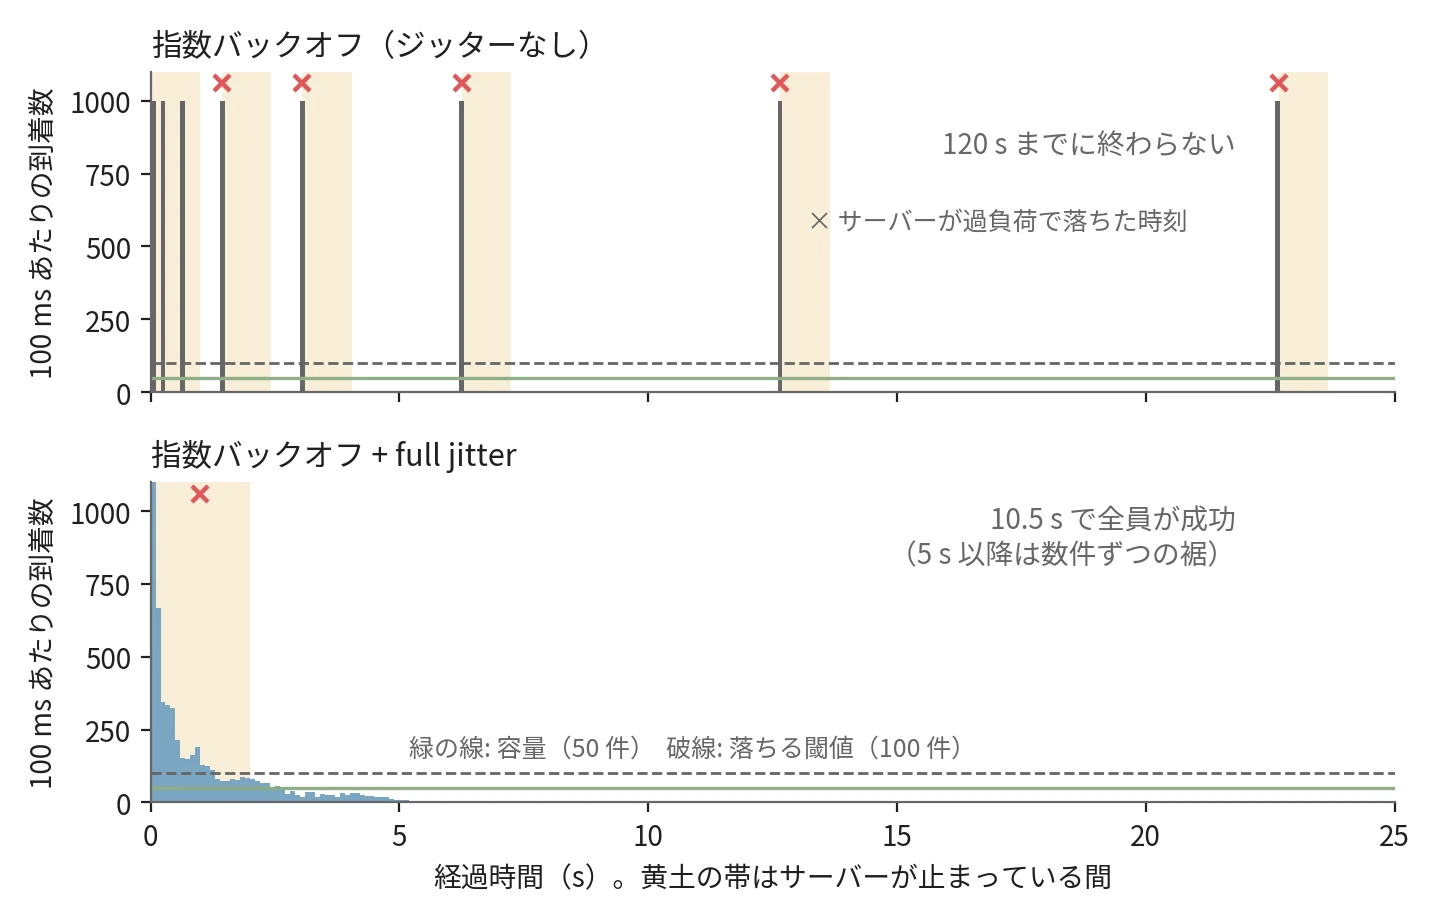
同時に失敗した 1,000 件の到着数(seed 0)。上はジッターなし、下は full jitter
上段は待ち時間を倍にしているだけなので、1,000 件が 1 本の棒に揃ったまま戻ってきます。下段は同じ指数バックオフの待ち時間を乱数で散らした full jitter(後で式を示します)で、山が容量の線の近くまで均されました。
本記事では、再試行で障害が長引く理由と、待ち時間・回数・予算の 3 つで再試行を抑える方法について、Python のシミュレーションの結果とともに説明します。扱う疑問は次の通りです。
- 再試行は、なぜ回復しかけたサーバーを再び落とすのか。
- 指数バックオフとジッターの式は、それぞれ何を変えるのか。
- どの失敗なら再試行してよいのか。
- 回数の上限と再試行の予算(retry budget)は、何を守るのか。
- Circuit Breaker と再試行は、どう組み合わせるのか。
同じ要求を 2 回処理しても結果を 1 回分に保つ仕組みは Idempotency で説明しており、本記事では送る側の時間と量の話をします。
再試行で障害が長引く理由
再試行は、失敗が一時的なものなら、利用者に失敗を見せずに済む安価な方法です。ネットワークの瞬断や、サーバーの入れ替えの間に届いた要求は、少し待てば成功します。
一方で、AWS の Timeouts, retries, and backoff with jitter(Amazon Builders’ Library)は、再試行を「selfish」(利己的)と書いています。クライアントが再試行すると、そのクライアントのためにサーバーの時間をさらに使うからです。失敗の原因が過負荷なら、再試行は負荷を増やし、過負荷を悪化させます。
上記に加えて、問題を大きくするのは再試行の時刻が揃うことです。例えば、サーバーが落ちた瞬間に処理中だった 1,000 件は、同じ時刻に失敗を受け取ります。全員が「1 秒後に再試行」と決めていれば、1 秒後に 1,000 件が同時に届きます。サーバーが起動し直した直後で容量が足りなければ、その山で再び落ち、全員がまた同じ時刻に失敗します。
このように、大勢のクライアントが同じ時刻に一斉に押し寄せる現象は thundering herd と呼ばれます。Google の SRE 本の Addressing Cascading Failures も、再試行の時刻が待ち時間の幅の中に散っていないと、ネットワークの小さな揺れのような乱れで再試行が同じ時刻に集まり、さらに増幅し合うことがあると書き、乱数を入れた指数バックオフを常に使うよう勧めています。
待ち時間を伸ばして散らす
指数バックオフは、失敗の回数 n に対して、待ち時間を base × 2^n のように倍々で伸ばします。待ち時間が際限なく伸びないように、上限(cap)で頭を打たせる形が一般的です。
ジッターの入れ方は、AWS の Marc Brooker 氏の記事 Exponential Backoff And Jitter(2015 年)が 3 通りを比べています。以下は、本記事の実験用に書いた lab/herd.py の抜粋です。式は、Brooker 氏の記事で使われたシミュレーターの公開コードと同じです。n は失敗の回数(1 回目の失敗の後は n = 1 なので、最初の待ちは 0.2 s)、BASE は 0.1 s、CAP は 10 s です。
def expo(n):                                  # ジッターなしの指数バックオフ
    return min(CAP, BASE * 2 ** n)


class FullJitter:                             # 0 から expo(n) までの一様乱数
    def wait(self, n, rng):
        return rng.uniform(0, expo(n))


class EqualJitter:                            # 半分は必ず待ち、残り半分を乱数にする
    def wait(self, n, rng):
        v = expo(n)
        return v / 2 + rng.uniform(0, v / 2)


class Decorrelated:                           # 前回の待ち時間の 3 倍までの乱数
    def __init__(self):
        self.sleep = BASE

    def wait(self, n, rng):
        self.sleep = min(CAP, rng.uniform(BASE, self.sleep * 3))
        return self.sleep
以下は、3 つの式で 40 のクライアントが引いた待ち時間を失敗の回数ごとに並べた図です。破線がジッターなしの値です。
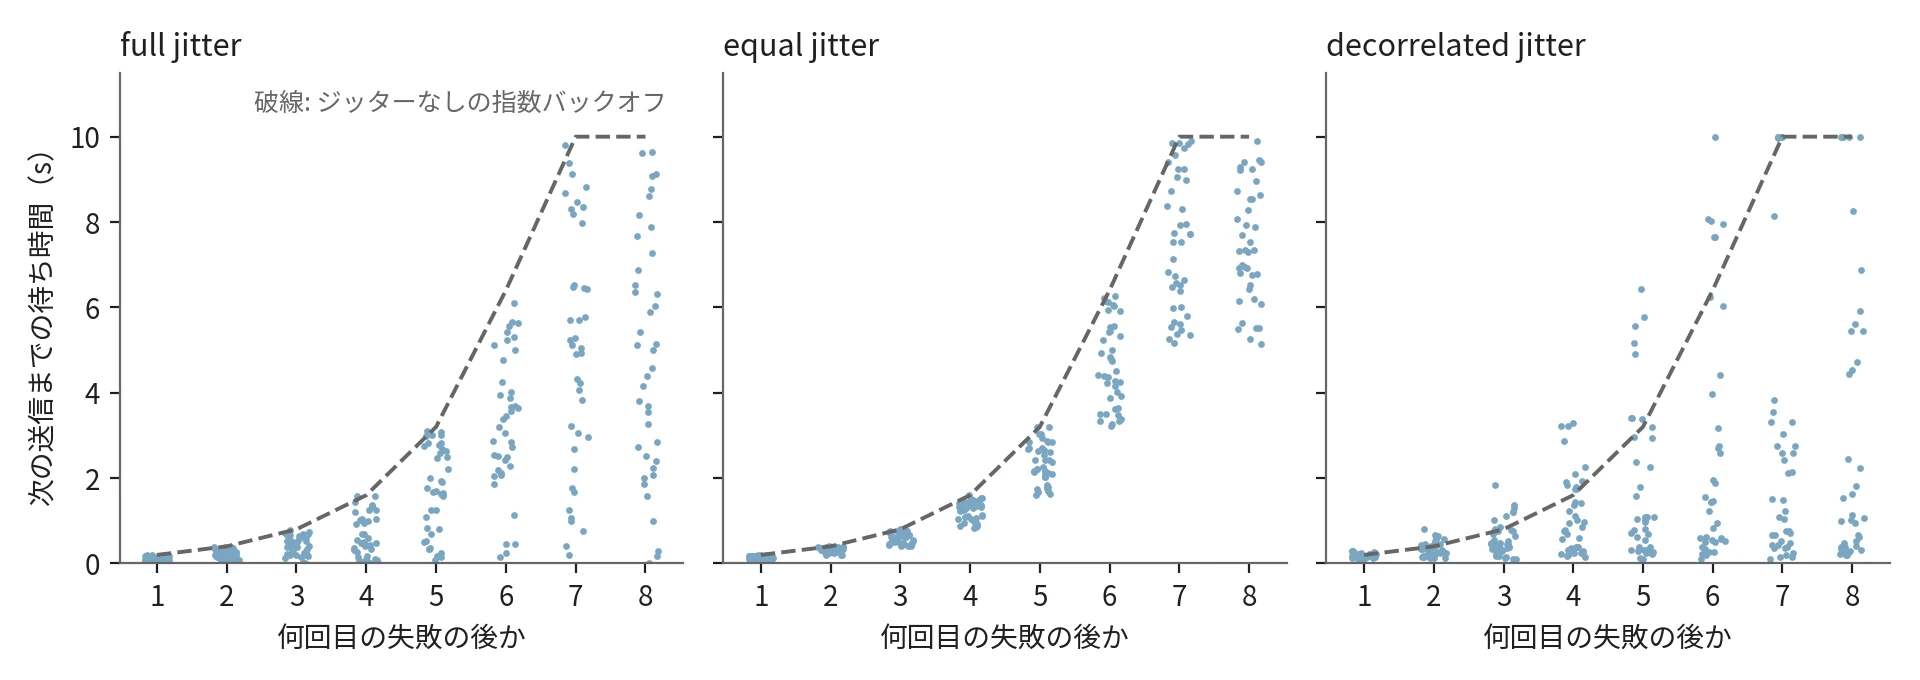
失敗の回数ごとの待ち時間(40 クライアント分)
full jitter は、待ち時間を 0 からその回の指数バックオフの値(破線)までに散らすので、短い待ちも出ます。equal jitter は、その回の指数バックオフの値の半分は必ず待つので、待ちの最小値が保たれます。decorrelated jitter は、失敗の回数ではなく前回に引いた値から次の範囲を決めるので、同じ回数でもクライアントごとの待ち時間の幅が広くなります。
Brooker 氏の記事は、楽観的な排他制御で 1 つの値を奪い合うクライアントのシミュレーションで、full jitter が仕事量(呼び出しの数)が最も少なく、equal jitter は時間も仕事量も劣ると結論しています。どれも、ジッターなしよりは仕事量と時間の両方が減りました。
gRPC の再試行の仕様(gRPC の設計提案の文書 gRFC A6)は、別の形のジッターを使います。こちらは n を再試行の回数で数え、n 回目の再試行は min(initialBackoff × backoffMultiplier^(n-1), maxBackoff) × random(0.8, 1.2) の後に送ります。指数バックオフの値の前後 20% に散らす形で、大勢のクライアントが同時にサーバーを叩かないためと説明されています。
落ちたサーバーに 1,000 件が戻る実験
ジッターの有無で負荷の山と回復までの時間がどれだけ変わるかは、Python の標準ライブラリだけで書いたシミュレーションで数えました(版と機材は lab/README.md に記録)。条件は次の通りです。
| 項目 | 値 |
|---|---|
| クライアント | 1,000。全員が t = 0 に 1 回ずつ要求を送る |
| サーバーの容量 | 10 ms あたり 5 件(毎秒 500 件)。超えた分は無作為に選んで失敗を返す |
| 最初の停止 | t = 0〜1 s は起動中で、全ての要求に失敗を返す |
| 過負荷での停止 | 直近 100 ms の到着が容量の 2 倍(100 件)を超えると落ち、1 s 止まる |
| 再試行 | 回数の上限なし。全員が成功するか 120 s で打ち切る |
| 方式 | 即時(次の 10 ms)、固定 1 s、指数(0.1 s × 2^n、上限 10 s)、指数に 3 種のジッター |
過負荷で落ちる条件は、到着が容量を大きく超えるとサーバーが応答できなくなる様子を単純にした仮定です。実際のサーバーでは、落ちる代わりに応答が遅れて timeout が増えるなど、壊れ方はさまざまです。
以下は、10 ms ごとの処理の抜粋です。CAPACITY は 10 ms あたりの容量の 5 件、recent は直近 100 ms(WINDOW = 10 回分)の到着数、CRASH_LIMIT は落ちる閾値の 100 件、RESTART は止まっている 1 s です。
for t in range(ticks):
    batch = schedule[t]                        # この 10 ms に届く要求
    recent[t % WINDOW] = len(batch)
    if t >= down_until and sum(recent) > CRASH_LIMIT:
        down_until = t + int(RESTART / TICK)   # 過負荷で落ちる
    if t < down_until:
        ok = set()                             # 止まっている間は全て失敗
    else:
        ok = set(rng.sample(batch, min(CAPACITY, len(batch))))
    for c in batch:
        if c in ok:
            done += 1
            continue
        failures[c] += 1
        w = policies[c].wait(failures[c], rng)  # 方式ごとの待ち時間
        schedule[t + 1 + int(round(w / TICK))].append(c)
乱数の seed を 0〜19 に固定して 20 回ずつ走らせた結果が、次の出力です(全体は lab/herd_output.txt)。
$ python3 herd.py herd.json
strategy        finish s (mean, min-max)     requests (mean, min-max)  crashes
immediate        120.00 (120.00-120.00)    12000000 (12000000-12000000)    119.0 (20 unfinished)
fixed 1s         120.00 (120.00-120.00)      119000 (119000-119000)    118.0 (20 unfinished)
exponential      120.00 (120.00-120.00)       17000 ( 17000- 17000)     14.0 (20 unfinished)
full jitter       12.03 (  9.97- 14.10)        6148 (  6046-  6571)      1.1
equal jitter      11.99 ( 11.39- 18.75)        6138 (  6084-  6182)      2.0
decorrelated      12.86 ( 10.41- 15.20)        8151 (  7404-  8500)      2.9
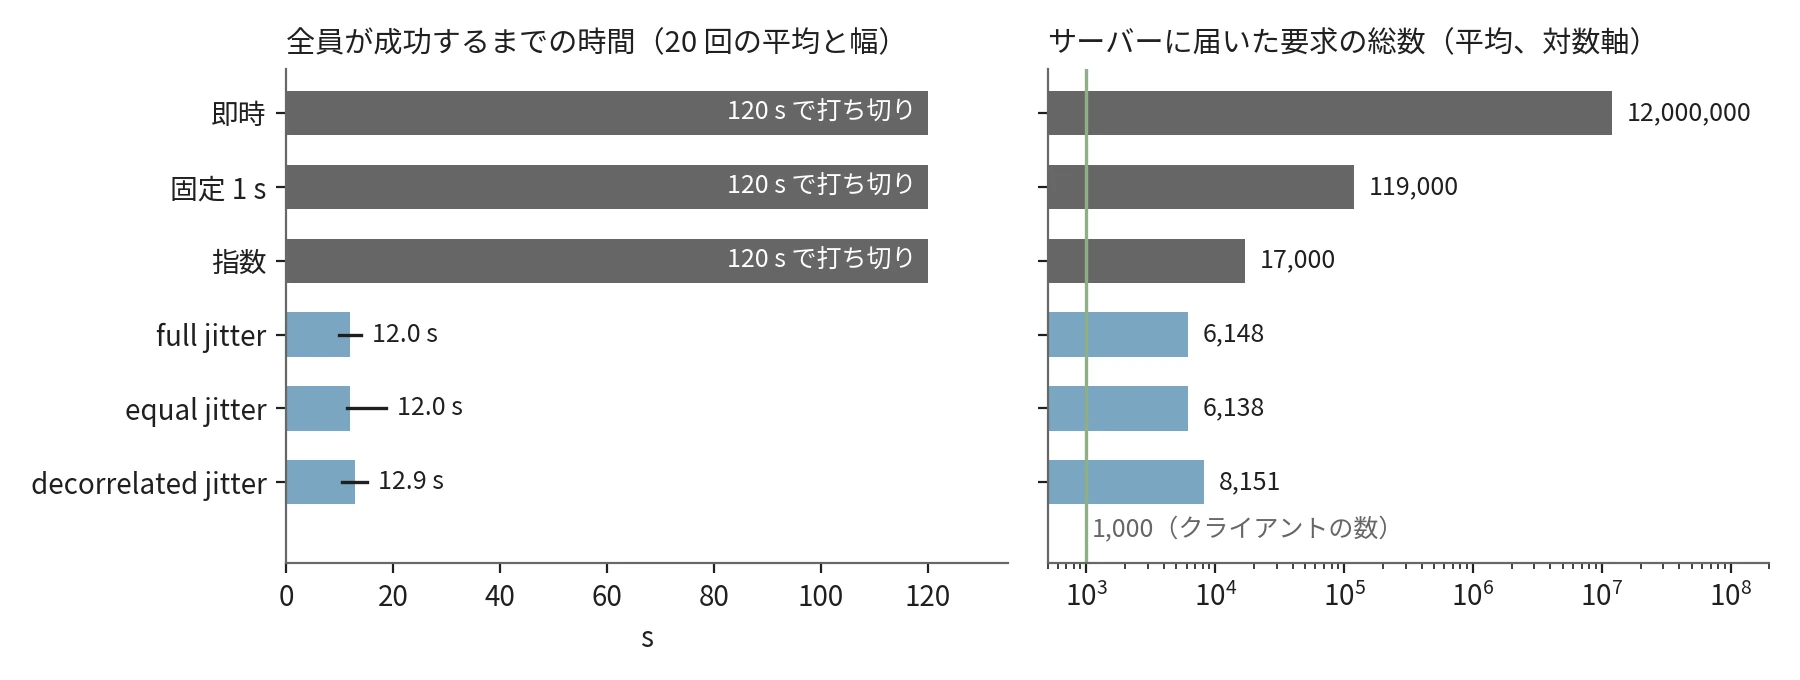
方式ごとの、全員が成功するまでの時間と要求の総数(seed 0〜19)
ジッターの無い 3 つは、20 回のどれも 120 s までに終わりませんでした(打ち切りの時刻を 120 s として平均しています)。即時は 10 ms ごとに 1,000 件が届き続け、固定 1 s は起動し直すたびに 1,000 件が同時に届き、どちらも毎秒落ち続けています。ジッターなしの指数バックオフは、待ち時間が伸びて落ちる間隔は空きましたが、1,000 件は最後まで同じ 10 ms に揃ったままで、上限の 10 s ごとに落ちました。待ち時間に乱数を使わないので、どの seed でも同じ数字でした。
ジッターを入れた 3 つは、約 10〜19 s で全員が成功しました。落ちた回数は、20 回の平均で full jitter が 1.1 回、equal jitter が 2.0 回、decorrelated jitter が 2.9 回です。どれも起動の直後に 1 回は落ちています。最初の数回の再試行は待ち時間が短いので、止まっていた 1 s の間に失敗した要求が、起動の直後に集まるからです。それ以降は、到着が容量の近くに均されます。
最初の送信を 0〜0.9 s に散らした条件(lab/herd_spread_output.txt)でも、ジッターなしの指数バックオフは終わりませんでした。固定 1 s は平均 16.89 s(下の図の seed 0 では 16.2 s)で終わったものの、その間に平均 11.7 回落ちています。最初の時刻が多少ずれていても、送り直す間隔が全員で同じなら、ずれは広がりません。以下は、この条件の seed 0 での到着数です。
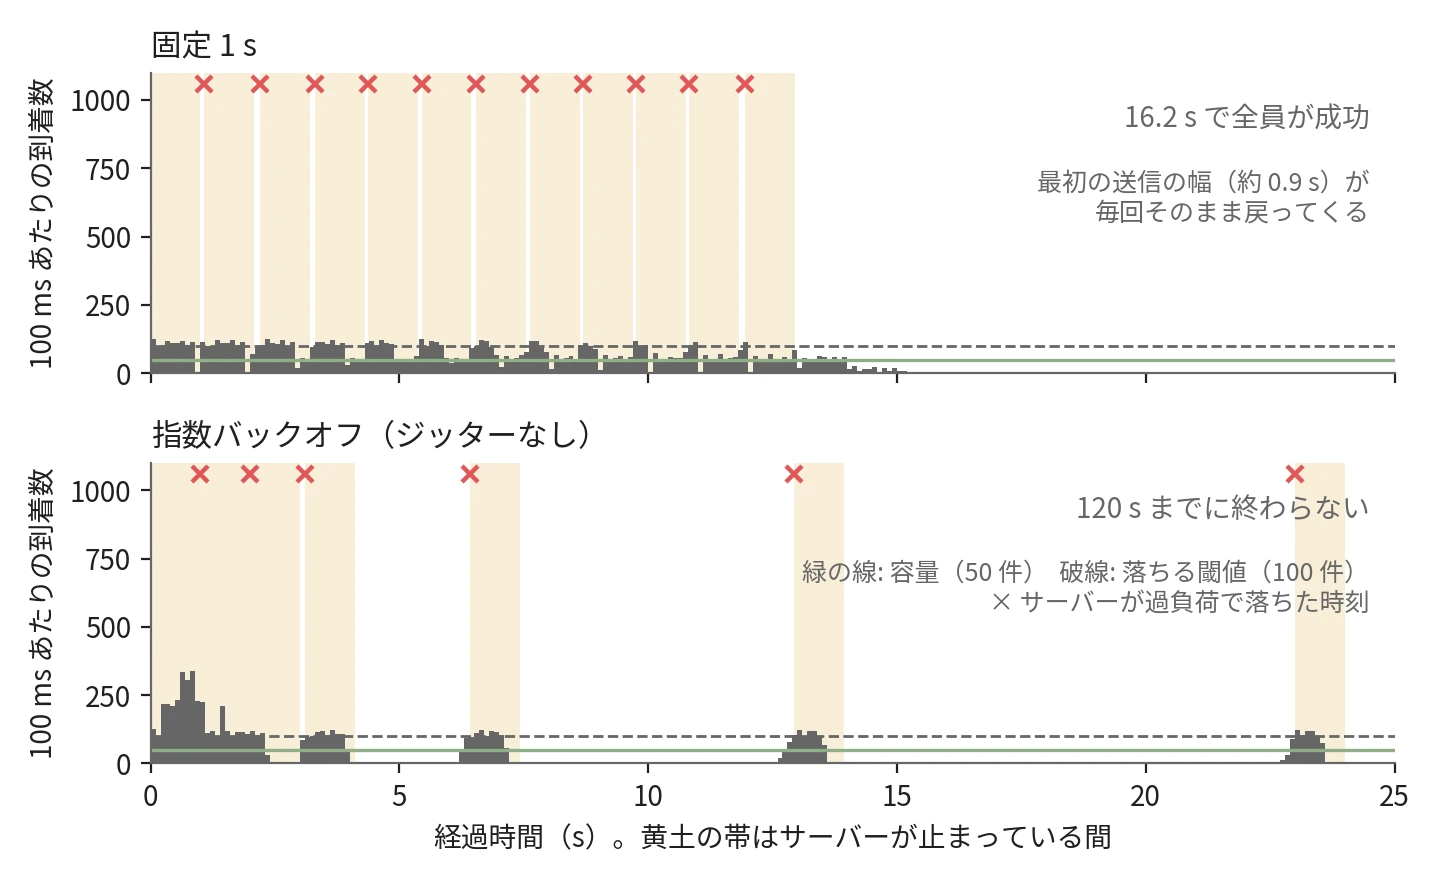
最初の送信を 0〜0.9 s に散らした時の到着数(seed 0)
どちらも、最初の 0.9 s の幅のかたまりが、形を保ったまま戻ってきます。固定 1 s が最後に終わるのは、毎回少しずつ成功してかたまりが縮み、13 s ごろに落ちる閾値を下回ったからです。ジッターは、戻ってくるたびにこの幅を広げる役割を持ちます。
3 種のジッターの差は、この実験では小さく出ました。decorrelated jitter だけは要求の総数が 3 割ほど多く、短い待ちを引き続けるクライアントが残るためと考えられます。Brooker 氏の記事で equal jitter が最も遅かったのとは違う結果で、仮定(奪い合いか、容量か)が変われば順位も変わります。
再試行してよい失敗
再試行してよいのは、時間が経てば成功し得る失敗だけです。Amazon Builders’ Library の記事は、クライアントのエラーは同じ要求のままでは後でも成功しないので再試行せず、サーバーのエラーは次の試行で成功し得る、と分けています。HTTP なら、400 番台の多く(不正な要求・権限が無い)は再試行しても結果が変わりません。
例外は、サーバーが「後でなら受け付ける」と伝える応答です。503 Service Unavailable と 429 Too Many Requests(レート制限で断られた時)は、Retry-After ヘッダーで待つ秒数を返せます。この値があれば、自分のバックオフより優先するのが一般的です。
gRPC は、再試行してよい状態コードを retryableStatusCodes で列挙させます。以下は、gRFC A6 の例です。
"retryPolicy": {
  "maxAttempts": 4,
  "initialBackoff": "0.1s",
  "maxBackoff": "1s",
  "backoffMultiplier": 2,
  "retryableStatusCodes": ["UNAVAILABLE"]
}
gRPC の状態コードの説明では、UNAVAILABLE は一時的な状態で、バックオフ付きの再試行で直る可能性が高いとされています。一方で、INVALID_ARGUMENT のような要求自体の誤りは、何度送っても失敗します。
もう 1 つの条件は、要求の副作用です。timeout は「処理されなかった」ことを意味しません。サーバーが処理を終えた後に応答だけが失われた要求を再試行すると、課金や注文が 2 回作られます。
Amazon Builders’ Library の記事は、副作用のある API は冪等性(idempotency、同じ要求を何度処理しても結果が 1 回分になる性質)を備えない限り再試行して安全ではない、としています。gRFC A6 も、INTERNAL で失敗した削除の要求は既に削除が済んでいる可能性があり、冪等なメソッドでなければ再試行しないよう求めています。再試行する側は、Idempotency の冪等キーのように、同じ要求だとサーバーが見分けられる形で送ります。
回数の上限と再試行の予算
待ち時間を散らしても、下流が長く止まっていれば、再試行の分だけ負荷は増えます。そのため、再試行は回数でも抑えます。
1 つ目は、1 件の要求あたりの回数の上限です。SRE 本の Handling Overload は、1 要求あたり最大 3 回の試行を上限にし、3 回とも過負荷で断られたら呼び出し元に失敗を返す例を挙げています。gRPC の maxAttempts は最初の送信を含む試行の回数で、仕様では 5 より大きい値は 5 として扱われます。
1 件ごとの上限は、呼び出しが多段になると掛け算になります。以下は、frontend → backend → db の 3 段の呼び出しで、frontend を呼ぶ側・frontend・backend の 3 か所がそれぞれ合計 3 回まで試し、db が失敗し続けた時に、各段に届いた呼び出しの回数です(lab/layers.py)。
$ python3 layers.py
{'frontend': 3, 'backend': 9, 'db': 27}
ユーザーの 1 回の操作が、db には 27 回届きます。段の数を増やした時の増え方は Backpressure の「タイムアウトと再試行による増幅」で計算しています。Amazon Builders’ Library の記事は、安価な操作では再試行をスタックの 1 か所だけで行うことを勧めています。
2 つ目は、再試行の予算です。1 件ごとの上限では、全ての要求が失敗している時に、負荷が最大の試行回数と同じ倍率まで増えます(後の実験と同じ gRFC A6 の例の最大 4 回なら 4 倍)。予算は、クライアント全体で再試行の量を正常時の要求の一定の割合に抑えます。
SRE 本は、クライアントごとに送った要求のうち再試行の割合が 10% 未満の間だけ再試行する方式を挙げています。Amazon Builders’ Library の記事も、トークンバケットで再試行を手元で制限する仕組みを 2016 年に AWS SDK に入れたと書いています。
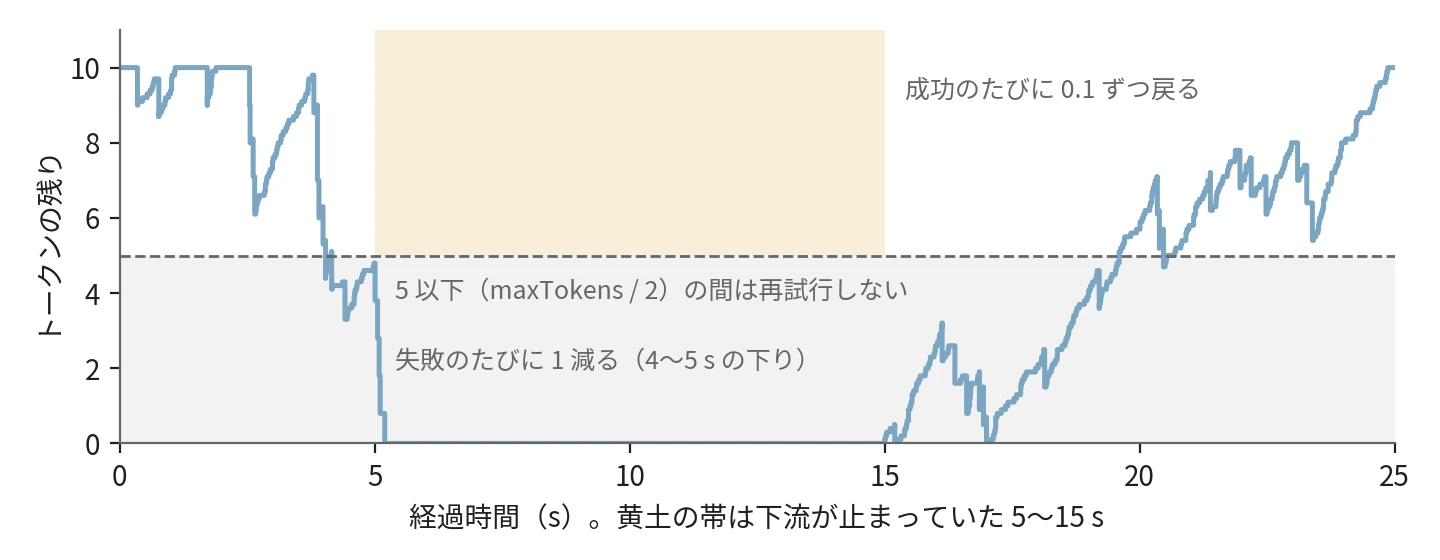
gRPC の retryThrottling は、この考え方をトークンで実装したものです。サーバー名ごとに maxTokens(例では 10)から始め、再試行の対象のコードで失敗するか pushback(サーバーからの再試行の指示)を受けるたびに 1 を引き、成功のたびに tokenRatio(例では 0.1)を足します。トークンが maxTokens / 2 以下の間は再試行しません。
以下は、後で説明する実験(10 のクライアント、下流が 5〜15 s 止まる条件)の 1 クライアント分のトークンの動きです。
gRPC の retryThrottling での、1 つのクライアントのトークンの残り(seed 0)
トークンが 5 以下の間は再試行しないので、止まっている 5〜15 s の再試行は 0 件です。15〜17 s に一度戻りかけて 0 に落ちたのは、止まっていた間にたまった要求が直後に集まり、また断られたためです。止まる前にも、要求が瞬間的に集まって容量を超えた分は断られるので、トークンは上下しています。止まった原因が直った後も、成功で 0.1 ずつしか戻らないので、再試行が戻るのは 4 秒ほど後です。
予算で負荷がどれだけ変わるかは、lab/budget.py で数えました。10 のクライアントが合計で毎秒約 300 件の新しい要求を送り、サーバー(容量と落ちる条件は前の実験と同じ)が t = 5〜15 s の間止まる条件です。再試行は gRFC A6 の例の retryPolicy(最大 4 回の試行、maxAttempts 4)に従い、予算の有無だけを変えました。
新しい要求はポアソン到着で、失敗は全て再試行の対象として数えます(gRFC A6 で数えるのは、再試行の対象のコードか pushback だけです)。トークンと再試行の割合はクライアントのプロセスごとに持ち、10% の方式は直近 1 s の送信で割合を数えます。元に戻った時刻は、停止の終わり以降で、成功が新しい要求の 9 割以上の状態が 3 秒続いた最初の秒です。戻らなければ 40 s で打ち切ります。
$ python3 budget.py
policy                          load during outage  crashes after  back to normal at
no retry                           1.00x (1.00-1.00)        0.0       15.0 s (15-15)
4 attempts                         3.89x (3.87-3.90)       25.0       40.0 s (40-40)
4 attempts + gRPC throttling       1.01x (1.01-1.01)        0.0       15.0 s (15-15)
4 attempts + 10% retry ratio       1.25x (1.23-1.26)        0.0       15.0 s (15-15)
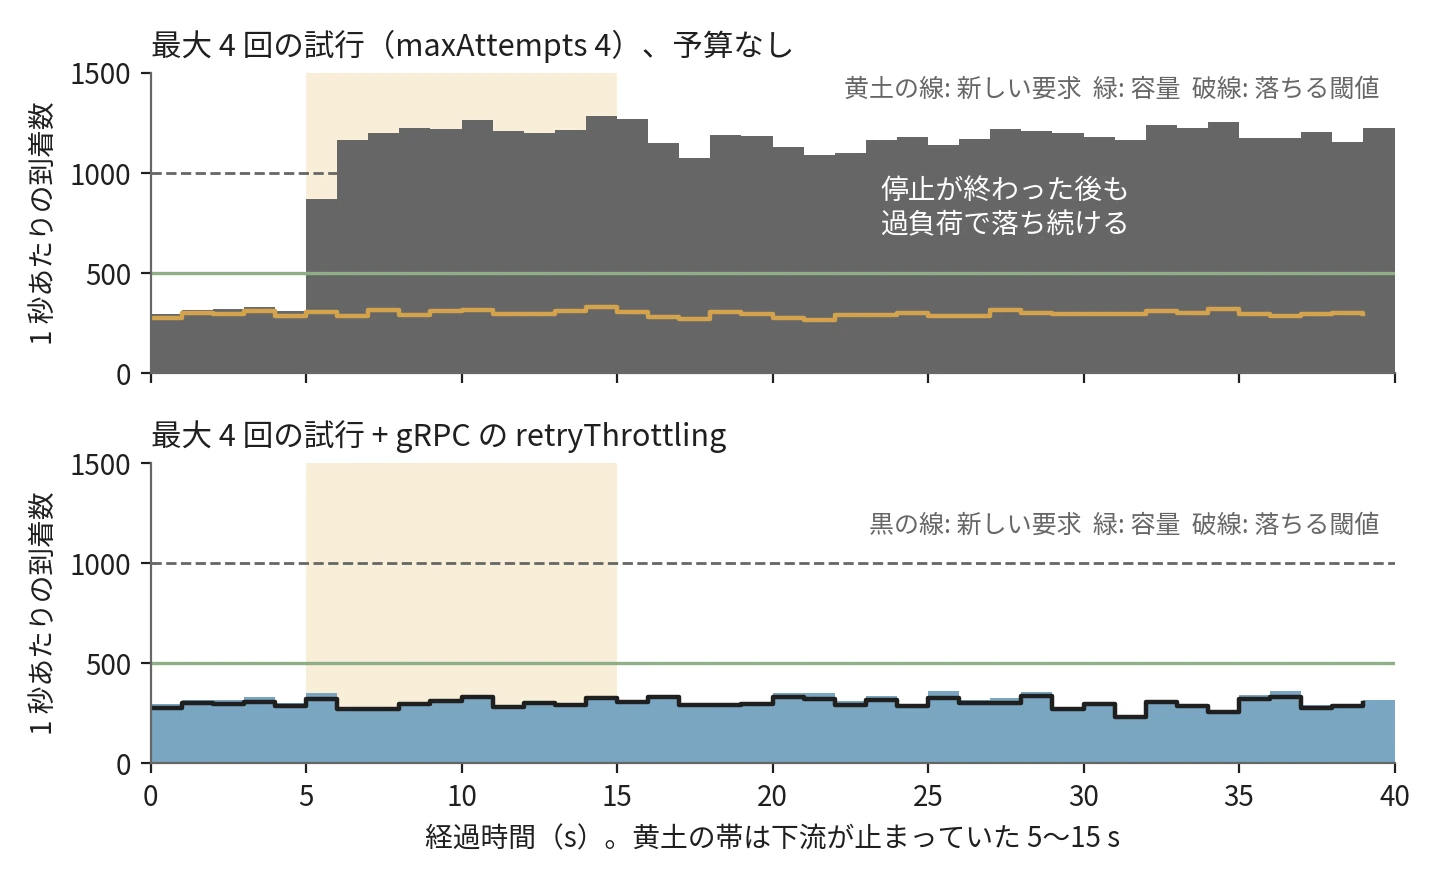
下流が 5〜15 s 止まった時の 1 秒ごとの到着数(seed 0)
予算なしでは、止まっている間の到着が新しい要求の 3.89 倍になりました。毎秒約 1,200 件は落ちる閾値(毎秒 1,000 件)を超えるので、15 s に止まった原因が直っても、再試行の山で落ち続け、打ち切りの 40 s まで戻りませんでした。原因が消えた後も、再試行が作る負荷だけで障害が続く状態です。
gRPC の retryThrottling では、クライアントごとに多くても 5 回失敗した時点でトークンが 5 以下になり、それ以降は再試行しなくなります。到着は 1.01 倍に収まり、15 s で元に戻りました。
再試行の割合を 10% に抑える方式は 1.25 倍でした。到着に占める再試行は約 20% と、10% の倍になりました。本記事の実装は、失敗した時点で割合を見て再試行を決めます。待ち時間の間はまだ送っていないので割合に数えられず、その間に別の失敗が再試行を決めるため、割合を超えて送ってしまいます。
Circuit Breaker との組み合わせ
Circuit Breaker は、失敗が続く下流への呼び出しを一定時間止め、すぐに失敗を返す仕組みです。再試行の予算と同じく、下流が止まっている間の負荷を減らします。
Amazon Builders’ Library の記事は、ブレーカーはシステムにテストしにくい動作の切り替え(モード)を持ち込み、回復までの時間を延ばすことがあるとして、代わりにトークンバケットで再試行を制限すると書いています。予算が絞るのは再試行だけで、最初の 1 回の送信は通します。ブレーカーは、Open(呼び出しを止めている状態)の間は最初の 1 回も止めます。
組み合わせる時は、再試行をブレーカーの外側に置き(再試行の処理がブレーカーを通して呼び出す形)、ブレーカーに断られた呼び出しは再試行しません。断られた呼び出しをやり直しても、すぐに失敗が返るだけだからです。外側と内側で何が変わるかは、Circuit Breaker のノートの「Timeout と Retry との組み合わせ」で実験しています。
利点
- 瞬断や入れ替えのような一時的な失敗が、利用者に見えずに済む
- 指数バックオフとジッターで、同時に失敗したクライアントの再試行が時間方向に散る
- 回数の上限と予算で、下流が止まった時の負荷の増え方に上限を置ける
- クライアントのライブラリや SDK の設定だけで導入でき、サーバーの変更が要らない
欠点
再試行は、失敗を時間で埋め合わせます。その代わりに、次の制約があります。
- 失敗が最終的に返るまでの時間が、待ち時間の合計だけ延びる
- 副作用のある要求は、冪等性が無いと二重に処理される
- 多段の呼び出しで各段が再試行すると、最下段の負荷が掛け算で増える
- ジッターの式・上限・予算の値は、負荷とサーバーの壊れ方次第で最適な値が変わる
- 障害の最中は、再試行の増加が原因なのか症状なのかを見分けにくい
適さないケース
- 要求の誤りや権限不足のように、何度送っても結果が変わらない失敗
- 冪等キーの無い決済や注文の作成のように、二重に処理すると困る要求
- 利用者が画面の前で待っていて、待ち時間の合計が timeout を超える呼び出し
- 呼び出しの多段の途中にあって、上の段が既に再試行している層
最後の項目は、再試行を 1 か所に寄せるためです。SRE 本の Handling Overload は、深いスタックでは、要求を断った層のすぐ上の層だけが再試行するべきだとしています。下の段は失敗をそのまま返し、「過負荷なので再試行しない」と分かる応答を付けると、上の段も再試行を控えられます。同じ節は、バックエンドが受け取った要求の再試行の回数から周りの過負荷を推し量り、「overloaded; don’t retry」の応答を返す例も挙げています。