レート制限(rate limiting)は、利用者ごとに一定時間あたりに受け付ける要求の数に上限を設け、超えた分を断るか遅らせる仕組みです。公開 API の「1 分に 60 回まで」、ログイン画面の試行回数の制限、Web サーバーの nginx の limit_req などが、この仕組みにあたります。断る時は、HTTP の 429 Too Many Requests を返すのが一般的です。
同じ「1 分に 60 回」でも、数え方は 1 つではありません。時刻を 1 分ごとの枠に切って数える方式(固定窓)、直近 1 分の記録を数える方式(スライディングログ)、一定の速さで溜まる許可を使う方式(トークンバケット)などがあり、どの瞬間に何件まで通すかが方式ごとに違います。以下は、枠の境目をまたいで 60 件ずつ要求が届いた時に、固定窓とスライディングログの 2 つの方式が通した件数です。
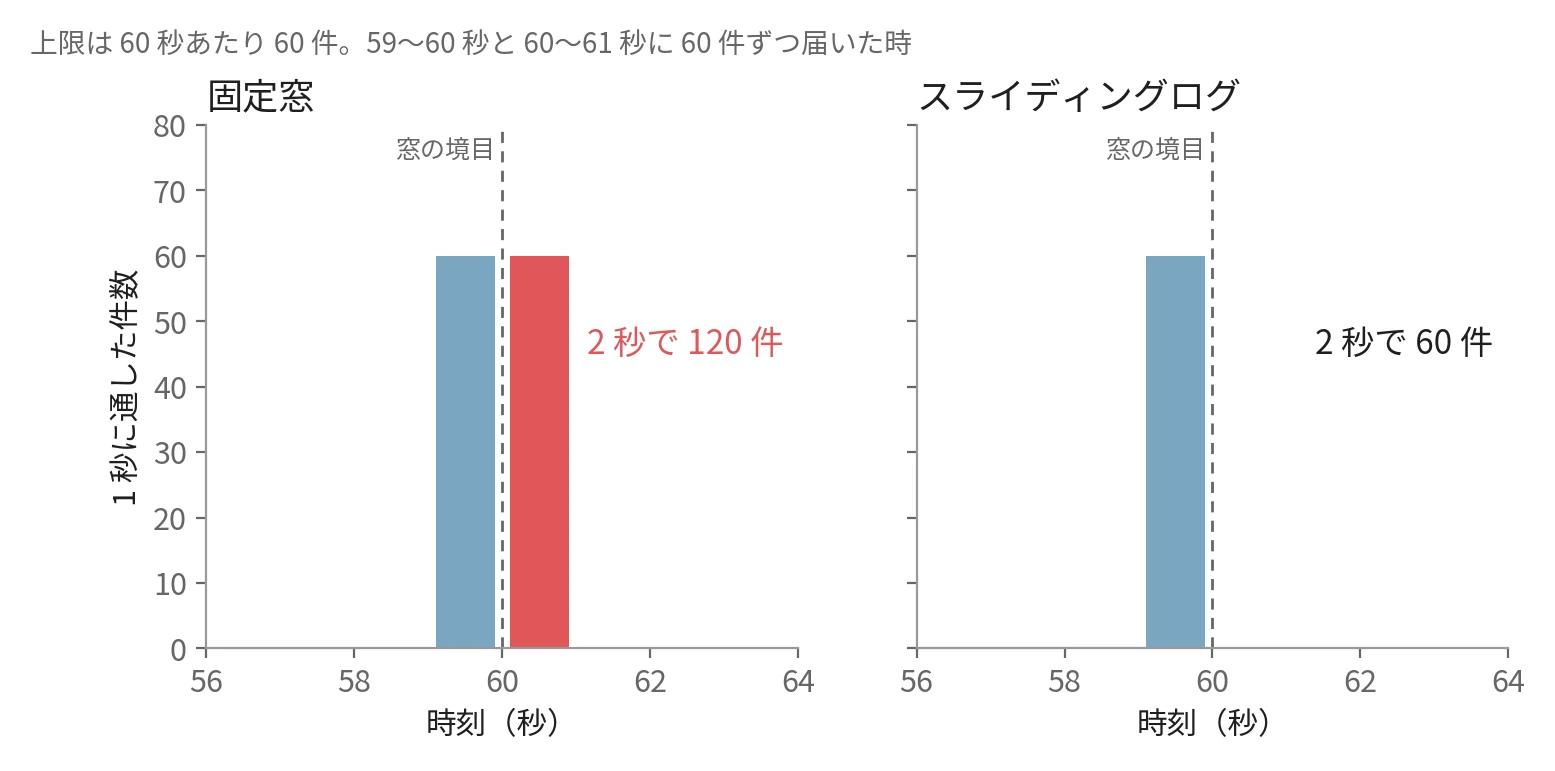
窓の境目の前後 1 秒に 60 件ずつ届いた時に通した件数
固定窓は、枠ごとに見れば 60 件以内という上限を守りながら、2 秒で 120 件を通しています。窓が切り替わった瞬間に数が 0 に戻るからです。
本記事では、Python で実装した各方式に同じ要求の列を通した結果と、手元の Redis で数を共有した実験から、レート制限の方式の違いを説明します。扱う疑問は次の通りです。
- 窓で数える 3 つの方式は、それぞれ何を数え、どこで上限を超えるのか。
- トークンバケットとリーキーバケットは、瞬間的な集中(バースト)をどう扱うのか。
- 複数のサーバーで上限を共有すると、どんな誤差が出るのか。
- 断ったことと再試行してよい時刻は、HTTP でどう伝えるのか。
下流の処理が詰まった時に送る量を絞らせる仕組みは Backpressure のノートで扱っています。同時に処理中の要求の数を制限する方式と、サーバー全体の負荷に応じて要求を捨てる負荷制御(load shedding)は説明しません。
レート制限が必要な理由
API のサーバーは、多数の利用者で同じ CPU・DB(データベース)・下流のサービスを共有しています。1 人の利用者のスクリプトが誤ってループし、1 秒に数百回の要求を送り続けると、他の利用者の要求まで遅くなります。悪意が無くても、失敗した要求をすぐに再送するクライアントは同じ状況を作ります。パスワードやワンタイムコードの総当たりのように、試行の回数そのものを抑えたい場面もあります(Authentication のノートで試算しています)。
レート制限は、この 1 人分の使用量に、あらかじめ上限を決めておく仕組みです。Backpressure がサーバーの今の混み具合に応じて送る量を絞らせるのに対し、レート制限はサーバーが空いていても上限を超えた分を断ります。混む前に、1 人が使える量を公平に分けておくためです。
Stripe は、ブログの Scaling your API with rate limiters(2017 年 3 月)で、本番で使う 4 つの制限を紹介しています。利用者ごとの 1 秒あたりの要求数の制限、同時に処理中の要求数の制限、重要でない要求への割り当てを超えた分を断る制限、ワーカーが過負荷の時に優先度の低い要求から捨てる制限です。本記事が扱うのは、1 つ目の「一定時間あたりの要求数」です。
この制限を作る時、最初に決めるのは「1 分」がどの 1 分を指すかです。12:00:00 からの 1 分なのか、今から遡った 1 分なのかで、実装も通る要求も変わります。
窓で数える 3 つの方式
窓(window)で数える方式は、時間を区切って、その区間に通した件数を上限と比べます。以下は、上限が 60 秒あたり 60 件の時、時刻 75 秒に届いた要求の判定で、各方式が数える範囲を示した図です。
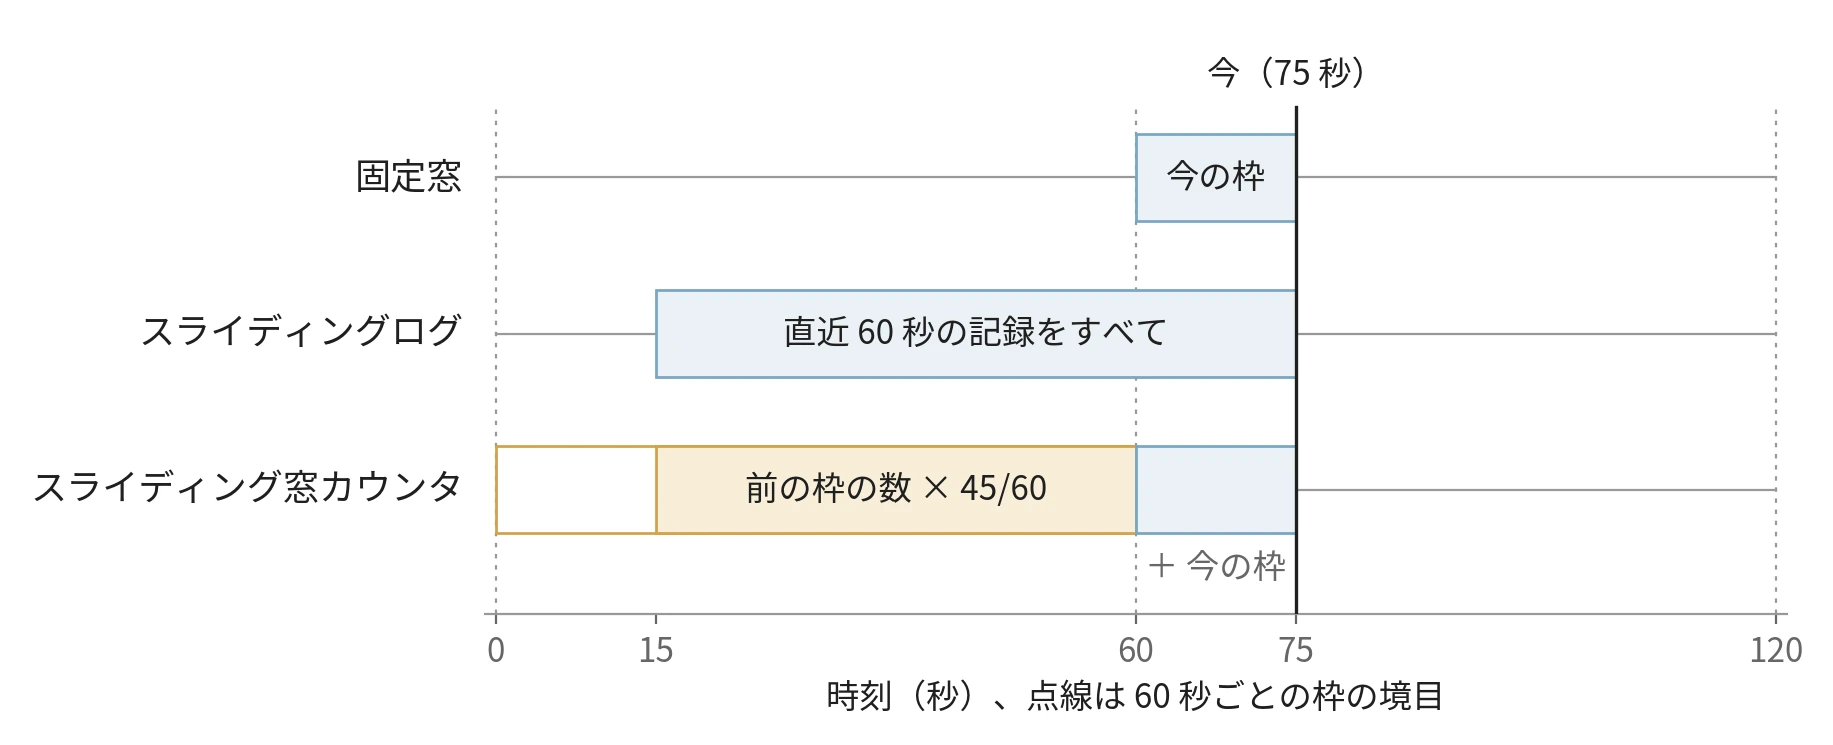
時刻 75 秒の判定で、各方式が数える範囲
固定窓(fixed window)は、時刻を 60 秒ごとの枠に切り、枠ごとに 1 つの数を持ちます。Redis の INCR のドキュメントにも、IP アドレスと現在の秒をつないだキーを INCR し、値が上限を超えたら断る例が載っています。利用者 1 人につき数が 1 つで済み、実装も最も簡単です。ただし冒頭の図の通り、前の枠の終わりと次の枠の初めに要求が集まると、上限の 2 倍まで通します。
スライディングログ(sliding log)は、通した要求の時刻をすべて記録し、判定のたびに 60 秒より古い記録を捨てて件数を数えます。どの 60 秒を取っても上限を超えませんが、利用者 1 人につき最大で上限の数だけ時刻を持つので、上限が大きいほどメモリを使います。
スライディング窓カウンタ(sliding window counter)は、固定窓の数を前の枠と今の枠の 2 つだけ持ち、前の枠の数は今の 60 秒に重なっている割合で按分して足します。Cloudflare はブログの How we built rate limiting capable of scaling to millions of domains(2017 年 6 月)で、この式を上限 50 件の例で示しています(上限が 50 件なのはこの例だけです)。
上限が 1 分に 50 件、前の 1 分に 42 件、今の 1 分が始まって 15 秒で 18 件なら、推定は 42 ×(60 − 15)÷ 60 + 18 = 49.5 件で、次の 1 件を足すと 50.5 件になるので断られます。
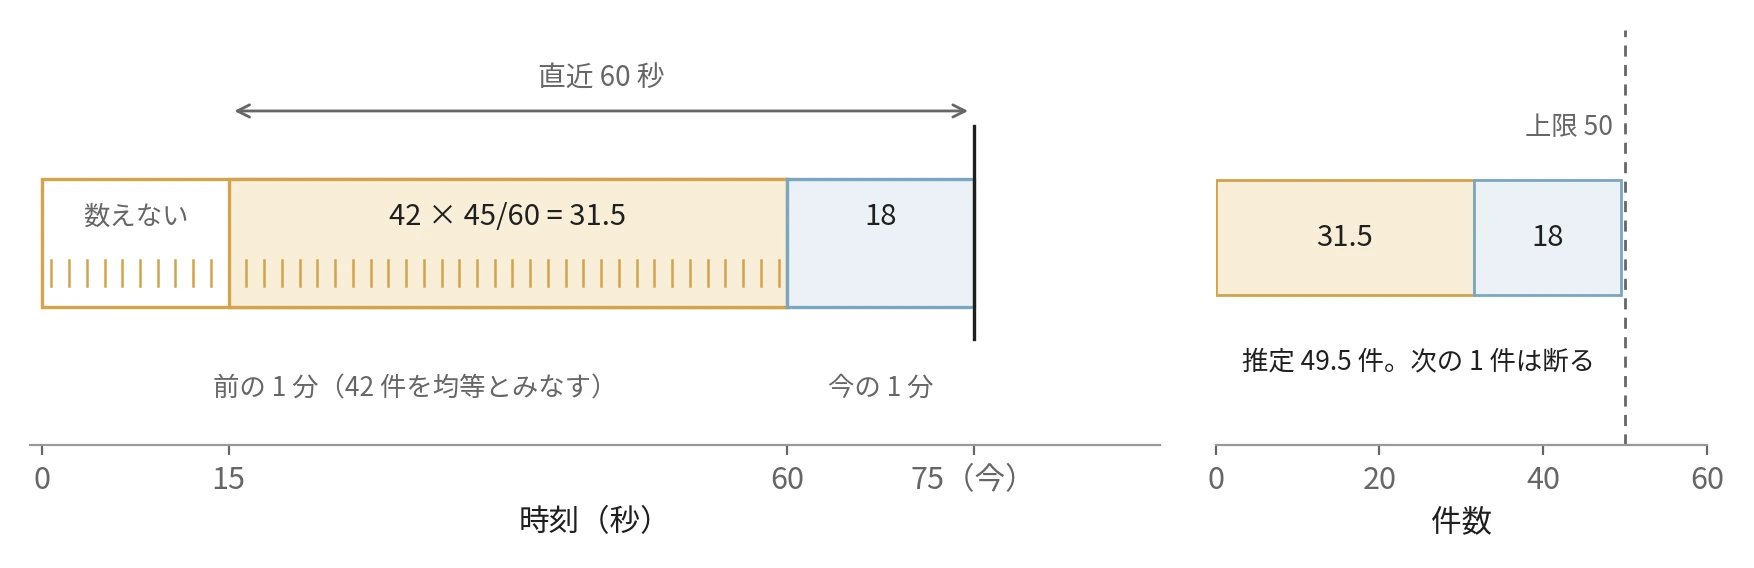
スライディング窓カウンタの推定(Cloudflare のブログの例)
式は、前の 1 分の 42 件が枠の中に均等に並んでいたとみなし、直近 60 秒に重なる 45 秒分だけを数えています。
同じブログは、27 万の送信元からの 4 億件の要求で、誤って通した・断った要求が 0.003%、推定と実際の速さの差が平均 6% だったとしています。
一方で、同じブログは式の前提として「This algorithm assumes a constant rate of requests during the previous sampling period.」(このアルゴリズムは、前の枠の間、要求が一定の速さで届いたと仮定している)と断っています。
2 つの到着列での比較
3 つの方式の差を数値で確かめるために、2026 年 11 月 11 日に、Python 3.14.4 の標準ライブラリだけで各方式を実装し(lab/limiters.py)、同じ要求の列を通しました(lab/simulate.py)。時刻は実時間ではなく数値として渡しているので、結果は機材によらず同じです。上限はすべて 60 秒あたり 60 件、数えるのは通した要求だけです。以下は、スライディング窓カウンタの部分の抜粋です。
class SlidingWindowCounter:
    def estimate(self, t):
        w = math.floor(t / self.window)
        if w != self.current:
            # 1 つ進んだなら今の数が前の数になる。2 つ以上進んだなら前の枠は空
            self.prev = self.cur if self.current is not None and w == self.current + 1 else 0
            self.current, self.cur = w, 0
        elapsed = t - w * self.window
        return self.prev * (self.window - elapsed) / self.window + self.cur

    def allow(self, t):
        if self.estimate(t) + 1 <= self.limit:   # この 1 件を足しても上限以内なら通す
            self.cur += 1
            return True
        return False
1 つ目の到着列は、冒頭の図の 59〜60 秒と 60〜61 秒に 60 件ずつ、計 120 件です。固定窓は 120 件すべてを通し、スライディングログとスライディング窓カウンタは 60 件で止めました。
2 つ目の到着列は、100 秒まで何も送らず、100 秒から 220 秒まで 1 秒に 2 件ずつ送り続けるものです。以下は、5 秒ごとに通した件数です。一番下のトークンバケットは次の節で説明します。横の破線は 5 秒に 5 件、つまり 60 秒あたり 60 件を均した速さ(1 秒に 1 件)です。右上の件数は、60 秒で 60 件を超えた方式を黄土色にしています。
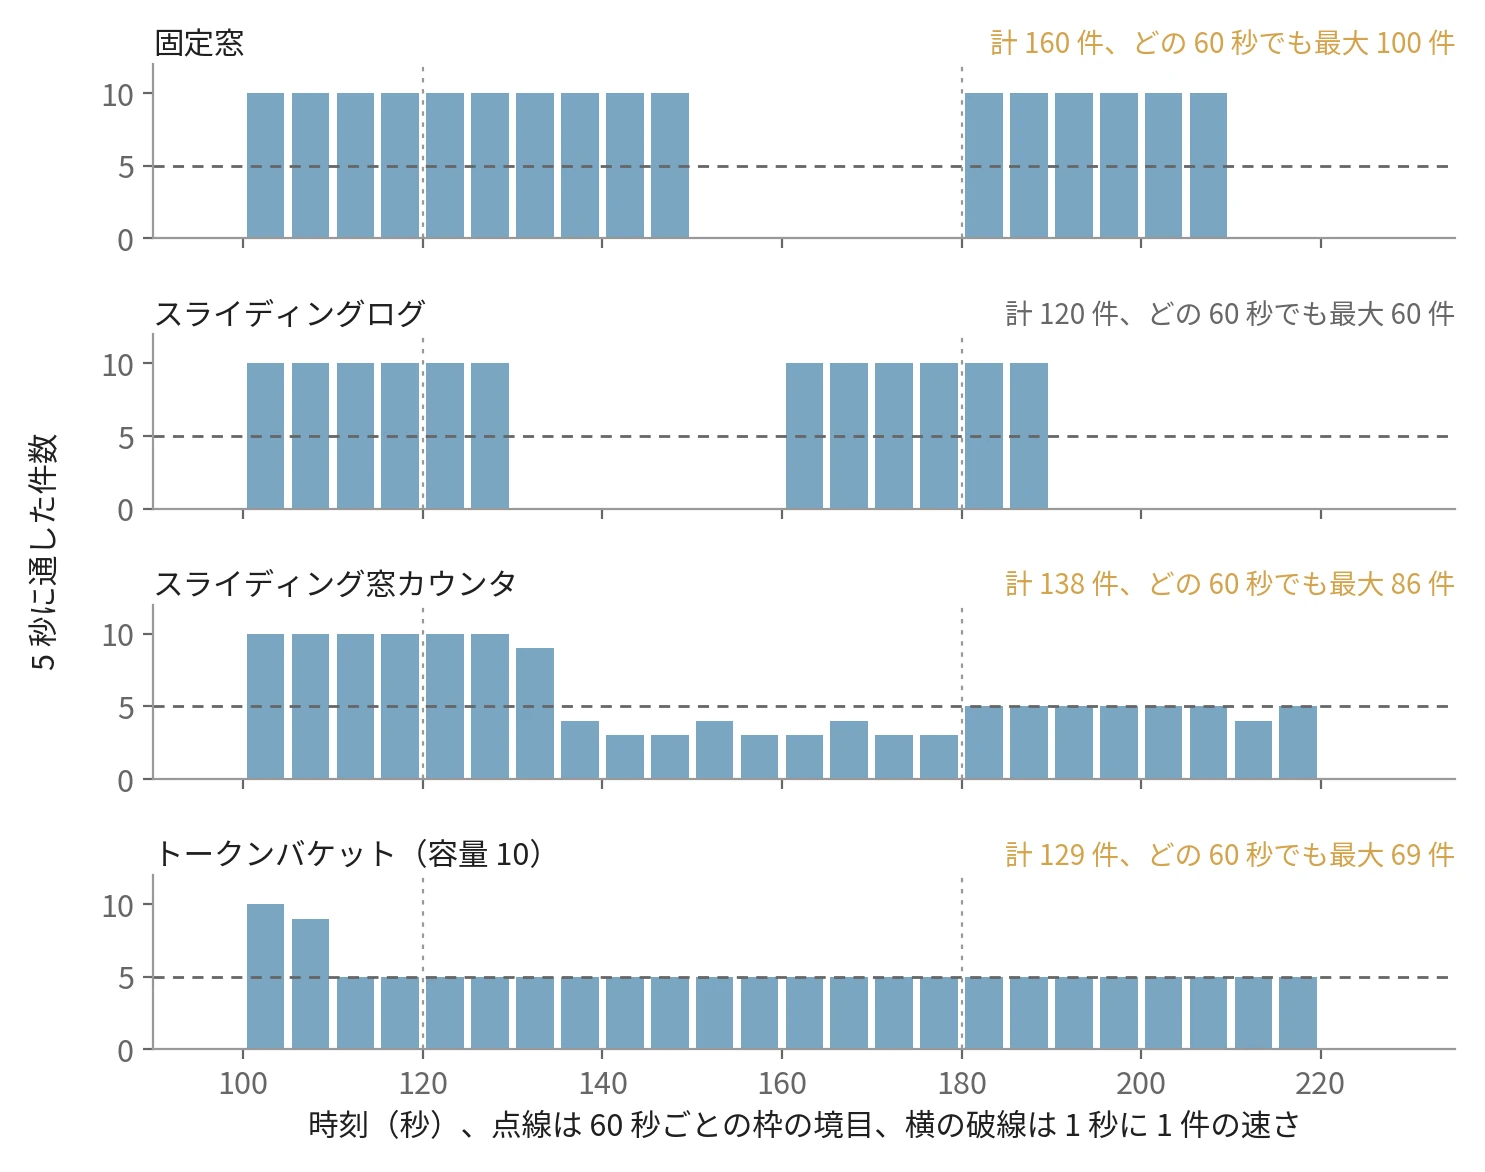
1 秒に 2 件を送り続けた時、5 秒ごとに通した件数
固定窓とスライディングログは、上限に届くまで 1 秒に 2 件を通し、届いた後はしばらく 1 件も通しません。固定窓は 120 秒の境目で数が 0 に戻るので、100〜150 秒に通し続け、100〜160 秒の 60 秒で 100 件を通しました。スライディングログは、どの 60 秒を取っても 60 件以内でしたが、30 秒通して 30 秒止まる動きを繰り返しています。
スライディング窓カウンタは止まらず、135 秒ごろからは 5 秒に 3〜5 件に落ちますが、60 秒あたり最大 86 件を通しました。前の枠(60〜120 秒)の 40 件は、すべて 100〜120 秒に届いています。
式はこの 40 件が枠の中に均等にあったとみなし、120 秒から重みを減らし始めます。実際には 160〜180 秒まで直近 60 秒に残っているので、その差の分だけ多く通しました。Cloudflare の 0.003% は実際のトラフィックでの値で、今回は前の枠の後半に要求を寄せた、式に不利な到着列です。
バケットで数える方式
図の一番下のトークンバケット(token bucket)は、窓を持ちません。バケットには 1 秒に r 個ずつトークンが溜まり、容量 b を超えた分は捨てられます。要求は 1 件につきトークンを 1 個使い、トークンが無ければ断られます。1 秒に 1 個は、窓の方式の「60 秒あたり 60 件」と同じ平均の速さです。以下は、容量 10、1 秒に 1 個の時、2 つ目の到着列でのトークンの残りです。
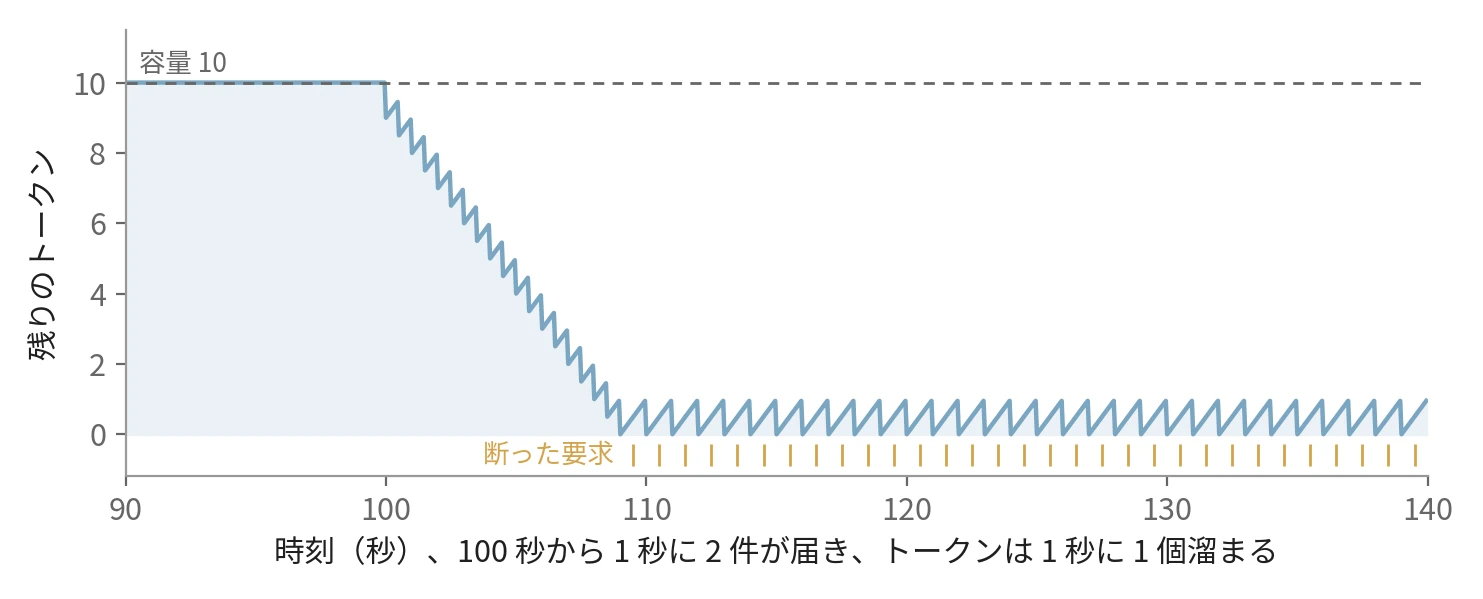
容量 10・1 秒に 1 個のトークンバケットの残り
満杯の 10 個を使い切るまでは 1 秒に 2 件を通し、その後は溜まる速さの 1 秒に 1 件だけを通します。窓の方式のような「30 秒通して 30 秒止まる」動きにはなりません。容量 b は、しばらく休んでいた利用者に一度に許すバーストの大きさです。
そのため、トークンバケットの上限は「60 秒あたり 60 件」ではありません。長さ T 秒の区間に通るのは、最大で b + r × T 件(容量 10・60 秒なら 70 件)です。今回の到着列では、60 秒あたり最大 69 件でした。容量を窓と同じ 60 にすると最大 119 件になり、固定窓の境目と同じく 2 倍近くを通します。1 つ目の到着列でも、容量 60 は 2 秒で 61 件、容量 10 は 11 件を通しました。
リーキーバケットの 2 つの意味
リーキーバケット(leaky bucket)は、底に穴の空いたバケットに例えた方式で、2 つの意味で使われます。1 つは、要求ごとにバケットへ水を足し、水が一定の速さで漏れ、あふれそうなら断る判定の方式です。水の量を「使ったトークン」と読み替えると、トークンバケットと同じ判定になります。
もう 1 つは、要求を待ち行列に入れ、一定の速さで取り出して処理する方式です。nginx の limit_req はこの意味で、ドキュメントには「The limitation is done using the “leaky bucket” method.」(制限はリーキーバケットの方式で行う)とあります。
上限を超えた要求は待たされ、limit_req の burst 引数で指定した数を超えると断られます。nodelay 引数を付けると、burst の範囲内の要求を待たせずに通します。断る時の状態コードは、limit_req_status の既定値の 503 です。
同じ実験で、1 秒に 1 件を取り出す容量 10 の待ち行列に 2 つ目の到着列を通すと、処理の間隔は常に 1 秒になりました。その代わりに、待ち行列に入った要求は最大 10 秒待たされています。
GCRA
GCRA(Generic Cell Rate Algorithm)は、トークンバケットと同じ判定を時刻の値 1 つで行う方式です。トークンの数と最後に補充した時刻の 2 つを持つ代わりに 1 つの値で済むので、Redis の 1 つのキーにも置けます。元は ATM(Asynchronous Transfer Mode)網で、セル(固定長のパケット)が契約した速さに従っているかを判定するために定められました。
ATM Forum の Traffic Management Specification 4.1(1999 年 3 月、リンクは大学のミラー)の 4.4.2 節が、ITU-T I.371 の図を元に、仮想スケジューリングと連続状態のリーキーバケットの 2 つの等価な流れ図で定義しています。
前者の仮想スケジューリングは、次の要求が来るはずの理論上の到着時刻(TAT、Theoretical Arrival Time)を 1 つ持つだけです。
class GCRA:
    def __init__(self, increment, limit):
        self.i, self.l = increment, limit      # I = 1 / rate、L は早着を許す幅
        self.tat = None

    def allow(self, t):
        if self.tat is None or self.tat < t:
            self.tat = t                        # 遅れて来たなら、今を基準にする
        if self.tat > t + self.l:
            return False                        # 早すぎる。TAT は変えない
        self.tat += self.i
        return True
トークンバケット(速さ r、容量 b)と GCRA(I = 1/r、L = (b − 1)/r)に、ランダムな間隔の要求を計 6 万件通したところ、判定が食い違った要求は 0 件でした(丸めの誤差を避けるために分数で計算)。
複数のサーバーで数を共有する
API のサーバーが 1 台なら、数は自分のメモリに置けば済みます。ロードバランサーの後ろに複数台が並ぶと、同じ利用者の要求が別々のサーバーに届くので、数をどこに置くかを決める必要があります。
素朴な方法は、上限を台数で割り、各サーバーが自分の分だけを数えることです。サーバー間の通信が要らない代わりに、要求が均等に振り分けられる前提に頼ります。lab/split.py で、上限 60 件を 2 台で 30 件ずつ分け合い、利用者が 60 秒に 60 件(上限ちょうど)を送る状況を計算しました。
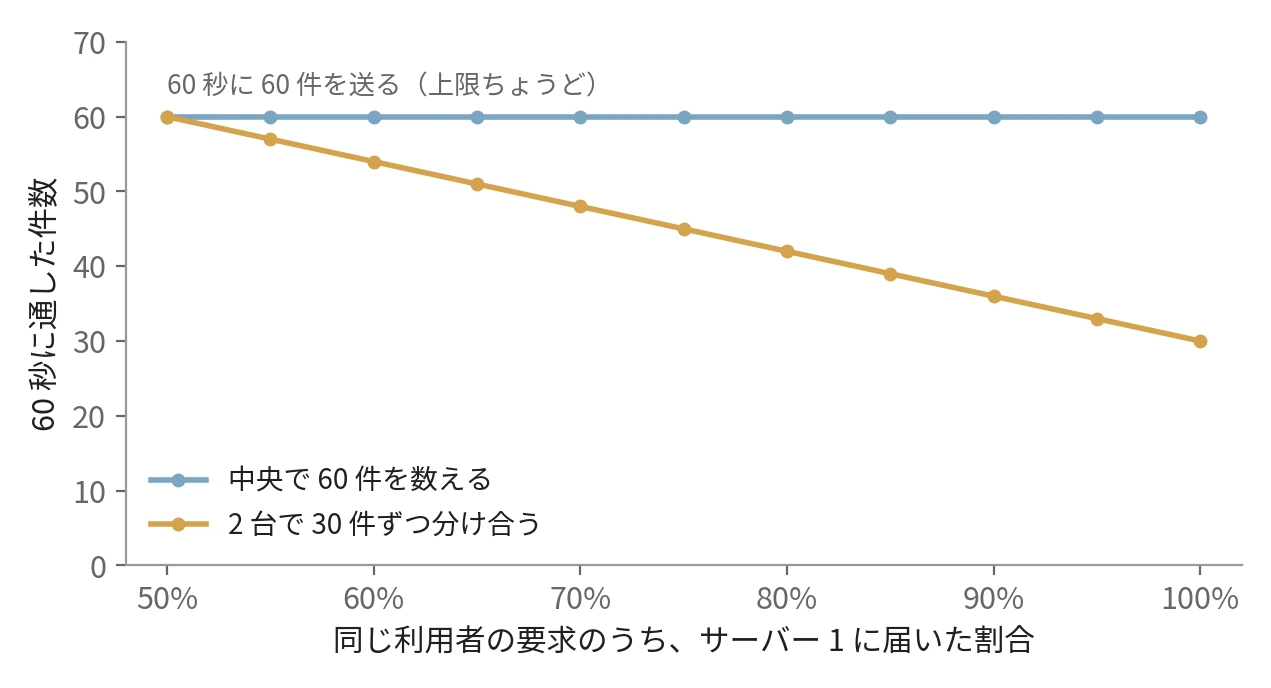
上限を 2 台で分け合った時と中央で数えた時に通した件数
振り分けが半々なら 60 件すべてが通ります。接続単位で振り分けるロードバランサーでは、HTTP の接続を使い回すクライアントの要求が 1 台に偏ります。8 割がサーバー 1 に届くと、上限以内の 60 件のうち 18 件が断られる計算です。逆に台数を増やした時に割り当てを直し忘れると、全体では上限を超えて通します。
中央の Redis で数える
もう 1 つの方法は、数を中央の Redis に置き、全サーバーが同じキーを更新することです。Stripe も、ブログで「We implement our rate limiters using Redis.」(レート制限は Redis で実装している)と書いています。この時に気を付けるのは、数を確かめてから増やす 2 つの操作の間に、他のサーバーの要求が割り込むことです。
同じ 11 月 11 日に、8 個のプロセスを 8 台のサーバーに見立て、同じ利用者のキーに 50 件ずつ一斉に要求を送りました。上限は 100 件です。
Redis は Docker で 127.0.0.1 だけに公開して動かしました(版は lab/output_race.txt の先頭に記録)。以下は、lab/race.py の 2 つの数え方の抜粋です。r.call() は、標準ライブラリだけで書いた Redis のクライアント(lab/resp.py)でコマンドを 1 つ送る関数です。
def check_then_incr(r, key, gap=0.0):
    current = int(r.call("GET", key) or 0)    # 今の数を読み
    if gap:
        time.sleep(gap)                        # 別のホストの Redis までの往復を真似た待ち
    if current < LIMIT:
        r.call("INCR", key)                    # 上限未満なら増やす(2 つの操作の間に割り込まれうる)
        return True
    return False

INCR_LUA = """
local current = redis.call("INCR", KEYS[1])
if current == 1 then
  redis.call("EXPIRE", KEYS[1], 60)
end
return current
"""

def incr(r, key, sha):
    # sha は SCRIPT LOAD で登録した INCR_LUA のハッシュ。EVALSHA はそれを呼ぶ
    return r.call("EVALSHA", sha, 1, key) <= LIMIT   # 増やした後の値で判定する
後者は、Redis の INCR のドキュメントにある Lua のスクリプトの EXPIRE を 60 秒にし、戻り値と上限の比較を足したもので、最初の要求から 60 秒の固定窓にあたります。
比較のために、トークンバケットの計算全体を Lua で書いた版(lab/race.py の TOKEN_BUCKET_LUA)も試しました。Redis は Lua のスクリプトを不可分に実行し、実行中は他のコマンドを処理しません。以下は、各方式を 20 回ずつ試した結果です。
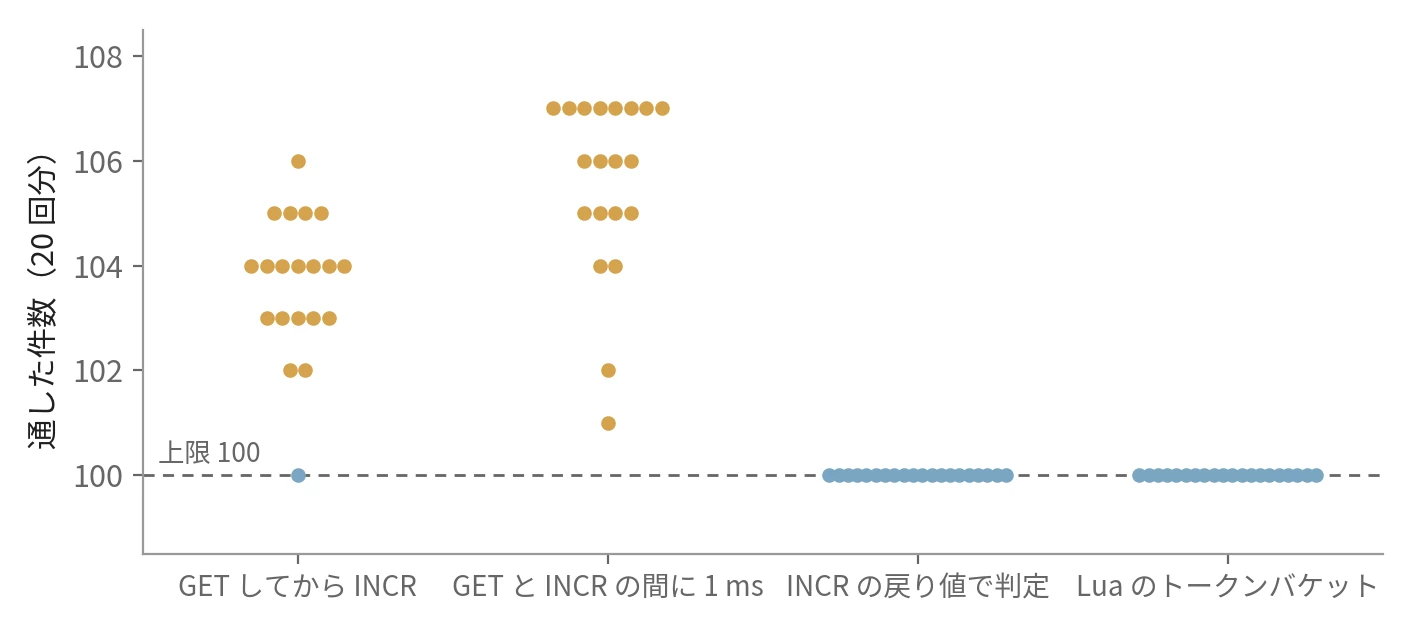
8 プロセスから 400 件を送った時に通した件数(上限 100)
GET してから INCR する方式は、20 回中 19 回で上限を超え、最大 106 件を通しました。GET と INCR の間に 1 ms 待たせると最大 107 件です。99 件を通した時点で 8 台が同時に GET し、全員が 99 を読んでから増やすと 107 件になるので、超える量は最大で「同時に判定しているサーバーの数 − 1」です。INCR の戻り値で判定する方式と、トークンバケットの計算全体を Lua で書いた方式は、20 回とも 100 件ちょうどでした。INCR は読んで増やすまでを 1 つのコマンドで行うので、間に他のサーバーの要求が割り込みません。
中央で数えることの代償
中央で数えると、要求のたびに Redis との往復が 1 回増えます。今回の 127.0.0.1(機材は AMD Ryzen AI Max+ 395)では PING の往復の中央値が 27 µs でしたが、別のホストならネットワークの往復の時間がそのまま足されます。利用者が多いと 1 台の Redis に収まらないので、利用者のキーを Consistent Hashing などで複数の Redis に分けることになります。
Redis が止まった時に要求を通すか断るかも、先に決めておく必要があります。Stripe は、例外を各層で捕まえ、レート制限の不具合では要求を通す(fail open)ように作ることを勧めています。プロキシの Envoy は、各プロキシのトークンバケットで先にバーストを吸収し、全体の上限は外部の制限サービスで数える 2 段の構成を取れます。
429 と Retry-After で断ったことを伝える
上限を超えた要求に返す 429 Too Many Requests は、RFC 6585(2012 年 4 月)で定義された状態コードです。RFC 6585 は、利用者の見分け方や数え方を定めていません。429 の応答に Retry-After を付けてよいこと(MAY)と、429 の応答をキャッシュに保存してはならないこと(MUST NOT)を定めています。
Retry-After は、RFC 9110 の 10.2.3 節で定義されたヘッダーで、次の要求までどれだけ待つべきかを Retry-After: 120 のような秒数か、HTTP の日時で示します。
RateLimit ヘッダーの draft
断られる前に残りの量を知らせるヘッダーは、IETF の HTTPAPI ワーキンググループで draft-ietf-httpapi-ratelimit-headers として議論されています。2026 年 11 月 11 日時点の最新は 2026 年 5 月 23 日の -11 で、RFC にはなっていない Internet-Draft です。
この版は、方針を示す RateLimit-Policy(上限 q と窓の秒数 w)と、今の状態を示す RateLimit(残り r と、割り当てが元に戻るまでの秒数 t)の 2 つのヘッダーを定めています。
draft は「This specification does not mandate a specific throttling algorithm.」(本仕様は特定の制限のアルゴリズムを定めない)としており、Retry-After と両方ある時は Retry-After を優先します。
標準ライブラリの HTTP サーバーで、固定窓の「10 秒あたり 5 件」を数え、-11 の形でヘッダーを返す lab/server.py を書きました。curl で 6 回続けて送った時の、5 回目と 6 回目の応答です(全体は lab/output_server.txt)。
$ curl -si http://127.0.0.1:18080/   # 5 回目
HTTP/1.0 200 OK
RateLimit-Policy: "default";q=5;w=10
RateLimit: "default";r=0;t=5

$ curl -si http://127.0.0.1:18080/   # 6 回目
HTTP/1.0 429 Too Many Requests
RateLimit-Policy: "default";q=5;w=10
RateLimit: "default";r=0;t=5
Retry-After: 5
クライアントは、Retry-After の秒数だけ待ってから送り直します。複数のクライアントが同じ秒数で一斉に戻ると、窓が開いた瞬間に再び集中します。送り直す時の間隔のずらし方は Retry and Backoff のノートで、同じ要求を 2 度処理しないための工夫は Idempotency のノートで扱っています。
利点
- 1 人の利用者の暴走や誤った再送が、他の利用者の応答を遅らせなくなる
- 総当たりのように、試行の回数そのものが脅威になる攻撃の速さを抑えられる
- 上限と残りを利用者に示せば、クライアントは断られる前に送る量を調整できる
- 方式を選べば、バーストを許す量(トークンバケットの容量)と平均の速さを別々に決められる
欠点
レート制限は、利用者ごとの数を持ち、要求のたびにその数を確かめて更新します。その代わりに、次の制約があります。
- 窓の方式は、境目で上限の 2 倍まで通すか、メモリを多く使うか、到着の偏りで誤差が出るかのどれかを受け入れる
- 複数のサーバーでは、上限を分け合うと偏りで誤って断り、中央で数えると要求ごとに往復が増える
- 中央の数を確かめてから増やす実装は、同時に判定するサーバーの数だけ上限を超える
- 利用者をどう見分けるか(API キー、IP アドレスなど)を誤ると、同じ NAT の後ろの別人を一緒に断る
Rate Limiting の効果が小さくなりやすいケース
- 1 件ごとの重さが大きく違い、件数ではなく処理時間や同時実行数が資源を使い切る API
- 多数の IP アドレスから少しずつ送られる攻撃のように、1 人あたりの上限に引っかからない負荷
- サーバー全体が既に過負荷で、利用者ごとの上限以内の要求だけでも処理しきれない状況
- 呼び出し側から見て、失敗が続く下流への呼び出しを止めたい状況(Circuit Breaker の役割)
1 つ目と 3 つ目は、レート制限が要らないという意味ではありません。Stripe が同時実行数の制限や負荷に応じて捨てる制限を並べて使っているように、件数の上限は他の制限と組み合わせて初めて資源を守れます。