Consistent Hashing(コンシステントハッシュ法)は、データを複数のサーバーに振り分ける時に、サーバーの追加・削除で保存先が変わるデータを少なくする方法です。例えば、商品 ID ごとにキャッシュの保存先を決めているサービスで、容量を増やすためにサーバーを追加する場合に使います。
保存先が変わると、古いサーバーにあるキャッシュをそのまま参照できなくなります。キャッシュを作り直す要求が DB(データベース)に集中すると、容量を増やす操作が一時的な負荷の増加につながります。データを永続保存する用途でも、保存先を変える範囲が広いほどコピーするデータが増えます。
本記事では、キーからデータの保存先を決める基本を説明し、サーバーを 3 台から 4 台に増やす実験で、次の疑問を確かめます。
- ハッシュ値をサーバー台数で割るだけでは、なぜ多くのデータで保存先が変わるのか。
- ハッシュリングと仮想ノードは、データ移動と偏りをどう減らすのか。
- キーが均等に分かれても、負荷が偏るのはなぜか。
- 複製と修復には、別にどのような処理が必要なのか。
台数で割る方法の問題
キーとは、product:42 のようにデータを指定する識別子です。ハッシュ関数でキーを整数に変換すると、同じキーから同じ値を計算できます。ここでは、データを保存するサーバーをノードと呼びます。
3 台を [A, B, C] の順に並べ、hash(key) % 3 の結果を配列の添字にすれば、保存先を決められます。% は割り算の余りを求める演算子です。ハッシュ値が十分に分散していれば、キーの件数もおおむね均等になります。
しかし、D を追加して [A, B, C, D] にすると、割る数が 3 から 4 に変わります。
| ハッシュ値の例 | 3 台:余り → 保存先 | 4 台:余り → 保存先 |
|---|---|---|
| 4 | 1 → B | 0 → A |
| 5 | 2 → C | 1 → B |
| 6 | 0 → A | 2 → C |
| 7 | 1 → B | 3 → D |
D に移すデータだけでなく、A・B・C の間でも保存先が変わっています。ハッシュ値を 12 で割った余りが均等なら、3 台から 4 台に増やす時に保存先が変わるキーの割合は 75% です。3 と 4 の最小公倍数である 12 通りのうち、両方の余りが一致するのは 0・1・2 の 3 通りしかありません。
必要なのは、ノードの追加時に既存ノード間でのデータ移動をなるべく避け、新しいノードに渡す部分だけを選ぶ方法です。オブジェクトストレージである OpenStack Swift の解説でも、台数を割る方法から始めて、再配置を減らす必要性を説明しています。
ハッシュリングによる保存先の決定
ハッシュリングでは、ハッシュ値の最大値の次を 0 につなぎ、数値の範囲を円として扱います。各ノードにも円上の位置を割り当てます。この位置をトークンと呼びます。
キーのハッシュ値から時計回りに進み、最初に到達したトークンのノードを保存先にします。キーのハッシュ値がトークンと同じ位置なら、そのノードに保存します。リングは数値の並びを表しており、サーバー同士を円形に配線するという意味ではありません。
以下は、数値の範囲を説明用に 0 以上 100 未満に縮めた図です。A を 20、B を 60、C を 90 に置き、D を 40 に追加します。緑の区間だけが B から D に移ります。
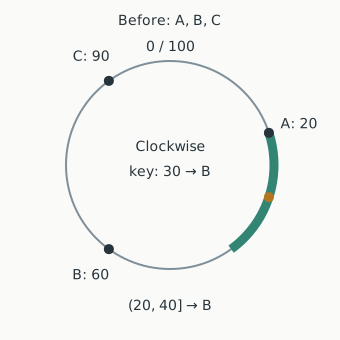
追加前:ハッシュ値が 20 を超えて 60 以下なら、保存先は B。
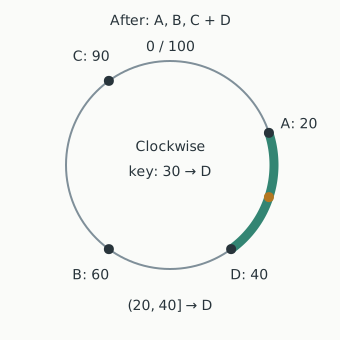
追加後:20 を超えて 40 以下だけ D に移動。
図は筆者作成の説明例です。(20, 40] は「20 を含まず、40 を含む区間」を表します。90 を超えた値は 0 に戻って A に到達するため、A に保存するキーのハッシュ値の範囲は円の端をまたぎます。
D を追加しても、既存のトークンを動かさなければ、D に保存先を変更する区間以外は変わりません。削除の場合も同様で、消したトークンに対応する区間のデータは、時計回りの次のトークンのノードに保存先を変えます。これはキーから保存先を決める規則であり、保存済みデータのコピーを実行する処理は別に必要です。
仮想ノードによる分散
1 台にトークンを 1 個だけ置くと、トークンの間隔によって保存するキーの数が偏ります。上記の図でも、A・B・C に割り当てられた区間の長さは 30・40・30 です。ランダムに配置すれば、さらに大きく偏る場合があります。
そこで、1 台の実ノードに複数のトークンを割り当てます。このような論理上の位置を仮想ノード(Virtual Node、vnode)と呼びます。例えば A に A:0、A:1、A:2 の 3 個を割り当てても、稼働するサーバーは A の 1 台です。
1 台に 1 個のトークン
1 台に複数のトークン
独立に分散した位置を多く持たせると、実ノードごとに割り当てられた区間の長さの合計は均等に近付きやすくなります。ただし、仮想ノード数を増やせば必ず偏りが小さくなる、という保証ではありません。位置の選び方やノードの容量差も影響します。
Apache Cassandra のドキュメントでは、仮想ノードによる分散とともに、トークン数が増えると修復する区間も増える点を説明しています。仮想ノードを多く持たせるほど管理する情報も増えるため、個数だけで判断することはできません。
10 万件のキーによる比較
同じ 10 万件のキーに対して、次の 3 種類の割り当てを比較します。通信やデータのコピーは行わず、保存先が変わるキーの件数を数えます。
- ハッシュ値を台数で割った余りを使う。
- 1 台にトークンを 1 個だけ置く。
- 1 台にトークンを 128 個置く。
Python の hashlibで SHA-256 を計算し、キーには key:0 から key:99999、トークンには node:A:0 のような文字列を使います。全ての入力が固定されているため、同じコードで同じ結果を確認できます。SHA-256 は実験で使うハッシュ関数として選んでおり、Consistent Hashing が暗号学的ハッシュ関数を必須とするわけではありません。
実験コードを保存し、次のコマンドで実行できます。追加パッケージは不要です。
以下が experiment.py の全体です。
"""Compare primary-owner mappings, not network transfers or server performance.
Run: python3 experiment.py (Python 3, standard library only).
"""

from bisect import bisect_left
from collections import Counter
from hashlib import sha256


def hash_value(value):
    return int.from_bytes(sha256(value.encode('utf-8')).digest(), 'big')


def make_ring(nodes, vnodes):
    entries = sorted(
        (hash_value(f'node:{node}:{v}'), node) for node in nodes for v in range(vnodes)
    )
    points = [point for point, _ in entries]
    assert len(points) == len(set(points)), 'Token collision'
    return points, [node for _, node in entries]


def owner(ring, key_hash):
    points, nodes = ring
    return nodes[bisect_left(points, key_hash) % len(points)]


def main():
    keys = [hash_value(f'key:{i}') for i in range(100_000)]
    old_nodes = ['A', 'B', 'C']
    new_nodes = old_nodes + ['D']
    # Explicit boundary checks for the clockwise successor rule.
    tiny = ([20, 60, 90], ['A', 'B', 'C'])
    assert [owner(tiny, h) for h in [0, 20, 21, 60, 90, 99]] == ['A', 'A', 'B', 'B', 'C', 'A']
    print('keys=100000, nodes=3->4, primary owner only')
    for vnodes in [0, 1, 128]:
        label = 'modulo' if vnodes == 0 else f'ring-v{vnodes}'
        if vnodes == 0:
            before = [old_nodes[h % 3] for h in keys]
            after = [new_nodes[h % 4] for h in keys]
        else:
            old_ring = make_ring(old_nodes, vnodes)
            new_ring = make_ring(new_nodes, vnodes)
            before = [owner(old_ring, h) for h in keys]
            after = [owner(new_ring, h) for h in keys]
            assert all(a == b or b == 'D' for a, b in zip(before, after))
            removed_ring = make_ring(['A', 'C'], vnodes)
            assert all(a == 'B' or owner(removed_ring, h) == a for h, a in zip(keys, before))
        changed = sum(a != b for a, b in zip(before, after))
        counts = Counter(after)
        print(
            f'{label}: changed={changed} ({changed / len(keys):.2%}), '
            + ' '.join(f'{n}={counts[n]}' for n in new_nodes)
        )


if __name__ == '__main__':
    main()
python3 experiment.py
実行結果は以下の通りです。changed は保存先が変わったキーの件数、A から D は追加後に各ノードに割り当てられたキーの件数です。
keys=100000, nodes=3->4, primary owner only
modulo: changed=74934 (74.93%), A=24841 B=24912 C=25394 D=24853
ring-v1: changed=6166 (6.17%), A=71518 B=16010 C=6306 D=6166
ring-v128: changed=26510 (26.51%), A=23047 B=25048 C=25395 D=26510
剰余を使う方法では、追加後のノードごとのキー件数は均等に近い一方、約 75% のキーで保存先が変わりました。トークンを 128 個にしたリングでは、保存先の変更は約 27% に収まっています。リングで保存先が変わったキーは全て D に移り、既存ノード同士の移動がないこともコード内で検証しています。
トークンが 1 個の結果だけを見ると、移動が約 6% で済んでいます。しかし、A に約 72% のキーが集中し、新しい D に割り当てられたキーは約 6% にとどまっています。移動が少ないことと、追加した容量を使えることは別です。
保存先を決める処理は、ソートしたトークンを二分探索するだけで書けます。上記のコードの owner がこの処理に当たります。bisect_left は、キーのハッシュ値以上となる最初の位置を返します。
points はトークンの数値、nodes は対応する実ノード名を同じ順序で並べた配列です。全トークンより大きい値なら探索結果が配列の長さになるので、余りを取って先頭に戻します。ここでの % は探索結果を円の先頭に戻すためであり、キーのハッシュ値をノード台数で割る処理とは異なります。
この実験は、固定したキーとトークン配置での 1 回の比較です。移動する割合は常に 26.51% になるわけではありません。また、数えているのは最初の保存先となるノードの変更であり、複製を含む転送量や所要時間ではありません。
キーの偏りと負荷の偏り
仮想ノードは各ノードに割り当てる区間を分散しますが、1 個のキーを複数のキーに分割する機能はありません。例えば、ある商品のページだけにアクセスが集中すると、そのキーのデータを保存するノードに要求が集まります。このようなキーを Hot Key と呼びます。
| 偏っている対象 | 仮想ノードで解決できるか |
|---|---|
| ノードごとのハッシュ空間の広さ | 複数区間に分けて偏りを減らせる |
| 1 キー当たりのデータサイズ | 件数が均等でも保存量は偏る |
| 1 キー当たりの要求数 | 同じキーへの要求は同じ保存先に集まる |
読み取りが集中するなら、手前のキャッシュや複製からの読み取りで要求を分散する方法があります。更新が集中するなら、カウンターなどを分割できるか、キーの設計から見直す必要があります。仮想ノードの追加だけで、単一キーの処理能力が増えるわけではありません。
複製とデータの修復
保存先が 1 台だけでは、そのノードが停止するとデータを読めなくなります。そこで、リング上で最初の保存先に続く異なる実ノードにもコピーを保存します。例えば 3 台に複製するなら、A の次に A の別の仮想ノードが現れても、それを 2 台目として数えず、別の実ノードまで進みます。同じサーバーに 3 個置いても、そのサーバーの故障には耐えられないからです。
さらに、同じラックの電源断などに備えるには、実ノードが違うだけでなく、共通の原因で停止する範囲を分けます。どこに複製するかと、何台から応答があれば成功とするかは別の判断です。後者はクォーラムの役割です。
複製先が決まっても、停止中に更新を受け取れなかったノードには古いデータが残ります。Amazon Dynamo の論文では、Consistent Hashing による分割と、Merkle Tree を使った複製間の修復を組み合わせています。Merkle Treeは、データを階層的なハッシュで比較し、不一致のある部分を絞るために使えます。
ノード追加時にも、新しい保存先を計算するだけではデータは届きません。対象範囲のコピー中に受け付けた更新を反映し、切り替え前後の要求をどこに送るかを決める必要があります。Consistent Hashing は移す範囲を小さくしますが、移行中の更新を失わない仕組みまでは提供しません。
利点と欠点
- ノードを増減しても、関係しない区間のデータは保存先を保てます。キャッシュの作り直しや、保存データの再配置を減らせます。
- 同じハッシュ関数とトークン配置を共有するクライアントは、キーから保存先を計算できます。ただし、配置情報を共有・更新する仕組みが必要です。
- 仮想ノードでノードごとのキー件数の偏りを抑えられますが、管理するトークンや修復区間が増えます。
- データの複製、更新の整合性、故障検知、移行中の要求の扱いは、別の仕組みと組み合わせます。
適さないケース
単一の Hot Key が負荷の中心なら、まずそのキーへの要求やデータを分散できるかを検討します。また、日付順などの範囲検索を主に行う場合、元のキーの順序をハッシュが崩すため、値の範囲で保存先を分ける方法の方が適する場合があります。
ノードの増減がほとんどなく、データも 1 台に収まるなら、配置情報の管理や移行処理を追加する負担が利点を上回ることもあります。Consistent Hashing を選ぶ理由は、台数を増やせることだけでなく、増減時に保存先の変更を抑えたいかどうかにあります。