UUID(Universally Unique Identifier)は、128 ビットの識別子です。DB(データベース)に問い合わせずにアプリ側で ID を作れること、複数の DB で作った ID が衝突しないこと、URL に出しても件数や順番が推測されにくいことから、表の主キーに使われます。一方で、「UUID を主キーにすると索引が遅くなる」という話もよく聞きます。
では、2024 年 5 月に RFC 9562 で定められた UUIDv7(先頭に時刻を入れた版)にすれば、この問題は無くなるのでしょうか。以下は、PostgreSQL 18 で主キーの型だけが違う 3 つの表に 100 万件を入れた後、それまでの変更をファイルに書き出してから 1 万件を足し、主キーの索引のどのブロック(8 KB の読み書きの単位)が書き換わったかを描いた図です。帯の長さ(索引の大きさ)が型ごとに違う理由は、後の節で説明します。
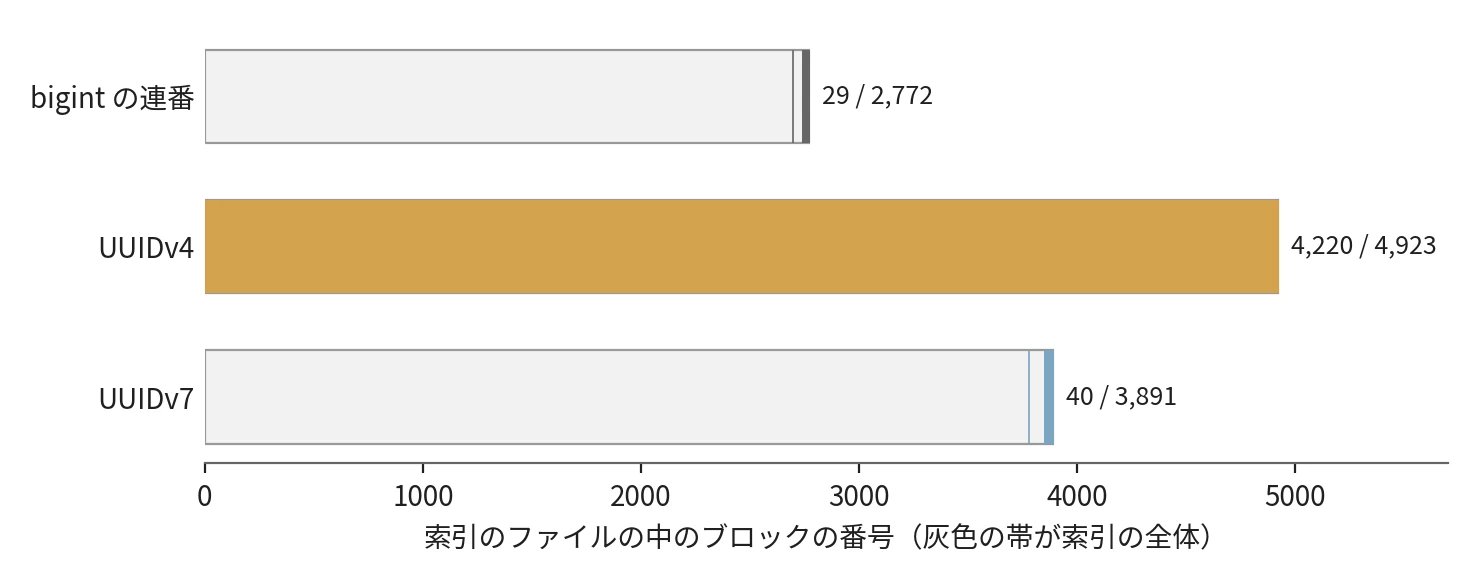
1 万件を足した時に書き換わった主キーの索引のブロック
UUIDv4(全てが乱数の版)は、1 万件を足しただけで索引の 86% のブロックを書き換えました。UUIDv7 は、連番の bigint と同じく末尾の数十ブロックだけです(少し離れた 1 本の線は、後で説明する 1 つ上の段のブロックです)。書き換えたブロックの数は、そのまま WAL(変更の記録)の量とメモリに置いておくべきブロックの数に効きます。
本記事では、PostgreSQL 18.6 で手元に作った表を使って、主キーに UUIDv7 を使った時に何が変わり、何が変わらないのかを説明します。扱う疑問は次の通りです。
- UUIDv4 と UUIDv7 は、128 ビットの中身がどう違うのか。
- UUIDv4 の主キーは、なぜ索引の全体を書き換えるのか。
- UUIDv7 にすると、索引の大きさ・WAL の量はどこまで連番に近づくのか。
- 連番の
bigintと比べて、UUIDv7 に残る費用は何か。 - 値に時刻が入ることで、何に気をつけるのか。
UUID の他の版(v1・v3・v5・v6・v8)の詳細と、MySQL など他の DBMS(Database Management System)での測定には触れません。
UUIDv4 と UUIDv7 の中身
UUID の 128 ビットには、どの作り方の UUID かを示す版(version)の 4 ビットと、UUID の形式を示す変種(variant)の 2 ビットが決まった位置に入ります。残りの 122 ビットの使い方が、版ごとに違います。以下は、v4 と v7 の 128 ビットを並べた図です。
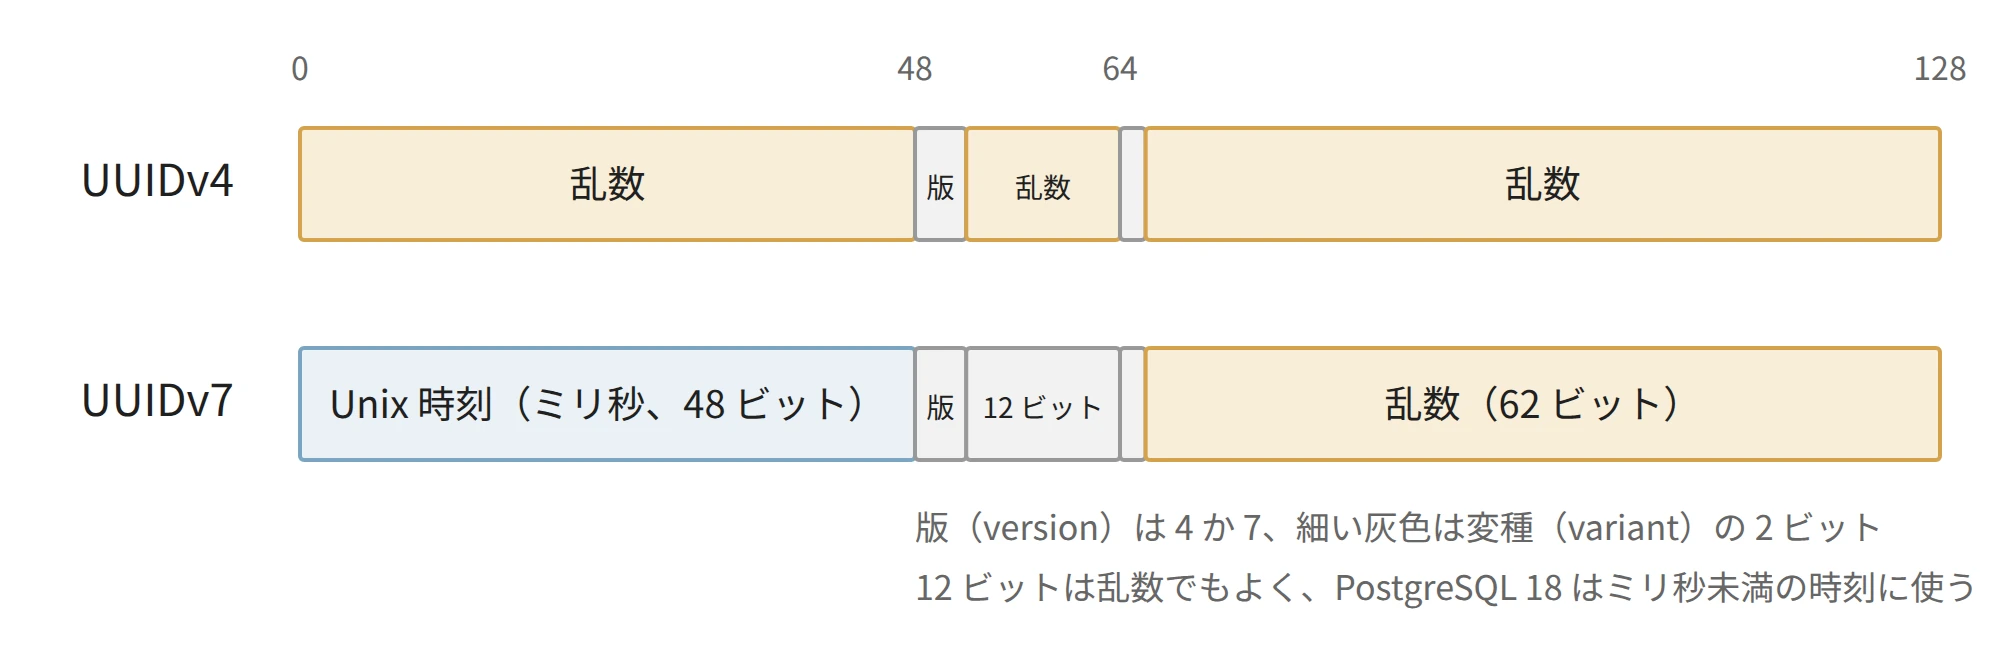
UUIDv4 と UUIDv7 の 128 ビットの使い道(RFC 9562 の 5.4 節と 5.7 節)
UUIDv4 は、ほぼ全てが乱数です。続けて作った値でも、大小の関係はでたらめになります。UUIDv7 は、先頭の 48 ビットに 1970 年からのミリ秒(Unix 時刻)が入るので、後に作った値ほど大きくなります。RFC 9562 は、v7 のような時刻順の UUID が要る理由として、v4 は「DB の索引での局所性が悪く」、B-tree への影響が「劇的になり得る」と書いています。
PostgreSQL 18 では、uuidv4() と uuidv7() の 2 つの関数で、DB の中で両方を作れます。5 件ずつ作ると、次の通りでした。
SELECT uuidv4() AS v4, uuidv7() AS v7 FROM generate_series(1, 5);
                  v4                  |                  v7
--------------------------------------+--------------------------------------
 5597e9b5-9449-4f42-b12f-6eaf58644ee2 | 01a1ca26-afd5-7ea6-811a-36764d9a44a3
 680185fc-c834-481a-a582-0398c55b12ae | 01a1ca26-afd5-7ec9-a546-13b0c00caea2
 af686a58-16e0-4c49-9814-f8498faadd58 | 01a1ca26-afd5-7ed5-95e5-51b2506ff485
 1e3a31de-91db-4e74-bcfe-ead6888e634a | 01a1ca26-afd5-7ee0-830e-45e0119798e1
 a92efe57-1a46-4cf2-871b-296a3e8e7c62 | 01a1ca26-afd5-7eed-8e00-0e149fec855a
16 進数の 1 桁は 4 ビットなので、先頭の 48 ビットは、ハイフンを除いた先頭の 12 桁です。v7 は、先頭の 01a1ca26-afd5 が時刻の部分で、5 件とも同じミリ秒に作られています。その後ろの 7 が版です。続く 3 桁(12 ビット、ea6・ec9・ed5…)が増えていくのは、PostgreSQL が図の 12 ビットにミリ秒未満の時刻を入れているからです。v4 は、先頭の桁から順序がばらばらです。
新しい値が索引のどこに入るか
主キーには、値の順に並んだ B-Tree の索引が作られます。索引の一番下の段(葉)では、キーが値の順に並び、ブロックに詰められています(木の形は B-Tree のノートで説明しています)。
新しい行を入れると、そのキーは値の順で収まる葉のブロックに書き込まれます。連番と UUIDv7 は、新しい値ほど大きいので、いつも右端の葉に入ります。UUIDv4 は値がでたらめなので、100 万件の索引のどこに入るかもでたらめです。
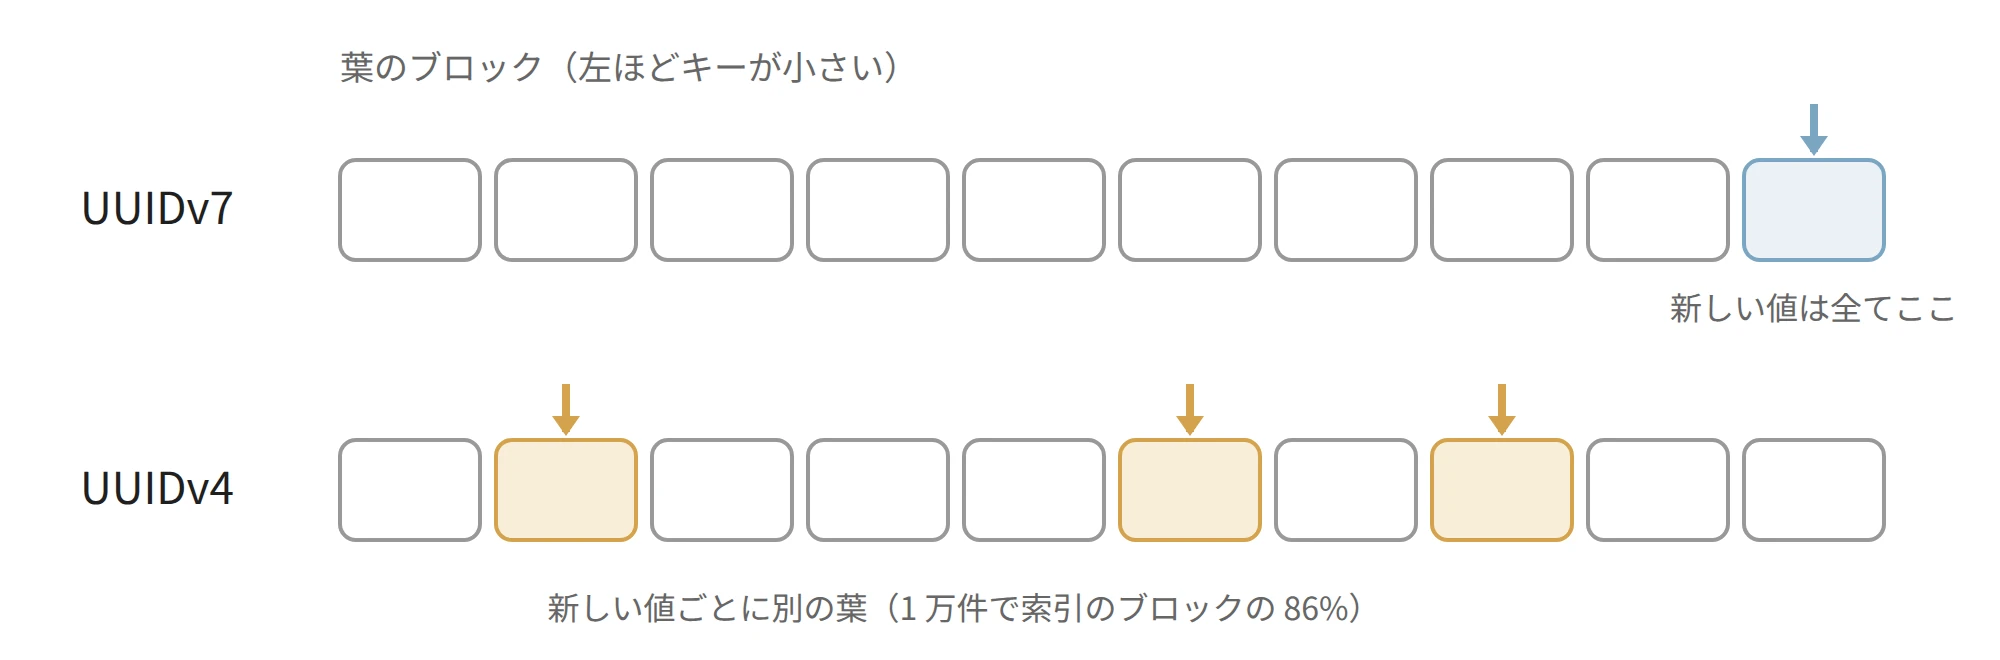
新しい値が入る葉(キーの順に並べた模式図)
葉が満杯になると、PostgreSQL はブロックを 2 つに分け(分割)、新しいブロックは多くの場合、ファイルの末尾に足します。右端にしか入れない索引では、キーの順の右端が、ファイルの末尾の新しいブロックになります。 冒頭の図の横軸はファイルの中の番号なので、連番と UUIDv7 は帯の末尾だけが塗られました。離れた 1 本の線は、分割のたびに新しいブロックへの道を書き足す、葉の 1 つ上の段(中間)のブロックです。UUIDv4 は葉のどこにでも入るので、帯の全体が塗られました。
散らばった書き込みと WAL・メモリ
書き換えるブロックが散らばると、まず WAL が増えます。WAL(Write-Ahead Log)は、DB が変更を表や索引のファイルに書く前に追記する変更の記録で、障害の後はこれを読み直して復旧します。
チェックポイントは、メモリ上で書き換えたブロックをまとめて表と索引のファイルに書き出し、復旧を始める位置を決める処理です。既定では 5 分ごと(checkpoint_timeout)か、WAL が一定の量に達した時に走ります。
PostgreSQL の既定の設定(full_page_writes)では、チェックポイントの後で各ブロックを最初に書き換える時だけ、変更の差分ではなくブロックの内容 8 KB を丸ごと WAL に書きます。書き込みの途中で OS が落ちて、半分だけ書かれたブロックが残っても直せるようにするためです。以下は、その流れを時間に沿って描いた図です。
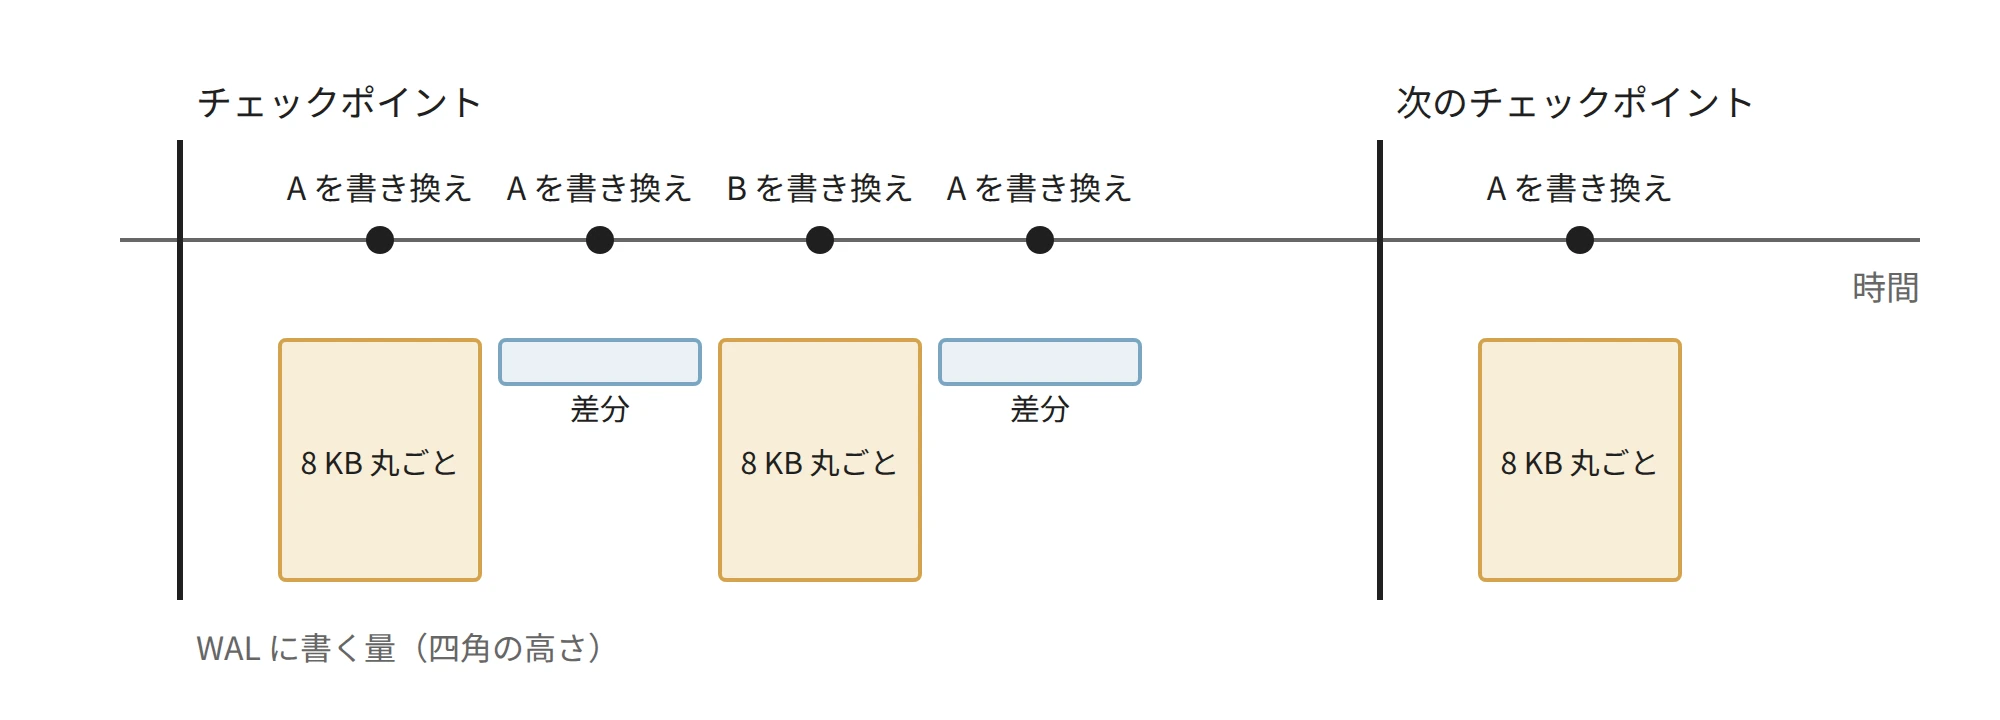
チェックポイントの後、ブロックごとに最初の書き換えだけ 8 KB を丸ごと書く
丸ごと書くのはブロックごとに 1 回なので、WAL の量は、チェックポイントの後にいくつの異なるブロックを書き換えたかで、ほぼ決まります。動き続けるサーバーでは、この「チェックポイントの直後」が 5 分ごとに来ます。
実験では、CHECKPOINT を実行した直後に 1 万件を足し、その間に増えた WAL の量と、書き換わったまま(まだファイルに書き出していない)索引のブロックの数を数えました。WAL には表の変更も入るので、索引のブロックがほとんど散らばらない連番の値が、表の分を含めた基準になります。
SELECT a.*, pg_relation_size(a.key_type || '_pkey') / 8192 AS index_pages FROM add_result AS a;
 key_type | dirty_index_pages | wal_mb | index_pages
----------+-------------------+--------+-------------
 t_bigint |                29 |    1.6 |        2772
 t_v4     |              4220 |   25.3 |        4923
 t_v7     |                40 |    1.7 |        3891
dirty_index_pages が書き換わった索引のブロックの数、wal_mb が WAL の量(MB)、index_pages が索引の全ブロック数です。UUIDv4 は 4,220 ブロックを書き換え、WAL は 25.3 MB でした。4,220 ブロック × 8 KB は約 33 MB です。丸ごと書く時はブロックの中の空きを省くので、7 割ほど埋まったブロックを全て書いたとすると、20 MB 台になります。数字は、書き換えたブロックのほぼ全てが丸ごと WAL に書かれたことと合います。UUIDv7 は 1.7 MB で、連番の 1.6 MB とほとんど同じです。
散らばったブロックは、メモリにも効きます。PostgreSQL は、表と索引のブロックを共有のメモリ(shared buffers)に置いて読み書きします。右端にしか書かない索引なら、置いておくべきブロックは右端の数十個で済みます。UUIDv4 の索引では、索引の全体が書き込み先になるので、全体をメモリに置けないと、入れるたびにディスクからブロックを読むことになります。
今回の 100 万件の索引(最大 38 MB)は、既定の shared buffers(128 MB)に収まる大きさです。それでも 100 万件を入れる時間は、連番の 4.31 秒、UUIDv7 の 5.51 秒に対して、UUIDv4 は 8.00 秒でした。索引がメモリに収まらない大きさでは今回は測っていませんが、入れるたびにディスクからブロックを読む分が、この差に加わるはずです。
索引の大きさ
書き込む位置の違いは、索引の大きさにも残ります。100 万件を入れた後の主キーの索引を、拡張機能 pgstattuple の pgstatindex() で調べた結果は、次の通りです。
     index     | size  | leaf_pages | avg_leaf_density | leaf_fragmentation
---------------+-------+------------+------------------+--------------------
 t_bigint_pkey | 21 MB |       2733 |            90.01 |                  0
 t_v4_pkey     | 38 MB |       4870 |            70.87 |              49.96
 t_v7_pkey     | 30 MB |       3832 |            89.98 |                  0
avg_leaf_density は葉のブロックの平均の充填率(%)です。UUIDv7 は連番と同じ 90% まで埋まり、UUIDv4 は 71% でした。
葉が満杯になると、ブロックを 2 つに分けて(分割)キーを移します。途中のブロックが割れる時はキーをおおむね半分ずつに分けるので、ランダムな位置に入る UUIDv4 の葉は、半分空いたブロックが増えます。右端のブロックが割れる時は、PostgreSQL は左のブロックを fillfactor(B-Tree の既定は 90%)まで詰めたまま残します。この仕組みは、B-Tree のノートの 挿入の順序とページの埋まり方 で整数を使って確かめています。UUID でも同じことが起きました。
leaf_fragmentation は、葉のブロックの並び(キーの順)と、ファイルの中のブロックの番号の順がずれている割合です。UUIDv4 は 50% で、範囲を順に読む時にファイルの中を飛び回ることになります。
連番に残る差は 16 バイト
UUIDv7 で書き込み先の問題は無くなりますが、大きさの差は残ります。UUID は 16 バイトで、bigint の 8 バイトの 2 倍です。表を見ると、同じ 90% の充填率でも、索引は連番の 21 MB に対して UUIDv7 は 30 MB でした。2 倍にならないのは、索引の 1 件にキーの他に、ヘッダと表のレコードの位置(合わせて 8 バイト)と、ブロックの中の位置を指す 4 バイトが付くからです。1 件は連番で 20 バイト、UUID で 28 バイトになり、約 1.4 倍です。
この差は主キーの索引だけで終わりません。他の表から外部キー(Foreign Key)で参照すると、参照する側の列も、その列の索引も 16 バイトになります。bigint の親の表を参照する子の表と、UUIDv7 の親の表を参照する子の表を 1 つずつ作り、親と同じ 101 万件(100 万件に、後で足した 1 万件)を入れて、参照する列に索引を付けて比べました。
       relname       | size
---------------------+-------
 c_bigint            | 43 MB
 c_bigint_parent_idx | 22 MB
 c_bigint_pkey       | 22 MB
 c_v7                | 58 MB
 c_v7_parent_idx     | 30 MB
 c_v7_pkey           | 30 MB
子の表は、主キーと参照する列の 2 つが UUID になるので、43 MB から 58 MB に増えました。索引も、どちらも 22 MB から 30 MB です。参照の多い設計では、この 16 バイトの差が表と索引の数だけ掛かります。
値に入った時刻
UUIDv7 の先頭は時刻なので、値から作った時刻が読めます。PostgreSQL 18 の uuid_extract_timestamp() で取り出すと、次の通りです。
SELECT u, uuid_extract_version(u) AS version, uuid_extract_timestamp(u) AS ts
FROM (VALUES (uuidv4()), (uuidv7())) AS t(u);
                  u                   | version |             ts
--------------------------------------+---------+----------------------------
 a1d2c0d5-583b-4a89-b128-ac5664aa0bc9 |       4 |
 01a1ca26-afd6-750c-bc4e-9a857ccd8ee4 |       7 | 2026-11-11 10:28:15.446+00
関数を使わなくても、先頭の 12 桁を 16 進数として読めばミリ秒の時刻です。ユーザーや注文の ID を URL に出す場合、その ID から登録や注文の時刻が分かります。登録の時刻を知られたくない ID は、UUIDv4 にするか、外に出す ID と主キーを分けます。
なお、RFC 9562 は、UUID を推測されにくい値として扱わないよう求めています。持っているだけでアクセスできる鍵(security capabilities)として使ってはならない、と書かれています(8 節)。PostgreSQL 18 の UUIDv7 は、乱数が 62 ビットに減っているので、なおさらです。招待リンクやパスワード再設定のトークンには、UUID ではなく、十分な長さの乱数を使います。
値の順序はどこまで保証されるか
UUIDv7 が時刻順に並ぶのは、同じ時計で作った値どうしの話です。PostgreSQL 18 の実装は、同じ接続(セッション)の中では、前に作った値の時刻を覚えておき、時計がそれより十分に進んでいなければ、ミリ秒未満の 12 ビットの最小単位(Linux では約 0.24 マイクロ秒)だけ進めた時刻を使います(uuid.c)。 これで、同じ接続の値は前の値より必ず大きくなります。RFC 9562 が単調に並べる方法として挙げるうちの、ミリ秒未満の時刻を使う方法です。1 つの接続で 10 万件を続けて作ると、次の通りでした。
 total | ascending | distinct_ms
-------+-----------+-------------
 99999 |     99999 |         115
隣り合う 99,999 組の全てで後の値が大きく、10 万件は 115 ミリ秒の間に作られていました。同じミリ秒の中に平均 870 件ほどがありますが、順序は崩れていません。
接続が違えば、この保証はありません。前の値の記録は接続ごとなので、時計が補正で戻った時や、ある接続が時計より先に進めた値を作った直後に別の接続が時計どおりの値を作った時、2 つの接続が同じ約 0.24 マイクロ秒の中で値を作った時(大小は後ろの乱数で決まる)には、別の接続の値どうしで大小が前後します。アプリのサーバーが複数台あってそれぞれで UUIDv7 を作るなら、さらにサーバー間の時計のずれの分だけ前後します。RFC 9562 も、1 つの DB を使うアプリでは、DB の中で作った UUID が最もよく単調に並ぶ、と書いています(6.13 節)。
索引にとっては、順序が多少前後しても困りません。新しい値が右端の数ブロックの中に入れば、書き込み先は散らばらないからです。困るのは、UUIDv7 の順を「作った順」として使う場合です。作った順が要るなら、時刻の列や連番を別に持ちます。
利点
- 新しい値が索引の右端に入るので、書き換えるブロックが連番と同じ程度に収まる
- チェックポイントの後の WAL の量が UUIDv4 より大幅に少ない
- 葉の充填率が fillfactor まで上がり、索引が UUIDv4 より小さい
- DB に問い合わせずにアプリ側で作れ、複数の DB で作っても衝突しない
欠点
UUIDv7 は、乱数の一部を時刻に置き換えることで、UUID のまま索引の右端に書けるようにした ID です。その代わりに、次の制約があります。
bigintの 2 倍の 16 バイトで、主キー・外部キー・その索引の全てが大きくなる- 値から作った時刻が読める
- 乱数が減り(PostgreSQL 18 の実装では 62 ビット)、推測されにくさを求める用途にはなおさら向かない
- 複数のサーバーで作ると、時計のずれの分だけ順序が前後する
UUIDv7 の効果が小さい、または向かないケース
- 1 つの DB の中だけで ID を作り、外に出さない表(
bigintの連番の方が小さい) - 件数が少なく、索引の全体が常にメモリに載っている表
- 作った時刻を外に知られたくない ID(UUIDv4 や、外に出す ID を分ける方が良い)
- 既に UUIDv4 で作られた大量の行がある表(新しい行だけ v7 にしても、古い行の並びは変わらない)
UUIDv4 から UUIDv7 への切り替えは、値の型が同じ uuid なので、列の既定値を変えるだけで始められます。ただし、既に入っている v4 の値は索引の全体に散らばったままです。v7 の値は先頭が時刻(今なら 01 から始まる値)なので、索引の中では v4 の値に挟まれた一か所に固まって入り、書き込み先は散らばらなくなります。ただし、そこは右端ではないので、葉の分割はキーを半分ずつに分ける方になり、v7 の値が入った葉は約 50% しか埋まりません。v4 で 100 万件を入れた後に v7 で 20 万件を足して試すと、葉の平均の充填率は 70.6% から 66.1% に下がりました。v4 の行を全て消して VACUUM すると、残った v7 の葉は 50.1% でした。90% に戻すには、索引を作り直す(REINDEX)必要があり、作り直すと 89.9% になりました(lab/output_switch.txt)。
実験の SQL・実行用のスクリプト・出力の全体は lab/ にあります。