会員の表に、紹介してくれた会員の id を入れる referred_by というカラムがあります。紹介を受けずに入会した会員は NULL です。この表から「まだ誰も紹介していない会員」を数える SQL を書きました。何件返るか、予想してみてください。
SELECT count(*) FROM members
WHERE id NOT IN (SELECT referred_by FROM members);
| id | name | referred_by | score | |
|---|---|---|---|---|
| 1 | sato | sato@example.com | NULL | 80 |
| 2 | suzuki | suzuki@example.com | 1 | NULL |
| 3 | takahashi | NULL | 1 | 60 |
| 4 | tanaka | NULL | NULL | 90 |
| 5 | ito | ito@example.com | 2 | NULL |
referred_by に入っている id は 1 と 2 だけなので、誰も紹介していないのは 3・4・5 の 3 人です。ところが、手元の PostgreSQL 18・MySQL 8.4・SQLite 3.46・DuckDB 1.5 で実行すると、4 つとも 0 件でした。同じ問いを NOT EXISTS で書くと、4 つとも 3 件です。
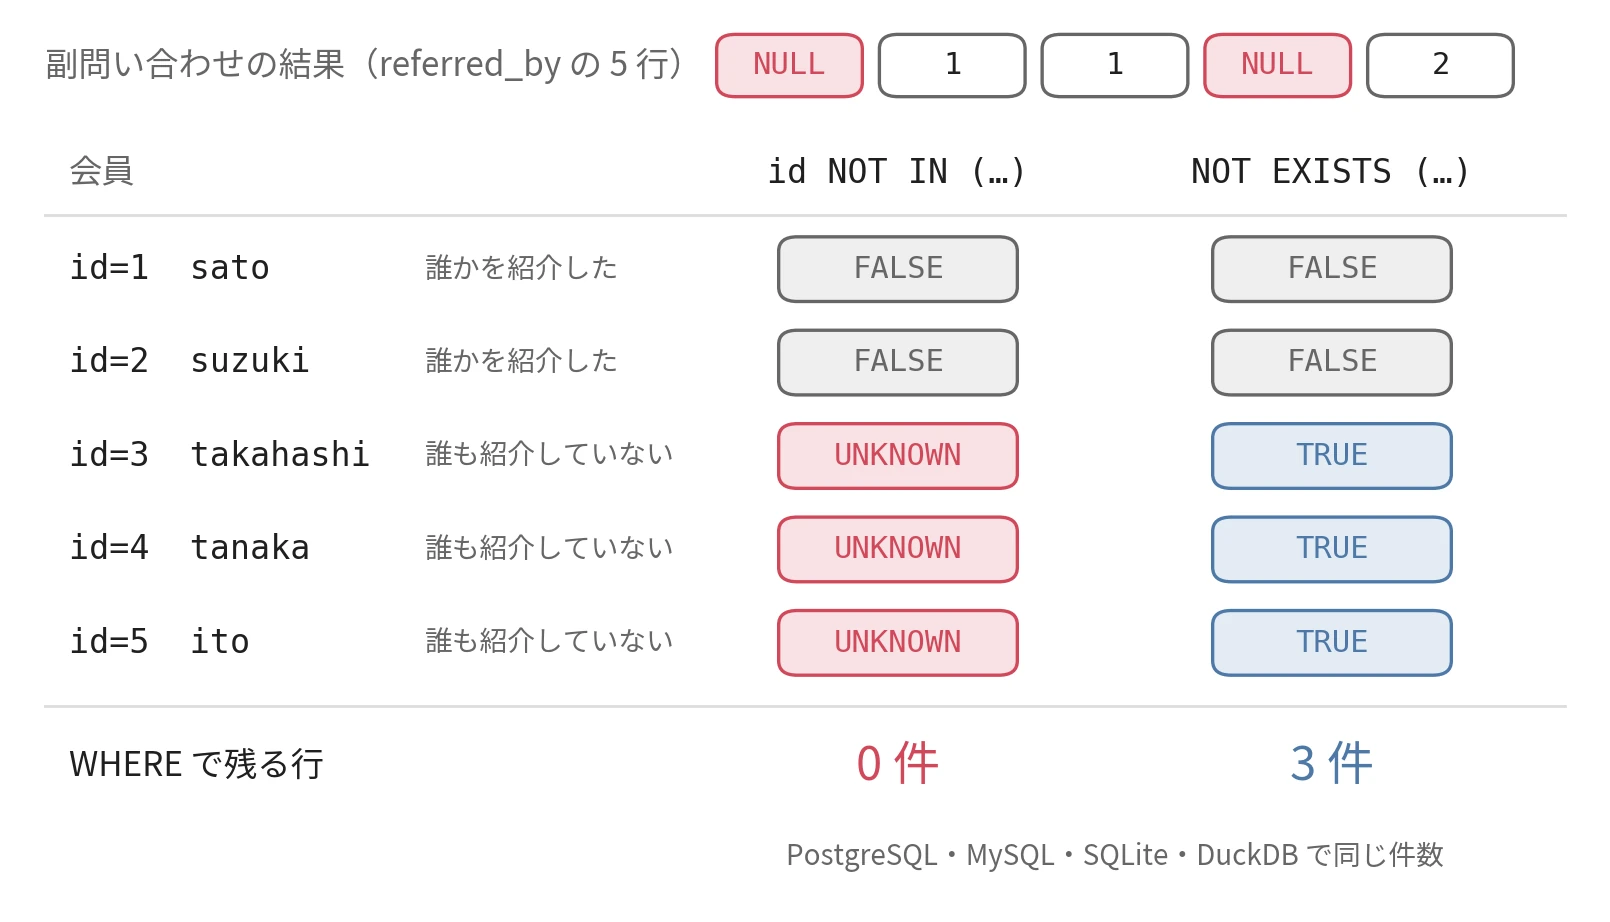
誰も紹介していない会員を NOT IN と NOT EXISTS で数えた結果
図の UNKNOWN は、TRUE でも FALSE でもない 3 つ目の結果です。副問い合わせ(subquery、SQL の中に入れた SELECT)が返す 5 行に NULL が 2 つ混ざったことで、3・4・5 の 3 人の条件が UNKNOWN になり、結果から消えました。
エラーも警告も出ず、件数が少なく返るだけなので、NULL を含まないテストのデータでは正しく動きます。紹介を受けない会員が初めて登録された日から、本番の結果だけが 0 件になります。
本記事では、SQL を書くアプリケーションの開発者と、既存のシステムで NULL が原因で件数が合わない場面に出会った人に向けて、次の疑問に答えます。
NULLとの比較は、何を返すのか。NOT INが 0 件を返すのは、なぜか。WHEREで消えるNULLが、CHECKやUNIQUEを通るのはなぜか。- 集計と並べ替えで、
NULLはどう数えられ、どこに並ぶのか。 NOT INの問題は、件数のほかに何があるのか。NULLを許すカラムを作る時に、何を決めておくか。
実験では、同じ SQL を 4 つの DBMS(Database Management System)で実行し、結果を並べました。
3 つ目の真理値 UNKNOWN
NULL は、カラムに値が入っていないことを表す印です。数値の 0 や空の文字列は値なので、NULL とは別に扱われます。NULL と何かを比べると、結果は TRUE でも FALSE でもない UNKNOWN になります。
NULL = NULL も UNKNOWN です。SQL は UNKNOWN を NULL として返すので、NULL = NULL を計算すると、4 つの DBMS で NULL が返りました。値が分からない 2 つが等しいかどうかは分からない、という扱いです。
WHERE email = NULL と書くと、どの行でも UNKNOWN になり、1 行も返りません。NULL かどうかは、TRUE か FALSE だけを返す専用の述語 IS NULL・IS NOT NULL で調べます。
TRUE・FALSE・UNKNOWN の 3 つで条件を評価する仕組みは、三値論理(three-valued logic)と呼ばれます。UNKNOWN が AND・OR・NOT を通ると、次の結果になります。
| A | B | A AND B | A OR B | NOT A |
|---|---|---|---|---|
| TRUE | UNKNOWN | UNKNOWN | TRUE | FALSE |
| FALSE | UNKNOWN | FALSE | UNKNOWN | TRUE |
| UNKNOWN | UNKNOWN | UNKNOWN | UNKNOWN | UNKNOWN |
表は、UNKNOWN を「TRUE と FALSE のどちらかだが、どちらか分からない」と読めば覚えなくて済みます。FALSE AND B は B が何であっても FALSE なので、FALSE と決まります。TRUE AND B は B 次第なので、決まらずに UNKNOWN のままです。NOT も、反転できるのは TRUE と FALSE だけで、UNKNOWN は UNKNOWN のまま残ります。
WHERE は、条件が TRUE になった行だけを残します。FALSE と UNKNOWN は区別されず、どちらも捨てられます。例えば、アドレスが sato@example.com でない会員を数える次の SQL は、5 人のうち 4 人を返しそうに見えますが、4 つの DBMS で 2 件でした。
SELECT count(*) FROM members WHERE email <> 'sato@example.com'; -- 2
email が NULL の takahashi と tanaka は、比較が UNKNOWN になって消えます。NULL の会員も数えたいなら、email IS NULL OR email <> 'sato@example.com' と書くか、IS DISTINCT FROM を使います。
IS DISTINCT FROM は NULL を 1 つの値として比べ、TRUE か FALSE だけを返す演算子です。PostgreSQL・SQLite・DuckDB は受け付け、MySQL 8.4 は構文エラーでした。MySQL では、NULL どうしを等しいと見なす <=> を使い、NOT (email <=> 'sato@example.com') と書きます。
NOT IN が 0 件になる仕組み
x NOT IN (a, b, c) は、x <> a AND x <> b AND x <> c と同じ意味です。冒頭の SQL では、副問い合わせの結果が (NULL, 1, 1, NULL, 2) なので、会員 id=3 の条件は次のように展開されます。
3 <> NULL  AND  3 <> 1  AND  3 <> 1  AND  3 <> NULL  AND  3 <> 2
UNKNOWN    AND  TRUE    AND  TRUE    AND  UNKNOWN    AND  TRUE   →  UNKNOWN
AND でつないだ中に UNKNOWN が 1 つでもあると、全体は FALSE か UNKNOWN にしかならず、TRUE にはなりません。リストに NULL が入った時点で、NOT IN はどの行でも TRUE を返せなくなります。
逆向きの IN は OR でつながるので、この問題が起きません。id IN (SELECT referred_by FROM members) は、id=1 なら 1 = 1 が TRUE で全体も TRUE になり、4 つの DBMS で正しく 2 件を返しました。IN で正しく動いていた条件に NOT を付けた途端に、0 件になります。
NOT EXISTS は、条件に合う行が 1 行でもあるかを問います。EXISTS が返すのは TRUE か FALSE だけで、副問い合わせの中で比較が UNKNOWN になった行は、合う行に数えないだけです。次の 3 つの書き方は、4 つの DBMS で全て 3 件を返しました。
-- 1. NOT EXISTS
SELECT count(*) FROM members m
WHERE NOT EXISTS (SELECT 1 FROM members r WHERE r.referred_by = m.id);

-- 2. 副問い合わせから NULL を除いた NOT IN
SELECT count(*) FROM members
WHERE id NOT IN (SELECT referred_by FROM members WHERE referred_by IS NOT NULL);

-- 3. LEFT JOIN で相手が見つからない行
SELECT count(*) FROM members m
LEFT JOIN (SELECT DISTINCT referred_by FROM members) r ON r.referred_by = m.id
WHERE r.referred_by IS NULL;
ただし、NOT EXISTS へ書き換えると結果が変わる行もあります。それは NOT IN の左に書いたカラムが NULL の行です。例えば referred_by NOT IN (SELECT id FROM members) なら、referred_by が NULL の sato と tanaka が当たります。
この行は、副問い合わせが 1 行でも返せば、NOT IN では UNKNOWN で落ちます。NOT EXISTS では等しい行が見つからないので残ります。NOT IN の左が NULL になる行を 1 行だけ用意した実験では、4 つの DBMS で NOT IN が 0 件、NOT EXISTS が 1 件でした。
NOT IN は、PostgreSQL の Wiki の「Don’t Do This」で、避けるべき SQL の書き方の最初に挙げられ、NOT EXISTS への書き換えが勧められています。理由は 2 つで、1 つは上の 0 件、もう 1 つは後の節で測る実行時間です。IS NOT NULL で NULL を除いた NOT IN は件数こそ正しく返しますが、遅さは残ります。
ORM が組み立てる NOT IN
SQL を手で書かず、ORM(Object-Relational Mapping)を使っていても同じことが起きます。以下は、Python の SQLAlchemy 2.1 で、同じ問いを 2 通りに書いたコードの抜粋です。referred_by は Mapped[int | None] で、NULL を許すカラムとして宣言しています。
# 書き方 1: 「紹介者の id の一覧に入っていない会員」
q1 = select(Member.name).where(Member.id.not_in(select(Member.referred_by)))
# 書き方 2: 「その会員を紹介者に持つ行が存在しない会員」
r = aliased(Member)
q2 = select(Member.name).where(~exists().where(r.referred_by == Member.id))
SQLite の上で実行すると、組み立てられた SQL と結果は次の通りでした(出力は抜粋)。
-- not_in
WHERE (members.id NOT IN (SELECT members.referred_by FROM members))
=> []
-- not_exists
WHERE NOT (EXISTS (SELECT * FROM members AS members_1 WHERE members_1.referred_by = members.id))
=> ['takahashi', 'tanaka', 'ito']
not_in は名前の通り NOT IN に変換され、空の一覧を返しました。SQLAlchemy はカラムが NULL を許すことを知っていますが、NOT IN を書き換えたり警告を出したりはしませんでした。referred_by は他の会員を指す外部キーにもしています。外部キー制約は NULL を拒まないので、Foreign Key を張っていても、この 0 件は防げません。
OUTER JOIN が作る NULL
NULL は、表に保存された値からだけ生まれるわけではありません。LEFT JOIN は、結合の相手が見つからない行も残し、相手のカラムを NULL で埋めます。前に挙げた LEFT JOIN の書き方は、この NULL を使っていました。結合が作った NULL も、WHERE での扱いは保存された NULL と同じです。
例えば、会員に紹介者を結合し、紹介者が sato の会員だけを除くつもりで WHERE を足すと、4 つの DBMS で次の件数になりました。
SELECT count(*) FROM members m
LEFT JOIN members r ON r.id = m.referred_by;               -- 5
-- 上に WHERE r.name <> 'sato' を足す                       -- 1
-- 上に WHERE r.name IS DISTINCT FROM 'sato' を足す         -- 3
紹介者のいない sato と tanaka は、結合で r.name が NULL になり、<> の比較が UNKNOWN になって消えます。残ったのは ito の 1 件だけで、LEFT JOIN で残したはずの行を WHERE が落とし、内部結合と同じ結果になりました。IS DISTINCT FROM で書けば、紹介者のいない 2 人も残って 3 件です。
同じ r.name <> 'sato' を ON r.id = m.referred_by AND r.name <> 'sato' のように ON に書くと、4 つの DBMS で 5 件でした。LEFT JOIN の ON は結合の相手を選ぶ条件なので、条件が UNKNOWN でも左の会員は捨てられず、相手を NULL で埋めて残ります。絞り込みたい条件は WHERE に、相手を選ぶ条件は ON に書きます。
結合が作った NULL と、相手の表に保存された NULL は、r.name を見ても区別できません。相手が見つかったかどうかは、NULL になり得ない相手の主キー(r.id)が NULL かどうかで判断します。結合と、後の節で見る 0 行の集計は、NOT NULL のカラムからも NULL を作ります。
CHECK・UNIQUE・GROUP BY での NULL
WHERE で捨てられた UNKNOWN は、制約やグループ分けの中では別の扱いを受けます。以下は、同じ表に 4 つの仕組みを当てた時の、UNKNOWN と NULL の行き先です。
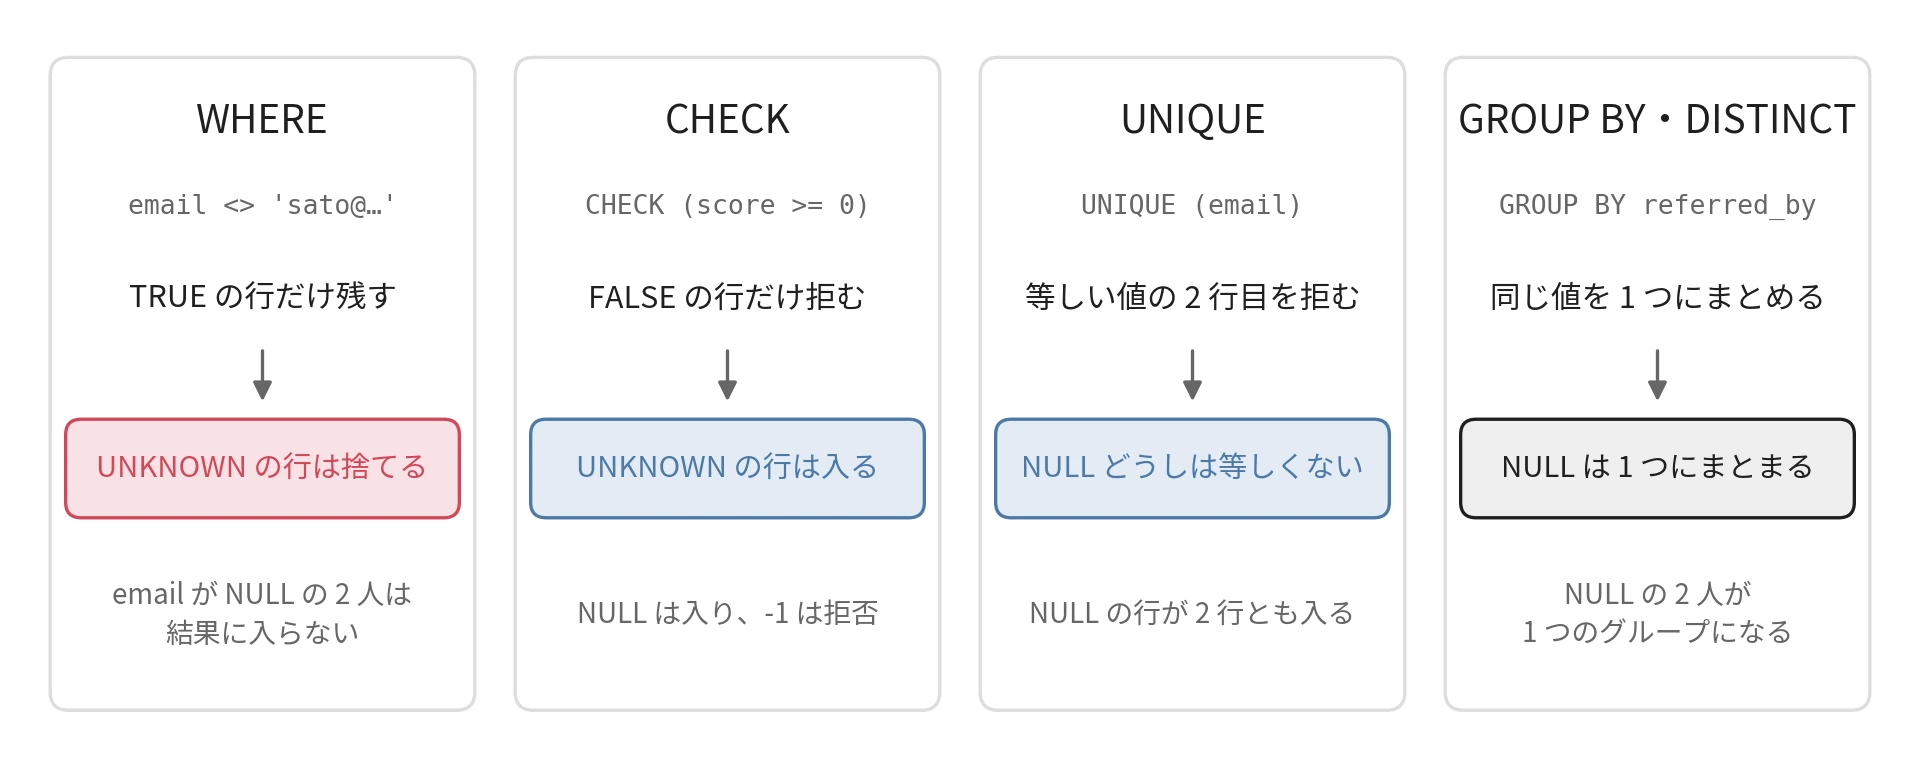
UNKNOWN と NULL が、WHERE・CHECK・UNIQUE・GROUP BY でどう扱われるか
図の左端にある WHERE は、TRUE の行だけを残します。内部結合の ON も同じですが、前の節で見たとおり、LEFT JOIN の ON は相手を選ぶだけで左の行を残します。
これに対して、CHECK 制約は FALSE の行だけを拒みます。PostgreSQL の文書には「a check constraint is satisfied if the check expression evaluates to true or the null value」(CHECK 制約は、式が真か NULL になれば満たされる)とあります。
実験でも、CHECK (score >= 0) を付けたカラムに NULL は 4 つの DBMS で入り、-1 は 4 つとも拒否されました。CHECK (score >= 0) は「値があれば 0 以上」という意味で、値があることまでは求めません。値を必須にするなら NOT NULL を別に付けます。
UNIQUE は NULL を重複と見なさない
PostgreSQL・MySQL・SQLite・DuckDB の一意制約は、既定では = と同じく NULL どうしを等しいと見なしません。UNIQUE を付けたカラムに NULL の行を 2 つ入れると、4 つの DBMS で 2 行とも入りました。
CREATE TABLE u (email VARCHAR(50) UNIQUE);
INSERT INTO u VALUES (NULL);
INSERT INTO u VALUES (NULL);  -- 4 つの DBMS で通る
アドレスを任意入力にした会員の表では、未入力の会員が何人いても登録できるので、多くの場合はこの扱いが望ましい動きです。重複を防ぐ仕組みの全体は、UNIQUE Constraint のノートで扱っています。
一意制約が NULL を何件許すかは、SQL 標準が決めずに DBMS に任せている所です。PostgreSQL の文書にも「The default null treatment in unique constraints is implementation-defined according to the SQL standard」(一意制約が null をどう扱うかの既定は、SQL 標準では実装定義)とあります。
NULL を 1 つまでにしたい時の手段も、DBMS ごとに違います。PostgreSQL 15 以降は UNIQUE NULLS NOT DISTINCT と書くと 2 つ目の NULL を拒み、実験の PostgreSQL 18 でも重複のエラーになりました。MySQL・SQLite・DuckDB では、この構文自体が構文エラーです。
CREATE TABLE u2 (email VARCHAR(50) UNIQUE NULLS NOT DISTINCT);
INSERT INTO u2 VALUES (NULL);
INSERT INTO u2 VALUES (NULL);  -- PostgreSQL 18 は重複のエラー
反対に、SQL Server は既定で NULL を 1 つしか許しません。Microsoft の文書には「only one null value is allowed per column」(1 つのカラムに NULL は 1 つまで)とあります。SQL Server から PostgreSQL へ移すと、NULL が 1 つまでという前提が黙って外れます。
主キーにも差がありました。主キーは SQL 標準では NOT NULL を含みますが、SQLite は INTEGER PRIMARY KEY・WITHOUT ROWID の表・STRICT の表などの例外を除いて、主キーのカラムに NULL を許します。code VARCHAR(10) PRIMARY KEY の表に NULL を 2 行入れると、SQLite だけが 2 行とも受け付け、他の 3 つは拒否しました。この動きは、SQLite の文書によると、初期のバージョンにあった不具合を互換のために残したものです。
GROUP BY は NULL を 1 つにまとめる
GROUP BY と DISTINCT は、= とは逆に NULL どうしを同じ値として 1 つにまとめます。GROUP BY referred_by では、紹介者のいない sato と tanaka が 1 つのグループになり、SELECT DISTINCT referred_by は NULL・1・2 の 3 行を返しました。UNION で重複を除く時も同じで、NULL の 2 行は 1 行になりました。
一方で、count(DISTINCT referred_by) は 2 です。DISTINCT は NULL を 1 つの値として残しますが、count は NULL を数えないからです。集計は NULL を数えない、という扱いを次の節で見ます。
集計で消える NULL
count(*) 以外の集約関数は、NULL の行を飛ばして計算します。冒頭に載せた表では、score は suzuki と ito が NULL です。4 つの DBMS で、次の結果になりました。
| SQL | 結果 |
|---|---|
count(*) | 5 |
count(score) | 3 |
avg(score) | 76.67 |
sum(score) * 1.0 / count(*) | 46.00 |
0 行に対する sum(score) | NULL |
avg(score) は、NULL を除いた 80・60・90 の 3 人の平均です。score の NULL が「まだ採点していない」なら 76.67 が正しく、「受けなかったので 0 点」なら 46.00 が正しい値です。どちらの SQL が正しいかは、NULL に何の意味を持たせたかで決まり、SQL からは判断できません。分析の前処理で、値の無い所を平均で埋めるか 0 で埋めるかを選ぶ話は、欠損値処理のノートで扱っています。
もう 1 つは、0 行の sum が 0 ではなく NULL になることです。PostgreSQL の文書にも「sum of no rows returns null, not zero as one might expect」(行が無い時の sum は、期待に反して 0 ではなく NULL を返す)とあります。
avg・max・min も同じで、0 行で数を返すのは count だけです。月ごとの売上を足す SQL で注文の無い月があると、画面に空欄が出るか、アプリケーション側で NULL を数値に変換する所で例外になります。
0 として扱うなら、coalesce(sum(score), 0) のように coalesce で置き換えます。coalesce は、引数のうち最初の NULL でない値を返す関数で、引数が全て NULL なら NULL を返します。
DBMS で分かれる並び順と連結
ここまでの結果は、4 つの DBMS で同じでした。分かれたのは、NULL の並び順と文字列の連結です。以下は、ORDER BY email の昇順(ASC)と降順(DESC)で、NULL がどこに並んだかの図です。
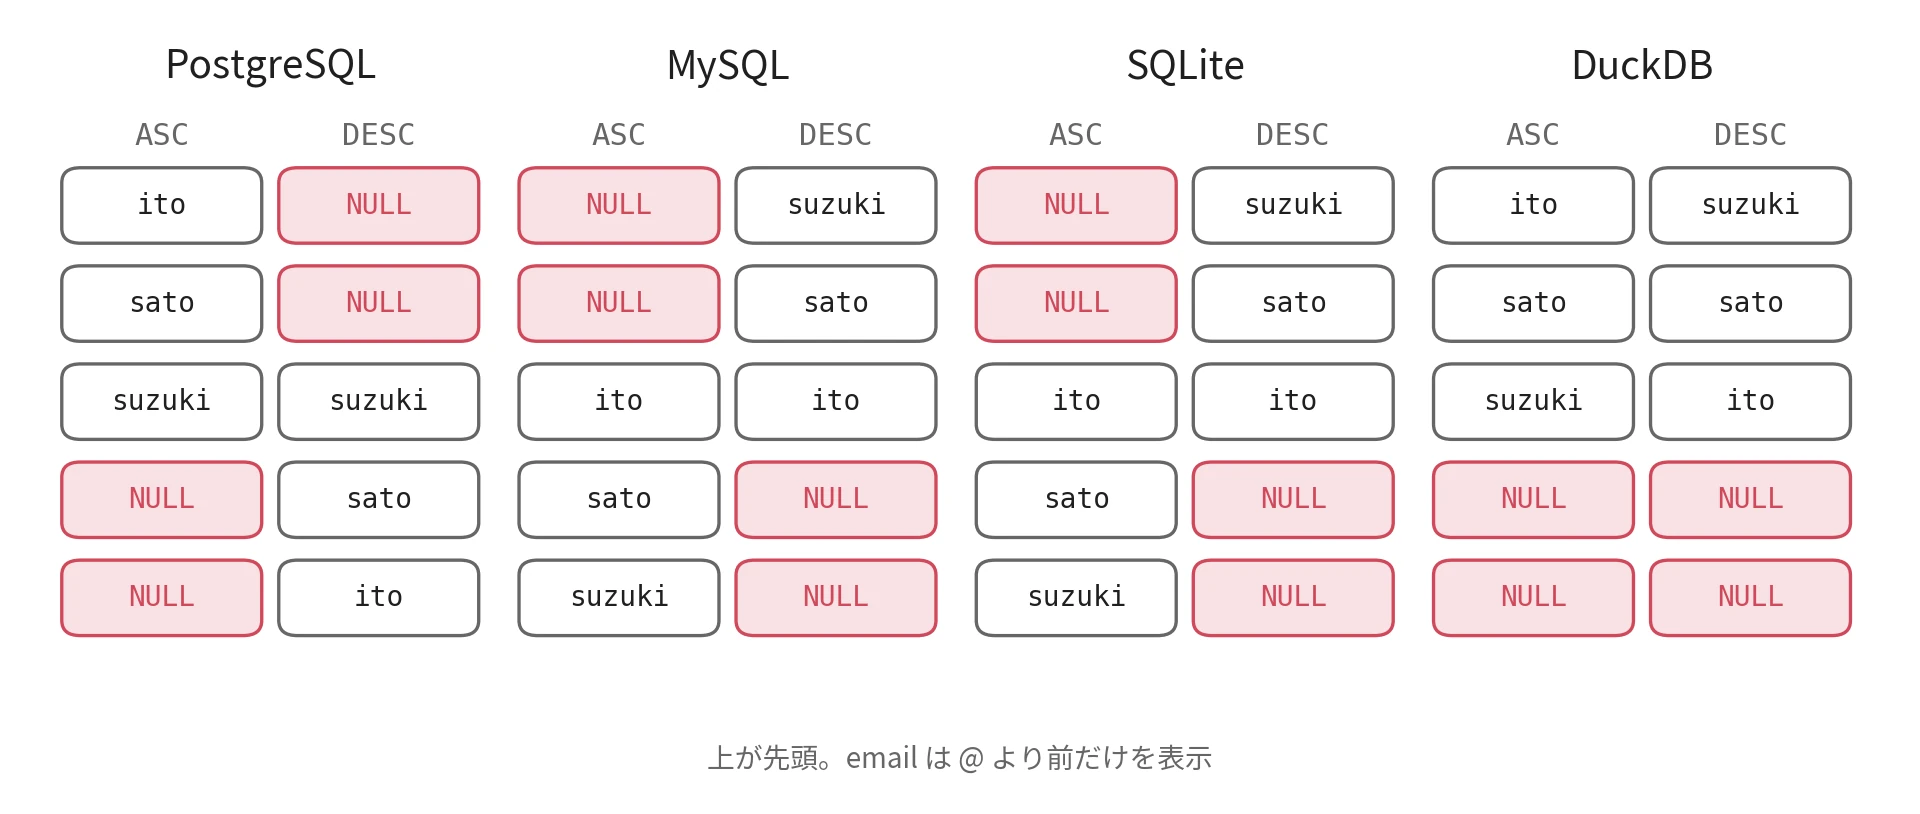
ORDER BY email で NULL が並ぶ位置(上が先頭)
PostgreSQL は、文書のとおり NULL をどの値よりも大きいものとして並べるので、昇順では末尾、降順では先頭に来ます。MySQL と SQLite は逆に NULL を最も小さいものとして扱い、昇順で先頭に来ます。SQLite の文書にも、NULL は他のどの値よりも小さいとあります。DuckDB は向きに関係なく末尾に置き、文書でも既定は NULLS LAST です。
最高点の会員を ORDER BY score DESC LIMIT 1 で取ると、PostgreSQL は点の無い suzuki を返し、他の 3 つは 90 点の tanaka を返しました。score が NULL なのは suzuki と ito の 2 人で、NULL どうしの順は決まっていないので、PostgreSQL が 2 人のどちらを返すかも保証されません。
DB を移した時や、開発に SQLite、本番に PostgreSQL を使う構成では、並び順が黙って変わります。
ORDER BY score DESC NULLS LAST と書けば、PostgreSQL・SQLite・DuckDB は 90 点の tanaka を返しますが、MySQL 8.4 は構文エラーでした。4 つ全てで同じ結果にするなら、NULL かどうかを先に並べる式を足します。
SELECT name FROM members ORDER BY score IS NULL, score DESC LIMIT 1; -- 4 つとも tanaka
score IS NULL は、値がある行で FALSE、NULL の行で TRUE になり、昇順では FALSE が先に並ぶので、NULL の会員が末尾に回ります。逆に NULL を先頭に揃えたい時は score IS NULL DESC と書きます。並べたカラムの値を手掛かりに次のページを読む Keyset Pagination では、NULL を含むカラムを並びのキーにすると、NULL の行を境目の比較で取りこぼします。
文字列の連結は、演算子の || と関数の concat で結果が割れました。
| 連結するもの | PostgreSQL | MySQL | SQLite | DuckDB |
|---|---|---|---|---|
演算子で 'a' と NULL | NULL | NULL | NULL | NULL |
演算子で 'a' と 'b' | ab | 0 | ab | ab |
concat('a', NULL) | a | NULL | a | a |
MySQL の || は既定では論理和の OR で、'a' || 'b' は文字列を数値として評価した 0 になります。sql_mode に PIPES_AS_CONCAT を足すと、ab を返しました。
concat 関数は、PostgreSQL・SQLite・DuckDB では NULL を無視し、MySQL では 1 つでも NULL があると結果が NULL になります。氏名を concat(last_name, ' ', middle_name, ' ', first_name) で組み立てると、ミドルネームの無い人の氏名が MySQL だけ空になります。
もう 1 つ、Oracle Database は長さ 0 の文字列を NULL として扱います。Oracle の文書には「The database currently treats a character value with a length of zero as null」(現状、長さ 0 の文字値を NULL として扱う)とあり、空の文字列を入れたつもりのカラムが IS NULL に当たります。
NOT IN が遅くなる行数
Wiki が挙げた 2 つ目の理由は速さです。冒頭と同じ形の表を行数を変えて作り、PostgreSQL 18 で NOT IN と NOT EXISTS の実行時間を測りました。表は会員 n 人で、referred_by の 1 割が NULL、残りは自分か自分より前の会員です。件数を揃えるため、NOT IN は副問い合わせから NULL を除く書き方にしました。
-- NOT IN
SELECT count(*) FROM big b
WHERE b.id NOT IN (SELECT referred_by FROM big WHERE referred_by IS NOT NULL);
-- NOT EXISTS
SELECT count(*) FROM big b
WHERE NOT EXISTS (SELECT 1 FROM big r WHERE r.referred_by = b.id);
work_mem は、PostgreSQL が並べ替えやハッシュ表に使うメモリの上限で、既定は 4MB です。64kB にも絞ったのは、少ない行数でも、副問い合わせの結果がメモリに収まらない状態を作るためです。既定のままと 64kB の場合を並べると、次の通りでした。
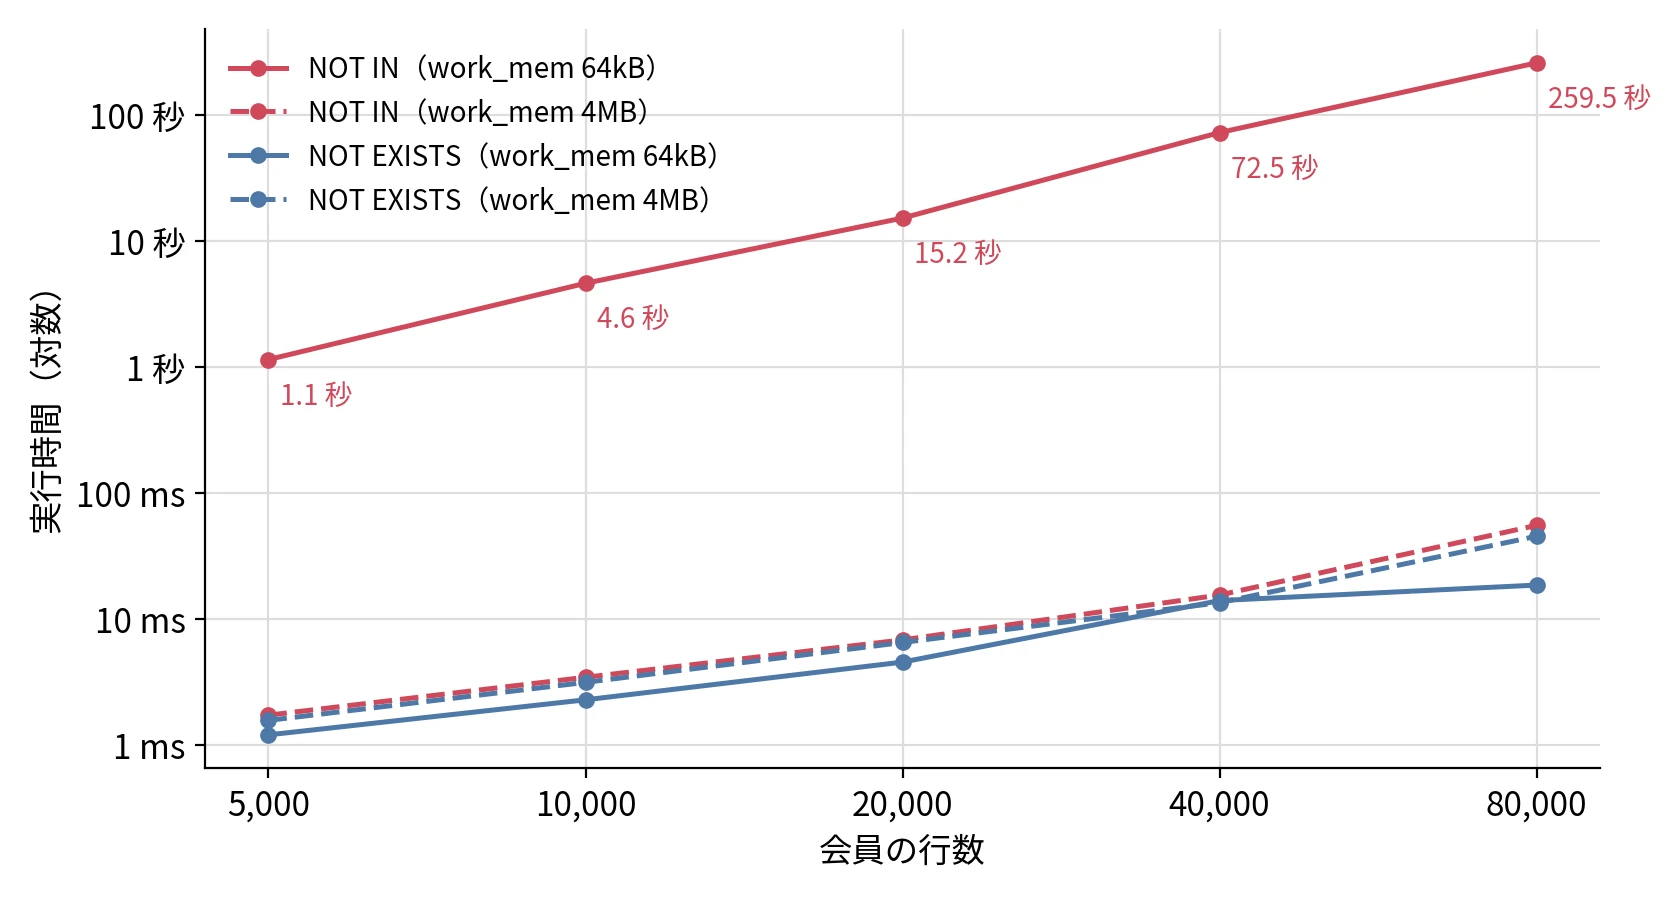
NOT IN と NOT EXISTS の実行時間(PostgreSQL 18、3 回の最小値。64kB の NOT IN は 40,000 行以上で 1 回)
64kB の NOT IN だけが、行数が 2 倍になるたびに 3〜5 倍に伸び、80,000 行で 259.5 秒掛かりました。同じ条件の NOT EXISTS は 19 ms です。20,000 行の実行計画を見ると、違いは副問い合わせの読み方にありました(出力は抜粋)。
-- NOT IN(work_mem 64kB)
Seq Scan on big b (actual rows=10506.00 loops=1)
  Filter: (NOT (ANY (id = (SubPlan 1).col1)))
  SubPlan 1
    ->  Materialize (actual rows=13746.77 loops=20000)
-- NOT EXISTS(work_mem 64kB)
Merge Anti Join (actual rows=10506.00 loops=1)
  Merge Cond: (b.id = r.referred_by)
SubPlan は副問い合わせ、その下の Materialize は副問い合わせの結果を一度ためたものです。NOT IN は、外側の 20,000 行の 1 行ごとに、このためた結果を先頭から読み直し(loops=20000)、平均で 13,747 行を読んでいます。
NOT EXISTS は、相手の見つからない行だけを残す結合(Anti Join)として、2 つの表を 1 回ずつ読むだけです。
実行計画を選ぶ部分をプランナと呼びます。プランナが NOT IN を同じ結合に書き換えないのは、リストに NULL があると 1 行も返さないという NOT IN の意味が、結合では表せないからです。副問い合わせで NULL を除いても、PostgreSQL 18 では書き換えられませんでした。実行計画の読み方は、Query Processing のノートで扱っています。
既定の 4MB では、80,000 行までの NOT IN は 55 ms で済みました。副問い合わせの結果をハッシュ表(hashed SubPlan)にして 1 回で引くからです。ただし、ハッシュ表を使うのは、それがメモリに収まると見積もった時だけです。既定の設定のまま行数を増やして EXPLAIN を見ると、250,000 行までは hashed SubPlan、300,000 行からは 1 行ごとに読み直す SubPlan に変わりました。
rows=  250000  work_mem=4MB  Filter: (NOT (ANY (id = (hashed SubPlan 1).col1)))
rows=  300000  work_mem=4MB  Filter: (NOT (ANY (id = (SubPlan 1).col1)))
20 万行で試した時は速かった NOT IN が、会員が 30 万人を超えた日から、1 行ごとに副問い合わせを読み直す計画に変わります。Wiki は、この計画の時間が行数の 2 乗で伸びる(O(N²))と書いています。境目の行数は、work_mem と副問い合わせの行の大きさで変わります。
NULL を許すカラムを作る前に
冒頭の 0 件は、referred_by に NULL が 1 つ入った時点で決まっていました。SQL を書く側から見ると、NULL を許すカラムは、それを使う全ての SQL に三値論理を持ち込みます。
最初に決めるのは、NULL を許すかどうかです。値が必ず入るカラムには NOT NULL を付けます。そのカラムを条件に使っても、カラム自身の NULL が原因で UNKNOWN になることは無くなり、読み出すコードからも NULL の分岐が減ります。ただし、OUTER JOIN が埋める NULL と 0 行の集計が返す NULL は、NOT NULL のカラムからも生まれます。
一方で、退会日時や承認日時のように、値がまだ入っていない時期が実在するカラムもあります。そこを無理に NOT NULL にすると、0 や 9999-12-31 のような特別な値を入れることになります。NULL を許すと決めたカラムで決めることは、次の 3 つです。
1 つ目は、NULL が何を表すかです。同じ NULL でも、表したいものによって正しい集計が違います。score で考えると、次の 3 通りがあります。
NULL で表すもの | score の例 | 平均の取り方 |
|---|---|---|
| まだ値が無い | 未採点 | NULL を除いた avg(score) |
| 0 と同じ | 欠席は 0 点 | NULL でなく 0 を保存する |
| 当てはまらない | 受験の対象外 | 対象外の行を母数から外す |
avg(score) の正しい値が 76.67 と 46.00 に分かれたのは、未採点と 0 点を同じ NULL で表せてしまうからです。deleted_at が NULL なら未削除という Soft Delete の約束のように、意味が 1 つなら NULL で困りません。
意味を 1 つに決められないなら、状態を表すカラムを別に持つか、紹介の関係を別の表に出して行が無いことで表します。別の表に出せば、referred_by の NULL そのものが無くなります。
NULL を避けて特別な値を入れる手もありますが、問題の場所が移るだけです。年齢に 0 を入れる設計は 0 歳の会員が現れた時点で意味が衝突し、期限の 9999-12-31 は「期限が最も遠い契約」を求めた結果に紛れ込みます。特別な値を使ってよいのは、本物の値として入り得ず、集計や範囲の比較に混ざっても意味が壊れない時だけです。
2 つ目は、NULL を許すカラムに否定の条件を書く時の形です。<> と NOT IN は UNKNOWN の行を落とすので、NOT EXISTS か IS DISTINCT FROM で書きます。ORM のメソッドが組み立てる SQL も、NOT IN になっていないかを一度は見ておきたい所です。
3 つ目は、既定の扱いに頼らず、期待する結果を SQL に書いておくことです。本記事の実験で DBMS ごとに分かれた所や、既定のままでは期待とずれた所と、その書き方は次の通りです。
| ずれる所 | 書き方 |
|---|---|
NULL の並び順 | ORDER BY score IS NULL, score DESC |
| 0 行の集計 | coalesce(sum(score), 0) |
NULL を含む連結 | coalesce で空の文字列にしてから連結 |
一意制約が許す NULL の数 | 使う DBMS の既定を確認し、要るなら制約を足す |
どれも、NULL を含まないテストのデータでは見つかりません。テストに使うデータへ NULL の行を 1 つ足して同じ SQL を流すと、冒頭の NOT IN のように件数が減る SQL が見つかります。
実験の SQL・実行用のスクリプト・出力の全体は lab/ にあります。