セマンティックレイヤー(semantic layer)は、「売上」「販売点数」のような指標の計算式と、テーブル同士のつなぎ方を一箇所に定義しておき、問い合わせのたびにその定義から集計の SQL を組み立てる層です。ダッシュボード、表計算、LLM(Large Language Model、大規模言語モデル)のエージェントは、テーブルに SQL を書く代わりに「どの指標を、どの切り口(地域別・月別のような集計の分け方)で」とだけ問い合わせます。実装には、SQL でテーブルの変換を定義・管理するツールの dbt の Semantic Layer(エンジンは OSS の MetricFlow で、手元の dbt Core と組み合わせても動く)、Looker の LookML、Cube などがあります。
この層が要るのは、例えば、会議で 2 つのダッシュボードの「10 月の売上」が食い違う時や、LLM のエージェントに地域別の支払い額を聞いたら実際の 2 倍以上の数字が返ってきた時です。セマンティックレイヤーが効くのは、SQL を書く手間よりも、この 2 つの場面です。1 つは、誰が問い合わせても同じ定義の数字が返ること。もう 1 つは、定義から正しく数えられない問いに、もっともらしい誤った数字ではなくエラーを返すことです。以下は、後の実験で使う注文 1 件を、明細と支払いの 2 つのテーブルにつないだ時の図です。
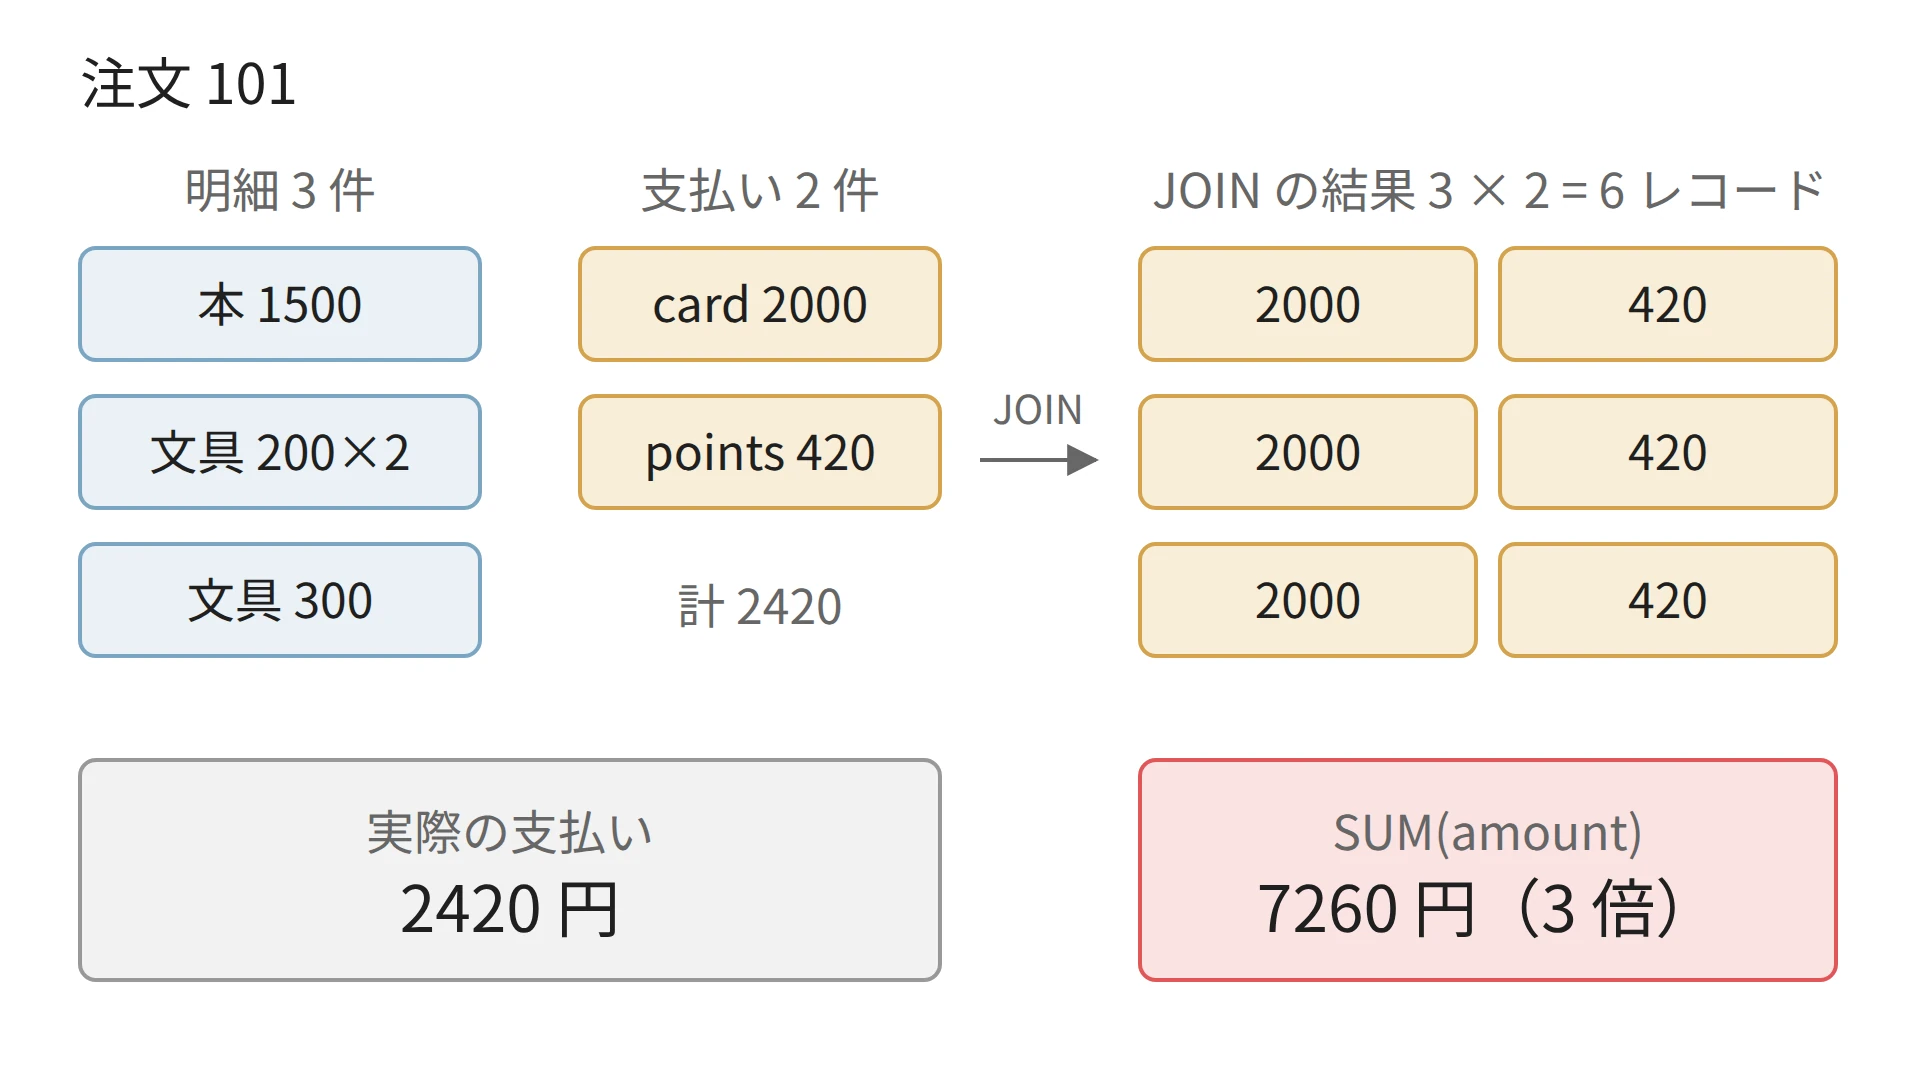
明細と支払いを同時に JOIN すると、支払いが明細の数だけ数えられる
SQL としては正しく動き、エラーも出ません。それでも合計は実際の 3 倍です。人が書いても LLM が書いても、この形の JOIN を一度書けば、同じように膨らんだ数字が返ります。
本記事では、セマンティックレイヤーが何に効き、何に効かないのかを、MetricFlow を手元で動かした結果で説明します。扱う疑問は次の通りです。
- 同じ「売上」なのに、ダッシュボードごとに数字が合わないのはなぜか。
- JOIN で数字が膨らむのは、どんなテーブルの組み合わせの時か。
- セマンティックレイヤーは何を定義し、どう SQL を組み立てるのか。
- 正しく数えられない問いに、どう振る舞うのか。
- LLM と組み合わせると、正答率はどれだけ変わるのか(2026 年 4 月時点の測定)。
BI ツールごとの製品比較や、問い合わせ結果のキャッシュ・アクセス権限の管理のような周辺の機能は説明しません。
セマンティックレイヤーが必要な理由
指標の定義は、テーブルのどこにも書かれていません。例えば、通販サイトの「10 月の売上」を数えるとします。手元に用意したのは、次の 4 つの CSV です。
| テーブル | 中身 | 件数 |
|---|---|---|
| customers | 顧客と地域(東京・大阪) | 3 |
| orders | 注文と状態(completed・returned) | 4 |
| order_items | 注文の明細(カテゴリ・数量・税抜の単価) | 7 |
| payments | 支払い(card・points、税込の金額) | 6 |
注文 103 は返品された注文で、注文 101 と 104 は card と points の 2 回に分けて払われています。明細の単価は税抜で、支払いの金額は消費税 10% を含みます。この 4 つのテーブルに対して「10 月の売上」を数える SQL は、少なくとも 4 通り書けます。明細の単価から数えるか支払いから数えるか、返品を含めるか除くかで、結果は次のように分かれました(sqly は CSV に SQL を実行する CLI です)。
$ sqly --sql-file revenue.sql orders.csv order_items.csv payments.csv
+---------------------+-------+
|     definition      | value |
+---------------------+-------+
| items, all          |  7500 |
| items, completed    |  5700 |
| payments, all       |  8250 |
| payments, completed |  6270 |
+---------------------+-------+
どれも SQL としては正しく、どれを「売上」と呼ぶかは会社の決め事です。経理は税抜で返品を除いた 5700 円を、決済の担当は税込の支払い額(8250 円か 6270 円)を見たいかもしれません。ダッシュボードごとに別の人が SQL を書くと、それぞれが別の定義を選び、会議で「どちらの数字が正しいのか」を確かめる時間が生まれます。
上記に加えて、定義を決めた後も、JOIN の書き方で数字が狂います。冒頭の図の通り、1 件の注文に明細も支払いも複数ある時に両方を同じ SQL で JOIN すると、レコードが掛け算で増えます。sqly で、地域別の支払い額と販売点数を 1 回の JOIN で数えた結果が次です。
SELECT c.region,
       SUM(p.amount)   AS paid,
       SUM(i.quantity) AS qty,
       COUNT(*)        AS joined_rows
FROM orders o
JOIN customers   c ON c.customer_id = o.customer_id
JOIN order_items i ON i.order_id    = o.order_id
JOIN payments    p ON p.order_id    = o.order_id
GROUP BY c.region
ORDER BY c.region;
+--------+------+-----+-------------+
| region | paid | qty | joined_rows |
+--------+------+-----+-------------+
| 大阪   | 5500 |   9 |           5 |
| 東京   | 9240 |   9 |           7 |
+--------+------+-----+-------------+
正しい値は、東京が支払い 4400 円・5 点、大阪が 3850 円・5 点です。東京の支払いは 2 倍以上、販売点数は両地域とも 2 倍近くに膨らみました。支払いは明細の数だけ、明細は支払いの数だけ複製されるからです。
1 対多の関係を JOIN して、多の側の数だけ 1 の側のレコードが複製されることを、MetricFlow のドキュメントは fan-out join と呼んでいます。今回のように、注文という共通の親から 2 つの 1 対多の関係を同時にたどり、明細と支払いが多対多の組み合わせになる形は chasm join と呼ばれます。冒頭の図は、この chasm join の例です。どちらも、件数を確かめなければ気付けません。
指標とエンティティを定義する
セマンティックレイヤーは、この 2 つの問題を「指標の定義」と「テーブルのつなぎ方の定義」を一箇所に集めることで扱います。利用する側は指標名と切り口だけを渡し、SQL はレイヤーが組み立てます。
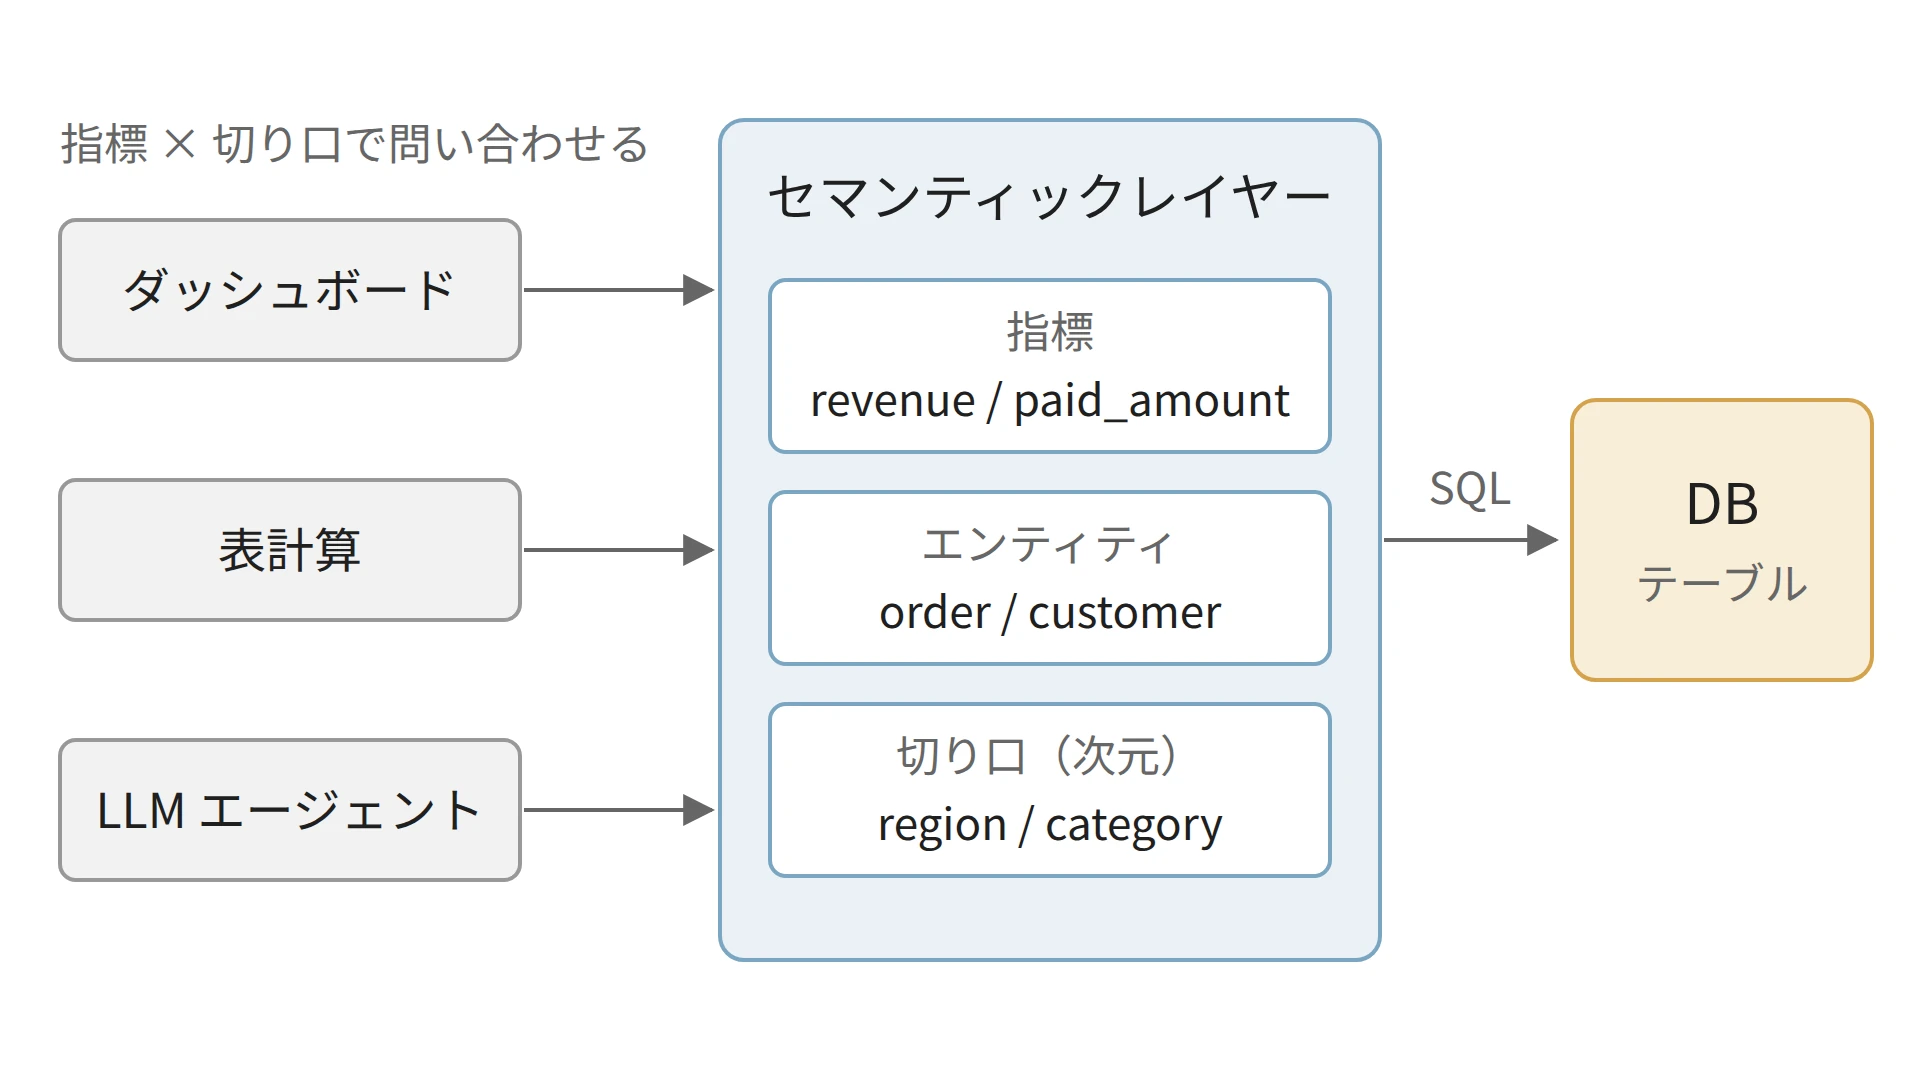
利用者は指標と切り口だけを渡し、SQL はレイヤーが組み立てる
MetricFlow では、dbt のモデル(SQL で定義したテーブルやビュー)ごとに、次の 3 種類を YAML で定義します(semantic models)。
| 種類 | 役割 | 今回の例 |
|---|---|---|
| エンティティ(entity) | テーブルをつなぐキー | order、customer |
| 次元(dimension) | 集計を分ける切り口(図の「切り口」) | region、category、status |
| 指標(metric) | 集計する値と計算式 | revenue、paid_amount、items_sold |
エンティティには型があり、そのテーブルで 1 レコードに 1 つだけ現れるキーは primary、複数のレコードに現れうるキーは foreign です。以下は、明細と支払いの定義の抜粋です(dbt Core 1.12 以降の書式)。stg_ は、CSV をそのまま読み込んだ段のモデルに付ける慣習的な接頭辞です。agg_time_dimension は、指標を日付で集計する時にどの日付の列を使うかの指定です。
  - name: stg_order_items
    semantic_model: {enabled: true, name: order_items}
    agg_time_dimension: ordered_at
    columns:
      - name: item_id
        entity: {type: primary, name: order_item}
      - name: order_id
        entity: {type: foreign, name: order}     # 1 件の注文に明細は複数
      - name: category
        dimension: {type: categorical, name: category}
      - name: ordered_at
        granularity: day
        dimension: {type: time, name: ordered_at}
    metrics:
      - name: items_sold
        type: simple
        agg: sum
        expr: quantity
      - name: revenue
        description: "税抜の売上。返品された注文を除く"
        type: simple
        agg: sum
        expr: quantity * price
        filter: "{{ Dimension('order__status') }} = 'completed'"

  - name: stg_payments
    semantic_model: {enabled: true, name: payments}
    agg_time_dimension: paid_at
    columns:
      - name: payment_id
        entity: {type: primary, name: payment}
      - name: order_id
        entity: {type: foreign, name: order}     # 1 件の注文に支払いは複数
      - name: paid_at
        granularity: day
        dimension: {type: time, name: paid_at}
    metrics:
      - name: paid_amount
        type: simple
        agg: sum
        expr: amount
revenue の定義が、前の節で 4 通りに分かれた「売上」の決め事です。税抜の単価から数え、filter で返品された注文を除くと、ここで一度だけ決めています。order__status は、order エンティティでつながる注文のテーブルの status という意味で、エンティティ名を __ でつないで、たどる経路を書きます。全体の定義は lab/models/semantic.yml にあります。
注文と顧客も同じ形で定義しています。注文は order を primary、customer を foreign に持ち、顧客は customer を primary に持ちます。以下は、4 つのモデルのエンティティのつながりです。
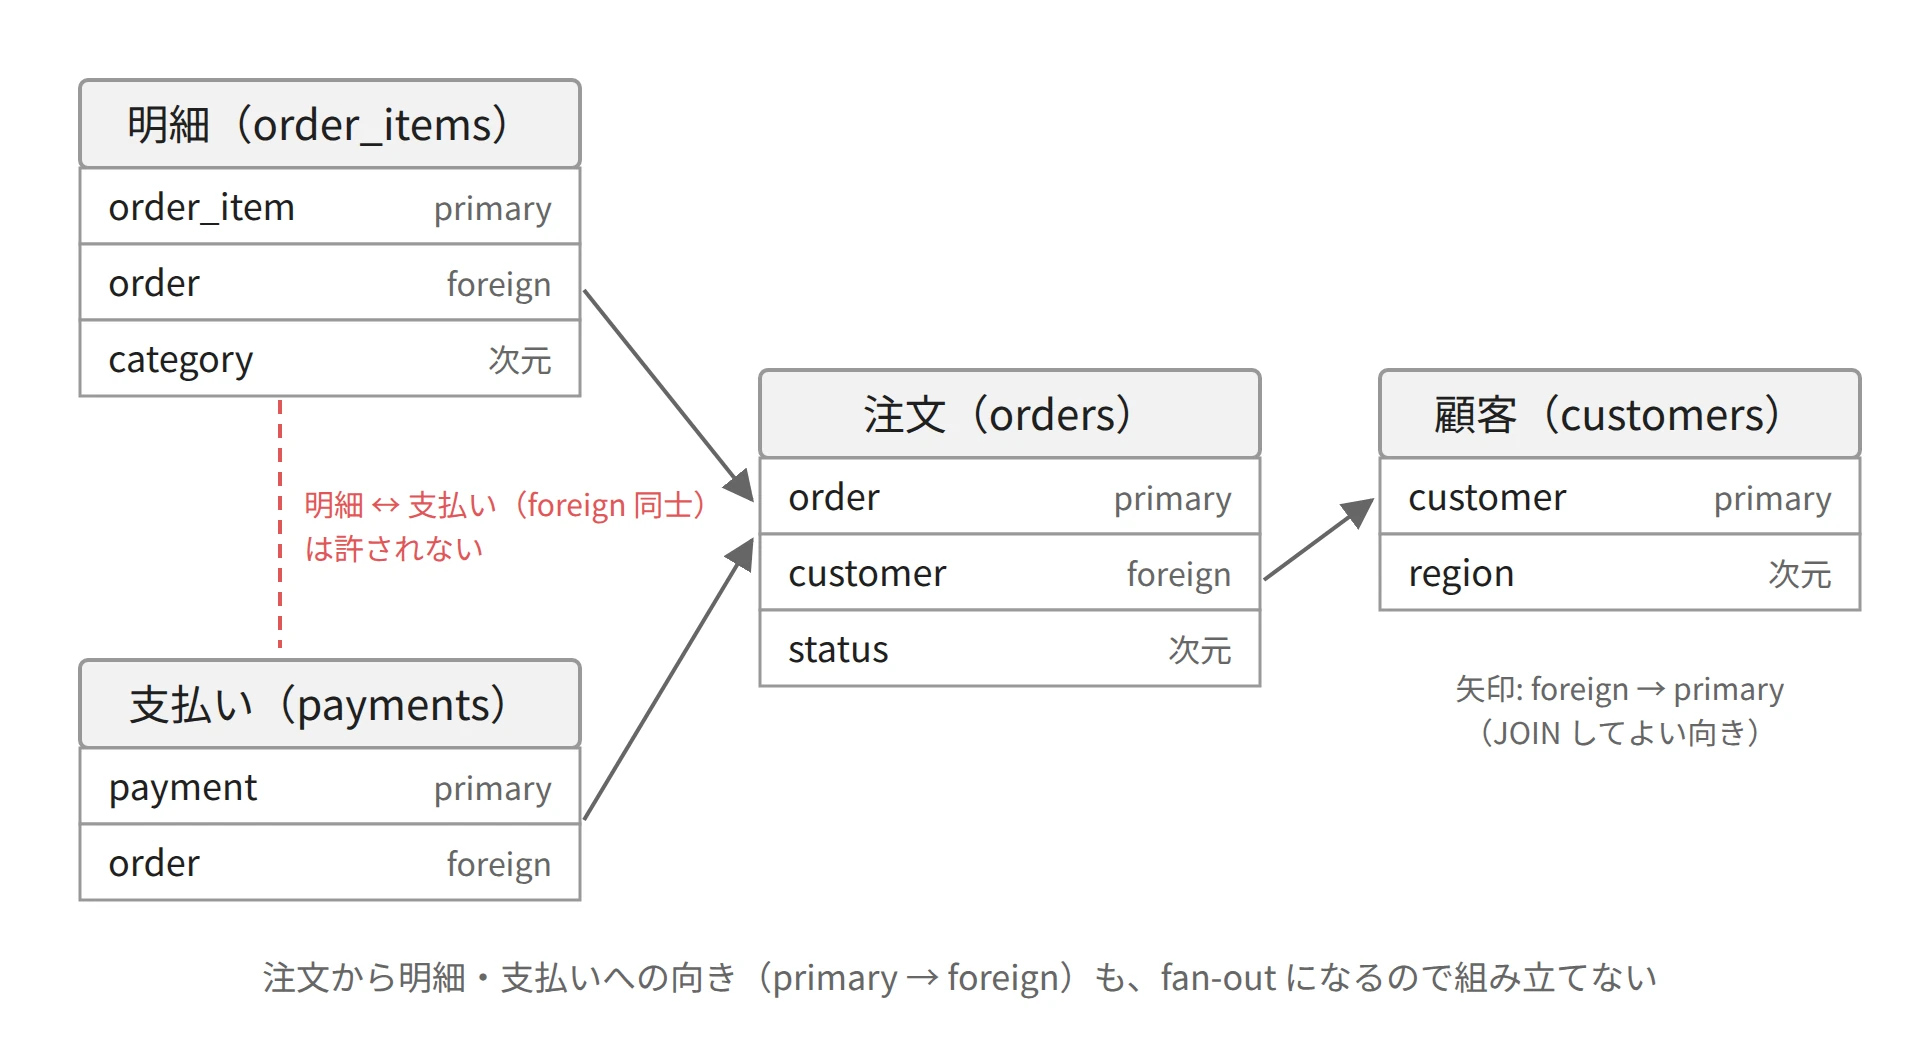
4 つのモデルのエンティティと、JOIN してよい向き
指標ごとに集計してから並べる
2026 年 11 月に、dbt Core 1.12.6・MetricFlow 0.213.0・DuckDB の組み合わせで、同じ 4 つの CSV に、MetricFlow の CLI(mf)で問い合わせました。手順は lab/run.sh にあります。地域は、支払いから注文、注文から顧客へと 2 段たどった先の次元なので、order__customer__region と書きます。
$ mf query --metrics paid_amount,items_sold --group-by order__customer__region
order__customer__region      paid_amount    items_sold
-------------------------  -------------  ------------
東京                                  4400             5
大阪                                  3850             5
$ mf query --metrics revenue
  revenue
---------
     5700
素朴な JOIN で 9240 円になった東京の支払いが、正しい 4400 円になりました。--explain を付けると、組み立てた SQL を表示できます。以下は、その構造を残して列名とサブクエリを縮めたものです(全文は lab/output_mf_sql.txt)。
SELECT COALESCE(p.region, i.region) AS order__customer__region,
       MAX(p.paid_amount) AS paid_amount,
       MAX(i.items_sold)  AS items_sold
FROM (
  -- 支払いだけを注文・顧客に LEFT JOIN して、地域ごとに合計する
  SELECT oc.region, SUM(payments.amount) AS paid_amount
  FROM stg_payments payments
  LEFT OUTER JOIN (orders と customers を LEFT JOIN したもの) oc
    ON payments.order_id = oc.order_id
  GROUP BY oc.region
) p
FULL OUTER JOIN (
  -- 明細だけを注文・顧客に LEFT JOIN して、地域ごとに合計する
  SELECT oc.region, SUM(order_items.quantity) AS items_sold
  FROM stg_order_items order_items
  LEFT OUTER JOIN (同上) oc
    ON order_items.order_id = oc.order_id
  GROUP BY oc.region
) i ON p.region = i.region
GROUP BY COALESCE(p.region, i.region);
支払いと明細を同じ JOIN に入れず、指標ごとに別のサブクエリで地域まで集計してから、地域をキーに横に並べています。外側の MAX は、地域ごとに 1 行しかない値を取り出しているだけです。どちらのサブクエリも、多の側(支払い・明細)から 1 の側(注文・顧客)へ向かう JOIN だけなので、レコードは増えません。
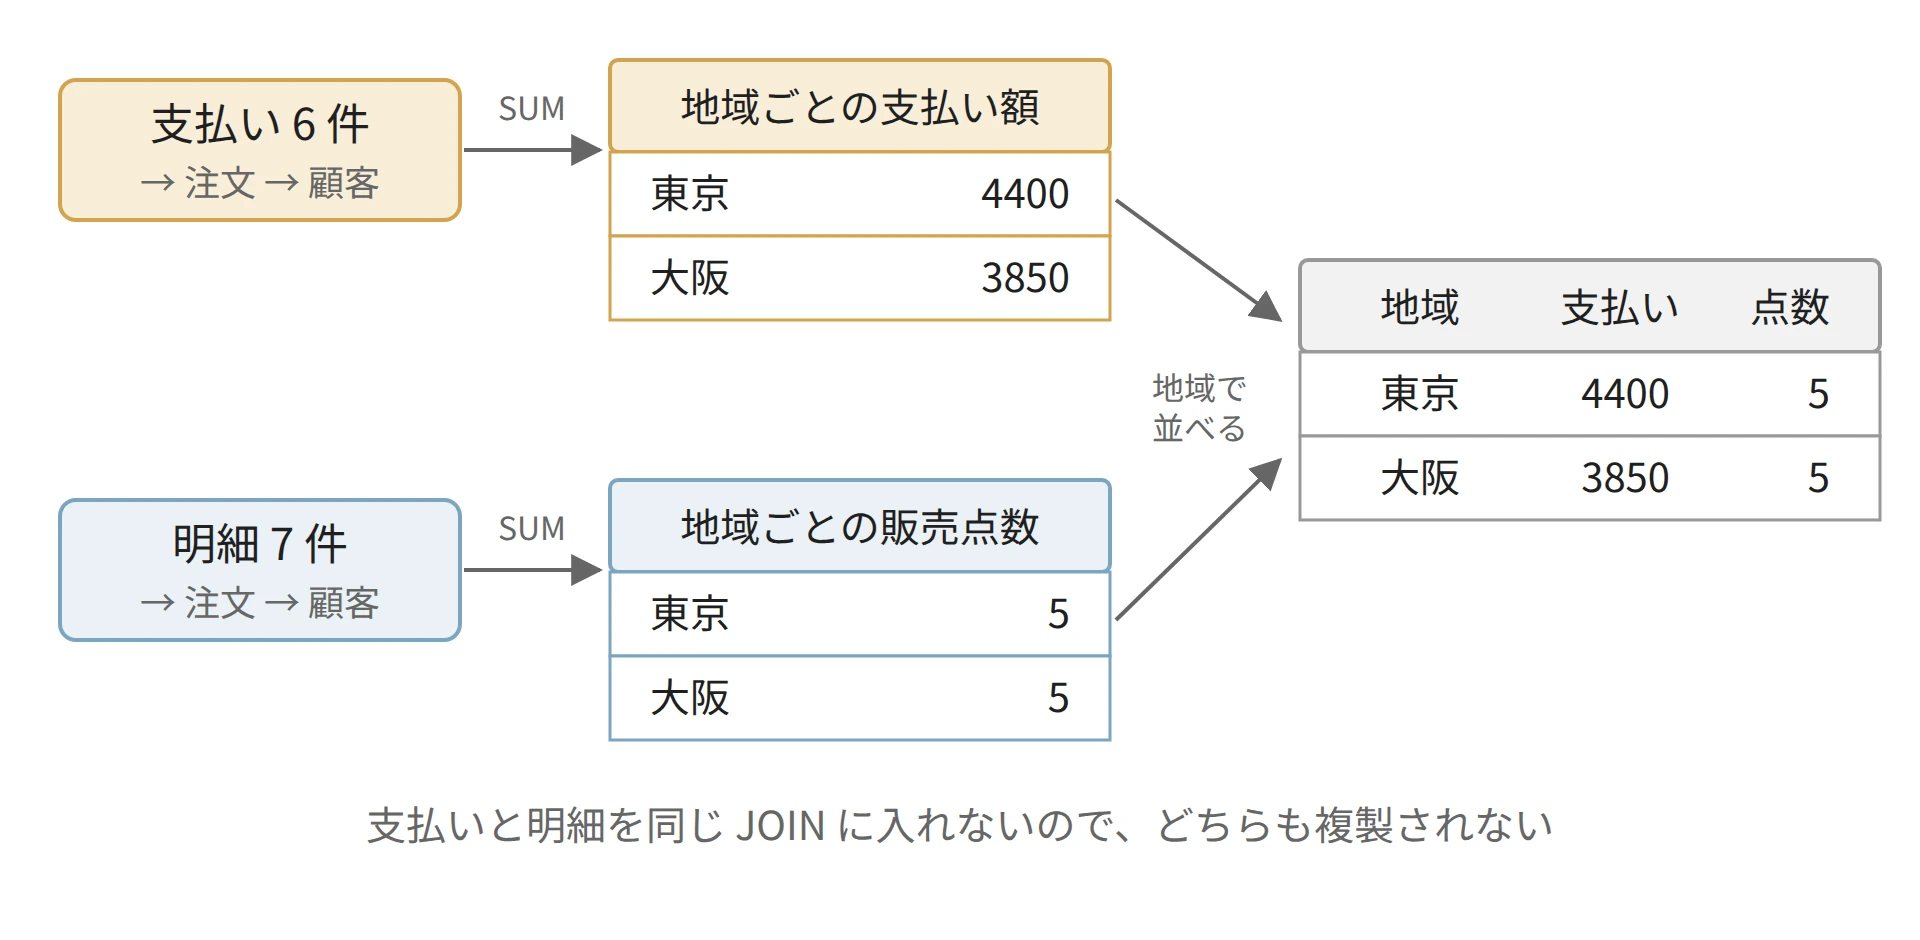
指標ごとに地域まで集計してから、地域で並べる(冒頭の図と対になる組み立て方)
MetricFlow は、この JOIN の向きをエンティティの型から選びます。join のルールでは、foreign から primary への JOIN(支払いの order から注文の order へ)は許し、primary から foreign への JOIN(注文から明細へ)や foreign 同士の JOIN(明細から支払いへ。どちらも order が foreign)は fan-out になるとして許しません。冒頭の図の chasm join は、この foreign 同士の組み合わせにあたります。SQL を書く人が毎回レコード数を確かめる代わりに、エンティティの型を一度宣言すれば、膨らむ JOIN は組み立てられなくなります。
正しく数えられない問いはエラーにする
では、商品カテゴリ別の支払い額を問い合わせると、どうなるでしょうか。
$ mf query --metrics paid_amount --group-by order_item__category
ERROR: Got error(s) during query resolution.

Error #1:
  Message:

    The given input does not match any of the available group-by-items for
    SimpleMetric('paid_amount'). Common issues are:

      * Incorrect names.
      * No valid join paths exist from the measure to the group-by-item.
        (fan-out join support is pending).
      * There are multiple matching join paths.
        (disambiguation support is pending).
支払いからカテゴリへは、支払い → 注文 → 明細とたどる必要があり、注文から明細へは 1 対多の JOIN です。MetricFlow はこの経路を組み立てず、数字の代わりにエラーを返しました(エラーの全文は lab/output_mf_error.txt)。
この問いは、そもそも定義が足りません。注文 101 の 2420 円のうち、何円が本で何円が文具かは、どのテーブルにも書かれていないからです。単価の比で按分するか、カテゴリ別には税抜の売上(revenue)を見るかは、会社が決めることです。SQL を手で書けば、明細と支払いを JOIN して膨らんだ数字が出てしまいます。セマンティックレイヤーは、決め事が無い所で数字を作らず、止まります。
LLM と組み合わせた時の効き目
LLM のエージェントにセマンティックレイヤーを使わせる時、LLM が選ぶのは指標名・切り口・絞り込みの条件だけで、SQL はレイヤーが組み立てます。LLM には、ツール呼び出しで「指標と切り口を指定して問い合わせる関数」を渡す形になります。
dbt Labs は、この組み合わせと、LLM に直接 SQL を書かせる Text-to-SQL を比べたベンチマークの結果を 2026 年 4 月 7 日に公開しています。データは、data.world の Juan Sequeda 氏らが論文で作った保険会社の架空のデータ(ACME Insurance。dbt Labs のベンチマークでは 15 テーブル)で、11 個の質問を各 20 回解かせています。11 問のうち 8 問はレイヤーの範囲内で、3 問は MetricFlow がたどれる段数を超えた JOIN が要る問いです。LLM は Anthropic の Claude Sonnet 4.6 と OpenAI の GPT-5.3 Codex で、記事は 2023 年 11 月に GPT-4 で測った結果も並べています。以下は、記事の表を図にしたものです。
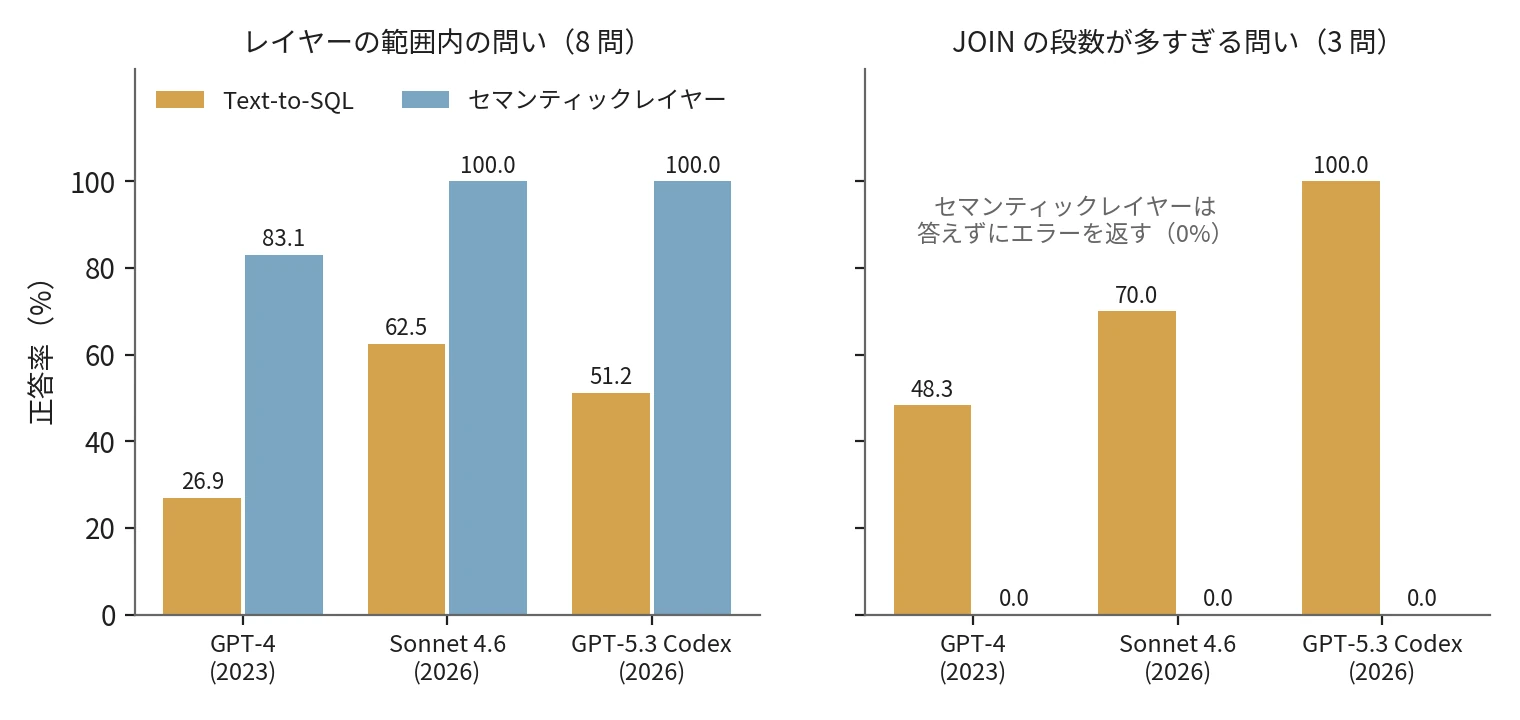
dbt Labs のベンチマーク(2026-04-07 公開)の正答率。GPT-4 は 2023 年 11 月の結果(dbt Labs の記事の表から作図)
左のパネルの通り、Text-to-SQL は 2023 年の GPT-4 から大きく伸びました。全 11 問での正答率は、32.7% から 64.5% へとほぼ倍になっています。一方で、セマンティックレイヤーの範囲内の問いでは、2026 年のどちらの LLM も 100% でした。
右のパネルは、MetricFlow がたどれる段数を超えた JOIN が要る問いです。MetricFlow がたどれるのは、2 段までの JOIN です(支払い → 注文 → 顧客が 2 段)。ACME Insurance のテーブルは細かく正規化されていて、3 段以上たどる必要のある問いがありました。セマンティックレイヤーは 0% で、2023 年から変わっていません。前の節のエラーは fan-out を避けるためでしたが、こちらは段数の上限によるもので、理由は違います。記事は、この 0% を誤答ではなく「答えられない」とエラーで返した結果だとして、次のように書いています。
With text-to-SQL, failure looks like a plausible but incorrect answer. With the Semantic Layer, failure looks like an error message.
(Text-to-SQL の失敗は、もっともらしいが誤った答えの形で現れる。セマンティックレイヤーの失敗は、エラーメッセージの形で現れる。)
その後、記事の著者は LLM に dbt のモデルを 3 つ足させ、全 11 問をレイヤーの範囲に入れました。以下は、dbt のモデルを足す前と後の、全 11 問での正答率です。
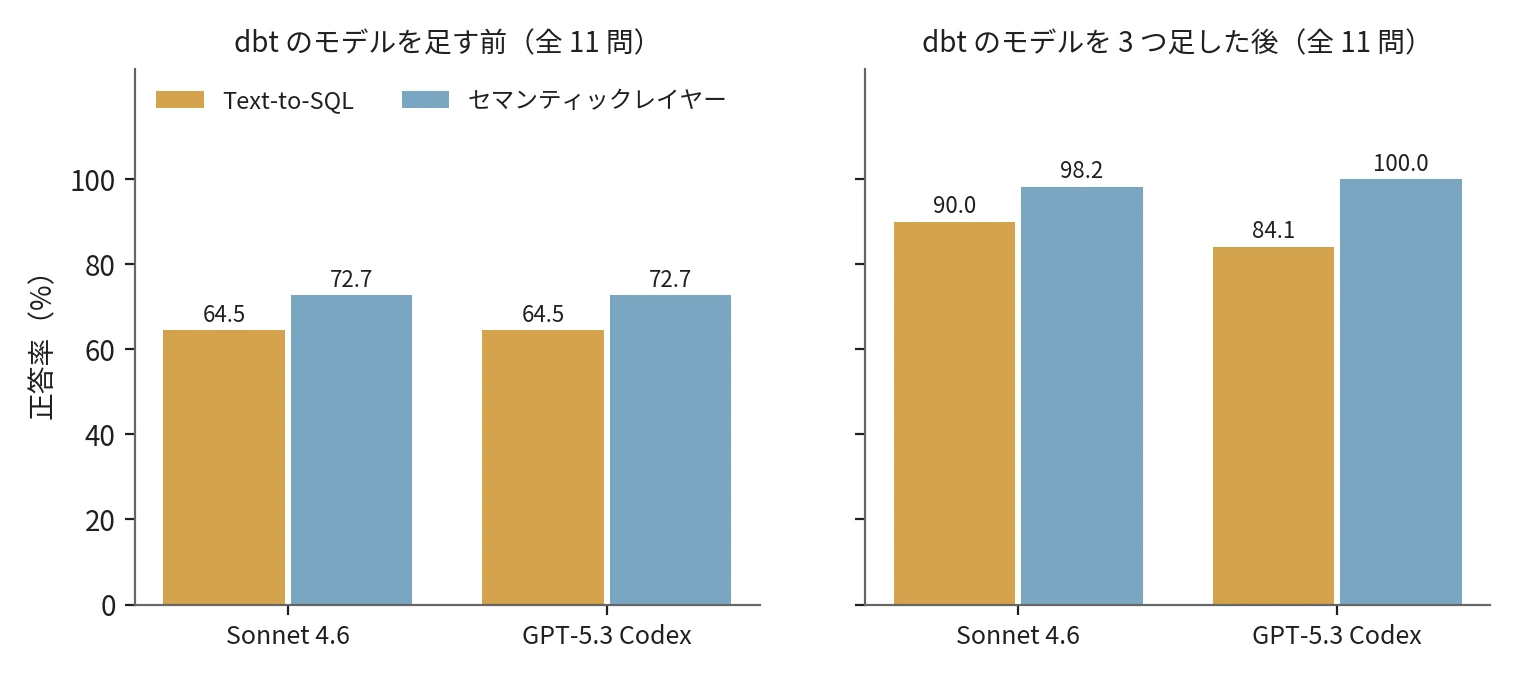
dbt のモデルを 3 つ足す前と後の、全 11 問の正答率(dbt Labs の記事の表から作図)
足す前のセマンティックレイヤーが 72.7% にとどまるのは、範囲外の 3 問が 0% だからです。足したモデルは、いくつかのテーブルをあらかじめ JOIN したもので、たどる段数が減ります。
dbt のモデルを足した後は、Sonnet 4.6 の Text-to-SQL が 90.0%・セマンティックレイヤー経由が 98.2%、GPT-5.3 Codex は 84.1% と 100% でした。記事は、生のテーブルの上に dbt のモデルを整えることが、どちらの方法の正答率も押し上げるとしています(Text-to-SQL には、足したテーブルの DDL も渡しています)。
数字を読む時の注意
この数字を読む時の注意が 3 つあります。
- dbt Labs は Semantic Layer を提供する会社で、質問は 11 個と少ない。
- 推論の強さ(reasoning effort。答える前に考えるトークンの量の設定)を変えた比較(レイヤーで答えられる問いだけを使った)では、同じ Anthropic の Claude Opus 4.6 はセマンティックレイヤー経由でも、どの強さでも 87.2〜87.5% にとどまった。LLM が指標と切り口を選び間違える余地は残る。
- Text-to-SQL の側には、15 テーブルのスキーマ全体を毎回渡している。テーブルが数百ある環境では、この渡し方自体が難しい(入力が長いほど LLM の答えが崩れやすいことは Long Context のノートを参照)。
つまり、2026 年 4 月時点の LLM では、テーブルの上に dbt のモデルを整えれば、Text-to-SQL も 8〜9 割の問いを解けます。それでもセマンティックレイヤーを挟む理由は、正答率の差よりも、間違え方の差にあります。定例の報告や監査に出す数字のように、誤った数字が黙って出ることが許されない場面ほど、この差が効きます。
利点
- 指標の定義が一箇所にあり、ダッシュボード・表計算・LLM のどれから問い合わせても同じ数字になる
- エンティティの型から JOIN の向きが決まり、fan-out で膨らんだ数字を出さない
- 定義から数えられない問いは、誤った数字ではなくエラーで返る
- LLM は指標と切り口を選ぶだけで済み、SQL の書き間違いが答えに入らない
- 「売上」の定義を変える時、直すのは YAML の 1 か所になる
欠点
セマンティックレイヤーは、問い合わせの自由さと引き換えに、定義した範囲の正しさを保証します。その代わりに、次の制約があります。
- 定義していない指標・切り口・経路の問いには、まったく答えられない
- 指標とエンティティを定義し、テーブルの変更に合わせて保守する手間が掛かる
- 組み立てる SQL はサブクエリが重なり、手で書く SQL より長く読みにくい
- 実装ごとに定義の書式が違い、dbt の中でも 1.12 で新しい書式が加わって旧書式と 2 通りある
- 段数の多い JOIN のように、実装が対応していない経路は、モデルを足して範囲に入れる必要がある
セマンティックレイヤーの効果が小さくなりやすいケース
- 問い合わせる人が 1〜2 人で、指標の定義が会話だけで揃う規模の分析
- 1 回きりの調査で、テーブルを探りながら問いを変えていく探索的な分析
- 明細と支払いのような 1 対多の関係が少なく、JOIN で数字が膨らむ経路がほとんど無いデータ
- 指標そのものがまだ決まっておらず、定義を固めると議論の方が止まる段階
dbt Labs の記事も、どちらかを選ぶのではなく使い分けることを勧めています。報告や KPI のように正しさが要る数字はレイヤーで答えます。探索的な問いも、まずレイヤーで答えられるかを見て、小さなモデルの追加で埋まるならそうし、それでも駄目な時だけ Text-to-SQL に戻す、という順です。