SQL には欲しい結果だけを書き、どの索引をどの順に読むかは DB(データベース)に任せます。DB が決めたこの手順が、実行計画です。任せた部分の中身を知らないままアプリケーションから SQL を書いていると、次のような前提を置きがちです。
- LIMIT を付ければ、読む行が減って速くなる。
- 同じ SQL で同じ実行計画なら、かかる時間もほぼ同じ。
- DB は、条件に合う行数をおおよそ知っている。
- 実行計画を選ぶ時間は、実行する時間に比べて小さい。
どれも、成り立たない場合があります。以下は、手元の PostgreSQL 18 で、500 万行の表 events から 1 人の利用者が持つ行を id の順に取り出す SQL で、LIMIT の件数だけを変えて実行した時間です。
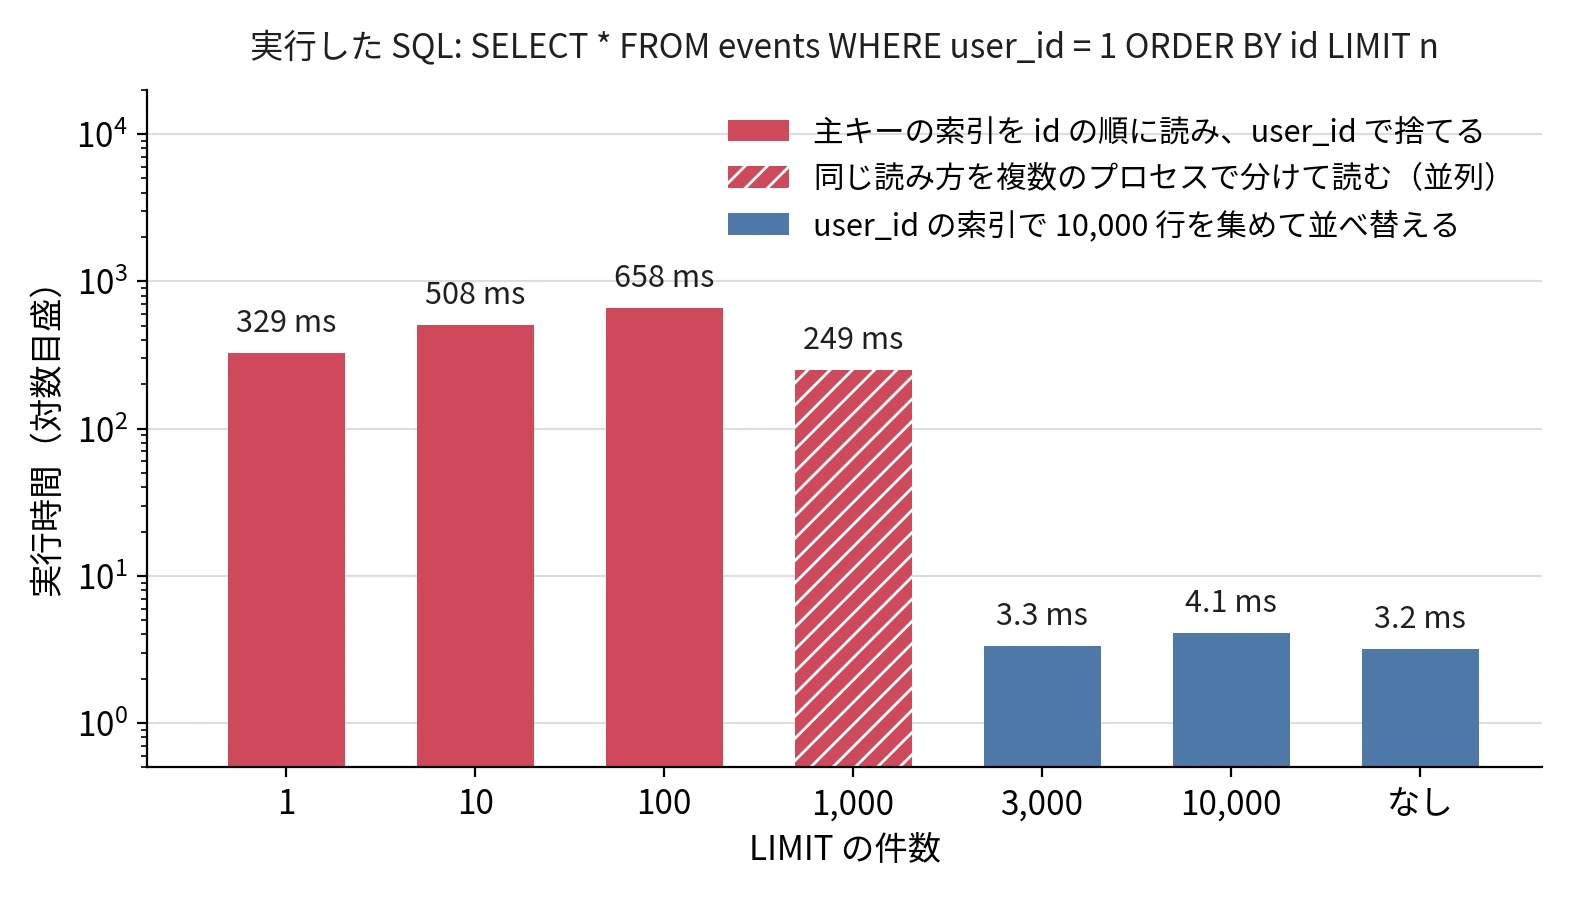
LIMIT の件数ごとの実行時間と、DB が選んだ読み方
LIMIT が無ければ 3 ms で終わる SQL が、LIMIT 1 を付けると 329 ms 掛かりました。赤い棒と青い棒では、DB が選んだ読み方が違います。LIMIT の件数を見て読み方を変えたのは DB の中でプランナと呼ばれる部分で、その判断の根拠は、表について DB が持っている統計情報と、いくつかの仮定です。
本記事では、SQL を書いて DB に読み方を任せている人と、遅くなった SQL の実行計画を読むことになった人に向けて、次の疑問に答えます。
- SQL を受け取ってから結果を返すまでに、DB の中で何が起きるのか。
- 選ばれた実行計画は、どう動いて行を返すのか。
- LIMIT 1 を付けただけで遅くなるのは、なぜか。
- DB は、条件に合う行数をどう見積もるのか。
- 見積もりの外れは、どう見つけて直すのか。
- 結合する表が増えると、計画の選び方はどう変わるのか。
実験には、Docker で動かした PostgreSQL 18.6 と MySQL 8.4.11 を使いました。
SQL から結果までの 4 つの段階
PostgreSQL の文書「The Path of a Query」では、SQL を受け取ってから結果を返すまでが、次のような段階に分かれています。
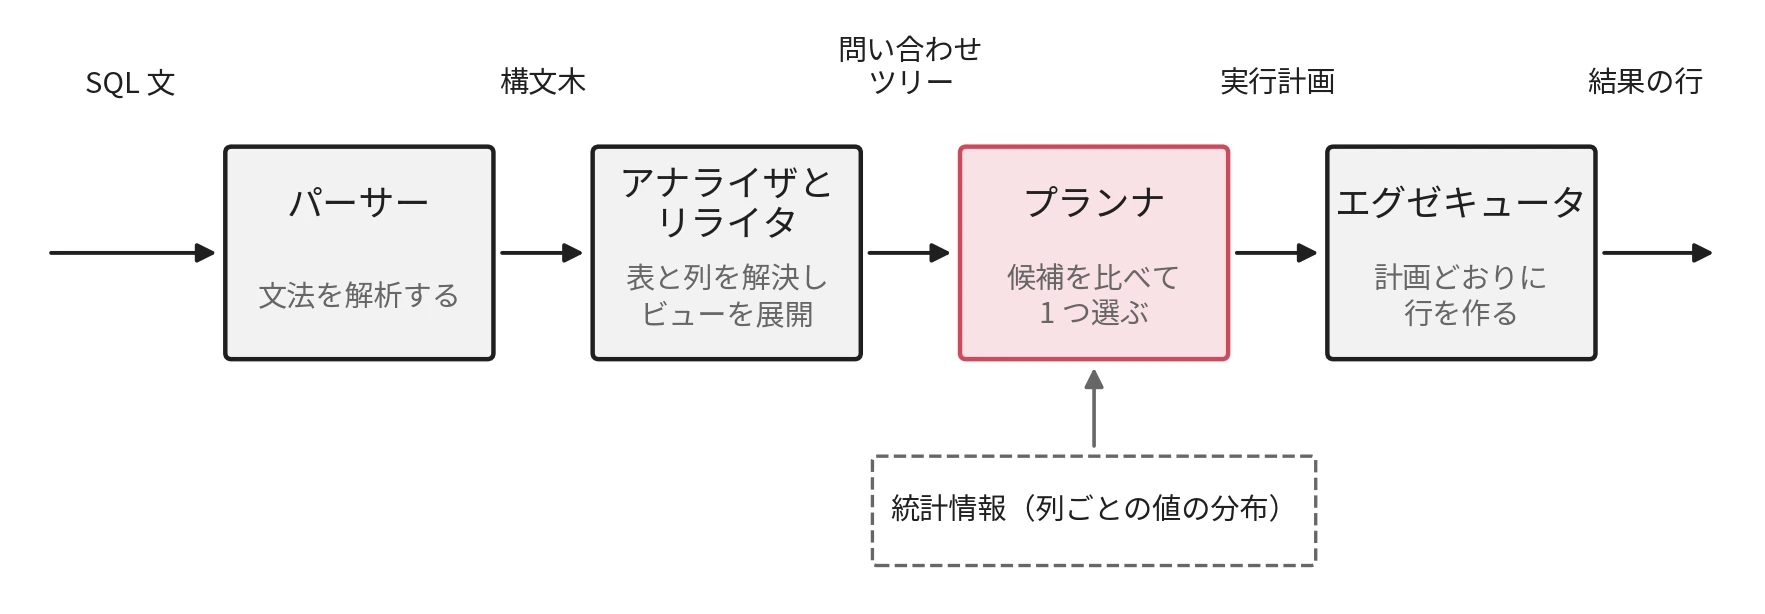
SQL から結果までの段階と、各段階が次に渡すもの
パーサーは SQL の文法を調べ、文を木の形にします。この構文木(parse tree)には、まだ文字列としての表や列の名前しかありません。PostgreSQL のパーサーは、この段で表の定義を一切引きません。次の段で、表や列の名前を DB 自身が持つ表の定義と突き合わせ、実在する表と列を指す問い合わせツリー(query tree)にします。図のアナライザは、PostgreSQL のソースが使う呼び名です。リライタは、ビューへの参照をビューを定義した SQL に置き換えるような書き換えをします。ここまでで、何を求められているかは決まります。
まだ決まっていないのは、どう読むかです。表を先頭から読むか索引を使うか、どの索引か、表をどの順に結合するかの組み合わせの数だけ、読み方の候補があります。候補ごとの手順を木の形にしたものを実行計画(query plan)と呼び、プランナ(planner)が候補を比べて 1 つを選びます。選ぶ時の材料が、図の下にある統計情報です。エグゼキュータ(executor)は、選ばれた計画をそのとおりに動かして結果の行を作ります。
プランナが選んだ実行計画は、EXPLAIN で表示できます。EXPLAIN ANALYZE と書くと実際に実行し、計画の各段で実際に出た行数と時間も並べます。実際に実行するので、UPDATE や DELETE に付けると表も書き換わります。
段が繰り返し動いた時は、出力の loops に回数が出て、行数は 1 回あたりの平均になります。PostgreSQL 18 からは、実際の行数が 1.00 のように小数で出ます。
実行計画から行を引き出すエグゼキュータ
冒頭の SQL で、利用者だけを 1 から 500 に変えた時の実行計画は、次の通りでした。
EXPLAIN ANALYZE SELECT * FROM events WHERE user_id = 500 ORDER BY id LIMIT 1;
Limit  (cost=0.43..34.50 rows=1 width=14) (actual time=0.075..0.076 rows=1.00 loops=1)
  ->  Index Scan using events_pkey on events  (cost=0.43..169379.43 rows=4972 width=14) (actual time=0.073..0.074 rows=1.00 loops=1)
        Filter: (user_id = 500)
        Rows Removed by Filter: 497
Execution Time: 0.105 ms
字下げが深い行ほど、木の下にある段です。下にある Index Scan は、主キーの索引 events_pkey を id の小さい順にたどり、user_id = 500 に合わない行を捨てます(Filter)。上にある Limit は、受け取った行を 1 行だけ通します。主キーの索引は B-Tree の形で id の順に項目を並べているので、先頭からたどれば id の小さい行から順に出てきます。
エグゼキュータは、この木を上から動かします。上の段が下の段に「次の 1 行」を求め、下の段は 1 行を用意できた所で返します。Graefe 氏が 1994 年の論文「Volcano—An Extensible and Parallel Query Evaluation System」にまとめた形で、イテレータモデルとも呼ばれます。PostgreSQL のエグゼキュータも、文書によるとこの形の要求引き寄せ型(demand-pull)パイプラインです。
PostgreSQL のソースにある executor の README では、木を組む ExecInitNode、次の 1 行を求める ExecProcNode、後始末の ExecEndNode がこの動きに当たります。
Limit は 1 行を受け取った時点で求めるのをやめるので、Index Scan も 500 万行の途中で止まります。出力の Rows Removed by Filter: 497 は捨てた行数で、498 行を読んだ所で 1 行目が見つかり、0.1 ms で終わりました。
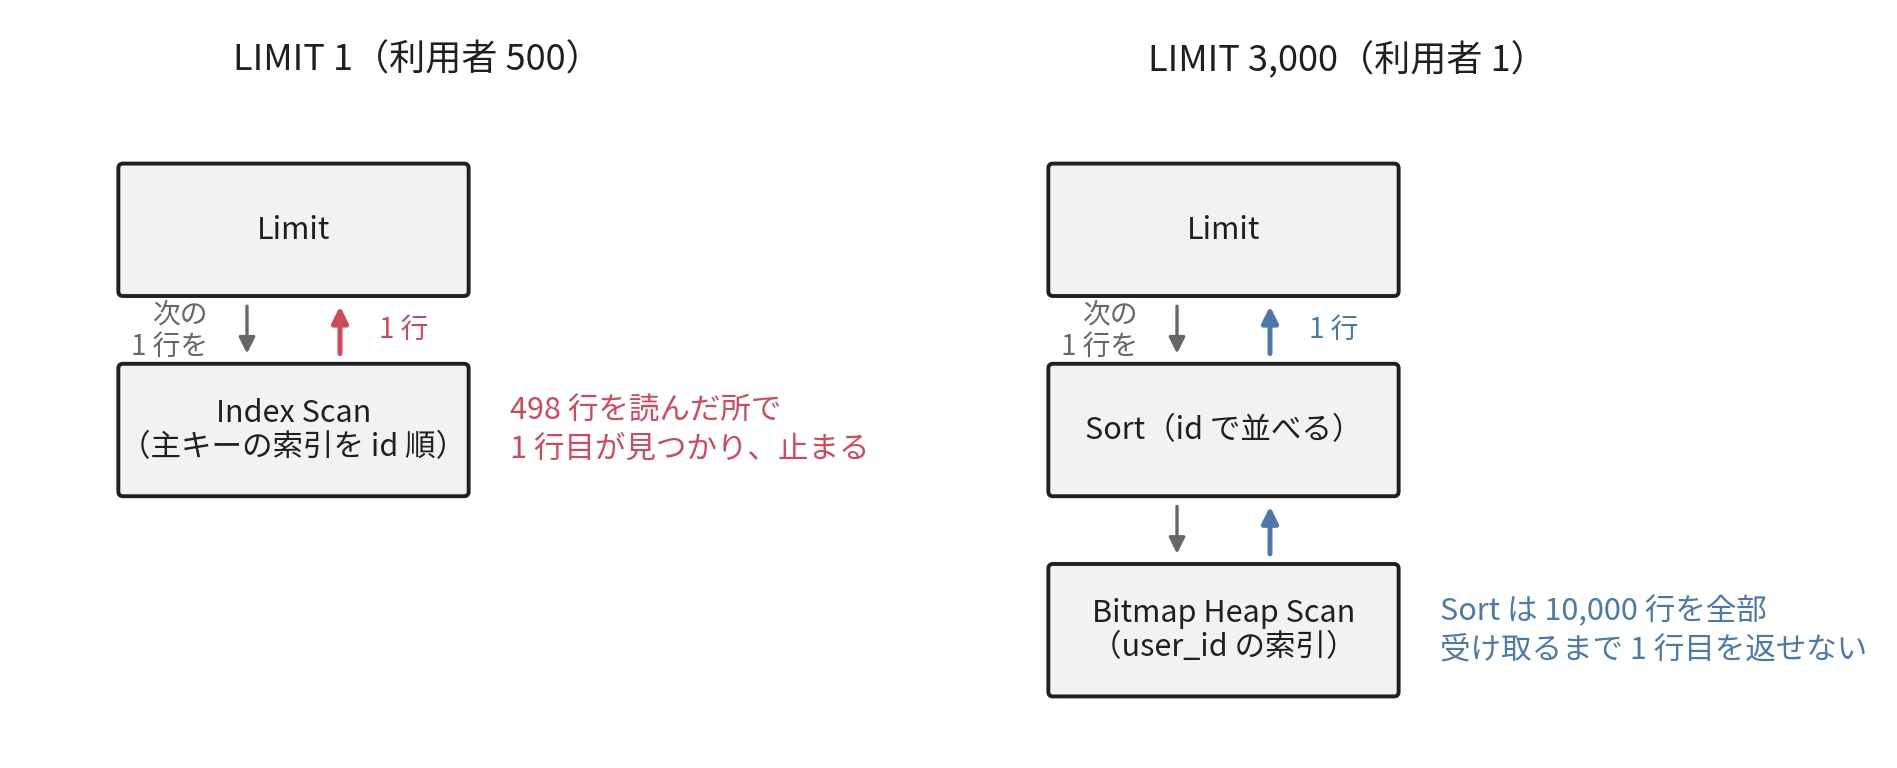
上の段が下の段に 1 行ずつ求める形と、途中で止まれない Sort
ただし、どの段も途中で止まれるわけではありません。図の右にある計画では、Bitmap Heap Scan が user_id の索引で該当する行の位置を集めてから表を読みます。
その上の Sort は、下から来る行を全部受け取って並べ替えるまで、最初の 1 行を返せません。後で触れる Hash Join も、片方の表からハッシュ表を作り終えるまでは 1 行目を返せません。Limit と読む段の間に、このように入力を全部受け取る段があると、LIMIT を付けても読む行は減りません。
1 行ずつ求める形は、段の組み合わせを自由に変えられる一方で、1 行ごとに関数の呼び出しが起きます。集計のように大量の行を読む用途で、列ごとにまとめて処理する DB があるのはこのためです。その違いは Columnar Storage で扱っています。
LIMIT 1 で遅くなる計画
同じ SQL で、利用者を 1 に戻した時の実行計画です。
Limit  (cost=0.43..21.60 rows=1 width=14) (actual time=452.919..452.922 rows=1.00 loops=1)
  ->  Index Scan using events_pkey on events  (cost=0.43..169379.43 rows=8000 width=14) (actual time=452.917..452.918 rows=1.00 loops=1)
        Filter: (user_id = 1)
        Rows Removed by Filter: 4990000
Execution Time: 452.953 ms
計画の形は利用者 500 と同じですが、捨てた行が 4,990,000 行あります。主キーの索引をほぼ最後まで読んだ所で、1 行目が見つかりました。
冒頭の図に載せた 329 ms は 5 回の中央値で、この出力はそのうち 1 回の 453 ms です。別に 5 回測った中央値は 341 ms で、実行のたびに数百 ms の幅でぶれました。値だけが違う同じ形の SQL で、同じ実行計画なのに、利用者 500 なら 0.1 ms、利用者 1 なら数百 ms 掛かります。
プランナが比べた数字
プランナがこの計画を選んだ理由は、出力の cost にあります。cost は、ページを 1 つ順に読む手間を 1.0 とした見積もりの単位で、0.43..169379.43 は最初の 1 行を返すまでと、全部を返すまでの見積もりです。この Index Scan を最後まで動かすと 169,379 で、条件に合う行は rows=8000 と見積もっています。
Limit の段にある 21.60 は、次の計算で出ています。
0.43 + (169379.43 - 0.43) × 1 / 8000 = 21.60
8,000 行のうち 1 行が出れば止まるので、全体の 8,000 分の 1 だけ読めば済む、という見積もりです。もう 1 つの候補だった、user_id の索引で利用者 1 の行を集めてから id で並べ替える計画は、設定 enable_indexscan = off で主キーの索引を使えなくして表示させると、次の通りでした。
Limit  (cost=17490.21..17490.21 rows=1 width=14)
  ->  Sort  (cost=17490.21..17510.21 rows=8000 width=14)
        Sort Key: id
        ->  Bitmap Heap Scan on events  (cost=90.43..17450.21 rows=8000 width=14)
Sort は全部を受け取るまで 1 行目を返せないので、Limit の段でも 17,490 のままです。21.60 と 17,490 を比べて、プランナは主キーの索引を読む計画を選びました。冒頭の図で LIMIT 3,000 から青の計画に変わったのは、赤い計画の見積もりが LIMIT の件数に比例して増え、17,490 を超えたからです。
LIMIT 1,000 が赤のままだった理由
上の式に 1,000 を入れると 21,000 ほどになり、17,490 を超えます。それでも LIMIT 1,000 が赤のままだったのは、出力の段が Parallel Index Scan に変わったからです。主キーの索引を id の順に読む点は同じで、複数のプロセスが分けて読む分だけ見積もりが下がり、青の計画より安く出ました。
8,000 分の 1 で止まる前提
8,000 分の 1 で止まるという見積もりは、利用者 1 の行が、主キーの索引をたどる順の中に均等に散らばっていることを前提にしています。
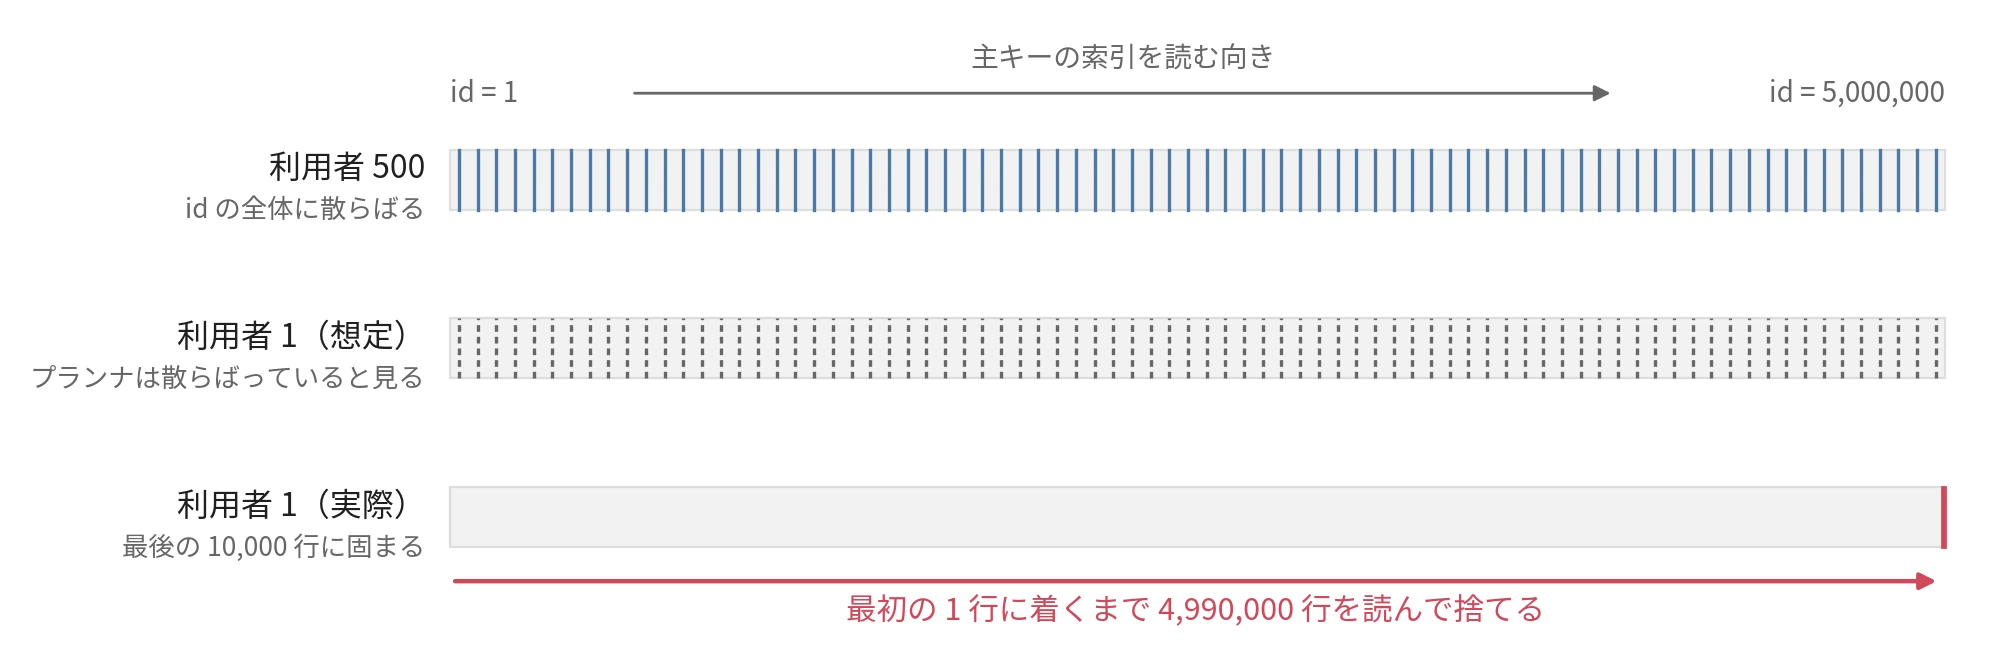
主キーの索引を読む時、利用者の行がどこにあるか(プランナの想定と実際)
実験の表は、1,000 人の利用者が持つ行を交互に入れた後に、利用者 1 の 10,000 行を最後に足して作りました。利用者 500 の行は前提どおり散らばっているので、498 行目で見つかります。利用者 1 は、最後の 10,000 行に固まっています。
実際のシステムでも、id や作成日時の並びと、ある列の値が置かれる位置が無関係でないことはよくあります。例えば、最近使い始めた大口の顧客、新しく足した種類のイベント、処理待ちの状態にある行は、どれも id の大きい方に固まりやすくなります。プランナは行数を見積もれても、利用者 1 の行が、主キーの索引をたどる順のどこにあるかは知りません。
並び順を表す統計 correlation との違い
PostgreSQL も、行の並び順をまったく見ていないわけではありません。列ごとの統計情報には pg_stats の correlation があります。値の順と、表の中で行が並ぶ順がどれだけ揃っているかを -1〜+1 で表した数で、プランナは ±1 に近い列ほど Index Scan を安く見積もります。同じ行を入れる順だけ変えて見積もりと実行時間を比べた実験は、先に出た Index Scan のノートにあります。
ただ、correlation は 1 つの列の中で値と並び順を比べた数で、user_id = 1 の行が id の並びのどこに来るかという、列をまたいだ位置は表しません。
MySQL での同じ SQL
MySQL 8.4 の InnoDB に同じ行を入れ、同じ SQL を実行すると、数 ms で終わりました。選ばれたのは user_id の索引です。
-> Limit: 1 row(s)  (cost=19785 rows=1) (actual time=2.89..2.89 rows=1 loops=1)
    -> Index lookup on events using events_user_id_idx (user_id=1)  (cost=19785 rows=17998) (actual time=2.89..2.89 rows=1 loops=1)
InnoDB の文書のとおり、InnoDB では索引の各項目が、索引の列に加えて主キーの値を持ちます。user_id の索引では、同じ利用者の項目が主キーである id の順に並ぶので、最初の項目がそのまま答えになります。PostgreSQL で索引の各項目が持つのは、表の中で行がある位置です。
PostgreSQL 12 以降の B-Tree は、同じ user_id の項目をこの位置の順に並べます。実験の表は id の順に行を入れたので、実際には id の順にも並んでいます。ただ、位置の順が id の順と揃うことをプランナは前提にできないので、この索引だけで ORDER BY id を済ませる計画は作りません。
MySQL でも、並べ替えの列を主キー以外にすると同じことが起きます。id と同じ値を入れた列 seq に索引を付け、ORDER BY seq LIMIT 1 にした結果です。
| SQL と設定 | 選ばれた読み方 | 実行時間 |
|---|---|---|
ORDER BY id LIMIT 1 | user_id の索引 | 3.8 ms |
ORDER BY seq LIMIT 1 | seq の索引を順に読み、user_id で捨てる | 11,161 ms |
上に加えて prefer_ordering_index=off | user_id の索引で集めて並べ替える | 18.0 ms |
seq の索引を順に読む計画は 499 万行を読み、11 秒掛かりました。表の 3 行目の prefer_ordering_index は、LIMIT のある ORDER BY で並びどおりの索引を優先する最適化を止める設定です。MySQL の文書によると、この最適化が望ましくない場合がある理由は、データの分布がおおむね均一だという仮定です。冒頭の図で赤い棒を生んだのと同じ仮定です。PostgreSQL の本体には、この最適化だけを止める設定はありません。
値の分布と、列どうしの関係
利用者 1 の行数は、8,000 と 10,000 で少しずれただけでした。統計情報を集める ANALYZE は、大きな表では無作為に選んだ一部の行を標本として読むので、見積もりは少しずれ、ANALYZE をやり直すたびに少し変わります。
プランナが 1 つの列の条件をここまで見積もれるのは、ANALYZE が 列ごとに値の分布を記録する からです。文書が「always approximate」と書くとおり、記録は常に近似で、SQL を実行するたびに更新されるわけでもありません。異なる値の数、よく出る値とその割合、残りの値を範囲で区切ったヒストグラムを持ち、user_id = 1 なら、よく出る値の割合に表の行数を掛けます。
記録は列ごとです。そのため、条件が複数の列にまたがると、プランナは列どうしが独立だと見なして割合を掛け合わせます。顧客の表 customers を 100 万行で作り、市区町村 city が決まれば都道府県 pref と地方 region も決まるようにしました。city は 1,000 通り、pref は 50 通り、region は 5 通りです。
SELECT * FROM customers c WHERE c.city = 7 AND c.pref = 0 AND c.region = 0;
プランナの見積もりは、1,000,000 × 1/1,000 × 1/50 × 1/5 = 4 行です。実際には city = 7 の行は全て pref = 0 かつ region = 0 なので、1,000 行が返ります。
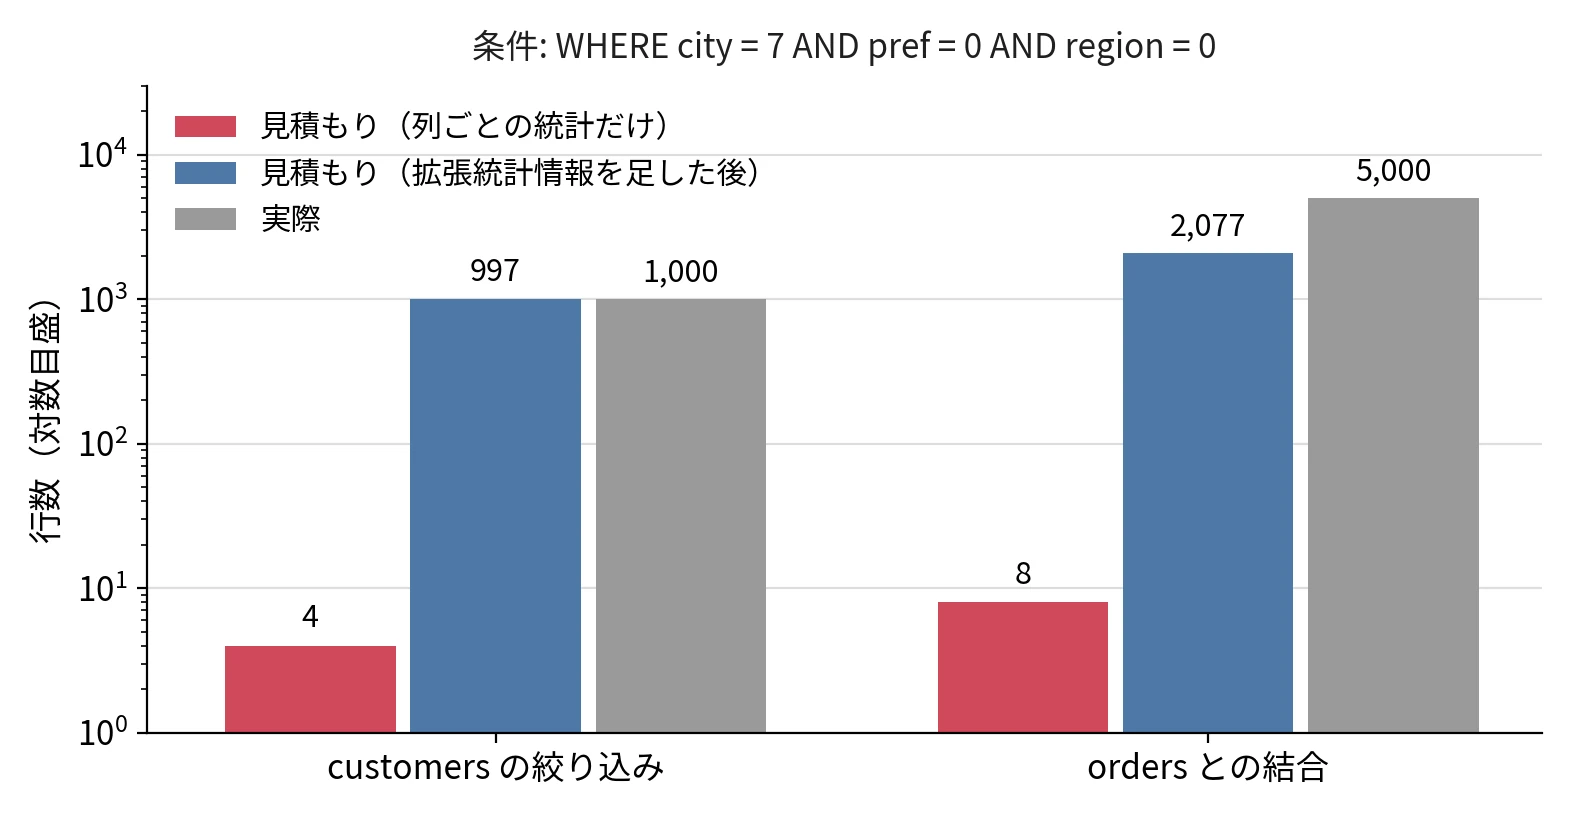
関係のある 3 列の条件で、見積もった行数と実際の行数
外れた見積もりは、その上の段に引き継がれます。この顧客の注文を表 orders と結合すると、見積もりは 8 行、実際は 5,000 行でした。この実験では、見積もりが外れても索引で注文を引く計画のままで、実行時間は拡張統計情報を足す前が 30 ms、後が 19 ms でした。拡張統計情報は、この後の小見出しで扱います。
Leis 氏らは論文「How Good Are Query Optimizers, Really?」(VLDB 2015)で、実在のデータと多くの表を結合する SQL を使って主要な DB の見積もりを調べ、どれも大きく外れることを示しました。見積もりは均一や独立のような単純な仮定に頼っていて、実在のデータではその仮定がよく外れ、ときに極端に遅い計画を生みます。プランナの選択を左右するのは、1 ページを読む手間を 1.0 とするような cost の単価よりも、この行数の見積もりの方だという結果も出ています。
列どうしの関係を教える
PostgreSQL では、CREATE STATISTICS で列の組を指定すると、列どうしの関係も記録します。この拡張統計情報(extended statistics)を足して ANALYZE をやり直すと、見積もりは 997 行になりました。
CREATE STATISTICS customers_dep (dependencies) ON city, pref, region FROM customers;
ANALYZE customers;
dependencies は、ある列の値が決まると別の列でも値が決まる関係を記録する種類です。他に、列の組ごとに異なる値の数を数える ndistinct と、よく出る値の組を記録する mcv があります。ただ、どの種類も、ある値を持つ行が、別の列で並べた時にどこへ来るかは記録しません。冒頭で LIMIT 1 が遅くなった原因は、この位置でした。
見積もりの外れの見つけ方と直し方
遅い SQL を見つけたら、EXPLAIN ANALYZE の各段で、見積もりの rows と実際の rows を並べて見ます。桁がずれている最初の段が、プランナの判断が狂い始めた所です。
冒頭の件では、見積もりの行数はほぼ合っていて、手掛かりは Rows Removed by Filter: 4990000 でした。Limit の下にある段が膨大な行を捨てていたら、プランナが「すぐ見つかる」と見込んだ行が、並びの後ろに固まっています。
見積もりが外れても、返る行が間違うわけではありません。変わるのは、どの読み方が速いかという判断だけです。直し方は、外れた理由で変わります。どちらの理由でも、大量に書き込んだ直後は統計情報が古いままのことがあるので、先に ANALYZE を実行します。
| 外れた理由 | 直し方 | 実験での結果 |
|---|---|---|
| 行が並びの後ろに固まる | 条件と並べ替えに使う列を並べた複合索引 | 329 ms → 0.055 ms |
| 条件の列どうしが関係する | CREATE STATISTICS | 4 行 → 997 行 |
複合索引 (user_id, id) を足すと、索引の中で利用者 1 の項目が id の順に並ぶので、最初の項目がそのまま答えになります。MySQL の user_id の索引が速かったのと同じ形です。
同じ形の SQL をパラメータを変えて何度も実行するアプリケーションでは、計画が使い回されることがあります。値を見ずに作った計画を使い回すと、利用者 500 にも利用者 1 にも同じ計画が使われます。その条件は Query Plan Cache で説明しています。PostgreSQL の本体には実行計画を指定するヒント句は無く、拡張の pg_hint_plan で足せます。
結合する表の数と、計画を選ぶ時間
2 つの表を結合する仕方には、次の 3 つがあります。プランナは、結合する表の組ごとに、この中から安いものを選びます。
| 結合の仕方 | 動き | 向く場面 |
|---|---|---|
| Nested Loop | 外側の 1 行ごとに内側を探す | 外側が少なく、内側を索引で引ける |
| Hash Join | 片方でハッシュ表を作り、もう片方で引く | 等しい値での結合で、ハッシュ表を作る側がメモリに収まる |
| Merge Join | 両方を結合の列で並べ、並行に読む | 両方が既に並んでいるか、並べ替えても安い |
先の顧客と注文の結合で見積もりが外れても計画が変わらなかったのは、顧客を外側に置いて注文を索引で引く Nested Loop が、4 行でも 1,000 行でも安かったからです。どちらの表を外側にするかもプランナが決めるので、FROM に書いた順とは限りません。
結合する表が増えると、候補の数が急に増えます。表が n 個なら、結合する順番だけで n の階乗(n!)通りあります。PostgreSQL のプランナは、2 表の組から順に最も安い結合の仕方を求め、それを積み上げて大きな組を作る動的計画法で、順番をほぼ網羅的に調べます。
組ごとに安い候補だけを残して先へ進み、結合の条件が無い組み合わせも原則として後回しにするので、n! 通りを全て比べるわけではありません。IBM の System R で示された方法で、1979 年の Selinger 氏らの論文が元になっています。
ただし、FROM に並ぶ表が geqo_threshold(既定は 12)以上になると、遺伝的アルゴリズムで一部の順番だけを調べる GEQO に切り替えます。1,000 行の表を 2〜14 個用意し、全てを 1 つ目の表と id で結合する SQL の、計画を作る時間を測りました。
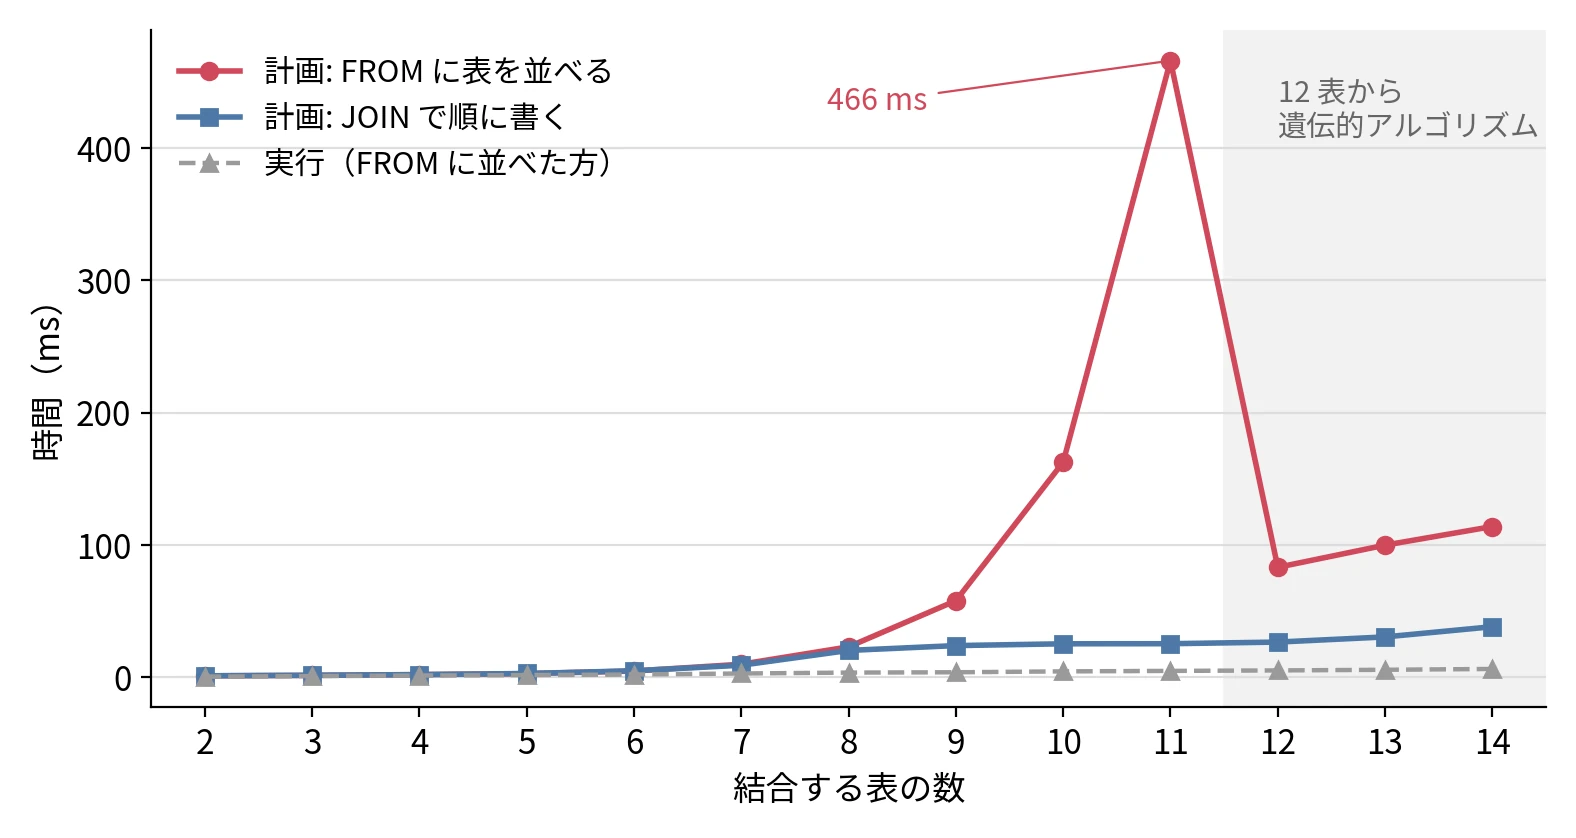
結合する表の数と、計画を作る時間
FROM に表を並べた 11 表の SQL は、計画に 466 ms、実行に 4.9 ms 掛かりました。実行よりも、読み方を選ぶ方に 100 倍近い時間を使っています。12 表で 83 ms に下がるのは、GEQO に切り替わって調べる順番が減るからです。調べる範囲の絞り方は DB ごとに違い、SQLite は結合の順を探す各段で、良い経路を少数だけ残して先へ進みます。
JOIN で書くと順番が残る
同じ結合を t1 JOIN t2 ON ... JOIN t3 ON ... と JOIN で書くと、9 表以降も計画の時間は 24〜38 ms に留まりました。JOIN の書き方では、join_collapse_limit(既定は 8)までの表は 1 つの並びにまとめて順番を探します。9 表目でまとめると 8 を超えるので、先の 8 表を 1 つの部分として先に順番を決め、その結果を 1 つの表と見なして残りの表と並べ、もう一度順番を探します。計画を作る時間は短くなりますが、先の 8 表を先に結合するという書いた形が実行計画に残ります。
ORM が生成する SQL や、ビューを重ねた SQL では、本人が書いたつもりのない数の表が結合されていることがあります。EXPLAIN ANALYZE の最後に出る Planning Time が Execution Time より大きければ、この節の現象を疑います。
遅くなった SQL に出会ったら
DB に任せた読み方が遅かった時、プランナが間違えたと考える前に、プランナが何を前提にしたかを EXPLAIN ANALYZE で読み取ります。
見る所は 3 つです。各段の見積もりと実際の rows がずれていれば、統計情報か列どうしの関係を疑い、ANALYZE と CREATE STATISTICS を試します。行数が合っているのに Limit の下で Rows Removed by Filter が膨らんでいれば、冒頭の図で赤い棒になったのと同じで、条件に合う行が並びの後ろに固まっています。WHERE の列と ORDER BY の列を並べた複合索引を作ります。Planning Time が Execution Time より大きければ、結合する表の数を見直すか、計画を使い回す仕組みを使います。
冒頭の図で赤い棒になった計画も、前提が合うデータなら 0.1 ms で終わる選択で、DB の不具合ではありません。データの偏りを知っているのは、表に行を書き込むアプリケーションです。
実験の SQL・実行用のスクリプト・出力の全体は lab/ にあります。