Query Plan Cache(実行計画のキャッシュ)は、DB(データベース)が同じ形の SQL を受け取るたびに構文解析と実行計画の作成をやり直さず、前に作った結果を使い回す仕組みです。実行計画(query plan)は、どの表をどの順に読み、どの索引を使うかという DB 内部の手順で、作り方は Query Processing のノートで説明しています。
使い回しの単位になるのが、プリペアドステートメント(prepared statement)です。$1 のような値の穴を残した SQL を先に DB に渡しておき、実行時には値だけを送ります。以下は、PostgreSQL で PREPARE した文を繰り返し EXECUTE する時に、解析と計画を何回目に行うかを示した図です。
PREPARE した文の解析と計画が行われる回
上記の図の解析は PREPARE の時に 1 回だけ行われます。計画は 2 通りで、1〜5 回目のように値を見て毎回作るのが custom plan、6 回目からのように値を見ずに作った計画を使い回すのが generic plan です。どちらを使うかを DB が途中で切り替えるので、同じ SQL が 6 回目から急に別の計画で動く、という現象が起こります。
本記事では、PostgreSQL 17 を中心に、実行計画を使い回す仕組みと、その使い回しが遅さの原因になる条件を説明します。扱う疑問は次の通りです。
- 解析・計画・実行のうち、どこを使い回しているのか。
- custom plan と generic plan は、どう選ばれるのか。
- 値の偏った列では、なぜ同じ計画が遅くなるのか。
- 表の定義や統計情報を変えた時、計画はいつ作り直されるのか。
- 接続プールやドライバは、知らないうちに何をしているのか。
複数の DB サーバーにまたがる分散実行と、SELECT の結果をそのまま保存する結果キャッシュには触れません。
計画を使い回す理由
実行計画を作るには、表と索引の定義を読み、統計情報から候補ごとのコストを見積もる必要があります。大量のレコードを読む集計では計画の時間は誤差ですが、主キーで 1 件を引くような短い SQL では、計画を作る時間と実行する時間が同じ桁に並びます。
例えば、後の実験では、10 件だけ読む EXECUTE の実行時間が 0.063 ms でした。3 回の実験の Planning Time は、計画を作った時が 0.06〜0.15 ms 程度、使い回した時が 0.01〜0.02 ms 程度でした。同じ形の SQL を毎秒数千回流すサーバーでは、この差が CPU 時間として積み上がります。
値を別に送るので SQL インジェクション対策にもなりますが、本記事では性能の面だけを説明します。
使い回す単位
使い回す単位は、DBMS(Database Management System)で違います。PostgreSQL は接続(セッション)ごとに文を保存し、SQL Server と Oracle Database は、サーバー全体で共有する領域に計画を置きます。
PREPARE で作った文は、そのセッションが終わると消え、他の接続からは使えません。
アプリが PREPARE と書かなくても、ドライバが 拡張問い合わせプロトコル(extended query protocol)の Parse・Bind・Execute の 3 つのメッセージで同じことをしています。Parse で解析し、Bind で値を渡し、多くの場合 Bind の処理の中で計画が作られます。PostgreSQL の手続き言語 PL/pgSQL で書いた関数の中の SQL も、同じ仕組みで計画を使い回します。
以下は、ドキュメントで確認できる範囲での比較です(2026 年 11 月時点)。
| PostgreSQL 17 | SQL Server 2022 以降 | Oracle Database 23 | |
|---|---|---|---|
| 計画を置く場所 | セッションごとのメモリ | サーバー全体のプランキャッシュ | 共有プールの shared SQL area |
| 別の接続との共有 | しない | する | する |
| 値を見て計画を作る時 | 最初の 5 回は毎回(custom plan) | コンパイル・再コンパイル時(parameter sniffing) | ハード解析時(bind peeking) |
| 値の偏りへの備え | 6 回目に generic plan と比べる | 件数の範囲ごとに複数の計画(PSP) | 値に応じて複数の計画(adaptive cursor sharing) |
SQL Server では、コンパイルした計画は読み取り専用の構造で、多数のユーザーが使い回します。値などの実行ごとの情報は、実行コンテキストという別の構造に分けて持ちます。Oracle でも、shared SQL area に解析木と実行計画が入り、セッションの状態はプライベート SQL 領域に置かれます。
PostgreSQL は共有しない分、接続を 100 本張れば同じ SQL の計画を 100 個作ります。その代わり、別の接続が作った悪い計画に引きずられることはありません。
Generic Plan と Custom Plan
PostgreSQL のプリペアドステートメントは、2 種類の計画のどちらかで実行されます。custom plan は、その回の値を埋め込んで作る計画で、shop_id = 1 なら 1 の統計を見て選びます。generic plan は値を見ずに作る計画で、全ての回で同じものを使います。
既定の plan_cache_mode(auto)では、次の順で選ばれます。
- 最初の 5 回は custom plan で実行し、それぞれの推定コストを記録する
- 6 回目に generic plan を 1 度作り、その推定コストを 5 回の平均と比べる
- generic plan の方が安ければ、以降は generic plan を使う
- 安くなければ custom plan を続け、以降も実行のたびに平均と比べ直す
custom plan の平均には、計画を作る手間の見積もりも足されます。そのため、計画の中身が同じなら generic plan が選ばれやすくなります。判定は実行のたびに GetCachedPlan から呼ばれる choose_custom_plan にあり、「5 回」はソースのコメントでも「arbitrary」(任意の値)と書かれた固定値です。
問題は、generic plan が値を知らない状態で件数を見積もる点です。shop_id = $1 のような等号の条件では、PostgreSQL はおおむね 1 / n_distinct(列の値の種類数の推定)を選択性(条件を通るレコードの割合)として使います(selfuncs.c の var_eq_non_const)。つまり、どの値も同じ件数を持つと仮定した、平均的な値の計画になります。
ちなみに、パーティションを持つ表では、generic plan でも実行開始時に $1 の値で不要なパーティションを外せます。
6 回目に計画が変わる実験
値の偏った列で、6 回目の切り替えを起こします。100 万件の注文のうち 99% を 1 つの大口店舗(shop_id = 1)が占め、残りの 1 万件を 1,000 店舗で 10 件ずつ分けた表です。PostgreSQL 17.11 の Docker コンテナで実行し、設定は既定のままです。以下は、実験用の SQL から切り替えに関わる部分を抜き出したものです。
CREATE TABLE orders (
  id      bigint PRIMARY KEY,
  shop_id int    NOT NULL,
  amount  int    NOT NULL
) WITH (autovacuum_enabled = off);   -- 実験中に自動の ANALYZE が走らないようにする
INSERT INTO orders
  SELECT g,
         CASE WHEN g % 100 = 0 THEN 2 + (g / 100) % 1000 ELSE 1 END,
         g % 1000
  FROM generate_series(1, 1000000) AS g;
CREATE INDEX orders_shop_id_idx ON orders (shop_id);
VACUUM ANALYZE orders;

PREPARE q(int) AS SELECT sum(amount) FROM orders WHERE shop_id = $1;
EXPLAIN (ANALYZE) EXECUTE q(1);   -- 1 回目
EXECUTE q(1);                     -- 2〜5 回目も同じ値
EXECUTE q(1);
EXECUTE q(1);
EXECUTE q(1);
EXPLAIN (ANALYZE) EXECUTE q(1);   -- 6 回目
EXPLAIN (ANALYZE) EXECUTE q(500); -- 小さい店舗
SET plan_cache_mode = force_custom_plan;
EXPLAIN (ANALYZE) EXECUTE q(1);   -- 値ごとの計画に戻す
pg_stats の n_distinct は 257 でした。実際は 1,001 種類ですが、ANALYZE は標本から推定するので、作り直すたびに揺れます(3 回で 257・261・265)。1 回目と 6 回目の実行計画は以下の通りです(抜粋)。
--- 1 回目
 Finalize Aggregate  (cost=12645.83..12645.84 rows=1 width=8) (actual time=35.400..40.521 rows=1 loops=1)
   ->  Gather  (cost=12645.62..12645.83 rows=2 width=8) (actual time=35.301..40.512 rows=3 loops=1)
         ->  Partial Aggregate  ...
               ->  Parallel Seq Scan on orders  (cost=0.00..10614.33 rows=412514 width=4) (actual time=0.008..21.204 rows=330000 loops=3)
                     Filter: (shop_id = 1)
 Planning Time: 0.108 ms
 Execution Time: 40.549 ms

--- 6 回目
 Aggregate  (cost=579.20..579.21 rows=1 width=8) (actual time=116.930..116.932 rows=1 loops=1)
   ->  Index Scan using orders_shop_id_idx on orders  (cost=0.42..569.47 rows=3891 width=4) (actual time=0.045..76.918 rows=990000 loops=1)
         Index Cond: (shop_id = $1)
 Planning Time: 0.123 ms
 Execution Time: 116.955 ms
1 回目は Filter: (shop_id = 1) と値が埋め込まれた custom plan で、99% を読むので表全体を並列に走査しています。6 回目は条件が $1 のままの generic plan に変わりました。推定は 1,000,000 / 257 ≒ 3,891 件で、実際の 990,000 件の約 250 分の 1 です。少数と見積もったので、Index Scan を選んでいます。
値も SQL も変えていないのに、実行時間は 40 ms から 117 ms に延びました。推定コストで見ると、custom plan の 12,646 に対して generic plan は 579 で、比較の時点では generic plan の方が 20 倍以上安く見えています。
同じ実験を 3 回流すと、custom plan(1 回目と後述の force_custom_plan)は 36〜84 ms、generic plan(6・7 回目)は 103〜169 ms でした(2 回目・3 回目の出力)。以下は、3 回の実験の 1・6・7 回目の実行時間を並べた図です。
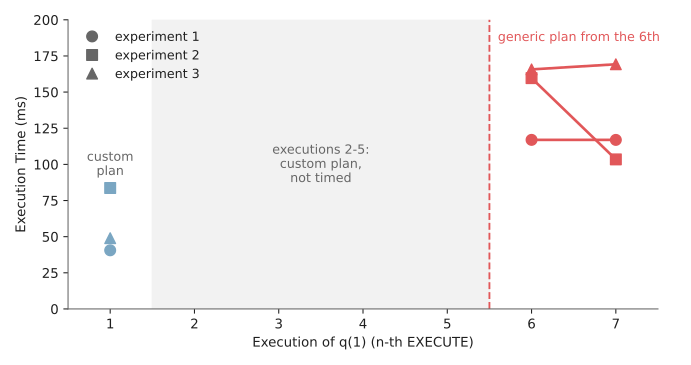
3 回の実験での q(1) の実行時間
ばらつきはあっても、どの実験でも 6 回目に generic plan に切り替わった所から遅くなっています。2〜5 回目は EXPLAIN を付けずに実行したので、時間を測っていません。
| 実行 | 計画 | 推定件数 | 実際の件数 | 実行時間 |
|---|---|---|---|---|
q(1) 1 回目 | custom(Parallel Seq Scan) | 約 99 万 | 990,000 | 40.5 ms |
q(1) 6 回目 | generic(Index Scan) | 3,891 | 990,000 | 117.0 ms |
q(500) 8 回目 | generic(Index Scan) | 3,891 | 10 | 0.063 ms |
q(1) force_custom_plan | custom(Parallel Seq Scan) | 約 99 万 | 990,000 | 39.7 ms |
並列の走査の rows は、全体の件数をワーカー数に応じた係数(ここでは 2.4)で割った推定で、全体では約 99 万件です。上記の表の 3 行目の通り、同じ generic plan でも小さい店舗には向いています。plan_cache_mode = force_custom_plan にすると、毎回値を見て計画を作るので、大口店舗は元の並列走査に戻りました。
反対に、最初の 5 回を小さい店舗の値で実行すると、手順の 4 の通り 6 回目も custom plan のままでした(pg_prepared_statements の generic_plans が 0、custom_plans が 6)。custom plan の推定コストは約 15(計画の手間を足して約 20)で、generic plan の 579 より安かったからです。
つまり、切り替わるかどうかは、最初の 5 回にどの値が来たかで変わります。
パラメータの偏りで遅くなる条件
上記の実験から、同じ計画が遅くなる条件は次の 3 つが重なった時だと分かります。
- 列の値の件数が大きく偏っている(大口顧客、
statusの大半が完了、など) - 件数によって最適な計画が変わる(索引か全走査か、結合の順序や方法など)
- 使い回す計画が、件数の違う値を前提に作られている
SQL Server の parameter sniffing も同じ構図です。違いは、どの値を前提にするかです。PostgreSQL の generic plan は値を見ない平均的な計画で、SQL Server はコンパイル(または再コンパイル)した時に渡された値を見て作った計画を使い回します。Oracle Database の bind peeking も、ハード解析の時だけ値を見ます。
そのため、SQL Server や Oracle では、たまたま最初に来た値で 1 日の性能が変わる、という形で表に出ます。
これに対して、SQL Server 2022 以降の Parameter Sensitive Plan optimization(PSP、互換性レベル 160 以上)は、統計のヒストグラムから偏った等号の条件を見つけ、件数の範囲ごとに別の計画を持ちます。Oracle の adaptive cursor sharing も、値によって計画を分ける機能です。PostgreSQL 17 の generic plan は、1 つの文に 1 つです。
計画が作り直される条件
保存した計画は、表の定義や統計が変わると古くなります。PostgreSQL は、文が参照する表や関数を覚えておき、それらが変わったという通知(キャッシュの無効化)を受けると、次の実行の前に解析と計画をやり直します。
PREPARE のドキュメントには、DDL(Data Definition Language、表や索引を定義する SQL)による定義の変更、統計の更新、search_path の変更が挙げられています。実験で確かめた結果は以下の通りです。
| 変更 | 実験での結果 |
|---|---|
DROP INDEX | 次の EXECUTE で generic plan が並列の全走査に変わった |
CREATE INDEX | 次の EXECUTE で Index Scan に戻った |
ALTER TABLE ... ADD COLUMN | SELECT * の文が cached plan must not change result type で失敗した |
SET search_path = archive | 同じ文が archive.orders を数えた(100 万件 → 1 件) |
行数とページ数が変わらない ANALYZE | 作り直されなかった |
1 件足してからの ANALYZE | 作り直された |
ADD COLUMN のエラーは、文を解析し直した結果、* の展開で返す列が増えたからです。PostgreSQL は、プリペアドステートメントの結果の形が途中で変わることを許しません。実験では、DEALLOCATE して PREPARE し直すと、4 列の結果で動きました。
統計の更新は、ドキュメントの説明より条件が狭い結果になりました。n_distinct = 2 を設定して ANALYZE すると、pg_stats の値は 2 に変わり、新しく作った generic plan は 50 万件(並列の走査の表示では 2.4 で割った 208,333 件)と見積もります。しかし、元からあった文は 3,891 件の計画のままでした。
--- ANALYZE の前後で、pg_class の値は同じ
 relpages | reltuples
     5406 |     1e+06
--- 行数もページ数も変わらない ANALYZE の後(元からあった文)
   ->  Index Scan using orders_shop_id_idx on orders  (cost=0.42..569.47 rows=3891 width=4)
--- 1 件足してから ANALYZE した後(元からあった文)
               ->  Parallel Seq Scan on orders  (cost=0.00..10614.34 rows=208333 width=4)
ソースを読むと、理由が分かります。計画を捨てる合図は pg_class(表の行数やページ数を持つカタログ)などの更新から出ます(inval.c)。列の値の分布を持つ pg_statistic の更新には、保存した計画は反応しません(plancache.c のコールバック登録)。
ANALYZE は、行数やページ数などが前と同じなら pg_class を書き換えません(vacuum.c の vac_update_relstats)。以下は、合図が出る変更と出ない変更を並べた図です。
計画を捨てる合図が出る更新と出ない更新
上記の図の右の列が、実験で元からあった文が 3,891 件の計画のまま残った経路です。
書き込みのある表では、ANALYZE のたびに行数やページ数が少しずつ動くので、作り直されることが多い筈です。しかし、値の分布だけが変わった時に古い計画が残る経路があることは、覚えておくと調査の役に立ちます。
接続プールとドライバ
アプリが PREPARE を書かなくても、ドライバが自動でプリペアドステートメントを使うことがあります。Go の pgx は、既定(QueryExecModeCacheStatement)で文を自動的に prepare してキャッシュします。Java の PgJDBC は、prepareThreshold(既定 5)に達した 5 回目の実行から名前付きの文に切り替えます。
サーバー側の 5 回はそこから数えるので、generic plan への切り替えはさらに後になる筈です(本記事では未検証)。どちらも、ORM(Object-Relational Mapping)越しに SQL を発行するアプリで起こり得ます。
接続プールを挟むと、もう 1 つ問題が出ます。PgBouncer の transaction mode は、トランザクションが終わるたびにサーバー接続をプールに返します。プリペアドステートメントはサーバー側のセッションにあるので、次のトランザクションが別の接続に割り当てられると、その文は存在しません。
PgBouncer は 1.21.0(2023 年 10 月)で、プロトコルの名前付きプリペアドステートメントに対応しました。max_prepared_statements が 0 以外なら、クライアントが作った文を追跡し、割り当てた接続に無ければその場で prepare します。1.24.0 からは既定値が 200 になり、最初から有効です。ただし、SQL の PREPARE と EXECUTE はそのまま転送され、追跡されません。
以下は、1.21 の前と後で、別の接続に割り当てられたトランザクションが同じ文を使う時の動きです。
PgBouncer の transaction mode で文が別の接続に渡る時
上記の図の tx 1 と tx 2 は、同じクライアントが続けて流したトランザクションです。
PgBouncer は文を接続ごとに prepare し直すので、「5 回」もサーバー接続ごと・文ごとに数えられる筈です。そのため、同じ API が時々だけ遅いという症状になり得ます(本記事では未検証)。
対策として plan_cache_mode を force_custom_plan にする場合、transaction mode ではセッションの SET が別の接続に残るので、トランザクション内の SET LOCAL か、ALTER ROLE ... SET を使います。後者は新しいサーバー接続にしか効かず、PgBouncer が保持している既存の接続は張り直すまで古い値のままです。
利点
- 短い SQL で、毎回の解析と計画の CPU 時間を省ける
- PostgreSQL では、custom plan で値ごとの計画を作るか、generic plan で計画を省くかを DB が自動で選ぶ
- DDL や
search_pathの変更では、使う側が何もしなくても計画が作り直される
欠点
実行計画のキャッシュは、計画を作る時間を省くために、計画を値に合わせる機会を手放します。その代わりに、次の制約があります。
- 値の件数が偏った列では、使い回した計画が一部の値で大きく遅くなる
- 切り替わるかどうかが最初の数回の値で変わり、再現しにくい
- PostgreSQL では接続ごとに計画を持つので、接続数の分だけメモリと計画の手間がかかる
- 列の追加で
cached plan must not change result typeが出るなど、スキーマ変更とぶつかる - 統計だけが変わった時に、古い計画が残る場合がある
Query Plan Cache の効果が小さくなりやすいケース
- 1 回に大量のレコードを読む集計やバッチで、計画の時間が実行時間に比べて無視できる場合
- 同じ文を 1 接続で数回しか流さず、使い回す前に接続が切れる場合
- 値によって件数が何桁も変わる列を条件に持ち、毎回 custom plan が必要になる場合
3 つ目は、キャッシュを使わない方が良いという意味ではありません。解析は使い回し、計画だけを毎回作る force_custom_plan も選べます。値の偏りが無い列なら、generic plan で計画を省く利点の方が大きくなります。
実験の SQL・実行用のスクリプト・出力の全体は lab/ にあります。