MVCC(Multiversion Concurrency Control)は、レコードを更新しても古い内容をすぐには消さず、複数の版を並べて持つことで、読み手と書き手が互いを待たずに済むようにする仕組みです。PostgreSQL では、UPDATE は古い版の隣に新しい版を足し、DELETE は版に「消した」という印を付けるだけです。誰からも見えなくなった古い版を後で回収するのが、VACUUM という処理です。
例えば、件数は 10 万件のまま変わらないのに、表のファイルが毎日大きくなっていく DB(データベース)があるとします。調べると VACUUM は動いているのに古い版が 1 件も消えておらず、原因は誰かが開いたまま放置したトランザクションだった、という場面です。以下は、手元の PostgreSQL 17 で、この場面を小さく再現した結果です。10 万件の表の全件を 10 回更新し、表の大きさを記録しました(比べるために、表ごとに自動の VACUUM を止めています)。
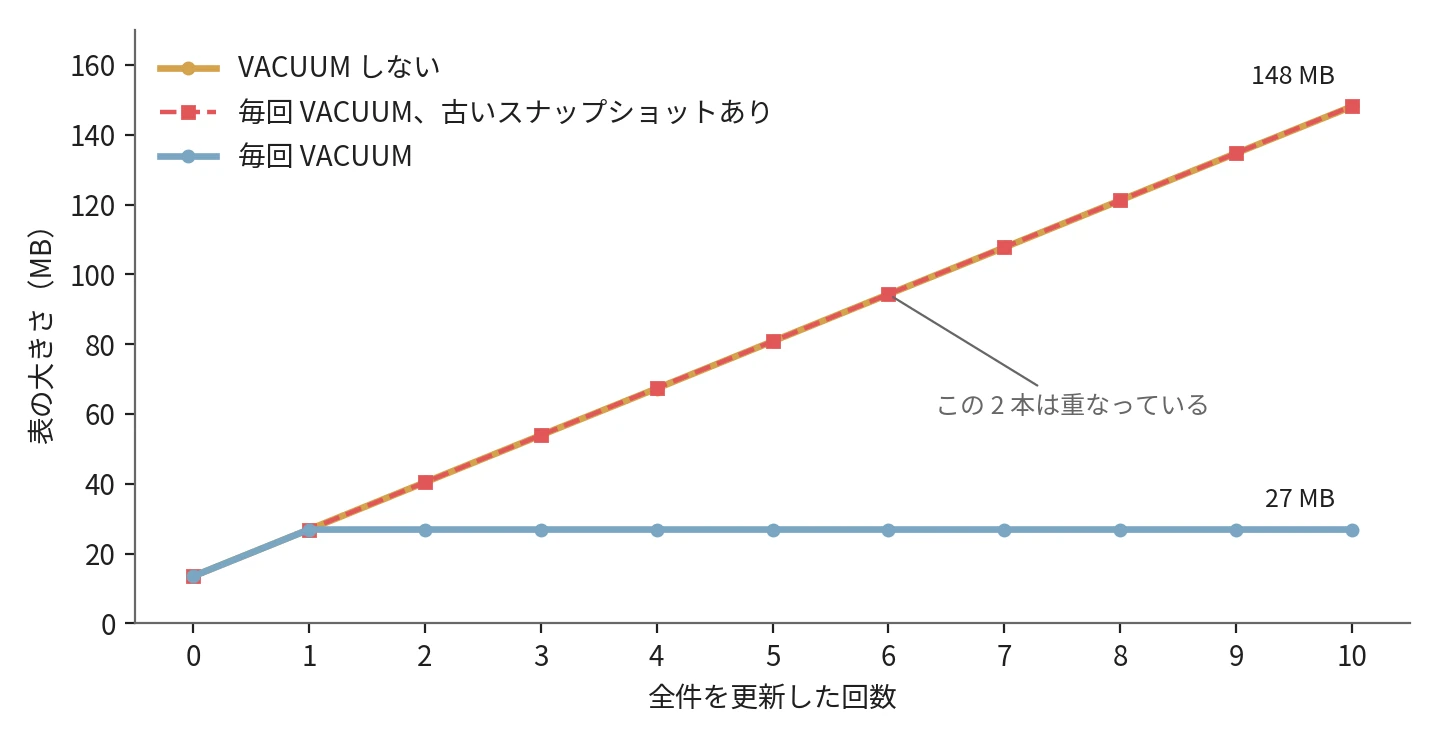
10 万件の全件を 10 回更新した時の表の大きさ
スナップショットは、ある時点までに確定(COMMIT)したデータだけが見える、読み取りの視点です。毎回 VACUUM する表は 27 MB で止まりました。一方、毎回 VACUUM しても、別の接続が古いスナップショットを持ったままの表は、VACUUM しない表と同じ 148 MB まで増えました。件数はどの表も 10 万件です。
本記事では、PostgreSQL 17 で手元に作った表を使って、MVCC が版をどう持ち、VACUUM がそれをいつ消せるのかを説明します。扱う疑問は次の通りです。
- UPDATE と DELETE は、表のブロックの中で何をしているのか。
- VACUUM は何を消し、なぜ表のファイルは小さくならないのか。
- 開いたままのトランザクションは、なぜ VACUUM を止めるのか。
- 自動の VACUUM(autovacuum)は、いつ動くのか。
- VACUUM が追いつかないと、最後に何が起きるのか。
MVCC が読み手に見せる版を選ぶ規則(分離レベル)は、Transaction Isolation と Snapshot Isolation のノートで扱っているので、本記事では繰り返しません。MySQL(InnoDB)のように、古い版を表の外(undo log)に置く実装との比較にも深入りしません。
UPDATE は版を足す
PostgreSQL の表は、8 KB のブロックを並べたファイルです。1 つのブロックに、レコードの版(tuple)がいくつも入ります。各版には、その版を作ったトランザクションの ID(xmin)と、その版を消したトランザクションの ID(xmax、まだ消されていなければ 0)が付いています。トランザクション ID は、書き込みをするトランザクションに 1 つずつ振られる通し番号です。
2 件の口座(id 1 の残高 100、id 2 の残高 500)を入れた表で、id 1 の残高を 200 に更新しました。psql で 1 文ずつ実行すると、文ごとに別のトランザクションとして確定する(自動コミット)ので、INSERT が 741、UPDATE が 742、後の DELETE が 743 になっています。拡張機能 pageinspect の heap_page_items() は、ブロックの中の版を、見えるかどうかに関係なく全て並べます。
SELECT lp, t_xmin, t_xmax, t_ctid FROM heap_page_items(get_raw_page('acct', 0));
 lp | t_xmin | t_xmax | t_ctid
----+--------+--------+--------
  1 |    741 |    742 | (0,3)
  2 |    741 |      0 | (0,2)
  3 |    742 |      0 | (0,3)
lp はブロックの中の版の番号、t_ctid は次の版の位置(ブロック 0 の 3 番、のように読みます)で、自分自身を指していれば最新の版です。普通の SELECT では id 1 は 1 件しか見えませんが、ブロックの中には 1 番(残高 100)と 3 番(残高 200)の 2 つの版があります。以下は、この 2 つの版と、それを読む側の関係を描いた図です。
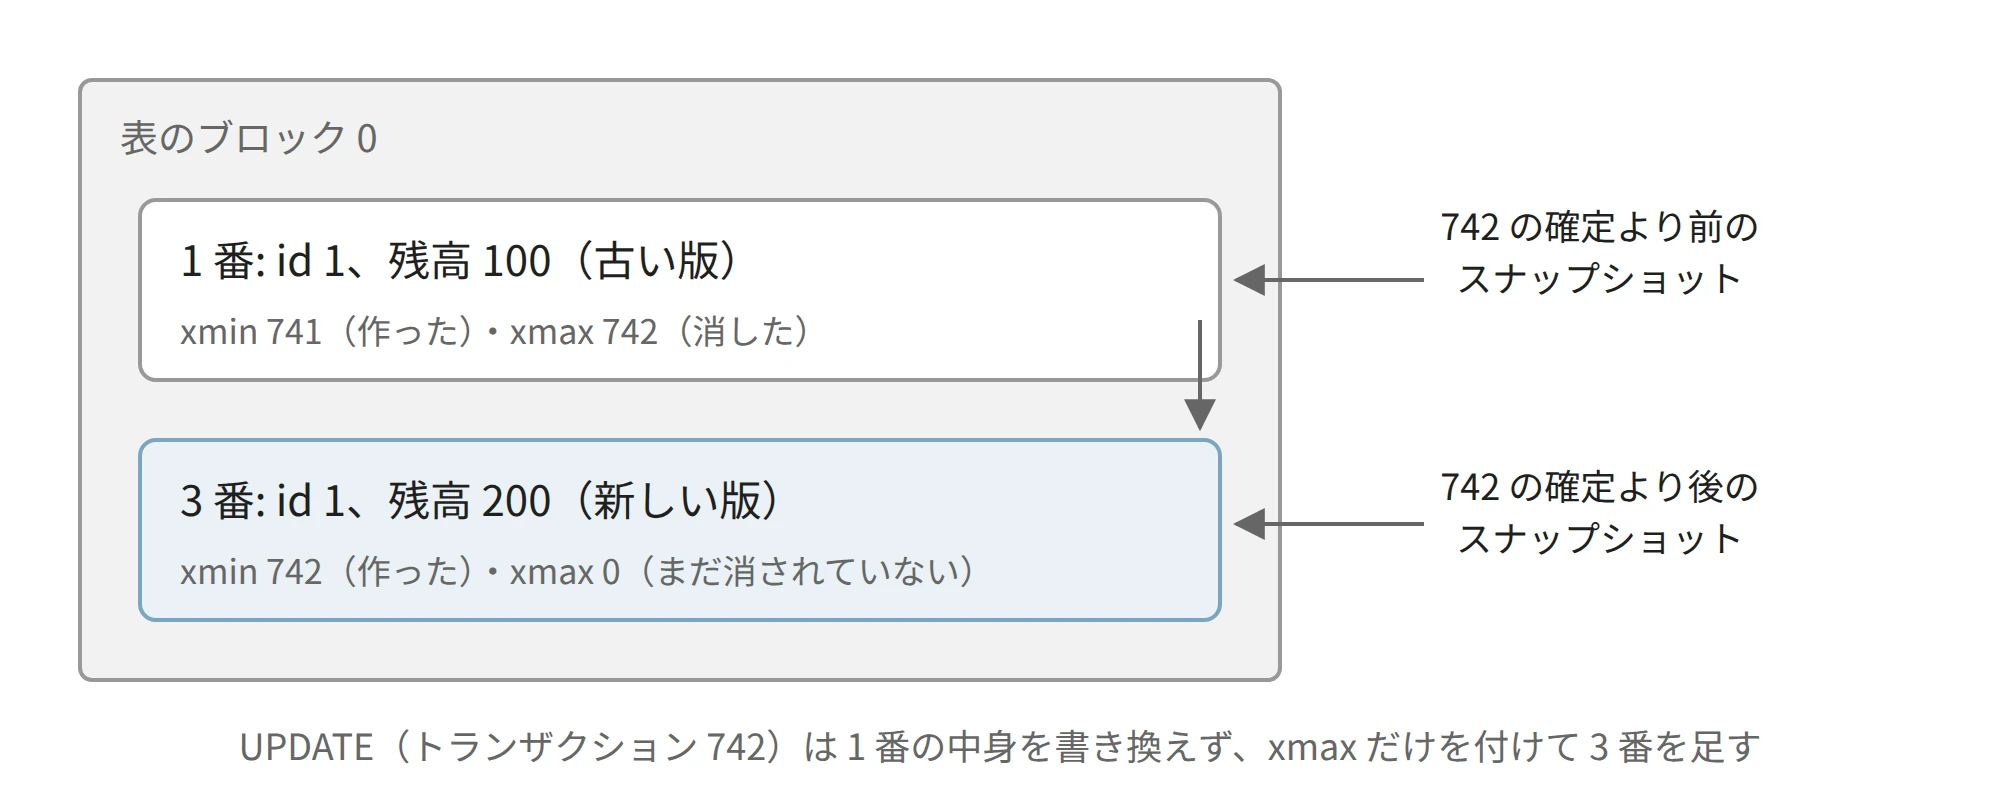
UPDATE の後のブロックの中(id 2 の版は省略)
UPDATE を実行したトランザクション 742 は、1 番の中身を書き換えず、xmax に自分の ID を書いて、3 番を足しました。742 が確定する前に取ったスナップショットで読むトランザクションは 1 番を、確定した後に取ったスナップショットで読むトランザクションは 3 番を読みます。書き手が古い版を残しておくので、読み手は書き手を待たずに読めます。
続けて id 1 を DELETE すると、3 番の xmax に 743 が入るだけで、版はブロックに残りました。
 lp | t_xmin | t_xmax | t_ctid
----+--------+--------+--------
  1 |    741 |    742 | (0,3)
  2 |    741 |      0 | (0,2)
  3 |    742 |    743 | (0,3)
VACUUM が消すもの
xmax が付いて、その削除が確定し、今後どのスナップショットからも見えなくなった版を、PostgreSQL のドキュメントでは dead tuple(死んだ版)と呼びます。「どのスナップショットからも見えない」という条件は、後の節で効いてきます。上の DELETE の後で VACUUM acct を実行すると、ブロックの中は次のようになりました。
SELECT lp, lp_flags, t_xmin, t_xmax, t_ctid FROM heap_page_items(get_raw_page('acct', 0));
 lp | lp_flags | t_xmin | t_xmax | t_ctid
----+----------+--------+--------+--------
  1 |        0 |        |        |
  2 |        1 |    741 |      0 | (0,2)
1 番は中身が消えて空き(lp_flags が 0。1 は使用中)になり、末尾の 3 番は番号ごと無くなりました(末尾に並んだ空きの番号は詰められます)。生きている id 2 の版だけが残っています。VACUUM は、死んだ版を消し、その版を指す索引の項目も消して、空いた場所を次の INSERT や UPDATE で使えるようにします。
空いた場所は使い回すが、ファイルは縮まない
冒頭のグラフで、毎回 VACUUM した表が 1 回目に 13.5 MB から 27 MB に増え、そこで止まったのは、このためです。1 回目の UPDATE で、全件の新しい版が足されて 2 倍になります。その後の VACUUM で古い版の場所が空き、2 回目の UPDATE はその空きに新しい版を書きます。古い版と新しい版の 2 組分の場所があれば、それ以上は増えません。
VACUUM は空いた場所を使い回せるようにするだけで、ファイルを小さくはしません(末尾のブロックが丸ごと空き、表のロックがすぐ取れる時は、その分を切り詰めます)。VACUUM しなかった 148 MB の表で確かめると、次の通りでした。
VACUUM しなかった表        148 MB
VACUUM の後               148 MB
もう 1 回、全件を UPDATE    148 MB(空いた場所を使ったので増えない)
VACUUM FULL の後           13 MB
VACUUM FULL は、生きている版だけを新しいファイルに書き写して表を作り直すので、ファイルが元の大きさに戻ります。その代わり、作り直す間は表に最も強いロック(ACCESS EXCLUSIVE)を取り、読み出しも止めます。動いているサービスの表に気軽には使えません。
古いスナップショットが VACUUM を止める
VACUUM が消せるのは、どのトランザクションからも見えなくなった版だけです。冒頭のグラフの赤の破線では、別の接続で次のトランザクションを開き、表を 1 回読んだまま待たせておきました(実験では、ロックの解放を待たせることで開いたままにしています)。
BEGIN ISOLATION LEVEL REPEATABLE READ;
SELECT count(*) FROM items_hold;
-- ここで止まったまま
REPEATABLE READ では、トランザクションの最初の問い合わせで取ったスナップショットを最後まで使います。このトランザクションは、いつ同じ表をもう一度読むか分かりません。読んだ時には、スナップショットを取った時点の版を返す必要があります。そのため、その時点より後に消された版は、どれも消せません。
この接続のスナップショットは、トランザクション ID 797 より前に確定したものだけが見える状態でした。接続ごとのこの境目は、pg_stat_activity の backend_xmin で見られ、ここでは 797 でした。以下は、トランザクション ID の軸の上で、どこまでの版を消せるかを描いた図です。
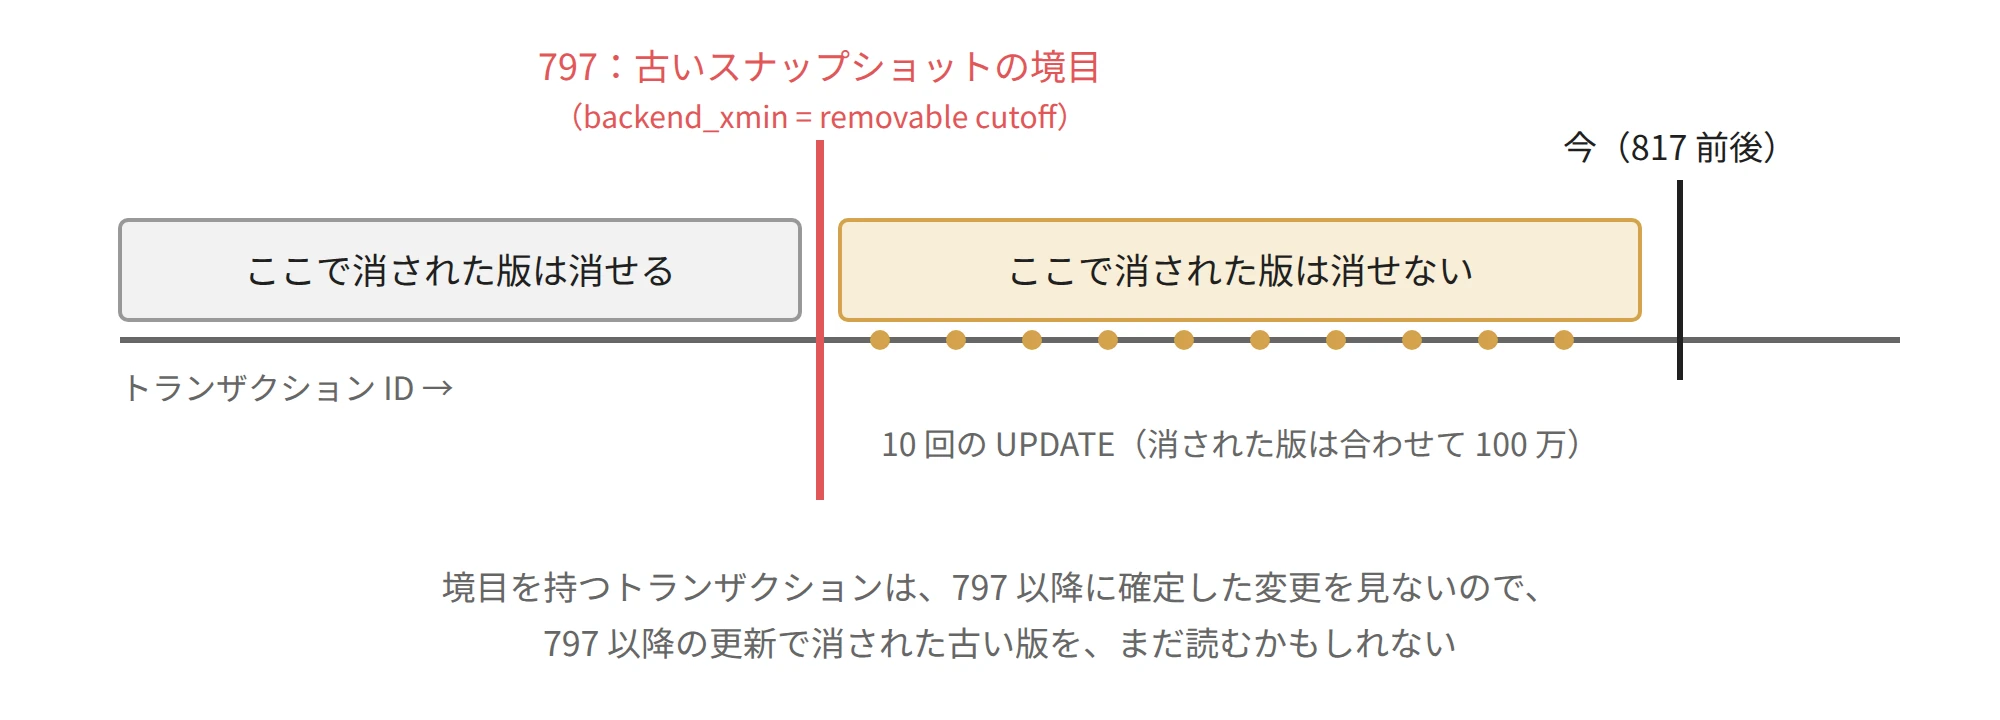
古いスナップショットより後に消された版は消せない
10 回の UPDATE はどれも 797 より後なので、10 回分の古い版は全て消せません。この状態で VACUUM (VERBOSE) を実行すると、次の出力になりました。
VACUUM (VERBOSE) items_hold;
INFO:  finished vacuuming "postgres.public.items_hold": index scans: 0
pages: 0 removed, 18966 remain, 18966 scanned (100.00% of total)
tuples: 0 removed, 1100000 remain, 1000000 are dead but not yet removable
removable cutoff: 797, which was 20 XIDs old when operation ended
tuples: の行は、110 万の版(生きている 10 万と死んだ 100 万)のうち、死んだ 100 万を 1 件も消していない(0 removed、dead but not yet removable)ことを示します。removable cutoff: 797 が、消せる版の境目で、backend_xmin と同じ値です。VACUUM は表の全 18,966 ブロック(pages: の行)を読んだうえで、何も消さずに終わりました。
待たせていたトランザクションを確定させてから、もう一度 VACUUM を実行すると、次の通りでした。
tuples: 1000000 removed, 100000 remain, 0 are dead but not yet removable
removable cutoff: 828, which was 0 XIDs old when operation ended
100 万の版が消え、生きている 10 万件だけが残りました。古いスナップショットは、その表だけでなく、同じ DB の全ての表の VACUUM を止めます。実験でも、毎回 VACUUM の表の計測を、待たせるトランザクションを開く前に済ませる必要がありました。
READ COMMITTED の場合
実験は REPEATABLE READ でしたが、PostgreSQL の既定の分離レベルは READ COMMITTED で、文ごとにスナップショットを取り直し、文が終わると手放します。そのため、読むだけで、カーソルも開いていないトランザクションは、BEGIN したまま止まっていても、文を実行していない間は境目を止めません。ただし、1 つの文が何時間も掛かれば、その間は止めます。また、書き込みをしたトランザクションは、自分のトランザクション ID を確定まで持ち続けるので、止まっている間も境目を止めます。
古いスナップショットを作るもの
実際のサービスで古いスナップショットを作りやすいのは、次のようなものです。
BEGINしたまま、アプリの処理や外部 API の呼び出しを待つトランザクション(idle in transactionの状態)のうち、書き込みをした後のもの、カーソルを開いたままのもの、REPEATABLE READ 以上のもの- 何時間も掛かる集計や、バックアップのための長い読み出し
- 読み取り用の複製(レプリカ)で長い問い合わせを流し、その境目を書き込みを受ける側(プライマリ)に伝える設定(hot_standby_feedback)。プライマリが古い版を消すと、レプリカの問い合わせが読む版が無くなるので、この設定ではプライマリが消すのを待つ
- hot_standby_feedback を使っていたレプリカが止まったまま残った、物理レプリケーションのスロット(複製先がどこまで受け取ったかをプライマリが覚えておく仕組みで、受け取った境目も覚え続ける)。論理レプリケーションのスロットが止めるのは、システムカタログの回収だけ
1 つ目は、トランザクションの範囲を広げすぎた時に起きます(Transaction Scope のノート)。PostgreSQL には、idle in transaction のまま一定の時間が経った接続を切る idle_in_transaction_session_timeout がありますが、既定は 0(切らない)です。
autovacuum が動く時
VACUUM を人が実行することはほとんどありません。PostgreSQL には、表ごとに死んだ版の数を数え、一定を超えると VACUUM を実行する autovacuum が既定で動いています(冒頭で触れた通り、本記事の実験では表ごとに止めています)。
既定では、死んだ版の数が「50 + 表の件数の 20%」を超えた表が対象になります(autovacuum_vacuum_threshold と autovacuum_vacuum_scale_factor)。10 万件の表なら 20,050 件です。1 億件の表では 2,000 万件になるので、大きな表ほど、死んだ版が大量に溜まってから動きます。大きな表だけ、この割合を表ごとに小さくする設定がよく使われます。
autovacuum が動いていても、上の節の古いスナップショットがあれば消せません。死んだ版の数が減らないので、autovacuum は同じ表を何度も読み直し、何も消せずに終わります。
トランザクション ID の周回
VACUUM には、もう 1 つ大事な仕事があります。トランザクション ID は 32 ビットの数で、約 40 億で一周します。PostgreSQL は、ある ID から見て約 20 億個前までを過去、20 億個先までを未来として比べます。そのため、版の xmin がそのまま残っていると、約 20 億のトランザクションの後、その版は突然「未来に作られた版」になり、見えなくなります。
これを防ぐため、VACUUM は十分に古い版に「凍結した(frozen)」印を付け、どのトランザクションからも過去として見えるようにします(ドキュメント)。表の中で最も古い凍結していない ID が 2 億トランザクション分(autovacuum_freeze_max_age の既定)古くなると、autovacuum を止めていても、凍結のための VACUUM が強制的に走ります。
以下は、32 ビットの ID を円で描き、凍結していない古い版が見えなくなる仕組みを示した図です。
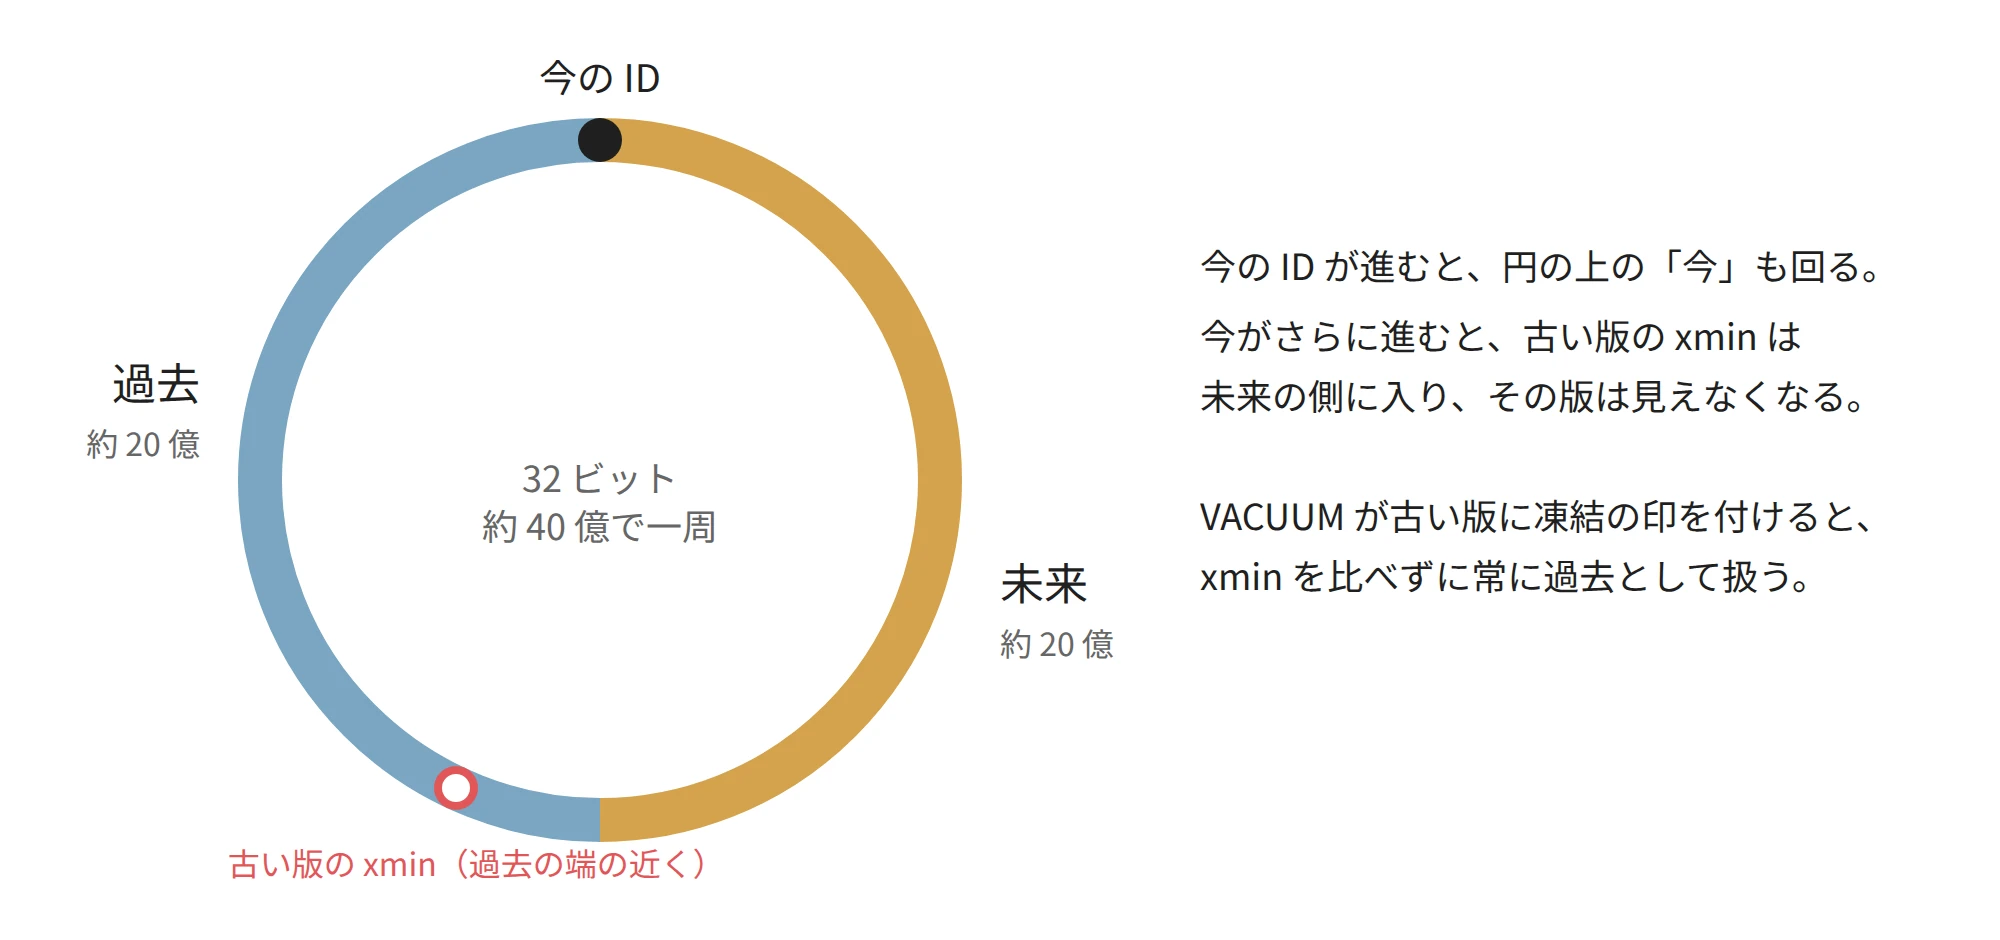
32 ビットのトランザクション ID の円
周回の手前で、PostgreSQL は段階を踏んで知らせます。残りが 4,000 万トランザクションを切るとログに警告を出し、それでも凍結が追いつかず、残り 300 万トランザクションを切ると、PostgreSQL は新しいトランザクション ID の割り当てを拒否します。書き込みが全て止まり、次のエラーになります。
ERROR: database is not accepting commands that assign new transaction IDs to avoid wraparound data loss in database "mydb"
実際に止まった例
エラー監視のサービス Sentry は、2015 年 7 月 20 日、米国の業務時間のほとんどの間止まりました。原因は、この周回を防ぐための VACUUM が追いつかず、書き込みが止まったことでした。
メール配信の Mandrill(Mailchimp のサービス)も、2019 年 2 月 4 日から 5 日にかけて、同じ周回の問題で送信が滞りました。Mailchimp の報告によると、ピーク時の負荷でトランザクション ID が上限の半分ほどまで上がることには 2018 年 11 月の時点で気づいていたものの、差し迫った問題ではないと判断していました。
どちらも、普段は見えない VACUUM の遅れが、ある日まとめて書き込みの停止として表に出た例です。手元の DB では、SELECT datname, age(datfrozenxid) FROM pg_database で、各 DB の最も古い凍結していない ID がどれだけ古いかを確かめられます。
利点
- 読み手は書き手を待たず、書き手は読み手を待たない
- 長い読み出しの途中でも、始めた時点の一貫した内容を読める
- PostgreSQL では古い版を表の中に残しておくので、更新を取り消す(ROLLBACK)時に元の内容を書き戻す必要が無い
欠点
PostgreSQL の MVCC は、古い版を表の中に残すことで、読み手と書き手が互いを待たない仕組みにしています。その代わりに、次の制約があります。
- 更新と削除のたびに死んだ版が残り、VACUUM で回収するまで表と索引が膨らむ
- VACUUM は空いた場所を使い回すだけで、ファイルを小さくするには VACUUM FULL などで表を作り直す必要がある
- 書き込みをしたまま、または古いスナップショットを持ったまま開いているトランザクションが 1 つあるだけで、同じ DB の全ての表の回収が止まる
- トランザクション ID が 32 ビットなので、凍結の VACUUM が追いつかないと書き込みが止まる
VACUUM の問題が小さくなりやすいケース
- 追記だけで、更新と削除がほとんど無い表(ログや履歴)
- 古いデータを
DELETEではなく、パーティションごと捨てる表(Partitioning のノート) - トランザクションが全て短く、
idle in transactionの接続を監視・切断している DB
実験の SQL・実行用のスクリプト・出力の全体は lab/ にあります。