ページング(pagination)は、一覧の結果を 20 件ずつのように区切って返す仕組みです。SNS のタイムライン、管理画面の一覧、API の一覧取得など、件数が多い一覧のほとんどで使われます。SQL で書く方法は大きく 2 つあり、1 つは LIMIT 20 OFFSET 40 のように先頭から何件を飛ばすかを指定する OFFSET、もう 1 つは前のページの最後のレコードの値を覚えておき、その続きから読むキーセット(keyset pagination、seek method とも呼ばれる)です。
以下は、PostgreSQL 17 に投稿 100 万件の表を作り、読み始める位置を変えながら 20 件を読む時間を測った結果です。
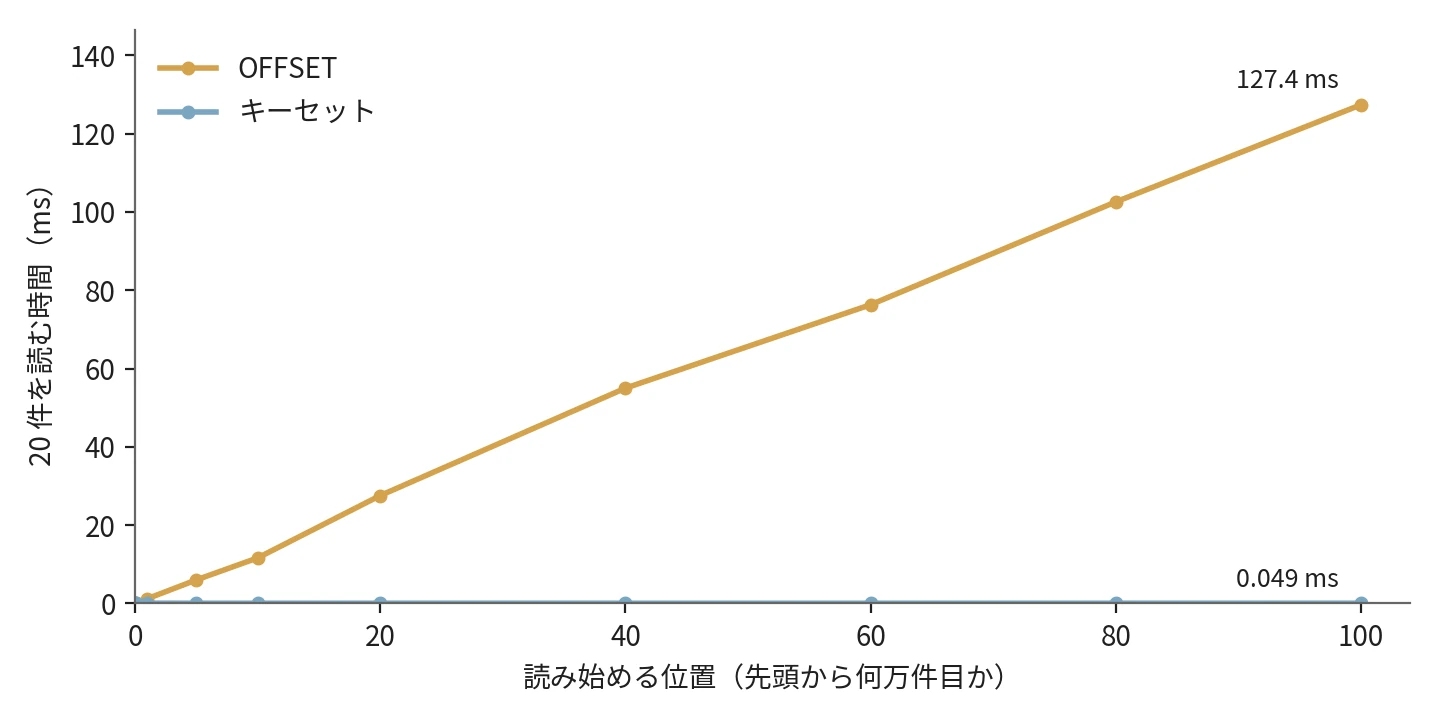
同じ 20 件を読む時間(7 回の中央値)
どちらの方法も、返す 20 件は同じです。それでも OFFSET は後ろのページほど遅くなり、最後のページではキーセット(0.049 ms)の約 2,600 倍の時間が掛かりました。差は速さだけではありません。ページを読む間に新しい投稿が入ると、OFFSET では次のページに前のページと同じ投稿が並びます。
本記事では、PostgreSQL 17 で手元に作った表を使って、2 つの方法の違いを説明します。扱う疑問は次の通りです。
- OFFSET は、なぜ後ろのページほど遅くなるのか。
- キーセットは、なぜどの位置でも同じ速さで読めるのか。
- ページを読む間にレコードが増減すると、何が起きるのか。
- キーセットの条件は、どう書くと速く、どう書くと OFFSET と同じ遅さに戻るのか。
- キーセットにできないこと(ページ番号への移動・総件数)は、どう補うのか。
全文検索のスコア順のように並びのキーが索引に無い一覧や、複数の DB サーバーにまたがる一覧には触れません。
2 つの書き方
例として、投稿を新しい順に 20 件ずつ並べる一覧を考えます。表は次の形で、created_at(投稿時刻)の新しい順、同じ時刻なら id の大きい順に並べます。索引は、この並びと同じ順で作っておきます(索引が要る理由は、後の節で実行計画を見ながら説明します)。
CREATE TABLE posts (
  id         bigint PRIMARY KEY,
  created_at timestamptz NOT NULL,
  title      text NOT NULL
);
CREATE INDEX posts_created_id ON posts (created_at DESC, id DESC);
OFFSET では、ページ番号から飛ばす件数を計算します。3 ページ目なら、先頭の 40 件を飛ばして次の 20 件です。
SELECT id, created_at, title FROM posts
ORDER BY created_at DESC, id DESC
LIMIT 20 OFFSET 40;
キーセットでは、前のページ(2 ページ目)の最後のレコード、つまり先頭から 40 件目の (created_at, id) を覚えておき、それより後ろに並ぶレコードを 20 件読みます。新しい順に並べているので、後ろに並ぶのは値が小さいレコードで、条件は < になります。
SELECT id, created_at, title FROM posts
WHERE (created_at, id) < ('2026-01-06 18:53:00+00', 999961)  -- 2 ページ目の最後のレコード
ORDER BY created_at DESC, id DESC
LIMIT 20;
(a, b) < (x, y) は 行の比較(row constructor comparison)で、左の要素から順に比べ、a が同じ時だけ b を比べます。2 つの SQL は、同じ 3 ページ目の 20 件を返します。
前のページの最後の値をどこから受け取るかは、API なら「次のページの続きの位置」(カーソル、cursor)として返すのが一般的です。決済サービスの Stripe の API は、一覧の最後のオブジェクトの ID を starting_after に渡すと続きを返します。GraphQL の Relay のカーソル接続の仕様 も、各要素にカーソルの文字列を付け、after に渡して続きを読む形です。この文字列の中身を利用者に見せない理由は、後の「カーソルを API で返す時の注意」の節で説明します。
OFFSET が後ろのページほど遅い理由
OFFSET が遅いのは、飛ばすレコードを飛ばしているわけではなく、読んでから捨てているからです。PostgreSQL のドキュメント にも「OFFSET で飛ばすレコードも、サーバーの中では計算しなければならない。そのため、大きな OFFSET は効率が悪いことがある」と書かれています。
以下は、索引の葉(索引の一番下の段で、キーが並び順に並んでいる所)に並ぶキーを新しい順に描き、2 つの方法がどこを読むかを示した図です。索引の木の形は B-Tree のノートで説明しています。
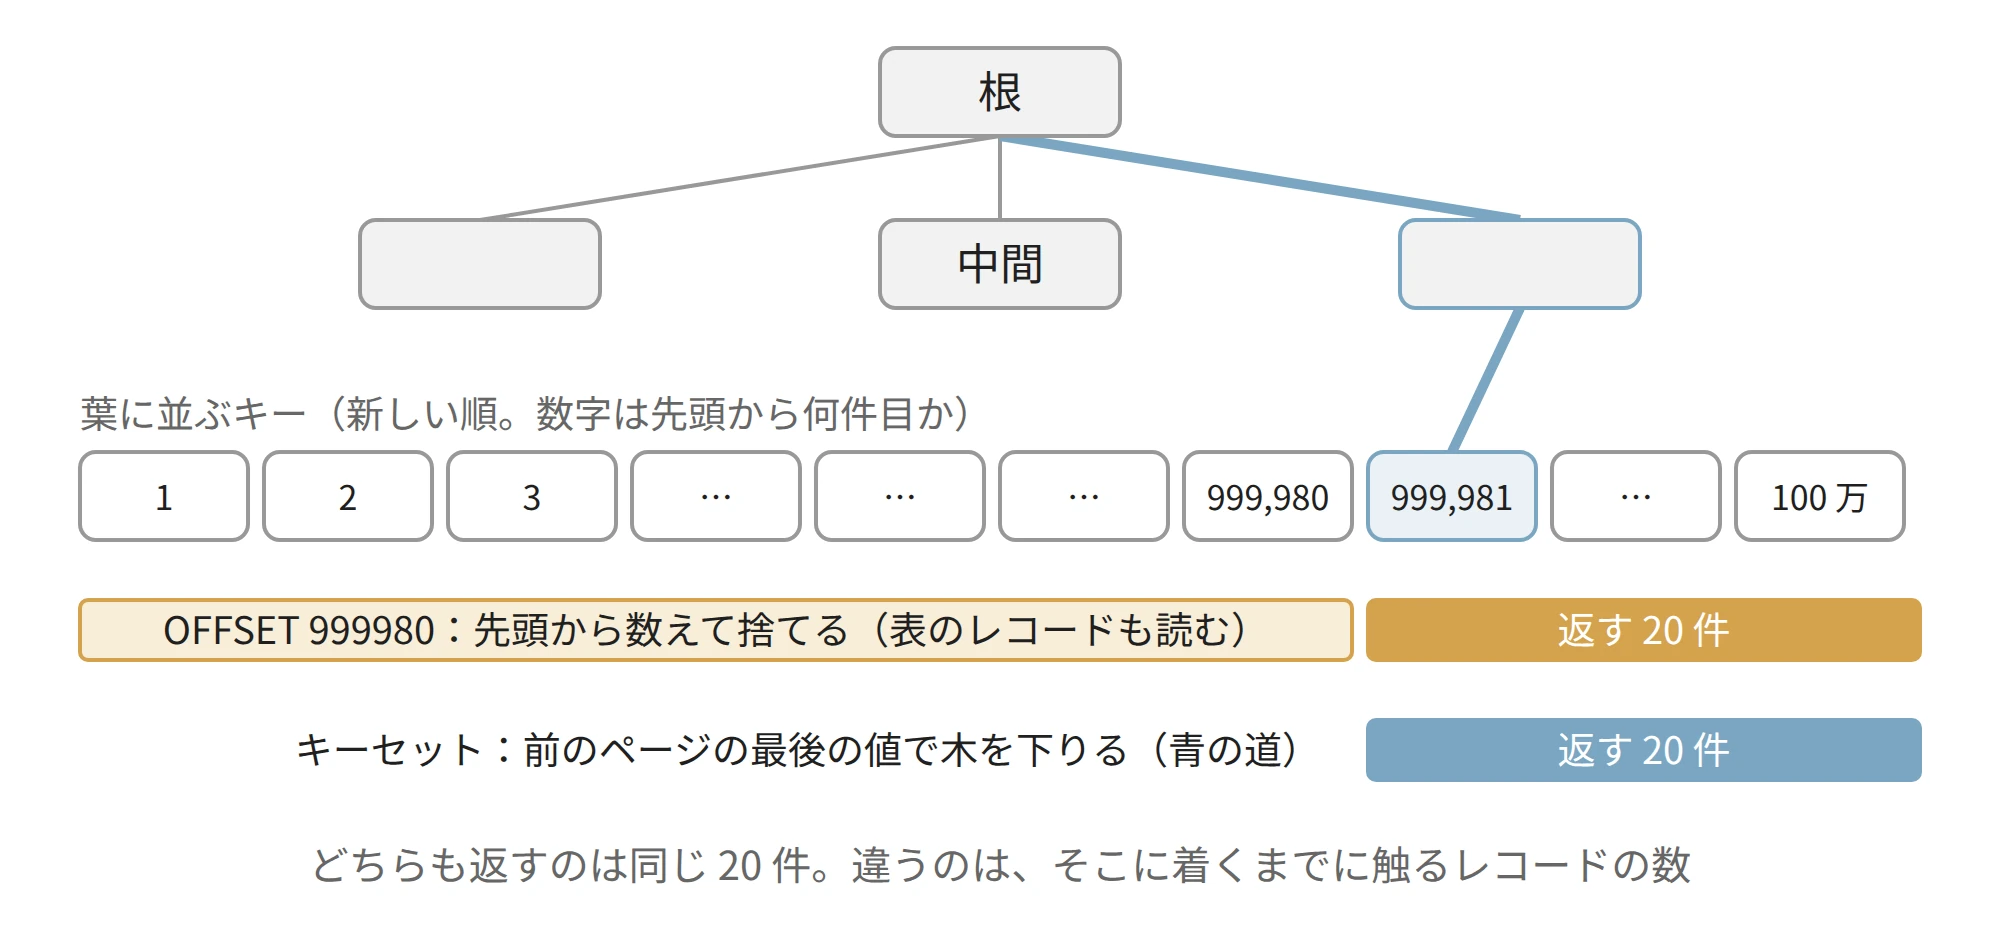
OFFSET は先頭から数え、キーセットは木を下りて途中から読む
OFFSET は、索引の先頭から 1 件ずつ数えて、999,980 件目まで来た所でやっと返し始めます。キーセットは、前のページの最後の値を目印に、根から葉まで木を下ります。100 万件の索引でも、木の段数は数段で済みます。
ここから先は、DB が 8 KB ずつ読み書きする単位が何度も出てきます。PostgreSQL のドキュメントではこれもページと呼びますが、一覧のページと紛らわしいので、本記事ではブロックと呼びます。
実際に最後のページを OFFSET で読むと、次の実行計画になりました。EXPLAIN (ANALYZE, BUFFERS) は、SQL を実際に実行して、各段階で返したレコードの数と読んだブロックの数を表示します。Buffers の hit は DB のメモリ(共有バッファ)にあったブロック、read は共有バッファに無く、OS に読み出しを頼んだブロック(OS のキャッシュから返った分も含む)の数です。
EXPLAIN (ANALYZE, BUFFERS, COSTS OFF)
SELECT id, created_at, title FROM posts
ORDER BY created_at DESC, id DESC
LIMIT 20 OFFSET 999980;

 Limit (actual time=291.823..291.831 rows=20 loops=1)
   Buffers: shared hit=7356 read=3831
   ->  Index Scan using posts_created_id on posts (actual time=0.009..221.326 rows=1000000 loops=1)
         Buffers: shared hit=7356 read=3831
 Execution Time: 291.849 ms
下の段の Index Scan は 100 万件を返し、上の段の Limit がそのうち 999,980 件を捨てて 20 件だけを返しています。読んだブロックは合わせて 11,187 です。表のブロックは 7,353 個(後の節で総件数を数えた時に読んだ数)なので、表の全てのブロックに触り、残りの約 3,800 回は索引のブロックに触った分です。
表まで読むのは、Index Scan が索引で見つけたレコードを 1 件ずつ表から取り出して上の段に渡し、捨てるかどうかはその後で Limit が決めるからです(索引から表を読む流れは Index Scan のノート)。
この 291.8 ms は、3,831 ブロックを OS から読んだ最初の 1 回の値です。冒頭のグラフの 127.4 ms は、全てのブロックが DB のメモリに載った後の中央値です。どちらにしても、時間は飛ばす件数に比例して伸びます。
キーセットが位置によらず速い理由
同じ最後のページを、キーセットで読みます。実際の一覧では前のページから受け取る値ですが、ここでは実験のために、999,980 件目のレコードを先に調べて ('2026-01-01 00:00:10+00', 21) を得ました。
実行計画の Index Cond は、索引で読み始める位置を決める条件です。索引の木を下りて条件を満たす最初のキーを探し、そこから葉を順に読みます。
EXPLAIN (ANALYZE, BUFFERS, COSTS OFF)
SELECT id, created_at, title FROM posts
WHERE (created_at, id) < ('2026-01-01 00:00:10+00', 21)
ORDER BY created_at DESC, id DESC
LIMIT 20;

 Limit (actual time=0.029..0.036 rows=20 loops=1)
   Buffers: shared hit=4
   ->  Index Scan using posts_created_id on posts (actual time=0.018..0.022 rows=20 loops=1)
         Index Cond: (ROW(created_at, id) < ROW('2026-01-01 00:00:10+00'::timestamp with time zone, 21))
         Buffers: shared hit=4
 Execution Time: 0.175 ms
Index Cond に行の比較がそのまま入り、Index Scan は 20 件を返した所で止まっています。読んだブロックは 4 で(索引の根・中間・葉の 3 段と、表の 1 ブロック)、OFFSET の 11,187 の約 2,800 分の 1 です。0.175 ms は 1 回だけ測った値なので、グラフの中央値(0.049 ms)とは少しずれます。
触るレコードの数が飛ばす件数に依存しないので、1 ページ目でも最後のページでも時間は同じです。冒頭のグラフで、キーセットの線が横軸に張り付いていたのはこのためです。
キーセットが速いのは、並びの順と同じ順の索引があり、条件が Index Cond に入る時だけです。索引が無ければ、どのページでも表を全件読み、条件を満たすレコードを並べ替えるので、キーセットでも 1 ページ目から遅くなり、位置によらず速いという利点は無くなります。条件の書き方で Index Cond から外れる例は、後の節で取り上げます。
読む間にレコードが増えると重なる
OFFSET のもう 1 つの問題は、ページの境目が「先頭から何件目か」で決まることです。1 ページ目を読んでから 2 ページ目を読むまでの間に、先頭に新しい投稿が入ると、全てのレコードが後ろにずれます。
ここからは、見やすさのために、id 1〜20 の投稿を 1 分おきの時刻で入れた小さな表 feed を使います(id 16 の時刻は 00:16)。5 件ずつのページで、1 ページ目に 20〜16 を読んだ後、21〜23 の 3 件が入った場合を試しました。以下は、その時の並びと、2 ページ目として返ったレコードを描いた図です。
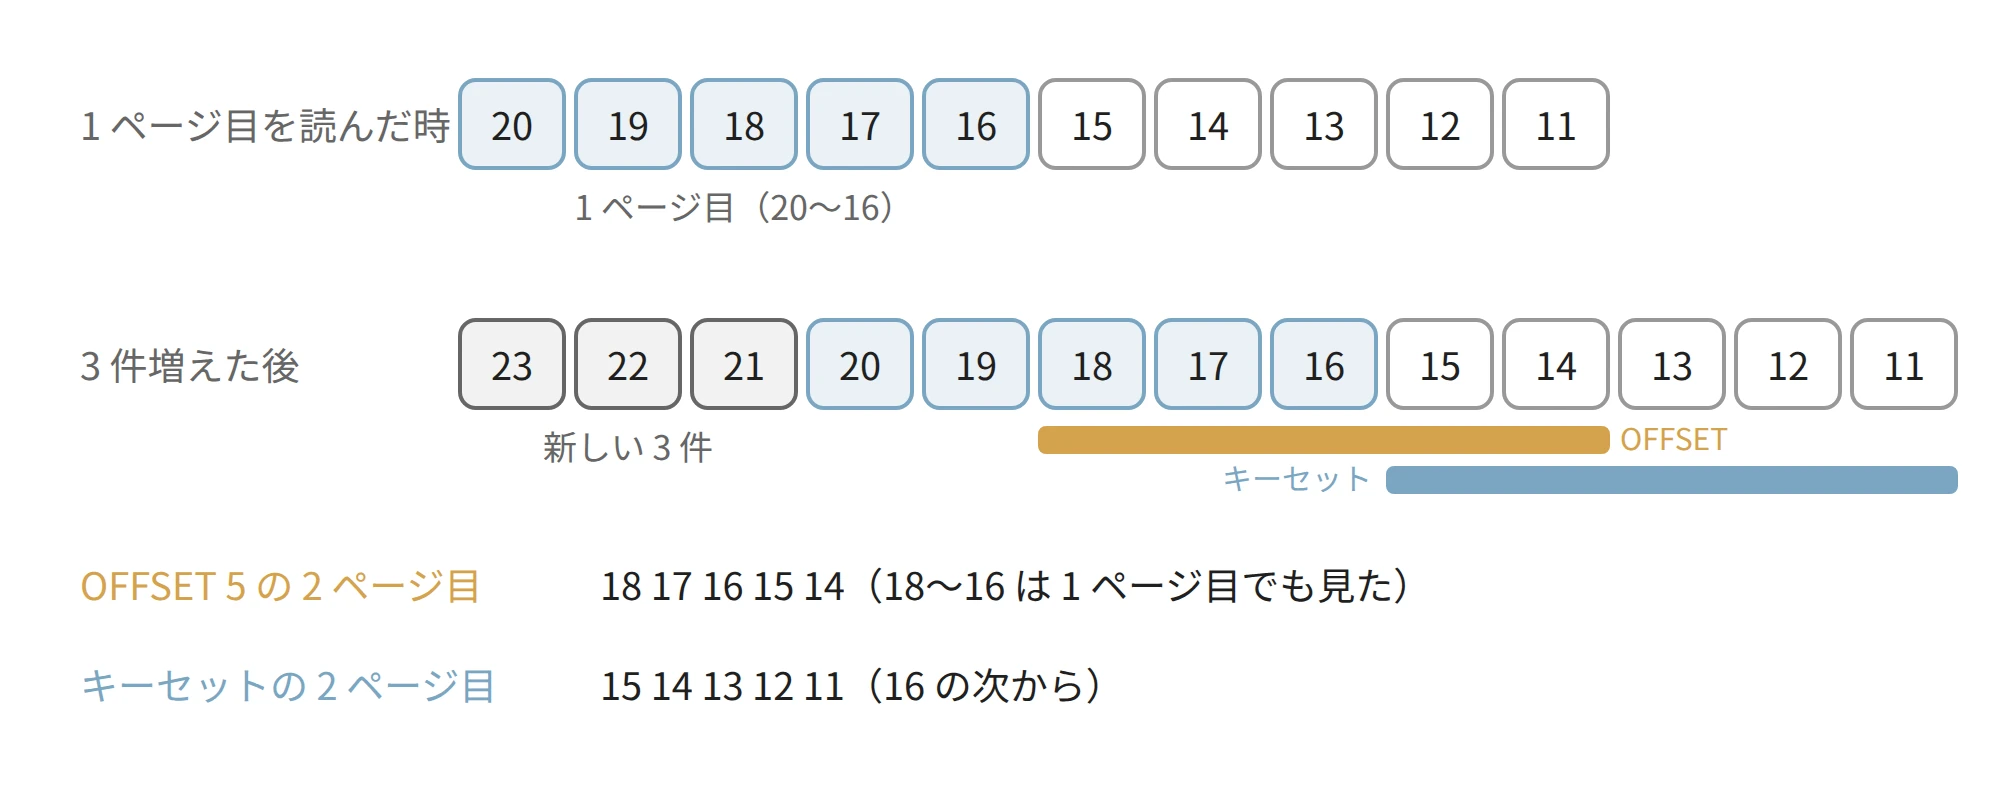
1 ページ目を読んだ後に 3 件増えた時の 2 ページ目
OFFSET 5 の 2 ページ目は 18・17・16・15・14 で、18〜16 の 3 件は 1 ページ目でも表示したものです。キーセットは「16 より後ろ」を読むので、15 から続きます。
逆に、1 ページ目に読んだレコードが消えると、OFFSET は消えた件数だけ飛ばします。増えた 3 件を消して元の 20 件に戻し、1 ページ目(20〜16)を読んだ後に 19 と 18 を消すと、2 ページ目は次の通りでした。
SELECT id FROM feed ORDER BY created_at DESC, id DESC LIMIT 5 OFFSET 5;   -- OFFSET の 2 ページ目
 id
----
 13
 12
 11
 10
  9

SELECT id FROM feed
WHERE (created_at, id) < (timestamptz '2026-01-01 00:16:00+00', 16)
ORDER BY created_at DESC, id DESC LIMIT 5;                                 -- キーセットの 2 ページ目
 id
----
 15
 14
 13
 12
 11
OFFSET では 15 と 14 が、どのページにも表示されません。重なりは利用者が気づけますが、飛ばしは気づけないので、通知や注文の一覧ではこちらの方が困ります。
キーセットでも、並びのキーそのものが書き換わるレコードは防げません。例えば updated_at(更新時刻)の順で並べる一覧では、読んでいる間に更新されたレコードが先頭へ移り、まだ読んでいないページから消えます。これを防ぐには、一覧の全体を同じ時点で読む必要があります。1 つのトランザクションでスナップショットを固定して読む方法は、Snapshot Isolation のノートで説明しています。ただし、利用者がページを送る間ずっとトランザクションを開けておくのは、現実的ではありません。
並びのキーを一意にする
キーセットの条件に使うキーは、並びの中で 1 件を一意に決められなければなりません。投稿時刻だけで並べると、同じ時刻の投稿がページの境目に来た時に取りこぼします。
6 件の投稿だけを入れた表 tie で試します。新しい順に 6・5・4・3・2・1 と並び、そのうち 4 と 3 が同じ 10:02 の投稿です。1 ページ目を 3 件読むと 6・5・4 で、最後のレコードは 4 です。2 ページ目を created_at だけの条件で読んだ場合と、(created_at, id) で読んだ場合は次の通りでした。
SELECT id, created_at FROM tie WHERE created_at < '2026-01-01 10:02+00'
ORDER BY created_at DESC LIMIT 3;                                                  -- created_at だけ
 id |       created_at
----+------------------------
  2 | 2026-01-01 10:01:00+00
  1 | 2026-01-01 10:00:00+00

SELECT id, created_at FROM tie WHERE (created_at, id) < ('2026-01-01 10:02+00', 4)
ORDER BY created_at DESC, id DESC LIMIT 3;                                         -- (created_at, id)
 id |       created_at
----+------------------------
  3 | 2026-01-01 10:02:00+00
  2 | 2026-01-01 10:01:00+00
  1 | 2026-01-01 10:00:00+00
created_at < 10:02 は、4 と同じ時刻の 3 まで外します。主キーの id を最後に足して (created_at, id) にすると、同じ時刻の中でも順序が決まり、3 が残ります。並びと索引と条件の 3 か所で、同じキーを同じ順に並べるのが原則です。
OFFSET でも、並びが一意でなければ同じ時刻のレコードの順序は実行のたびに変わり得るので、ページの境目で重なりや飛ばしが起きます。並びのキーを一意にするのは、どちらの方法でも要ることです。
OFFSET と同じ遅さに戻る書き方
行の比較は SQL の標準にありますが、対応は DBMS(Database Management System)ごとに違います。キーセットの解説で知られる Use The Index, Luke! の記述(SQL Server は 2017 の時点、MySQL は版の記載なし)によると、SQL Server は行の比較そのものを書けず、MySQL は正しく評価するものの、索引で読み始める位置を決める条件には使えません。そうした DBMS や、ORM(Object-Relational Mapping、表のレコードとプログラムのオブジェクトを対応させるライブラリ)で書きにくい場合は、同じ条件を OR で書きます。
WHERE created_at < x OR (created_at = x AND id < y)
意味は行の比較と同じですが、PostgreSQL 17 でも実行計画は違いました。100 万件の中ほど(50 万件目)を読み始める位置にすると、次のようになりました。
EXPLAIN (ANALYZE, BUFFERS, COSTS OFF)
SELECT id FROM posts
WHERE created_at < '2026-01-03 21:26:40+00'
   OR (created_at = '2026-01-03 21:26:40+00' AND id < 500001)
ORDER BY created_at DESC, id DESC
LIMIT 20;

 Limit (actual time=56.337..56.344 rows=20 loops=1)
   ->  Index Only Scan using posts_created_id on posts (actual time=56.334..56.338 rows=20 loops=1)
         Filter: ((created_at < '2026-01-03 21:26:40+00'::timestamp with time zone) OR ((created_at = '2026-01-03 21:26:40+00'::timestamp with time zone) AND (id < 500001)))
         Rows Removed by Filter: 500000
 Execution Time: 56.380 ms
Index Only Scan は、可視性マップ(表のブロックごとに、全てのレコードが誰からも見えるかを記録したもの)で見えると分かるブロックについては、表を読まずに索引だけで答える読み方です。ここでは使う列が id と created_at だけで、どちらも索引にあるので選ばれています。問題は、条件が Index Cond ではなく Filter に入っていることです。Filter は、索引から読んだレコードを 1 件ずつ見て、合わないものを捨てる条件です。1 回の索引の走査で範囲に使えるのは AND でつないだ条件だけで、OR でつないだ条件は使えないからです(PostgreSQL のドキュメント)。索引は先頭から読まれ、50 万件を捨てた後に 20 件を返しました。書き方はキーセットでも、動きは OFFSET と同じです。
直すには、索引で範囲を絞れる条件を外側に AND で足します。created_at <= x は 1 列だけの単純な範囲なので、Index Cond に入ります。同じ索引、同じ 50 万件目からの読み出しは次の通りでした。
EXPLAIN (ANALYZE, BUFFERS, COSTS OFF)
SELECT id FROM posts
WHERE created_at <= '2026-01-03 21:26:40+00'
  AND (created_at < '2026-01-03 21:26:40+00' OR id < 500001)
ORDER BY created_at DESC, id DESC
LIMIT 20;

 Limit (actual time=0.079..0.087 rows=20 loops=1)
   ->  Index Only Scan using posts_created_id on posts (actual time=0.078..0.082 rows=20 loops=1)
         Index Cond: (created_at <= '2026-01-03 21:26:40+00'::timestamp with time zone)
         Filter: ((created_at < '2026-01-03 21:26:40+00'::timestamp with time zone) OR (id < 500001))
         Rows Removed by Filter: 1
 Execution Time: 0.123 ms
Index Cond で 50 万件目の時刻まで木を下り、Filter で捨てたのは同じ時刻の 1 件だけです。56.4 ms が 0.123 ms になりました。
この形は、並びに昇順と降順が混ざる場合にも使えます。例えば「投稿時刻は新しい順、同じ時刻の中は id の小さい順」です。行の比較は全ての要素を同じ向きに比べるので、列をそのまま並べた (a, b) < (x, y) では書けません。数値の列なら、-id のような式の索引を作って向きを揃える手もありますが、一般には OR で書きます。
OR の形だけで書くと、上と同じように 500,001 件を Filter で捨て、52.9 ms 掛かりました。並びと同じ向きの索引 (created_at DESC, id ASC) を作り、外側に created_at <= x を足すと、次の通りです。
EXPLAIN (ANALYZE, BUFFERS, COSTS OFF)
SELECT id FROM posts
WHERE created_at <= '2026-01-03 21:26:40+00'
  AND (created_at < '2026-01-03 21:26:40+00' OR id > 500001)
ORDER BY created_at DESC, id ASC
LIMIT 20;

 Limit (actual time=0.048..0.054 rows=20 loops=1)
   ->  Index Only Scan using posts_created_desc_id_asc on posts (actual time=0.045..0.049 rows=20 loops=1)
         Index Cond: (created_at <= '2026-01-03 21:26:40+00'::timestamp with time zone)
         Filter: ((created_at < '2026-01-03 21:26:40+00'::timestamp with time zone) OR (id > 500001))
         Rows Removed by Filter: 2
 Execution Time: 0.081 ms
52.9 ms が 0.081 ms になりました。
どの書き方が Index Cond に入るかは、DBMS と版で違います。キーセットを書いたら、後ろの方のページで EXPLAIN を実行し、索引で読み始める位置が決まっているか(PostgreSQL なら Index Cond があり、Rows Removed by Filter が小さいか)を確かめるのが確実です。
ページ番号・前のページ・総件数
キーセットは「前のページの続き」しか読めません。OFFSET の一覧にあった機能のうち、3 つは別の方法で補います。
ページ番号への移動
キーセットでは、「120 ページ目」へ直接移動できません。120 ページ目の先頭の値は、119 ページ目まで読まないと分からないからです。タイムラインのように「もっと見る」で続きを読む一覧なら、ページ番号は要りません。ページ番号が要る一覧でも、深いページまで移動する利用者が少なければ、浅いページだけ OFFSET を使い、深いページは「日付で絞る」のような検索に誘導する方法があります。
前のページ
前のページは、並びの向きと比較の向きを両方逆にして読み、返す前に並べ直します。今のページの最初のレコードが (x, y) なら、次の形です。
SELECT * FROM (
  SELECT id, created_at, title FROM posts
  WHERE (created_at, id) > (x, y)
  ORDER BY created_at ASC, id ASC
  LIMIT 20
) AS prev
ORDER BY created_at DESC, id DESC;
PostgreSQL の B-Tree 索引は逆向きにも読めるので、(created_at DESC, id DESC) の索引で、この昇順の読み出しもできます。
総件数
「全 50,000 ページ」のような表示には、総件数が要ります。100 万件の表で SELECT count(*) FROM posts を実行すると、表の全 7,353 ブロックを読み、66.5 ms 掛かりました。総件数はキーセットでも OFFSET でも同じ手間なので、ページを送るたびに数えると、キーセットで省いた時間が戻ってきます。一覧の表示では件数を出さないか、「1 万件以上」のように上限で止めるか、別に数えておいた値を使うのが一般的です。
カーソルを API で返す時の注意
キーセットの値をそのまま URL に載せると、?after_created_at=2026-01-03T21:26:40Z&after_id=500001 のように並びのキーが API の形の一部になります。後で並びのキーを変えると、API の利用者のコードも直す必要が出ます。
そのため、多くの API は値を 1 つの文字列にまとめて、中身を利用者に見せない形(不透明なカーソル、opaque cursor)で返します。Relay の仕様も、カーソルを利用者が中身を解釈しない不透明な文字列として扱います。Base64 で符号化しただけの文字列は利用者が書き換えられるので、サーバー側では、デコードした値を他の入力と同じように検証します。
利点
- 読み始める位置によらず、触るレコードがページの件数分で済む
- ページを読む間にレコードが増減しても、重なりや飛ばしが起きない
- 読み始める位置が件数ではなく値で決まるので、索引の木を下りて直接探せる
欠点
キーセットは、「前のページの続き」に限ることで、読み始める位置を索引で直接探せるようにした方法です。その代わりに、次の制約があります。
- 任意のページ番号へ直接移動できない
- 並びと同じ順の索引と、並びを一意に決めるキーが要る
- 並び順を利用者が選べる一覧では、並びごとに索引と条件が要る
- 条件の書き方によっては索引で範囲を絞れず、OFFSET と同じ遅さに戻る
- 並びのキーが書き換わるレコードは、キーセットでも重なりや飛ばしが起きる
キーセットの効果が小さくなりやすいケース
- 全体で数百件程度の一覧で、最後のページでも OFFSET の飛ばす件数が小さい場合
- 利用者のほとんどが最初の数ページしか見ない一覧
- 並びのキーに合う索引を作れない、または作る価値が無い一覧(全文検索のスコア順など)
- ページ番号での移動が要件として外せない管理画面
1 つ目と 2 つ目は、OFFSET でも遅くならない一覧です。lab の計測では、1 万件目から読んでも 1.2 ms でした。管理画面の一覧を OFFSET で作り、無限スクロールや API のように後ろまで読まれる一覧をキーセットにする、という使い分けがよく取られます。
実験の SQL・実行用のスクリプト・出力の全体は lab/ にあります。計測は手元の 1 台で取った値で、マシンの負荷によって数倍変わります。比べる時は、同じ回の計測どうしで比べてください。