Index Scan は、索引(インデックス)を辿って条件に一致するレコードの在り処を求め、そこから表のレコードを読み出す方法です。DB(データベース)が 1 つの表からレコードを取り出す手段の 1 つで、表を先頭から順に読むシーケンシャルスキャン(sequential scan)と対になります。
遅い SQL の実行計画を確認すると、Index Scan という処理名が出てくることがあります。実行計画とは、DB がその問い合わせをどの手順で処理すると決めたのかを表す出力で、その手順を選ぶ DB の部品をプランナと呼びます。一覧画面の表示に数秒かかるので索引を足したのに応答時間が戻らない、という場面で開くのがこの出力です。
索引が存在することと、問い合わせがその索引で速くなることは別です。DB は索引を辿った後で表のレコードを読みに行くことが多く、そこで読むページの枚数が応答時間を大きく左右します。
条件に一致するレコードが返るまでの流れを以下に示します。
  %%{init: {"theme":"base","themeVariables":{"primaryColor":"#eaf1f5","primaryTextColor":"#28343b","primaryBorderColor":"#9cabb5","lineColor":"#596b76","textColor":"#28343b","actorBkg":"#eaf1f5","actorBorder":"#9cabb5","actorTextColor":"#28343b","actorLineColor":"#9cabb5","signalColor":"#596b76","signalTextColor":"#28343b","noteBkgColor":"#f7f1e5","noteBorderColor":"#c5b99b","noteTextColor":"#403c32","activationBkgColor":"#edf3ef","activationBorderColor":"#9aafa1"}}}%%
flowchart LR
    C["WHERE user_id = 42"] --> D["索引を根から降りて<br/>開始位置の葉を決める"]
    D --> L["葉の項目を順に読み<br/>レコードの在り処を得る"]
    L --> T["表のページを読む"]
    T --> R["結果のレコード"]
    classDef default fill:#eaf1f5,stroke:#9cabb5,color:#28343b;
上記の図の「索引を根から降りる」「葉の項目を順に読む」は索引の中だけで完結し、「表のページを読む」は条件によっては省けます。
本記事では、1 台の DB が B-Tree 系の索引を 1 本引いて SELECT のレコードを取り出す場合を例に、Index Scan が索引と表の間で何をしているのかと、同じ索引で速くなる場合とならない場合の分かれ目を説明します。取り上げる疑問は次の通りです。
- Index Scan は、索引を降りた後に表のレコードをどう読むのか。
- 同じ 100 件を返す Index Scan で、読むページが 4 枚と 103 枚に分かれるのはなぜか。
- index-only scan と bitmap scan は、表への読み出しをどう減らすのか。
- 索引があっても絞り込みに使いにくいのは、どんな条件なのか。
レコードを更新した時の索引の維持と、複数の処理が同時に読み書きする時の並行制御には触れません。どの方法を選ぶかを決める枠組みは Query Processing のノートにあります。
前提
前提を 3 つ置きます。1 つ目は、DB が表も索引もページという固定長の区画に区切って管理し、ストレージとの読み書きもページ単位で行うことです。1 枚のページには複数のレコードが載り、一度読んだページはバッファキャッシュというメモリ上の控えにしばらく残ります。
2 つ目は、B-Tree 系の索引がキーの順に並んだ木で、一番上のノードを根、一番下に並ぶノードを葉と呼ぶことです。探索は根から葉に 1 段ずつ進むので、以降ではこの動きを「降りる」と書きます。木の構造は B-Tree のノートで扱っています。
3 つ目は、索引と表が別々に置かれる構成です。InnoDB の主キー索引のように葉がレコードそのものを持つクラスタ化索引では、表を読みに行く段が最初からありません。
EXPLAIN に出る名前も、どの取り出し方を備えているかも、DBMS(Database Management System)で違います。
例えば、PostgreSQL の EXPLAIN では Index Scan、SQLite の EXPLAIN QUERY PLAN では SEARCH ... USING INDEX という行が出ます。PostgreSQL の Seq Scan はシーケンシャルスキャンです。
一方で、SQLite の SCAN は索引を先頭から全部読む場合も含むので、その語だけでは索引を使ったかどうかを判断できません。USING INDEX や USING COVERING INDEX の有無も確認します。次の SQLite の実行計画には SCAN と USING COVERING INDEX が同時に現れます。v の順に索引全体を読み、必要なカラムも索引だけから取得します。
CREATE TABLE scan_demo (id INTEGER PRIMARY KEY, v INTEGER);
INSERT INTO scan_demo VALUES (1, 30), (2, 10), (3, 20);
CREATE INDEX scan_demo_v ON scan_demo(v);
EXPLAIN QUERY PLAN SELECT v FROM scan_demo ORDER BY v;
SCAN scan_demo USING COVERING INDEX scan_demo_v
これは SQLite の SCAN と SEARCH の区別を確認する例です。実行計画の表示形式はバージョンで変わる場合があります。
索引を降りて表のレコードを読む流れ
Index Scan の処理は、索引を降りる、葉を読み進める、表のレコードを読む、という 3 つに分かれます。条件を外れるキーに当たった所で、葉を読み進める段が終わります。
この 3 つを動かすのは実行器です。実行器とは、実行計画の各段を実際に走らせる部分を指します。以下は、最初の 2 件を取り出すまでの往復です。
  %%{init: {"theme":"base","themeVariables":{"primaryColor":"#eaf1f5","primaryTextColor":"#28343b","primaryBorderColor":"#9cabb5","lineColor":"#596b76","textColor":"#28343b","actorBkg":"#eaf1f5","actorBorder":"#9cabb5","actorTextColor":"#28343b","actorLineColor":"#9cabb5","signalColor":"#596b76","signalTextColor":"#28343b","noteBkgColor":"#f7f1e5","noteBorderColor":"#c5b99b","noteTextColor":"#403c32","activationBkgColor":"#edf3ef","activationBorderColor":"#9aafa1"}}}%%
sequenceDiagram
    participant E as 実行器
    participant I as 索引
    participant T as 表
    E->>I: 最初の 1 件を要求
    I-->>E: 開始位置の葉の 1 件目
    E->>T: 項目が指すページを読む
    T-->>E: レコードを 1 つ返す
    E->>I: 次を要求
    I-->>E: 同じ葉の 2 件目
    E->>T: 別のページを読む
    T-->>E: レコードを 1 つ返す
上記の図の表への読み出しは、そのレコードが載っているページがバッファキャッシュに残っていればメモリの読み取りで済み、残っていなければストレージへの読み出しになります。
同じ動きは範囲の条件にも使えます。created_at BETWEEN ... AND ... なら、開始位置の葉まで 1 度降りた後は、条件を外れるまでキーを順に読み進めるだけです。索引がキーの順に並んでいるので、ORDER BY の指定が索引の並び順と一致していれば、その順序をそのまま結果の順序として使えます。
このように索引順で結果を返せる問い合わせに LIMIT 10 を付ければ、10 件を返した時点で走査を止められます。ただし OFFSET で先頭を読み飛ばす場合は、飛ばす分も読んでから捨てます(Keyset Pagination のノート)。一方で、並べ替え(Sort)やハッシュ表を作る段(Hash)は、入力をほぼ全件読むまで次の処理へ結果を渡せません。
索引を引くだけで終わらない理由
索引の葉が持つのは、キーと、そのキーに対応するレコードを見つけるための情報です。レコードの全てのカラムが入っているわけではないので、必要なカラムの値が索引に無ければ、DB は葉から得た情報を頼りに表のページを読みに行きます。
多くの場合、問題になりやすいのは表のページを読む部分です。木を降りる間に読む索引のページは段数の分だけで、上の段ほどバッファキャッシュに残りやすいからです。
索引の中で隣り合うキーは、表の中でも隣り合うとは限りません。PostgreSQL のヒープ(表のレコードの本体を格納した領域)のようにレコードを空いた場所に置いていく構成では、表の並びとキーの順序に関係がありません。一致した 100 件が 100 枚の別々のページに載っていれば、表のページを 100 枚読みます。
例えば、同じ 3 件は索引と表で次のように並びます。
  %%{init: {"theme":"base","themeVariables":{"primaryColor":"#eaf1f5","primaryTextColor":"#28343b","primaryBorderColor":"#9cabb5","lineColor":"#596b76","textColor":"#28343b","actorBkg":"#eaf1f5","actorBorder":"#9cabb5","actorTextColor":"#28343b","actorLineColor":"#9cabb5","signalColor":"#596b76","signalTextColor":"#28343b","noteBkgColor":"#f7f1e5","noteBorderColor":"#c5b99b","noteTextColor":"#403c32","activationBkgColor":"#edf3ef","activationBorderColor":"#9aafa1"}}}%%
flowchart TB
    subgraph IDX["索引の葉:キーの順に並ぶ"]
        K1["user_id 42<br/>1 件目"]
        K2["user_id 42<br/>2 件目"]
        K3["user_id 42<br/>3 件目"]
    end
    subgraph TBL["表:キー順とは限らない物理配置"]
        P1["ページ 7"]
        P2["ページ 812"]
        P3["ページ 5309"]
    end
    K1 --> P1
    K2 --> P2
    K3 --> P3
    classDef default fill:#eaf1f5,stroke:#9cabb5,color:#28343b;
上記の図では、索引を 1 枚読んで得た 3 件のために表を 3 枚読んでいます。
この散らばり具合は、レコードが挿入・更新されてきた履歴で決まり、問い合わせの書き方では動きません。PostgreSQL は、この散らばり具合を数値にして、カラムごとの統計情報(DB がカラムごとに集計しておく値の分布などの情報)の 1 つとして pg_stats の correlation に持っています。
correlation は、カラムの値の順と表の中でのレコードの並び順がどれだけ一致しているかを相関係数として -1〜+1 で表し、+1 は同じ順、-1 は逆順、0 付近は無関係に散らばった状態です。プランナは、この値が ±1 に近いほど、ディスクへのランダムアクセスが減るとして、そのカラムへの index scan を安く見積もります(pg_stats)。
PostgreSQL 17.11 で、100 万件の注文を user_id の順に並べた表 orders_sorted と、同じレコードをランダムな順に並べた表 orders_random を作り、どちらにも user_id の索引を張りました。1 つの user_id につき 100 件です。
CREATE TABLE orders_sorted AS
  SELECT g AS id, (g - 1) / 100 + 1 AS user_id, g % 1000 AS amount,
         (ARRAY['paid', 'new', 'sent'])[g % 3 + 1] AS status
  FROM generate_series(1, 1000000) AS g;
CREATE TABLE orders_random AS SELECT * FROM orders_sorted ORDER BY random();
CREATE INDEX orders_sorted_user_id_idx ON orders_sorted(user_id);
CREATE INDEX orders_random_user_id_idx ON orders_random(user_id);
VACUUM ANALYZE;

-- サーバーを再起動して共有バッファを空にしてから実行する
SET enable_bitmapscan = off;
EXPLAIN (ANALYZE, BUFFERS, COSTS OFF, TIMING OFF, SUMMARY OFF)
  SELECT status FROM orders_sorted WHERE user_id = 4242;
EXPLAIN (ANALYZE, BUFFERS, COSTS OFF, TIMING OFF, SUMMARY OFF)
  SELECT status FROM orders_random WHERE user_id = 4242;
pg_stats の correlation は、orders_sorted が 1、orders_random がほぼ 0(4 回作り直して -0.009〜0.004)でした。
散らばった表ではプランナが bitmap scan(表をページの順に読む取り出し方)を選ぶので、enable_bitmapscan を off にして両方とも Index Scan に揃えています。索引に無いカラム status を取り出した結果(抜粋)は以下の通りです。
 Index Scan using orders_sorted_user_id_idx on orders_sorted (actual rows=100 loops=1)
   Buffers: shared read=4

 Index Scan using orders_random_user_id_idx on orders_random (actual rows=100 loops=1)
   Buffers: shared read=103
Buffers は、その走査で触ったページの延べ枚数です。以下は、その枚数を 1 ページ 1 マスで並べた図です。
同じ 100 件の Index Scan で触ったページ(PostgreSQL 17.11)
索引を降りる分は数枚なので、散らばった表では、一致した 100 件のために読む表のページ約 100 枚がほぼそのまま出ています。ランダムな並びは作り直すたびに変わり、4 回のうち 2 回は 102 枚でした。
同じ問い合わせをもう一度流すと、orders_random は shared hit=103 に変わりました。hit はバッファキャッシュにあった枚数、read はその外から読んだ枚数です(OS のキャッシュから返る場合もあります)。2 回目は速く返りますが、触るページは同じ 103 枚です。
一致するレコードが増えるほど、表のページの読み出しは積み上がります。一方で、シーケンシャルスキャンが読むページの枚数は、条件で絞れた割合、つまり選択性(selectivity)では動きません。そのため、2 つの経路が読む枚数はどこかで入れ替わります。
同じ作り方の 2 つの表で条件を user_id BETWEEN 1 AND k に変え、一致する割合を 0.01% から 100% まで動かして、シーケンシャルスキャンと Index Scan が触ったページの延べ枚数と時間を測りました。実行計画は enable_* で固定し、並列実行は止めています。時間は全てのページを共有バッファに読み込んだ後の 7 回の中央値です。
# 抜粋。PLANS[plan] は enable_seqscan などを off にする SET 文
sql = ("SET max_parallel_workers_per_gather = 0;" + PLANS[plan] +
       "EXPLAIN (ANALYZE, BUFFERS, COSTS OFF, TIMING OFF) "
       f"SELECT status FROM {table} WHERE user_id BETWEEN 1 AND {k};")
全体は lab/selectivity_pg.py にあります。結果は次の通りです(抜粋)。
table          plan   selectivity(%)  rows     pages  time_ms   node
orders_random  seq              1.00    10000     6080     66.44   Seq Scan
orders_sorted  index            1.00    10000       72      1.30   Index Scan
orders_random  index            1.00    10000     9912     12.95   Index Scan
orders_random  seq             30.00   300000     6080     83.63   Seq Scan
orders_sorted  index           30.00   300000     2071     40.90   Index Scan
orders_random  index           30.00   300000   297883    201.58   Index Scan
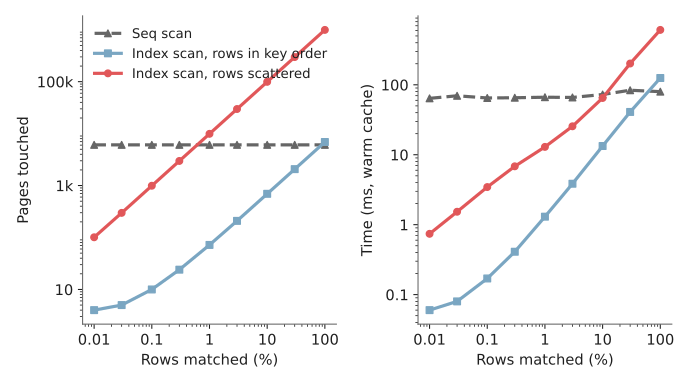
一致する割合ごとの、触ったページの延べ枚数と時間
上記の図の左の枚数(Pages touched)では、散らばった表(rows scattered)の Index Scan が一致した 1 件ごとにほぼ 1 枚を触るので、一致が 1% 弱(約 6,000 件)でシーケンシャルスキャン(Seq scan)の 6,080 枚を超えます。並んだ表(rows in key order)は 90% 前後までシーケンシャルスキャンより少ない枚数で済みます。
右の時間は全てのページがメモリにある状態の値で、1 枚を触る手間が安いぶん、散らばった表の交点は 10〜30% と枚数の交点より右に来ました。
表が小さいほどシーケンシャルスキャンが読む枚数も少ないので、交点は左へ寄ります。
PostgreSQL のドキュメントには、100 件から 1 件を選ぶ例について、その 100 件がおそらく 1 枚のディスクページに収まるので「there is no plan that can beat sequentially fetching 1 disk page」(1 枚のディスクページを順に読むことに勝てる計画は無い)とあります。
Index Scan で読む量を整理すると、およそ「索引で読むページ + 表で読むページ」で、選択性と correlation で決まります。読む量を減らす手段は次の 3 つです。
- index-only scan:表で読むページを減らす
- bitmap scan:表のページを読む順序を変える
LIMIT:必要な所で走査を止める
表への読み出しを減らす index-only scan
必要なカラムが全て索引に入っていれば、表への読み出しを省ける場合があります。PostgreSQL ではこの形を index-only scan と呼びます。
ある問い合わせに必要なカラムが全て入っている索引は、その問い合わせに対する covering index と呼ばれます。covering index に当たるかどうかは、索引の種類ではなく問い合わせとの組み合わせで決まります。
取り出すカラムだけを変えると実行計画がどう動くのかは、Python 標準の sqlite3 から SQLite 3.46.1 を使って確認できます。orders は 100 万件で、user_id は 1 万種類(1 つの値につきおよそ 100 件)です。張ってある索引は 1 本で、user_id と amount の 2 カラムをこの順に並べた複合索引です。
import random
import sqlite3

random.seed(0)
db = sqlite3.connect(":memory:")
db.execute("CREATE TABLE orders (id INTEGER PRIMARY KEY, user_id INTEGER, amount INTEGER, status TEXT)")
db.executemany(
    "INSERT INTO orders (user_id, amount, status) VALUES (?, ?, 'paid')",
    ((random.randint(1, 10000), random.randint(1, 1000)) for _ in range(1_000_000)),
)
db.execute("CREATE INDEX idx_orders_user_amount ON orders(user_id, amount)")
queries = [
    "SELECT status FROM orders WHERE user_id = 42",
    "SELECT amount FROM orders WHERE user_id = 42",
    "SELECT status FROM orders WHERE user_id + 0 = 42",
    "SELECT status FROM orders WHERE amount = 42",
]
for q in queries:
    print(db.execute("EXPLAIN QUERY PLAN " + q).fetchone()[3])
db.execute("ANALYZE")
print("ANALYZE 後:", db.execute("EXPLAIN QUERY PLAN " + queries[3]).fetchone()[3])
最初の 2 つの問い合わせの実行計画は次の通りです(抜粋)。
SEARCH orders USING INDEX idx_orders_user_amount (user_id=?)
SEARCH orders USING COVERING INDEX idx_orders_user_amount (user_id=?)
条件も索引も同じで、違うのは取り出すカラムだけです。status は索引に入っていないので表を読む必要があり、amount は索引に入っているので USING COVERING INDEX に変わりました。SQLite のドキュメントには、この最適化の効果として「saves one binary search for each row」(1 件ごとに二分探索を 1 回節約する)とあります。
以下が 2 つの経路の分かれ目です。
  %%{init: {"theme":"base","themeVariables":{"primaryColor":"#eaf1f5","primaryTextColor":"#28343b","primaryBorderColor":"#9cabb5","lineColor":"#596b76","textColor":"#28343b","actorBkg":"#eaf1f5","actorBorder":"#9cabb5","actorTextColor":"#28343b","actorLineColor":"#9cabb5","signalColor":"#596b76","signalTextColor":"#28343b","noteBkgColor":"#f7f1e5","noteBorderColor":"#c5b99b","noteTextColor":"#403c32","activationBkgColor":"#edf3ef","activationBorderColor":"#9aafa1"}}}%%
flowchart TB
    Q["WHERE user_id = 42"] --> D{"取り出すカラムが<br/>索引に揃っているか"}
    D -->|"揃っていない"| A1["索引を降りる"]
    A1 --> A2["表のページを読む"]
    A2 --> R["結果のレコード"]
    D -->|"揃っている"| B1["索引を降りる"]
    B1 --> R
    classDef default fill:#eaf1f5,stroke:#9cabb5,color:#28343b;
上記の図の揃っている経路では、一致するレコードが多い問い合わせほど「表のページを読む」を省けた時の差が大きくなります。索引にカラムを足せばこの経路に寄せられるため、PostgreSQL は検索の対象にしないカラムを索引に載せる INCLUDE を用意しています。
表を読まずに済むかどうかは、カラムが揃っているかだけでは決まりません。PostgreSQL はレコードを更新・削除しても古いレコードをしばらく残すので、索引の項目が指すレコードを今のトランザクションが読んで良いとは限りません。PostgreSQL の索引は、この「見えるかどうか」の情報を持ちません。
そこで使うのが、ページ内のレコードが全トランザクションから見えるかなどを記録する visibility map です。ヒープページ 1 枚につき 2 ビットを持ちます。
all-visible は全てのレコードが各トランザクションから見えると分かっていること、all-frozen は全てのレコードが freeze 済みであることを記録します。freeze は、古いトランザクション ID の周回に備える処理です。
index-only scan でヒープを読まずに済むかの判断に使うのは、all-visible のビットです。all-frozen は主に VACUUM の処理で使われ、索引だけで返すための追加条件ではありません。以下は all-visible を確認してからの分かれ道です。
  %%{init: {"theme":"base","themeVariables":{"primaryColor":"#eaf1f5","primaryTextColor":"#28343b","primaryBorderColor":"#9cabb5","lineColor":"#596b76","textColor":"#28343b","actorBkg":"#eaf1f5","actorBorder":"#9cabb5","actorTextColor":"#28343b","actorLineColor":"#9cabb5","signalColor":"#596b76","signalTextColor":"#28343b","noteBkgColor":"#f7f1e5","noteBorderColor":"#c5b99b","noteTextColor":"#403c32","activationBkgColor":"#edf3ef","activationBorderColor":"#9aafa1"}}}%%
flowchart TB
    F["索引で候補の項目を見つける"] --> V{"対応するヒープページの<br/>all-visible ビット"}
    V -->|"立っている"| A["索引から取り出した値を<br/>そのまま返す"]
    V -->|"立っていない"| B["ヒープのレコードを読む"]
    classDef default fill:#eaf1f5,stroke:#9cabb5,color:#28343b;
上記の図の下の経路が残るので、index-only scan はヒープへの読み出しを大きく減らす形であって、必ず 0 にする形ではありません。実際に何回ヒープを読みに行ったのかは、EXPLAIN ANALYZE の出力に出る Heap Fetches で分かります。
レコードの位置を集めてページ順に読む bitmap scan
表への読み出しが散らばる問題には、索引から一致したレコードの位置を先に全部集めて印を付け、その後で表をページの順に読む手もあります。これが bitmap scan で、PostgreSQL では索引 1 本の場合にもこの形が選ばれます。
複数の索引を組み合わせる際には、必要な索引をそれぞれ走査して「prepares a bitmap in memory giving the locations of table rows」(表のレコードの位置を示すビットマップをメモリ上に用意する)と説明されています。
このビットマップは、表の中でのレコードの位置の順に並んでいます。どの索引から作っても並び方が同じなので、問い合わせに応じて AND や OR で重ねられます。
例えば、2 本の索引を合成する場合は次の流れになります。
  %%{init: {"theme":"base","themeVariables":{"primaryColor":"#eaf1f5","primaryTextColor":"#28343b","primaryBorderColor":"#9cabb5","lineColor":"#596b76","textColor":"#28343b","actorBkg":"#eaf1f5","actorBorder":"#9cabb5","actorTextColor":"#28343b","actorLineColor":"#9cabb5","signalColor":"#596b76","signalTextColor":"#28343b","noteBkgColor":"#f7f1e5","noteBorderColor":"#c5b99b","noteTextColor":"#403c32","activationBkgColor":"#edf3ef","activationBorderColor":"#9aafa1"}}}%%
flowchart LR
    I1["索引 A を走査"] --> B1["レコードの位置の<br/>ビットマップ"]
    I2["索引 B を走査"] --> B2["レコードの位置の<br/>ビットマップ"]
    B1 --> AN["AND / OR で合成"]
    B2 --> AN
    AN --> S["表のページを<br/>物理的な順に読む"]
    S --> R["結果のレコード"]
    classDef default fill:#eaf1f5,stroke:#9cabb5,color:#28343b;
上記の図の最後で表を読む順序は、索引に並んでいた順ではなく物理的な順です。同じページに載っているレコードをまとめて処理でき、ページを何度も読み直す動きが減ります。同じドキュメントは、その代償として「any ordering of the original indexes is lost」(元の索引が持っていた順序は失われる)と書き、ORDER BY があれば別に整列の段が必要だと続けています。
先頭の 1 件が返るまでの時間も変わります。ビットマップを合成し終えるまで表を読み始められないので、索引を降りた直後に 1 件目が返るという性質は失われます。
ビットマップが割り当てられたメモリに収まらない場合の扱いにも注意が必要です。PostgreSQL はレコード単位での保持を諦めてページ単位に落とします。そうするとページ内のどのレコードが一致したかが分からなくなるので、そのページの全てのレコードで条件を確かめ直します。
索引があっても絞り込みに使いにくい条件
索引の構造と問い合わせ条件が噛み合わないと、索引があっても走査する範囲を絞れません。
| 条件 | なぜ絞り込みに使いにくいか |
|---|---|
| カラムに関数や演算を掛けている | 通常のカラム索引に入っているのは元の値なので、計算後の値では葉を辿れない |
| 複合索引の先頭カラムに条件が無い | 一般には走査する範囲を狭めにくい |
この型は、先ほどの SQLite のコードの 3 つ目と 4 つ目の問い合わせで再現できます。取り出すカラムを SELECT status に固定したまま条件だけを変えると、どちらも表を先頭から全部読む SCAN になりました。
SCAN orders
SCAN orders
ANALYZE 後: SEARCH orders USING INDEX idx_orders_user_amount (ANY(user_id) AND amount=?)
SCAN は索引の順に辿る場合も含めて全てのレコードを訪れること、SEARCH は表のレコードの一部だけを訪れることを表します(SQLite のドキュメント)。絞り込めているかどうかは、この 2 語の差に出ます。
最初の表に挙げた 2 つの条件には、それぞれ回避手段と例外があります。
関数や演算を掛けた条件には、式に張る索引で対応できます。PostgreSQL のドキュメントによれば、lower(col1) の結果に索引を定義してあれば、lower(col1) = 'value' という条件でも索引を使えます。以下は、カラムと式に張った索引の比較です。
  %%{init: {"theme":"base","themeVariables":{"primaryColor":"#eaf1f5","primaryTextColor":"#28343b","primaryBorderColor":"#9cabb5","lineColor":"#596b76","textColor":"#28343b","actorBkg":"#eaf1f5","actorBorder":"#9cabb5","actorTextColor":"#28343b","actorLineColor":"#9cabb5","signalColor":"#596b76","signalTextColor":"#28343b","noteBkgColor":"#f7f1e5","noteBorderColor":"#c5b99b","noteTextColor":"#403c32","activationBkgColor":"#edf3ef","activationBorderColor":"#9aafa1"}}}%%
flowchart LR
    subgraph COL["カラムに張った索引"]
        direction TB
        Q1["WHERE user_id + 0 = 42"] -.->|"計算後の値では<br/>辿れない"| K1["葉に並ぶのは<br/>user_id の元の値"]
    end
    subgraph EXP["式に張った索引"]
        direction TB
        Q2["WHERE lower(col1) = 'value'"] -->|"辿れる"| K2["葉に並ぶのは<br/>lower(col1) の結果"]
    end
    classDef default fill:#eaf1f5,stroke:#9cabb5,color:#28343b;
先頭カラムに条件が無い場合の制約は、複合索引の並び順から出ています。PostgreSQL は、複合索引が索引のカラムの任意の部分集合を含む条件で使えるとした上で、「the index is most efficient when there are constraints on the leading (leftmost) columns」(索引が最も効率的なのは、先頭(最も左)のカラムに制約がある時)としています。
以下は、先ほどの複合索引 (user_id, amount) の葉の並びです。amount の値は説明用です。
  %%{init: {"theme":"base","themeVariables":{"primaryColor":"#eaf1f5","primaryTextColor":"#28343b","primaryBorderColor":"#9cabb5","lineColor":"#596b76","textColor":"#28343b","actorBkg":"#eaf1f5","actorBorder":"#9cabb5","actorTextColor":"#28343b","actorLineColor":"#9cabb5","signalColor":"#596b76","signalTextColor":"#28343b","noteBkgColor":"#f7f1e5","noteBorderColor":"#c5b99b","noteTextColor":"#403c32","activationBkgColor":"#edf3ef","activationBorderColor":"#9aafa1"}}}%%
flowchart LR
    P1["user_id 1<br/>amount 10, 42, 87"] --> P2["user_id 2<br/>amount 7, 42"] --> P3["…"] --> P4["user_id 42<br/>amount 3, 42, 55"]
    N1["user_id = 42<br/>1 か所にまとまる"]:::note -.- P4
    N2["amount = 42<br/>user_id ごとに散る"]:::note -.- P2
    classDef default fill:#eaf1f5,stroke:#9cabb5,color:#28343b;
    classDef note fill:#f7f1e5,stroke:#c5b99b,color:#403c32;
先頭カラムの条件が無くても、索引を読むこと自体はできます。ただし、上記の図の amount = 42 のように項目が散ると、多くの場合は索引の全体を読む形になり、走査する範囲が絞られません。何を読むのが安いかはそこで改めて見積もられ、シーケンシャルスキャンが選ばれることもあります。
例外として、PostgreSQL 18 の複合索引のドキュメントは skip scan にも触れています。skip scan は、先頭カラムの取り得る値がごく少ないとプランナが見積もった場合に、その値ごとの等値の条件を内部で作り、「skip over most of the index」(索引の大半を読み飛ばす)形で走査する範囲を減らす方法です。
SQLite にも同じ名前の最適化があります。先頭カラムの 1 つの値に重複がおよそ 18 件以上あると分かった時だけ使われ、それを知る手段は ANALYZE の統計だけです。
先ほどの orders は 1 つの user_id に約 100 件あるので、ANALYZE の後に amount = 42 が ANY(user_id) AND amount=? の SEARCH に変わりました。統計が無いと、同じ索引と同じ条件でも表を全部読む SCAN になります。
見積もりでシーケンシャルスキャンに負ける条件
条件に合う索引があっても、プランナがシーケンシャルスキャンの方を安いと見積もれば、索引を使う実行計画は選ばれません。
| 条件 | なぜシーケンシャルスキャンが選ばれるか |
|---|---|
| 一致するレコードが表の大部分を占める | 索引を使う候補より、シーケンシャルスキャンの方が安いと見積もられる |
| 統計情報が古い | 推定レコード数が実際とずれ、シーケンシャルスキャンの方が安いと見積もられる |
コストは実際のレコード数ではなく、統計から見積もった推定レコード数で計算されます。
索引が使われない理由を調べたい時は、PostgreSQL の enable_seqscan を off にしてシーケンシャルスキャンを選びにくくし、別の計画が成立するかを確認します。それでもシーケンシャルスキャンが選ばれるなら、条件が索引と噛み合っていないなどの根本的な理由がある可能性が高いとドキュメントは説明しています。
利点
- 表のレコード数が増えても、読む量は表の大きさではなく一致するレコード数でおおむね決まる
- 索引の並び順をそのまま使えるため、
ORDER BYの整列を省ける場合がある - 先頭の数件だけが必要な問い合わせでは、途中で走査を止められる
- 必要なカラムが索引に揃っていれば、表への読み出しを大きく減らせる
欠点
Index Scan は、条件に一致するレコードだけに届く代わりに、表の並びと条件の書き方に左右されます。そのため、次の制約があります。
- 索引と表の 2 か所を読むため、一致するレコードが増えるほど表を読む回数が積み上がる
- 条件の書き方で索引を使えるかどうかが変わり、些細な違いで実行計画が動く
- 索引を増やすほど、レコードを更新するたびに書き換える対象が増える
Index Scan の効果が小さくなりやすいケース
- 条件に一致するレコードが表の大部分を占め、索引を辿った末にほとんどのページを読む場合
- 表が小さく、全体が数ページに収まる場合
- 索引の順序と表の並び順の相関が低く、一致したレコードが多数のページに散っている場合
- 取り出すカラムが多く、索引だけでは揃わない場合
1 つ目で影響しているのは選択性です。値の種類が少ないカラムだから索引が働かない、という話ではありません。値が 2 種類でも、片方が全体の 0.01% しか無ければ、その値で絞り込む問い合わせでは索引で読む量を減らせる場合があります。
3 つ目と 4 つ目は、表や索引の作り方を変えれば効果が戻ることがあります。PostgreSQL の CLUSTER のように、索引の順序に合わせて表のレコードを並べ直す操作を持つ DBMS もあります。
どの手段が選ばれるかを最後に決めるのは、冒頭で触れたプランナです。PostgreSQL のように索引を名指しするヒントを持たない DBMS では、開発者は、プランナが選べる実行計画を増やすように索引や問い合わせを設計します。