接続プール(connection pool)は、アプリが DB(データベース)への接続を何本か張ったまま持っておき、問い合わせのたびに 1 本を貸し出して、終わったら返してもらう仕組みです。Java の HikariCP、Go の標準ライブラリ database/sql のように、アプリの中に持つ実装と、PgBouncer のように、アプリと DB の間に置く実装があります。
接続プールの設定で迷うのは、何本まで張るか(プールの大きさ)です。遅い時に「接続が足りないのでは」と考えて、プールを大きくしたくなります。しかし、DB の CPU の数が変わらないなら、接続を増やしても DB が同時に処理できる量は増えません。以下は、アプリに同時に 256 件の問い合わせがある時、接続の本数で何が変わるかを描いた図です。
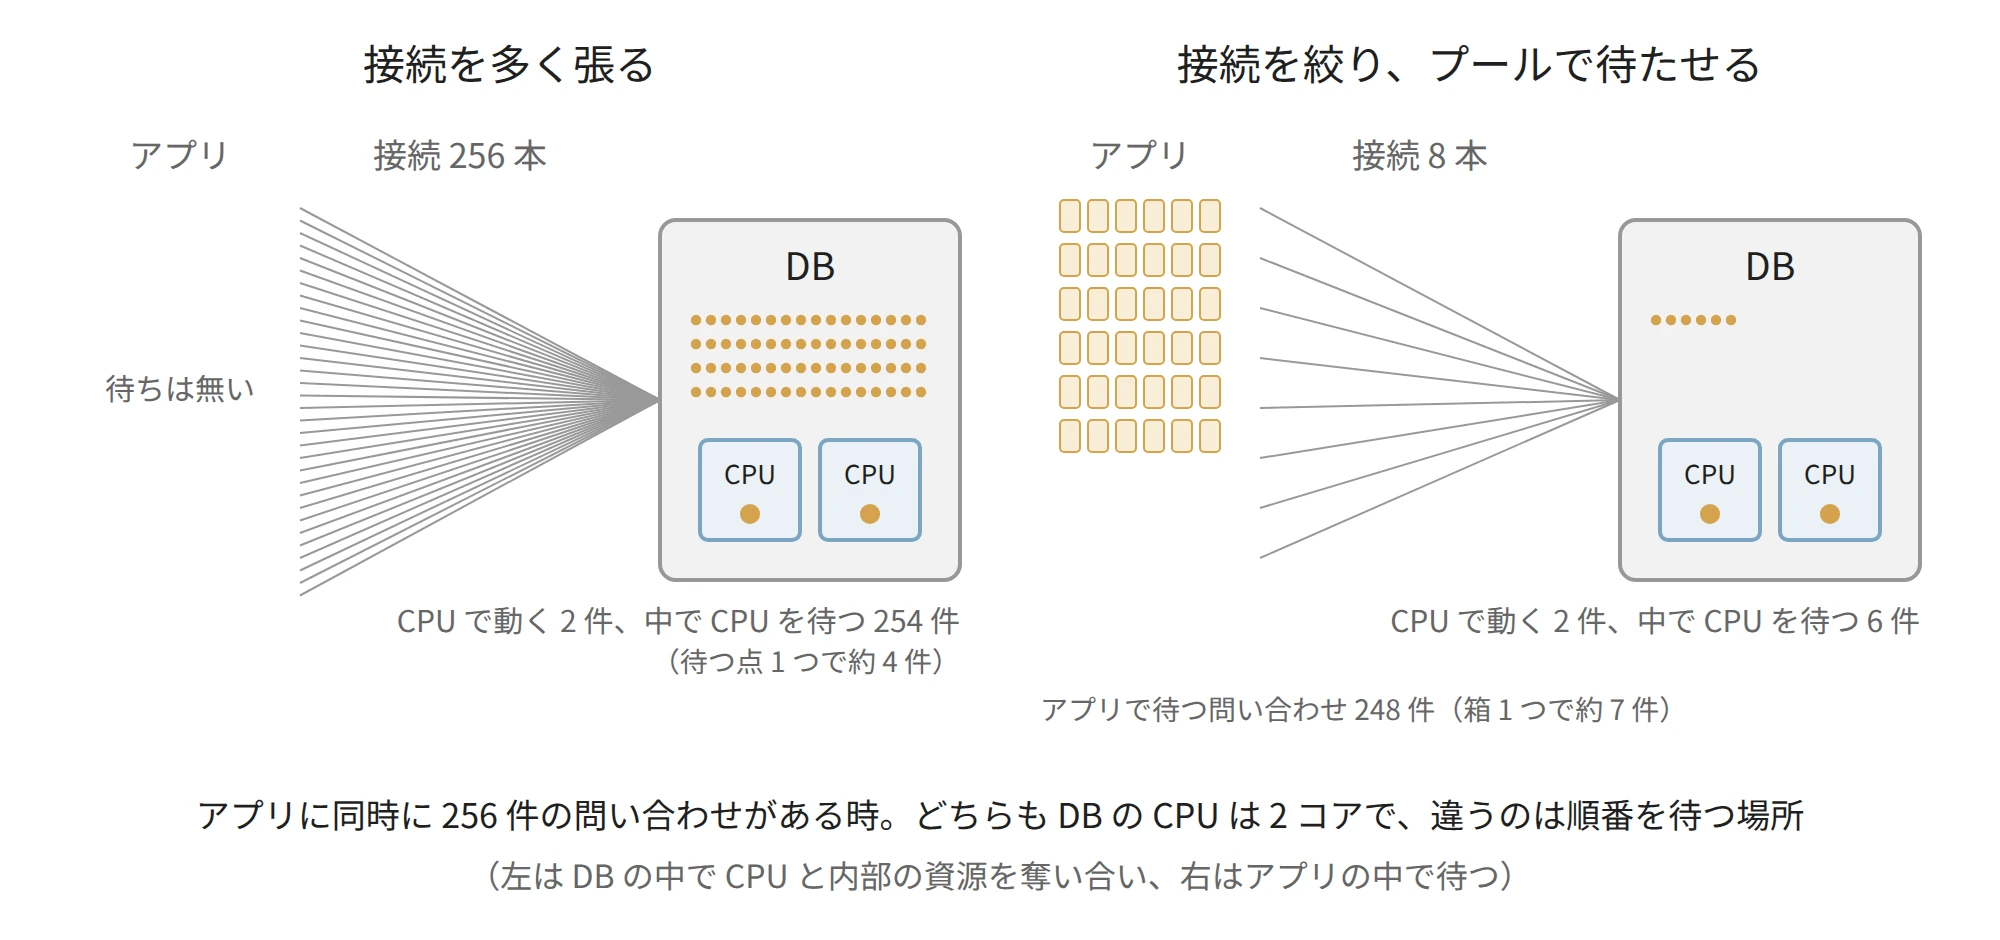
接続を増やしても、待つ場所が DB の中に移るだけ
接続を 256 本張っても、CPU が 2 コアなら、同時に動ける問い合わせは 2 個です。残りは DB の中で CPU の順番を待ちます。接続を 8 本に絞れば、256 件のうち 248 件はアプリの接続プールの前で待ちます。待つ場所が違うだけに見えますが、DB の中で待つ方が、DB の処理そのものを遅くします。その理由は、後の節で実測と一緒に見ます。
本記事では、CPU を 2 コアに固定した PostgreSQL 17 に、ベンチマークのツール pgbench で負荷を掛けた結果を使って、接続プールの大きさを説明します。扱う疑問は次の通りです。
- そもそも、なぜ接続を使い回すのか。
- 接続を増やすと、1 秒あたりに処理できる件数と応答時間はどう変わるのか。
- 同じ件数を処理する時、接続 8 本と 256 本で何が違うのか。
- プールの大きさは、何を目安に決めるのか。
- アプリのサーバーを増やした時に、何が起きるのか。
接続を使い回す理由
PostgreSQL は、接続を受けるたびに、その接続専用のプロセス(backend)を 1 つ起動します(ドキュメント)。接続には、TCP の接続、認証、プロセスの起動と初期化が含まれ、問い合わせ 1 回よりずっと重い処理です。
pgbench は、1 回の処理の単位をトランザクションと呼び、本記事の実験では、主キーで 1 件を読む SELECT 1 回がそれに当たります。-C は、トランザクションのたびに接続を張り直すオプションです。DB の条件は次の節と同じで、同じ 8 本の接続で、使い回す場合と張り直す場合を比べました(それぞれ 10 秒を 3 回の中央値)。
接続を使い回す   102,278 件/秒   平均 0.078 ms
毎回張り直す     672 件/秒       平均 11.9 ms
張り直すと、1 秒あたりの件数は約 150 分の 1 になりました。問い合わせ自体は 0.1 ms 足らずで終わるのに、張り直す場合は 1 件に 10 ms 以上掛かっています(8 本が 2 コアを分け合った状態での値)。接続プールの最初の役割は、この接続の費用を一度で済ませることです。
なお、この比較の使い回す場合(毎秒約 10 万件)は、次の節の接続 8 本(毎秒約 6 万件)と同じ条件ですが、別の時刻に流した計測です。同じマシンでも、時刻によってこれだけ揺れます。比べる時は、同じ時刻に続けて流した計測どうしで比べます。
接続を増やした実験
接続を何本まで増やすと速くなるのかを、pgbench で確かめました。条件は次の通りです。
- DB は PostgreSQL 17.11 の docker コンテナで、CPU を 2 コアに固定する(
--cpuset-cpus)。表は pgbench の初期化(-s 20、200 万件)で作り、全てメモリに載る - pgbench は別のコンテナから、主キーで 1 件を読む
SELECTだけを、接続数を変えて 10 秒ずつ流す(-S)。各接続は、前の問い合わせが返ったらすぐ次を送る - 接続数ごとに 5 回流し、中央値を取る。pgbench も同じマシンで動き、マシンの他の処理の影響で値は揺れる
以下は、接続数ごとの 1 秒あたりの件数と、1 件あたりの平均の応答時間(問い合わせを送ってから結果が返るまでの時間)です。この応答時間は、pgbench が計測した値ではなく、「接続数 × 計測時間 ÷ 件数」で求めた値です(後の節で触れます)。
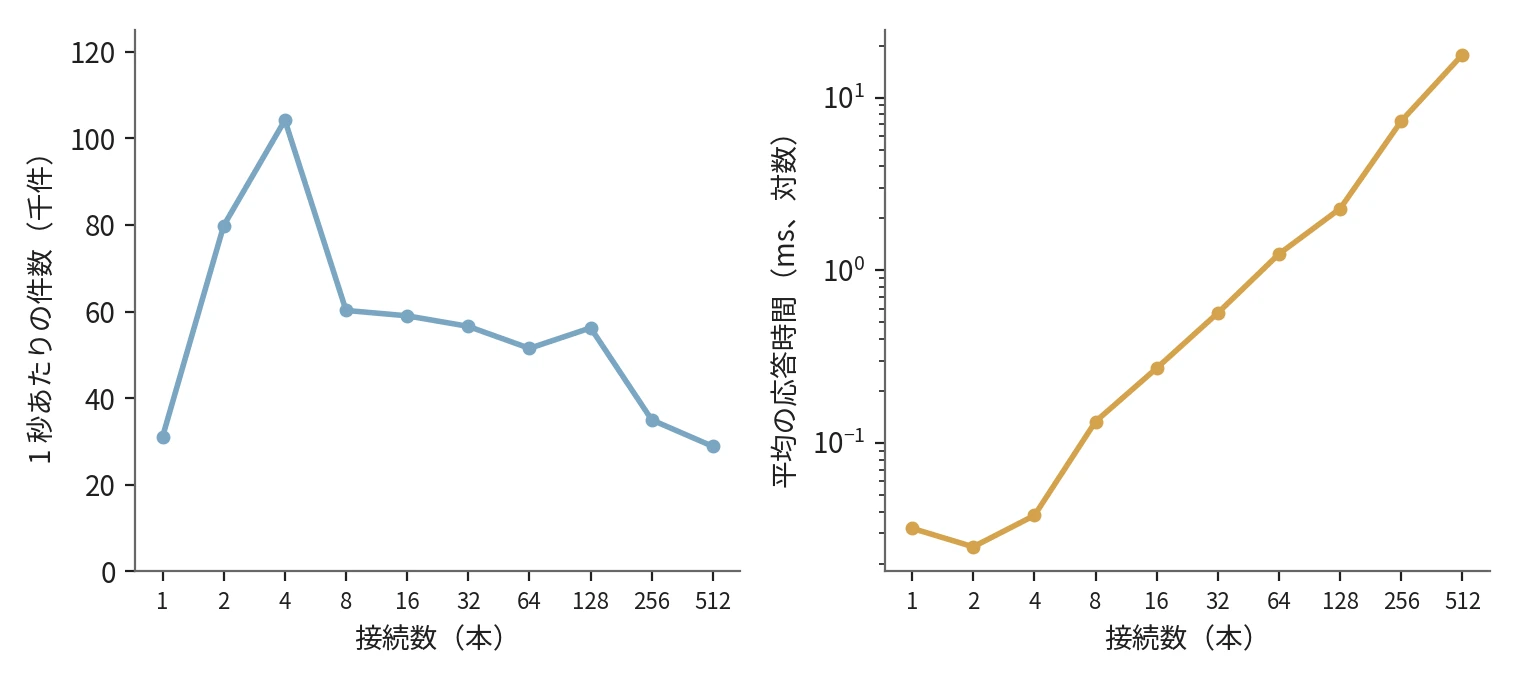
接続数ごとの、1 秒あたりの件数(左)と平均の応答時間(右、5 回の中央値)
1 秒あたりの件数は、接続 4 本の約 10.4 万件が最も多く、8〜128 本では 5〜6 万件、256 本で約 3.5 万件、512 本で約 2.9 万件に下がりました。接続を 4 本から 512 本に増やすと、処理できる件数は 3 割弱に減り、1 件あたりの平均の応答時間は 0.038 ms から 17.7 ms に伸びました。
CPU は 2 コアなのに、最も多いのが 2 本ではなく 4 本なのは、各接続には CPU を使わない時間があるからと考えられます(2 本の 5 回は 7.1 万〜8.3 万件で、4 本と範囲が重なってもいます)。結果を pgbench に返し、次の問い合わせが届くまでの間、その接続の分の CPU は空きます。その空きを、別の接続の問い合わせが埋めます。8 本で急に下がった理由は、この実験だけでは切り分けていません。
4 本の 5 回の値は 7.4 万〜12.6 万件と揺れが大きく、8 本以上との差も、マシンの状態によって変わります。それでも、どの回も接続を数百本に増やした方が速くなることはなく、応答時間は 4 本から先、接続数とともに伸び続けました。
接続を増やすと遅くなる理由
CPU が 2 コアなら、同時に動ける問い合わせは 2 個です。それより多い接続は、DB の中で CPU の順番を待つだけで、処理できる量は増えません。それでも接続を増やすと、次のような費用が接続の数とともに増えます。
- OS が、CPU を使うプロセスを切り替える回数(コンテキストスイッチ)。切り替えで、CPU のキャッシュに載っていた内容が追い出されることがある
- 共有メモリの上のロックや、内部のデータ構造の奪い合い
- 接続ごとのプロセスが使うメモリ
PostgreSQL の wiki の接続数のページも、接続が多い時の費用として、CPU のキャッシュの奪い合いや、接続数に応じて大きくなる内部の構造を挙げています。
この実験では、各接続は前の問い合わせが返るとすぐ次を送るので、DB と pgbench の間には、常に接続数と同じ数の問い合わせがあります。
中にある数 = 1 秒あたりの件数 × 1 件の応答時間、という関係(待ち行列の理論の Little の法則)から、応答時間は「接続数 ÷ 1 秒あたりの件数」になります。この実験(-R を付けない)で pgbench が表示する平均の応答時間も、この形の式(接続数 × 計測時間 ÷ 件数)で求めた値で、512 本なら 512 ÷ 28,860 件 ≒ 17.7 ms です。この形の負荷では、件数と応答時間は別々に決まりません。処理できる件数が増えないまま接続を増やせば、応答時間は接続数に比例して伸びます。
同じ件数を処理する時の違い
上の実験では、接続が多いほど多くの問い合わせを送っていました。実際のサービスで問題になるのは、同じ件数の要求が届いた時に、接続の数でどう違うかです。
pgbench の -R は、1 秒あたりの件数を固定して問い合わせを送るオプションです。空いている接続が無い間に届いた問い合わせは、空くまで待ちます(pgbench はスレッドごとに予定を作るので、8 本では接続ごとに、256 本では 32 本ずつの組ごとに待ちます。共有の待ち行列を持つ接続プールより、8 本に不利な条件です)。ここからの待ち時間は、この空き待ちと応答時間を足したものです。アプリの接続プールで順番を待つのと同じ形です。毎秒 1 万件から 4 万件まで、接続 8 本と 256 本で比べました(3 回の中央値)。
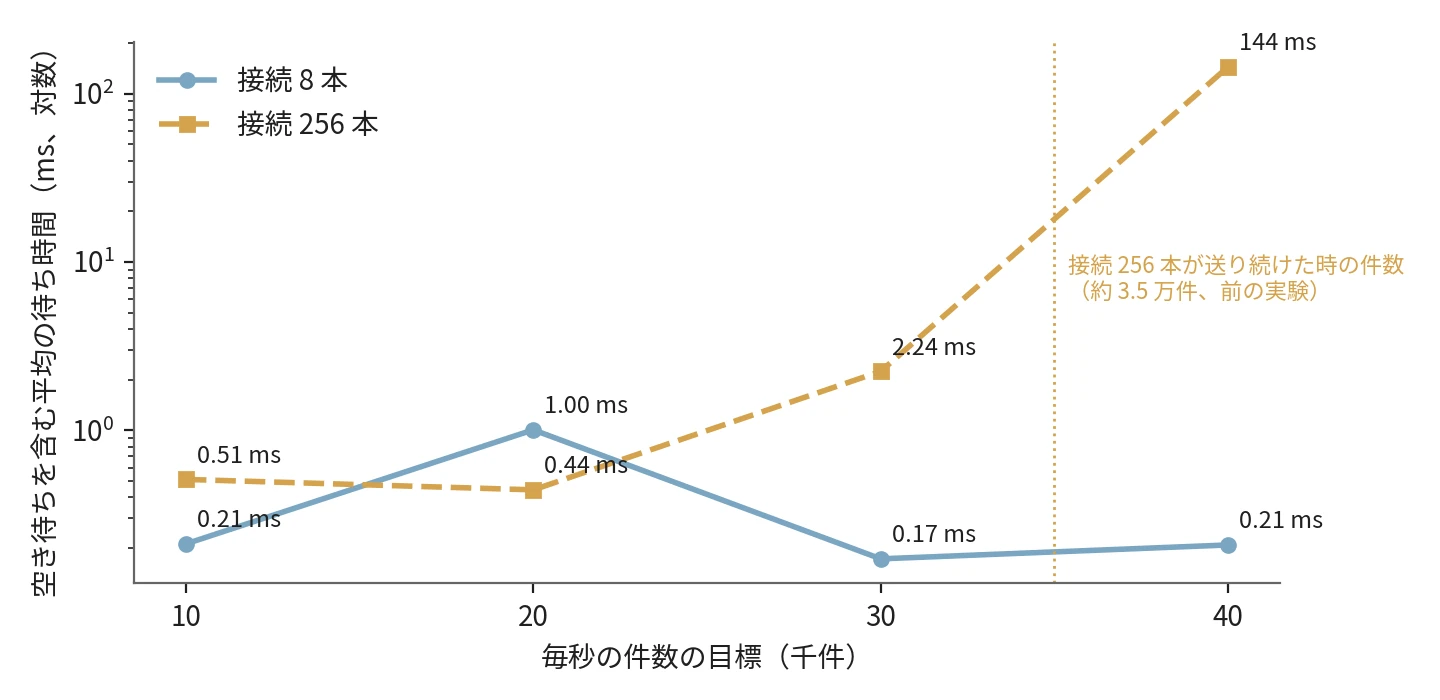
毎秒の件数を固定した時の、空き待ちを含む平均の待ち時間(3 回の中央値、縦軸は対数)
毎秒 2 万件までは、どちらも 1 ms 前後で、差はマシンの揺れの範囲です(8 本の毎秒 2 万件は、3 回が 7.6、1.0、0.40 ms とばらつき、中央値が 1.00 ms でした)。前の節の実験で、全ての接続が問い合わせを送り続けた時の件数は、256 本で毎秒約 3.5 万件、8 本で約 6 万件でした。毎秒 3 万件で 256 本の待ち時間が 2.24 ms に上がり始めたのは、256 本の DB が処理できる件数に近づいたからと考えられます。
毎秒 4 万件では、接続 8 本は 0.21 ms のまま(中央値。3 回のうち 1 回は 15 ms)でしたが、接続 256 本は 144 ms になりました。256 本では、予定の時刻から実際に送れるまでの遅れ(schedule lag)の平均が 120〜268 ms で、DB が目標の件数に追いつけず、待ちが溜まりました。256 本が処理できたのは毎秒約 3.9 万件です(前の実験の 3.5 万件より多いのは別の時刻の計測だからと考えられ、同じ条件でもこの程度は揺れます。4 万件との差には、計測の終わりに 256 本の接続を閉じる時間などが pgbench の件数の計算に入る分の、見かけの差も含まれます。256 本は毎秒 1 万件でも目標を 1〜3% 下回りました)。
8 本の方も、空いている接続が無い時は、アプリ側で順番を待ちます。それでも、DB が 1 件を速く処理するので、待ちはすぐに捌けます。接続を絞るのは、DB に処理できる以上の仕事を同時に抱えさせず、1 件あたりの処理を速いまま保つためです。
プールの大きさの目安
PostgreSQL の wiki には、スループット(1 秒あたりに処理できる件数)が最も高くなる接続数の目安として、次の式が載っています。HikariCP の About Pool Sizing も、この式を出発点として紹介しています。
接続数 = (CPU のコア数 × 2) + 実質的なディスクの数
コア数にはハイパースレッディングの論理コアを数えません。ディスクの数は、読み書きを並行して待てるディスクの数のことで、データが全てメモリに載っているなら 0 とします。今回の DB なら 2 × 2 + 0 = 4 本で、上の実験で 1 秒あたりの件数が最も多かった本数と一致しました(揺れの大きい計測なので、一致は目安としてです)。
wiki も HikariCP も、この式は出発点で、実際の負荷で前後を試すように書いています。問い合わせがディスクやネットワークで待つ時間が長ければ、その間は CPU が空くので、もう少し多い方が良くなります。
HikariCP の同じページには、Oracle の性能チーム(Real-World Performance group)の動画の例も紹介されています。接続を 2,048 本から 96 本に減らし、他は何も変えずに、アプリの応答時間が約 100 ms から約 2 ms に下がった、というものです。プールを小さくして速くなるのは、この実験に限った話ではありません。
アプリのサーバーを増やした時
プールの大きさはアプリのサーバー 1 台ごとの設定なので、DB から見た接続数は「サーバーの台数 × プールの大きさ」です。プール 20 本のサーバーを 10 台に増やせば、DB には 200 本の接続が来ます。
PostgreSQL が受け付ける接続数には上限(max_connections、既定は 100)があり、超えた接続は断られます。このうち 3 本(superuser_reserved_connections の既定)は管理者用に取っておかれるので、管理者でないアプリのユーザーは 97 本を超えた所で断られます。既定の設定の DB に、pgbench で管理者のユーザーから 101 本の接続を張ると、次のエラーになりました。
pgbench: error: connection to server at "note-pool-db100" (172.22.0.3), port 5432 failed: FATAL: sorry, too many clients already
上限を上げれば断られなくなりますが、上の実験の通り、DB が同時に抱える仕事が増えて遅くなります。
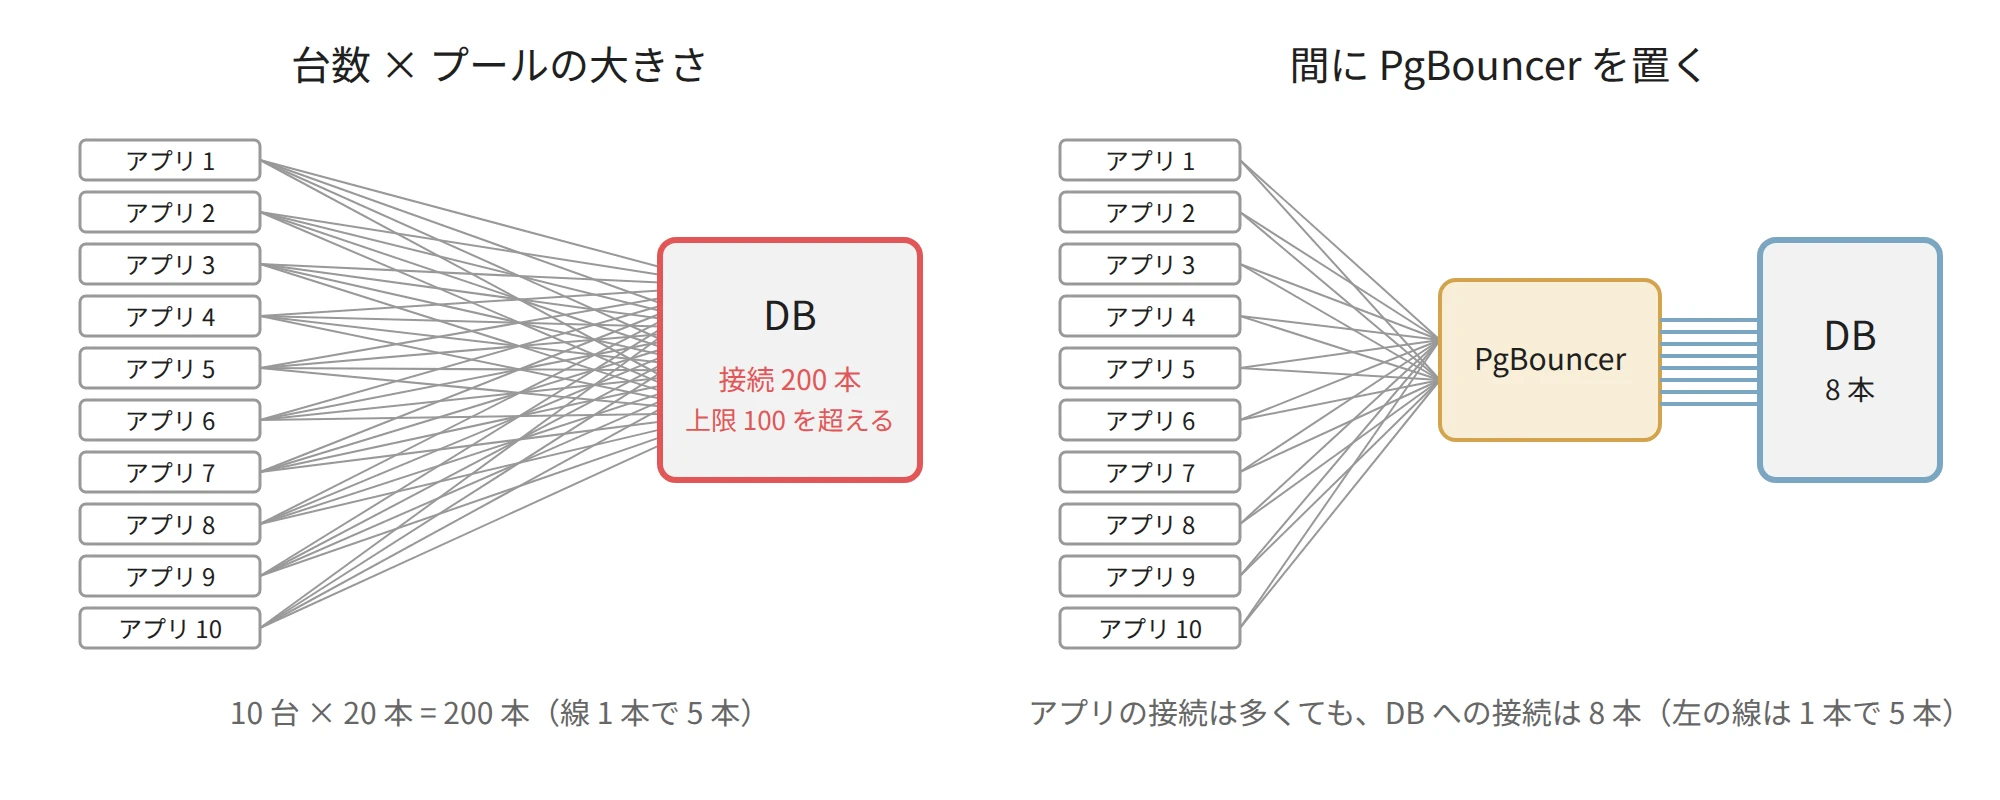
アプリのサーバーを増やした時の接続数と、PgBouncer でまとめる構成(右は後で説明する transaction mode)
台数が多い構成では、アプリと DB の間に PgBouncer のような接続プールを置き、多くのアプリの接続を少ない DB の接続にまとめます。
PgBouncer には、アプリの接続が切れるまで DB の接続を貸し続ける session mode と、トランザクションの間だけ貸し出して終わると返す transaction mode などがあります(features)。多くのアプリの接続を少ない DB の接続にまとめられるのは、transaction mode です。その代わり、セッションに結び付いた機能(SET で変えた設定や、一部のプリペアドステートメントなど)に制約が出ます。プリペアドステートメントとの関係は、Query Plan Cache のノートで説明しています。
接続プールは、DB の接続という資源に上限を置く仕組みでもあります。呼び出し先ごとにプールを分けて、1 つの用途が接続を使い切っても他の用途に残るようにする考え方は、Bulkhead のノートで扱っています。
利点
- 接続の費用(TCP、認証、プロセスの起動)を、問い合わせのたびに払わずに済む
- DB が同時に抱える問い合わせの数に上限を置き、DB の 1 件あたりの処理を速いまま保てる
- 要求が急に増えても、あふれた分はアプリ側の待ちになり、DB の接続数の上限を超えない
欠点
接続プールは、接続を使い回し、同時に使う本数を絞ることで、DB の処理を速く保ちます。その代わりに、次の制約があります。
- プールが埋まると、アプリ側で接続を待つ時間が増える(待つ時間の上限を決めておく必要がある)
- 適した大きさは DB の CPU の数や問い合わせの性質で変わり、実際の負荷で測って決める必要がある
- アプリのサーバーの台数が増えると、DB から見た接続数が台数に比例して増える
- 長いトランザクションや、接続を返し忘れる実装があると、プールの接続を持ち続けて他の要求を待たせる
- PgBouncer の transaction mode のように接続を細かく使い回すと、セッションに結び付いた機能が使えなくなる
接続プールの効果が小さくなりやすいケース
- 1 日に数回しか動かないバッチのように、接続を張る回数がもともと少ない処理
- 問い合わせのほとんどが数秒以上掛かる重い集計で、接続の費用が誤差になる場合
- 同時に動く要求が常に数本で、プールの大きさが問題にならない規模
実験のスクリプトと出力の全体は lab/ にあります。