データドリフト(data drift)は、モデルを学習した時と本番とで、データの分布が変わることです。コードもモデルも変えていないのに予測が外れ始める原因の 1 つで、本番のモデルを監視する仕組みには、入力の分布を学習時と比べてアラートを出す機能がよく入っています。
このアラートを入れる時、次の前提を置きがちです。
- 入力の分布が動いたら、正解率は落ちる。
- 入力の分布が動かなければ、正解率は保たれる。
- アラートが鳴ったら、再学習すれば戻る。
- p 値が小さいほど、大きく変わっている。
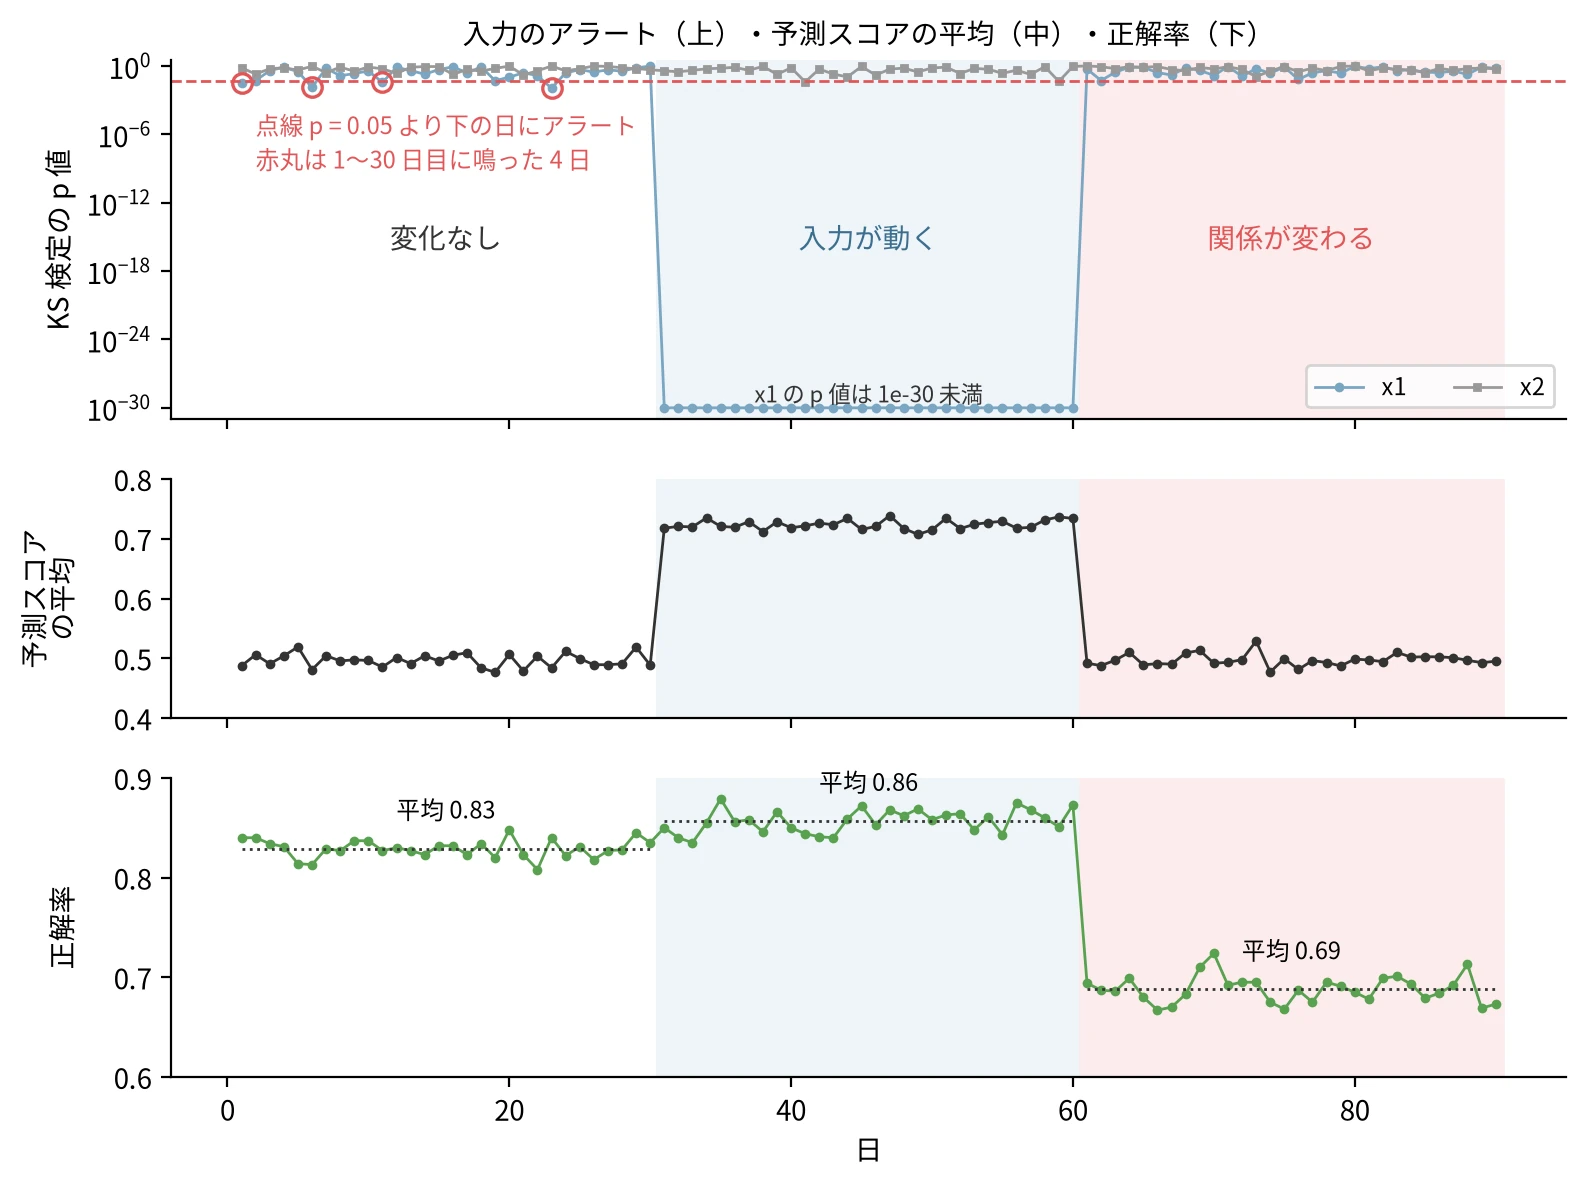
2 つの列 x1・x2 から 0 か 1 の y を当てるロジスティック回帰を 1 回だけ学習し、本番の 90 日分のデータを 1 日 1000 件ずつ作って監視しました。31 日目から x1 の平均を 1 ずらし、61 日目からは x1 を元に戻して、代わりに x2 が y に効かなくなるようにしています。
入力の監視は、学習時のデータとその日のデータを列ごとに 2 標本 KS 検定(Kolmogorov-Smirnov test)で比べ、どちらかの列の p 値が 0.05 未満ならアラートを出す形です。p 値は、2 つが同じ分布から取り出した標本だったとして、今と同じかそれより大きな差が偶然出る確率で、小さいほど同じ分布とは考えにくくなります。p 値の意味は仮説検定で説明しています。
入力のアラート(上)・予測スコアの平均(中)・正解率(下)の 90 日
x1 のアラートは 31〜60 日目の 30 日とも鳴り、その間の正解率は 0.83 から 0.86 に上がりました。61 日目からはアラートが 1 日も鳴らず、モデルが返す y=1 の確率である予測スコアも平均は学習時と同じ 0.50 のまま、正解率だけが 0.69 に落ちています。何も変えていない 1〜30 日目にも、アラートは 4 日鳴りました。
上の 4 つの前提は、この 90 日の監視と、後の節で行う実験で、どれも成り立たない例が出ます。本番のモデルにドリフトの監視を入れようとしている人や、監視のアラートが鳴っても精度が変わらない、またはアラートは静かなのに予測が外れている、という場面に出会った人は、まず「何の分布が変わったのか」を分けて考える必要があります。
本記事では、次の疑問に答えます。
- 何の分布が変わると、ドリフトと呼ぶのか。
- 入力が動いた時、正解率はいつ落ちるのか。
- 入力も予測も動かない変化は、どうすれば見えるか。
- アラートの鳴りやすさは、件数と列の数でどう変わるか。
- y=1 の割合だけが変わった時は、何を直すか。
- アラートが鳴った後、再学習で戻るのはどの変化か。
実験は scikit-learn 1.9.1、NumPy 2.5.4、SciPy 1.18.1 で行いました。図を描く処理も含めた完全なコードは data-drift_gen.py にあります。
何の分布が変わるのか
入力を x、正解を y とすると、データの分布は 4 つの見方で書けます。P(x) は入力の分布、P(y) は正解の割合、P(y|x) は入力から見た正解の確率、P(x|y) は正解ごとの入力の分布です。同時確率・周辺確率・条件付き確率の関係は、同時確率と条件付き確率で説明しています。
ドリフトの種類は、このうち何が変わり、何が変わらないかで分けます。似た分け方は、Moreno-Torres らの A unifying view on dataset shift in classification(2012 年)が整理しています。
| 名前 | 変わるもの | 変わらないもの | 正解が無くても見えるか |
|---|---|---|---|
| 共変量シフト(covariate shift) | 入力の分布 | 入力から見た正解の確率 | 入力の監視で見える |
| コンセプトドリフト(concept drift) | 入力から見た正解の確率 | 何も前提にしない | 入力が同じなら見えない |
| ラベルシフト(label shift) | 正解の割合 | 正解ごとの入力の分布 | 入力は動くが、原因は分からない |
| ドメインシフト(domain shift) | 環境の違いによる全般 | 何も前提にしない | 中身による |
冒頭の実験では、31〜60 日目が共変量シフト、61〜90 日目がコンセプトドリフトです。コンセプトドリフトでは P(x) が一緒に変わることもありますが、冒頭の実験では P(x) を学習時と同じにしています。ドメインシフトは、病院 A のデータで学習したモデルを病院 B で使うような環境の違いを広く指し、上の 3 つのどれも含みえます。
入力の分布 P(x) が変わることだけをデータドリフトと呼ぶ資料もあります。監視の話をする時は、ドリフトという語で済ませず、どの分布を比べているかを具体的に書く方が誤解がありません。分布は、本番の運用中に変わるだけでなく、学習用と評価用のデータを集めた環境が違う時にも変わります。
入力が動いても正解率が上がる時
冒頭の実験は次のコードで作りました。make_day は、x1・x2 を標準正規分布から取り出し、y=1 の確率を sigmoid(w1 × x1 + w2 × x2) で決めます。期間ごとに、平均 mean か重み w のどちらかを変えています。
def make_day(n, mean=(0.0, 0.0), w=(2.0, 2.0)):
    """x1, x2 は標準正規分布を mean だけずらしたもの。y=1 の確率は sigmoid(w1*x1 + w2*x2)"""
    X = rng.normal(size=(n, 2)) + np.array(mean)
    y = (rng.random(n) < sigmoid(X @ np.array(w))).astype(int)
    return X, y


def day_condition(day):
    if day < 30:
        return {}                      # 変化なし
    if day < 60:
        return {"mean": (1.0, 0.0)}    # 入力が動く: x1 の平均が 1 ずれる。y と x の関係は同じ
    return {"w": (2.0, 0.0)}           # 関係が変わる: 入力は学習時と同じ。x2 が y に効かなくなる


X_train, y_train = make_day(5000)
model = LogisticRegression().fit(X_train, y_train)

days = []
for day in range(90):
    X, y = make_day(1000, **day_condition(day))
    p_ks = [stats.ks_2samp(X_train[:, j], X[:, j]).pvalue for j in range(2)]
    score = model.predict_proba(X)[:, 1]
    days.append({"day": day + 1, "X": X, "y": y, "p_x1": p_ks[0], "p_x2": p_ks[1],
                 "score_mean": score.mean(), "acc": (model.predict(X) == y).mean()})

for lo, hi, name in [(0, 30, "変化なし"), (30, 60, "入力が動く"), (60, 90, "関係が変わる")]:
    part = days[lo:hi]
    alarm = sum(min(d["p_x1"], d["p_x2"]) < 0.05 for d in part)
    print(f"{lo + 1:2d}〜{hi:2d} 日目 {name:6s}: アラート {alarm:2d} / 30 日、"
          f"予測スコアの平均 {np.mean([d['score_mean'] for d in part]):.3f}、"
          f"正解率 {np.mean([d['acc'] for d in part]):.3f}")
 1〜30 日目 変化なし  : アラート  4 / 30 日、予測スコアの平均 0.497、正解率 0.829
31〜60 日目 入力が動く : アラート 30 / 30 日、予測スコアの平均 0.724、正解率 0.857
61〜90 日目 関係が変わる: アラート  0 / 30 日、予測スコアの平均 0.497、正解率 0.688
31〜60 日目では、x1 の平均が 1 ずれましたが、y と x の関係 P(y|x) はそのままです。学習したロジスティック回帰は、本当の関係と同じ形の式なので、x1 がどこへ動いてもほぼ正しい確率を返します。x1 が大きい方へ動くと、y=1 の確率がはっきり高い点が増えるので、正解率は上がりました。
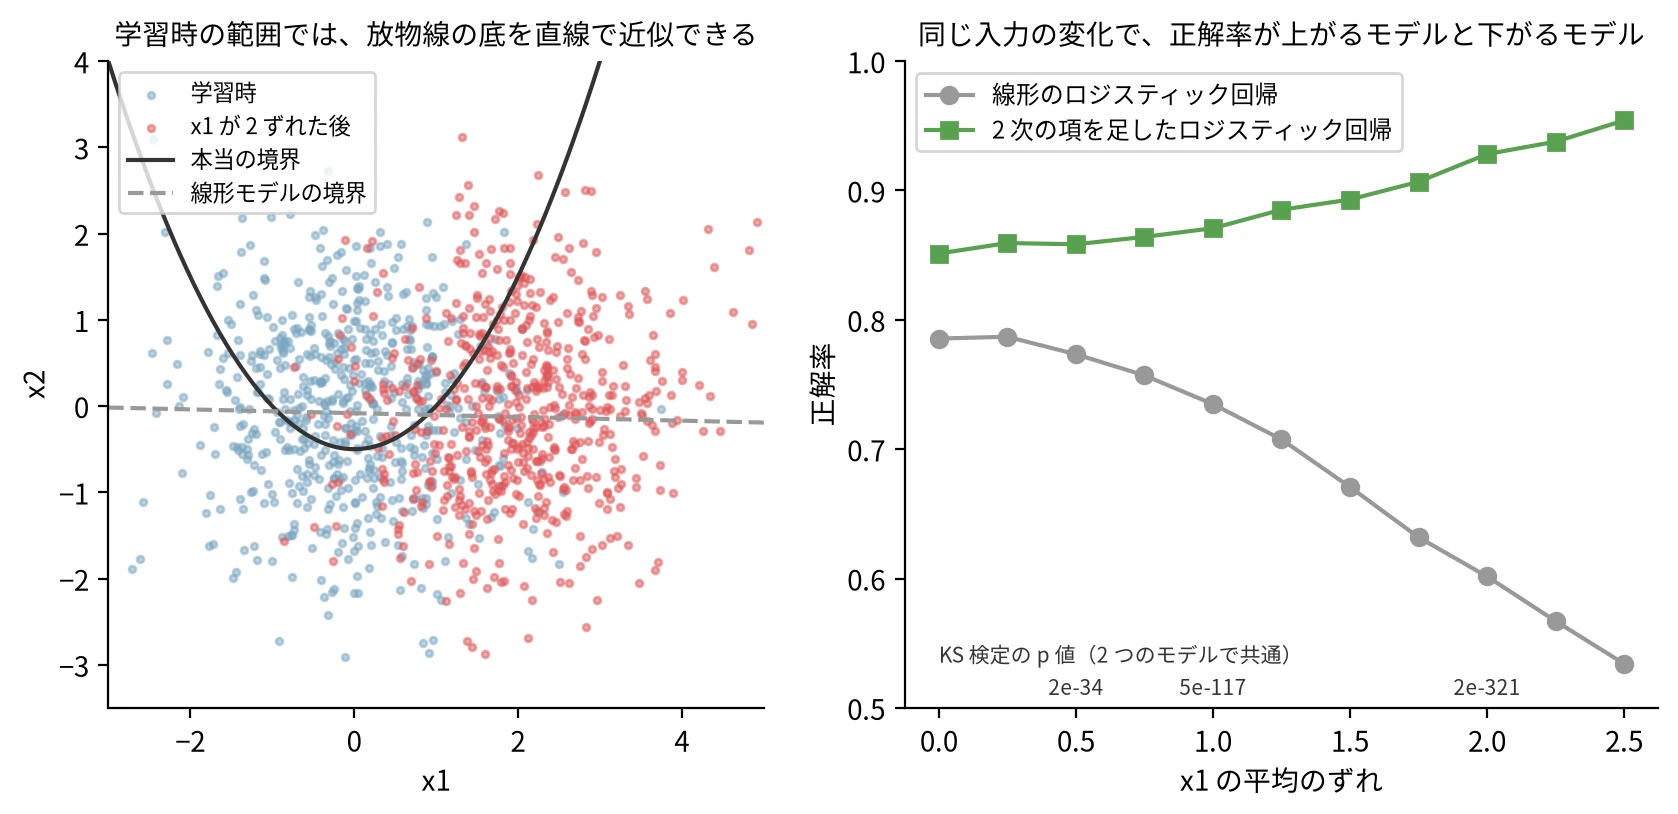
同じ共変量シフトでも、モデルの形が本当の関係と違うと話が変わります。y=1 の確率を決める境界を放物線にして、同じ 5000 件で 2 つのモデルを学習しました。1 つは境界を直線でしか引けない線形のロジスティック回帰、もう 1 つは x1 と x2 の 2 乗と積の項を足したロジスティック回帰です。本番では x1 の平均だけを 0 から 2.5 までずらし、正解率を比べます。
def truth_logit(X):
    return 3 * (X[:, 1] - 0.5 * X[:, 0] ** 2 + 0.5)   # 境界は放物線 x2 = 0.5 * x1^2 - 0.5


def make_shift(n, shift):
    X = rng.normal(size=(n, 2))
    X[:, 0] += shift                                    # x1 だけ平均を shift ずらす
    y = (rng.random(n) < sigmoid(truth_logit(X))).astype(int)
    return X, y


X_tr, y_tr = make_shift(5000, 0.0)
linear = LogisticRegression().fit(X_tr, y_tr)
quad = make_pipeline(PolynomialFeatures(2), LogisticRegression(max_iter=1000)).fit(X_tr, y_tr)

shifts = np.round(np.arange(0, 2.51, 0.25), 2)
res = {"linear": [], "quad": [], "ks": []}
for s in shifts:
    X, y = make_shift(20000, s)
    res["linear"].append((linear.predict(X) == y).mean())
    res["quad"].append((quad.predict(X) == y).mean())
    res["ks"].append(stats.ks_2samp(X_tr[:, 0], X[:1000, 0]).pvalue)
    if s in (0.0, 1.0, 2.0):
        print(f"x1 のずれ {s:.1f}: KS の p 値 {res['ks'][-1]:.1e}  "
              f"線形 {res['linear'][-1]:.3f}  2 次の項あり {res['quad'][-1]:.3f}")
x1 のずれ 0.0: KS の p 値 9.9e-01  線形 0.785  2 次の項あり 0.851
x1 のずれ 1.0: KS の p 値 4.8e-117  線形 0.735  2 次の項あり 0.871
x1 のずれ 2.0: KS の p 値 2.2e-321  線形 0.602  2 次の項あり 0.928
同じ x1 のずれで、線形のモデルは正解率が下がり、2 次の項を足したモデルは上がる
x1 を 2 ずらすと、線形のモデルは正解率が 0.79 から 0.60 に下がり、2 次の項を足したモデルは 0.85 から 0.93 に上がりました。KS 検定の p 値は 2 つのモデルで同じです。入力のアラートはモデルを見ていないので、新しい範囲をモデルが正しく扱えるかどうかまでは教えてくれません。入力の分布を見るだけでは、P(y|x) が変わっていないことも分かりません。
左の図のとおり、学習時のデータは原点の周りに集まっていて、その範囲では放物線の底を水平な直線で近似できます。x1 が右へ動くと、放物線は急に立ち上がりますが、線形のモデルは学習した範囲の外へ直線をそのまま延ばします。この実験で線形のモデルが正解率を落としたのは、学習した範囲の外で本当の関係と違う形をしていたためです。
形が合っているモデルでも、正解率が落ちる共変量シフトはあります。y=1 の確率が 0.5 に近い境界の付近へ入力が寄ると、正解がもともと五分五分の点が増え、どんなモデルでも当てにくくなります。冒頭の 31〜60 日目に正解率が上がったのは、その逆に、入力が境界から離れる向きへ動いたためです。
入力も予測も動かない変化
冒頭の 61〜90 日目は、入力の分布 P(x) を学習時に戻し、y の確率を決める式から x2 を外しました。モデルは固定で、入力の分布も同じなので、モデルが返す予測スコアの分布も学習時と同じになります。ここで言う予測スコアは、モデルが返す y=1 の予測確率です。
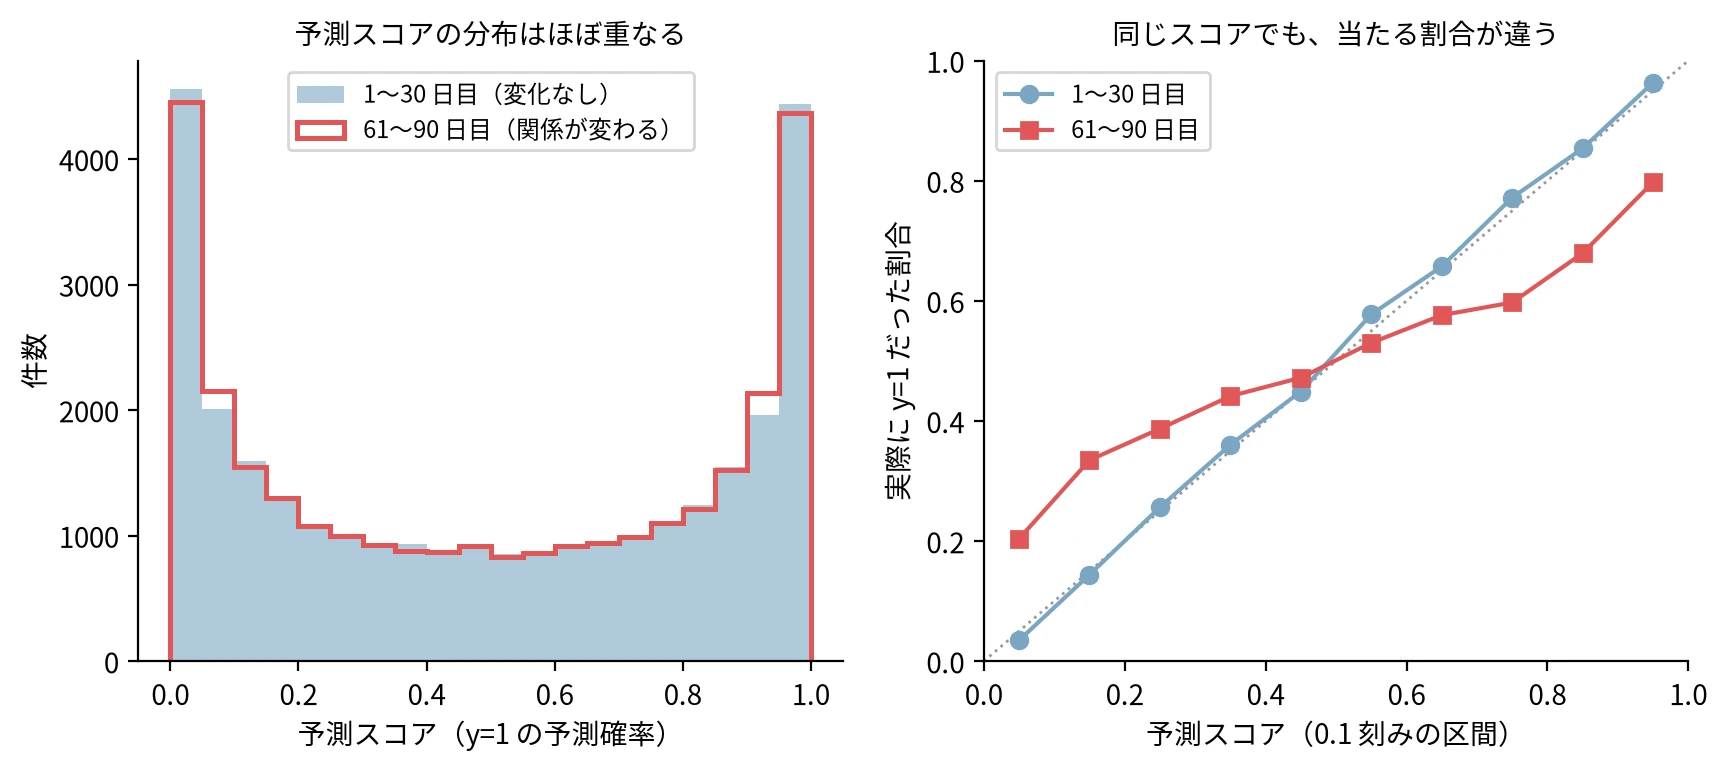
1〜30 日目と 61〜90 日目の予測スコアを比べ、さらにスコアを 0.1 刻みの区間に分けて、区間ごとに実際に y=1 だった割合を数えました。y=1 を正例と呼び、この割合を正例率と呼びます。この図は信頼性プロットと呼ばれ、確率の校正でも使います。
before = days[0:30]
after = days[60:90]
s_before = np.concatenate([model.predict_proba(d["X"])[:, 1] for d in before])
s_after = np.concatenate([model.predict_proba(d["X"])[:, 1] for d in after])
y_before = np.concatenate([d["y"] for d in before])
y_after = np.concatenate([d["y"] for d in after])
print(f"予測スコアの KS 検定(1〜30 日目と 61〜90 日目): p = {stats.ks_2samp(s_before, s_after).pvalue:.2f}")
bins = np.linspace(0, 1, 11)
rate_b, rate_a = [], []
for lo, hi in zip(bins[:-1], bins[1:]):
    mb, ma = (s_before >= lo) & (s_before < hi), (s_after >= lo) & (s_after < hi)
    rate_b.append(y_before[mb].mean())
    rate_a.append(y_after[ma].mean())
print("予測スコア 0.9〜1.0 の実際の正例率:", f"{rate_b[-1]:.2f} → {rate_a[-1]:.2f}")
print("予測スコア 0.0〜0.1 の実際の正例率:", f"{rate_b[0]:.2f} → {rate_a[0]:.2f}")
予測スコアの KS 検定(1〜30 日目と 61〜90 日目): p = 0.99
予測スコア 0.9〜1.0 の実際の正例率: 0.96 → 0.80
予測スコア 0.0〜0.1 の実際の正例率: 0.03 → 0.20
関係が変わった期間も予測スコアの分布は同じで、当たる割合だけが違う
予測スコアの分布を KS 検定で比べると p = 0.99 で、左の図でも 2 つのヒストグラムはほぼ重なります。右の図では、スコアが 0.9〜1.0 の区間で実際に y=1 だった割合が 0.96 から 0.80 に、0.0〜0.1 の区間では 0.03 から 0.20 に変わりました。モデルが返すスコアの並びは同じなのに、そのスコアが当たらなくなっています。
この変化は、入力を見ても予測を見ても分からず、正解と突き合わせた時に初めて見えます。予測した時刻・対象の ID・予測スコアを記録しておき、後から届いた正解と結び付けて正解率を出す仕組みが要ります。正解が遅れて届くサービスでモデルを監視する方法は、モデル性能の監視で説明しています。
検索の数とインフルエンザの関係が変わった例
実際に起きたコンセプトドリフトとしてよく引かれるのが、Google Flu Trends です。Google で検索された回数から、インフルエンザらしい症状で受診した患者の割合を推定する仕組みで、米国の CDC(疾病対策センター)の報告を当てるように作られていました。Lazer らの The Parable of Google Flu(Science、2014 年)によると、2013 年 2 月には CDC の 2 倍を超える割合を予測し、2011 年 8 月からの 108 週のうち 100 週で高く外しました。
論文は、外した原因として考えられるものに、Google が検索の仕組みに加えた変更を挙げています。Google は 2011 年 6 月に関連する検索語の提案を始め、2012 年 2 月には「fever」「cough」のような症状の検索へ病名の候補を返すようにしたと報告していて、これらが一部の語で検索回数を押し上げたと考えられます。入力である検索回数と、当てたい患者の割合をつなぐ関係 P(y|x) が、モデルの外で起きた変更によって動いた例と言えます。
件数と列の数で変わるアラート
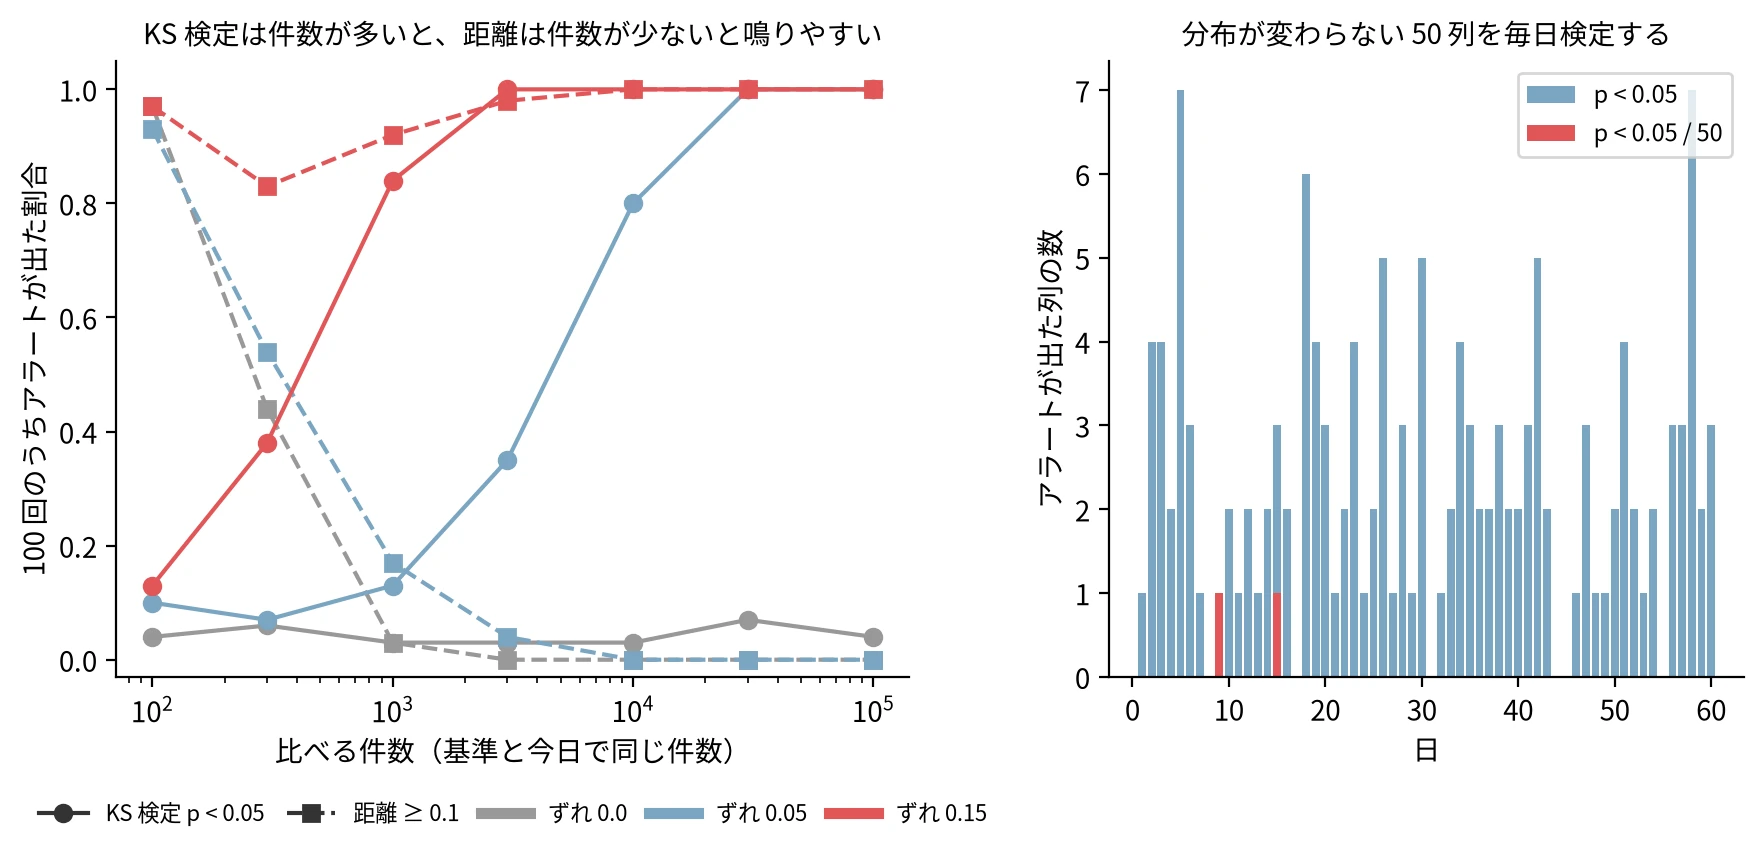
冒頭の 1〜30 日目は何も変えていないのに、アラートが 4 日鳴りました。KS 検定の p 値は、分布が同じでも 0.05 未満になる確率が 5% あり、x1 と x2 の 2 列を毎日見れば、どちらかが鳴る日はおよそ 10% になります。多くの検定を重ねると偽陽性が増える話も、冒頭で触れた仮説検定のノートにあります。
KS 検定は、2 つの標本それぞれで、値が t 以下の点が全体の何割かを t ごとに描いた累積分布を作り、その差が一番大きい所の値から p 値を出します。この p 値は件数にも左右され、件数が多いと、小さなずれでも 0.05 を下回ります。
そこで、ずれの大きさそのもので決める判定と比べました。2 つの分布がどれだけ離れているかを測る Wasserstein 距離を学習時のデータが持つ標準偏差で割り、0.1 以上ならアラートにする判定です。Wasserstein 距離は、片方の分布をもう片方の形に動かす時に、値を平均でどれだけ動かす必要があるかを表します。正規分布の平均だけがずれた時は、ずれの大きさそのものです。
ドリフトを監視するライブラリ Evidently は、文書によると、数値の列で使う既定の判定を件数で切り替えます。件数が 1000 以下なら KS 検定の p 値が 0.05 未満、それより多ければ標準偏差で割った Wasserstein 距離が 0.1 以上で、その列をドリフトとみなします。2026-11-13 に v0.7.23 の時点で読んだ文書の内容です。
sizes = [100, 300, 1000, 3000, 10000, 30000, 100000]
detect = {}
for shift in [0.0, 0.05, 0.15]:
    ks_rate, wd_rate = [], []
    for n in sizes:
        ks_hit = wd_hit = 0
        for _ in range(100):
            ref = rng.normal(size=n)
            cur = rng.normal(size=n) + shift          # 平均が標準偏差の shift 倍だけずれる
            ks_hit += stats.ks_2samp(ref, cur).pvalue < 0.05
            wd_hit += stats.wasserstein_distance(ref, cur) / np.std(ref) >= 0.1
        ks_rate.append(ks_hit / 100)
        wd_rate.append(wd_hit / 100)
    detect[shift] = (ks_rate, wd_rate)
    print(f"ずれ {shift:.2f}: KS でアラート {[round(float(r), 2) for r in ks_rate]}")
    print(f"           距離でアラート {[round(float(r), 2) for r in wd_rate]}")

cols, n_days = 50, 60
ref = rng.normal(size=(5000, cols))
raw, bonf = [], []
for _ in range(n_days):
    cur = rng.normal(size=(1000, cols))               # 50 列とも分布は変わらない
    p = np.array([stats.ks_2samp(ref[:, j], cur[:, j]).pvalue for j in range(cols)])
    raw.append((p < 0.05).sum())
    bonf.append((p < 0.05 / cols).sum())
raw, bonf = np.array(raw), np.array(bonf)
print(f"50 列・60 日: 1 列でもアラートが出た日 {np.sum(raw > 0)} / 60(p < 0.05)、"
      f"{np.sum(bonf > 0)} / 60(p < 0.05 / 50)。1 日あたりのアラートの平均 {raw.mean():.1f} 列")
ずれ 0.00: KS でアラート [0.04, 0.06, 0.03, 0.03, 0.03, 0.07, 0.04]
           距離でアラート [0.97, 0.44, 0.03, 0.0, 0.0, 0.0, 0.0]
ずれ 0.05: KS でアラート [0.1, 0.07, 0.13, 0.35, 0.8, 1.0, 1.0]
           距離でアラート [0.93, 0.54, 0.17, 0.04, 0.0, 0.0, 0.0]
ずれ 0.15: KS でアラート [0.13, 0.38, 0.84, 1.0, 1.0, 1.0, 1.0]
           距離でアラート [0.97, 0.83, 0.92, 0.98, 1.0, 1.0, 1.0]
50 列・60 日: 1 列でもアラートが出た日 54 / 60(p < 0.05)、2 / 60(p < 0.05 / 50)。1 日あたりのアラートの平均 2.3 列
件数ごとのアラートの出やすさ(左)と、50 列を毎日検定した時のアラート(右)
平均が標準偏差の 0.05 倍だけずれた列は、KS 検定では 1000 件で 13% しか鳴りませんが、30000 件を超えると 100 回とも鳴りました。このずれは、冒頭の実験で 31 日目に加えたずれの 20 分の 1 です。件数が多いほど小さなずれも見つけられるので、p 値の小ささは変化の大きさを表しません。
距離の判定は逆で、分布が全く変わらなくても、100 件なら 97%、300 件なら 44% の回で鳴りました。標本が少ないと、同じ分布から取り出しても、手元の標本から描いた分布どうしの間に距離が出るためです。区間の割合から計算する PSI(Population Stability Index)でも同じことが起き、情報理論で実測しています。Evidently が 1000 件を境に KS 検定と距離を切り替えるのは、それぞれが誤って鳴りやすい件数を避ける作りと読めます。
右の図は、分布が変わらない 50 列を毎日 KS 検定した結果です。60 日のうち 54 日で、どれかの列にアラートが出ました。0.05 を列数 50 で割る Bonferroni の補正にすると、アラートが出た日は 2 日になります。補正すると小さな変化を見逃しやすくなるので、補正だけで済ませず、変化の大きさ・続いた日数・影響する件数も合わせてアラートの条件にします。
列ごとの検定は、列どうしの関係を見ていません。2 つの列がそれぞれ同じ分布のまま、一緒に増減する度合いだけが変わっても、列ごとの KS 検定は鳴りません。平均が同じでも分布の形が変わることはあるので、平均だけでなく分布全体を比べることも必要です。
正例の割合だけが変わる時
ラベルシフト(prior shift とも呼ぶ)では、正解の割合 P(y) が変わり、正解ごとの入力の分布 P(x|y) は変わりません。症状から病気を当てるモデルで、症状の出方は同じまま、流行で患者の割合だけが増えた時がこれに当たります。P(x|y) が同じでも、P(x) と P(y|x) はどちらも変わります。
小さな数値例で見ます。2 値の入力 x について P(x=1|y=1) = 0.8、P(x=1|y=0) = 0.2 とし、P(y=1) が 0.1 から 0.5 に変わったとします。P(x=1) は 0.8 × 0.1 + 0.2 × 0.9 = 0.26 から 0.5 に、ベイズの定理で求める P(y=1|x=1) は 0.08 / 0.26 ≒ 0.31 から 0.8 に変わります。P(x) が動くので、入力のアラートは鳴ります。
正例の割合が 0.1 のデータで学習したモデルを用意し、割合が 0.3 と 0.5 の本番で使いました。割合が変わると、モデルが返す確率は、学習時と本番で割合が何倍違うかを重みにして付け直した値からずれます。
モデルが返す予測確率を p、学習時に正例が占めた割合を π、本番の割合を π' とします。y=1 に付ける重みを a、y=0 に付ける重みを b と置くと、補正した確率は次の式で決まります。
a = p × π' / π
b = (1 - p) × (1 - π') / (1 - π)
補正した確率 = a / (a + b)
学習時より正例が増えれば a が大きくなり、補正した確率は上がります。
本番の π' は正解が無いと分かりません。Saerens らが 2002 年に示した方法は、補正した確率の平均を新しい π' にする計算を繰り返し、正解を使わずに推定します。この繰り返しは EM アルゴリズム(Expectation-Maximization)の一種です。
次のコードで使う make_label は、y=1 の入力を平均 (1, 1)、y=0 の入力を平均 (0, 0) の正規分布から作ります。本番で変えるのは正例の割合 prior だけです。コードでは π を prior_train、推定中の π' を q と書いています。
def make_label(n, prior):
    y = (rng.random(n) < prior).astype(int)
    X = rng.normal(size=(n, 2)) + np.where(y[:, None] == 1, 1.0, 0.0)   # y=1 は平均 (1, 1)
    return X, y


prior_train = 0.1
X_l, y_l = make_label(20000, prior_train)
clf = LogisticRegression().fit(X_l, y_l)
rows = []
for prior in [0.1, 0.3, 0.5]:
    X, y = make_label(20000, prior)
    p = clf.predict_proba(X)[:, 1]
    q = prior_train                                   # 正解を使わずに今の正例率を推定する(EM)
    for _ in range(100):
        a = p * q / prior_train
        b = (1 - p) * (1 - q) / (1 - prior_train)
        q = np.mean(a / (a + b))
    a = p * q / prior_train
    b = (1 - p) * (1 - q) / (1 - prior_train)
    p_adj = a / (a + b)                               # 推定した正例率で予測確率を補正
    recall = lambda s: ((s > 0.5) & (y == 1)).sum() / (y == 1).sum()
    rows.append((prior, q, ((p > 0.5) == y).mean(), ((p_adj > 0.5) == y).mean(), recall(p), recall(p_adj)))
    print(f"正例率 {prior:.1f}: 推定 {q:.3f}  正解率 {rows[-1][2]:.3f} → {rows[-1][3]:.3f}  "
          f"再現率 {rows[-1][4]:.3f} → {rows[-1][5]:.3f}  "
          f"KS の p 値(x1){stats.ks_2samp(X_l[:1000, 0], X[:1000, 0]).pvalue:.1e}")
正例率 0.1: 推定 0.104  正解率 0.910 → 0.910  再現率 0.209 → 0.220  KS の p 値(x1)3.1e-01
正例率 0.3: 推定 0.306  正解率 0.753 → 0.798  再現率 0.202 → 0.556  KS の p 値(x1)6.2e-03
正例率 0.5: 推定 0.505  正解率 0.597 → 0.755  再現率 0.206 → 0.762  KS の p 値(x1)1.6e-16
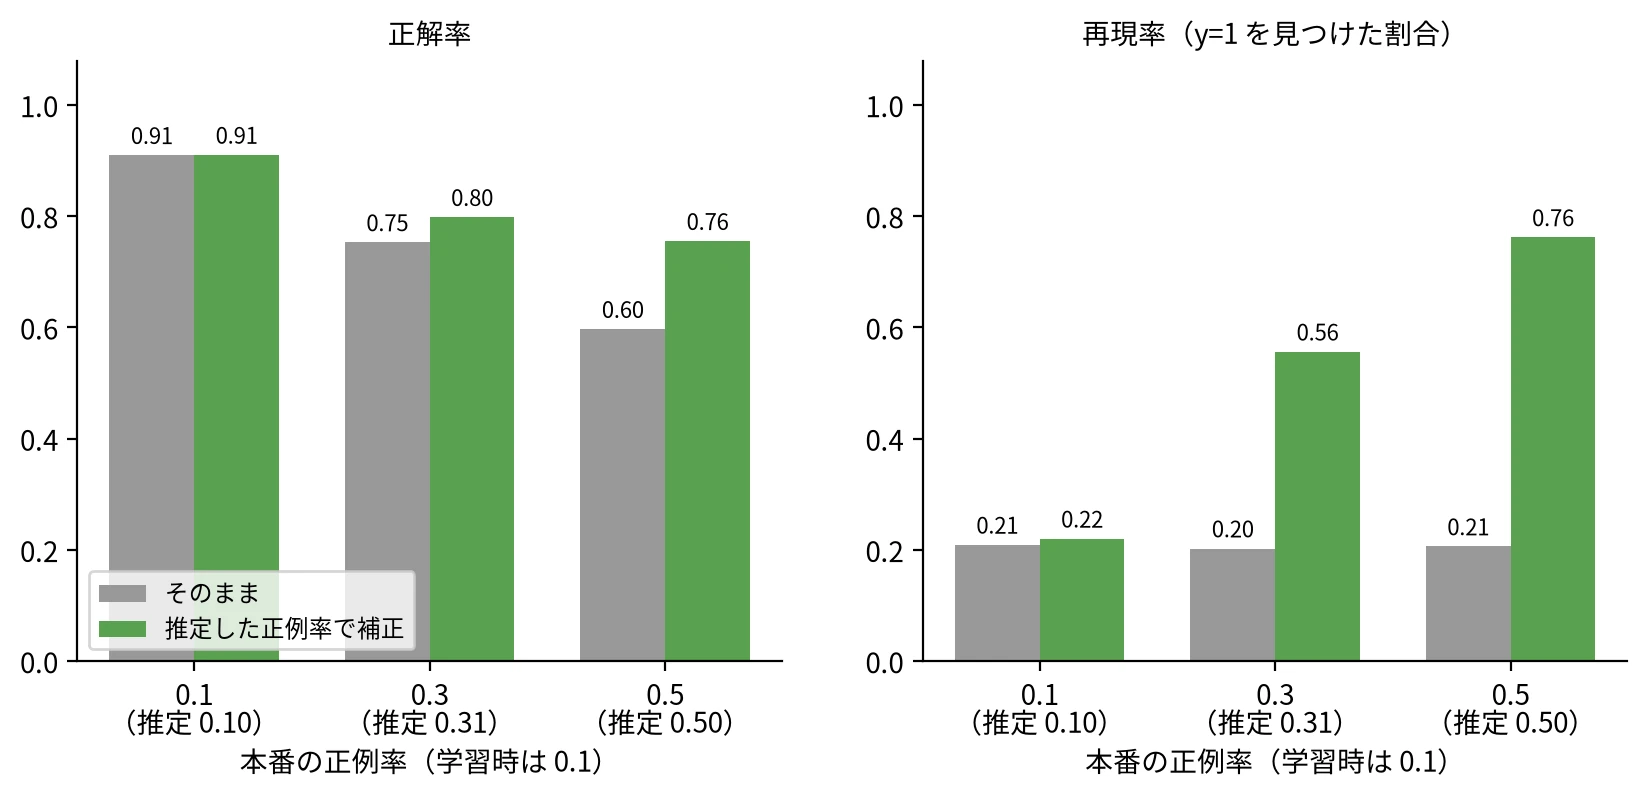
正例の割合だけが変わった時の、そのままのモデルと補正したモデル
正例の割合が 0.5 になると、そのままのモデルの正解率は 0.91 から 0.60 に落ち、y=1 を見つけた割合を表す再現率は 0.21 のままでした。モデルは学習時の 0.1 という割合を前提に、y=1 と言うのを控えたままだからです。正解を使わずに推定した割合は 0.505 で、それで補正すると正解率は 0.76、再現率は 0.76 になりました。
この補正が効くのは、P(x|y) が変わらないという前提が成り立つ時だけです。正例の割合が変わったことは分かっても、その前提が成り立つかどうかは割合からは分かりません。条件付きの分布ごと変わる一般の変化は、割合の補正や確率の校正だけでは解消できるとは限りません。中身を見られないモデルの予測だけからラベルシフトを検出・補正する方法は、Lipton らの Detecting and Correcting for Label Shift with Black Box Predictors(ICML 2018)にあります。
再学習で戻るもの、戻らないもの
冒頭の 90 日に、正解が 7 日遅れで届く条件を足して、毎日の朝にモデルを再学習する 2 つのやり方を固定のモデルと比べました。1 つは届いている正解のうち直近 14 日分だけで再学習するやり方、もう 1 つは学習時のデータと届いた全ての日で再学習するやり方です。いつ再学習を始めるか(定期・ドリフト検知・精度低下)と、どの期間で再学習するか、その評価の手順は、再学習パイプラインで説明しています。
DELAY, WINDOW = 7, 14
acc = {"fixed": [], "window": [], "all": []}
for t in range(30, 90):                               # 31〜90 日目
    known = range(0, t - DELAY + 1)                   # 正解が揃っている日(7 日前まで)
    Xw = np.vstack([days[k]["X"] for k in known][-WINDOW:])
    yw = np.concatenate([days[k]["y"] for k in known][-WINDOW:])
    Xa = np.vstack([X_train] + [days[k]["X"] for k in known])
    ya = np.concatenate([y_train] + [days[k]["y"] for k in known])
    X, y = days[t]["X"], days[t]["y"]
    acc["fixed"].append((model.predict(X) == y).mean())
    acc["window"].append((LogisticRegression().fit(Xw, yw).predict(X) == y).mean())
    acc["all"].append((LogisticRegression().fit(Xa, ya).predict(X) == y).mean())
for name, key in [("固定", "fixed"), ("直近 14 日で再学習", "window"), ("全期間で再学習", "all")]:
    a = np.array(acc[key])
    print(f"{name:10s}: 31〜60 日目 {a[:30].mean():.3f}  61〜67 日目 {a[30:37].mean():.3f}  "
          f"75〜90 日目 {a[44:].mean():.3f}")
固定        : 31〜60 日目 0.857  61〜67 日目 0.683  75〜90 日目 0.686
直近 14 日で再学習: 31〜60 日目 0.857  61〜67 日目 0.682  75〜90 日目 0.769
全期間で再学習   : 31〜60 日目 0.857  61〜67 日目 0.684  75〜90 日目 0.712
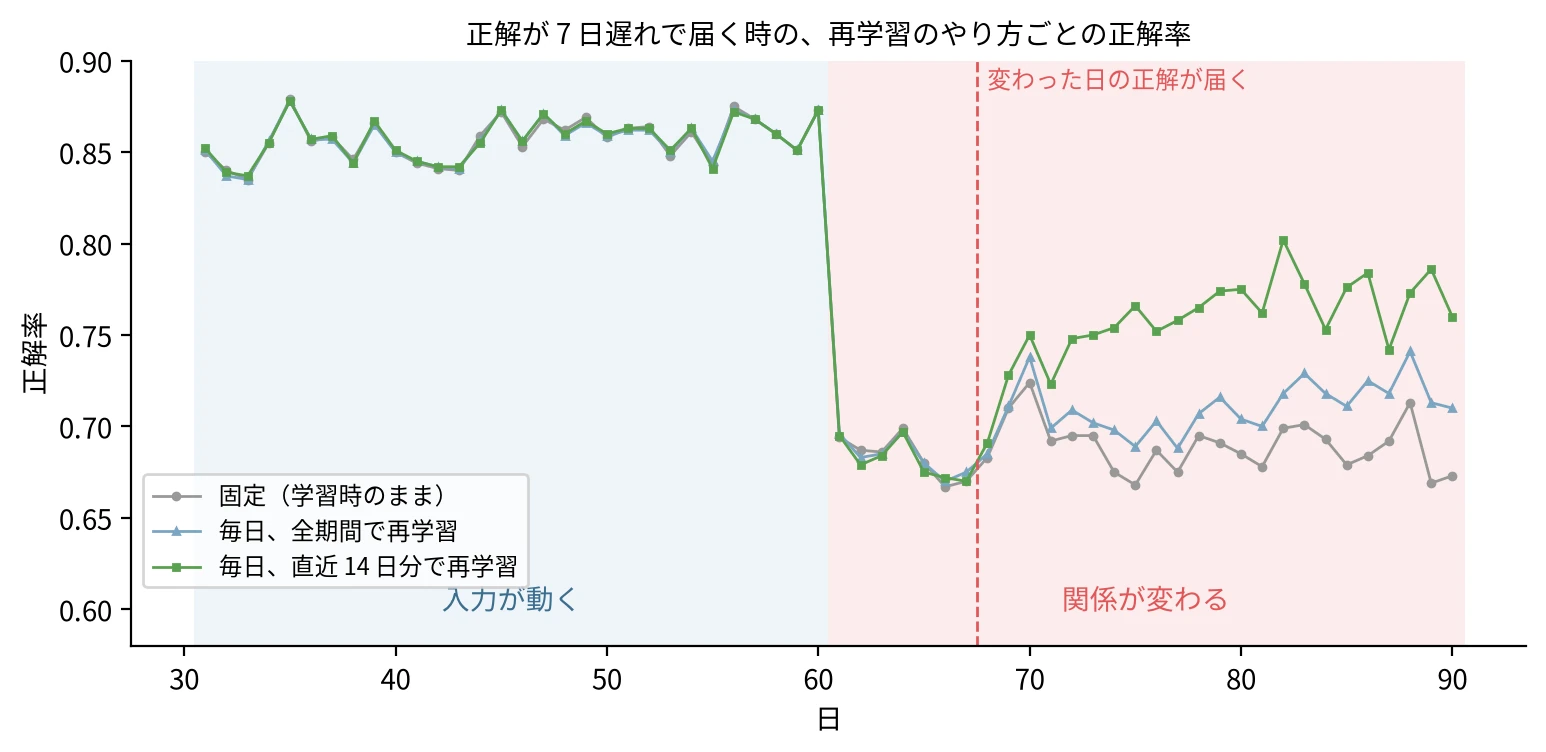
正解が 7 日遅れで届く時の、再学習のやり方ごとの正解率
31〜60 日目の共変量シフトでは、3 つのやり方の正解率は 0.857 で揃いました。アラートは 30 日鳴り続けていましたが、このモデルは本当の関係と同じ形で、P(y|x) も変わっていないので、再学習しても同じ式が返ってくるだけです。
61 日目からのコンセプトドリフトでは、変わった日の正解が届く 68 日目まで、どのやり方も 0.68 前後のままです。正解が揃った後は、直近 14 日分で再学習したモデルが 75〜90 日目に 0.769 まで戻り、全期間で再学習したモデルは 0.712 に留まりました。古い関係のデータが学習データの大半を占めているためです。
直近だけで再学習すると、一時的な偏りや誤った正解もそのまま取り込みます。SGDClassifier の partial_fit のように届いたデータで少しずつ更新するオンライン学習も同じで、更新の仕組みは勾配降下法と SGD で説明しています。直近だけに絞る代わりに、古いデータほど重みを下げて学習する方法もあります。再学習した候補は、学習に使っていない最近のデータで今のモデルと比べ、良くならなければ今のモデルを残します。新旧のモデルを並べて動かし、A/B テストで少しずつ新しいモデルへ切り替える運用もあります。
アラートが鳴った時に見る順
アラートが鳴ったら、最初に、データを集める処理と前処理が変わっていないかを見ます。単位の変更、欠損の増加、カテゴリの新しい値、列の取り違えでも、モデルに届く入力の分布は変わります。この場合に直すのはモデルではなく処理の方です。
処理に問題が無ければ、入力・予測・正解の割合のどれが動いたかを分けます。冒頭の図で言えば、上の段で入力が動き、中の段で予測スコアもそれに連れて動いたなら、共変量シフトの候補です。正解率が落ちるかどうかは、新しい範囲でモデルの形が本当の関係と合っているかと、入力が境界の近くへ寄ったかで決まります。入力と同時に正解の割合も動いたなら、ラベルシフトの補正で済むかを考えます。
鳴った列は、p 値ではなく、ずれの大きさ・続いた日数・影響する件数で並べ直します。冒頭の 1〜30 日目の 4 日のアラートや、50 列で 60 日中 54 日鳴ったアラートは、この並べ直しで優先度が下がります。
再学習の要否は、正解が届いた後の正解率で決めます。冒頭の 61〜90 日目のように、入力のアラートが 1 日も鳴らないまま正解率だけが落ちる変化もあるので、正解が遅れて届くサービスでは、入力の監視を早めの手掛かりとして使い、正解との突き合わせを判断の中心にします。正解が一部の利用者にしか付かないサービスでは、正解の付いた利用者が全体と同じ傾向かも見ます。