k-means(k 平均法)は、データの点を k 個のグループに分ける教師なし学習の手法です。グループをクラスタと呼び、各クラスタの中心からの距離が近い点を同じクラスタに集めます。正解のラベルを使わないので、顧客の分け方や、画像の色を k 色に減らす処理のように、答えの無いデータを要約する時に使います。
以下は、scikit-learn の KMeans を 2 つのデータに掛けた結果です。左は中心の違う 3 つの塊から作った 300 点、右は同じ範囲に一様な乱数で散らした 300 点で、右には塊がありません。黒い × がクラスタの中心です。
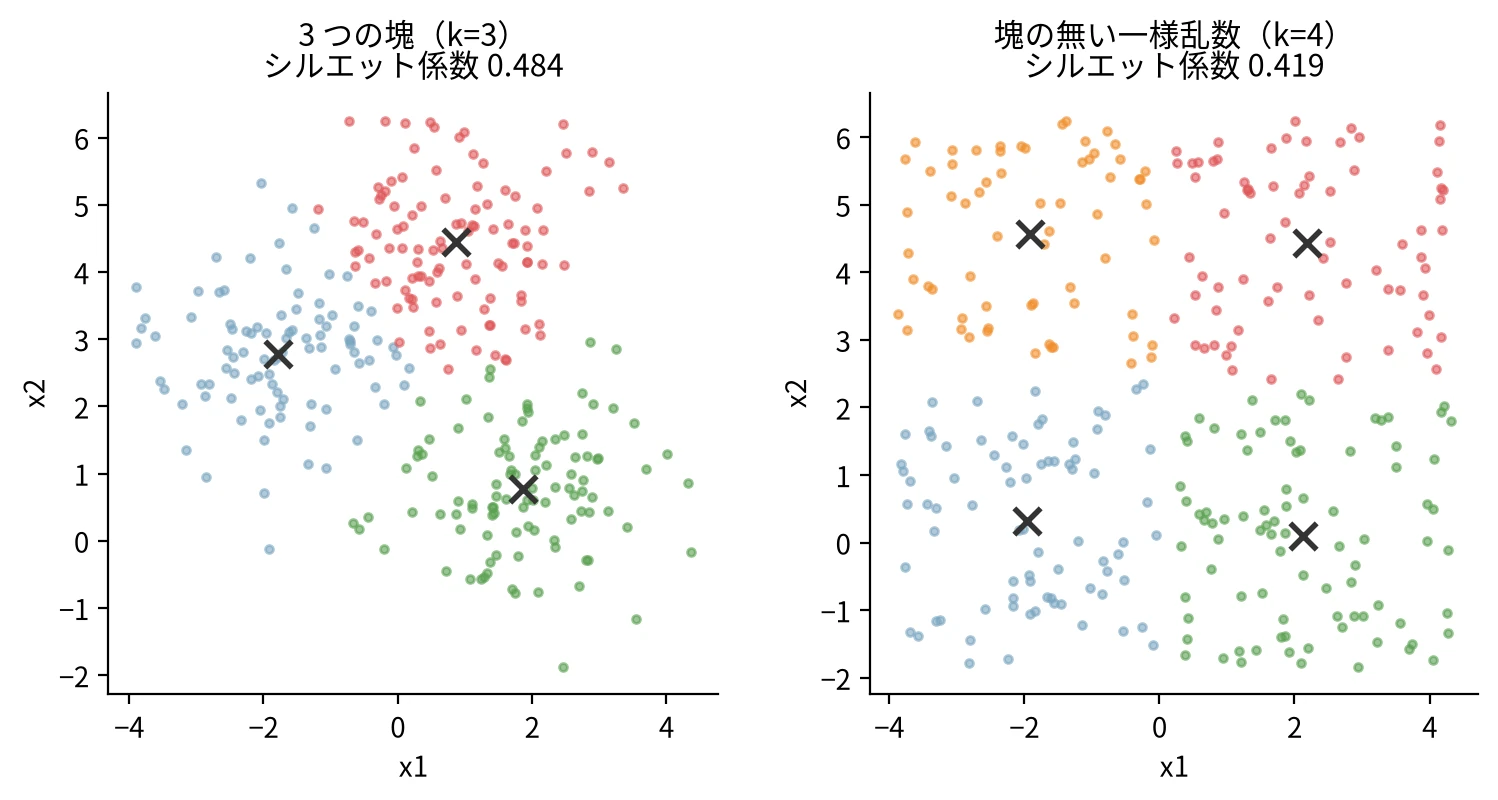
3 つの塊と、塊の無い一様乱数に k-means を掛けた結果
右の一様乱数でも、k-means は 4 つのきれいな区画を返しました。しかも、k を選ぶ時によく使う 3 つの指標を k=2〜8 で比べると、3 つともそろって k=4 を指します。クラスタの分かれ具合を表すシルエット係数も 0.419 で、本物の塊を持つ左の 0.484 と大きくは違いません。
手元の顧客データを k-means で分け、指標が 4 を指したので 4 つのセグメントに名前を付けて施策を考える、という場面はよくあります。その 4 つが、データの中に本当にある塊なのか、k-means が空間を 4 つに区切っただけなのかは、指標の値だけでは分かりません。
本記事では、ML を学び始めた人と、scikit-learn の k-means を手元のデータに使う人に向けて、次の疑問に答えます。
- k-means は何を小さくし、どんな手順で中心を決めるのか。
- 塊の無いデータでも、指標が k を 1 つに決めてしまうのはなぜか。
- 見つけた塊が本物かどうかは、どう確認するのか。
- 同じデータでも、実行するたびに結果が変わるのはなぜか。
- 列の単位や塊の形は、結果をどう変えるのか。
実験は scikit-learn 1.9.1 と NumPy 2.5.4 で行いました。図を描く処理も含めた完全なコードは k-means_gen.py にあります。
割り当てと更新の 2 段
k-means は、2 つの段を交互に繰り返して中心を動かします。割り当ての段では、各点を最も近い中心のクラスタに入れます。更新の段では、各クラスタに入った点の平均を新しい中心にします。この繰り返しは、Lloyd の論文の名前から Lloyd のアルゴリズムとも呼ばれます。
以下は、この 2 段を数値計算のライブラリ NumPy だけで書き、冒頭の図とは別の、中心の近い 3 つの塊を持つ 300 点に k=3 で掛けるコードです。初期の中心は、データの点からランダムに 3 つ選びます。
rng = np.random.RandomState(0)
X1 = rng.randn(100, 2) + np.array([0, 0])
X2 = rng.randn(100, 2) + np.array([3, 3])
X3 = rng.randn(100, 2) + np.array([0, 4])
Xh = np.vstack([X1, X2, X3])


def kmeans(X, k, max_iter=100, seed=0):
    # 1. 初期の中心を、データの点からランダムに k 個選ぶ
    rng = np.random.RandomState(seed)
    centers = X[rng.choice(len(X), k, replace=False)]
    history = [centers]

    for n_iter in range(1, max_iter + 1):
        # 2. 割り当て: 各点を最も近い中心の番号にする
        dists = np.linalg.norm(X[:, None, :] - centers[None, :, :], axis=2)
        labels = np.argmin(dists, axis=1)

        # 3. 更新: 割り当てられた点の平均を新しい中心にする
        new_centers = centers.copy()
        for i in range(k):
            members = X[labels == i]
            if len(members) > 0:
                new_centers[i] = members.mean(axis=0)
            else:
                # 0 件だと平均が NaN になるので、今の中心から最も遠い点へ移す
                far = np.argmax(dists[np.arange(len(X)), labels])
                new_centers[i] = X[far]

        # 4. 中心がほぼ動かなくなったら終了
        if np.allclose(centers, new_centers, atol=1e-4):
            break
        centers = new_centers
        history.append(centers)

    return labels, centers, history, n_iter


labels_h, centers_h, history, n_iter = kmeans(Xh, k=3)
print("反復回数:", n_iter)
print("初期の中心:", history[0].round(2).tolist())
print("最後の中心:", centers_h.round(2).tolist())
print("各クラスタの点数:", np.bincount(labels_h))
反復回数: 7
初期の中心: [[0.37, 4.14], [3.64, 1.43], [2.27, -1.45]]
最後の中心: [[-0.1, 4.05], [2.91, 2.77], [-0.09, 0.16]]
各クラスタの点数: [ 98 101 101]
以下は、history に残した中心の位置を 4 つの時点で描いた図です。時点は、初期・1 回目と 2 回目の更新・収束です。点の色は、その時点の中心で割り当てたクラスタで、矢印は前の時点からの中心の動きです。
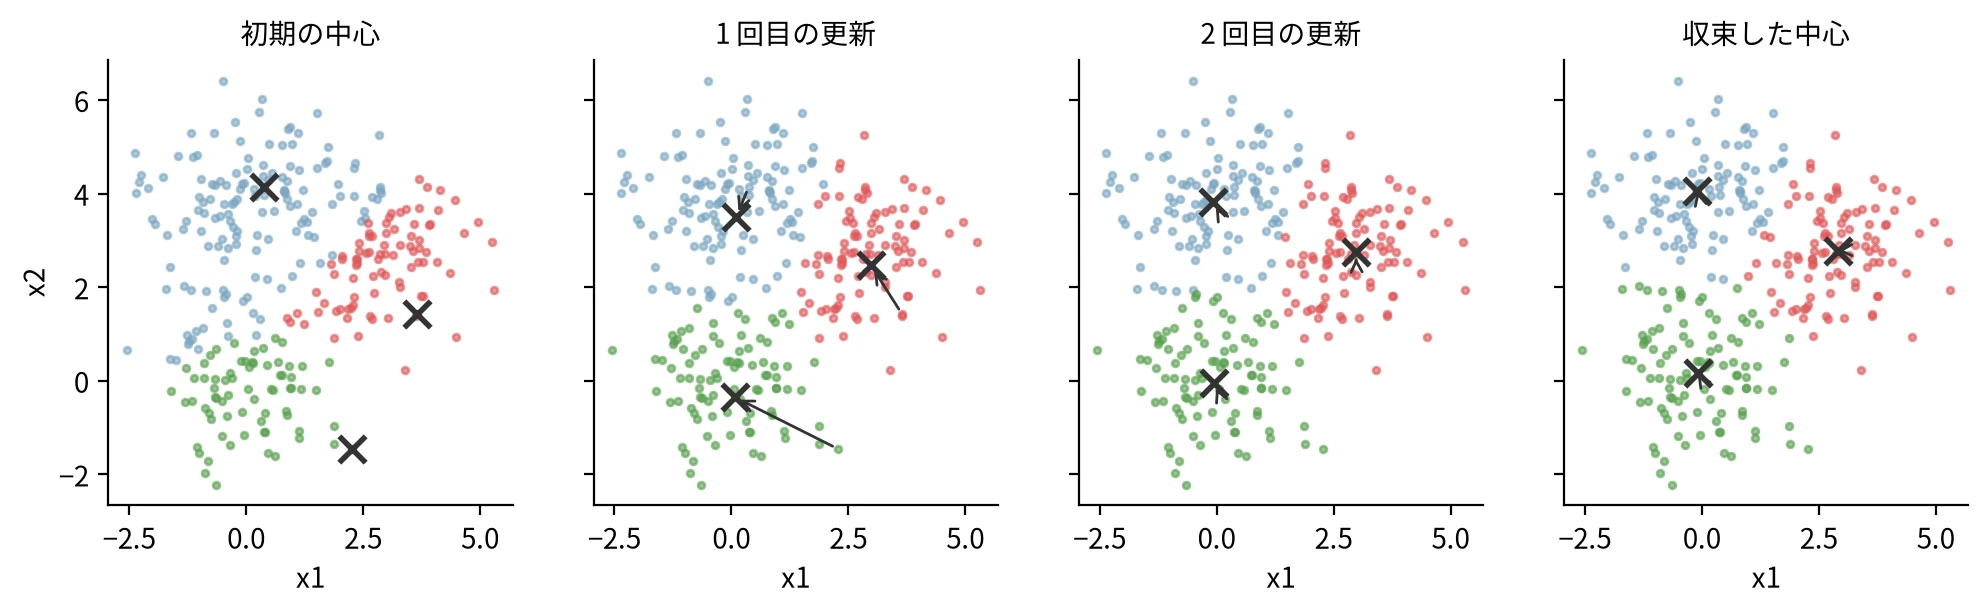
割り当てと更新を繰り返すと、中心が塊の真ん中へ移る
塊から外れた (2.27, -1.45) に置かれた中心も、1 回目の更新で左下の塊へ移り、7 回目で止まりました。最後の中心は、データを作った (0, 0)・(3, 3)・(0, 4) の近くです。
k-means が小さくしているのは、各点から自分のクラスタの中心までの距離の 2 乗を全ての点で足した値です。scikit-learn はこの値をイナーシャ(inertia)と呼び、inertia_ に入れて返します。割り当ての段も更新の段も、イナーシャを増やすことはありません。そのため、繰り返せば必ず止まります。
ただし、止まった所のイナーシャが一番小さいとは限りません。イナーシャは凸関数ではなく、中心の置き方によっては、最小より大きい値のまま、どちらへ動かしても下がらない所で止まります。どこで止まるかは初期の中心で決まるので、同じデータでも結果が変わります。この性質は、後の「実行するたびに結果が変わる理由」の節で実験します。
余談: 割り当てが 0 件のクラスタ
コードの else の枝は、割り当てが 0 件になったクラスタの扱いです。同じ座標の点を 2 つ初期の中心に選ぶと、距離が同じ点は全て番号の小さい中心に割り当てられ、もう一方は 0 件になります。0 件の平均は NaN で、NaN の中心は以後どの点とも距離が NaN になり、結果が壊れます。上の kmeans() は 0 件の中心を最も遠い点へ移していて、scikit-learn の実装も同じ考え方で移しています。
塊の無いデータで k を選ぶと
k-means は、k を先に決めないと動きません。k を選ぶ時によく使われるのは、次の 3 つの指標です。
| 指標 | 選ぶ k | 値の範囲 |
|---|---|---|
| イナーシャ | 減り方が鈍る所 | 0 以上、k とともに減る |
| シルエット係数 | 最も高い所 | -1〜1 |
| Davies-Bouldin 指数 | 最も低い所 | 0 以上 |
イナーシャは k を点の数まで増やせば 0 になるので、一番小さい k を選ぶことはできません。代わりに、k を 1 つ増やした時の減り方が急に鈍る所を探します。グラフが肘のように曲がるので、エルボー法と呼ばれます。考え方の由来としては、Thorndike の 1953 年の論文がよく挙げられます。
シルエット係数は、点ごとに 2 つの平均距離を比べます。a は同じクラスタの他の点までの平均距離、b は一番近い別のクラスタの点までの平均距離で、(b - a) / max(a, b) を全ての点で平均します。自分のクラスタの中が詰まっていて、隣のクラスタが遠いほど 1 に近づきます。
Davies-Bouldin 指数は、Davies と Bouldin が1979 年の論文で提案した指標です。各クラスタについて、2 つのクラスタの広がりの和を中心同士の距離で割った値が最大になる相手を探し、その値を全てのクラスタで平均します。隣のクラスタと重なって見えるほど大きくなります。
以下のコードは、冒頭の図の 2 つのデータで、k=2〜8 の 3 つの指標を測ります。make_blobs は、指定した数の中心の周りに正規分布で点を散らし、塊のあるデータを作る scikit-learn の関数です。U は、3 つの塊のデータ X と同じ縦横の範囲に、一様な乱数で 300 点を散らしたものです。
X, y = make_blobs(n_samples=300, centers=3, cluster_std=1.0, random_state=0)
rng = np.random.RandomState(0)
U = rng.uniform(X.min(axis=0), X.max(axis=0), size=X.shape)  # 同じ範囲に一様に散らばる 300 点

ks = list(range(2, 9))
scores = {}
for name, data in [("3 つの塊", X), ("一様乱数", U)]:
    rows = []
    for k in ks:
        km = KMeans(n_clusters=k, n_init=10, random_state=0).fit(data)
        rows.append((km.inertia_, silhouette_score(data, km.labels_),
                     davies_bouldin_score(data, km.labels_)))
    scores[name] = np.array(rows)
    print(name)
    print("k   イナーシャ  シルエット  Davies-Bouldin")
    for k, (ine, sil, db) in zip(ks, rows):
        print(f"{k}   {ine:8.1f}   {sil:8.3f}   {db:8.3f}")
以下は、出力のうち k=2〜5 の行です。
3 つの塊
k   イナーシャ  シルエット  Davies-Bouldin
2     1010.1      0.446      0.849
3      536.4      0.484      0.720
4      448.6      0.411      0.919
5      372.2      0.390      0.938
一様乱数
k   イナーシャ  シルエット  Davies-Bouldin
2     2091.1      0.369      1.132
3     1309.6      0.396      0.828
4      837.2      0.419      0.766
5      700.1      0.400      0.872
以下は、k=2〜8 の全ての値を指標ごとに並べた図です。丸で囲んだ点が、各指標で選ばれる k です。
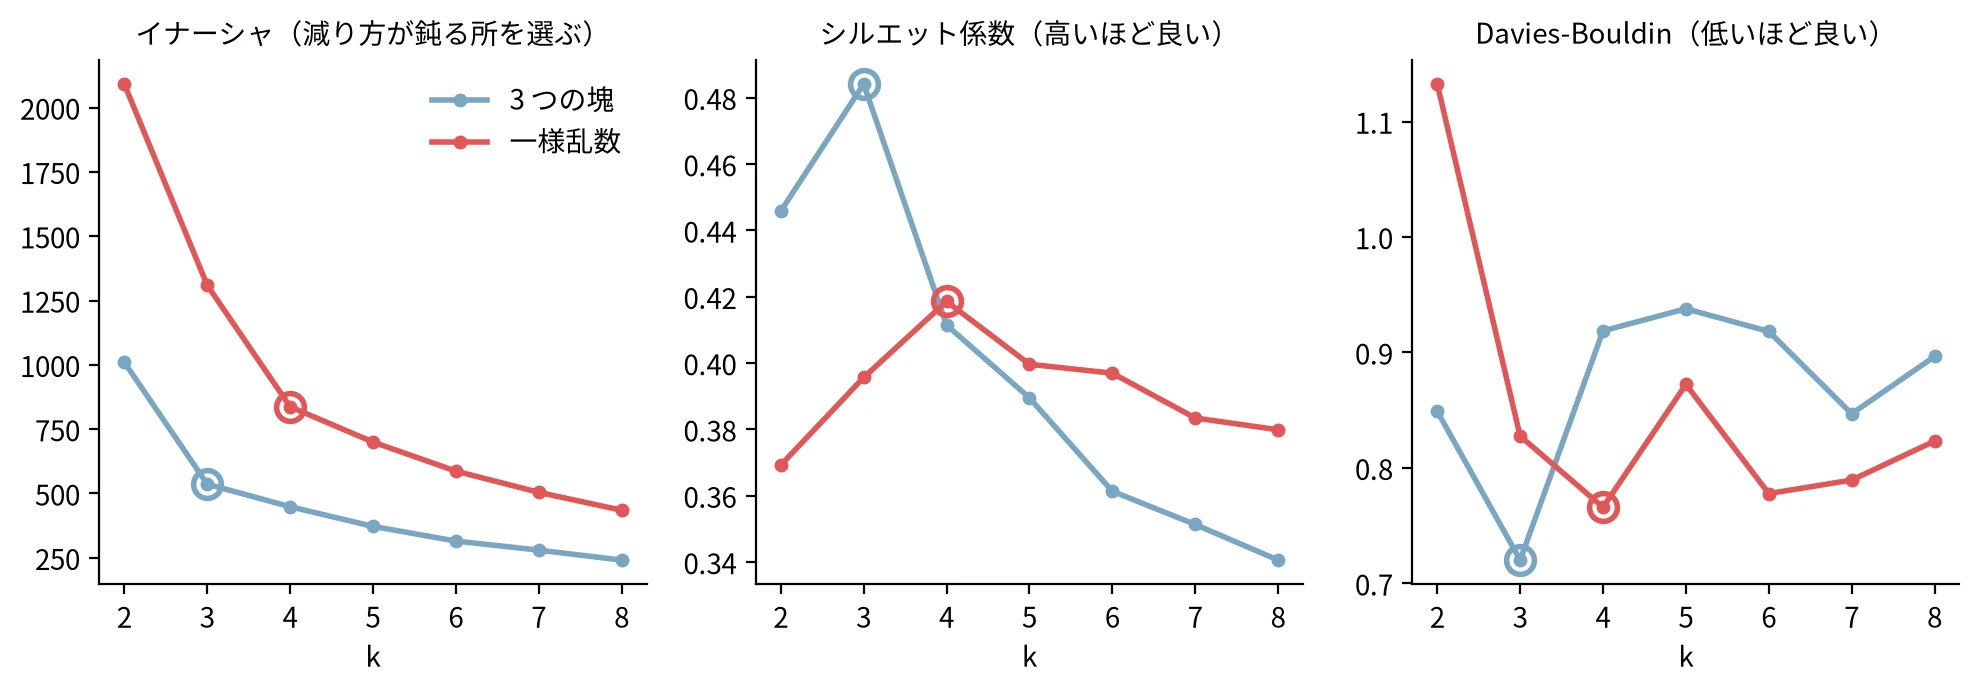
k を選ぶ 3 つの指標。3 つの塊では k=3、一様乱数では k=4 が選ばれる
3 つの塊のデータでは、3 つの指標がそろって k=3 を指しました。ここまでは期待どおりです。ところが一様乱数でも、イナーシャは 3→4 で 472 減った後、4→5 では 137 しか減らず、k=4 で曲がります。シルエット係数は k=4 で最大、Davies-Bouldin 指数は k=4 で最小です。
一様乱数が k=4 を選んだのは、散らした範囲の形のせいだと考え、範囲の縦横比を変えて確認しました。冒頭の U を散らした範囲は、横が約 8.3、縦が約 8.1 で、ほぼ正方形です。縦横比ごとに乱数の種を変えた 20 組を作り、シルエット係数が最大になる k を数えます。k ごとの回数は、Python の標準ライブラリの collections.Counter で数えます。
from collections import Counter

for ratio in [1, 2, 3]:
    picked = []
    for s in range(20):
        Ur = np.random.RandomState(100 + s).uniform([0, 0], [ratio, 1], size=(300, 2))
        sil = [silhouette_score(Ur, KMeans(n_clusters=k, n_init=10, random_state=0).fit(Ur).labels_) for k in ks]
        picked.append(ks[int(np.argmax(sil))])
    print(f"横:縦 = {ratio}:1 で選ばれた k の回数:", dict(sorted(Counter(picked).items())))
横:縦 = 1:1 で選ばれた k の回数: {3: 1, 4: 14, 5: 2, 6: 1, 8: 2}
横:縦 = 2:1 で選ばれた k の回数: {2: 20}
横:縦 = 3:1 で選ばれた k の回数: {2: 20}
正方形に近い範囲では 20 組中 14 組が k=4 を選び、横長にすると 20 組とも k=2 を選びました。指標が選んだ k は、データの中の塊ではなく、点を散らした範囲の形を写しています。3 つの指標は、どれも「k 個に分けた後の、まとまりと離れ具合」を測るだけで、分ける前にデータに塊があったかは測りません。そのため、3 つが同じ k を指しても、塊があることの証拠にはなりません。
一様乱数と比べて確かめる
シルエット係数の値の読み方には、解説によって少しずつ違う目安が紹介されています。例えば Wikipedia の Silhouette の項は、出典を示さずに、平均が 0.5 を超えれば妥当、0.25 を超えれば弱い構造としています。
この目安に当てはめると、前の節の値は本物の塊で 0.484、一様乱数で 0.419 で、どちらも 0.25〜0.5 の弱い構造の帯に入ります。点の数や次元が変われば値の出方も変わるので、1 本の目安の線で塊の有無を決めるのは難しいと言えます。
代わりに、同じ範囲の一様乱数で同じ手順を何回も行い、手元のデータの値と比べます。以下は、乱数の種を変えた一様乱数 20 組で、k=2〜8 の中で最も高いシルエット係数を集めるコードです。
null_best = []
for s in range(20):
    r = np.random.RandomState(100 + s)
    Ur = r.uniform(X.min(axis=0), X.max(axis=0), size=X.shape)
    best = max(silhouette_score(Ur, KMeans(n_clusters=k, n_init=10, random_state=0).fit(Ur).labels_)
               for k in ks)
    null_best.append(best)
null_best = np.array(null_best)
real_best = scores["3 つの塊"][:, 1].max()
print(f"一様乱数の範囲 {null_best.min():.3f}〜{null_best.max():.3f}、3 つの塊 {real_best:.3f}")
一様乱数の範囲 0.381〜0.442、3 つの塊 0.484
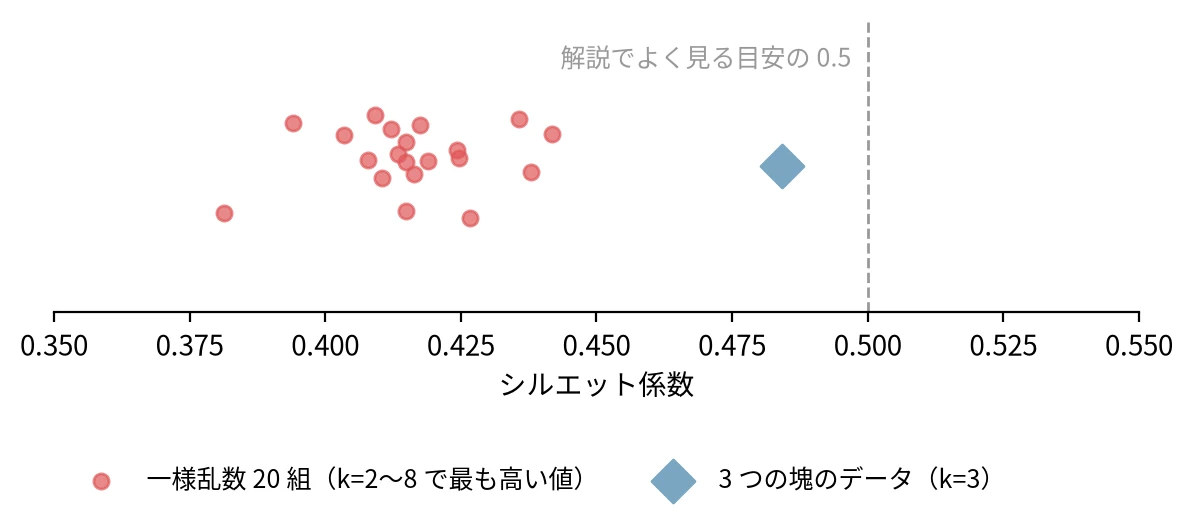
同じ範囲の一様乱数 20 組と、3 つの塊のデータのシルエット係数(縦の位置は重なりを避けるためにずらしただけ)
3 つの塊のデータの 0.484 は、20 組の一様乱数のどれよりも高い値でした。ただし、一様乱数の一番高い 0.442 との差は 0.04 ほどで、この差を目安の線だけから読み取ることはできません。塊の無いデータが取りうる値の範囲を作ってから比べると、初めて差が見えます。
イナーシャの減り方で同じ比較を行うのが、gap statistic です。Tibshirani らの論文は、一様乱数から作った参照のデータのイナーシャと比べて k を選ぶ方法を示していて、k=1、つまり塊が無いという答えも選べる点が、3 つの指標との違いです。
実行するたびに結果が変わる理由
最初の節で見たとおり、k-means が止まる所は初期の中心で変わります。そこで scikit-learn は、初期の中心を変えて何回か実行し、イナーシャの最も小さい結果を返します。その回数が n_init です。
初期の中心の選び方は、既定では k-means++ です。1 つ目の中心をランダムに選び、2 つ目以降は、既に選んだ中心から遠い点ほど選ばれやすくします。n_init の既定は scikit-learn 1.4 から "auto" に変わり、初期の中心を k-means++ で選ぶ時は 1 回しか実行しなくなりました。1.3 までの既定は 10 回です。
4×4 の格子に並べた 16 個の塊で、1 回で足りるかを確認しました。塊は互いに離れていて、正解の分け方は見ただけで分かります。分けた結果と正解の一致は、ARI(Adjusted Rand Index、調整ランド指数)で測ります。ARI は、2 つの分け方が同じなら 1、でたらめに分けた時と同じ程度なら 0 付近になる値で、クラスタの番号の付け方には左右されません。
grid = np.array([[i * 4.0, j * 4.0] for i in range(4) for j in range(4)])
Xg, yg = make_blobs(n_samples=1600, centers=grid, cluster_std=0.6, random_state=0)
ok_auto, ok_10, bad_seed = 0, 0, None
for s in range(100):
    lab_auto = KMeans(n_clusters=16, random_state=s).fit_predict(Xg)  # n_init は既定の "auto"
    lab_10 = KMeans(n_clusters=16, n_init=10, random_state=s).fit_predict(Xg)
    if adjusted_rand_score(yg, lab_auto) > 0.999:
        ok_auto += 1
    elif bad_seed is None:
        bad_seed = s
    ok_10 += adjusted_rand_score(yg, lab_10) > 0.999
print(f"16 個の塊を正しく分けた random_state: 既定 {ok_auto}/100、n_init=10 {ok_10}/100")
print("既定で失敗した最初の random_state:", bad_seed)
16 個の塊を正しく分けた random_state: 既定 83/100、n_init=10 100/100
既定で失敗した最初の random_state: 2
既定のままでは、random_state を 0〜99 に変えた 100 回のうち 17 回で、正しく分けられませんでした。以下は、その 1 つの random_state=2 の結果です。
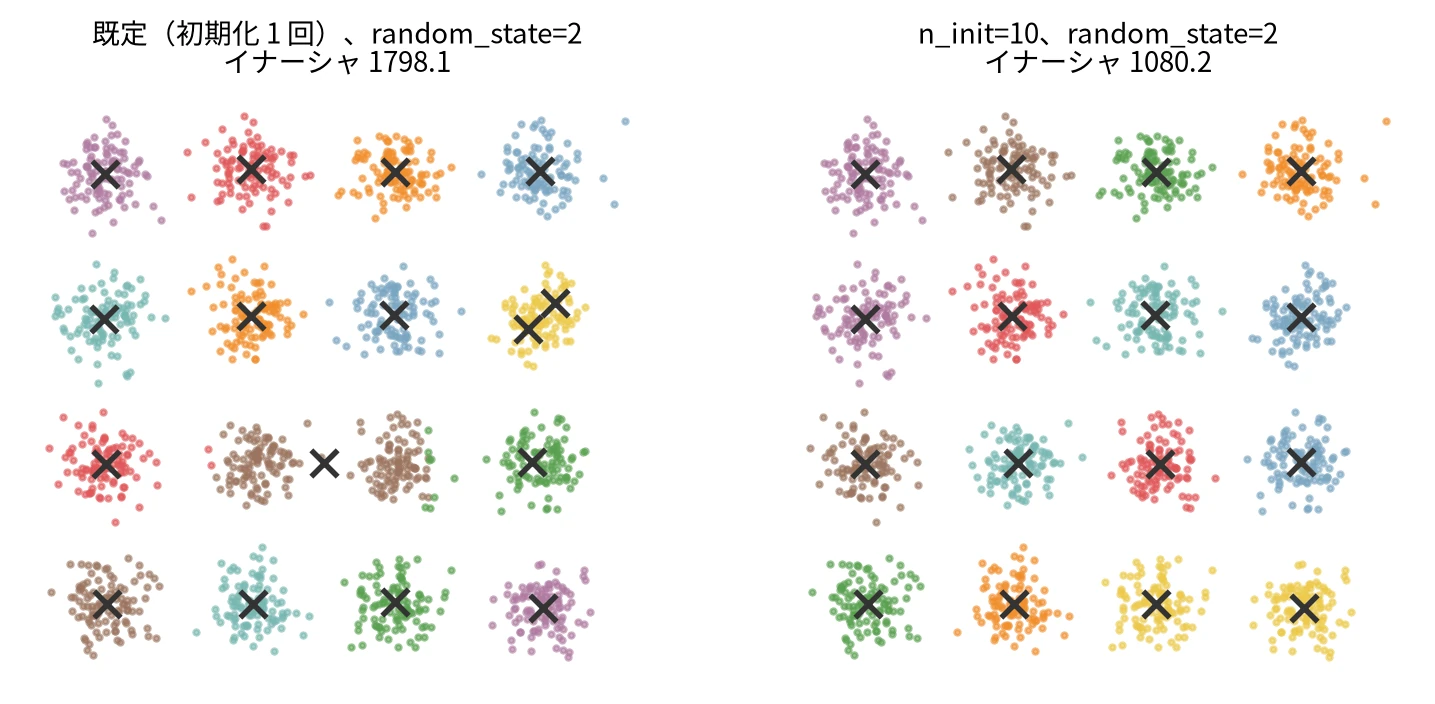
同じ random_state=2 での、既定の 1 回と n_init=10 の結果
左では、1 つの塊に中心が 2 つ入り、別の 2 つの塊は 1 つのクラスタにまとめられて、中心が塊の間の空白に置かれています。どの点もこれ以上動かないので、k-means はここで止まりました。イナーシャは 1798.1 で、n_init=10 で選ばれた右の 1080.2 の 1.7 倍ほどです。
n_init=10 にすると 100 回とも正しく分けられました。その代わり、1 回の fit で k-means を 10 回実行します。古い記事や 1.3 以前のコードの結果を再現する時も、n_init を明示しないと既定の回数が違います。
列の単位で変わるクラスタ
k-means は距離で点を分けるので、値の桁が大きい列ほど距離を左右します。scikit-learn に同梱の wine で確認します。wine は、3 品種のブドウから作ったワイン 178 本の化学分析の値を 13 列に並べたデータです。アミノ酸の一種のプロリンの量を表す proline の列だけ、値が 278〜1680 と大きく、他の列は magnesium の 70〜162 を除けば 30 以下です。
wine = load_wine()
Xw, yw = wine.data, wine.target
for title, data in [("そのまま", Xw), ("標準化してから", StandardScaler().fit_transform(Xw))]:
    lab = KMeans(n_clusters=3, n_init=10, random_state=0).fit_predict(data)
    print(f"wine {title}: ARI {adjusted_rand_score(yw, lab):.3f}")
wine そのまま: ARI 0.371
wine 標準化してから: ARI 0.897
以下は、各クラスタに各品種のワインが何本入ったかを数えたマス目です。
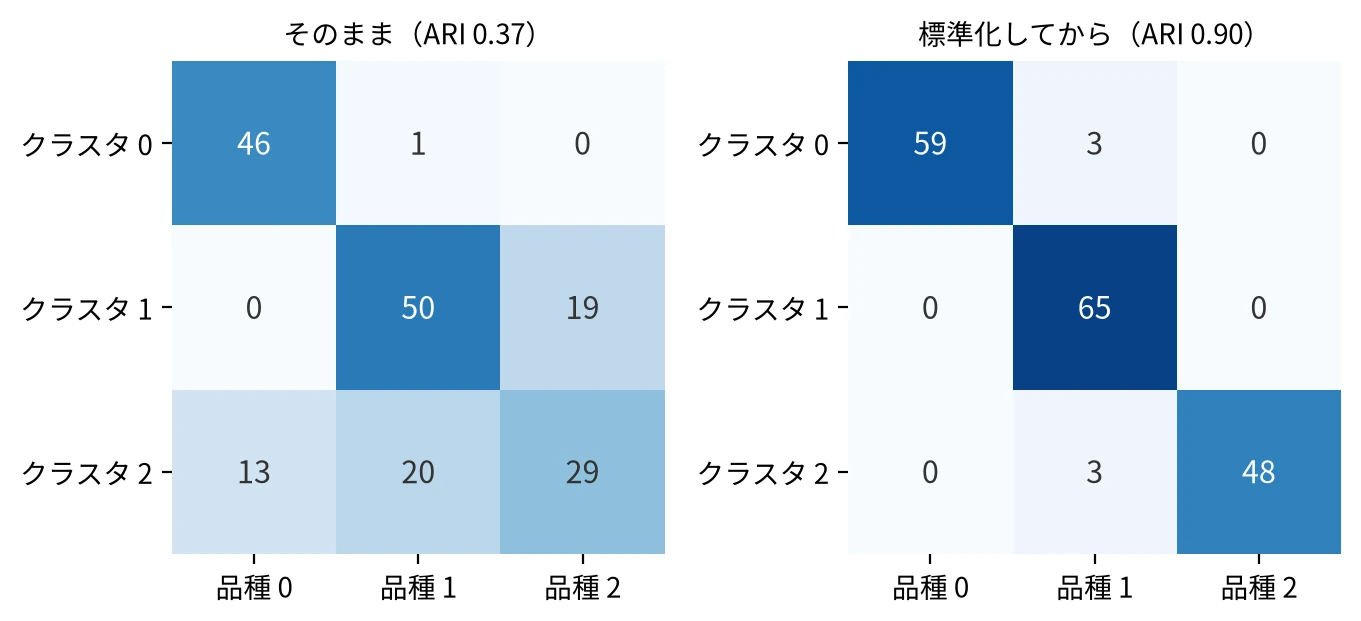
wine の 3 品種と、k=3 で分けたクラスタの対応
そのまま掛けると、クラスタ 2 には 3 品種が混ざりました。各列から平均を引いて標準偏差で割る標準化をしてから掛けると、ARI は 0.371 から 0.897 に上がり、ほぼ品種どおりに分かれます。
そのままの k-means が見ているのは、ほぼ proline の値の大小だけです。同じ wine で、PCA の第 1 主成分が proline の 1 列になる様子は PCA のノートで図にしています。列が多い時に PCA で次元を落としてから k-means を掛けるなら、その PCA の前にも標準化が要ります。
k-means が苦手な形
標準化しても、k-means が分けられない形があります。k-means は全ての点を一番近い中心に割り当てるので、クラスタの境目は、隣り合う 2 つの中心から等しい距離の直線になります。この性質から、どのクラスタも中心から丸く広がり、広がり方も同じくらいだという前提を置いていることになります。
以下は、この前提を外れる 3 つのデータに k-means と混合ガウスモデルを掛けた図です。混合ガウスモデルは、各クラスタを向きと広がりの違う正規分布で表す手法で、scikit-learn では GaussianMixture です。
Xb, yb = make_blobs(n_samples=600, random_state=170)
Xa = Xb @ np.array([[0.6, -0.6], [-0.4, 0.8]])  # 斜めに引き伸ばした塊
Xv, yv = make_blobs(n_samples=600, cluster_std=[1.0, 2.5, 0.5], random_state=170)  # 広がりの違う塊
Xu, yu = make_blobs(n_samples=[500, 30, 30], centers=[[0, 0], [4, 0], [4, 3]],
                    cluster_std=[1.5, 0.4, 0.4], random_state=0)  # 点の数の違う塊
cases = [("斜めに伸びた塊", Xa, yb), ("広がりの違う塊", Xv, yv), ("点の数の違う塊", Xu, yu)]
for title, data, truth in cases:
    Z = StandardScaler().fit_transform(data)
    km = KMeans(n_clusters=3, n_init=10, random_state=0).fit(Z)
    lab_gm = GaussianMixture(n_components=3, random_state=0).fit(Z).predict(Z)
    a_km, a_gm = adjusted_rand_score(truth, km.labels_), adjusted_rand_score(truth, lab_gm)
    print(f"{title}: k-means の ARI {a_km:.3f}、混合ガウスモデルの ARI {a_gm:.3f}")
斜めに伸びた塊: k-means の ARI 0.574、混合ガウスモデルの ARI 1.000
広がりの違う塊: k-means の ARI 0.774、混合ガウスモデルの ARI 0.956
点の数の違う塊: k-means の ARI 0.157、混合ガウスモデルの ARI 0.806
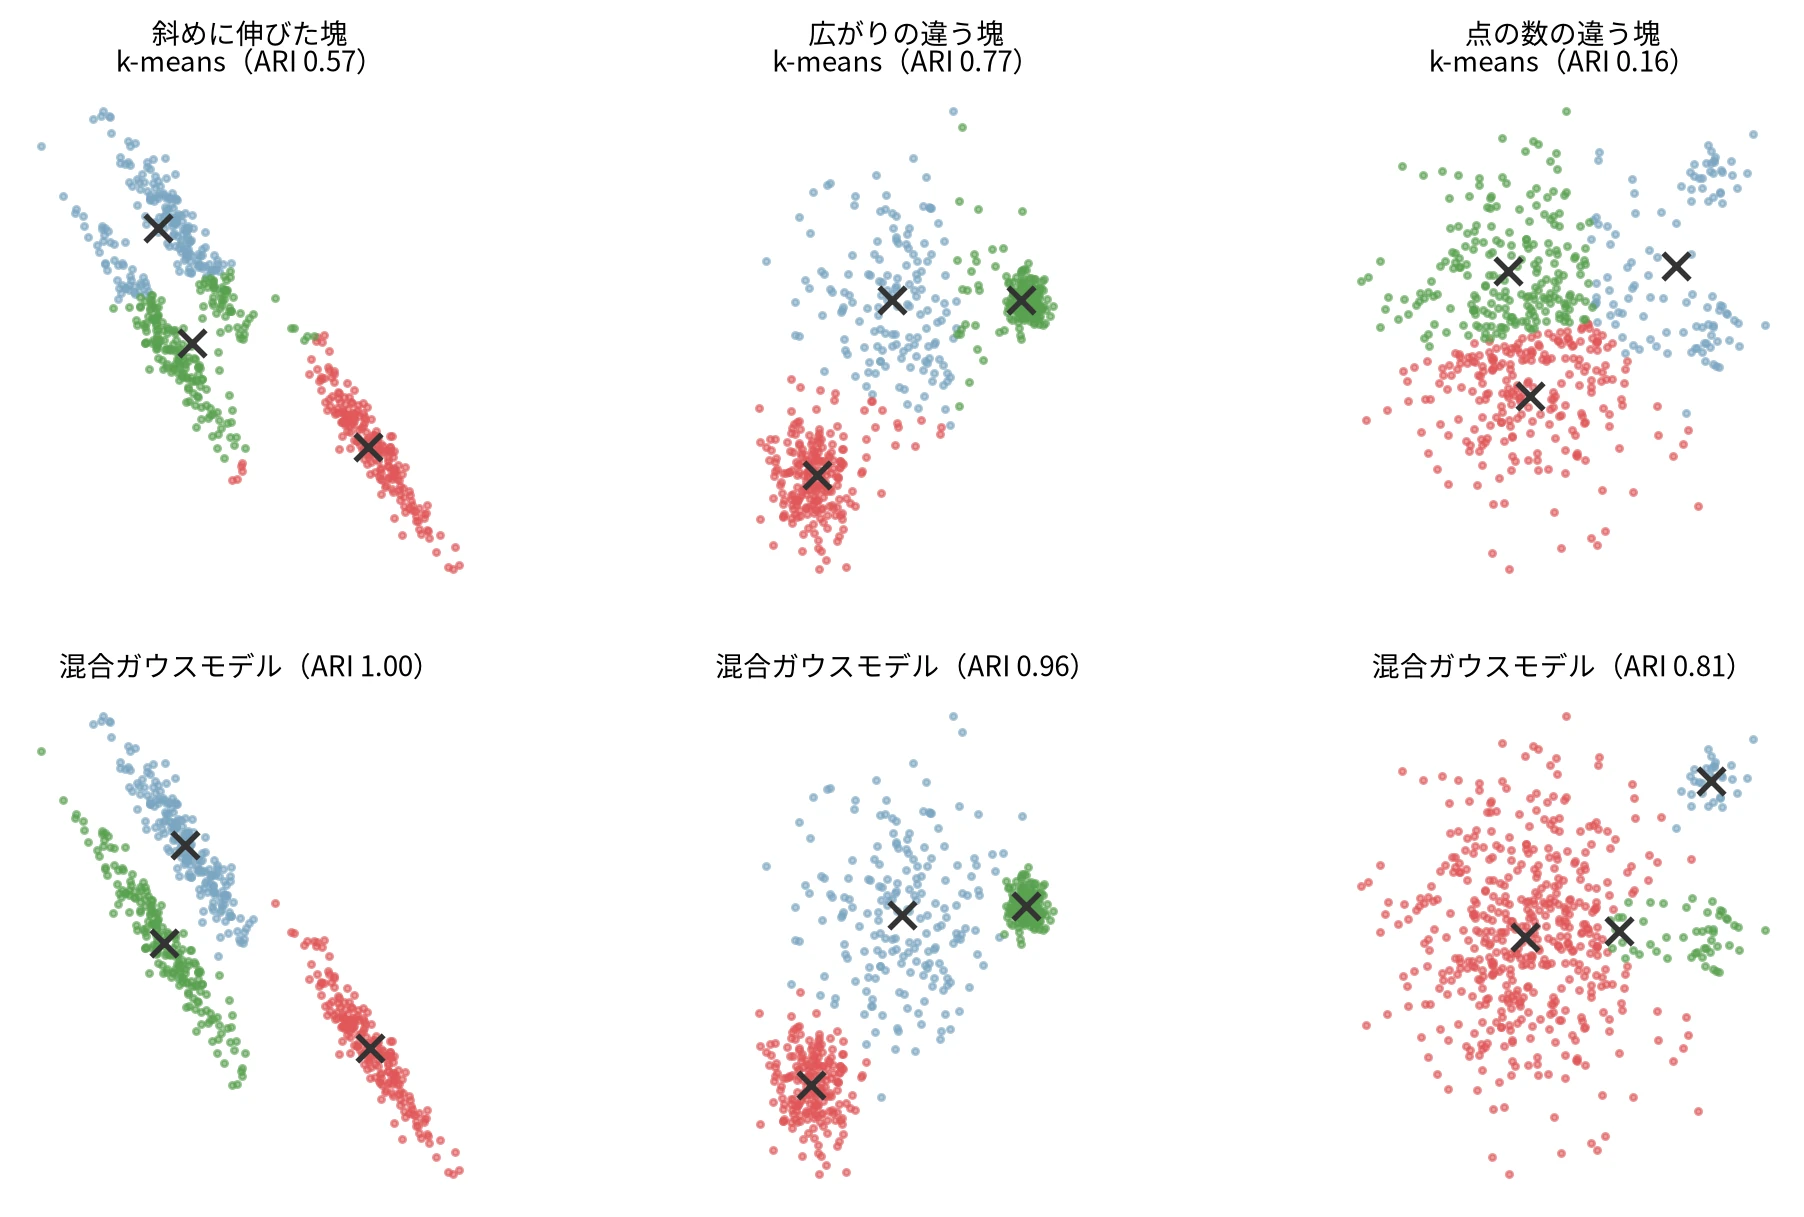
k-means の前提を外れる 3 つのデータと、混合ガウスモデルとの比較
一番差が大きいのは、500 点の大きい塊の横に 30 点の小さい塊が 2 つある右の列です。k-means は大きい塊を 2 つに割り、その右端と小さい 2 つの塊を 1 つのクラスタにまとめました。点の多い塊を割った方が、イナーシャが小さくなるからです。
形ごとに向く手法を並べると、次の表になります。
| 手法 | k を先に決めるか | 得意な形 | 外れ値 |
|---|---|---|---|
| k-means | 決める | 丸く、広がりと点の数が近い塊 | 中心を引っ張る |
| 混合ガウスモデル | 決める | 向きや広がりの違う楕円の塊 | 中心を引っ張る |
| DBSCAN | 決めない | 三日月のように曲がった塊 | 外れ値として分ける |
| 階層的クラスタリング | 後で切る高さを選ぶ | 入れ子になった塊 | つなぎ方による |
三日月型のデータで k-means と DBSCAN を比べた図は、DBSCAN のノートの最初の節にあります。
k-means を掛ける前に確かめること
最初に、列ごとの単位と桁をそろえます。単位の違う列が混ざっていれば標準化し、wine のように 1 列だけ桁が違うまま掛けると、その列の大小で分けた結果になります。カテゴリ変数のように平均や距離の意味が弱い列が多いなら、k-means 以外の手法を考えます。列が多すぎて距離の差が縮まる問題は、次元の呪いのノートで扱っています。
次に、k を選んだら、同じ範囲の一様乱数で同じ手順を回し、手元のデータの値がその範囲より上にあるかを見ます。冒頭の図の右のように、塊の無いデータでも k-means はきれいに区切り、3 つの指標はそろって 1 つの k を指します。指標が一致したことより、塊の無いデータとの差の方が、塊がある証拠になります。
scikit-learn 1.4 以降で既定の n_init のまま使っているなら、n_init=10 などを明示し、random_state を変えて結果が変わらないかを見ます。16 個の塊の実験では、既定では 100 回中 17 回、塊の割り方を間違えました。
最後に、分けた結果をセグメントとして使うなら、技術の指標とは別に、使う人と確認することが 3 つあります。セグメントごとに違う施策を打てるか、各セグメントに名前を付けられるか、運用でその数のセグメントを扱えるかです。名前を付けようとしても、冒頭の図の右のように「左上の区画」としか言えないなら、そのクラスタは k-means が空間を区切っただけかもしれません。