分散(variance、バリアンス)は、値が平均の周りにどれだけ散らばっているかを 1 つの数で表す指標です。各値から平均を引いた差を偏差と呼び、偏差を 2 乗して平均した値が分散です。期待値の記号では Var(X) = E[(X - E[X])²] と書き、式を展開すると E[X²] - E[X]²、つまり「2 乗の平均 − 平均の 2 乗」になります。分散の平方根を標準偏差と呼び、元の値と同じ単位で散らばりの大きさを読む時に使います。
2 つの式は数学の上では等しいので、計算しやすい方を使ってよさそうに見えます。後者なら、データを 1 回読む間に値の合計と 2 乗の合計を足していくだけで済みます。SQLite に組み込まれた集約関数には分散が無いので、SQL で AVG(ts * ts) - AVG(ts) * AVG(ts) と書くこともあります。以下、この書き方を AVG 式と呼びます。
ところが、Unix 時間をミリ秒で表した時刻を 1 万個作り、AVG 式で分散を計算すると、標準偏差 100 ms で散らばる時刻の分散が -1,073,741,824 になりました。2 乗の平均なので、正しい値は負になりえません。次の図は、時刻の散らばりを 1 ms から 1000 万 ms まで変えて、同じ計算を繰り返した結果です。正しい分散が 10 の 4 乗付近にある負の点が、上記の 1 回分です。散らばりの大きさが近くても、0 や正の値になる回があります。
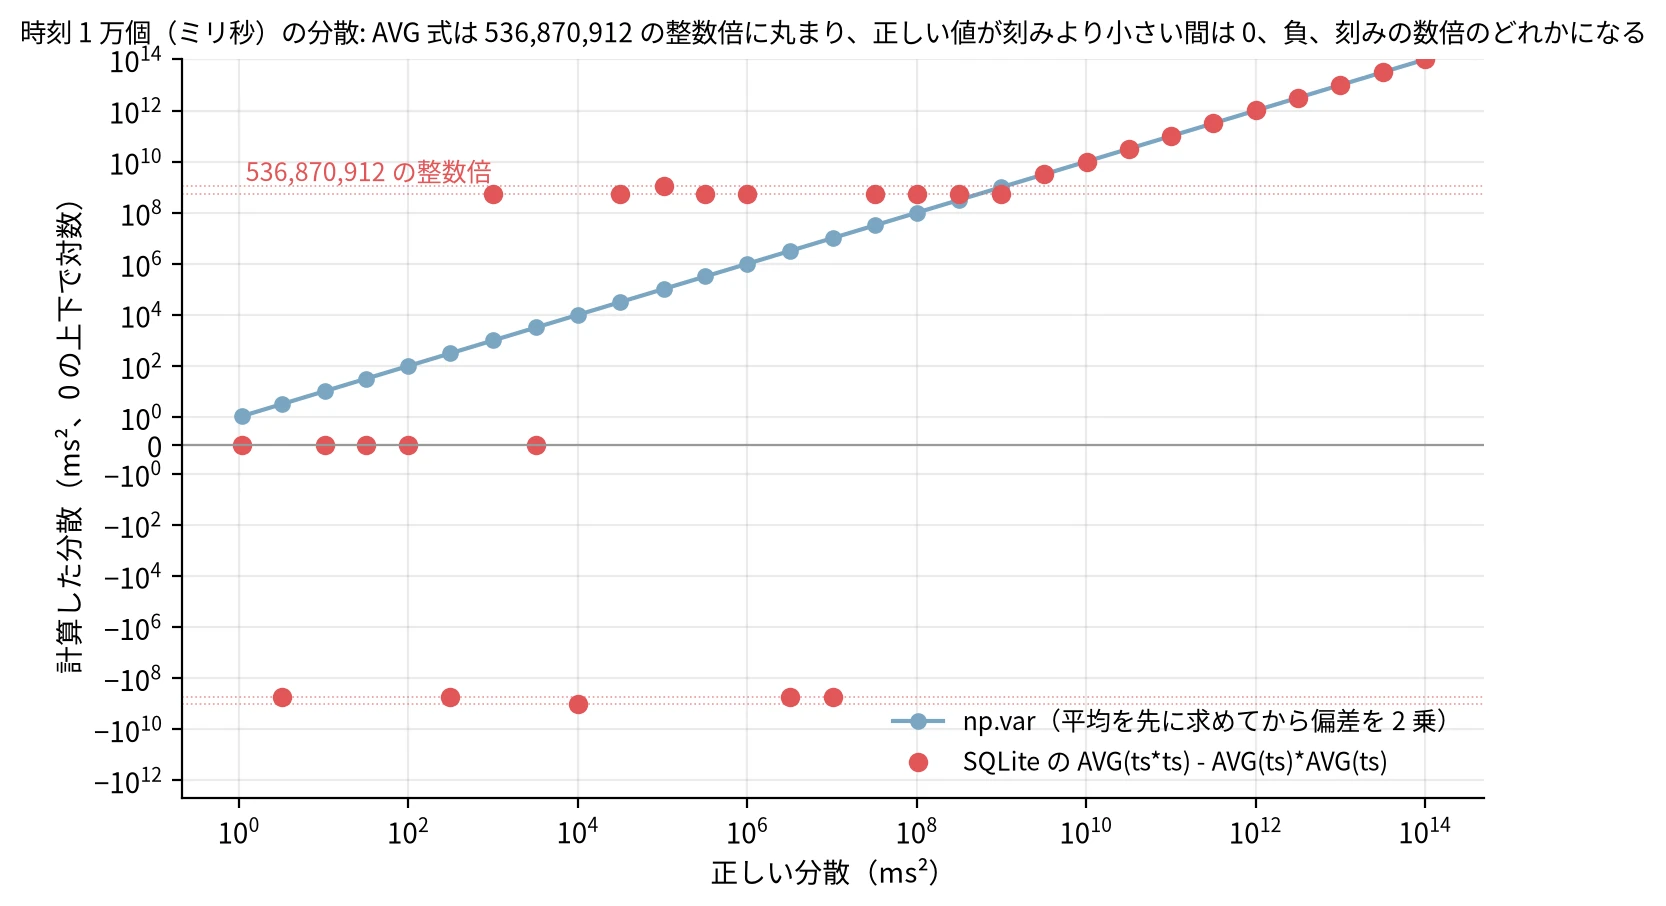
np.var と SQLite の AVG 式で計算した、時刻 1 万個(ミリ秒)の分散。縦軸は 0 の上下をそれぞれ対数で取る
NumPy の np.var は全ての点で正しい値を返しました。AVG 式の結果は、この時刻の大きさでは常に 536,870,912 の整数倍です。正しい分散がこの刻みより小さい間は、0 か刻みを数倍した値になります。
0 や負の値が出たのは、標準偏差が 3 秒ほど、正しい分散が 10 の 7 乗までの回でした。それより散らばりが大きい回は正の値ですが、刻みの倍数に丸まっていて、標準偏差が 100 秒ほどになるまで刻みの粗さが目立ちます。SQLite はエラーや警告を出しません。
アクセスログに残る時刻、センサーの値、金額のように、0 から遠い所で小さく揺れる値は珍しくありません。値を 1 件ずつ受け取りながら分散を出す処理を自分で書く時や、ダッシュボードの集計を SQL で組む時に、AVG 式は自然に出てきます。
本記事では、ML の式に出てくる分散を自分で計算したい人と、SQL や手書きの集計で分散を出す人に向けて、次の疑問に答えます。
- 分散は、値のばらつきをどう数にしたものか。
- AVG 式は、なぜ 0 や負の値を返すことがあるのか。
- 平均の近くへずらすと、なぜ正しく計算できるのか。
- 1 件ずつ届く値では、分散をどう更新すればよいか。
- 日ごとの分散から、月の分散をどう求めるか。
- 値を平均すると、分散はどれだけ小さくなるか。
実験は Python 3.12、SQLite 3.50.4、NumPy 2.5.4、scikit-learn 1.9.1 で行いました。図を描く処理も含めた完全なコードは variance_gen.py にあります。
偏差の 2 乗の平均
5 回の応答時間 120・80・100・140・60 ms を例に取ります。平均は 100 ms で、偏差は +20・-20・0・+40・-40 です。偏差をそのまま平均すると、正と負が打ち消し合って必ず 0 になるので、2 乗して符号を消してから平均します。
ms = np.array([120, 80, 100, 140, 60])  # 5 回の応答時間(ms)
dev = ms - ms.mean()
print("平均:", ms.mean())
print("偏差:", dev)
print("偏差の 2 乗:", dev**2)
print("分散:", np.mean(dev**2), " np.var:", np.var(ms))
平均: 100.0
偏差: [ 20. -20.   0.  40. -40.]
偏差の 2 乗: [ 400.  400.    0. 1600. 1600.]
分散: 800.0  np.var: 800.0
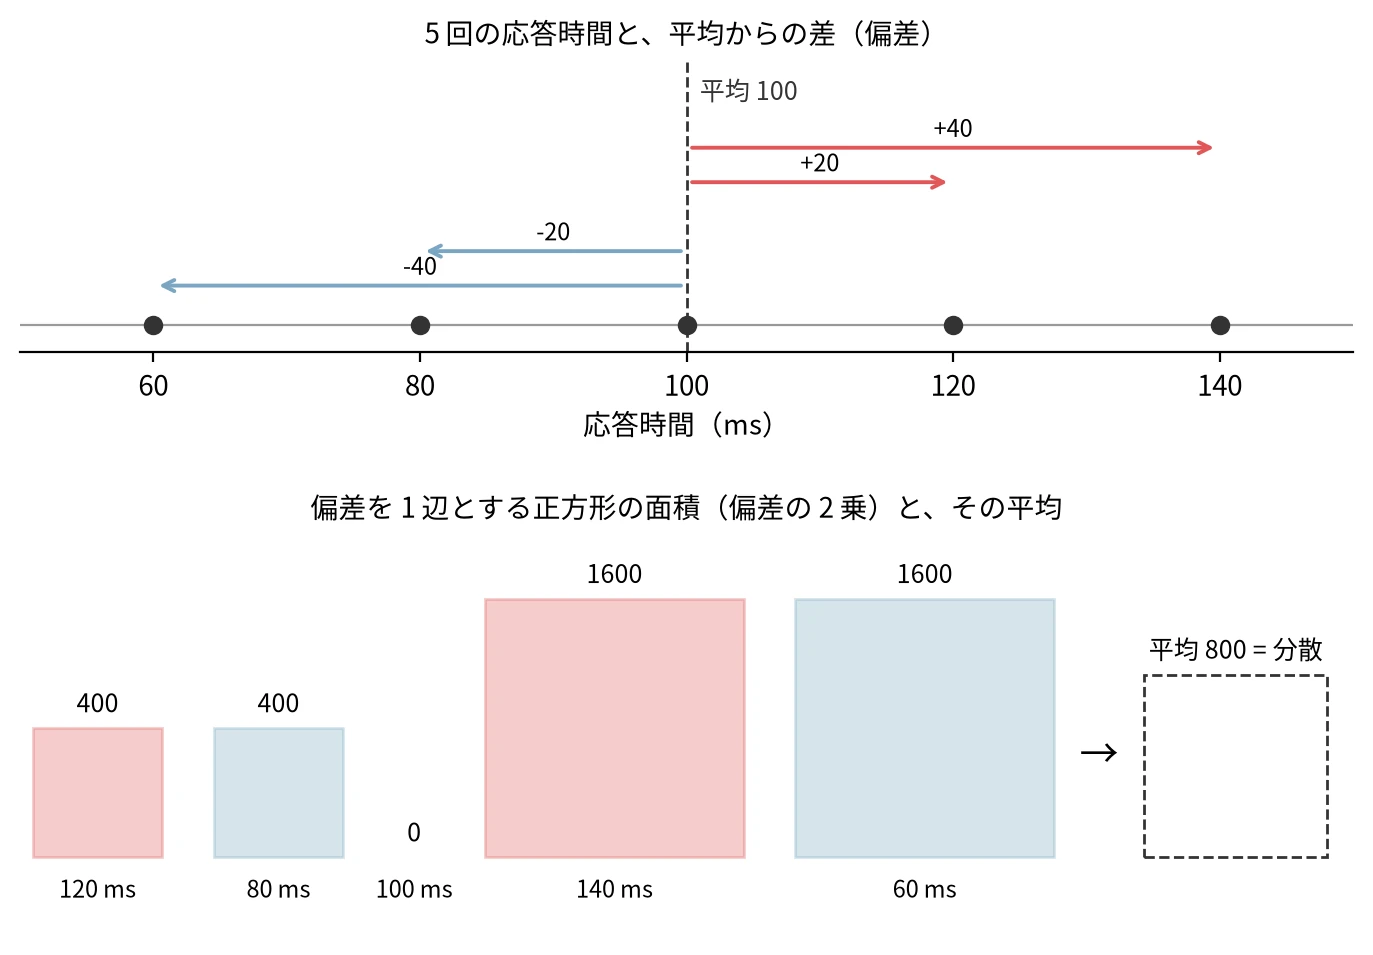
偏差を 1 辺とする正方形を並べ、面積を平均すると分散になる
偏差の 2 乗は、偏差を 1 辺とする正方形の面積と見ることができます。平均から 40 ms 離れた値は、20 ms 離れた値の 4 倍の面積を持つので、分散は平均から遠い値に強く引っ張られます。単位も 2 乗の ms² になるので、元の単位に戻したい時は平方根を取った標準偏差を使います。
絶対値の平均でも符号は消せますが、絶対値は 0 で微分できず、式の変形が面倒になります。2 乗には計算の上で都合の良い性質があります。偏差の 2 乗の合計は、平均の位置で最も小さくなります。線形回帰は残差の 2 乗の合計を小さくし、PCA は射影した後の分散を大きくするので、どちらも 2 乗の合計を使っています。後の節で使う、足した値の分散を各分散に分ける性質も、絶対値には成り立ちません。
その代わり、分散は外れ値の影響を強く受けます。平均からの差の絶対値を平均した平均絶対偏差(mean absolute deviation)や、四分位範囲は外れ値に強い一方で、足し算や後の節で扱う分解が使えません。外れ値が多いデータでは、分散だけで散らばりを判断しないようにします。
上記のコードでは個数の 5 で割りましたが、手元の値から元の集団が持つ分散を推定する時は n - 1 で割ります。件数が多ければ 2 つの割り方の差は小さいので、本記事では n で割る分散を使います。
n - 1 で割る標本分散と、10 万回の試行で比べた結果
分散 1 の正規分布から 5 個を引く試行を 10 万回繰り返し、2 つの割り方の平均を比べました。
rng = np.random.default_rng(0)
samples = rng.normal(0.0, 1.0, (100_000, 5))   # 分散 1 の正規分布から 5 個を引く試行を 10 万回
print(f"n で割った分散の平均    : {samples.var(axis=1, ddof=0).mean():.4f}")
print(f"n - 1 で割った分散の平均: {samples.var(axis=1, ddof=1).mean():.4f}")
n で割った分散の平均    : 0.8024
n - 1 で割った分散の平均: 1.0030
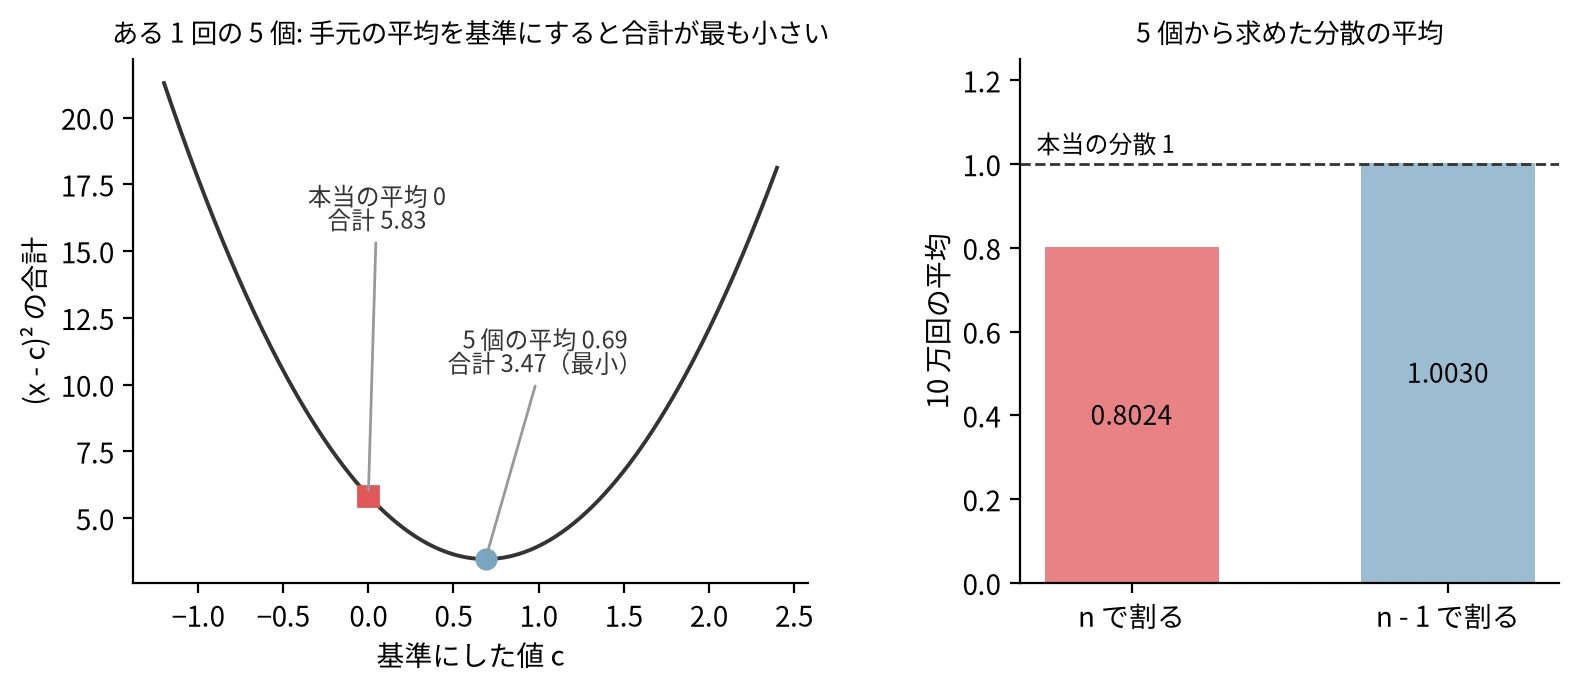
手元の平均から測ると合計が小さく出るので、n で割ると分散を小さく見積もる
上記のとおり、偏差の 2 乗の合計は平均の位置で最も小さくなります。手元にある値の平均は、元の集団が持つ本当の平均から少しずれます。そのため、手元の平均から測った合計は、本当の平均から測った合計以下になります。等しくなるのは 2 つの平均が一致した時だけなので、n で割ると分散を小さく見積もります。その見積もりを平均すると、本当の分散に比べて (n - 1) / n 倍になることが知られていて、n - 1 で割ると、このずれが消えます。平均すると本当の値に一致するこの性質は、不偏性と呼ばれます。
n で割った方は (5 - 1) / 5 = 0.8 のとおり小さく、n - 1 で割った方は 1 に戻りました。図の左に描いた 1 回では、本当の平均 0 から測ると合計は 5.83 ですが、手元の平均 0.69 から測ると 3.47 に減ります。
元の集団が持つ分散を母分散と呼び、手元の値から母分散を推定するために n - 1 で割った値を標本分散と呼びます。式は s² = Σ(x - x̄)² / (n - 1) で、x̄ は手元にある値の平均です。
NumPy の np.var は n、pandas の Series.var は n - 1 で割るのが既定で、少ない件数では値が合いません。標準偏差で同じ違いがどれだけ出るかは、標準偏差のノートで扱っています。
AVG 式が負になる仕組み
冒頭で -1,073,741,824 が出た、標準偏差 100 ms の 1 回分を詳しく見ます。時刻はミリ秒の整数で、INTEGER の列に入れています。正しい値は、Python 標準ライブラリの statistics.pvariance で求めました。整数を分数のまま計算し、最後に 1 回だけ float に直す実装なので、float64 で表せる最も近い値が返ります。
t0 = 1_794_441_600_000                      # 2026-11-12 00:00:00 UTC の Unix 時間(ミリ秒)
rng = np.random.default_rng(0)
ts = np.round(t0 + rng.normal(0, 100, 10_000)).astype(np.int64)  # 標準偏差 100 ms の 1 万個の時刻

con = sqlite3.connect(":memory:")
con.execute("CREATE TABLE ev (ts INTEGER)")
con.executemany("INSERT INTO ev VALUES (?)", [(int(v),) for v in ts])
naive = con.execute("SELECT AVG(ts * ts) - AVG(ts) * AVG(ts) FROM ev").fetchone()[0]
exact = statistics.pvariance(ts.tolist())   # 整数を分数のまま計算し、最後に 1 回だけ float に直す
print(f"statistics.pvariance(正確な値): {float(exact):,.2f}")
print(f"np.var                         : {np.var(ts):,.2f}")
print(f"AVG(ts*ts) - AVG(ts)*AVG(ts)    : {naive:,.2f}")
statistics.pvariance(正確な値): 9,961.78
np.var                         : 9,961.78
AVG(ts*ts) - AVG(ts)*AVG(ts)    : -1,073,741,824.00
ts * ts は約 3.2 × 10^24 で、SQLite で扱える整数の上限、約 9.2 × 10^18 を超えるので、SQLite はこの積を浮動小数点数で計算します。SQLite の浮動小数点数は、NumPy の float64 と同じ 64 ビットの形式です。AVG 式の 2 つの項と、その差を出しました。
a, b = con.execute("SELECT AVG(ts * ts), AVG(ts) * AVG(ts) FROM ev").fetchone()
print(f"AVG(ts*ts)       = {a:.17e}")
print(f"AVG(ts)*AVG(ts)  = {b:.17e}")
print(f"差               = {a - b:,.0f}")
print(f"この大きさで float64 が表せる数の間隔: {np.spacing(a):,.0f}")
AVG(ts*ts)       = 3.22002065581281612e+24
AVG(ts)*AVG(ts)  = 3.22002065581281719e+24
差               = -1,073,741,824
この大きさで float64 が表せる数の間隔: 536,870,912
float64 は有効数字が 2 進数で 53 桁、10 進数で約 16 桁しか無く、値が大きくなるほど、表せる数の間隔が広がります。3.2 × 10^24 付近では、float64 で表せる数が 536,870,912 おきにしかありません。np.spacing は、この間隔を返す関数です。間隔が広がると float32 の合計がある所から増えなくなる様子は、平均のノートで扱っています。
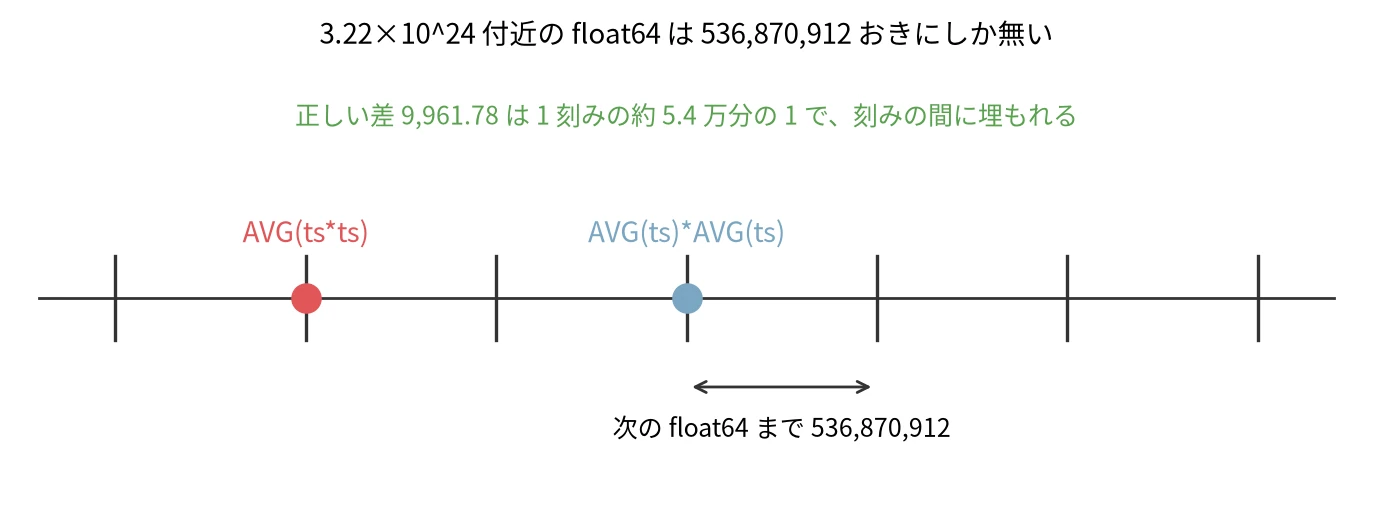
3.22 × 10^24 付近で float64 が表せる数の刻みと、AVG 式の 2 つの項
2 つの項は、どちらも刻みのどこかに丸められます。本当の差 9,961.78 は 1 刻みの約 5.4 万分の 1 しか無いので、丸めた後の差は 0 か、刻みの整数倍にしかなりません。今回は、平均の 2 乗が約 1.6 刻み大きい側に、2 乗の平均が 1 万回の足し算と割り算を経て約 0.4 刻み小さい側にずれ、差は 2 刻み分の -1,073,741,824 になりました。冒頭の図で赤い点が乗っていた段は、この刻みの整数倍です。
平均の近くへずらしてから計算する
全ての値から同じ定数 c を引いても、平均も同じだけずれるので、偏差は変わりません。そのため Var(X - c) = Var(X) が成り立ちます。値を a 倍すると偏差も a 倍になり、分散は a² 倍になります。2 つをまとめると、Var(aX + b) = a² Var(X) です。標準偏差を 3 倍にすると、分散は 9 倍になります。
AVG 式が壊れたのは、2 つの項が分散に比べて大きすぎたからでした。値を平均の近くへずらせば、2 つの項が小さくなり、丸めの誤差も小さくなります。同じ 1 万個から、平均との距離を変えながら定数を引き、AVG 式の相対誤差を測りました。
x = ts.astype(np.float64)
mu = np.mean(x)
dists = 10.0 ** np.arange(0, 12.6, 0.5)
errs = []
for d in dists:
    y = x - (mu - d)                     # 平均から d だけ離れた値 c = mu - d を引く
    v = np.mean(y * y) - np.mean(y) ** 2
    errs.append(abs(v - float(exact)) / float(exact))
y = x - x[0]                             # 最初の値を引く
first = np.mean(y * y) - np.mean(y) ** 2
print(f"最初の値 {int(ts[0]):,} を引いてから AVG 式: {first:,.2f}(平均との距離 {abs(mu - x[0]):.1f} ms)")
for d, e in zip(dists, errs):
    if d in (1, 1e4, 1e6, 1e8, 1e10):
        print(f"ずらした後の平均 {d:>18,.0f} ms  相対誤差 {e:.1e}")
最初の値 1,794,441,600,013 を引いてから AVG 式: 9,961.78(平均との距離 12.4 ms)
ずらした後の平均                  1 ms  相対誤差 0.0e+00
ずらした後の平均             10,000 ms  相対誤差 1.1e-12
ずらした後の平均          1,000,000 ms  相対誤差 1.9e-08
ずらした後の平均        100,000,000 ms  相対誤差 2.2e-05
ずらした後の平均     10,000,000,000 ms  相対誤差 2.6e+00
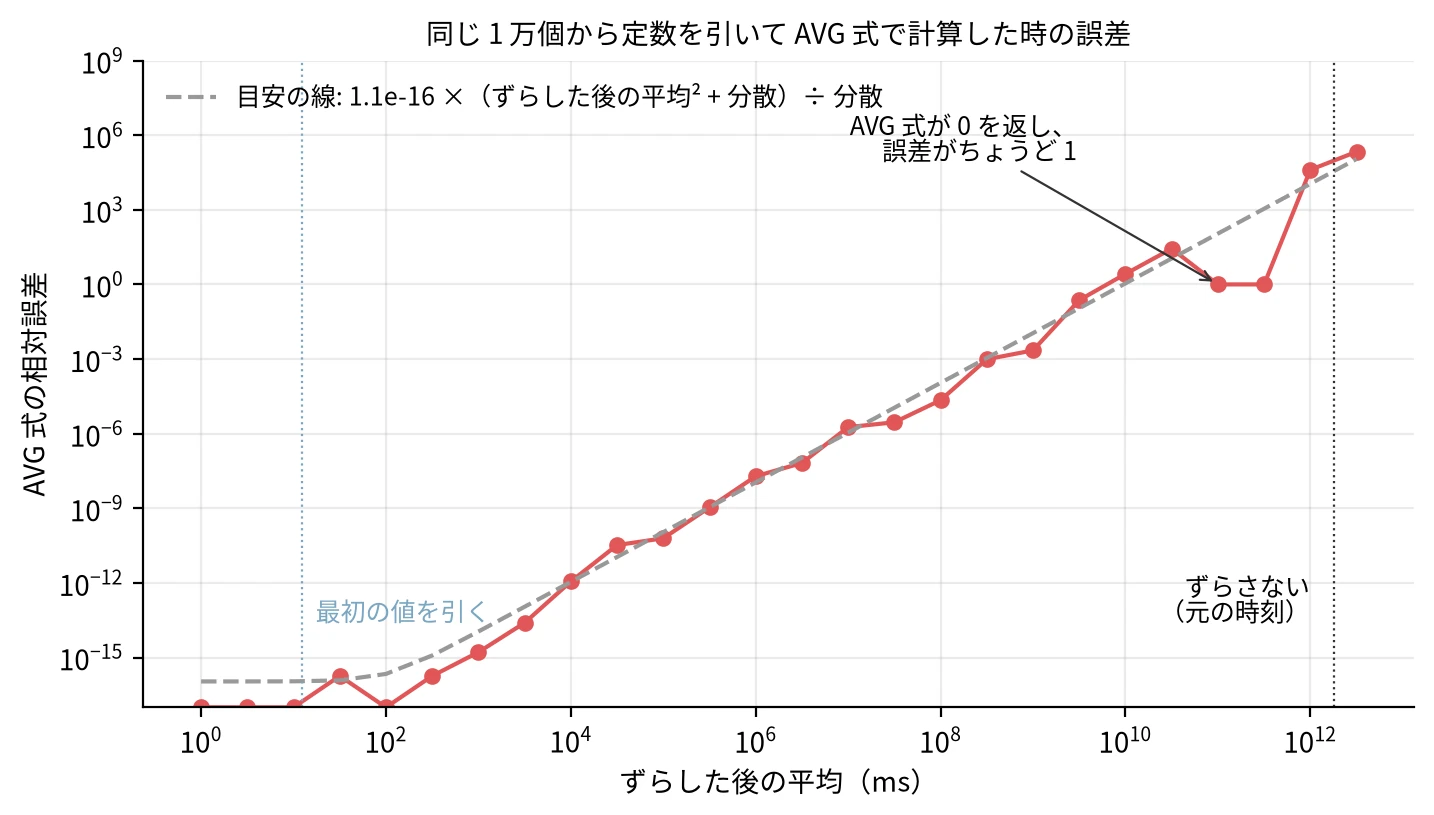
定数を引いてから AVG 式で計算した時の相対誤差
相対誤差は、目安の破線に沿って見ると、ずらした後の平均が 100 倍になるごとに約 1 万倍になります。実測の点は約 1,200 倍から 12 万倍とばらつきます。
破線の目安の線と、誤差がちょうど 1 の 2 点
float64 は 1 回の丸めで、値の約 1.1 × 10^-16 倍(2 の -53 乗)までずれます。2 乗の平均は「ずらした後の平均² + 分散」に等しいので、破線はこれを分散で割り、1.1 × 10^-16 を掛けた目安の線です。10 の 11 乗 ms 付近で誤差がちょうど 1 に落ちた 2 点は、AVG 式が 0 を返した所で、正しく計算できたわけではありません。
元の時刻は標準偏差が約 100 ms なので、ずらした後の平均 10 の 8 乗 ms は、平均が標準偏差の 100 万倍ある状態です。以下、この倍率を平均と標準偏差の比と呼びます。最初の値を引いた場合は、その値が平均から 12.4 ms しか離れていなかったので、AVG 式でも正しい 9,961.78 が出ました。最初の値が平均から標準偏差の数倍以内にあれば、比は数倍に収まるので同じように効きます。
np.var が正しかったのも同じ理由です。文書にあるとおり、np.var は先に平均を求め、各値から平均を引いてから 2 乗します。データを 2 回読みますが、大きな 2 つの項の引き算が起きません。
SQL でも、データの範囲に近い定数を先に引けば、同じ効果があります。冒頭で作った SQLite の表から、時刻が始まる 2026-11-12 00:00:00 を引いて、AVG 式で計算しました。
shifted = con.execute(
    "SELECT AVG((ts - 1794441600000) * (ts - 1794441600000))"
    " - AVG(ts - 1794441600000) * AVG(ts - 1794441600000) FROM ev").fetchone()[0]
print(f"SQLite で 1794441600000 を引いてから AVG 式: {shifted:,.2f}")
SQLite で 1794441600000 を引いてから AVG 式: 9,961.78
引いた後の値は数百 ms ほどなので、丸めの刻みが分散よりずっと細かくなります。
1 件ずつ届く値の分散
値が 1 件ずつ届き、2 回読むことができない場面もあります。件数と合計と 2 乗の合計だけを持てば、いつでも AVG 式で分散を出せますが、合計が大きくなるほど同じ丸めが起きます。
Welford 氏が 1962 年に示した方法は、件数と平均と偏差の 2 乗の合計を持ち、値が届くたびに更新します。最初の節で使った応答時間で、120・80・100 ms の 3 件の後に 140 ms が届いた 1 回分をたどります。
vals = [120.0, 80.0, 100.0]
old_mean = np.mean(vals)                                    # 100
old_m2 = float(np.sum((np.array(vals) - old_mean) ** 2))    # 800
v = 140.0
delta = v - old_mean                 # 更新前の平均から測った差
new_mean = old_mean + delta / 4
after = v - new_mean                 # 更新後の平均から測った差
new_m2 = old_m2 + delta * after
check = float(np.sum((np.array(vals + [v]) - new_mean) ** 2))
print(f"140 が届く: 更新前の平均から測った差 {delta:.0f}、更新後の平均 {new_mean:.0f}、更新後の平均から測った差 {after:.0f}")
print(f"足す量 {delta:.0f} × {after:.0f} = {delta * after:.0f}、更新後の合計 {new_m2:.0f}(4 個から直接計算すると {check:.0f})")
140 が届く: 更新前の平均から測った差 40、更新後の平均 110、更新後の平均から測った差 30
足す量 40 × 30 = 1200、更新後の合計 2000(4 個から直接計算すると 2000)
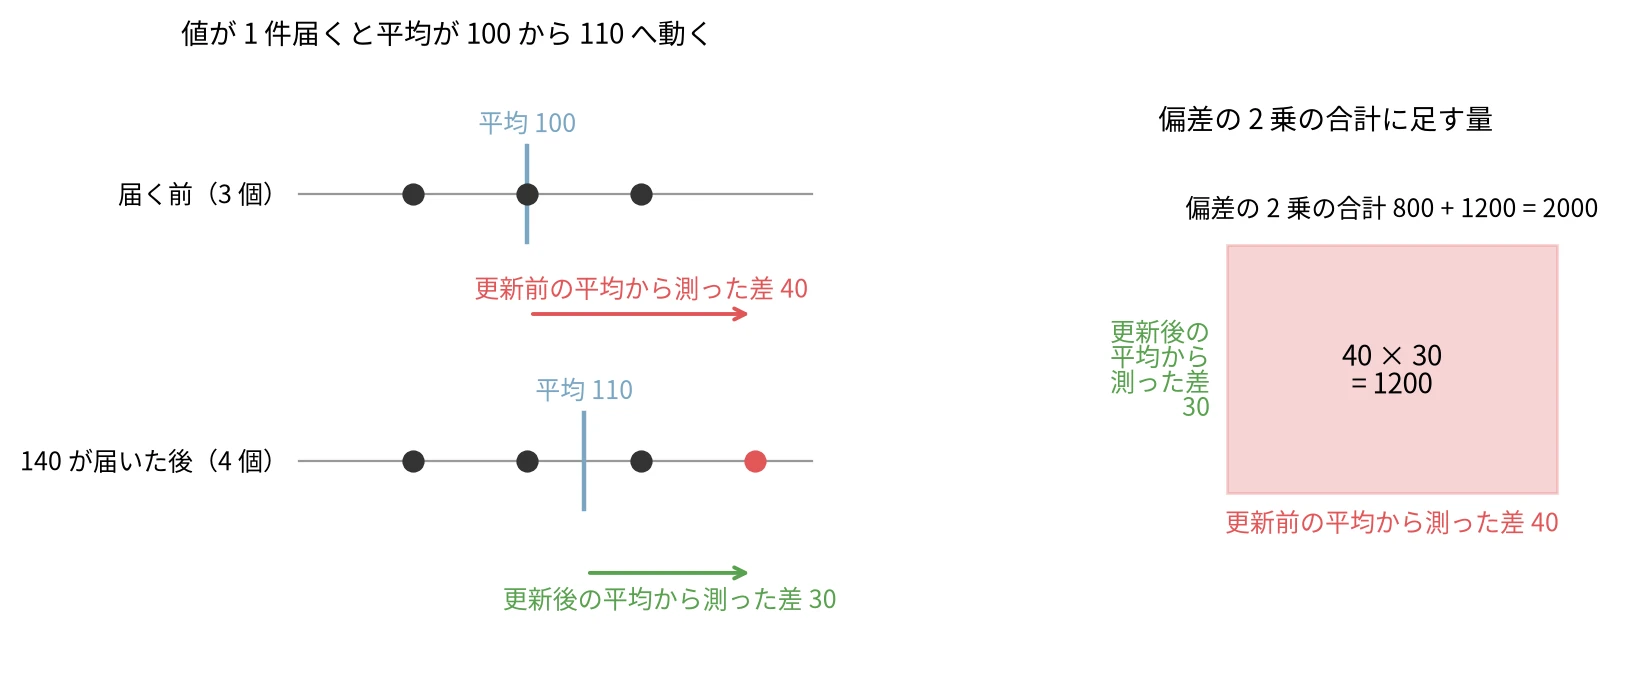
Welford の更新 1 回分: 2 つの差を掛けた長方形を足す
140 が届くと、平均は 100 から 110 へ動きます。平均が動くと、届いていた 120・80・100 の偏差も変わるので、140 の偏差を 2 乗して足すだけでは合計が合いません。更新前の平均から測った差 40 を 2 乗した 1600 では多すぎ、更新後の平均から測った差 30 を 2 乗した 900 では少なすぎます。2 つの差を掛けた 1200 は、既にある値で偏差が変わった分まで含めた増分にちょうど等しく、4 個から直接計算した 2000 と一致します。
冒頭の時刻を 1 件ずつ流し、合計と 2 乗の合計から出す方法と Welford 氏の方法で、届くたびに分散を求めました。
n = s = ss = 0                           # 件数・合計・2 乗の合計だけを持つ
naive_run = []
for v in ts.tolist():
    n += 1
    s += float(v)
    ss += float(v) * float(v)
    naive_run.append(ss / n - (s / n) ** 2)

n, mean, m2 = 0, 0.0, 0.0                # Welford: 件数・平均・偏差の 2 乗の合計
welford_run = []
for v in ts.tolist():
    n += 1
    delta = v - mean
    mean += delta / n
    m2 += delta * (v - mean)
    welford_run.append(m2 / n)
print(f"1 万件後  合計と 2 乗の合計: {naive_run[-1]:,.2f}  Welford: {welford_run[-1]:,.2f}"
      f"  正確な値: {float(exact):,.2f}")
neg = sum(1 for v in naive_run if v < 0)
zero = sum(1 for v in naive_run if v == 0)
print(f"合計と 2 乗の合計の途中の値: 負 {neg} 回、0 {zero} 回 / 10,000 回")
1 万件後  合計と 2 乗の合計: -13,958,643,712.00  Welford: 9,961.80  正確な値: 9,961.78
合計と 2 乗の合計の途中の値: 負 5029 回、0 473 回 / 10,000 回
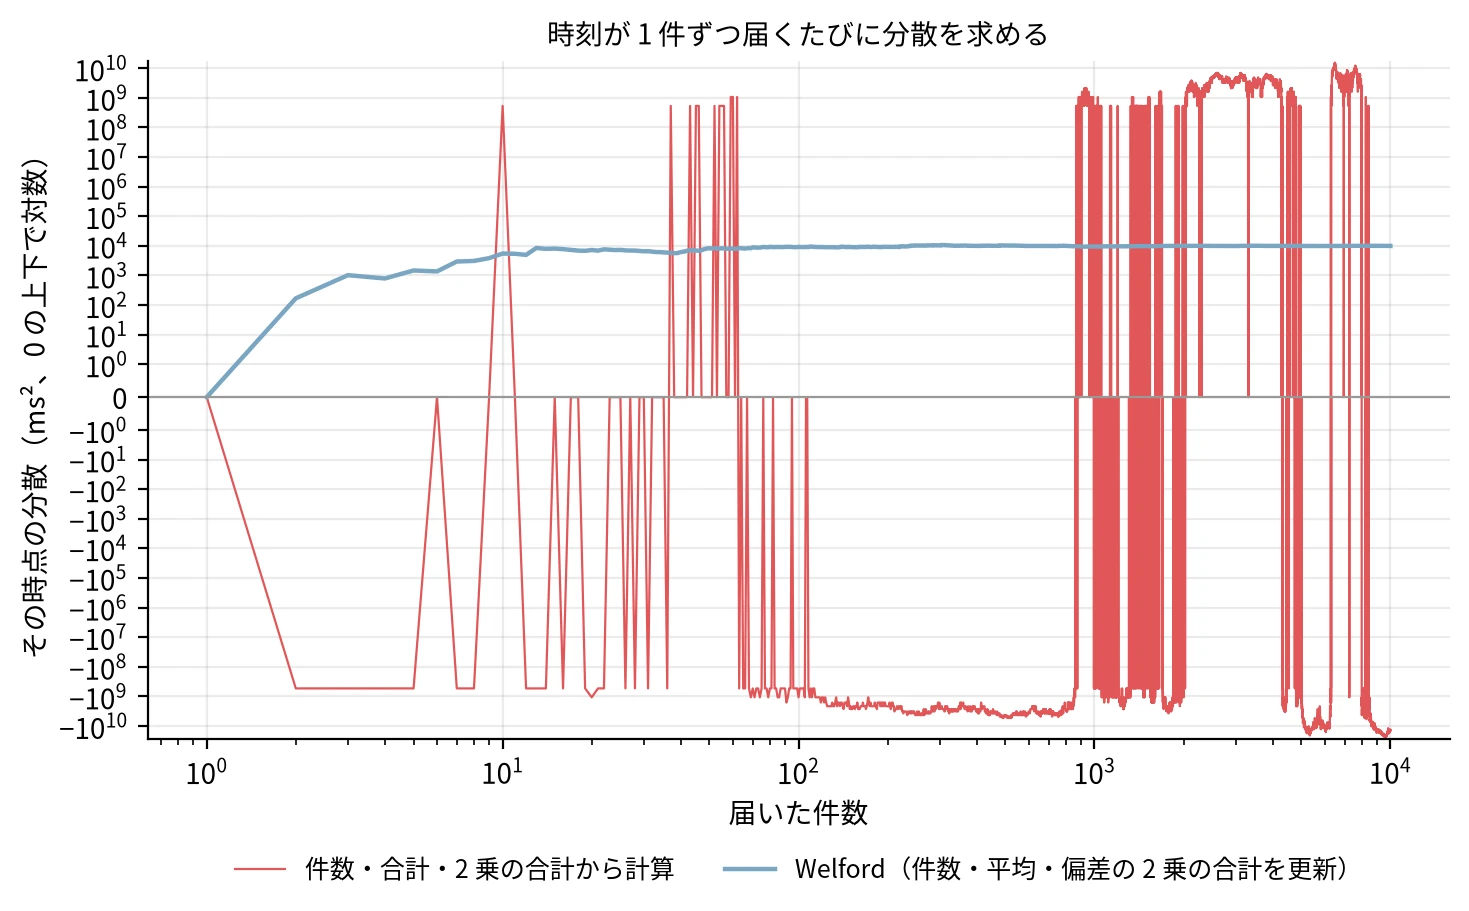
時刻が 1 件ずつ届くたびに求めた分散
合計と 2 乗の合計から出した分散は、1 万回のうち 5029 回が負、473 回が 0 で、最後は -13,958,643,712 でした。
Welford 氏の方法は、数件を過ぎると約 1 万で落ち着き、1 万件後は 9,961.80 でした。正確な値との差 0.02 は、1.8 × 10^12 ほどの平均を float64 で少しずつ更新する丸めによるものです。先に 1794441600000 を引いてから同じ更新をすると、9,961.78 になりました。
SQLite の AVG 式より誤差が大きい理由
上のループは、約 3.2 × 10^28 まで膨らんだ 2 乗の合計に値を素直に足すので、足すたびの丸めが 1 万回積み重なります。SQLite は 3.43.0 から、sum() と avg() の中で丸めの誤差を別の変数に持って補う Kahan-Babuska-Neumaier の加算を使っています。Python の math.fsum で誤差を補いながら足すと、SQLite と同じ値になりました。
fs = math.fsum(float(v) for v in ts.tolist()) / len(ts)
fss = math.fsum(float(v) * float(v) for v in ts.tolist()) / len(ts)
print(f"math.fsum で足した合計と 2 乗の合計から: {fss - fs * fs:,.0f}")
math.fsum で足した合計と 2 乗の合計から: -1,073,741,824
誤差を補っても、2 つの項の引き算で起きる -1,073,741,824 は残ります。
実際のソフトウェアでも、この問題を受けて計算の方法を変えた例があります。PostgreSQL は、浮動小数点数の variance() などの集約関数で 2 乗の合計から引く方法を使っていましたが、2018 年のコミットで、Youngs 氏と Cramer 氏の方法に替えました。Welford 氏の方法と同じく、偏差の 2 乗の合計を 1 回の走査で積み上げる方法です。コミットのメッセージには、2 つの項の差がそれぞれの項に比べて小さいと、精度が大きく失われると書かれています。この変更は PostgreSQL 12 のリリースノートに載っています。
scikit-learn の StandardScaler は、partial_fit でデータを分けて渡すと、件数・平均・分散を持ち、届いた分と合わせて更新します。冒頭の時刻を 1,000 件ずつ 10 回に分けて渡しました。
sc = StandardScaler()
for chunk in np.array_split(ts.astype(np.float64).reshape(-1, 1), 10):   # 1,000 件ずつ 10 回
    sc.partial_fit(chunk)
print(f"StandardScaler.partial_fit の分散: {sc.var_[0]:,.2f}")
StandardScaler.partial_fit の分散: 9,961.78
列の分散を自分で計算する時も、件数と平均と偏差の 2 乗の合計を持つ形にしておけば、今回の時刻では、AVG 式が壊れる条件でも丸めの誤差は分散に比べて小さく収まりました。
StandardScaler が行う標準化は、特徴量を平均 0・分散 1 に揃える処理で、ロジスティック回帰や kNN のように特徴量の大きさに左右されるモデルの前に使います。特徴量選択で使う scikit-learn の VarianceThreshold も列の分散を使い、しきい値より小さい、ほぼ定数の列を捨てます。
日ごとの分散から月の分散を出す
集計の表に、日ごとの件数・平均・分散を残しておくことはよくあります。materialized view で日別に集計した結果を残す場合も同じです。この表から月の分散を出す時に、日ごとの分散を平均すると、正しい値になりません。
公開データで試します。Fanaee-T 氏と Gama 氏が公開した Bike Sharing Dataset は、ワシントン D.C. の Capital Bikeshare のレンタル件数に天気を付けたデータです。これを OpenML から取得し、2011 年 1 月の 1 時間ごとの気温(℃)を使いました。31 日で 688 時間分あり、欠けた時間がある日も含まれます。
df = fetch_openml(data_id=42712, as_frame=True, parser="liac-arff").frame
df["day"] = (df["hour"].diff() < 0).cumsum()          # 時刻が 0 時に戻った所で日を変える
jan = df[(df["year"] == 0) & (df["month"] == 1)]      # 2011 年 1 月
daily = jan.groupby("day")["temp"].agg(n="count", mean="mean", var=lambda t: t.var(ddof=0))
print(f"日数 {len(daily)}、時間数 {int(daily['n'].sum())}")
print(f"日ごとの分散の平均         : {daily['var'].mean():.2f}")
print(f"1 月全体の分散(正しい値) : {jan['temp'].var(ddof=0):.2f}")

N = daily["n"].sum()
M = (daily["n"] * daily["mean"]).sum() / N
within = (daily["n"] * daily["var"]).sum() / N        # 日の中のばらつき(件数で重み付け)
between = (daily["n"] * (daily["mean"] - M) ** 2).sum() / N   # 日と日の差(日の平均のばらつき)
print(f"日の中のばらつき {within:.2f} + 日と日の差 {between:.2f} = {within + between:.2f}")
日数 31、時間数 688
日ごとの分散の平均         : 3.34
1 月全体の分散(正しい値) : 10.23
日の中のばらつき 3.51 + 日と日の差 6.73 = 10.23
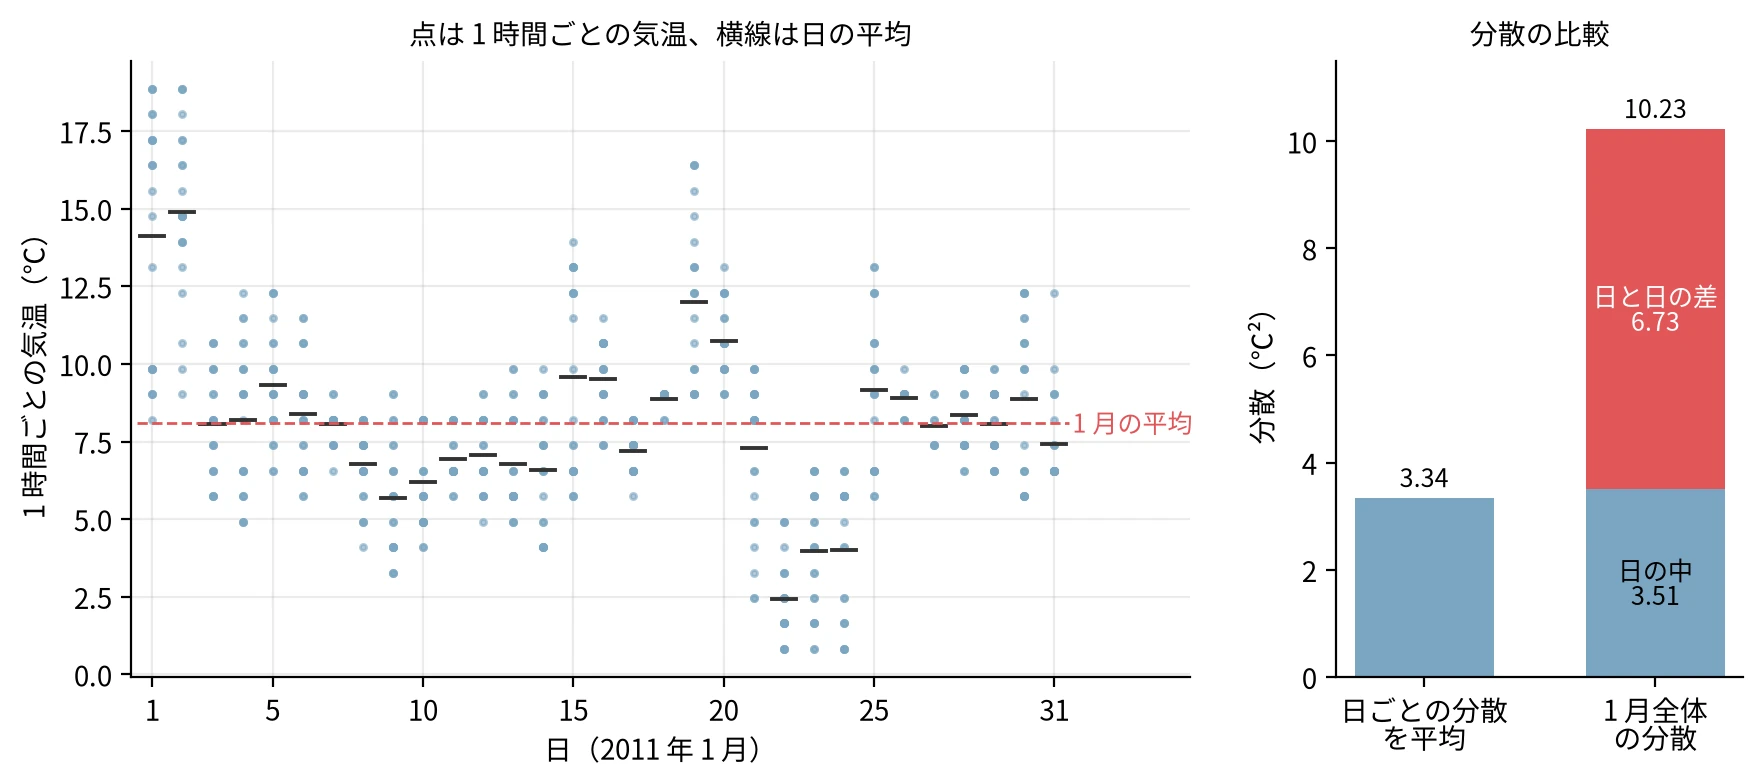
2011 年 1 月の 1 時間ごとの気温と、分散の比較
日ごとの分散を平均した値は 3.34 で、1 月全体の分散 10.23 の 3 分の 1 しかありません。日ごとの分散は、その日の平均からの偏差しか見ていないので、寒い日と暖かい日の差が入らないからです。
全体の分散は、日の中のばらつきと、日の平均が月の平均からどれだけ離れているかの 2 つに分かれます。前者は日ごとの分散を時間数で重み付けして平均した 3.51、後者は日ごとの平均から求めた分散を同じく時間数で重み付けした 6.73 で、足すと 10.23 に一致します。この分け方は、確率の言葉では全分散の法則(law of total variance)と呼ばれます。
式では Var(X) = E[Var(X | 日)] + Var(E[X | 日]) と書き、前の項が日の中のばらつき、後の項が日と日の差です。分けた結果を足すと必ず元の分散に戻り、近似ではありません。3.34 と 3.51 が違うのは、時間が欠けた日を 1 日として同じ重みで平均したかどうかの差です。
同じ分け方は ML の中にもあります。決定木の回帰では、分けた後に子ノードごとの分散を件数で重み付けして平均し、分ける前よりどれだけ小さくなるかで分け方を選びます。この減り方は平均二乗誤差(MSE)の減少と同じで、scikit-learn 1.9.1 の DecisionTreeRegressor では、既定の criterion="squared_error" がこの基準です。
分散分析(ANOVA)は、組の平均のばらつきが組の中のばらつきより十分大きいかを検定します。
2 組の集計をまとめる式
日ごとの集計を 1 日ずつ足していく時は、2 組の (件数, 平均, 偏差の 2 乗の合計) を 1 組にまとめる式を使います。Chan 氏・Golub 氏・LeVeque 氏が 1983 年の論文で示した形です。この式では、2 組の平均がどれだけ違うかを 2 乗する項が、上記の日と日の差に当たります。
def merge(a, b):
    """(件数, 平均, 偏差の 2 乗の合計) の 2 組を 1 組にまとめる。"""
    na, ma, m2a = a
    nb, mb, m2b = b
    n = na + nb
    delta = mb - ma
    return n, ma + delta * nb / n, m2a + m2b + delta**2 * na * nb / n


rows = [(r["n"], r["mean"], r["var"] * r["n"]) for _, r in daily.iterrows()]  # 分散 × 件数 = 偏差の 2 乗の合計
acc = rows[0]
for r in rows[1:]:
    acc = merge(acc, r)
print(f"日ごとの (件数, 平均, 分散) を順にまとめた分散: {acc[2] / acc[0]:.2f}")
日ごとの (件数, 平均, 分散) を順にまとめた分散: 10.23
31 日分を順にまとめると、1 月全体の 10.23 に一致しました。片方の組を 1 件にすれば、1 件ずつ届く値で使った Welford 氏の更新と同じ式になります。PostgreSQL が並列に集計した部分の結果をまとめる float8_combine や、StandardScaler の partial_fit も、この形でまとめています。集計の表から月や年の分散を出したいなら、日ごとの分散だけでなく、件数と平均も残しておく必要があります。
平均した値の分散
X と Y を足した値の分散は、Var(X + Y) = Var(X) + Var(Y) + 2 Cov(X, Y) です。Cov は 2 つが一緒に増減する度合いを表す共分散で、Cov(X, Y) = E[(X - E[X])(Y - E[Y])] です。Cov(X, X) = Var(X) なので、共分散は分散を 2 つの変数に広げたものと見ることができます。
共分散を 2 つの標準偏差で割った値が相関係数 ρ で、-1 から 1 の値を取ります。
変数が多い時は、変数の組ごとに共分散を求めて並べ、共分散行列を作ります。PCA では、この行列の固有値が、その主成分の軸に沿った分散になります。独立なら共分散は 0 で、分散はそのまま足し算になります。
分散 σ² の独立な値を n 個平均すると、和の分散は n σ²、n で割ると n² で割ることになるので、平均の分散は σ² / n です。この分散は n とともに 0 へ近づくので、平均が真の値に近づく大数の法則をここから示せます。平方根の σ / √n は標準誤差と呼ばれ、A/B テストの t 検定では、群ごとの分散から標準誤差を求め、2 群で平均を引き算した差をこれで割って t 値を出します。
値の間に相関 ρ があると、平均の分散は ρ σ² + (1 - ρ) σ² / n になり、n を増やしても ρ σ² より下がりません。分散 1 の値を n 個平均して、2 万回分の分散を測りました。
rng = np.random.default_rng(1)
ns = np.array([1, 2, 4, 8, 16, 32, 64, 128])
trials = 20_000
for rho in (0.0, 0.3):
    vs = []
    for k in ns:
        common = rng.normal(size=(trials, 1))           # 全員に共通する揺れ
        own = rng.normal(size=(trials, k))              # 1 個ずつの揺れ
        z = np.sqrt(rho) * common + np.sqrt(1 - rho) * own   # 分散 1、互いの相関 rho
        vs.append(z.mean(axis=1).var())
    print(f"相関 {rho}: " + "  ".join(f"n={k} {v:.3f}" for k, v in zip(ns, vs)))
相関 0.0: n=1 0.987  n=2 0.491  n=4 0.250  n=8 0.123  n=16 0.064  n=32 0.031  n=64 0.016  n=128 0.008
相関 0.3: n=1 0.995  n=2 0.654  n=4 0.470  n=8 0.390  n=16 0.351  n=32 0.318  n=64 0.316  n=128 0.310
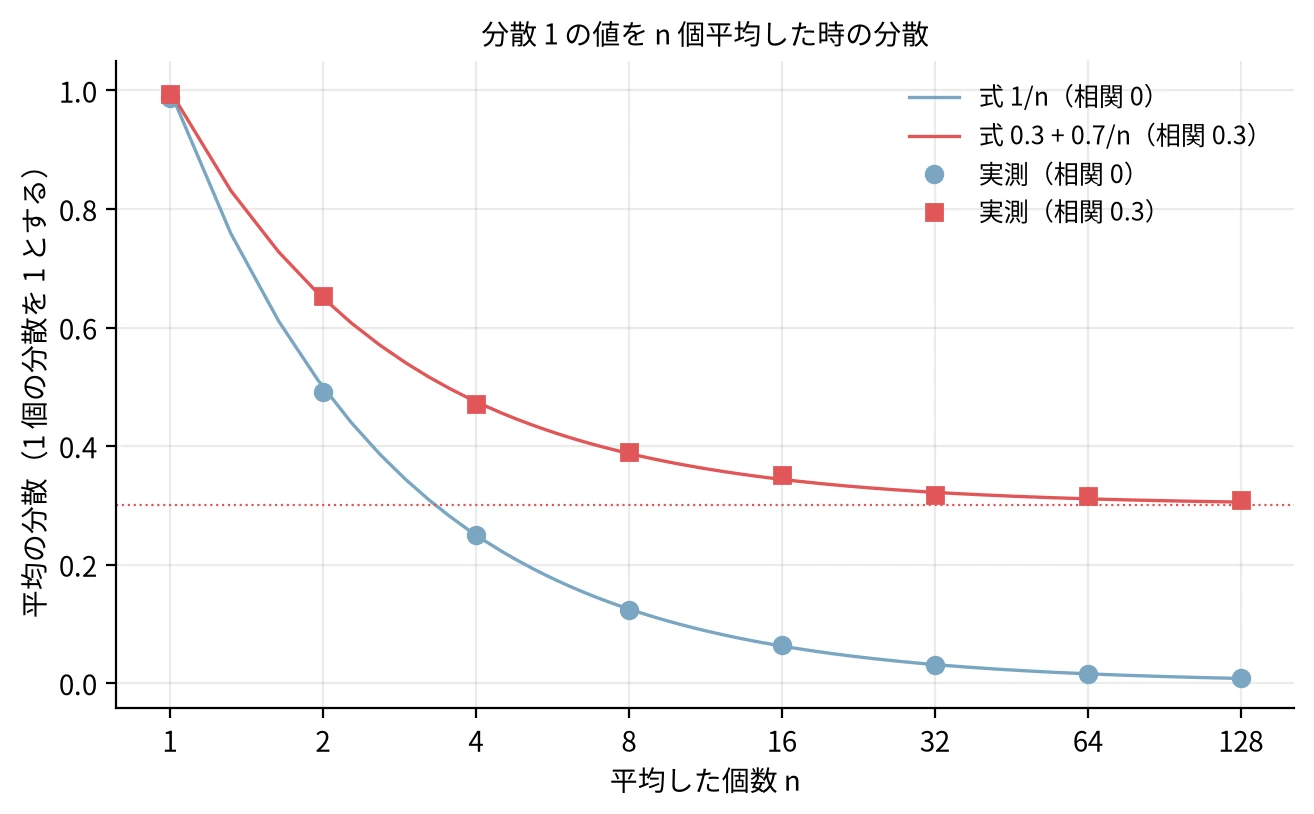
分散 1 の値を n 個平均した時の分散(実測と式)
相関 0 なら 128 個で 0.008 まで下がりますが、相関 0.3 では 128 個でも 0.310 です。複数のモデルで予測を平均するアンサンブル学習でも、各モデルが出す予測の相関が ρ で揃っていれば、モデルを増やしても予測の分散は ρ σ² より下がりません。
Breiman 氏の bagging(bootstrap aggregating)は、学習データから重複を許して取り直したデータごとにモデルを作り、予測を平均して分散を下げる方法です。ただし、元が同じ学習データなのでモデル同士は相関し、平均の分散は σ² / n までは下がらず ρ σ² が残ります。
ランダムフォレストは、同じ Breiman 氏が 2001 年の論文で示した方法で、分割ごとに、候補にする特徴量を無作為に一部だけ選び直します。選ぶ数は、scikit-learn の RandomForestClassifier では max_features で決めます。どの木も同じ強い特徴量で分けることが減るので、木同士の相関が下がり、ρ σ² そのものが小さくなります。
学習データを変えた時の予測のばらつきを分散で測る考え方は、バイアス-バリアンス分解で扱っています。そこでは二乗誤差をバイアスの 2 乗と分散の 2 つに分け、過学習を分散が大きい状態として説明します。
分散を自分で計算する前に
分散を出す時は、最初にデータの平均と標準偏差の比を見ます。ずらす実験では、比が 10 の 6 乗で相対誤差が約 2 × 10^-5、10 の 8 乗で 1 を超えました。冒頭の時刻は比が約 10 の 10 乗あり、AVG 式は使えません。Unix 時間のミリ秒、ナノ秒、大きな ID、0 から遠い所で揺れる測定値は、この形になりやすい値です。
データを 2 回読めるなら、np.var のように平均を引いてから 2 乗します。SQL なら、データの範囲に近い定数を先に引きます。1 件ずつ届く値や、分けて集計した結果をまとめる時は、件数と平均と偏差の 2 乗の合計を持ち、Welford 氏の更新と 2 組をまとめる式で足していきます。日ごとの表から月の分散を出す時に、日ごとの分散を平均してはいけません。
自分で書いた集計が正しいかは、statistics.pvariance や np.var の値と並べれば分かります。返ってきた分散が 0 や負、あるいはデータの散らばりと関係の無い刻みの倍数になっていたら、計算の方法を疑います。