歪度(skewness、わいど)は、分布の左右の非対称さを 1 つの数で表す指標です。平均が分布の中心、分散と標準偏差が広がりを表すのに対して、歪度は右に長く裾を引くと正、左に長く裾を引くと負、左右対称なら 0 になります。給与・取引金額・待ち時間のように下限はあるが上限の無い量は、右に裾を引きやすく、歪度が正になります。
右に歪んだ列は、log(1 + x) を計算する log1p 変換で裾を縮めることがよくあります。scikit-learn に同梱の California Housing は、1990 年の米国の国勢調査から作った 20640 地区のデータで、目的変数は地区ごとの住宅価格の中央値です。この価格は 10 万ドル単位で配布されていて、歪度は 0.98 でした。同じ列を 100 万ドル単位・10 万ドル単位・1 ドル単位に直してから log1p をかけたのが、次の図です。
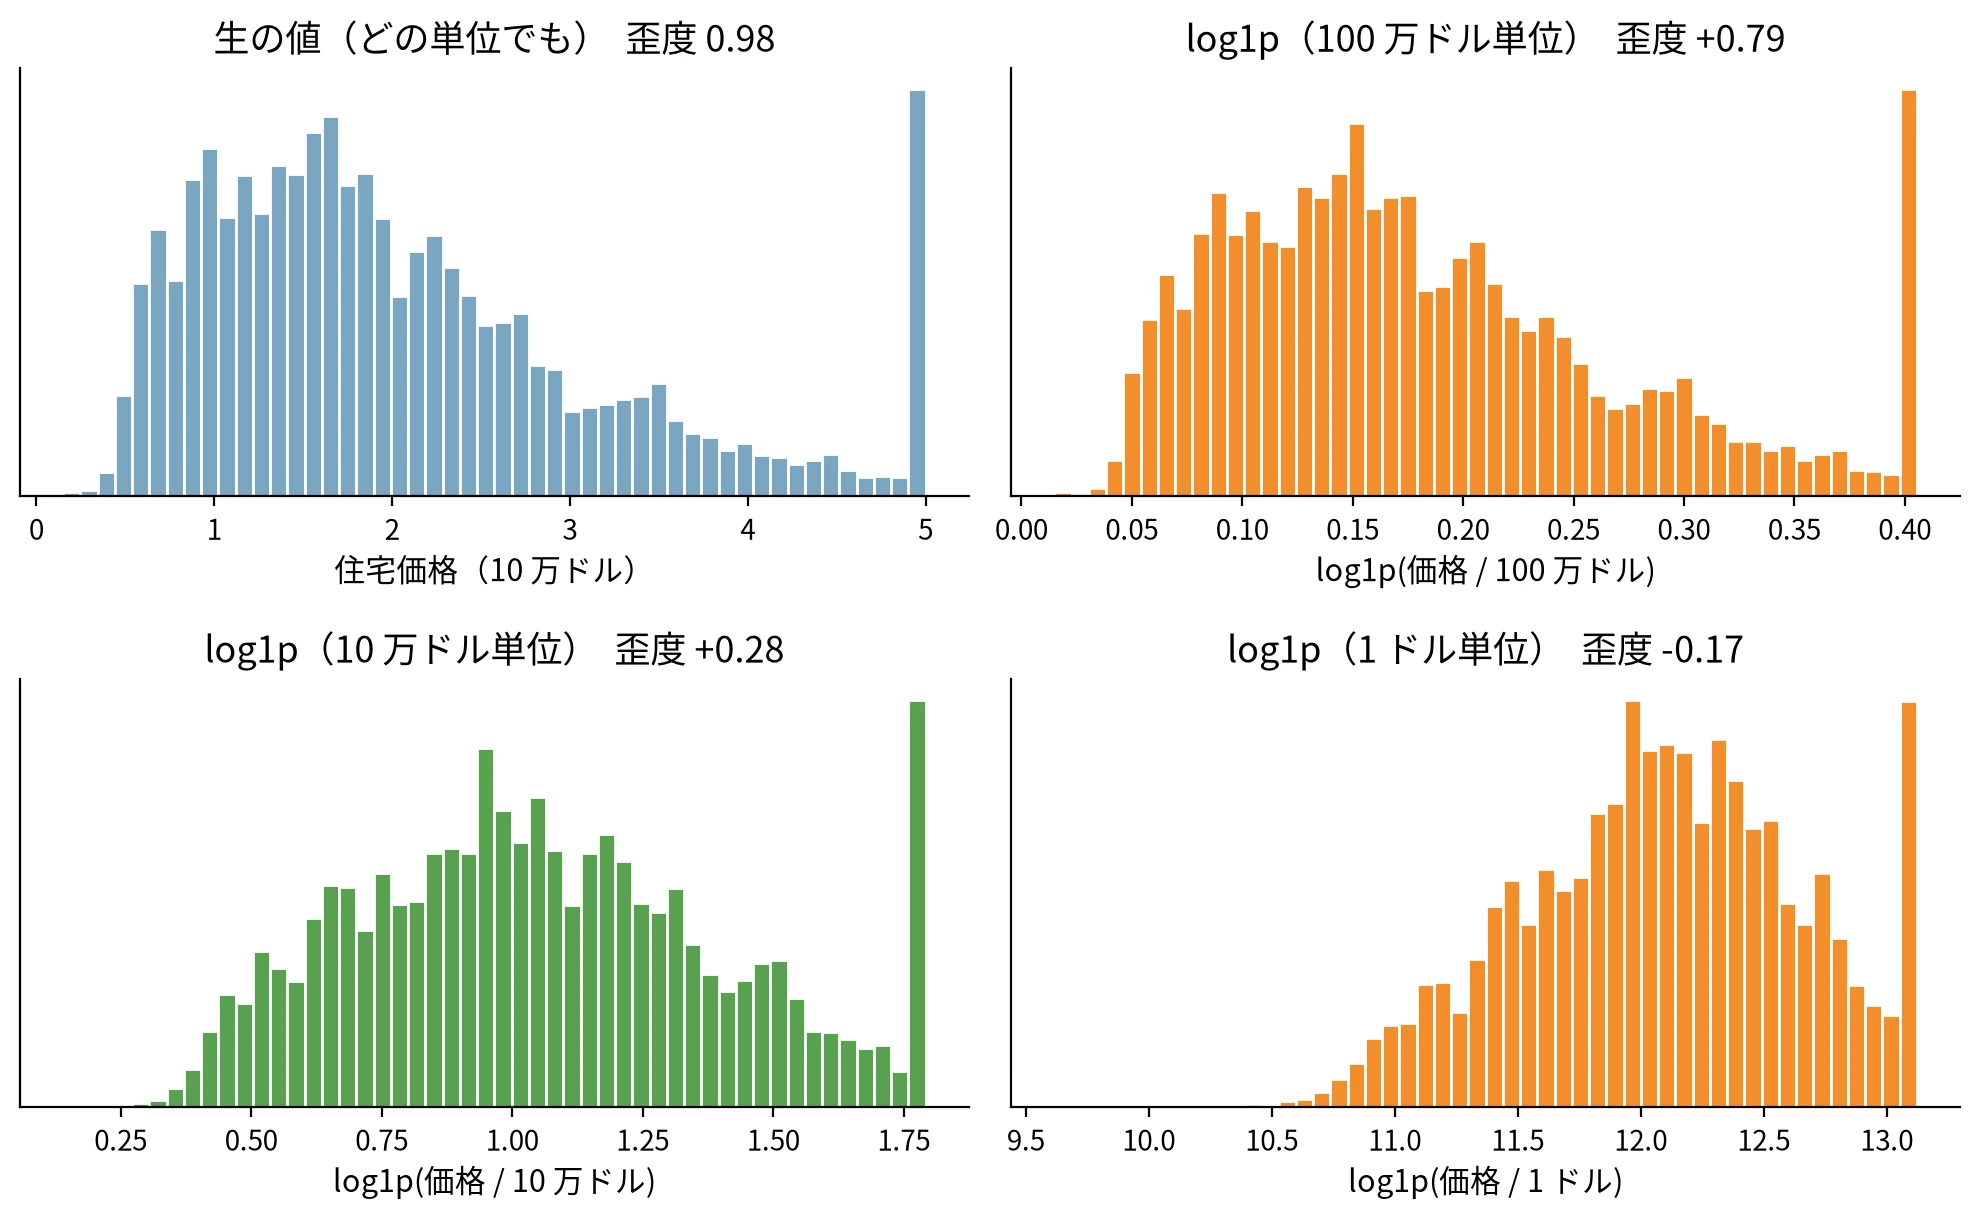
California Housing の住宅価格に、単位を変えて log1p をかけた後の分布
歪度は単位を変えても 0.98 のままです。ところが log1p をかけた後の歪度は、100 万ドル単位なら 0.79 でほとんど縮まず、1 ドル単位なら -0.17 で左に裾を引きます。変換の式も、データの並びも同じで、変わったのは単位だけです。どの図も右端に高い棒が立つのは、このデータの価格が 50 万ドル、配布時の単位で 5 を上限に打ち切られているからで、その地区は単位を変えても動きません。
価格や金額の列は、円・千円・万円、ドル・千ドルと、どの単位で保存されているかがデータごとに違います。前処理で log1p を入れて「歪度が下がったから効いた」と判断していると、同じ前処理を単位の違う別のデータに使った時に、効かなかったり反対側に歪んだりします。
本記事では、ML の説明に出てくる歪度を自分で計算してみたい人と、scikit-learn で手元の列に log1p をかける人に向けて、次の疑問に答えます。
- 歪度は何を測り、なぜ単位で変わらないのか。
- log1p の効き方は、なぜ単位で変わるのか。
- log1p の代わりの冪変換は、単位に左右されないのか。
- 計算した歪度は、何件あれば当てになるのか。
- 列ごとの歪度から、どの列を変換すればよいのか。
- 目的変数に log1p をかけると、何が変わるのか。
実験は NumPy 2.5.4、SciPy 1.18.1、scikit-learn 1.9.1、pandas 3.1.1 で行いました。図を描く処理も含めた完全なコードは skewness_gen.py にあります。
歪度の定義
代表的な定義は、平均を引いて標準偏差で割る標準化をした値の、3 乗の平均です。mu を平均、sigma を標準偏差、E[...] を括弧の中の値の平均として、次の式で表します。
skewness = E[((X - mu) / sigma)^3]
1 乗のまま平均を取ると、正と負の差が打ち消し合って必ず 0 になります。2 乗すると符号が消えて分散になり、広がりしか残りません。3 乗なら符号が残り、平均から大きく離れた値ほど強く効きます。差が 2 なら 3 乗して 8、差が -2 なら -8 です。
3 乗する前に sigma で割るので、歪度は単位を持たない数になります。価格を 10 倍しても、X - mu と sigma が両方 10 倍になって打ち消し合います。冒頭の図の左上で、どの単位でも歪度が 0.98 だったのはこのためです。
統計の関数を集めた SciPy の scipy.stats.skew で、右に長い分布・左右対称の分布・左に長い分布の歪度を計算し、平均と中央値も並べました。右に長い分布には、log を取ると正規分布になる対数正規分布を使い、左に長い分布はそれを左右反転して作りました。
import numpy as np
from scipy import stats

rng = np.random.default_rng(0)
right = rng.lognormal(0.0, 0.6, 5000)
sym = rng.normal(2.0, 0.8, 5000)
left = -rng.lognormal(0.0, 0.6, 5000) + np.exp(2)
for name, data in [("右に長い", right), ("左右対称", sym), ("左に長い", left)]:
    print(f"{name}: 歪度 {stats.skew(data):+.2f}  平均 {data.mean():.2f}  中央値 {np.median(data):.2f}")
右に長い: 歪度 +1.85  平均 1.19  中央値 0.98
左右対称: 歪度 -0.09  平均 2.01  中央値 2.02
左に長い: 歪度 -2.25  平均 6.18  中央値 6.39
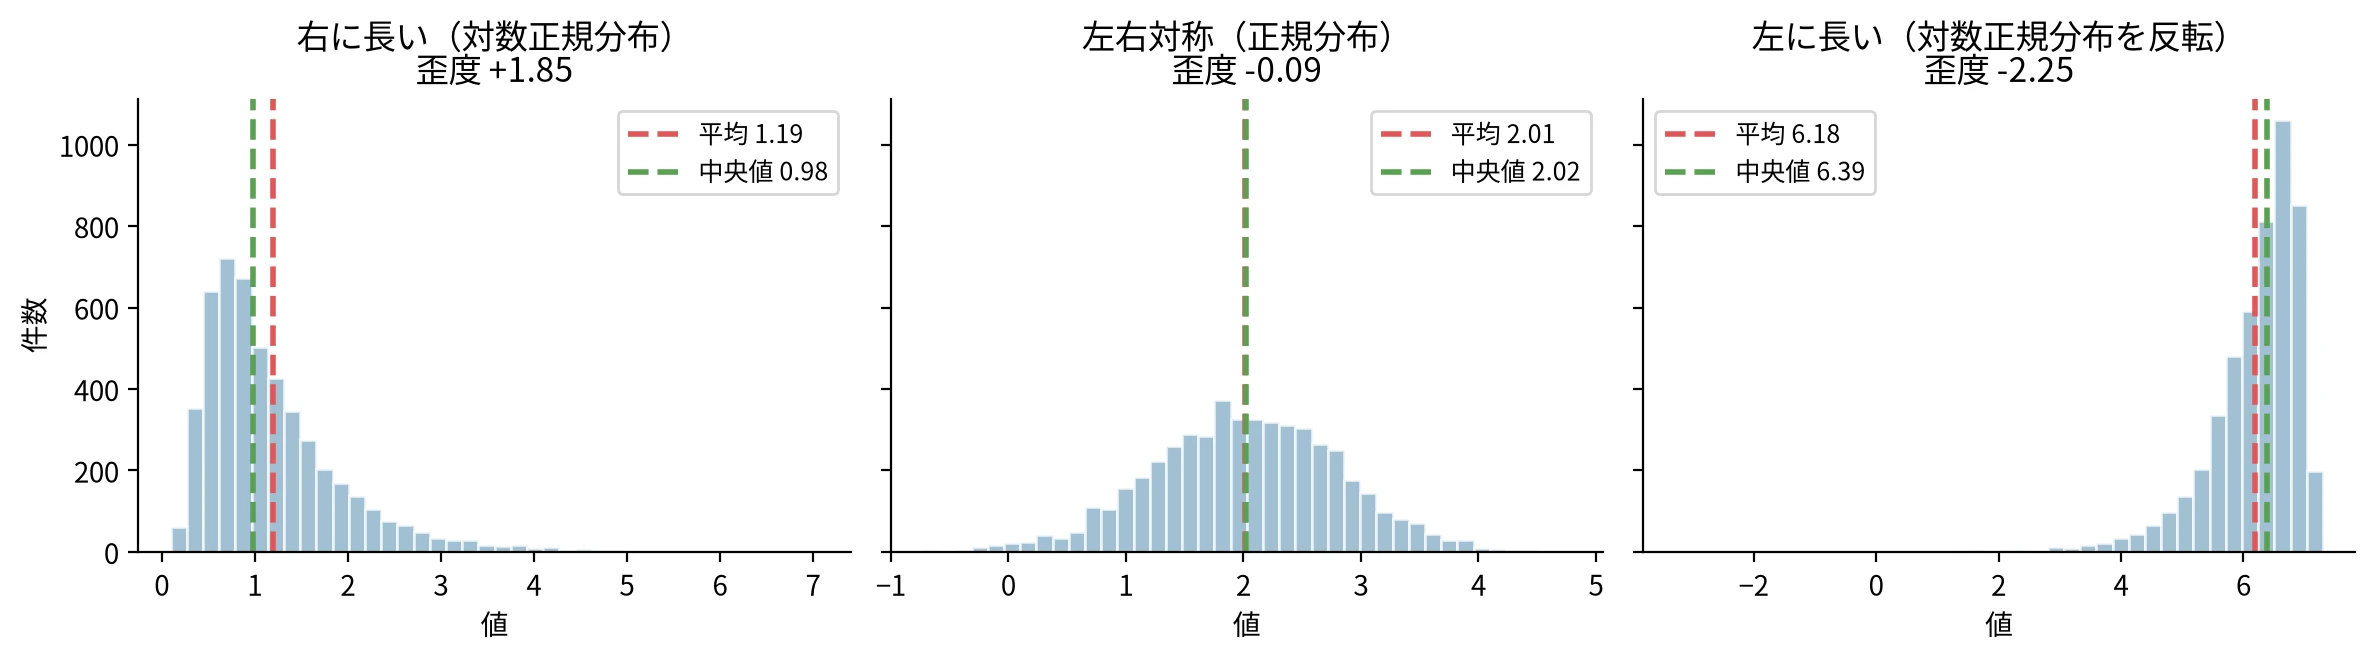
右に長い・左右対称・左に長い分布の歪度と、平均・中央値の位置
右に長い分布では、裾の大きな値に引っ張られて平均が中央値より右に来ます。正規分布から引いた標本でも、歪度はちょうど 0 にはならず -0.09 です。ただし、平均と中央値の位置だけから歪度の符号は決まりません。左右非対称でも歪度が 0 になる分布もあるので、歪度の値と一緒にヒストグラムや KDE(カーネル密度推定)で形を見ます。
歪度の絶対値が 0.5 未満ならほぼ対称、1 以上なら強く歪んでいる、という目安がよく使われます。この目安は件数や分布の種類を考えない経験則で、後の節で示すように、件数が少ないと歪度そのものが小さく出ます。
log1p の効き方が単位で変わる仕組み
np.log1p は log(1 + x) を返す関数で、log(x) と違って 0 を含む件数や金額にもそのまま使えます。歪度は単位で変わらないのに log1p の結果が変わるのは、式の中の + 1 が単位を持たない固定の数だからです。
x が 1 より十分小さい時、log(1 + x) はほぼ x に等しく、変換しても分布の形は変わりません。x が 1 より十分大きい時は、1 + x がほぼ x なので、log(1 + x) はほぼ log(x) になります。log(x) は単位を変えても全体が一定の数だけずれるだけなので、歪度は単位に左右されません。どちらに寄るかは、列の値が 1 と比べてどれだけ大きいかで決まり、それを決めているのが単位です。
住宅価格に掛ける倍率を 0.001 から 100 万まで変えて、log1p 後の歪度を計算しました。配布時は 10 万ドル単位なので、倍率 0.1 が 100 万ドル単位、倍率 1 が配布時のまま、倍率 10 万が 1 ドル単位に当たります。
from sklearn.datasets import fetch_california_housing

y = fetch_california_housing().target          # 地区ごとの住宅価格の中央値。単位は 10 万ドル
scales = 10.0 ** np.arange(-3, 6.01, 0.25)
sk = np.array([stats.skew(np.log1p(y * c)) for c in scales])
print(f"log(y) の歪度: {stats.skew(np.log(y)):+.3f}")
for c in [1e-3, 1e-1, 1, 10, 1e5]:
    print(f"倍率 {c:<6g}: 中央値 {np.median(y * c):10.4g}  log1p 後の歪度 {stats.skew(np.log1p(y * c)):+.3f}")
log(y) の歪度: -0.173
倍率 0.001 : 中央値   0.001797  log1p 後の歪度 +0.975
倍率 0.1   : 中央値     0.1797  log1p 後の歪度 +0.791
倍率 1     : 中央値      1.797  log1p 後の歪度 +0.276
倍率 10    : 中央値      17.97  log1p 後の歪度 -0.090
倍率 100000: 中央値  1.797e+05  log1p 後の歪度 -0.173
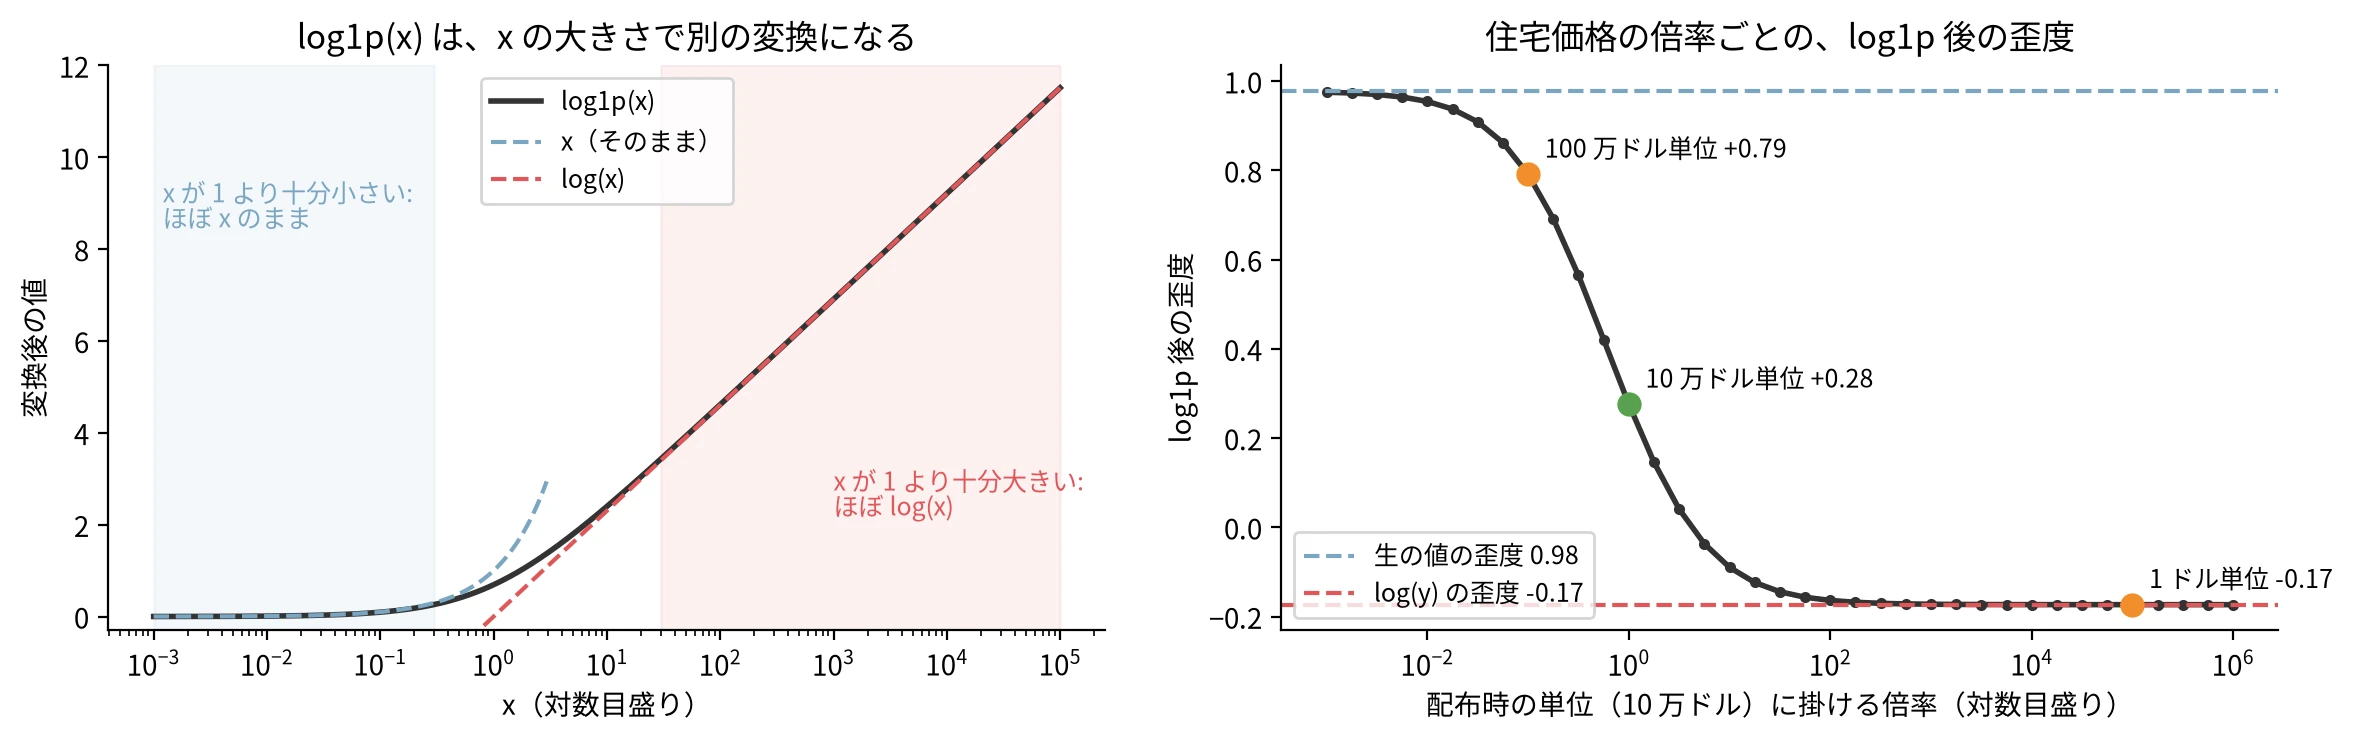
log1p(x) の曲線(左)と、住宅価格の倍率ごとの log1p 後の歪度(右)
右の図の曲線は、倍率が小さい側では生の値の歪度 0.98 に、大きい側では log(y) の歪度 -0.17 に張り付きます。間で歪度が大きく動くのは、中央値がおよそ 0.1 から 10 の間、つまり値の多くが 1 の前後にある時です。配布時の 10 万ドル単位は中央値が 1.8 で、ちょうど歪度が大きく動く範囲に入っています。
1 ドル単位で -0.17 になったのは、log1p が強く縮めたからではなく、log(y) そのものがこの列では左に裾を引くからです。値の大きい列に log1p をかけると、得られるのは log の結果で、それ以上は縮みも伸びもしません。log1p が 1 との差の小さい値で精度を保つ仕組みは、対数・指数と log-odds で説明しています。
Box-Cox 変換と Yeo-Johnson 変換
log1p の代わりに、変換の強さを表す λ をデータから決める冪変換もあります。Box-Cox 変換は (x^λ - 1) / λ で、λ が 0 の時は log(x) になり、正の値にしか使えません。Yeo-Johnson 変換は 0 や負の値にも使えるように Box-Cox を広げたもので、0 以上の値には ((x + 1)^λ - 1) / λ を使います。scikit-learn の PowerTransformer は両方を持ち、既定は Yeo-Johnson です。
同じ 3 つの単位で、log1p と並べました。
from sklearn.preprocessing import PowerTransformer

units = [("100 万ドル", 0.1), ("10 万ドル", 1.0), ("1 ドル", 1e5)]
for unit, scale in units:
    x = (y * scale).reshape(-1, 1)
    bc = PowerTransformer(method="box-cox").fit(x)
    yj = PowerTransformer(method="yeo-johnson").fit(x)
    print(f"{unit:>7} 単位: log1p {stats.skew(np.log1p(x.ravel())):+.2f}"
          f"  Box-Cox {stats.skew(bc.transform(x).ravel()):+.2f} (λ={bc.lambdas_[0]:.2f})"
          f"  Yeo-Johnson {stats.skew(yj.transform(x).ravel()):+.2f} (λ={yj.lambdas_[0]:.2f})")
出力を表にまとめると、次の通りです。
| 単位 | log1p 後の歪度 | Box-Cox 後の歪度 | Box-Cox の λ | Yeo-Johnson 後の歪度 | Yeo-Johnson の λ |
|---|---|---|---|---|---|
| 100 万ドル | +0.79 | -0.01 | 0.12 | +0.10 | -3.97 |
| 10 万ドル | +0.28 | -0.01 | 0.12 | +0.03 | -0.35 |
| 1 ドル | -0.17 | -0.01 | 0.12 | -0.01 | 0.12 |
Box-Cox は、どの単位でも λ が 0.12、歪度が -0.01 で同じです。x を c 倍すると x^λ も c^λ 倍されるだけで、形は変わらないからです。
Yeo-Johnson は、歪度はどの単位でも 0 に近づきますが、λ は -3.97 から 0.12 まで変わります。式の中に log1p と同じ + 1 があるので、単位が変わると、同じ形にするための λ も変わります。λ の値を別のデータと比べたり、λ から「ほぼ log 変換だ」と読んだりする時は、単位を揃えてからにします。
歪度が当てになる件数
ここまでは 20640 件の列でした。件数が少ないと、歪度は別の理由で当てになりません。3 乗するので、1 件の大きな値が結果をほとんど決めてしまい、その大きな値は件数が少ないと滅多に入らないからです。
log を取った値の標準偏差を 1 にした対数正規分布は、歪度が 6.18 と式で求まります。この分布から 10 件から 10000 件の標本を 500 回ずつ引き、標本の歪度を計算しました。コードの lognormal(0.0, 1.0, n) の 1.0 がこの標準偏差で、歪度の定義の sigma とは別の数です。
true_skew = (np.exp(1) + 2) * np.sqrt(np.exp(1) - 1)   # log を取った値の標準偏差が 1 の対数正規分布の歪度
print(f"対数正規分布の歪度: {true_skew:.2f}")
rng = np.random.default_rng(0)
ns = [10, 30, 100, 1000, 10000]
samples = {}
for n in ns:
    g = np.array([stats.skew(rng.lognormal(0.0, 1.0, n)) for _ in range(500)])
    samples[n] = g
    bound = (n - 2) / np.sqrt(n - 1)                    # n 件の標本の歪度が取りうる最大値
    print(f"n={n:<6} 中央値 {np.median(g):.2f}  90% 点 {np.percentile(g, 90):.2f}  上限 {bound:.2f}")
対数正規分布の歪度: 6.18
n=10     中央値 1.25  90% 点 2.21  上限 2.67
n=30     中央値 1.96  90% 点 3.55  上限 5.20
n=100    中央値 2.98  90% 点 5.08  上限 9.85
n=1000   中央値 4.37  90% 点 7.29  上限 31.58
n=10000  中央値 5.29  90% 点 7.31  上限 99.98
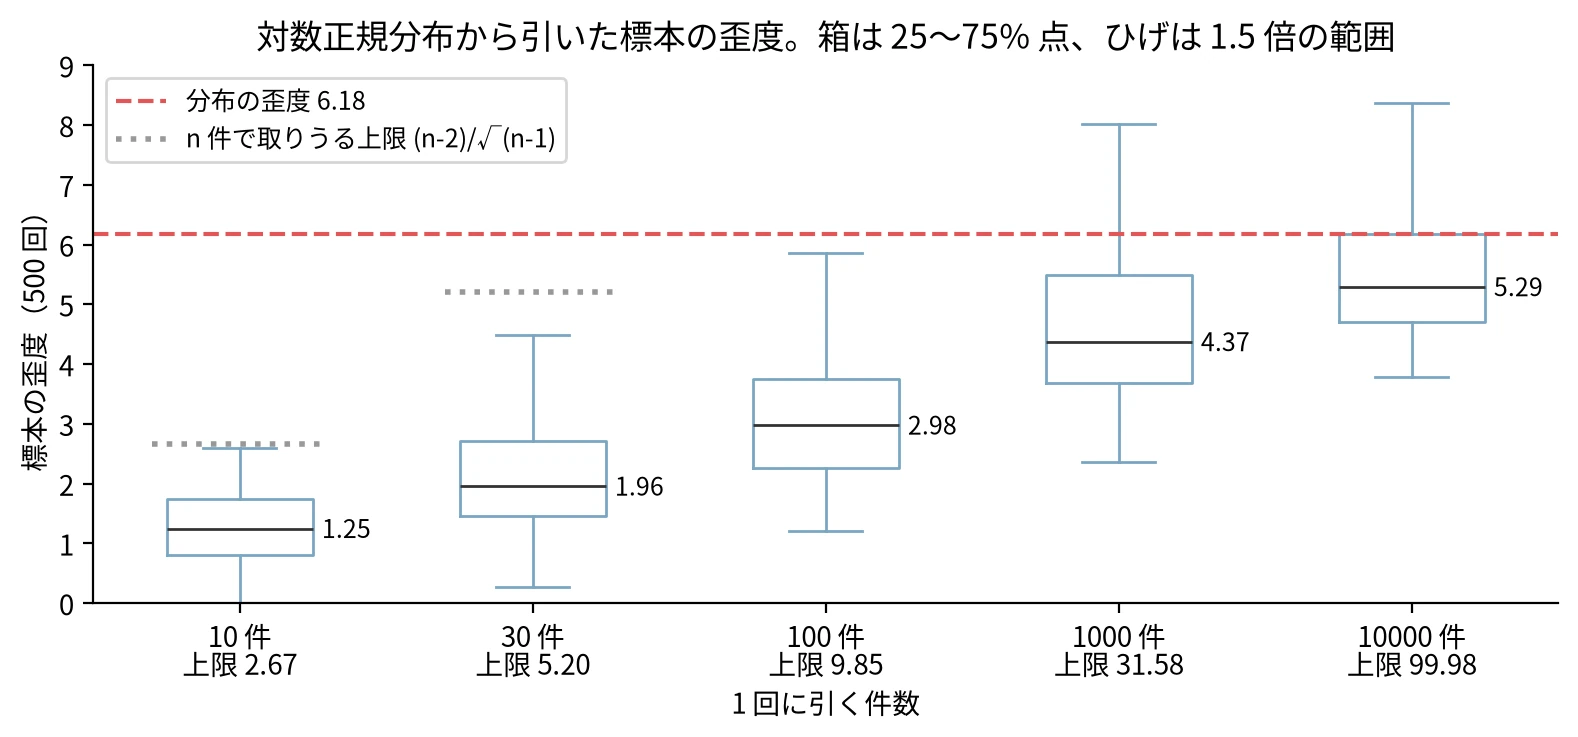
対数正規分布から引いた標本の歪度と件数
10 件の標本では、どう引いても歪度は 2.67 を超えません。n 件の標本の歪度には (n - 2) / √(n - 1) という上限があり、1 件だけが飛び抜けて残りが全て同じ値の時にこの上限に届きます。1000 件でも中央値は 4.37 で、分布の歪度 6.18 の 7 割ほどです。件数が少ない列ほど歪度は小さく出るので、「0.5 未満だから変換は要らない」という判断は、件数の少ない列ほど甘くなります。
scipy と pandas の既定の違い
同じ標本でも、計算するライブラリで歪度の値が変わります。scipy.stats.skew の既定は bias=True で、上の定義の式をそのまま標本に当てます。pandas の Series.skew は、件数で補正した値を返し、scipy.stats.skew(x, bias=False) と同じになります。
import pandas as pd

x20 = rng.lognormal(0.0, 1.0, 20)
print(f"n=20 の同じ標本: scipy skew {stats.skew(x20):.3f}"
      f"  scipy skew(bias=False) {stats.skew(x20, bias=False):.3f}  pandas skew {pd.Series(x20).skew():.3f}")
n=20 の同じ標本: scipy skew 3.174 scipy skew(bias=False) 3.437 pandas skew 3.437
20 件では 3.17 と 3.44 で 1 割近く違います。補正の係数は件数が増えると 1 に近づくので、数千件の列なら差は気になりません。列の一覧表は pandas で、ノートブックの別のセルは scipy で計算していると、件数の少ない列では同じ列の歪度が 2 つの値になります。
列ごとの歪度と変換の選び方
California Housing の説明変数のうち、緯度と経度を除く 6 列と目的変数について、生の歪度と log1p 後の歪度を並べました。表の「意味」の列は、scikit-learn のデータの説明から書き足しています。
X = fetch_california_housing(as_frame=True).frame.drop(columns=["Latitude", "Longitude"])
for col in X.columns:
    v = X[col].to_numpy()
    print(f"{col:<12} 中央値 {np.median(v):8.2f}"
          f"  生の歪度 {stats.skew(v):+6.2f}  log1p 後 {stats.skew(np.log1p(v)):+6.2f}")
| 列 | 意味 | 中央値 | 生の歪度 | log1p 後の歪度 |
|---|---|---|---|---|
| MedInc | 所得の中央値 | 3.53 | +1.65 | +0.23 |
| HouseAge | 築年数の中央値 | 29.00 | +0.06 | -1.14 |
| AveRooms | 世帯あたりの部屋数 | 5.23 | +20.70 | +1.39 |
| AveBedrms | 世帯あたりの寝室数 | 1.05 | +31.31 | +8.99 |
| Population | 地区の人口 | 1166.00 | +4.94 | -1.04 |
| AveOccup | 世帯あたりの人数 | 2.82 | +97.63 | +3.88 |
| MedHouseVal | 住宅価格の中央値 | 1.80 | +0.98 | +0.28 |
全ての列に同じ log1p をかけると、結果は 3 通りに分かれます。1 つ目は、ほぼ対称になった MedInc と MedHouseVal です。2 つ目は、反対側に歪んだ HouseAge と Population です。HouseAge はもともと対称なのに -1.14 と左に歪み、Population は中央値が 1166 と大きいので log1p がほぼ log になって、+4.94 から -1.04 になりました。3 つ目は、log1p の後も歪度が 1 を超える AveRooms・AveBedrms・AveOccup です。
3 つ目のうち、AveBedrms と AveOccup は log1p の後も 8.99 と 3.88 です。scikit-learn のデータの説明には、世帯が少なく空き家の多い別荘地のような地区で、世帯あたりの値が極端に大きくなると書かれています。AveOccup は、20640 地区のうち値の大きい 10 地区を除くだけで、log1p 後の歪度が 0.80 まで下がりました。
AveBedrms は同じようにはいきません。半分の地区が 1.01 から 1.10 の狭い幅に収まっていて標準偏差が小さいので、少し大きいだけの地区も平均から遠い値として 3 乗に効きます。歪度を作っている地区が 10 では済まず、大きい方の 10 地区を除いても 7.28、200 地区を除いてようやく 2.32 です。
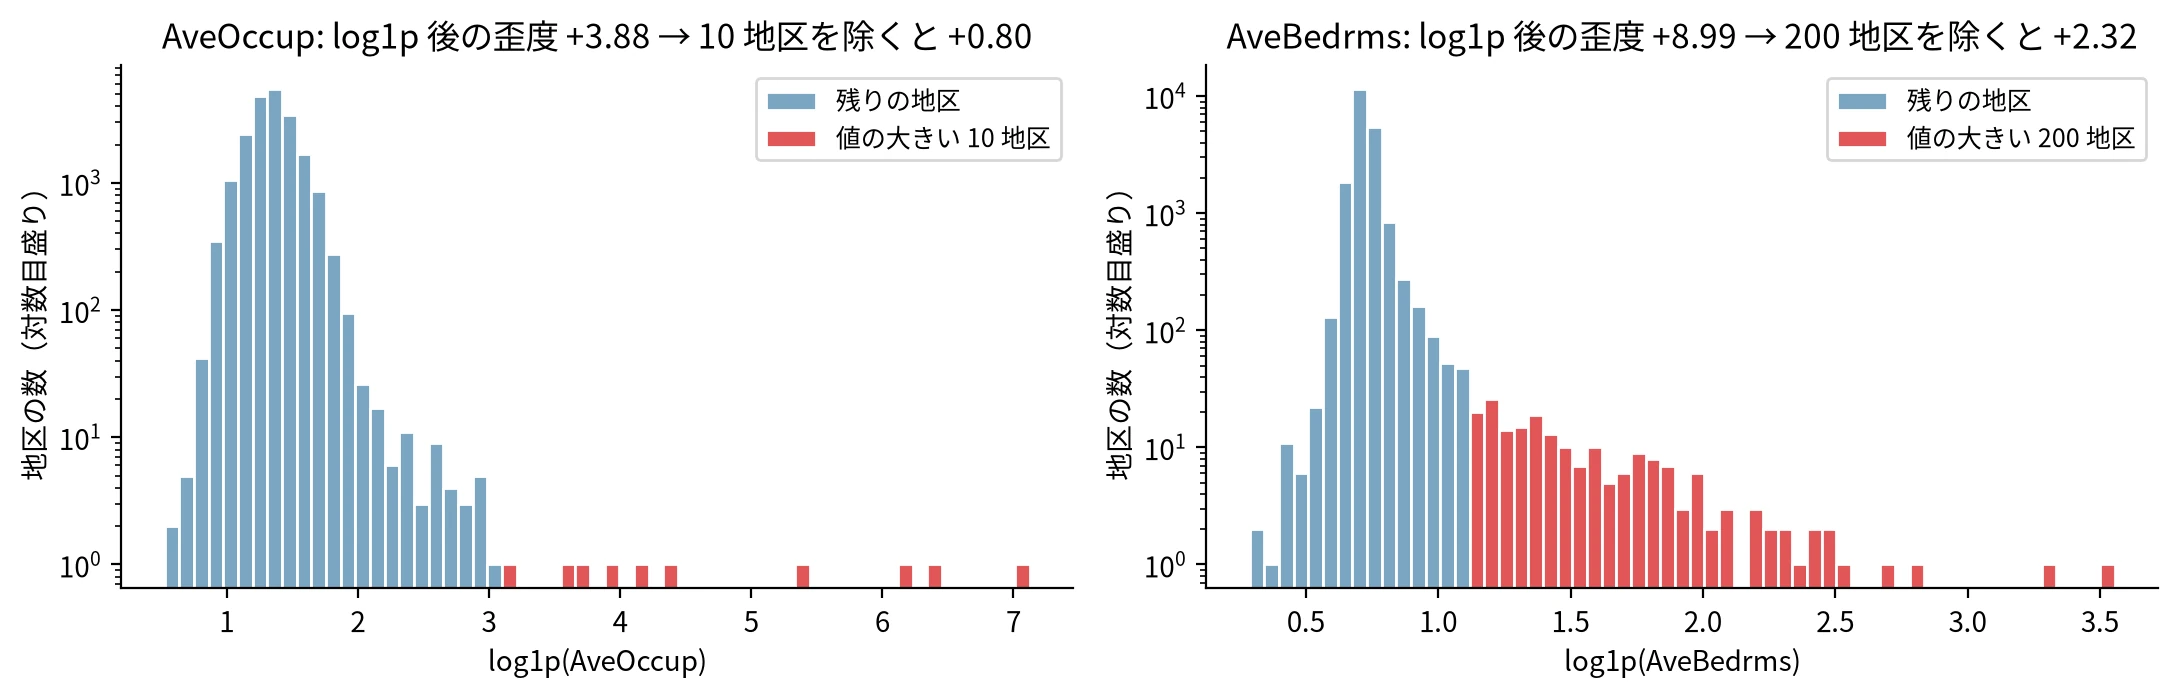
log1p をかけた後の AveOccup と AveBedrms で、歪度を決めている地区
どちらの列も、変換を選ぶより先に、歪度を決めている行が何かを調べます。全体で 2 番目に大きい、AveOccup が 599.7 の地区が、標準化した後も大きいまま残って確率的勾配降下法(SGD)の学習を乱す様子は、最急降下法・SGD で見ています。右に長い分布で外れ値の線を引く時の注意は、分位数で説明しています。
変換の要否は、列ごとに歪度の値だけでなく、値の範囲と単位、ヒストグラムを並べて決めます。この変換が効くのは、値の大きさそのものを使う線形回帰や k 近傍法のようなモデルです。ランダムフォレストや勾配ブースティングの木は、特徴量の大小の順だけで分割するので、log1p のように順序を変えない変換では、選ばれる分割は変わりません。
目的変数を log1p で学習する
価格のように右に歪んだ目的変数をそのまま線形回帰で学習すると、予測値の大きい所ほど残差が広がることがあります。残差は、実際の値から予測値を引いた差です。価格が面積に対して掛け算で揺れる人工データで、生の y と log1p(y) で学習し、予測値の小さい半分と大きい半分で残差の標準偏差を比べました。
from sklearn.linear_model import LinearRegression

rng = np.random.default_rng(3)
area = rng.uniform(30, 200, 300)
price = np.exp(1.0 + 0.015 * area + rng.normal(0, 0.25, 300))  # 掛け算の揺れで右に歪む
Xa = area.reshape(-1, 1)
for name, t in [("生の y", price), ("log1p(y)", np.log1p(price))]:
    model = LinearRegression().fit(Xa, t)
    pred = model.predict(Xa)
    resid = t - pred
    low = pred < np.median(pred)
    print(f"{name:<9} 残差の標準偏差: 予測値の小さい半分 {resid[low].std():.2f}、大きい半分 {resid[~low].std():.2f}")
生の y      残差の標準偏差: 予測値の小さい半分 4.08、大きい半分 8.26
log1p(y)  残差の標準偏差: 予測値の小さい半分 0.22、大きい半分 0.23
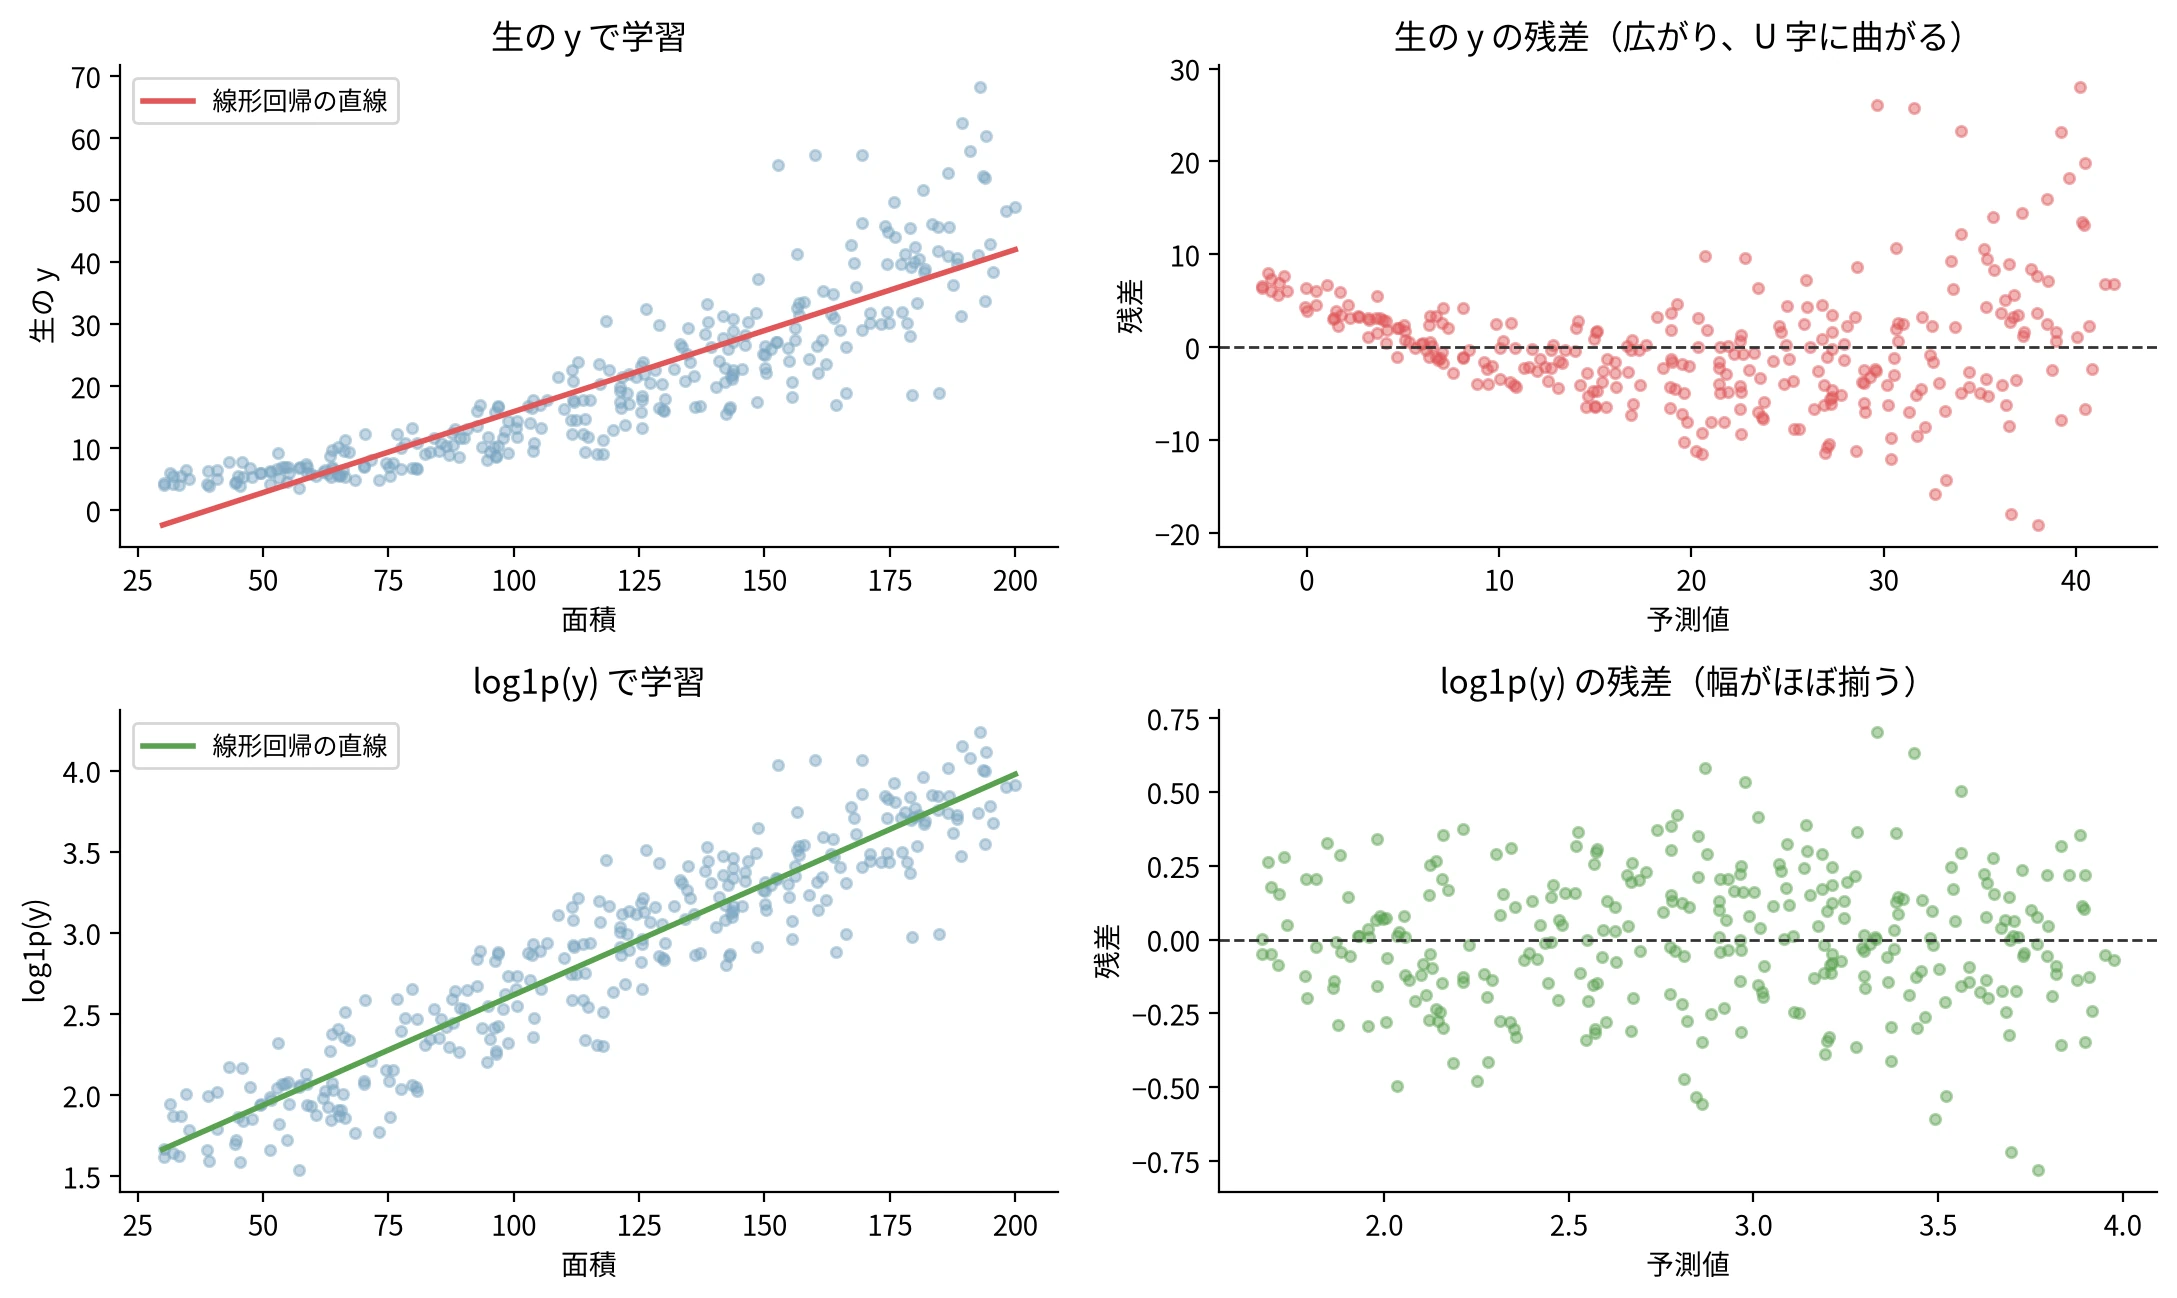
生の y と log1p(y) で学習した線形回帰の残差
生の y では、予測値の大きい半分で残差の標準偏差が 4.08 から 8.26 へ約 2 倍になり、右上の図は扇形に広がります。直線では曲がった関係を表せないので、右上の残差は両端で上に寄る U 字にも曲がり、面積の小さい所では予測値が負になっています。log1p(y) では 0.22 と 0.23 で揃い、曲がりも消えました。
ただし、この人工データは対数を取ると直線になるように作っているので、揃うのは当然でもあります。変換が残差を揃えるかは、実データで残差の図を描いて見ます。
log1p(y) で学習したモデルの予測は、np.expm1 で元の単位に戻してから、元の単位の回帰の評価指標で比べます。目的変数でも冒頭の単位の話は同じで、住宅価格を 1 ドル単位で持っていれば log1p(y) は log(y) と同じです。戻した予測は期待値より小さくなるので、予測を足して総額を出すと足りなくなることを期待値で実測しています。
log1p をかける前に見ること
最初に、列の単位と中央値を見ます。冒頭の住宅価格のように値の多くが 0.1 から 10 の間にある列では、log1p の効き方が単位で大きく変わります。中央値が数十を超えるなら log1p はほぼ log で、単位は結果に効きません。中央値が 0.1 を下回るなら、log1p はほとんど何もしません。
歪度の値を読む時は、計算した件数と、どのライブラリの値かも見ます。数十件の列の歪度は小さく出て、上限もあります。pandas と scipy の既定は違う値を返します。
変換を選ぶ時、単位に左右されたくなければ Box-Cox、0 や負の値を含むなら Yeo-Johnson を使います。Yeo-Johnson の λ を読む時は、どの単位で決めた値かも一緒に見ます。log1p を使い続けるなら、学習に使ったデータと推論で渡すデータの単位を揃えます。片方だけ千円単位にすると、冒頭の図の右上と左下のように、同じ列から形の違う特徴量ができます。
log1p の後も歪度が大きい列は、変換ではなく行を見ます。California Housing の AveOccup のように、20640 地区のうち 10 地区が歪度を決めていることがあります。冒頭の図の右端に立つ棒も、価格の上限 5 で打ち切られた地区で、どの単位で log1p をかけても消えません。