分位点(quantile)は、データを小さい順に並べた時に、下から割合 q の位置にある値です。q を百分率で書いたものをパーセンタイル(percentile)と呼び、90 パーセンタイルは下から 90% の位置の値です。監視の画面では p90・p99 と略します。25%・50%・75% の 3 つは四分位点(quartile)と呼び、Q1・Q2・Q3 と書きます。Q2 は中央値そのものです。
以下は、ある API の 10 回分の応答時間 12, 13, 14, 15, 16, 18, 20, 25, 40, 900 ms から、5 つのツールの関数で 90 パーセンタイルを計算した結果です。Python のライブラリの NumPy と pandas、DB の PostgreSQL と分析向けの DuckDB、Excel と同じ名前の関数を持つ表計算ソフトの LibreOffice Calc を使いました。図の Calc は LibreOffice Calc です。
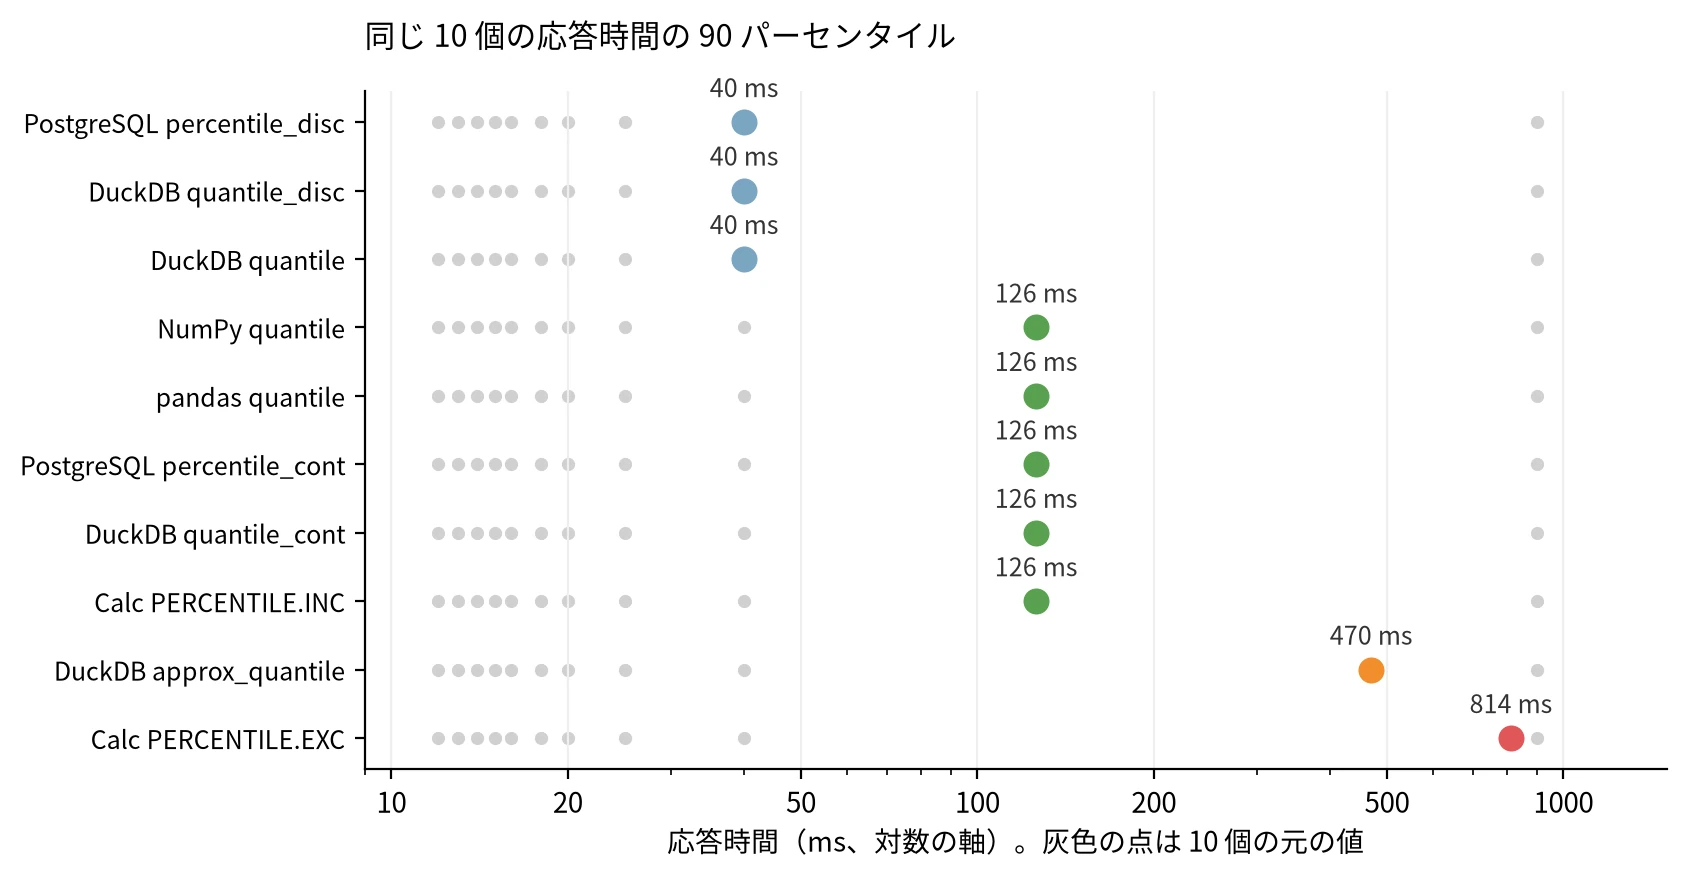
関数ごとに計算した、同じ 10 個の応答時間の 90 パーセンタイル
同じ 10 個から、40・126・470・814 ms の 4 通りの値が返りました。どの関数も誤りではなく、9 番目の 40 ms と 10 番目の 900 ms の間のどこを 90% の位置とみなすかの決め方が、関数ごとに違います。
応答時間の目標を「p99 が 200 ms 以下」のように決めて監視する場面があります。こうしたサービスの目標値を SLO(Service Level Objective)と呼びます。アクセスログを PostgreSQL で集計した p99 と、同じログを pandas に読み込んで出した p99 が合わない、という場面にも出会います。pandas の describe() が出す 25%・75% の列や、外れ値を除く閾値も、同じ分位点の計算です。
本記事では、ML の説明に出てくる分位点を自分で計算して確認したい人と、応答時間や予測の誤差を分位点で見る人に向けて、次の疑問に答えます。
- 同じデータで、関数ごとに分位点が違うのはなぜか。
- NumPy・pandas・PostgreSQL・DuckDB・Calc は、どの決め方か。
- 何件あれば、決め方の違いを気にしなくてよいのか。
- サーバーごとの p99 を平均すると、全体の p99 になるのか。
- 四分位点による外れ値の判定は、応答時間にも使えるのか。
- 分位点そのものを予測するには、どうするのか。
実験は NumPy 2.5.4、pandas 3.1.1、scikit-learn 1.9.1、PostgreSQL 18.6、DuckDB 1.5.5、LibreOffice 26.2 で行いました。図を描く処理も含めた完全なコードは quantile_gen.py にあります。
9 番目と 10 番目の間のどこを取るか
10 個の値を小さい順に並べた時、各順位を全体の何 % の位置とみなすかの目盛りが、決め方ごとに違います。以下は、冒頭の 4 つの値に対応する決め方の目盛りを順位 1〜10 の上に並べ、90% がどこに落ちるかを示した図です。
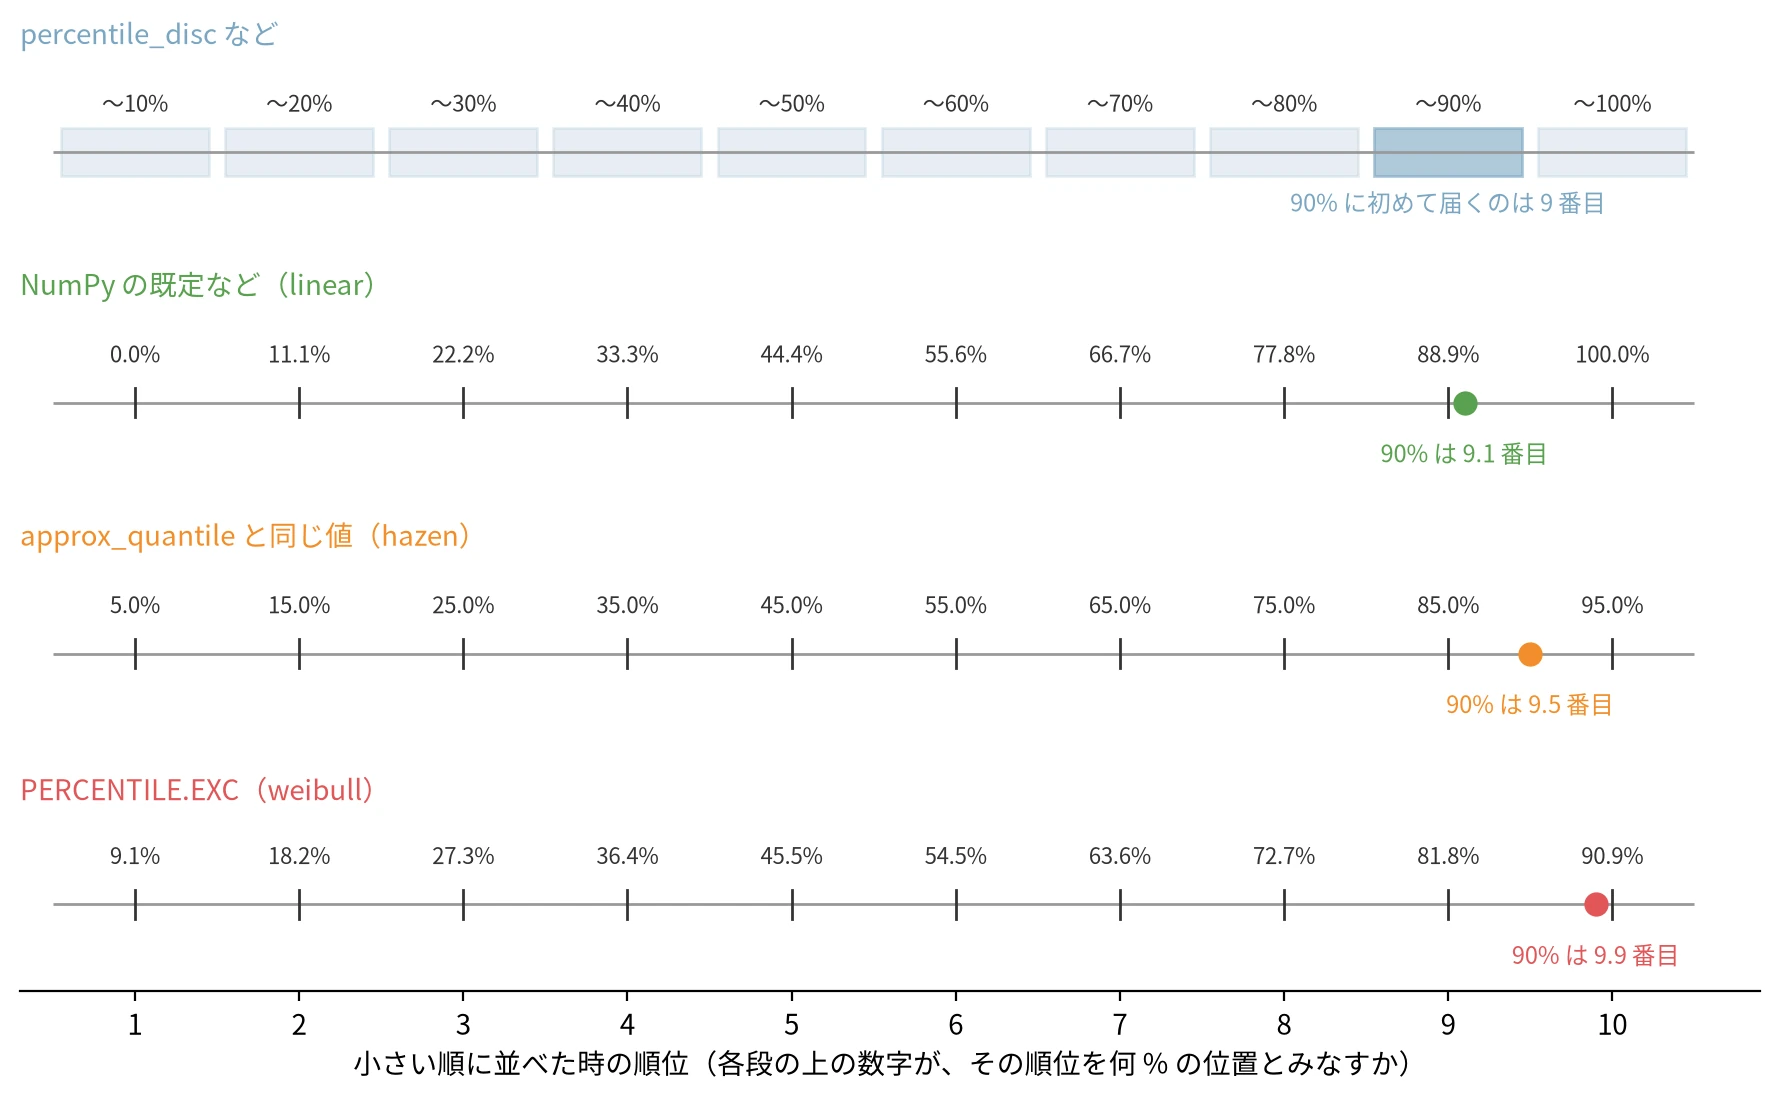
4 つの決め方が順位に割り当てる割合と、90% の落ちる位置
1 段目の PostgreSQL の percentile_disc は、各順位が 10% ずつの幅を受け持つとみなします。間を補間せずに、下からの割合が初めて 90% に届く 9 番目の値 40 ms をそのまま返します。
2 段目以降は、各順位を目盛りの 1 点とみなし、90% が 2 つの目盛りの間に落ちたら、両隣の値を直線で結んで間を補間します。目盛りの振り方は次の 3 通りです。
- linear は、1 番目を 0%、10 番目を 100% とする
- hazen は、各順位を自分の 10% の幅の真ん中に置く
- weibull は、両外側に 0 番目と 11 番目があるとみなし 11 等分する
位置の式で書くと、linear は 1 + (n - 1) * q、hazen は n * q + 0.5、weibull は (n + 1) * q で、n = 10、q = 0.9 ではそれぞれ 9.1・9.5・9.9 番目です。9.1 番目は、9 番目から 10 番目へ 1 割進んだ所という意味です。以下は、その位置を実際の値の上に置いた図です。
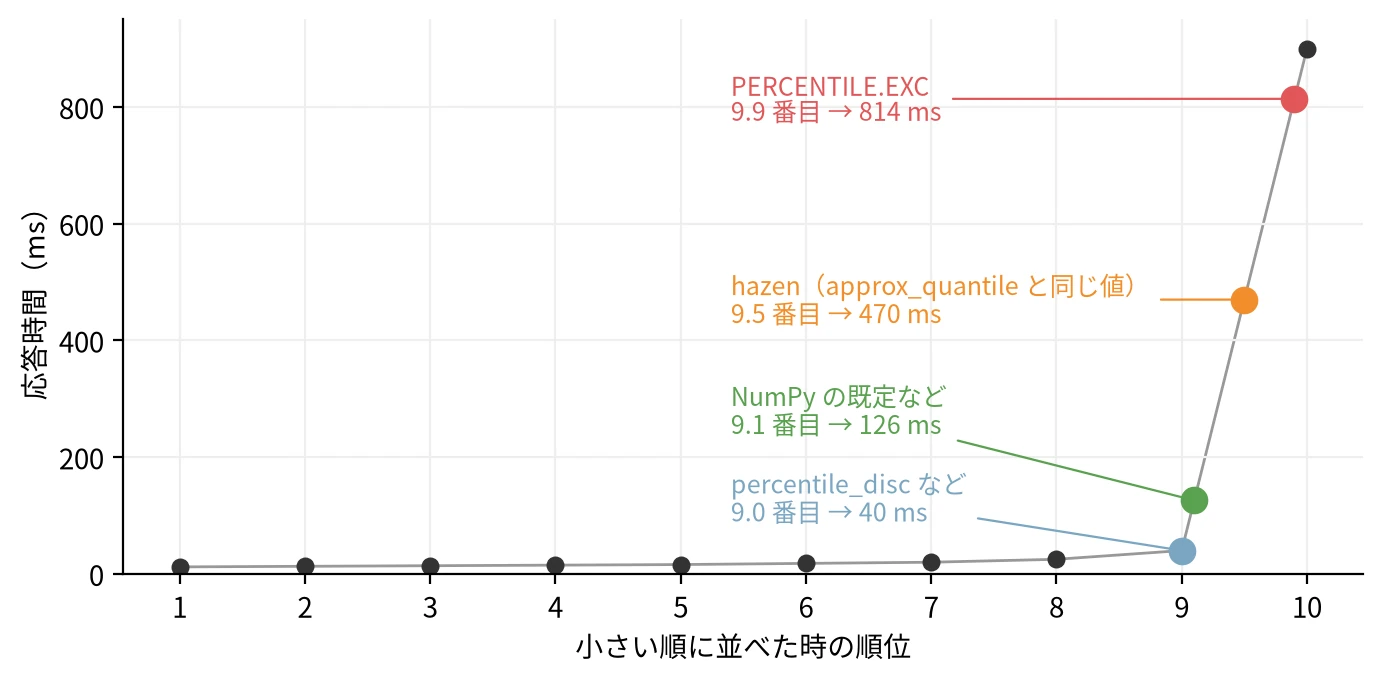
4 つの決め方が取った位置。9 番目と 10 番目の差が 860 ms あるので、位置の小さな差が値の大きな差になる
9 番目と 10 番目の差は 860 ms あるので、0.1 番目の違いが 86 ms の違いになります。linear は 40 ms に 86 ms を足して 126 ms、hazen は 430 ms を足して 470 ms、weibull は 774 ms を足して 814 ms です。NumPy・pandas・PostgreSQL の percentile_cont は linear、LibreOffice Calc の PERCENTILE.EXC は weibull と同じ値でした。
DuckDB の approx_quantile は、大量のデータを少ないメモリで要約する T-Digest という近似の手法で、上の目盛りの式は持ちません。この 10 個では 470 ms を返し、hazen と同じ値になりました。
Hyndman と Fan の論文「Sample Quantiles in Statistical Packages」(1996 年)は、統計ソフトで使われていた分位点の決め方を 9 種類に整理しました。NumPy の quantile は、この 9 種類に 4 つを足した 13 通りを method で選べます。以下のコードで、冒頭の値を NumPy で再現しました。
import numpy as np
import pandas as pd

latency_ms = [12, 13, 14, 15, 16, 18, 20, 25, 40, 900]
print("NumPy の既定(linear):", np.quantile(latency_ms, 0.9).round(2))
print("pandas の既定:", round(pd.Series(latency_ms).quantile(0.9), 2))
for method in ["inverted_cdf", "linear", "hazen", "weibull"]:
    print(f"method={method}:", np.quantile(latency_ms, 0.9, method=method).round(2))
NumPy の既定(linear): 126.0
pandas の既定: 126.0
method=inverted_cdf: 40
method=linear: 126.0
method=hazen: 470.0
method=weibull: 814.0
inverted_cdf が percentile_disc の 40 ms、weibull が PERCENTILE.EXC の 814 ms と同じ値です。hazen の 470 ms は、この 10 個では approx_quantile と一致しました。以降のコードも、この 2 行の import を前提にします。
ツールごとの既定
ツールの関数が、前の節のどの決め方かを確認します。PostgreSQL では、次の SQL を流しました。
WITH t(v) AS (VALUES (12), (13), (14), (15), (16), (18), (20), (25), (40), (900))
SELECT percentile_cont(0.9) WITHIN GROUP (ORDER BY v) AS cont_90,
       percentile_disc(0.9) WITHIN GROUP (ORDER BY v) AS disc_90,
       percentile_cont(0.5) WITHIN GROUP (ORDER BY v) AS cont_50,
       percentile_disc(0.5) WITHIN GROUP (ORDER BY v) AS disc_50
FROM t;
      cont_90       | disc_90 | cont_50 | disc_50
--------------------+---------+---------+---------
 125.99999999999969 |      40 |      17 |      16
PostgreSQL の文書によると、percentile_cont は隣り合う値の間を補間し、percentile_disc は並べた位置が指定の割合以上になる最初の値を返します。50% の列では、percentile_cont が真ん中の 2 つ 16 と 18 の平均の 17 を返し、percentile_disc は 16 を返しました。
DuckDB でも、同じ値で次の SQL を流しました。
CREATE TABLE t AS SELECT unnest([12, 13, 14, 15, 16, 18, 20, 25, 40, 900]) AS v;
SELECT quantile_cont(v, 0.9) AS cont_90, quantile_disc(v, 0.9) AS disc_90,
       quantile(v, 0.9) AS q_90, approx_quantile(v, 0.9) AS approx_90,
       median(v) AS median, quantile(v, 0.5) AS q_50
FROM t;
┌───────────────────┬─────────┬───────┬───────────┬────────┬───────┐
│      cont_90      │ disc_90 │ q_90  │ approx_90 │ median │ q_50  │
│      double       │  int32  │ int32 │   int32   │ double │ int32 │
├───────────────────┼─────────┼───────┼───────────┼────────┼───────┤
│ 125.9999999999997 │      40 │    40 │       470 │   17.0 │    16 │
└───────────────────┴─────────┴───────┴───────────┴────────┴───────┘
DuckDB 1.5 の文書には、quantile は quantile_disc の別名とあります。そのため DuckDB では、同じ 10 個の中央値が median では 17、quantile(v, 0.5) では 16 になりました。
LibreOffice Calc では、10 個の値を A1〜A10 に入れ、=PERCENTILE.INC(A1:A10,0.9) が 126、=PERCENTILE.EXC(A1:A10,0.9) が 814 でした。Microsoft の PERCENTILE.EXC の文書には、割合が 1/(n + 1) の倍数でない時は値の間を補間するとあります。Excel そのもので計算はしていません。
以下は、前の節の NumPy の method とここまでの結果を対応させた表です。中央値の列は、10 個の 50% の位置の値です。
| 関数 | NumPy の method | p90 | 中央値 |
|---|---|---|---|
NumPy・pandas の既定、percentile_cont、quantile_cont、PERCENTILE.INC | linear | 126 | 17 |
percentile_disc、quantile_disc、DuckDB の quantile | inverted_cdf | 40 | 16 |
PERCENTILE.EXC | weibull | 814 | 17 |
DuckDB の approx_quantile | 10 個では hazen と同じ値 | 470 | ― |
多くのツールの既定は linear で、SQL の _disc の付く関数と DuckDB の quantile だけが元のデータの値を返します。手元の値と SQL の値を突き合わせる時は、まずこの表の同じ行の関数どうしで比べます。
件数と p99 のずれ
冒頭の 10 個では 4 通りに分かれましたが、件数が増えると隣り合う値の差が縮むので、決め方の違いも小さくなります。作ったデータで、どれくらいの件数なら気にしなくてよいかを確認しました。
応答時間によくある右に長い分布として、対数正規分布を使います。対数を取ると正規分布になる分布で、ここでは対数の平均を log 20、標準偏差を 0.6 にしたので、中央値は 20 ms です。標準正規分布の 99% 点は 2.3263 なので、本当の p99 は 20 * exp(0.6 * 2.3263) で 80.8 ms と計算で分かります。件数を 10〜10,000 件に変えて 500 回ずつデータを作り、inverted_cdf・linear・weibull の 3 つで p99 を計算しました。
rng = np.random.default_rng(0)
true_p99 = 20 * np.exp(0.6 * 2.3263)  # 中央値 20 ms、sigma 0.6 の対数正規分布の 99% 点
sizes = [10, 20, 50, 100, 200, 500, 1000, 2000, 5000, 10000]
methods = ["inverted_cdf", "linear", "weibull"]
gap, spread = [], []
for size in sizes:
    est = np.array([[np.quantile(s, 0.99, method=m) for m in methods]
                    for s in rng.lognormal(np.log(20), 0.6, size=(500, size))])
    gap.append(np.median(est.max(axis=1) - est.min(axis=1)) / true_p99)  # 同じデータでの方法の差
    lo, hi = np.quantile(est[:, 1], [0.1, 0.9])  # 取り直すたびの linear の値の幅(中央の 80%)
    spread.append((hi - lo) / true_p99)
    print(f"{size:>5} 件: 方法の差 {gap[-1]:.1%}、取り直しの幅 {spread[-1]:.1%}")
   10 件: 方法の差 1.3%、取り直しの幅 52.4%
  100 件: 方法の差 14.5%、取り直しの幅 42.6%
 1000 件: 方法の差 1.6%、取り直しの幅 17.5%
10000 件: 方法の差 0.2%、取り直しの幅 6.1%
出力は一部の行だけを載せています。赤い線は同じデータで 3 つの方法が出した p99 の差、青い線はデータを作り直すたびに linear の p99 がどれだけ動くかで、どちらも本当の p99 に対する割合です。
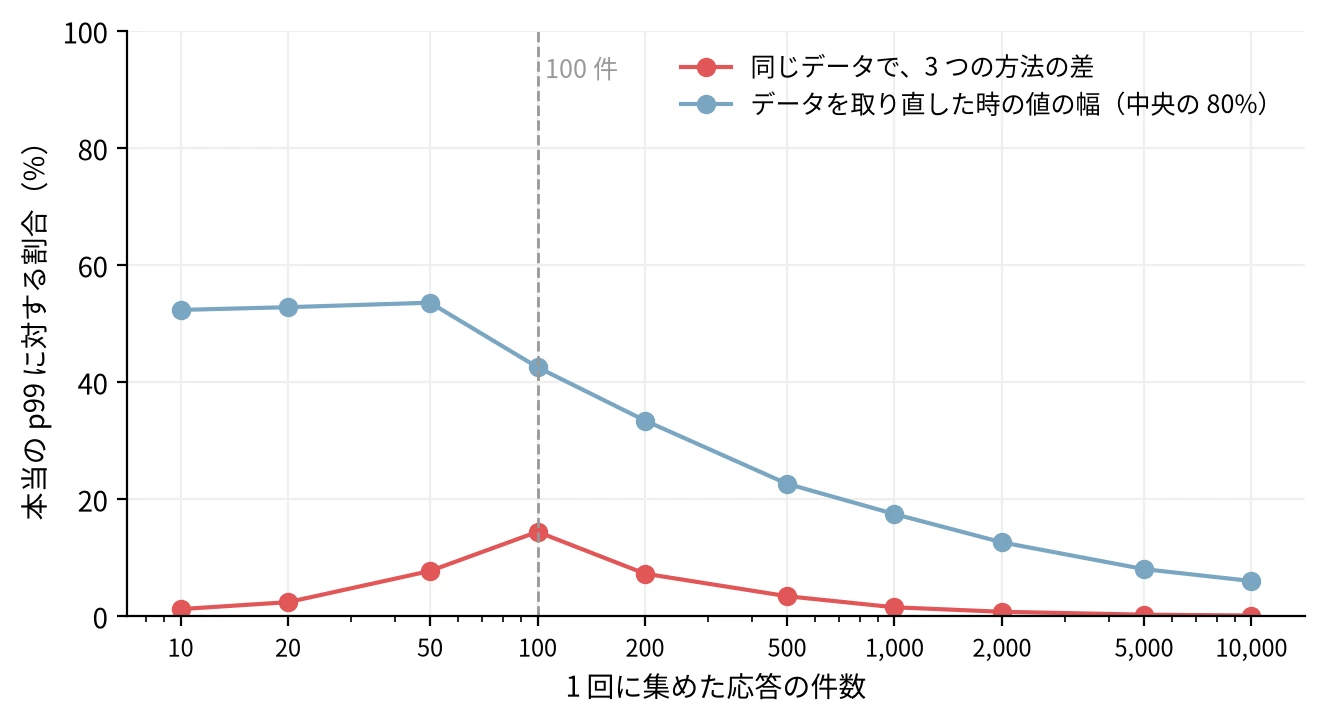
p99 を計算した時の、方法による差と、データを取り直した時の幅
赤い線は 100 件で山になり、100 件より少ないと逆に小さくなります。100 件より少ないと、99% の位置が最大値のすぐ近くに来るからです。inverted_cdf は最大値そのものを返し、weibull の位置 (n + 1) * 0.99 は最大値の外側になるので、NumPy は最大値を返します。linear の位置 1 + (n - 1) * 0.99 は、10 件で 9.91 番目、50 件で 49.51 番目で、最大値と 1 つ手前の間の値になります。
100 件ちょうどでは、inverted_cdf が 99 番目、weibull がほぼ 100 番目を取ります。裾の 99 番目と 100 番目の差がそのまま方法の差になるので、ここで山になります。
weibull と同じ決め方の Calc は、最大値の外側の位置を計算しません。冒頭の 10 個で =PERCENTILE.EXC(A1:A10,0.99) を計算すると、エラー(Err:504)を返しました。
青い線は、どの件数でも赤い線より大きく出ました。1,000 件でも、作り直すたびに p99 は本当の値の 17.5% ほどの幅で動きます。100 件より少ない時に 3 つの方法が揃うのは、2 つが最大値を返し、linear も最大値と 1 つ手前の間の値を返すからです。その一番遅い 1〜2 件は、作り直すたびに大きく変わります。
1 分ごとの p99 を出す監視で、1 分間の応答が数十件しかなければ、その p99 は 1 分間で一番遅かった 1〜2 件で決まります。このずれは、決め方を揃えても小さくなりません。件数ごとの推定の揺れは、大数の法則と中心極限定理で扱っています。
サーバーごとの p99 を平均する
件数の次は、複数の集計を 1 つにまとめる時です。監視の画面で、サーバーごとの p99 を平均して全体の p99 として並べることがあります。以下は、3 台のサーバーのうち、応答の 9 割を受けたサーバー A だけが遅い場合の結果です。A は中央値 40 ms、B と C は中央値 20 ms の対数正規分布から作りました。
rng = np.random.default_rng(1)
servers = {
    "サーバー A": rng.lognormal(np.log(40), 0.6, 9000),  # 応答の 9 割を受け、遅い
    "サーバー B": rng.lognormal(np.log(20), 0.5, 500),
    "サーバー C": rng.lognormal(np.log(20), 0.5, 500),
}
p99s = {k: np.quantile(v, 0.99) for k, v in servers.items()}
avg_p99 = np.mean(list(p99s.values()))
all_p99 = np.quantile(np.concatenate(list(servers.values())), 0.99)
for k, v in p99s.items():
    print(f"{k}: {len(servers[k])} 件、p99 {v:.1f} ms")
print(f"3 台の p99 の平均: {avg_p99:.1f} ms、全ての応答をまとめた p99: {all_p99:.1f} ms")
サーバー A: 9000 件、p99 163.0 ms
サーバー B: 500 件、p99 54.7 ms
サーバー C: 500 件、p99 60.2 ms
3 台の p99 の平均: 92.6 ms、全ての応答をまとめた p99: 158.3 ms
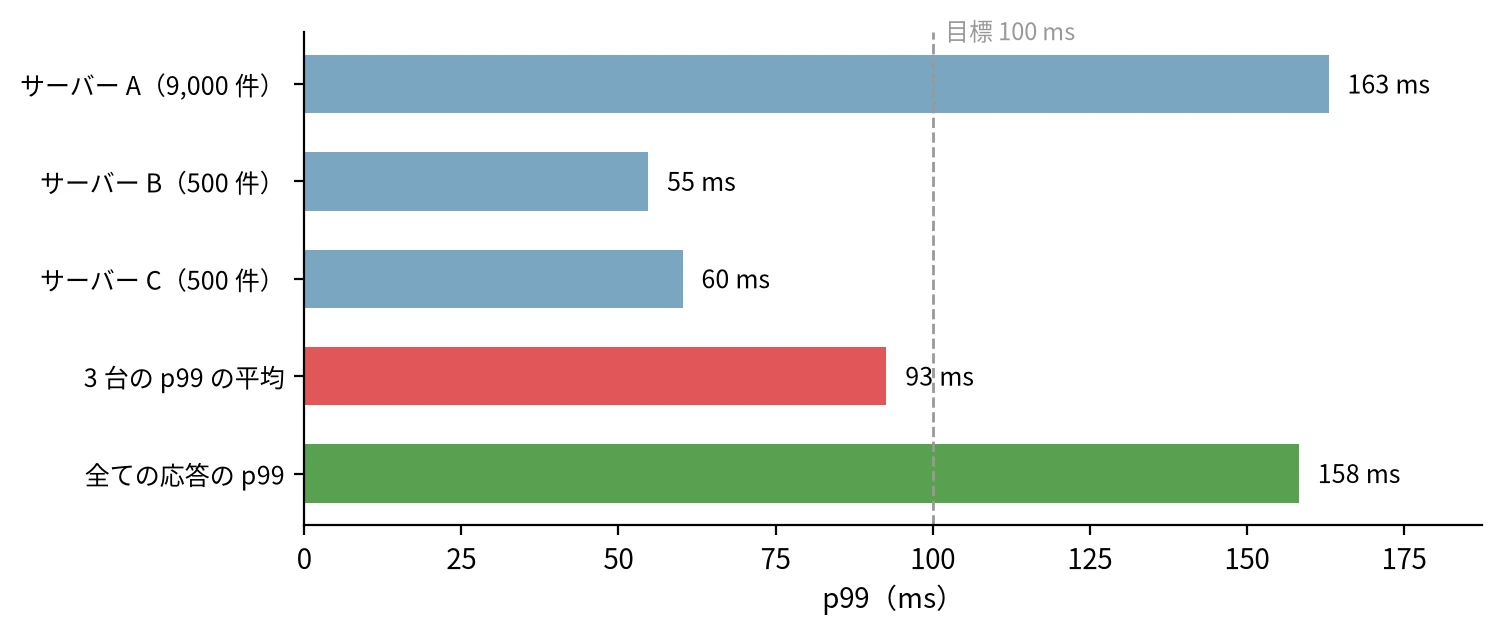
サーバーごとの p99、その平均、全ての応答をまとめた p99(目標 100 ms は説明用の値)
3 台の p99 の平均は 92.6 ms で、目標を 100 ms とすると達成して見えます。全ての応答をまとめた p99 は 158.3 ms で、利用者の 1% は 158 ms 以上待っています。平均は 3 台を同じ重さで扱うので、500 件しか受けていない B と C の速さが、9,000 件を受けた A の遅さを薄めました。
監視の OSS である Prometheus のヒストグラムとサマリーの文書も、事前に計算した分位点を平均すると統計的に意味の無い値になると書いています。まとめた p99 が欲しい時は、元の値を集めてから計算するか、件数を数えた表であるヒストグラムを足し合わせてから計算します。Prometheus のヒストグラムは、バケットの上限 le ごとに件数を数えます。histogram_quantile に、sum by (le) で上限ごとの件数を足してから渡す書き方は、モデル性能のモニタリングのノートで使っています。
四分位範囲と外れ値
ここからは、分位点を閾値として使う場面です。四分位範囲(IQR、Interquartile Range)は Q3 - Q1 で、真ん中の 50% のデータが収まる幅です。describe() の 75% から 25% を引いた値で、標準偏差と並ぶ散らばりの指標です。
IQR で外れ値を決める方法に、統計学者の Tukey の方法があります。Q1 から IQR の 1.5 倍だけ下と、Q3 から 1.5 倍だけ上に境界を引き、その外を外れ値とみなします。この境界をフェンスと呼びます。1.5 は Tukey が箱ひげ図で使った経験則で、理論から決まる値ではありません。
以下のコードは、正規分布の 200 点に極端な値を 5 個混ぜた前後で IQR と標準偏差を比べ、フェンスの外の値を拾います。続けて、前の節と同じ形の応答時間 500 件にも同じフェンスを当てます。
rng = np.random.default_rng(0)
base = rng.normal(50, 8, 200)
data = np.concatenate([base, [10, 15, 95, 110, 130]])
for name, d in [("混ぜる前", base), ("5 個混ぜた後", data)]:
    a, b = np.quantile(d, [0.25, 0.75])
    print(f"{name}: IQR={b - a:.2f} 標準偏差={d.std():.2f}")
q1, q3 = np.quantile(data, [0.25, 0.75])
iqr = q3 - q1
lo, hi = q1 - 1.5 * iqr, q3 + 1.5 * iqr
flagged = np.sort(data[(data < lo) | (data > hi)])
print(f"フェンス [{lo:.1f}, {hi:.1f}]、外れ値 {flagged.tolist()}")

lat = rng.lognormal(np.log(20), 0.6, 500)  # 前の節と同じ形の応答時間 500 件
l1, l3 = np.quantile(lat, [0.25, 0.75])
l_hi = l3 + 1.5 * (l3 - l1)
print(f"応答時間 500 件: 上のフェンス {l_hi:.1f} ms、超えた件数 {(lat > l_hi).sum()}、"
      f"下のフェンスを下回った件数 {(lat < l1 - 1.5 * (l3 - l1)).sum()}")
混ぜる前: IQR=10.50 標準偏差=7.69
5 個混ぜた後: IQR=10.63 標準偏差=11.39
フェンス [29.0, 71.5]、外れ値 [10.0, 15.0, 95.0, 110.0, 130.0]
応答時間 500 件: 上のフェンス 55.4 ms、超えた件数 21、下のフェンスを下回った件数 0
5 個を混ぜると、標準偏差は 7.69 から 11.39 へ 1.5 倍になり、IQR は 10.50 から 10.63 とほとんど動きませんでした。IQR は順位で決まるので、端の値がどれだけ大きくても、真ん中の 50% の幅は変わりにくいからです。平均と標準偏差で決めた境界が、外れ値に引きずられて外れ値を見逃す様子は、標準偏差のノートの「外れ値 1 個の影響」で確認しています。
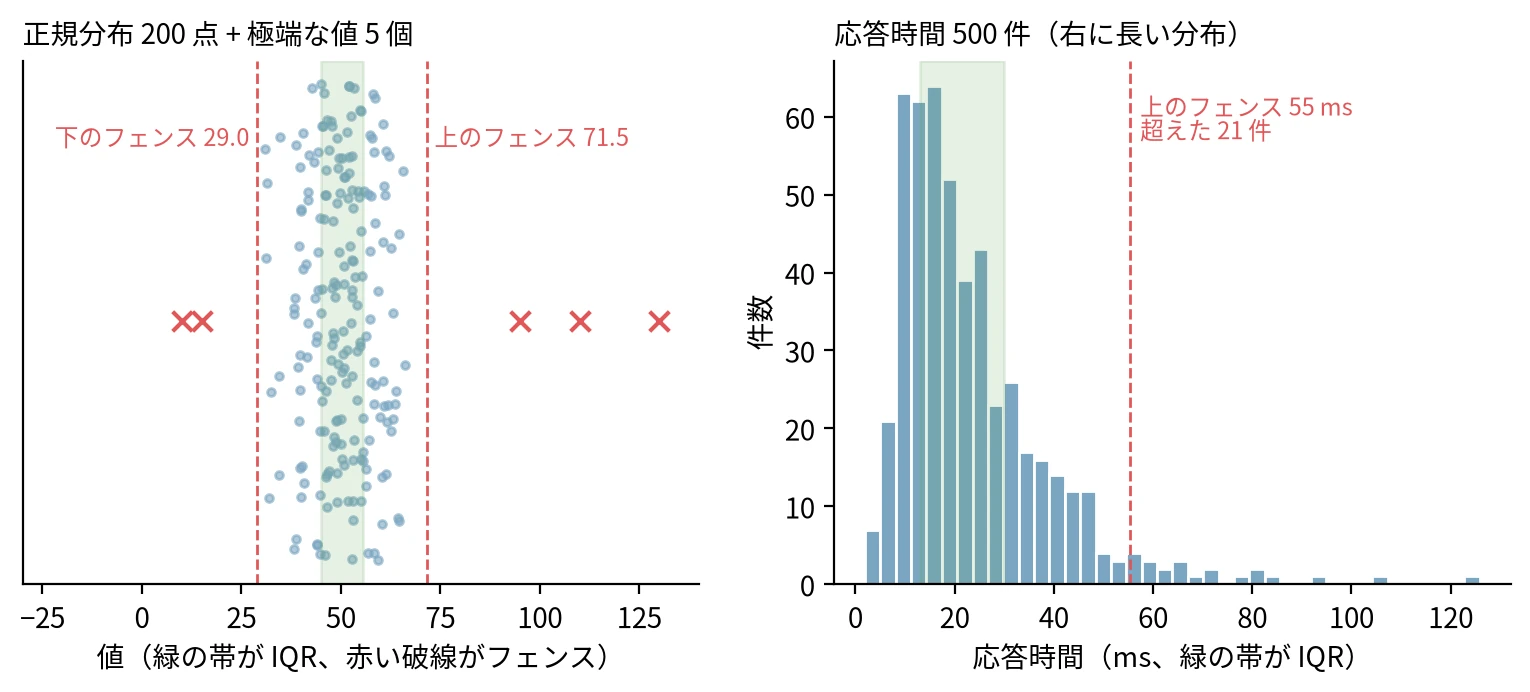
Tukey のフェンス。左は混ぜた 5 個だけを拾い、右は右に長い分布の裾の 21 件を拾う
左の図では、混ぜた 5 個だけがフェンスの外に出ました。右の応答時間では、500 件のうち 21 件、4.2% が上のフェンスを超え、下のフェンスを下回った値はありません。この 21 件は混ぜた異常値ではなく、右に長い分布の裾そのものです。歪んだ分布にそのまま当てると、遅い応答を毎回数 % ずつ外れ値として捨てることになります。
外れ値に強い前処理としては、scikit-learn の RobustScaler が、中央値を引いて IQR で割ります。平均と標準偏差を使う標準化との違いは、標準化のノートで比べています。
分位点を予測する分位回帰
ここまでは手元のデータの分位点を数えました。分位回帰(quantile regression)は、入力から出力の分位点を予測する回帰です。例えば「この大きさのリクエストなら、9 割は何 ms 以内に返るか」を予測します。二乗誤差で学習する普通の回帰は平均を予測し、中央値のノートで扱った中央値を予測する回帰は q = 0.5 の場合です。
分位回帰は、予測が実測を下回った誤差に q、上回った誤差に 1 - q を掛けた損失を最小にします。この損失を pinball loss と呼びます。q = 0.9 なら下回る罰が 9 倍重いので、9 割の点が予測より下に来る所で釣り合います。
以下のコードは、x が大きいほど雑音が大きいデータに、scikit-learn の GradientBoostingRegressor で q = 0.1, 0.5, 0.9 を学習します。loss="quantile" が pinball loss で、alpha が q です。仕組みは勾配ブースティングのノートで扱っています。q = 0.1 と q = 0.9 の予測の間は、8 割の点が入るはずの区間です。学習データと、同じ式で新しく作った 5,000 点で、区間に入った割合を数えます。
from sklearn.ensemble import GradientBoostingRegressor

rng2 = np.random.default_rng(7)
x = np.linspace(0, 10, 200)
y = np.sin(x) * 3 + 0.5 * x + rng2.normal(0, 0.2 + 0.3 * x, 200)
X = x.reshape(-1, 1)


def fit(q):
    return GradientBoostingRegressor(loss="quantile", alpha=q, n_estimators=100,
                                     max_depth=3, random_state=0).fit(X, y)


q_low, q_med, q_high = fit(0.1), fit(0.5), fit(0.9)
inside = (q_low.predict(X) <= y) & (y <= q_high.predict(X))
rng3 = np.random.default_rng(99)
x_new = rng3.uniform(0, 10, 5000)
y_new = np.sin(x_new) * 3 + 0.5 * x_new + rng3.normal(0, 0.2 + 0.3 * x_new)
X_new = x_new.reshape(-1, 1)
inside_new = (q_low.predict(X_new) <= y_new) & (y_new <= q_high.predict(X_new))
print(f"学習データで区間に収まった割合: {inside.mean():.0%}、新しいデータ: {inside_new.mean():.0%}")
学習データで区間に収まった割合: 79%、新しいデータ: 64%
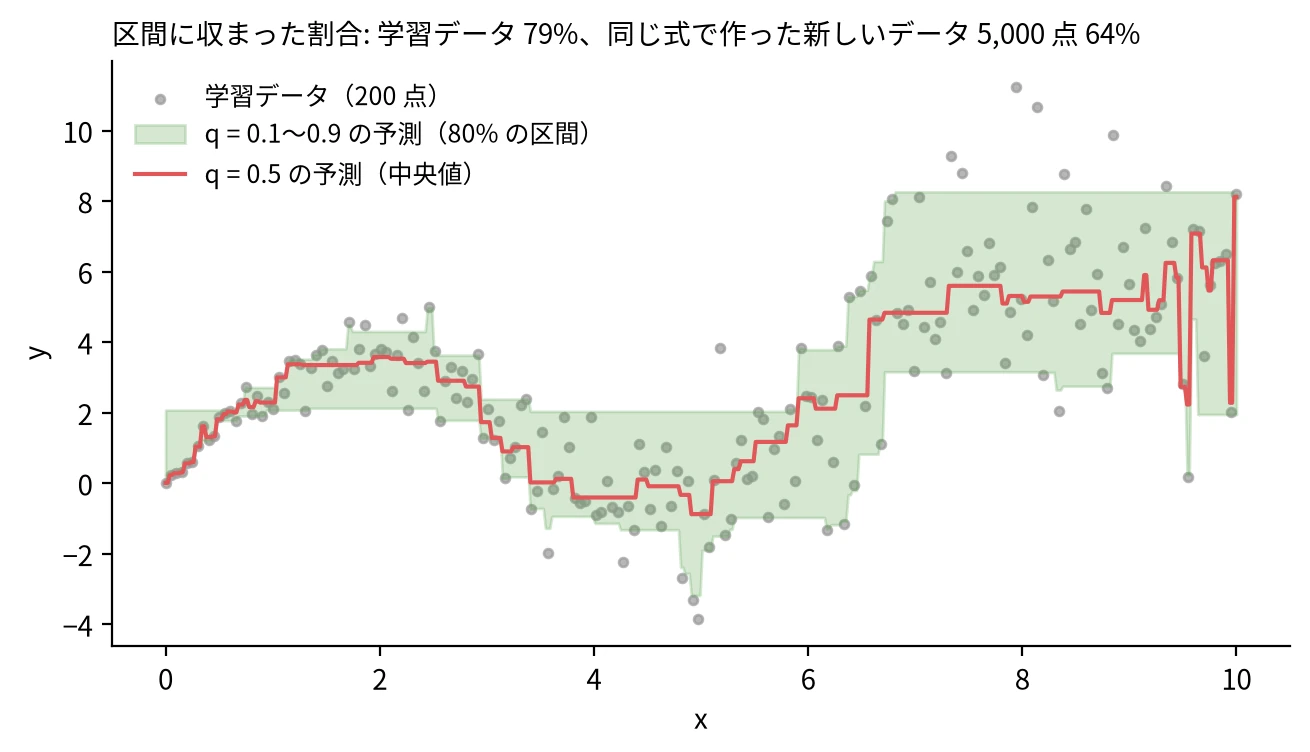
分位回帰で予測した中央値と、q = 0.1〜0.9 の区間
学習データでは狙い通り 79% が区間に入ったのに、新しいデータでは 64% でした。図の右端で帯が個々の点を追って尖っているように、200 点に合わせ込み過ぎた区間は、新しいデータには狭すぎます。分位回帰で作った区間は、学習に使っていないデータで、狙った割合が入るかを数えてから使います。
分位点で閾値を決める前に確かめること
推論サービングの応答時間のように p99 の目標を決める時や、異なるツールで出した分位点を突き合わせる時は、まず計算した関数を確認します。冒頭の図の 40 ms と 126 ms の差は、SQL では _disc か _cont か、DuckDB では quantile か quantile_cont かの違いでした。突き合わせる時は、ツールごとの既定の表の同じ行どうしで比べ、NumPy なら method を合わせます。
次に、1 回の集計に入る件数を見ます。p99 なら 100 件より少ない集計は、最大値か、その 1 つ手前との間を見ているのと同じで、1,000 件でも取り直すたびに 2 割近く動きました。集計の幅を広げて件数を増やすか、件数の足りる p90 などで見る方が落ち着きます。
複数のサーバーや時間帯をまとめる時は、分位点を平均せず、元の値かヒストグラムをまとめてから計算します。外れ値の閾値に四分位点を使う時は、応答時間のような右に長いデータでは裾の数 % が毎回拾われることを前提にします。異常検知のスコアの 99% 点を閾値にする時も、同じ件数の考え方が効きます。
冒頭の 10 個の応答時間では、どの関数も 9 番目の 40 ms と 10 番目の 900 ms の間の値を返しました。10 個しかないデータの p90 は、決め方を変えれば 40 ms にも 814 ms にもなる、というのが件数の足りない分位点の実際の姿です。