平均(算術平均、mean)は、全ての値を足して、値の個数で割った値です。機械学習では、列ごとの平均を引いてから学習する標準化、誤差の平均を小さくする損失関数、画像の画素からデータ全体の平均を引く前処理など、至る所で計算します。
以下は、scikit-learn に同梱の写真 2 枚を load_sample_images で読み込み、ランダムな位置で 224×224 画素を切り抜いて画像を作り、枚数を変えながら、R・G・B のチャンネルごとに画素の平均を NumPy で計算した結果です。画素の値は 255 で割って 0〜1 にし、深層学習で一般的な 32 ビットの浮動小数点数(float32)で持っています。
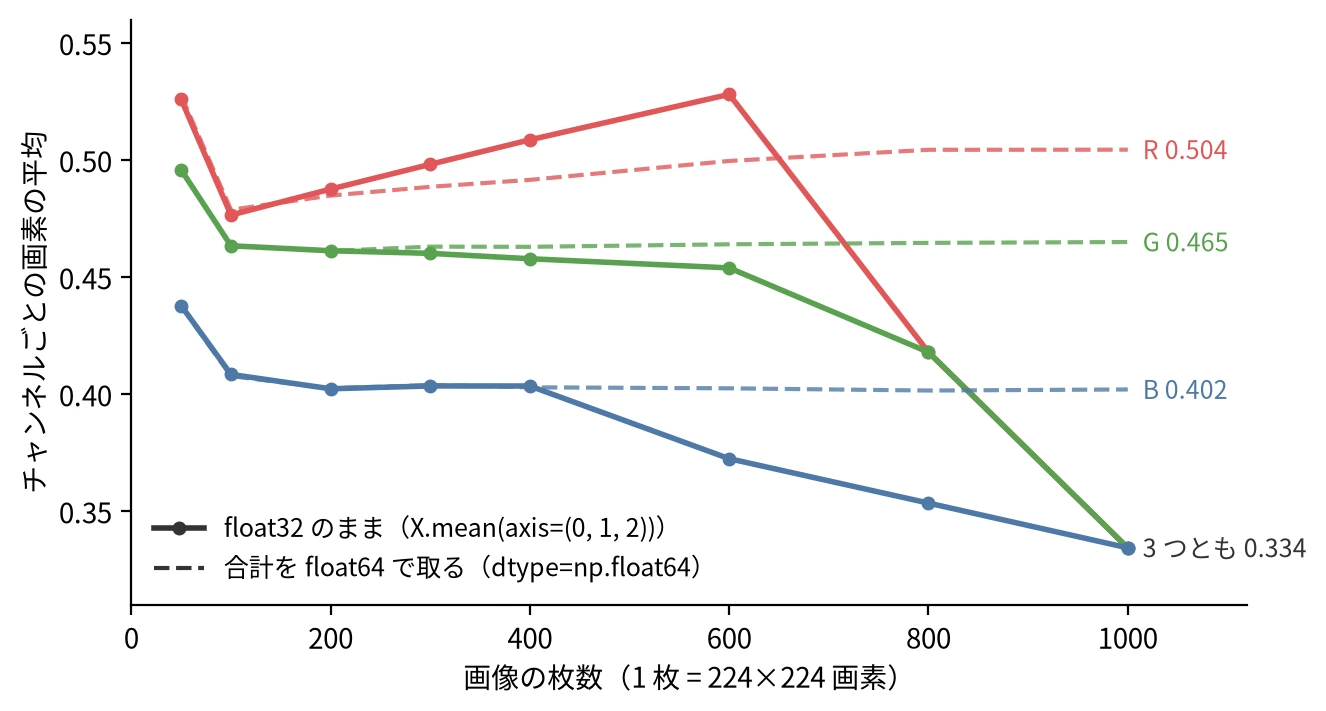
float32 のまま取ったチャンネルごとの平均と、合計を float64 で取った平均(NumPy 2.5.4)
合計を float64 で取ると、1000 枚でも R は 0.504、G は 0.465、B は 0.402 です。float32 のままだと数百枚から離れ始め、1000 枚では 3 つのチャンネルが全て 0.334 になりました。0.334 は、16,777,216 を 1 チャンネルの画素の数 50,176,000 で割った値で、写真の中身とは関係がありません。エラーも警告も出ません。
画像の学習では、画素からチャンネルごとの平均を引いて標準偏差で割る正規化を行います。PyTorch の torchvision の学習済みモデルは写真の画像分類のデータセット ImageNet の平均 [0.485, 0.456, 0.406] を使いますが、自分の画像では手元のデータの平均を計算することがあります。PyTorch のテンソルは既定で float32 なので、NumPy に渡して axis でチャンネルを指定して平均を取ると、図の実線の値を正規化に使うことになります。
本記事では、ML を学び始めた人と、手元のデータで平均を計算して前処理や比較に使う人に向けて、次の疑問に答えます。
- 平均は何を最小にする値で、1 つの値でどれだけ動くのか。
- float32 の合計は、なぜある所から増えなくなるのか。
- 同じ配列なのに、書き方で平均が変わるのはなぜか。
- 区画ごと・グループごとの平均を平均すると、なぜずれるのか。
- 速さの比のような比率は、どう平均すればよいのか。
実験は NumPy 2.5.4、pandas 3.1.1、scikit-learn 1.9.1 で行いました。図を描く処理も含めた完全なコードは mean_gen.py にあります。
合計を個数で割る値
n 個の値 x1, x2, ..., xn の平均は x_bar = (x1 + x2 + ... + xn) / n です。手元のデータから計算するこの値を標本平均と呼び、確率分布から決まる期待値 mu = E[X] と区別します。データを増やすと標本平均が期待値に近づく様子は、大数の法則と中心極限定理で扱っています。
平均は、データを 1 つの値 c で代表させた時の二乗誤差 (x1 - c)^2 + ... + (xn - c)^2 を最小にする c です。平均二乗誤差(MSE)の損失関数で回帰すると平均に近い値を予測し、決定木の回帰の葉が葉の中の平均を返すのも、この性質によります。絶対誤差を最小にするのは中央値で、2 つの最小点を並べた図は中央値のノートにあります。
平均は、1 つの値を大きくすれば、いくらでも動きます。n 個の平均が x_bar のデータに値 v を 1 つ足すと、平均は (v - x_bar) / (n + 1) だけ動きます。応答時間のように、たまに極端な値が混ざるデータの典型値を見るなら、分位点の p50 や p99 を使います。後の節で、実在のデータで 1 つの値が平均をどれだけ動かすかを見ます。
float32 の合計が増えなくなる所
NumPy の平均は、合計を個数で割って求めます。float32 のまま平均を取ると、合計も float32 で計算します。以下のコードは、全て 1.0 の float32 の値を 2000 万個並べた 2 列の行列で、列ごとの平均を取ります。2 列にしたのは、画像のチャンネルごとの平均と同じく、1 列の値がメモリの上で飛び飛びに並ぶ形にするためで、この形が効く理由は次の節で扱います。比べるために、同じ 2000 万個を 1 次元の配列にした場合と、1 つずつ順に足した途中の合計も見ます。
n = 20_000_000
ones = np.ones((n, 2), dtype=np.float32)  # 2 列の行列。1 列目だけを見る
print("2 列の行列の axis=0 の平均:", ones.mean(axis=0))
print("1 次元の配列の平均:", ones[:, 0].copy().mean())
running = np.cumsum(ones[:, 0])  # float32 で 1 つずつ順に足した途中の合計
print("途中の合計の最後:", running[-1], " 2**24 =", 2**24)
for v in [2.0**22, 2.0**23, 2.0**24, 2.0**25]:
    print(f"{v:>12,.0f} の隣の float32 との間隔: {np.spacing(np.float32(v))}")
2 列の行列の axis=0 の平均: [0.8388608 0.8388608]
1 次元の配列の平均: 1.0
途中の合計の最後: 1.6777216e+07  2**24 = 16777216
   4,194,304 の隣の float32 との間隔: 0.5
   8,388,608 の隣の float32 との間隔: 1.0
  16,777,216 の隣の float32 との間隔: 2.0
  33,554,432 の隣の float32 との間隔: 4.0
1.0 の平均は 1.0 のはずですが、2 列の行列の axis=0 の平均は 0.8388608 でした。1 つずつ順に足した合計は 2000 万ではなく 16,777,216 で止まっていて、0.8388608 はこれを 2000 万で割った値です。1 次元の配列の平均が 1.0 のままだった理由は次の節に回し、ここでは止まった合計を見ます。以下は、途中の合計を足した回数ごとに描いた図です。
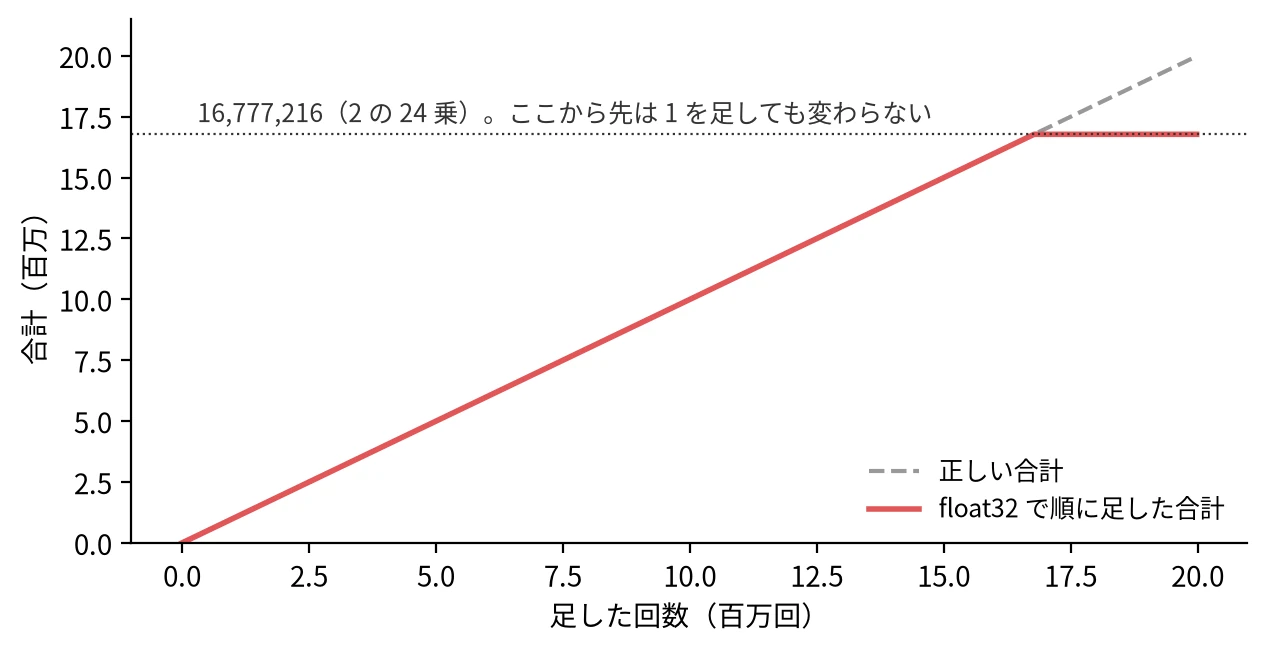
float32 で 1.0 を順に足した合計は、16,777,216 から増えない
float32 は、数値を 2 進数の 24 桁の有効数字と指数で表します。そのため、表せる数の間隔は値が大きくなるほど広がり、出力の通り、8,388,608(2 の 23 乗)から先は隣の数との間隔が 1、16,777,216(2 の 24 乗)から先は 2 になります。
16,777,216 に 1 を足した 16,777,217 は float32 では表せず、計算の結果は表せる数に丸められます。16,777,217 は 16,777,216 と 16,777,218 のちょうど中間です。浮動小数点数の規格の IEEE 754 が定める既定の丸めは、中間の値を 2 進数の有効数字の最後の桁が 0 になる側へ丸めます。16,777,216 は 2 の 24 乗なので有効数字の桁が全て 0 で、16,777,218 は最後の桁が 1 です。そのため 16,777,216 に戻ります。足しても変わらない合計が、2000 万回まで続きました。以下の図の上の段が、この丸めです。
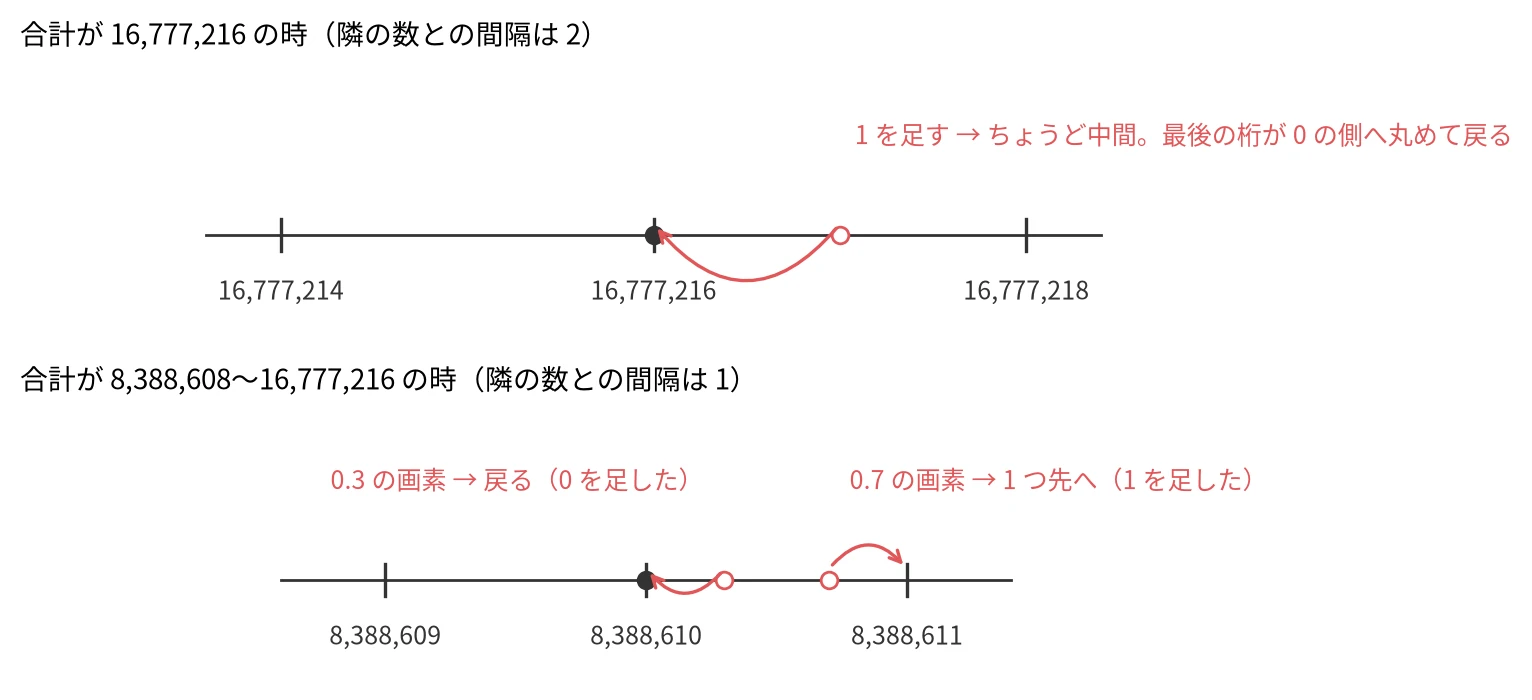
表せる数の間隔と、足した値の丸め
冒頭の画像に戻ると、画素の値は 1 以下です。合計が 16,777,216 に届くと、それ以上の画素を足しても合計は変わりません。1000 枚の 0.334 は、合計が 3 つのチャンネルとも 16,777,216 で止まった結果です。800 枚で R が G と同じ 0.418 に落ちるのも、R と G の合計が 16,777,216 で止まり、それを 800 枚の画素数 40,140,800 で割ったからです。
止まる手前でも、合計は正しく増えません。図の下の段のように、8,388,608〜16,777,216 では間隔が 1 なので、0.5 より大きい画素は 1 として、0.5 より小さい画素は 0 として足されます。600 枚の配列で、これを確かめたコードが以下です。
X600 = make_crops(600)  # (600, 224, 224, 3) の float32。切り抜きを作る関数は完全なコードにある
for c, ch in enumerate("RGB"):
    v = X600[..., c].ravel()
    cs = np.cumsum(v)  # axis=(0, 1, 2) の平均と同じく、float32 で順に足した途中の合計
    k = np.searchsorted(cs, 2**23)  # 合計が 8,388,608 を超えた位置
    after = v[k + 1:]  # その後に足した画素
    grown = float(cs[-1]) - float(cs[k])
    print(f"{ch}: 8,388,608 を超えた後に増えた量 {grown:.0f}、0.5 より大きい画素 {(after > 0.5).sum()} 個、"
          f"1 として足した割合 {(after > 0.5).mean():.3f}、値の平均 {after.mean():.3f}")
R: 8,388,608 を超えた後に増えた量 7510072、0.5 より大きい画素 7510072 個、1 として足した割合 0.558、値の平均 0.508
G: 8,388,608 を超えた後に増えた量 5278236、0.5 より大きい画素 5278236 個、1 として足した割合 0.447、値の平均 0.467
B: 8,388,608 を超えた後に増えた量 2824626、0.5 より大きい画素 2824626 個、1 として足した割合 0.310、値の平均 0.409
合計が 8,388,608 を超えた後に増えた量は、3 チャンネルとも 0.5 より大きい画素の数と一致しました。足された量を画素の数で割ると、1 として足した割合になります。以下は、この割合と、本当の値の平均を並べた図です。
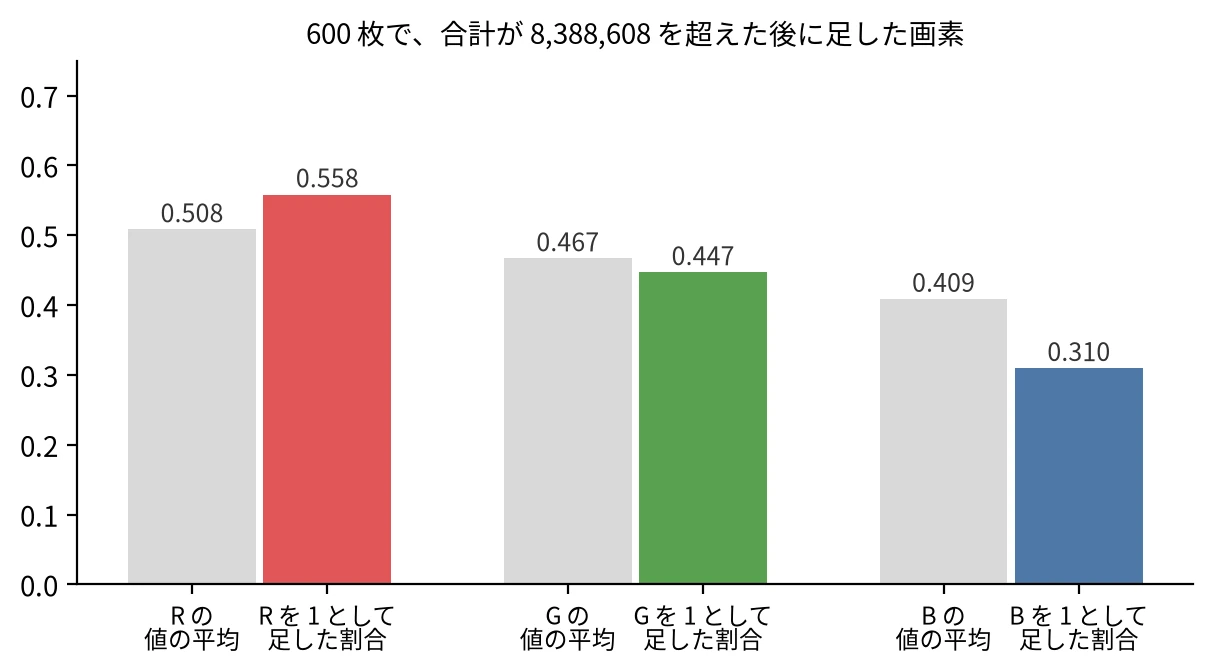
1 として足した割合と、本当の値の平均(600 枚)
R は、1 として足した割合 0.558 が本当の値の平均 0.508 より大きいので、平均が高くずれます。B は 0.310 が 0.409 より小さいので、低くずれます。冒頭の図の 600 枚で R が 0.528、B が 0.372 になったのは、このためです。
書き方で変わる平均
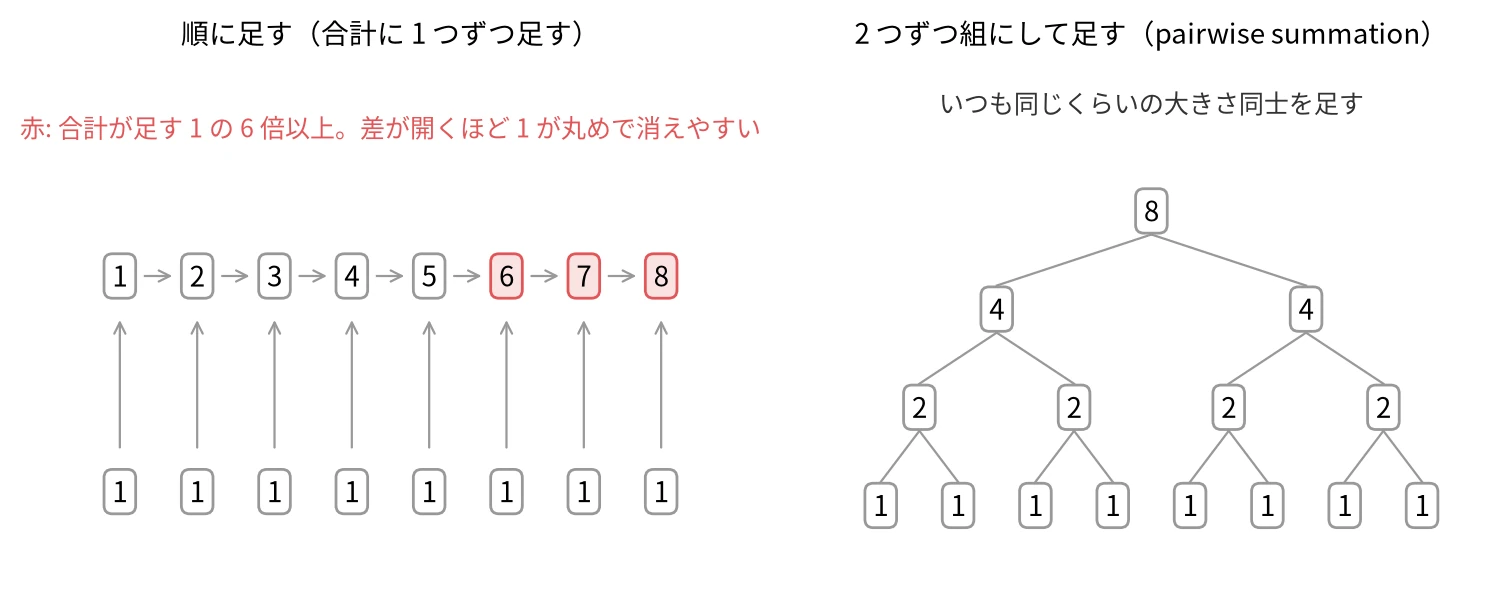
前の節で後に回した、1 次元の配列の平均が 1.0 のままだった理由です。numpy.sum の文書によると、NumPy は 1 つずつ順に足す代わりに、区間を分けて別々に合計してから足し合わせる pairwise summation を使います。以下は、8 個の 1 を 2 つの方法で足す様子を描いた図です。
順に足す場合と、2 つずつ組にして足す場合
図の左では、例として合計が足す 1 の 6 倍以上になった所を赤くしています。順に足すと、合計がどれだけ大きくなっても、足す値は 1 のままです。合計と足す値の差が開くほど、前の節のように足した値が丸めで消えます。組にして足すと、足す 2 つの数がいつも同じくらいの大きさなので、丸めで失う量が小さく済みます。
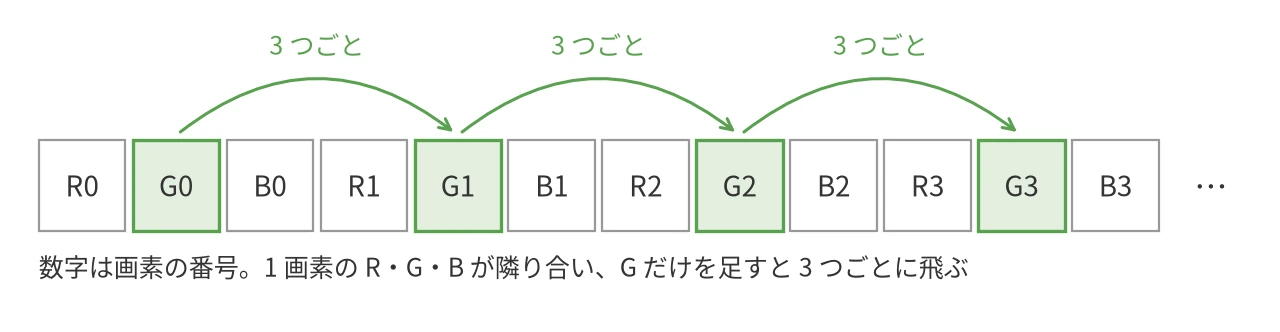
ただし、文書には「改善した精度は、メモリの上で連続した軸に沿って合計する時だけ使う」とあります。冒頭の画像の配列は (枚数, 224, 224, 3) の形で、メモリの上では以下の図のように 1 画素の R・G・B が隣り合って並びます。
画像の配列のメモリの上の並び
チャンネルごとの平均を取る X.mean(axis=(0, 1, 2)) は、3 つごとに離れた値を足していくので、順に足す方法になります。前の節の 2 列の行列の axis=0 も、1 列の値が 2 つごとに並ぶので同じで、1 次元の配列だけが pairwise summation で 1.0 になりました。
以下は、800 枚の配列で、G チャンネルの平均をいくつかの書き方で計算した結果です。flat は、同じ配列を (画素の数, 3) の形に並べ直したものです。
| 書き方 | G の平均 |
|---|---|
X.mean(axis=(0, 1, 2)) | 0.4180 |
X.mean(axis=(0, 1, 2), dtype=np.float64) | 0.4647 |
X[..., 1].mean() | 0.4647 |
np.ascontiguousarray(flat.T).mean(axis=1) | 0.4647 |
pd.DataFrame(flat).mean() | 0.4647 |
StandardScaler().fit(flat).mean_ | 0.4647 |
ずれたのは最初の書き方だけでした。2 行目は、合計を float64 で取る指定です。3 行目は G だけを取り出し、axis を付けずに平均を取るので、文書の通り pairwise summation が使われます。4 行目は、チャンネルごとに値が連続するように並べ直しています。
pandas の DataFrame は、同じ型の列をまとめて、列ごとに値が連続する形で持ちます。手元の pandas 3.1.1 で内部の配列を見ると、(列の数, 行の数) の形でした。そのため、列ごとの平均は連続した軸に沿った合計になります。
scikit-learn の StandardScaler は、平均を求める合計を float64 で取ります。scikit-learn のソースでその処理に付いたコメントは、NumPy の Issue #9393 を参照しています。この Issue は、画像の形の float32 の配列で axis=(0, 1, 2) の平均が 0.5 ではなく 0.102 になったという報告で、冒頭の図と同じ現象です。
np.mean の文書には、float32 の平均が不正確になる例として、1.0 と 0.1 を 512×512 個ずつ並べた配列の平均が 0.54999924 になる例が載っています。この例は axis を付けないので、手元の NumPy 2.5.4 では 0.55 になりました。文書の例で問題が見えないからといって、axis を付けた平均まで安全とは言えないということです。
平均の平均
ここまでは計算の誤差でした。ここからは、何を平均するかの取り違えです。scikit-learn に同梱の California Housing は、1990 年のアメリカの国勢調査から、カリフォルニア州の 20,640 の区画ごとに、所得や人口などを並べたデータです。AveOccup の列は、区画の人口を世帯の数で割った、1 世帯あたりの人数です。
house = fetch_california_housing(as_frame=True).frame
households = house["Population"] / house["AveOccup"]  # 区画ごとの世帯の数
occ = house["AveOccup"]
print(f"区画ごとの値の平均: {occ.mean():.3f}")
print(f"世帯の数で重みを付けた平均: {np.average(occ, weights=households):.3f}")
print(f"全人口 / 全世帯: {house['Population'].sum() / households.sum():.3f}")
top = occ.idxmax()
print(f"最大の区画: AveOccup {occ[top]:.1f}、人口 {house['Population'][top]:.0f}、世帯 {households[top]:.0f}")
print(f"最大の区画を除いた区画ごとの平均: {occ.drop(top).mean():.3f}")
区画ごとの値の平均: 3.071
世帯の数で重みを付けた平均: 2.854
全人口 / 全世帯: 2.854
最大の区画: AveOccup 1243.3、人口 7460、世帯 6
最大の区画を除いた区画ごとの平均: 3.011
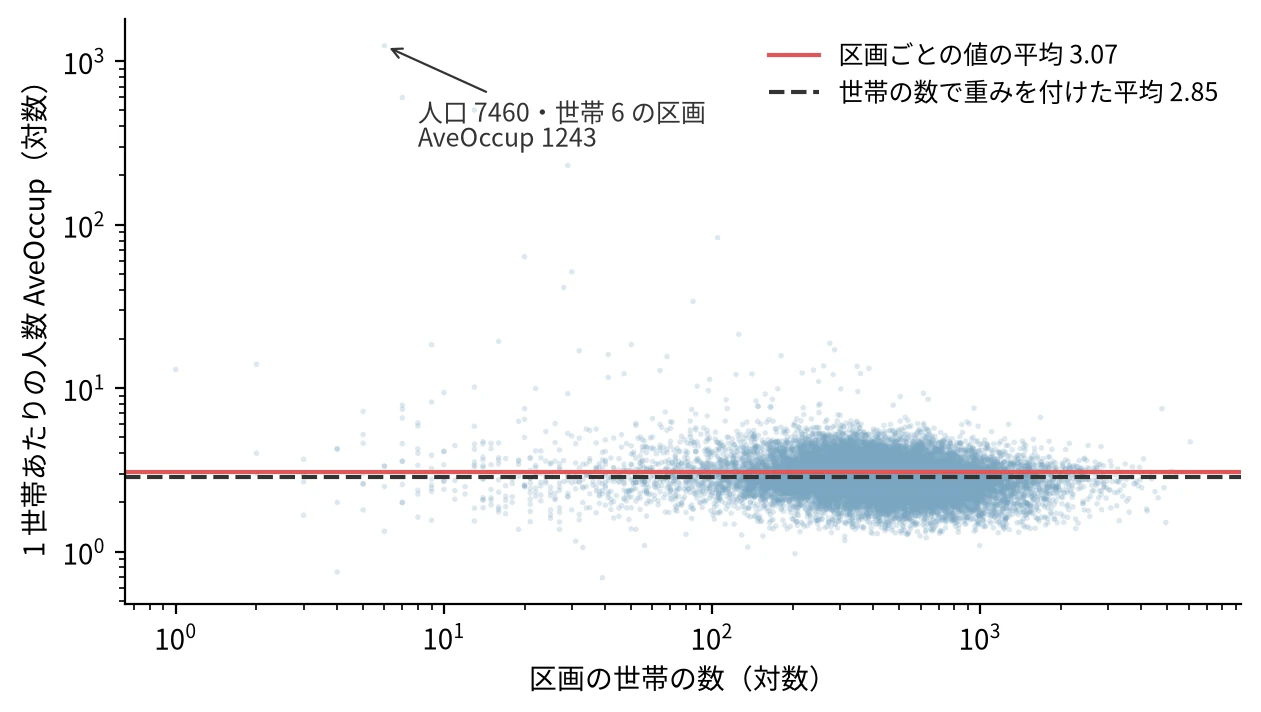
occ.mean() で区画ごとの値をそのまま平均すると 3.071 人です。州全体の 1 世帯あたりの人数は、全人口を全世帯で割った 2.854 人で、区画ごとの値に世帯の数で重みを付けた加重平均と一致します。以下は、区画ごとの世帯の数と AveOccup を並べた図です。
区画ごとの世帯の数と 1 世帯あたりの人数(California Housing)
世帯の数が少ない区画ほど、値が大きく外れます。最も大きい区画は、人口 7460 人に対して世帯が 6 つの区画で、AveOccup は 1243.3 です。区画ごとの平均では、6 世帯の区画も 1000 世帯の区画も同じ 1 票なので、この 1 区画だけで平均が 3.011 から 3.071 へ 0.06 上がりました。
この 0.06 は、最初の節の式 (v - x_bar) / (n + 1) で計算できます。この区画を除いた 20,639 区画が n、その平均 3.011 が x_bar、足す値 v が 1243.3 で、(1243.3 - 3.011) / 20,640 は 0.06 です。
同じ取り違えは、システムの監視や学習の記録でも起きます。サーバーごとの平均の応答時間を平均する時や、学習の損失を平均する時です。学習では、データを小分けにした塊(ミニバッチ)ごとに損失の平均を記録しますが、件数の少ない最後のミニバッチの平均も、他と同じ重さで平均すると全体の平均からずれます。全体の平均が欲しいなら、合計を足し合わせてから全体の個数で割るか、np.average の weights に個数を渡します。重みの違いは、グループごとの比較と全体の比較の向きを逆にすることもあり、同時分布・周辺分布・条件付き分布で UC Berkeley の出願のデータを使って確認しています。
比率の平均
比率を平均する時も、平均の取り方で結論が変わります。ここでは、2 つの方法で平均を計算する時間を要素の数ごとに測り、その時間の比を平均します。以下は、Python の組み込みの sum(lst) / len(lst) と NumPy の arr.mean() の時間を測ったコードです。要素の数は 10 個から 100 万個まで変えています。
rng = np.random.default_rng(0)
sizes = [10, 100, 1_000, 10_000, 100_000, 1_000_000]
t_py, t_np = [], []
for size in sizes:
    arr = rng.normal(1000, 10, size)
    lst = arr.tolist()
    num = max(1, 200_000 // size)
    t_py.append(min(timeit.repeat(lambda: sum(lst) / len(lst), number=num, repeat=7)) / num)
    t_np.append(min(timeit.repeat(lambda: arr.mean(), number=num, repeat=7)) / num)
t_py, t_np = np.array(t_py), np.array(t_np)
r = t_py / t_np  # 1 より大きければ Python の方が遅い
print(f"Python / NumPy の算術平均: {r.mean():.2f}")
print(f"NumPy / Python の算術平均: {(1 / r).mean():.2f}")
print(f"Python / NumPy の幾何平均: {np.exp(np.log(r).mean()):.2f}")
print(f"NumPy / Python の幾何平均: {np.exp(np.log(1 / r).mean()):.2f}")
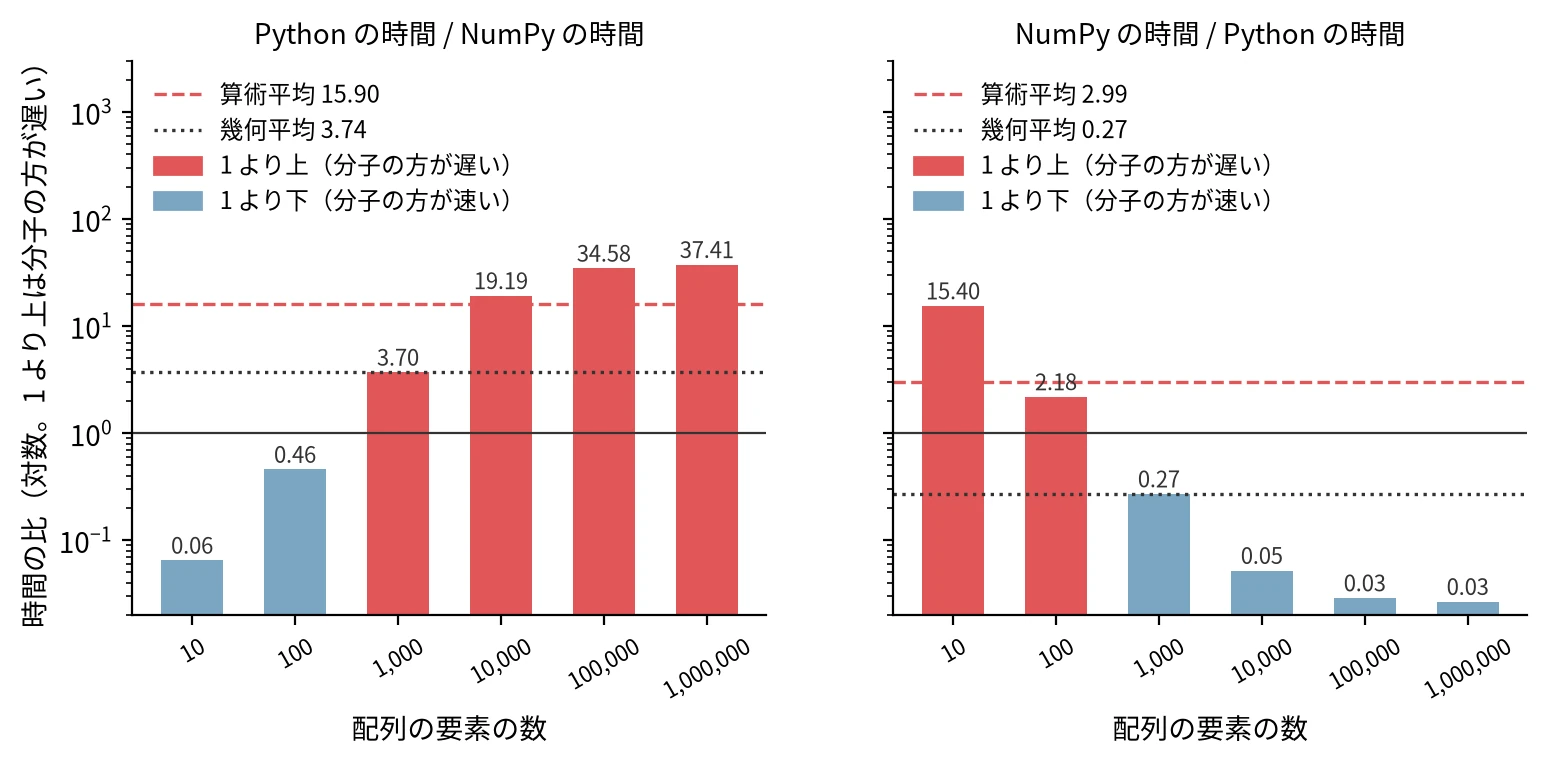
Python の時間を NumPy の時間で割った比を算術平均すると 10 倍を超え、「Python は平均で 10 倍以上遅い」と言えます。同じ測定を逆に割って算術平均しても 1 を超え、「NumPy の方が平均で遅い」とも言えてしまいます。以下は、要素の数ごとの比を 2 通りの向きで並べた図で、赤い棒は比が 1 より上で分子の方が遅く、青い棒は 1 より下で分子の方が速いことを表します。
要素の数ごとの時間の比と、その算術平均・幾何平均(著者の環境で測定)
算術平均は、大きい比に引っ張られます。左では 1,000 個以上の大きな比が、右では 10 個と 100 個の赤い棒が平均を押し上げ、どちらの向きでも「分子の方が遅い」になりました。
比の対数を平均してから戻す幾何平均なら、2 つの向きの値は互いの逆数で、どちらの向きで割っても「Python が数倍遅い」という同じ結論になります。ベンチマークの比を幾何平均でまとめる理由は、Fleming と Wallace の論文「How not to lie with statistics: the correct way to summarize benchmark results」(1986 年)が論じています。
図を描いた回の数値と条件
時間は timeit.repeat を 7 回繰り返した最小値で、著者の PC で NumPy 2.5.4 と Python 3.12.12 を使いました。他の処理の負荷で、実行のたびに数値は変わります。図を描いた回の出力は次の通りです。
Python / NumPy の算術平均: 15.90
NumPy / Python の算術平均: 2.99
Python / NumPy の幾何平均: 3.74
NumPy / Python の幾何平均: 0.27
速さそのもの、例えば 1 秒あたりに処理するデータの量を平均する時は、もう 1 つの取り違えがあります。同じ量のデータを 100 MB/s で 1 回、10 MB/s で 1 回処理した時の平均の速さは、2 回の合計の量を合計の時間で割った 18.2 MB/s で、算術平均の 55 MB/s ではありません。この値は、逆数を平均してから戻す調和平均 2ab / (a + b) です。
混同行列で扱う F1 が適合率(Precision)と再現率(Recall)の調和平均なのも、どちらか一方が低ければ全体も低く出るようにするためです。
平均を取る前に確かめること
float32 の配列で平均を取る前に、合計がどこまで大きくなるかを見積もります。値の大きさと個数を掛けた合計が 16,777,216 に近づくなら、dtype=np.float64 を付けるか、平均を取る軸がメモリの上で連続しているかを確かめます。画像のチャンネルごとの平均は、冒頭の図のように、数百枚で既にずれ始めます。
次に、何の平均が欲しいのかを決めます。区画やサーバーやバッチごとの平均を平均すると、個数の少ないグループも同じ重さで数えます。全体の平均が欲しいなら、個数で重みを付けます。比率なら幾何平均、同じ量の仕事の速さなら調和平均が、取り違えの少ない選び方です。
最後に、平均がデータの典型値を表しているかを見ます。California Housing の 1 区画のように、1 つの値で平均は動きます。偏った分布の典型値は中央値で、ばらつきは分散や標準偏差で見ます。平均を正規化に使う前は、冒頭の図の破線のように float64 で計算し直した値と一度比べておけば、0.334 のような値を見逃しません。