カーネル密度推定(Kernel Density Estimation, KDE)は、データ点の集まりから滑らかな分布の曲線を推定する手法です。各データ点に小さな山(カーネル)を置き、全ての山を足して全体の形を作ります。山の広がりをバンド幅(bandwidth)と呼び、曲線の見え方はほぼこの値で決まります。
バンド幅を自分で決めずに済むよう、scipy の gaussian_kde、seaborn の kdeplot、scikit-learn の KernelDensity は、どれも "scott" という文字列を受け付けます。Scott の規則という同じ名前の決め方なので、同じデータに渡せば同じ曲線になりそうです。
scikit-learn に同梱の load_breast_cancer は、乳房の腫瘍 569 件について、細胞核の画像から測った値を 30 列並べたデータです。そのうち細胞核の面積(mean area)と輪郭の凹み(mean concavity)の 2 列に、scipy と scikit-learn で同じ "scott" を渡しました。
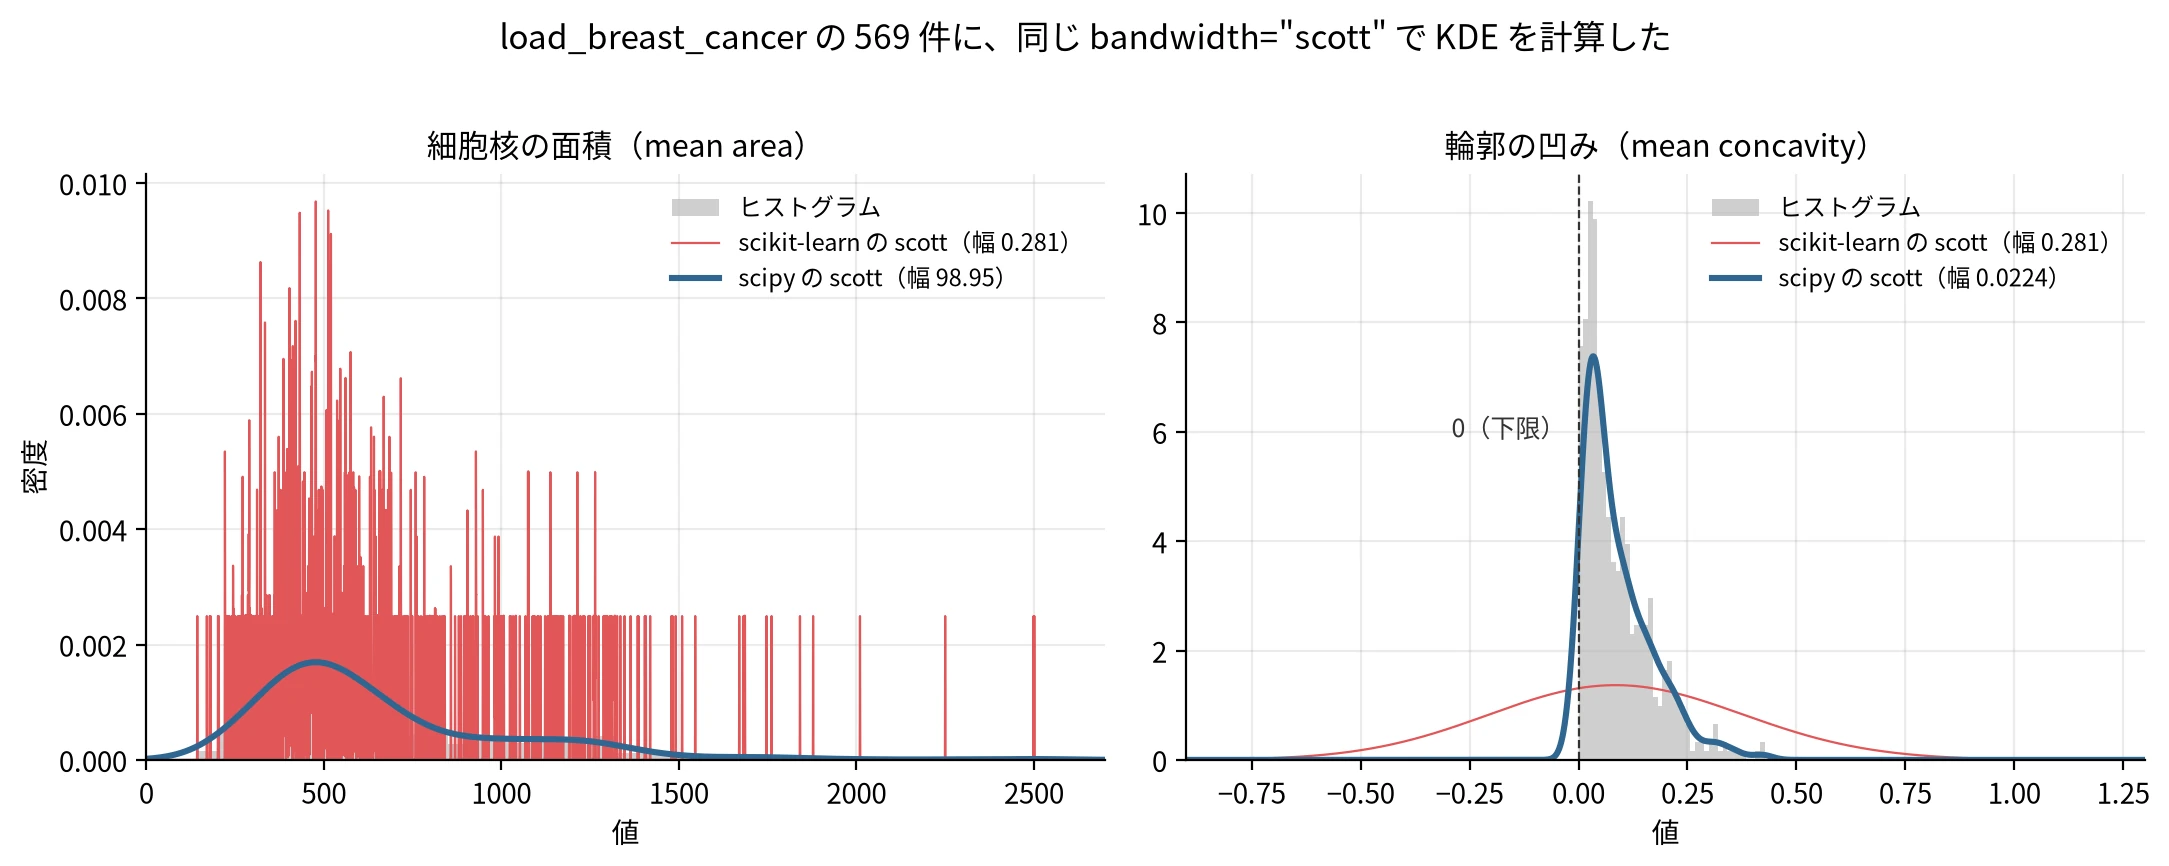
同じ bandwidth=“scott” を渡した scipy と scikit-learn の KDE
mean area では、scipy の幅が 98.95、scikit-learn の幅が 0.281 で、352 倍違いました。scikit-learn の曲線は 569 件の点ごとに尖り、0.05 刻みで評価して山を数えると 395 個ありました。mean concavity では逆に scikit-learn の幅が 12.5 倍広く、負にならない値なのに曲線の面積の 38% が 0 未満に出ました。どちらもエラーや警告は出ません。
KernelDensity は点ごとの密度を返し、学習したデータに似た新しい点も引けます。そのため、seaborn で描いた形を見て特徴量を選び、同じ列を KernelDensity に渡して異常検知やデータの生成に使う時に、この違いに出会います。曲線の形を見ずにスコアだけを使うと、別の分布を推定していることに気付けません。
本記事では、ML の説明に出てくる KDE を自分で計算して確認したい人と、scikit-learn や seaborn で手元のデータに KDE を使う人に向けて、次の疑問に答えます。
- KDE は、1 点ずつ何を足して曲線を作るのか。
- バンド幅を変えると、山の数はどう変わるのか。
- 規則で決める幅と、交差検証で選ぶ幅はどれだけ違うのか。
- scikit-learn の
"scott"は、scipy と何が違うのか。 - 0 が下限の値では、曲線のどこが誤るのか。
- 診断ごとに重ねた曲線は、どう読めばよいのか。
実験は scikit-learn 1.9.1、SciPy 1.18.1、seaborn 0.13.2 で行いました。図を描く処理も含めた完全なコードは kde_gen.py にあります。
1 点ずつのカーネルの和
KDE の式は次の通りです。
f(x) = (1 / (n * h)) * Σ K((x - x_i) / h)
n はデータ点の数、x_i は各データ点、h はバンド幅、K はカーネル関数です。カーネル関数は面積が 1 の山で、ガウス関数が最も一般的です。
ガウスカーネルなら、各データ点 x_i に中心が x_i、標準偏差が h の正規分布を置き、全部足してから n で割る操作です。標準正規分布から引いた 15 点で、h = 0.5 の KDE を計算します。
sample = np.random.default_rng(5).normal(0, 1, 15)
xs = np.linspace(-4, 4, 400)
h = 0.5
kde = np.zeros_like(xs)
for xi in sample:
    k = np.exp(-0.5 * ((xs - xi) / h) ** 2) / (h * np.sqrt(2 * np.pi))
    kde += k / len(sample)  # 1 点分のカーネルを n で割って足す
print(f"面積: {np.trapezoid(kde, xs):.3f}")
面積: 1.000
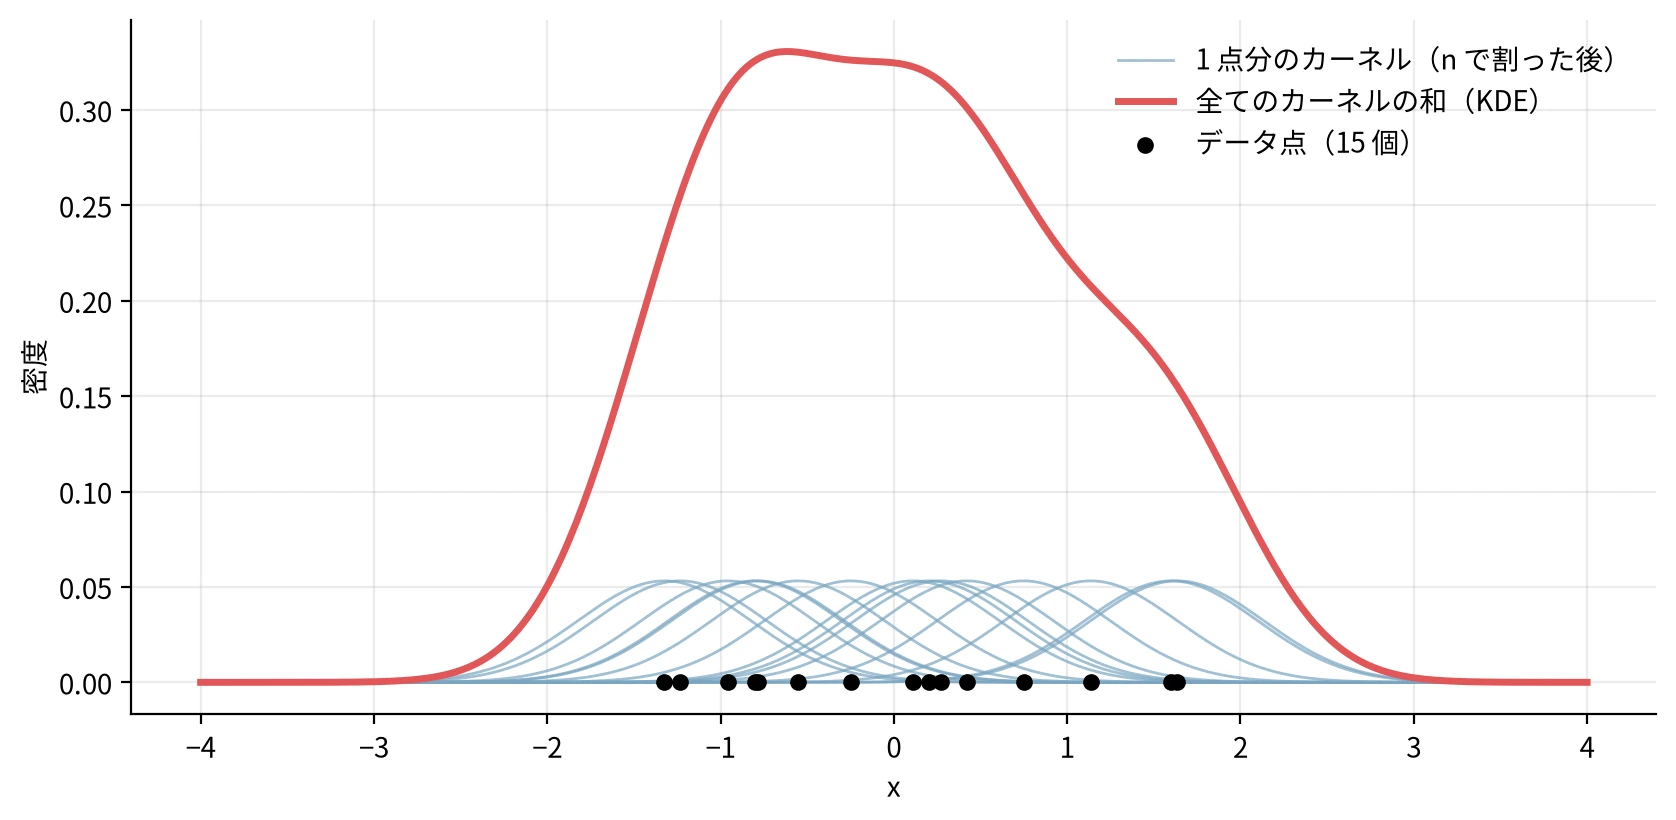
1 点ごとのカーネルと、その和の KDE
点が密集している所では青いカーネルが重なるため、赤い曲線が高くなります。各カーネルの面積が 1 なので、n で割って足した曲線の面積も 1 になり、出力は確率密度関数として読めます。
バンド幅と山の数
冒頭の図で曲線の形を変えたのは、この h だけです。中心が -2 と 2 の正規分布から 200 点ずつ引いた 2 峰性のデータで、h を 3 通りに変え、曲線の山の数を scipy.signal.find_peaks で数えます。gaussian_kde の bw_method に数値を渡すと、データの標準偏差に掛ける倍率として扱われるので、h を標準偏差で割って渡します。gaussian_kde は標準偏差を n - 1 で割って求めるので、コードも std(ddof=1) で揃えます。
rng = np.random.default_rng(0)
data = np.concatenate([rng.normal(-2.0, 0.8, 200), rng.normal(2.0, 0.8, 200)])
xs = np.linspace(-5, 5, 400)
for h in [0.1, 0.5, 2.0]:
    kde = stats.gaussian_kde(data, bw_method=h / data.std(ddof=1))
    peaks, _ = find_peaks(kde(xs))
    print(f"h={h}: 山の数 {len(peaks)}")
h=0.1: 山の数 15
h=0.5: 山の数 2
h=2.0: 山の数 1
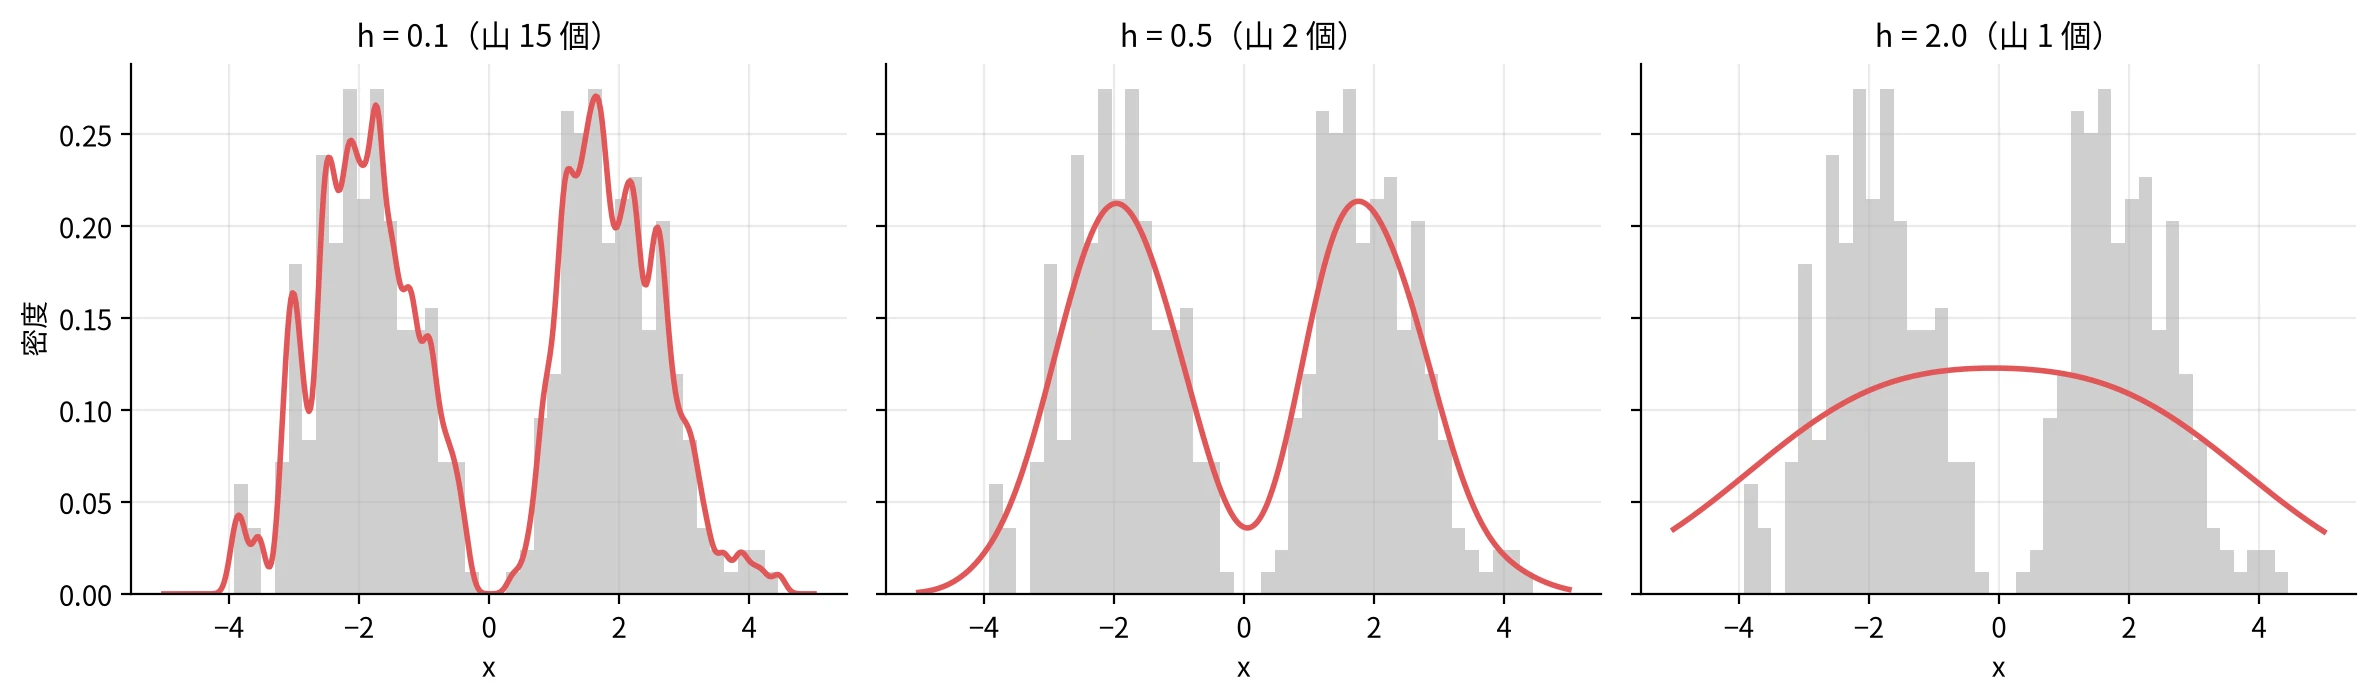
バンド幅 h による KDE の形の違い
h = 0.1 では個々の点の小山が残り、元の分布に無い山が 15 個現れます。これを過小平滑(under-smoothing)と呼び、冒頭の mean area の赤い曲線はこの状態です。h = 2.0 では 2 つの山が 1 つに潰れ、2 峰性が見えなくなります。これを過剰平滑(over-smoothing)と呼び、mean concavity の赤い曲線がこの状態です。
カーネルの形も選べます。KernelDensity はガウスの他に、範囲が有限の Epanechnikov や箱型の tophat などを持ちます。scipy のドキュメントにも、推定への影響はカーネルの形よりバンド幅の方がはるかに大きいとあり、特別な理由が無ければガウスで十分です。
規則で決める幅と交差検証で選ぶ幅
h を決める代表的な方法は次の 3 つです。σ はデータの標準偏差、d は次元数です。
| 決め方 | h |
|---|---|
Scott の規則("scott") | σ * n^(-1/(d+4)) |
gaussian_kde の "silverman" | 1 次元では 1.06 * σ * n^(-1/5) |
| 交差検証 | 検証用のデータで対数尤度が最も大きい値 |
1 次元の Scott の規則は σ * n^(-1/5) なので、"silverman" は Scott の 1.06 倍で、ほぼ同じ値になります。
"silverman" の名前は Silverman の本に由来します。ただし、本で勧めている式は四分位範囲も使う 0.9 * min(σ, IQR / 1.34) * n^(-1/5) で、scipy の "silverman" とは係数が違います。ここでは、scipy で文字列を渡すだけで使える "scott" と "silverman" の 2 つを比べます。
交差検証で使う対数尤度は、検証用の各点で曲線の高さを取り、その対数を足した値です。検証用の点が多く集まる所で曲線が高いほど、大きくなります。
同じ 2 峰性のデータで、規則による値と、KernelDensity を 5 分割の交差検証で選んだ値を比べます。gaussian_kde の factor は、前の節で bw_method に渡した倍率と同じもので、文字列を渡すと規則で決まった倍率が入ります。これに標準偏差を掛けると h になります。
交差検証には GridSearchCV を使います。400 点を 5 つに分け、80 点ずつを検証用にして、残りの 320 点で KDE を作ります。KernelDensity の score は検証用の点の対数尤度の和を返すので、GridSearchCV はその 5 回の平均が最も大きい h を選びます。
for rule in ["scott", "silverman"]:
    kde = stats.gaussian_kde(data, bw_method=rule)
    h = kde.factor * data.std(ddof=1)
    print(f"{rule}: h={h:.2f}, 山の数 {len(find_peaks(kde(xs))[0])}")

hs = np.arange(0.05, 2.01, 0.05)
grid = GridSearchCV(
    KernelDensity(),
    {"bandwidth": hs},
    cv=KFold(5, shuffle=True, random_state=0),
).fit(data[:, None])
h_cv = grid.best_params_["bandwidth"]
print(f"交差検証: h={h_cv:.2f}")
scott: h=0.64, 山の数 2
silverman: h=0.68, 山の数 2
交差検証: h=0.25
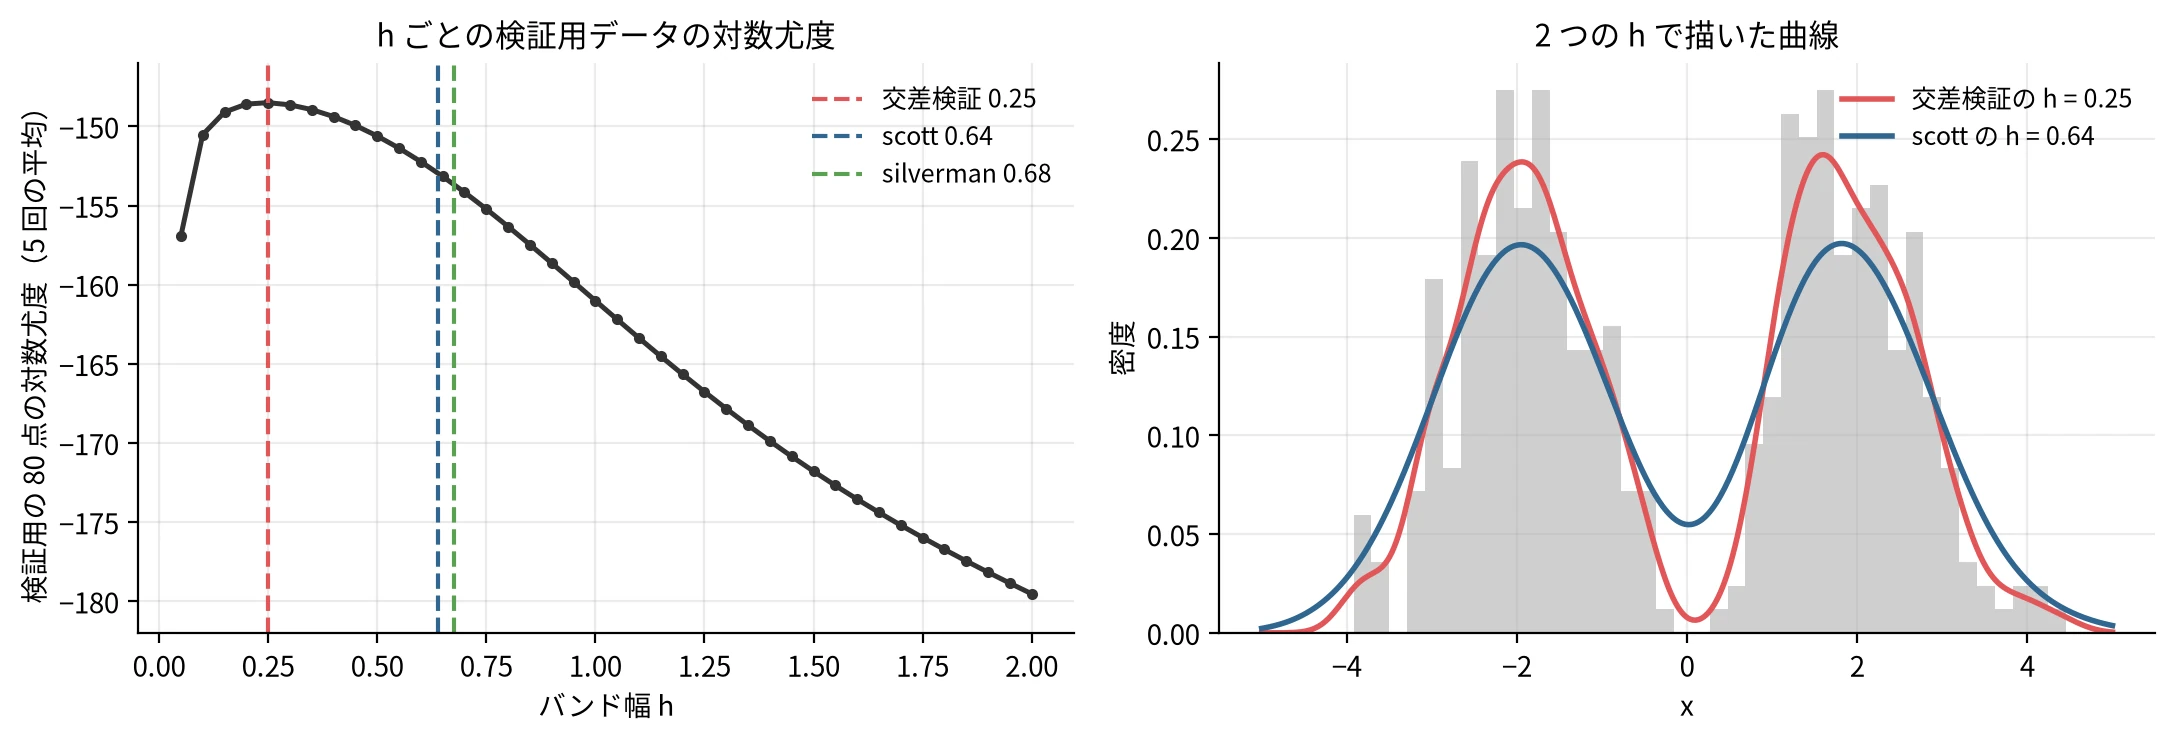
交差検証の対数尤度と、2 つの h で描いた曲線
規則の値は交差検証の約 2.5 倍です。規則が使う σ には 2 つの山の間の距離も含まれるので、幅が広めに出ます。scipy のドキュメントも、規則は単峰の分布向けで、多峰の分布は平滑しすぎる傾向があると書いています。
今回は規則の値でも山は 2 つ残り、右の図の青い曲線のように谷が浅くなっただけでした。交差検証の値も分割で動き、random_state を 0〜2 にすると 0.20〜0.30 でした。どちらの決め方でも、1 つの値に決め打ちせず、曲線を何本か描いて山の数と位置が保たれるかを見ます。
scikit-learn の “scott” は標準偏差を掛けない
規則の式の σ を思い出すと、冒頭の違いの原因が分かります。scikit-learn 1.9.1 の KernelDensity の実装は、"scott" の幅を n^(-1/(d+4)) とし、σ を掛けていません。569 件の 1 列なら、どの列でも 569^(-1/5) = 0.281 です。
load_breast_cancer の 30 列について、列の標準偏差に対して scipy の幅と scikit-learn の幅を並べました。
X = cancer.data
n, d = X.shape
h_scipy = np.array([stats.gaussian_kde(X[:, j]).factor * X[:, j].std(ddof=1) for j in range(d)])
h_sklearn = KernelDensity(bandwidth="scott").fit(X[:, :1]).bandwidth_
print(f"n^(-1/5) = {n ** (-1 / 5):.3f}、scikit-learn の幅 {h_sklearn:.3f}")
for col in ["mean area", "mean concavity"]:
    j = names.index(col)
    print(f"{col}: scipy {h_scipy[j]:.3f}  scikit-learn {h_sklearn:.3f}  比 {h_scipy[j] / h_sklearn:.3g}")
n^(-1/5) = 0.281、scikit-learn の幅 0.281
mean area: scipy 98.950  scikit-learn 0.281  比 352
mean concavity: scipy 0.022  scikit-learn 0.281  比 0.0797
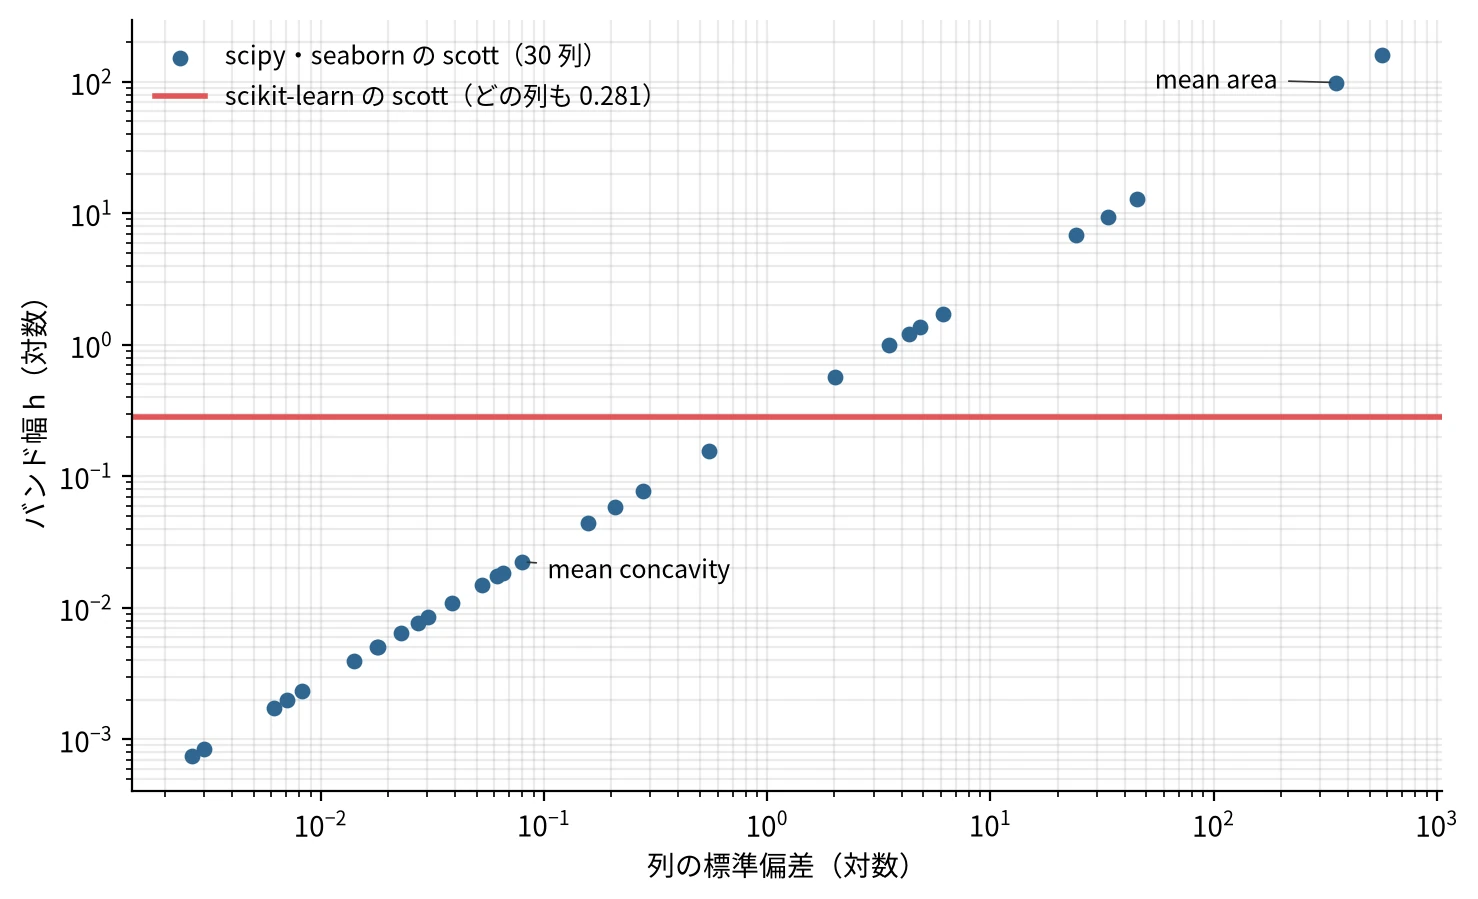
列の標準偏差と、scott で決まるバンド幅
scipy の幅は列の標準偏差に比例し、点が右上がりの直線に並びます。scikit-learn の幅は 0.281 の水平な線で、列の散らばりを見ません。標準偏差が 1 より大きい列では幅が狭すぎて冒頭の mean area のように尖り、1 より小さい列では広すぎて mean concavity のように潰れます。
seaborn の kdeplot は内部で scipy の gaussian_kde を呼ぶので、曲線は scipy と一致します。scikit-learn の "scott" を scipy と揃えるには、列を平均 0・標準偏差 1 に揃える標準化をしてから渡します。
ax = sns.kdeplot(x=area)                                    # seaborn の曲線
line_x, line_y = ax.lines[0].get_data()
print("seaborn と scipy の差の最大:", np.abs(line_y - stats.gaussian_kde(area)(line_x)).max())

z = StandardScaler().fit_transform(area[:, None])            # 平均 0・標準偏差 1 にしてから使う
sk_z = KernelDensity(bandwidth="scott").fit(z)
xs = np.arange(0, 3000, 0.05)                               # 0.05 刻みで曲線を評価する
u = (xs - area.mean()) / area.std()                         # 評価する点も標準化した軸へ移す
y_z = np.exp(sk_z.score_samples(u[:, None])) / area.std()   # 標準化した軸の密度を元の単位に戻す
print(f"標準化してから: 幅(元の単位){sk_z.bandwidth_ * area.std():.2f}  山の数 {len(find_peaks(y_z)[0])}")
print(f"  scipy との差の最大 {np.abs(y_z - stats.gaussian_kde(area)(xs)).max():.1e}")
seaborn と scipy の差の最大: 0.0
標準化してから: 幅(元の単位)98.86  山の数 2
  scipy との差の最大 4.5e-07
標準化した軸では、値が標準偏差 1 つ分で 1 進みます。そのため、標準化した軸の密度を元の単位の密度に戻すには、標準偏差で割ります。最後の 2 行はこの換算です。
標準化した後の幅は元の単位で 98.86 で、scipy の 98.95 との差は、標準偏差を n で割るか n - 1 で割るかの違いです。曲線の差も最大で 4.5e-07 で、山の数も scipy と同じ 2 個になりました。
KernelDensity は、学習したデータの密度を score_samples で返し、sample で新しい点を引けます。密度の低い点を異常とする異常検知や、scikit-learn の例のような手書き数字の生成はこの 2 つを使います。どちらも幅を間違えると、針の列か潰れた山から点数や新しい点を出すことになります。
なお、KernelDensity の既定は bandwidth=1.0 の固定値で、これも列の単位を見ません。2 列以上を渡すと、全ての列に同じ幅のカーネルを置くので、列ごとの単位の違いがそのまま曲線の形に出ます。どちらの場合も、標準化してから渡すのが安全です。
0 が下限の列
scipy の幅を使っても、mean concavity には別の誤りが残ります。輪郭に凹みが無い細胞核は 0 になり、負の値は取りません。ところがガウスカーネルは 0 の近くの点にも左右対称に置かれるので、山の左半分が 0 未満にはみ出します。
kde = stats.gaussian_kde(concavity)
print(f"幅 {kde.factor * concavity.std(ddof=1):.4f}、0 未満にはみ出した面積 {kde.integrate_box_1d(-np.inf, 0):.3f}")
counts, _ = np.histogram(concavity, bins=[0, 0.01, 0.02])
print("0〜0.01 のヒストグラムの密度:", round(counts[0] / len(concavity) / 0.01, 2))
reflected = lambda t: kde(t) + kde(-t)                       # 0 で折り返して足す(t >= 0 で使う)
print(f"x=0 の密度: KDE {kde(0)[0]:.2f}  折り返し {reflected(0)[0]:.2f}")
幅 0.0224、0 未満にはみ出した面積 0.075
0〜0.01 のヒストグラムの密度: 7.38
x=0 の密度: KDE 4.18  折り返し 8.36
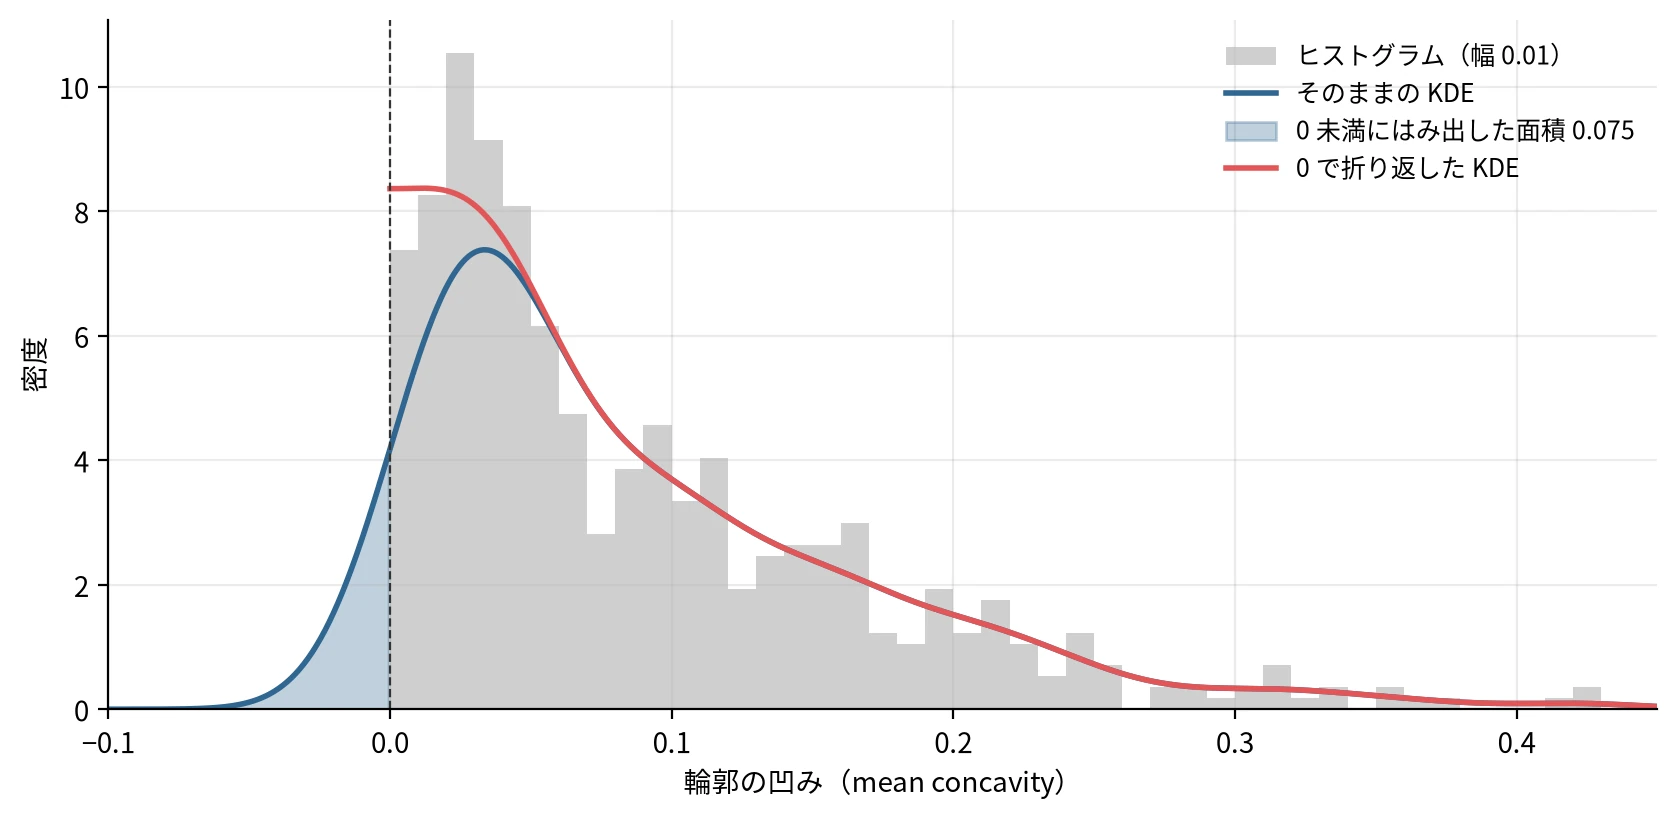
0 が下限の mean concavity で、はみ出した面積と、0 で折り返した KDE
曲線の面積の 7.5% が、ありえない負の値に置かれました。その分 0 の近くの密度が低く出て、0 での高さは 4.18 と、0〜0.01 のヒストグラムの 7.38 の 6 割ほどです。この曲線で「凹みがほぼ無い細胞核は珍しい」と読むと誤ります。
直し方の 1 つは、0 未満にはみ出した分を 0 で折り返して足す反射法です。赤い曲線は 0 以上だけで面積が 1 になり、0 での高さは 8.36 と、ヒストグラムに近づきました。
金額・待ち時間・個数のように下限がある値も、同じ補正をします。0 を含まない正の値なら、対数を取ると下限が無くなるので、対数の軸で KDE を計算する方法もあります。mean concavity のように 0 ちょうどの値を含む列では対数が取れないので、折り返しを使います。
診断ごとの曲線を重ねて読む
KDE は、クラスごとに描いて重ねる使い方もよくします。load_breast_cancer の mean area を良性 357 件と悪性 212 件に分け、2 本の曲線が交わる mean area の値を求めました。
malignant = area[cancer.target == 0]   # 悪性 212 件
benign = area[cancer.target == 1]      # 良性 357 件
kde_m, kde_b = stats.gaussian_kde(malignant), stats.gaussian_kde(benign)
a = np.linspace(100, 2600, 2501)
diff_density = kde_m(a) - kde_b(a)
diff_count = len(malignant) * kde_m(a) - len(benign) * kde_b(a)
print("密度が逆転する mean area:", a[np.flatnonzero(np.diff(np.sign(diff_density)))])
print("件数が逆転する mean area:", a[np.flatnonzero(np.diff(np.sign(diff_count)))])
密度が逆転する mean area: [670.]
件数が逆転する mean area: [708.]
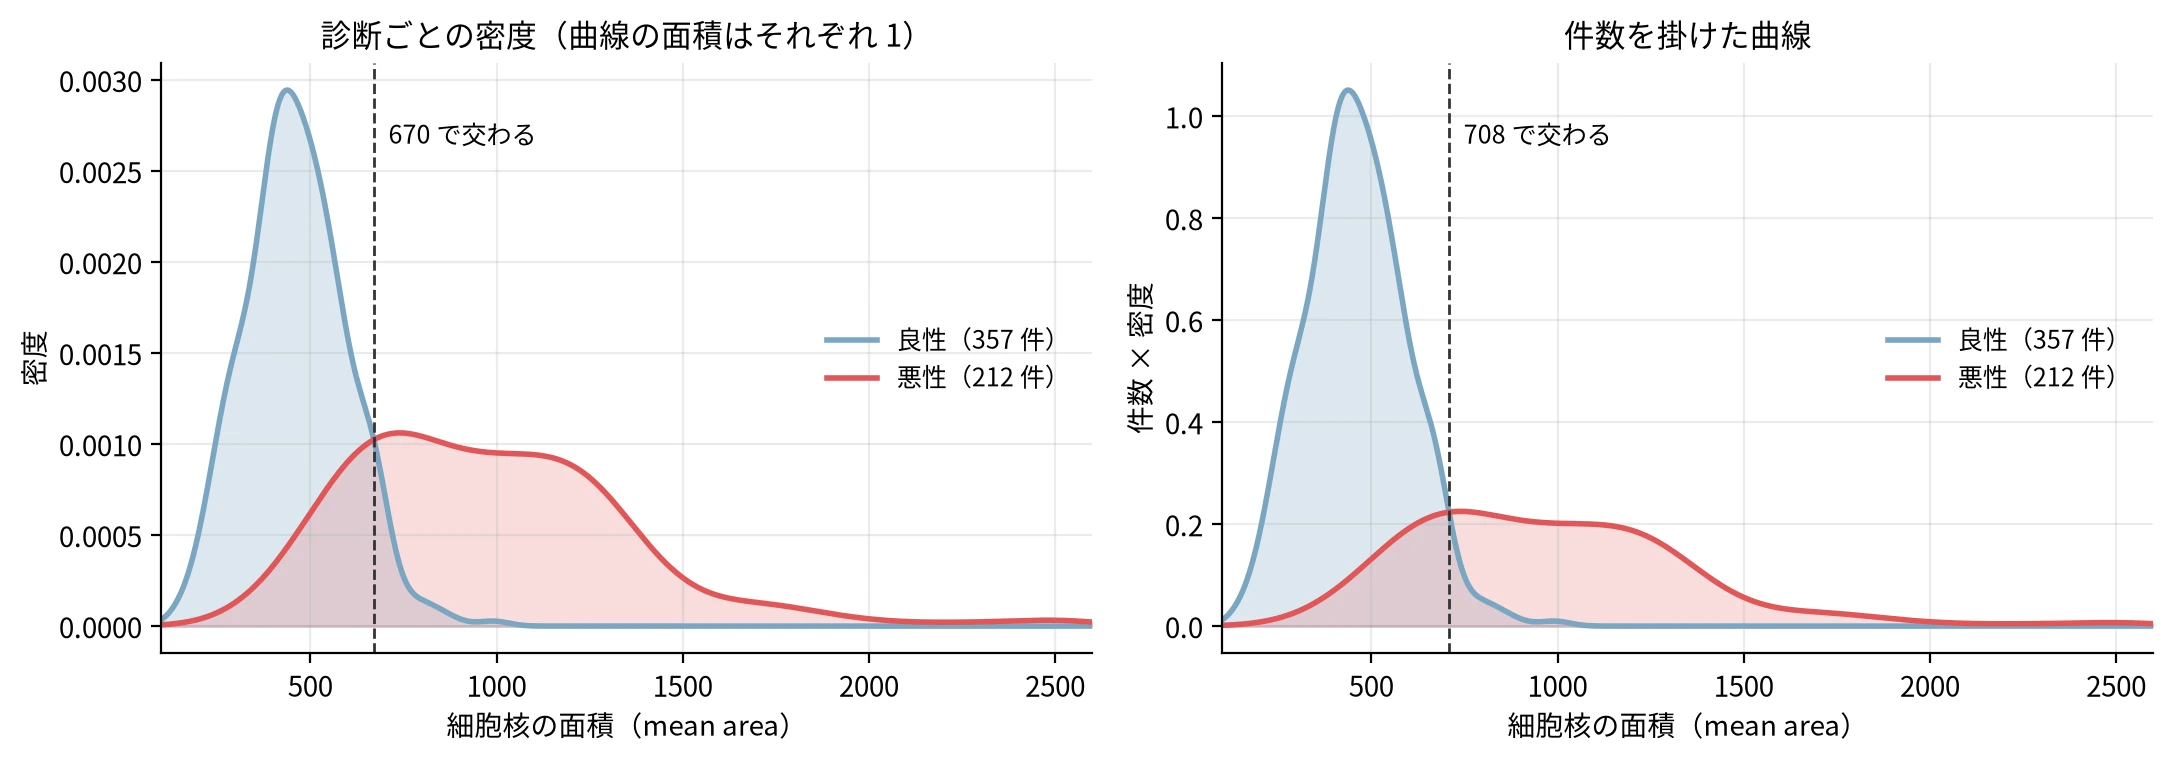
診断ごとの mean area の KDE と、件数を掛けた曲線
悪性は mean area の大きい側に寄っていますが、400〜900 では 2 本が重なり、mean area だけでは分けきれません。
2 本の曲線は、それぞれの診断の中で曲線の面積を 1 にしています。赤が青を上回るのは 670 からですが、悪性の件数が良性を上回るのは 708 からでした。良性の方が 1.7 倍多いからです。
曲線の面積を 1 にした 2 本は、診断を条件とした密度 P(x | y) です。mean area が x の腫瘍が悪性である確率 P(y | x) を読むには、診断の比率 P(y) を掛けます。この掛け算はベイズの定理そのもので、件数を掛けた右の図がその形です。混同行列のように、陽性の比率が変わると読み方が変わる話と同じです。
KDE の曲線を使う前に確認すること
KDE の曲線を読む前に、まずバンド幅をデータの単位で出します。scipy なら kde.factor * x.std(ddof=1)、scikit-learn なら bandwidth_ です。冒頭の図の mean area のように、幅が列の標準偏差より極端に小さければ針の列に、mean concavity のように標準偏差を超えるほど大きければ潰れた山になっています。scikit-learn に文字列や 1.0 を渡す時は、先に標準化します。
幅が妥当な桁でも、1 つの値で決めずに、規則の値と交差検証の値を含む何本かの h で描き、山の数と位置が変わらないかを見ます。多峰のデータでは、規則の値が広めに出ます。
次に、値に下限や上限があるかを見ます。あれば、範囲の外にはみ出した面積を測り、折り返すか変換してから使います。クラスごとに重ねた曲線から「どちらのクラスが多いか」を読むなら、クラスの件数を掛けてから比べます。
一般に、KDE は数十件以下のデータでは形も幅の選び方も不安定で、次元の呪いのため次元が増えるほど必要なデータ数が急に増えます。scikit-learn の手書き数字の例も、64 次元を PCA で 15 次元にしてから KDE を計算しています。
冒頭の図の 2 本の曲線は、同じ 569 件から作ったものです。どちらを信じるかは、幅を単位付きで見れば決まります。