同時分布(joint distribution)は、複数の変数の値の組ごとの確率です。周辺分布(marginal distribution)は、同時分布を一部の変数について合計し、その変数を消した分布で、条件付き分布(conditional distribution)は、一部の変数の値を固定した時の残りの変数の分布です。
機械学習で出会う値の多くは、条件付き分布から求めた値です。分類器が出す確率は入力を固定した時のクラスの条件付き分布で、回帰が予測する値は入力を固定した時の目的変数の平均です。
カリフォルニア大学バークレー校(UC Berkeley)の 1973 年の大学院の出願では、6 学科を合計した合格率は男性 44.5%、女性 30.4% で男性の方が高いのに、学科ごとに見ると 6 学科のうち 4 学科で女性の方が高くなっています。このように、全体と内訳で大小が逆転することがあります。回帰モデルに特徴量を 1 つ足したら、別の特徴量の係数の符号が変わることもあります。どちらも計算の誤りではなく、グループをまとめた周辺分布で見るか、グループの値を固定した条件付き分布で見るかの違いで起きます。
ペンギンのくちばしでも、同じことが起きます。以下は、南極の Palmer 基地の周辺の 3 島で計測された 3 種のペンギン 342 羽について、くちばしの長さから厚さを線形回帰で予測した結果です。データは palmerpenguins として公開されているものを使いました。破線は 3 種を混ぜたまま学習した回帰の予測で、実線は種を特徴量に足して学習した回帰の予測です。
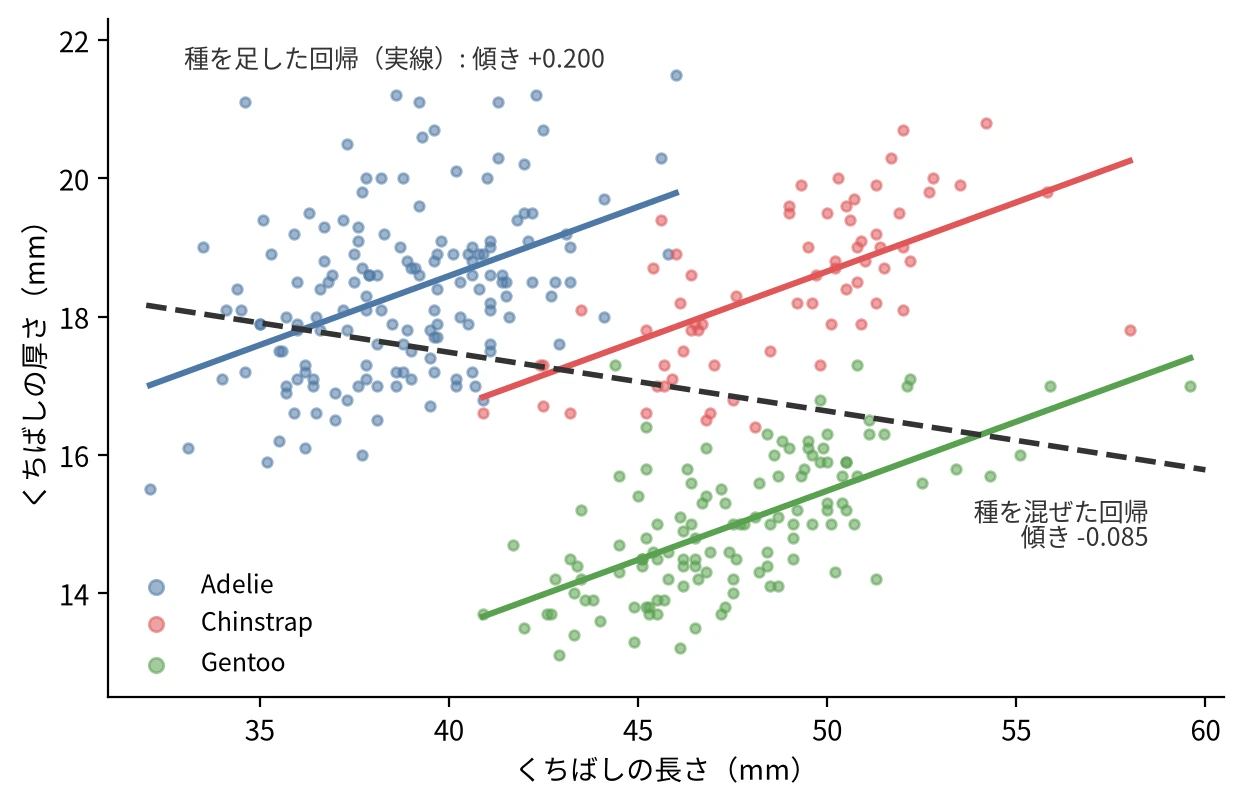
くちばしの長さから厚さを予測する回帰(種を混ぜた場合と、種を足した場合)
種を足した回帰の傾きは +0.200 で、種ごとに別々に学習しても +0.18〜+0.22 です。どの種でも、くちばしが長いほど厚くなります。3 種を混ぜると傾きは -0.085 で、長いほど薄くなります。相関係数も、種ごとの +0.39〜+0.65 に対して、全体では -0.24 です。どちらも同じ 342 羽から計算した値です。
本記事では、ML を学び始めた人と、手元のデータの集計やモデルの係数を読む人に向けて、次の疑問に答えます。
- 3 つの分布は、件数の表のどこを見た値か。
- まとめた表で、なぜ大小が逆転するのか。
- 連続の値で条件を付けると、何が起きているのか。
- 特徴量を 1 つ足すと、係数の符号が変わるのはなぜか。
- 混ぜる比率が変わると、関係はどこまで動くのか。
- 独立と条件付き独立は、何が違うのか。
実験は NumPy 2.5.4、pandas 3.1.1、scikit-learn 1.9.1 で行いました。図を描く処理も含めた完全なコードは joint-marginal-conditional_gen.py にあります。
件数の表の中の 3 つの分布
最初に、離散の変数で 3 つの分布を表の上に置きます。使うのは、冒頭で触れた UC Berkeley の 1973 年の大学院の出願のうち、出願の多い 6 学科への 4526 件の出願について、学科・性別・合否の組ごとに件数を数えたデータです。R に UCBAdmissions として同梱されており、ここでは Rdatasets が配布している CSV を使いました。
import pandas as pd

ucb = load_csv("UCBAdmissions.csv",
               "https://vincentarelbundock.github.io/Rdatasets/csv/datasets/UCBAdmissions.csv")
counts = ucb.pivot_table(index=["Dept", "Gender"], columns="Admit",
                         values="Freq", aggfunc="sum")  # 6 学科 × 2 性別 × 2 合否 = 24 マス
n_total = counts.to_numpy().sum()

# 学科について合計して学科を消す(周辺化): 性別 × 合否の 2 × 2 の表
by_gender = counts.groupby(level="Gender").sum()
print((by_gender / n_total).round(3))
rate_all = by_gender["Admitted"] / by_gender.sum(axis=1)  # P(合格 | 性別)
print("P(合格 | 性別):", rate_all.round(3).to_dict())
load_csv は、配布元から 1 回だけ取得して手元の写しを読む小さな関数です。出力は次の通りでした。
Admit   Admitted  Rejected
Gender
Female     0.123     0.282
Male       0.265     0.330
P(合格 | 性別): {'Female': 0.304, 'Male': 0.445}
この 4 つの値が、性別と合否の同時分布 P(性別, 合否) です。4 つを足すと 1 になります。表の右端と下端に、行の合計と列の合計を書き足すと、次のようになります。
| 合格 | 不合格 | 行の合計 P(性別) | |
|---|---|---|---|
| 女性 | 0.123 | 0.282 | 0.405 |
| 男性 | 0.265 | 0.330 | 0.595 |
列の合計 P(合否) | 0.388 | 0.612 | 1 |
表の端(margin)に書いた合計が周辺分布で、名前の由来もここにあります。P(性別) は合否について合計して消した分布、P(合否) は性別について合計して消した分布です。
条件付き分布は、1 つの行だけを取り出し、その行の合計で割って和を 1 にした分布です。女性の行なら 0.123 / 0.405 = 0.304 で、出願した女性の合格率 P(合格 | 女性) は 30.4% になります。式で書くと P(y | x) = P(x, y) / P(x) で、両辺に P(x) を掛けた P(x, y) = P(y | x) × P(x) を乗法定理と呼びます。
列で割ると別の値になります。合格者のうち女性の割合 P(女性 | 合格) は 0.123 / 0.388 = 0.317 で、30.4% とは意味も値も違います。条件と結果を入れ替えた確率を互いに変換する式がベイズの定理で、判定が陽性の時に本当に陽性である確率を求める例で説明しています。
まとめると大小が逆転する表
前の節の表では、男性の合格率は 44.5%、女性は 30.4% でした。この表は、学科・性別・合否の 3 つの変数の同時分布から、学科について合計して消した周辺分布です。学科を消さずに、学科ごとに合格率を並べたのが次の図です。
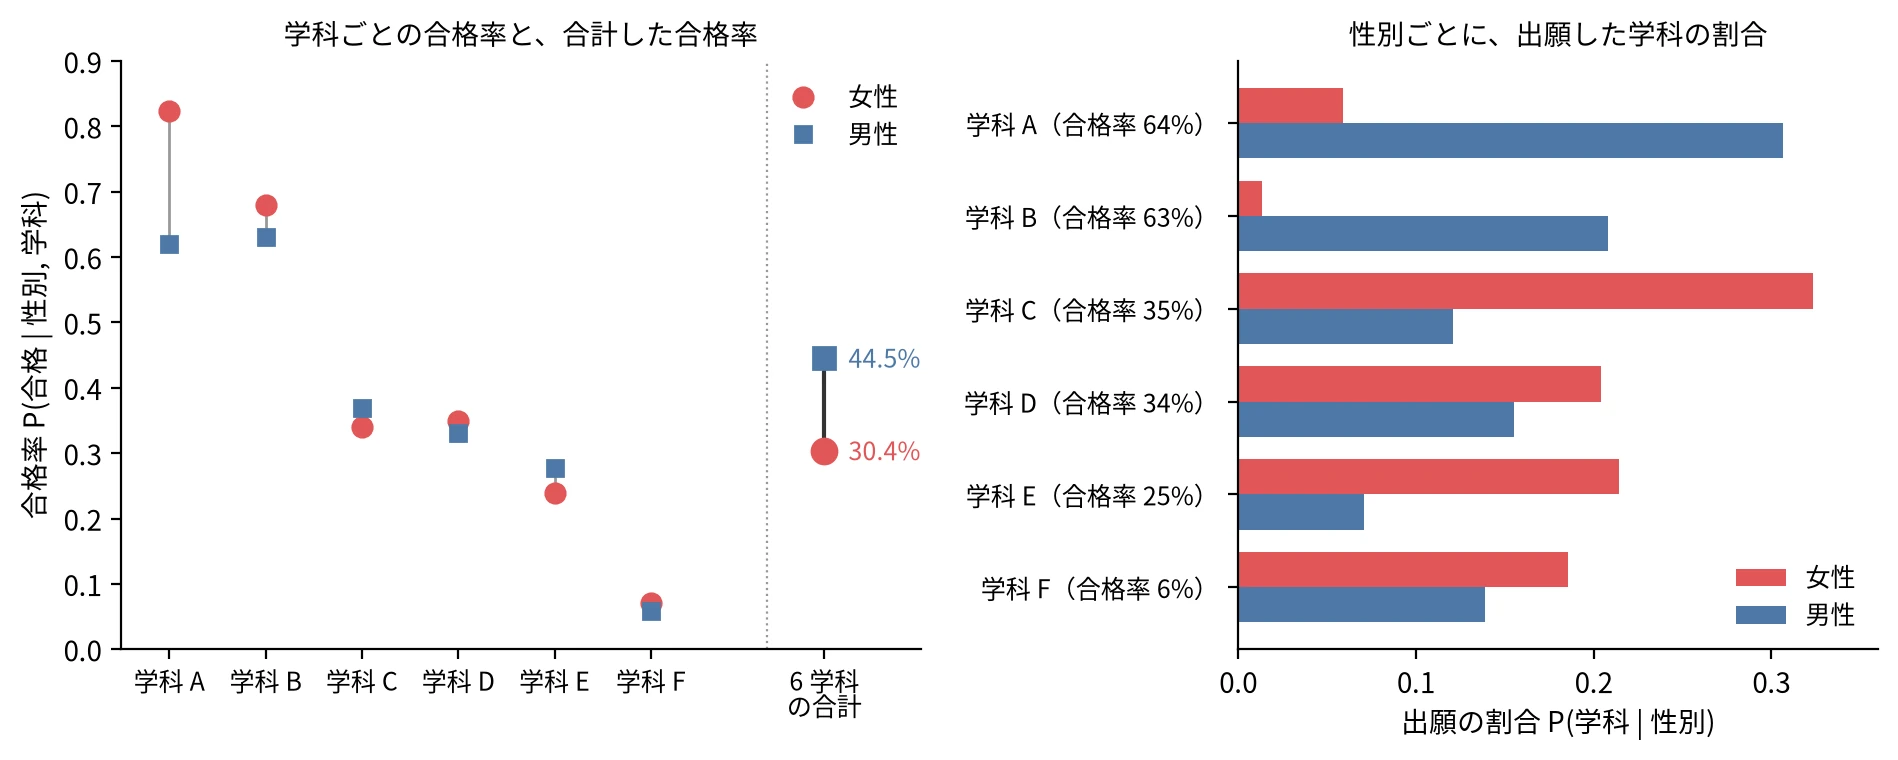
学科ごとの合格率と、性別ごとに出願した学科の割合(UC Berkeley、1973 年)
左の図で、6 学科のうち A・B・D・F の 4 学科は女性の合格率の方が高く、C と E の 2 学科は男性が高いものの、差は 4 ポイント以内です。それでも、学科をまとめると男性が 14 ポイント上になります。集計の仕方で大小が逆転するこの現象は、シンプソンのパラドックス(Simpson’s paradox)と呼ばれ、このデータは、Bickel らの 1975 年の論文が分析した出願の一部です。
理由は右の図にあります。男性の出願の 51% は合格率が 6 割を超える学科 A と B に向かい、女性の出願の 93% は合格率が 4 割に届かない学科 C〜F に向かっていました。
周辺の合格率は、その性別の出願がどの学科に向かったかの割合で、学科ごとの合格率に重みを付けた平均です。
P(合格 | 性別) = Σ_学科 P(合格 | 性別, 学科) × P(学科 | 性別)
rate = (counts["Admitted"] / counts.sum(axis=1)).unstack("Gender")  # P(合格 | 性別, 学科)
apply = counts.sum(axis=1).unstack("Gender")
share = apply / apply.sum(axis=0)                                   # P(学科 | 性別)
print("重み付き平均の P(合格 | 性別):", (rate * share).sum(axis=0).round(3).to_dict())
重み付き平均の P(合格 | 性別): {'Female': 0.304, 'Male': 0.445}
学科ごとの合格率がほぼ同じでも、重みの P(学科 | 性別) が性別で違えば、平均は大きく離れます。重みの違いで平均がずれる話は、平均の「平均の平均」の節で、区画ごとの値を平均した例を扱っています。
連続の値で条件を付ける
ペンギンのくちばしのような連続の値でも、考え方は同じです。条件付き分布 P(厚さ | 長さ = c) は、散布図を 長さ = c の位置で縦に細く切り、その帯に入った点の厚さを集めた分布に当たります。
データは palmerpenguins の配布元の CSV を使いました。Adelie(アデリーペンギン)151 羽、Gentoo(ジェンツーペンギン)123 羽、Chinstrap(ヒゲペンギン)68 羽で、元の 344 羽からくちばしの値が欠けた 2 羽を除いています。計測は Gorman らの 2014 年の論文のものです。
peng = load_csv("penguins.csv",
                "https://raw.githubusercontent.com/allisonhorst/palmerpenguins/main/inst/extdata/penguins.csv")
peng = peng.dropna(subset=["bill_length_mm", "bill_depth_mm"])  # 欠けた 2 羽を除く

for c in [40, 44, 48]:
    b = peng[(peng["bill_length_mm"] - c).abs() < 1.5]  # 長さ c ± 1.5 mm の帯
    mean_all = b["bill_depth_mm"].mean()                 # E[厚さ | 長さ ≈ c]
    by_sp = b.groupby("species")["bill_depth_mm"].agg(["size", "mean"])
    print(f"長さ ≈ {c} の帯: {len(b)} 羽 E[厚さ|長さ] = {mean_all:.2f}",
          "  ".join(f"{sp} {int(r['size'])} 羽 {r['mean']:.2f}" for sp, r in by_sp.iterrows()))
長さ ≈ 40 の帯: 61 羽 E[厚さ|長さ] = 18.38 Adelie 59 羽 18.49  Chinstrap 1 羽 16.60  Gentoo 1 羽 13.70
長さ ≈ 44 の帯: 43 羽 E[厚さ|長さ] = 15.56 Adelie 8 羽 18.60  Chinstrap 5 羽 17.56  Gentoo 30 羽 14.42
長さ ≈ 48 の帯: 50 羽 E[厚さ|長さ] = 15.73 Chinstrap 13 羽 17.87  Gentoo 37 羽 14.98
各行の後半は、帯の中の種ごとの羽数と平均の厚さです。以下は、3 本の帯と、帯ごとの厚さの分布を並べた図です。
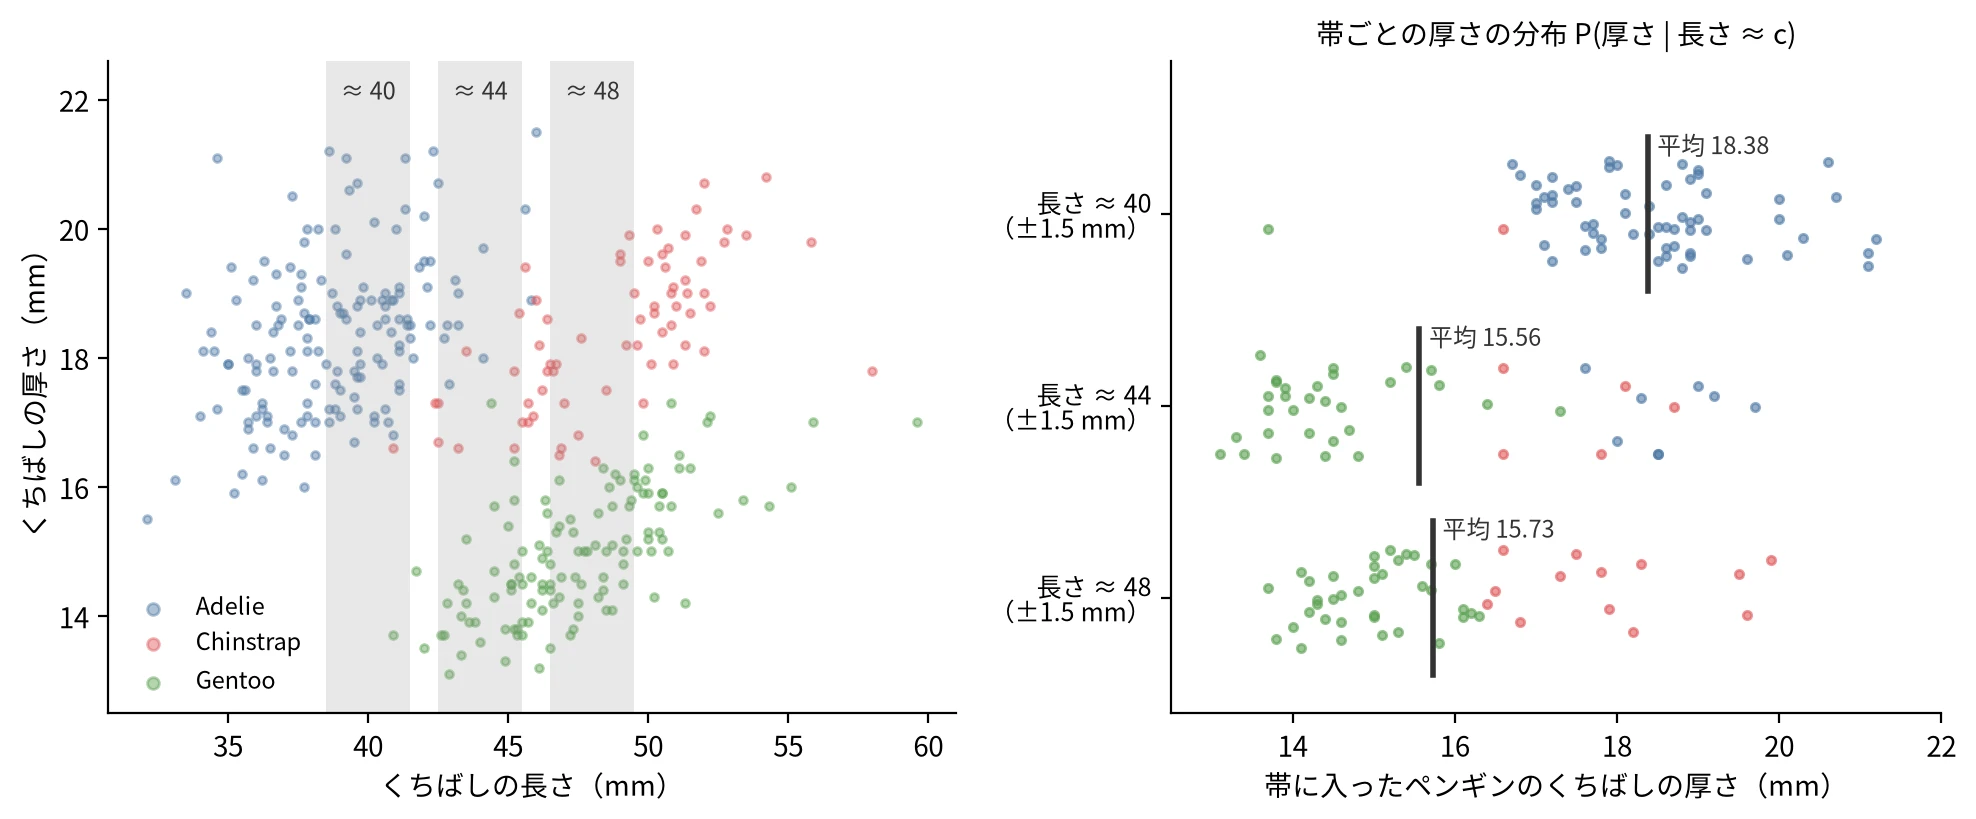
縦の帯で切った条件付き分布 P(厚さ | 長さ ≈ c) と、帯の中の種の内訳
長さ 40 の帯から 44 の帯へ移ると、厚さの平均は 18.38 mm から 15.56 mm へ 2.8 mm 下がります。Adelie だけを見ると 18.49 から 18.60 へ上がっているので、下がった原因は帯の中身の入れ替わりです。長さ 40 の帯はほぼ Adelie だけですが、44 の帯では 43 羽のうち 30 羽が、くちばしの薄い Gentoo でした。
帯の平均は、前の節の合格率と同じ形の、種ごとの平均の加重平均です。
E[厚さ | 長さ] = Σ_種 E[厚さ | 長さ, 種] × P(種 | 長さ)
E[厚さ | 長さ] は、長さを固定した時の厚さの期待値で、条件付き期待値と呼びます。二乗誤差で学習する回帰モデルが予測しようとしているのは、この値です。重みの P(種 | 長さ) は長さとともに動くので、種ごとの関係が右上がりでも、混ぜた関係は右下がりになり得ます。
種を足すと回帰の係数の符号が変わる
冒頭の図の 2 本の回帰は、scikit-learn の LinearRegression で学習しました。種は、種ごとに 0 か 1 を立てる列に変える one-hot エンコーディングで特徴量にしています。カテゴリの列を数値の列に変える方法は、カテゴリ変数のエンコーディングで扱っています。
from sklearn.linear_model import LinearRegression

x, y = peng[["bill_length_mm"]], peng["bill_depth_mm"]
m1 = LinearRegression().fit(x, y)  # 長さだけ
X2 = pd.get_dummies(peng[["bill_length_mm", "species"]], drop_first=True, dtype=float)
m2 = LinearRegression().fit(X2, y)  # 長さ + 種
print(f"長さだけ: 長さの係数 {m1.coef_[0]:+.3f}")
print("長さ + 種:", {c: round(float(v), 3) for c, v in zip(X2.columns, m2.coef_)})
長さだけ: 長さの係数 -0.085
長さ + 種: {'bill_length_mm': 0.2, 'species_Chinstrap': -1.933, 'species_Gentoo': -5.106}
drop_first=True は、種の 3 列のうち先頭の Adelie の列を落とす指定です。3 列を全て残すと、どの行でも合計が 1 になり、切片と区別できなくなるためです。Adelie は species_Chinstrap と species_Gentoo がどちらも 0 の行として表され、残った 2 列の係数は Adelie との差になります。
長さだけのモデル m1 の係数 -0.085 は、混ぜたデータで「長さが 1 mm 違うと、厚さの予測がどれだけ違うか」で、前の節の E[厚さ | 長さ] の傾きです。種を足したモデル m2 の係数 +0.200 は、種の列を固定した時の傾き、つまり同じ種の中で長さが 1 mm 違う時の差です。species_Gentoo の -5.106 は、同じ長さなら Gentoo は Adelie より 5.1 mm 薄いという意味で、冒頭の図で緑の実線が青の実線より下にある距離に当たります。
2 つの係数は、どちらも計算としては正しく、使う目的が違います。種が分からないペンギンの厚さを長さだけから予測するなら、m1 の右下がりの直線は、手元の 3 種の混ざり方の下で二乗誤差が最も小さい直線です。長さが厚さにどう効くかを読みたいなら、種を固定した m2 の係数を見ます。線形回帰の係数を「他の特徴量を固定した時の効き方」と読めるのは、固定する特徴量がモデルに入っている時だけです。
混ぜる比率で変わる関係
m1 の予測は、混ぜ方の P(種 | 長さ) が変わらない限り使えます。この P(種 | 長さ) は、種ごとの長さの分布と、全体に占める種の割合 P(種) で決まります。種ごとの長さの分布が同じでも、P(種) が変われば、各帯の中の種の内訳も変わります。
では、全体に占める種の割合が変わると、傾きはどこまで動くのか。比率を 1 つの数で表せるように、Adelie と Gentoo の 2 種だけを使い、全体に占める Gentoo の割合を 0% から 100% まで 2.5% 刻みで動かして、回帰の傾きを測りました。羽数は変えず、LinearRegression の fit の sample_weight で各羽の重みを変えています。
ag = peng[peng["species"].isin(["Adelie", "Gentoo"])]
is_g = (ag["species"] == "Gentoo").to_numpy()
n_a, n_g = (~is_g).sum(), is_g.sum()
for p in np.linspace(0, 1, 41):
    w = np.where(is_g, p / n_g, (1 - p) / n_a)  # Gentoo が全体の p を占めるように重みを付ける
    s = LinearRegression().fit(ag[["bill_length_mm"]], ag["bill_depth_mm"],
                               sample_weight=w).coef_[0]
    print(f"Gentoo の割合 {p:.1%}: 傾き {s:+.3f}")
Gentoo の割合 0.0%: 傾き +0.179
Gentoo の割合 5.0%: 傾き -0.009
Gentoo の割合 45.0%: 傾き -0.212
Gentoo の割合 92.5%: 傾き -0.011
Gentoo の割合 95.0%: 傾き +0.039
Gentoo の割合 100.0%: 傾き +0.205
出力は 41 行のうち、符号が変わる前後と最も負の所だけを抜き出しました。全体を描いたのが次の図です。
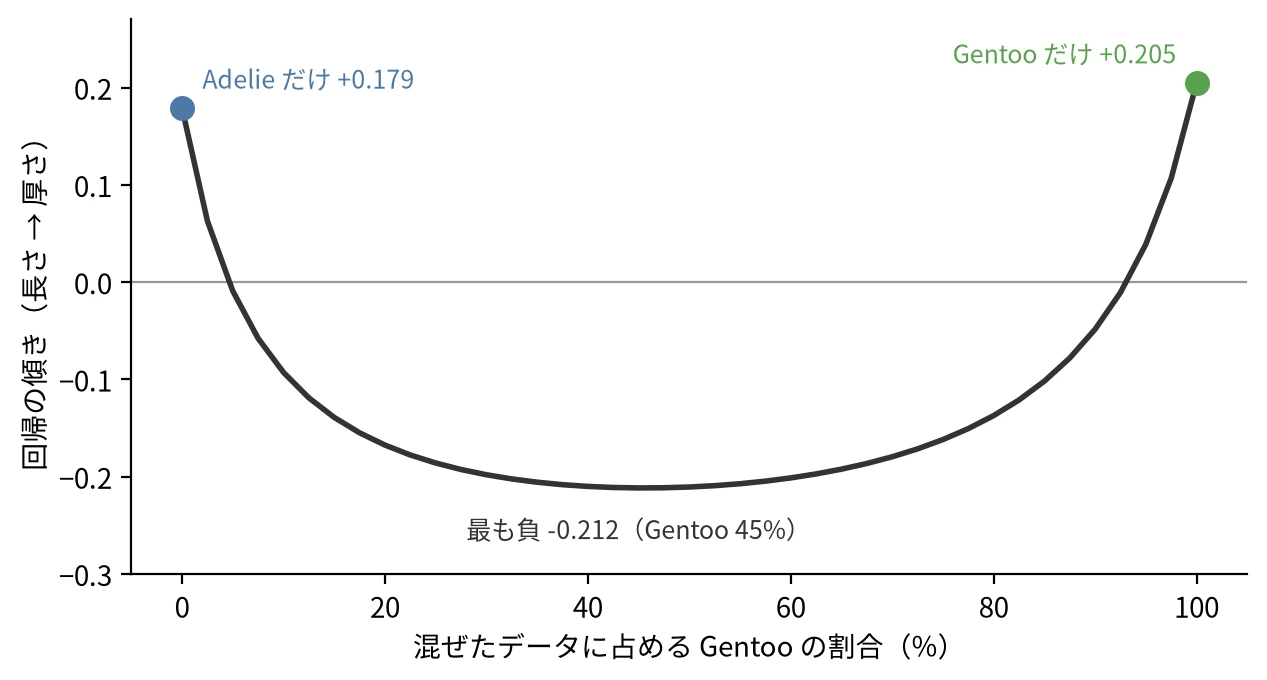
混ぜたデータに占める Gentoo の割合と、回帰の傾き(Adelie と Gentoo の 2 種)
1 種だけなら傾きは +0.179 と +0.205 で、どちらも右上がりです。Gentoo を 5% 混ぜただけで傾きは負になり、92.5% まで負のままでした。Adelie は短くて厚く、Gentoo は長くて薄いので、2 種を混ぜると、種の間の違いが種の中の傾きを上回ります。
本番のデータで、この比率が動くことがあります。長さだけで学習した m1 から見ると、入力の分布 P(長さ) だけでなく、長さと厚さの関係 P(厚さ | 長さ) まで変わったように見えます。学習時と本番でデータの性質が変わるデータドリフトの分類では、P(y | x) が変わる concept drift に当たります。種を特徴量に入れた m2 から見ると、種ごとの関係は変わっておらず、入力の分布が動いただけの covariate shift です。同じ変化でも、どの変数で条件を付けたモデルかで、名前も対処も変わります。
独立と条件付き独立
2 つの変数が独立(independent)とは、P(x, y) = P(x) × P(y) が成り立つことです。乗法定理と並べると P(y | x) = P(y) と同じで、x の値を知っても y の分布が変わらない状態を指します。
最初の表では、全体の合格率 P(合格) は 38.8% で、P(合格 | 女性) の 30.4% とも P(合格 | 男性) の 44.5% とも違います。学科をまとめた表では、性別と合否は独立ではありません。一方、学科を固定すると、学科 A を除けば男女の合格率の差は 5 ポイント以内でした。学科を固定した時に P(合格 | 性別, 学科) = P(合格 | 学科) が成り立つ状態は、学科を条件とした条件付き独立と呼ばれ、Berkeley のデータはこれに近い表です。
条件付き独立と独立は別の性質で、一方が成り立っても、もう一方が成り立つとは限りません。Naive Bayes は、正解のクラスを固定すると特徴量どうしが条件付き独立だと仮定し、P(x1, ..., xn | y) = Π_i P(xi | y) と分解して計算する分類器です。この掛け算を確率のまま行うと、1 未満の数を数百回掛けた値が小数で表せる範囲を下回り、0.0 になります。手書き数字の例と、log の和で避ける方法は、対数・指数と log-odds にあります。
独立かどうかは、相関係数が 0 かどうかでは判定できません。相関係数は線形の関係だけを測るので、0 を中心に左右対称に散らばる x と y = x^2 の相関係数は 0 ですが、独立ではありません。同時分布が周辺分布の積からどれだけ離れているかを測る量が、情報理論の相互情報量です。
集計やモデルの関係を読む前に確認すること
全体の合格率や、混ぜたデータで学習した回帰の傾きを読む前に、その値が周辺の値か、何かを固定した条件付きの値かを確認します。周辺の値は、グループの混ざり方で重みを付けた、グループごとの値の平均です。グループを分ける変数が手元にあるなら、冒頭の図のように、分けて同じ比較をやり直します。分けた結果と大小や符号が揃っているかを見るだけで、Berkeley のような取り違えは防げます。
次に、分けた比較と混ぜた比較のどちらを使うかを決めます。これはデータだけでは決まりません。Berkeley では、どの学科に出願するかを選ぶのは出願者で、合否を決めるのは学科なので、Bickel らは学科ごとの比較から、女性に不利な選考の証拠は無いと結論しました。ペンギンの予測なら、種が分からないまま長さだけで予測するのか、種を入力に足せるのかで、使う係数が変わります。
最後に、混ぜた関係をそのままモデルに使うなら、混ぜ方が本番で変わらないかを監視します。Gentoo と Adelie の比率で傾きが +0.205 から -0.212 まで動いたように、グループの比率は、グループの中で何も変わっていなくても P(y | x) を動かします。グループを分ける変数を特徴量に入れておけば、その変化は入力の分布の変化として現れ、モデル性能劣化の監視でも原因を切り分けやすくなります。冒頭の破線と実線のどちらを使うかは、種が分からないまま長さだけで予測したいのか、同じ種の中での長さの効き方を知りたいのかで決まります。