相関係数は、2 つの列が一緒に増えたり減ったりする度合いを -1 から +1 の 1 つの数にまとめた指標です。+1 に近いほど片方が増えるともう片方も増え、-1 に近いほど片方が増えるともう片方は減ります。pandas の DataFrame.corr で相関行列を出し、目的変数(予測したい列)と相関の強い列を探したり、似た列の組を見つけたりするのは、手元のデータを眺める時に最初に行うことの 1 つです。
その相関行列を読む時、相関係数について次の 4 つを前提にしがちです。どれも成り立ちません。
- 相関係数が 0 に近ければ、2 つの列は無関係である。
- 1000 行もあれば、1 行の外れ値では相関係数はほとんど動かない。
- 目的変数と相関の無い列は、予測に使えない。
- 無関係な列どうしで、相関係数が 0.7 を超えることはまず無い。
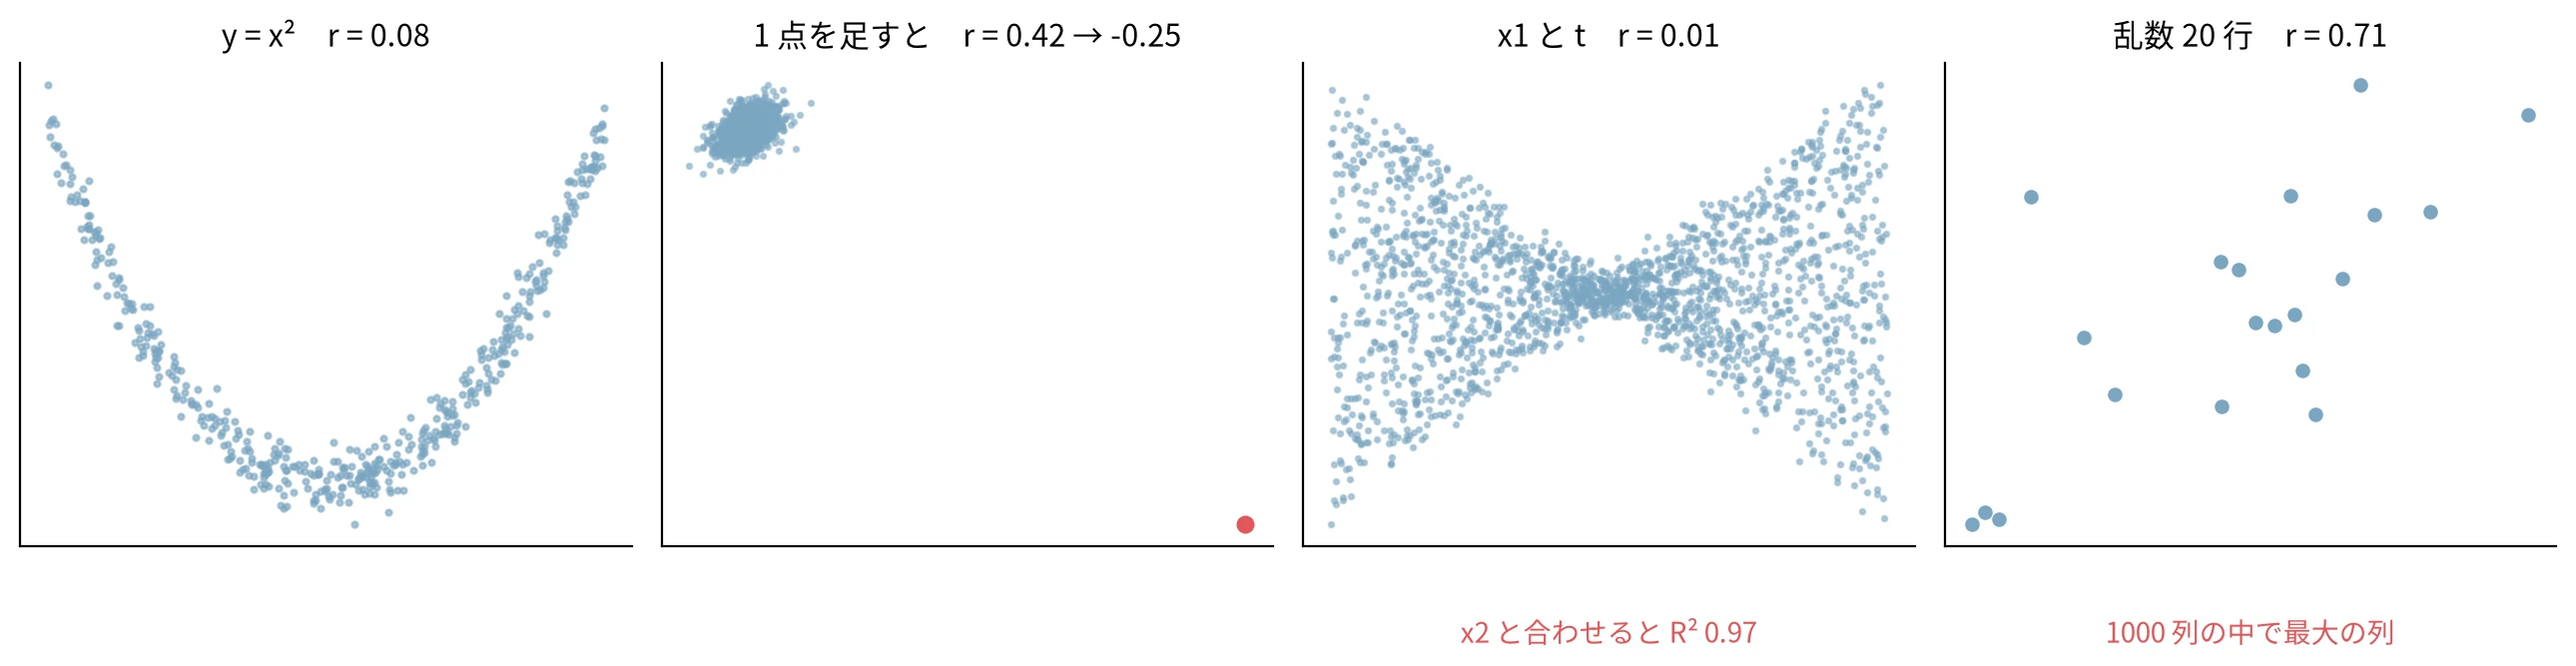
次の図は、4 つの前提の反例を手元で作ったものです。
4 つの前提の反例(左から、曲がった関係、外れ値 1 点、2 列の掛け算、乱数の多い列)
1 枚目は y が x でほぼ決まるのに r は 0.08、2 枚目は 1000 点の外に 1 点を足しただけで r が 0.42 から -0.25 に変わりました。3 枚目の x1 は、相関が 0.01 でも、別の列 x2 と合わせると目的変数をほぼ当てられます。4 枚目は 20 行の乱数で r が 0.71 になった列です。4 つとも、相関係数が「点ごとの積の平均」として計算されることから説明できます。
本記事では、ML の説明に出てくる相関係数を自分で計算して確認したい人と、相関行列を見て列を選ぶ人に向けて、次の疑問に答えます。
- 相関係数は、点ごとに何を計算しているのか。
- 0 に近いのに関係がある、はどういう時に起きるのか。
- 外れ値 1 点は、相関係数をどこまで動かすのか。
- 相関の無い列は、予測に使えないのか。
- 無関係な列どうしでも、どのくらいの相関が出るのか。
- Spearman・Kendall・ξ に替えると、何が変わるのか。
実験は NumPy 2.5.4、SciPy 1.18.1、scikit-learn 1.9.1 で行いました。図を描く処理も含めた完全なコードは correlation_gen.py にあります。
共分散と相関係数
2 つの列 x と y が一緒に動くかは、各点で「x が平均からどれだけ離れているか」と「y が平均からどれだけ離れているか」を掛けると分かります。両方とも平均より大きい点と、両方とも平均より小さい点では積が正になり、片方だけ大きい点では負になります。この積を全ての点で平均した値が共分散(covariance)で、Cov(x, y) = mean((x - mean(x)) * (y - mean(y))) です。mean は平均で、y に x 自身を入れると Cov(x, x) は分散と同じ式になります。
共分散は列の単位で値が変わります。身長と体重から求めた共分散は単位が cm と kg の積になり、身長を cm から m に直すと共分散は 100 分の 1 になるので、値の大きさだけでは関係の強さを比べられません。そこで、それぞれの列を標準偏差で割ってから積を平均します。
r = Cov(x, y) / (std(x) * std(y)) = mean(z_x * z_y)
z_x は、x から平均を引いて標準偏差で割った値です。単位が割り算で消えるので、r は単位を持たず、必ず -1 から +1 に収まります。±1 になるのは、全ての点が 1 本の直線に乗る時だけです。この r が、Karl Pearson が 1895 年の論文で式にした Pearson の相関係数で、単に相関係数と言えばこれを指します。列の単位をそろえる考え方は標準化、標準偏差は標準偏差のノートで説明しています。
diabetes で積を数える
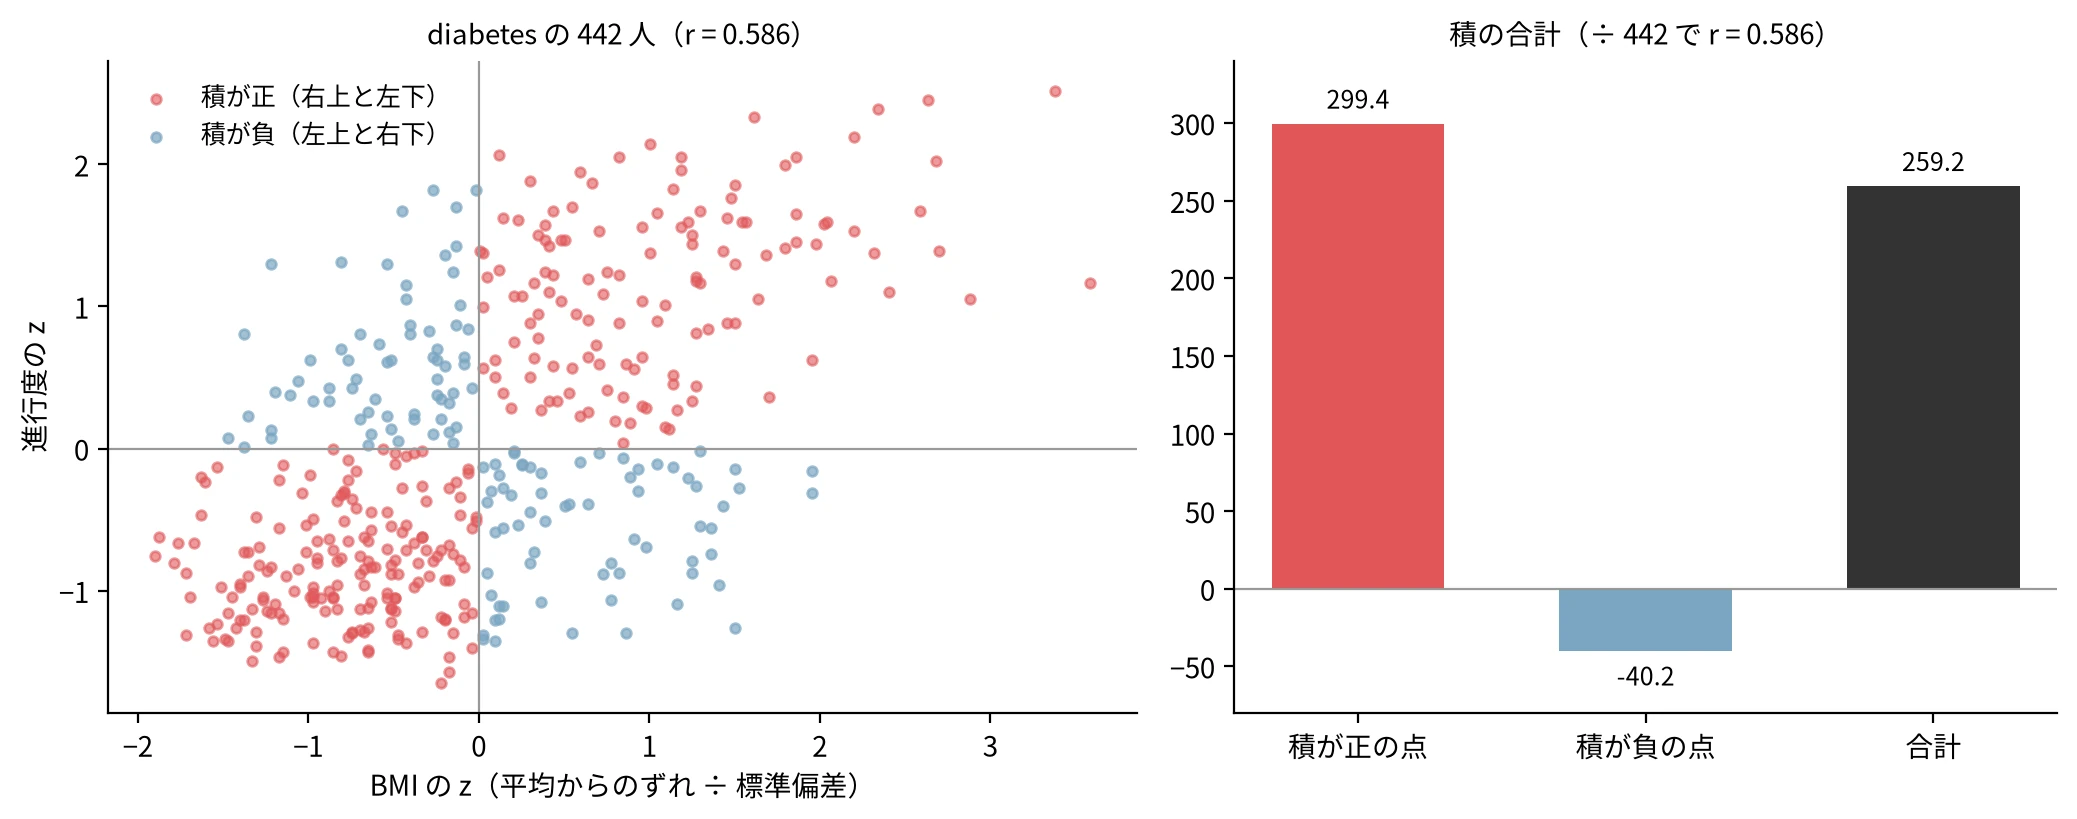
scikit-learn に同梱の diabetes は、糖尿病の患者 442 人について、年齢や BMI などの 10 列と、1 年後に測った病気の進行度を並べたデータです。BMI と進行度の相関係数を np.corrcoef と、積を平均する式で計算し、積が正の点と負の点に分けて足しました。
import numpy as np
from sklearn.datasets import load_diabetes

def zscore(a):
    return (a - a.mean()) / a.std()

d = load_diabetes(scaled=False)
bmi, prog = d.data[:, 2], d.target            # 442 人の BMI と、1 年後の病気の進行度
zx, zy = zscore(bmi), zscore(prog)
prod = zx * zy                                 # 点ごとの積
print("np.corrcoef:", round(np.corrcoef(bmi, prog)[0, 1], 3))
print("積の平均   :", round(prod.mean(), 3))
print(f"積が正の点: {(prod > 0).sum()} / {len(prod)}  積の合計 {prod[prod > 0].sum():.1f}")
print(f"積が負の点: {(prod < 0).sum()} / {len(prod)}  積の合計 {prod[prod < 0].sum():.1f}")
print("r の 2 乗    :", round(np.corrcoef(bmi, prog)[0, 1] ** 2, 3))
np.corrcoef: 0.586
積の平均   : 0.586
積が正の点: 310 / 442  積の合計 299.4
積が負の点: 132 / 442  積の合計 -40.2
r の 2 乗    : 0.344
diabetes の BMI と進行度で、点ごとの積を正と負に分けて足した結果
赤い点で積を足した 299.4 から青い点の 40.2 を引くと 259.2 で、これを 442 人で割ると 0.586 になります。相関係数は、どの点が正と負のどちらにどれだけ寄与したかの足し算でしかありません。この見方を持っておくと、冒頭の 4 つの前提がどこで崩れるかも、積の足し算として読めます。
r が 0.586 でも、BMI だけで進行度を当てられるわけではありません。切片の付いた直線を最小二乗法で当てはめる線形回帰では、同じデータで測った R² は r の 2 乗の 0.344 に一致し、進行度のばらつきの 3 分の 1 ほどしか説明しません。別のモデルで予測した時や、学習に使っていないデータで測った時は R² と r² が一致せず、その例は回帰の評価指標で扱っています。
なお、y を 100 分の 1 にしても 100 倍にしても z_y は変わらないので、相関係数も変わりません。一方、この直線の傾きは y と一緒に 100 分の 1 や 100 倍になります。r が大きいことは、回帰直線の傾きが急なことを意味しません。
曲がった関係
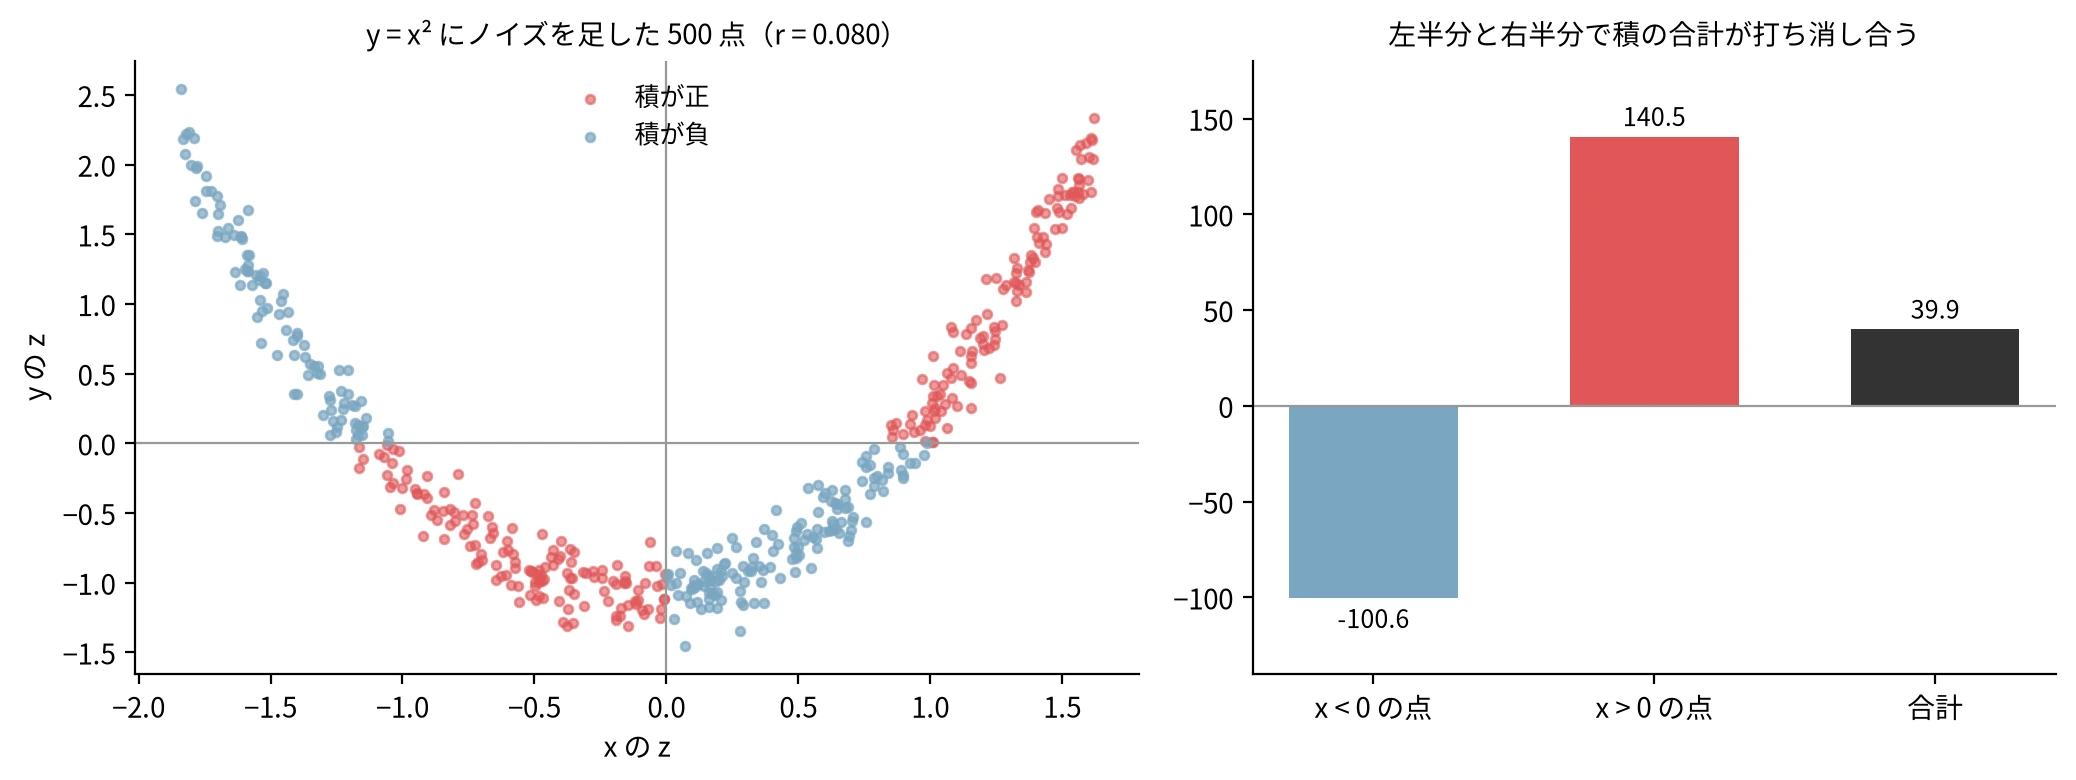
冒頭の 1 枚目は、x を -1 から 1 の一様乱数で 500 個作り、y = x² に小さなノイズを足したデータです。y は x でほぼ決まります。
rng = np.random.default_rng(0)
x = rng.uniform(-1, 1, 500)
y = x**2 + rng.normal(0, 0.05, 500)            # x で y がほぼ決まる
p = zscore(x) * zscore(y)
print("y = x^2 の r:", round(np.corrcoef(x, y)[0, 1], 3))
print(f"x < 0 の点の積の合計 {p[x < 0].sum():.1f}、x > 0 の点の積の合計 {p[x > 0].sum():.1f}")
x02 = rng.uniform(0, 2, 500)                   # 同じ y = x² を 0〜2 の範囲で作る
print("x を 0〜2 にした y = x^2 の r:", round(np.corrcoef(x02, x02**2 + rng.normal(0, 0.05, 500))[0, 1], 3))
y = x^2 の r: 0.08
x < 0 の点の積の合計 -100.6、x > 0 の点の積の合計 140.5
x を 0〜2 にした y = x^2 の r: 0.967
y = x² では、左半分と右半分の積が打ち消し合う
左半分では x が増えると y が減るので積の多くが負、右半分では両方が増えるので正になり、2 つが打ち消し合って合計は 39.9、r は 0.08 になります。r が 0 でないのは、乱数で左右に入った点の数と位置が少しずれたためで、点が左右で対称なら r は 0 に近づきます。同じ y = x² でも、x を 0〜2 の範囲で作ると右半分だけになり、r は 0.967 です。r は関数の形だけでなく、x がどの範囲に散らばっているかでも変わります。
相関係数が見ているのは「直線で近似した時に、どれだけ直線に乗るか」だけです。0 に近い r は「直線の関係が無い」ことしか言えず、2 つの列が独立かどうかは判定できません。独立と相関の違いは同時分布・周辺分布・条件付き分布で、曲がった関係も数える指標の 1 つである相互情報量は情報理論で扱っています。
統計量が同じでも散布図の形が全く違う例としては、Anscombe が 1973 年に作った 4 つのデータと、それを恐竜の絵などに広げた Datasaurus Dozen がよく知られています。Anscombe の 4 つは 11 点ずつのデータで、どれも x と y の平均と分散がほぼ同じで、r が約 0.816、最小二乗法の直線が y = 0.50x + 3.00 です。それでも 1 つは素直な直線、1 つは曲線、1 つは 1 点を除くと r が 1 になる直線、残りの 1 つは x が 1 点を除いて全て 8 で、その 1 点が直線の傾きを決めています。
外れ値 1 点
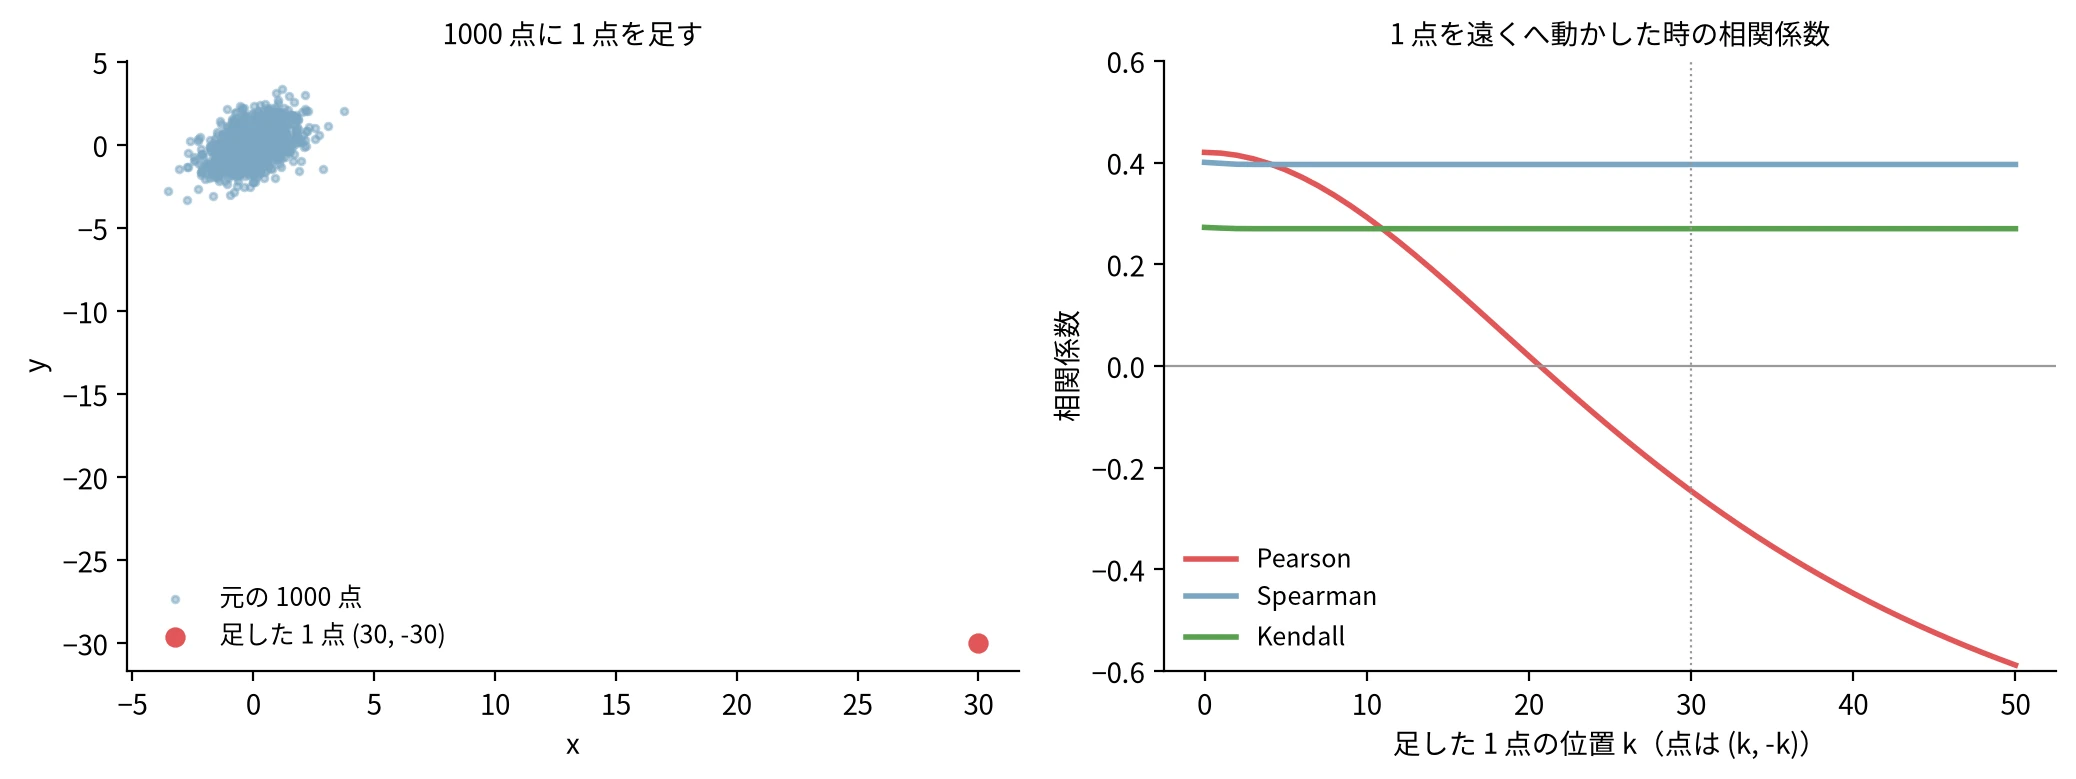
積の平均は、1 つの点の積が大きければ、その点の影響を大きく受けます。r が 0.42 になる 1000 点を作り、(k, -k) の 1 点だけを足して、k を大きくしていきました。Spearman の相関係数は、値の代わりに順位を使う相関係数です。図に出てくる Kendall の相関係数も順位を使う相関係数で、どちらも最後の節で詳しく扱います。
from scipy import stats

rng = np.random.default_rng(1)
n = 1000
a = rng.normal(size=n)
b = 0.4 * a + np.sqrt(1 - 0.4**2) * rng.normal(size=n)   # r が 0.4 ほどの 1000 点
print(f"1000 点だけ: Pearson {np.corrcoef(a, b)[0, 1]:.3f}  Spearman {stats.spearmanr(a, b).statistic:.3f}")
for k in [10, 20, 30]:
    xa, ya = np.append(a, k), np.append(b, -k)            # (k, -k) に 1 点だけ足す
    p = zscore(xa) * zscore(ya)
    print(f"(+{k}, -{k}) を足す: Pearson {np.corrcoef(xa, ya)[0, 1]:+.3f}  "
          f"Spearman {stats.spearmanr(xa, ya).statistic:+.3f}  "
          f"足した 1 点の積 {p[-1]:.1f}  残り 1000 点の積の合計 {p[:-1].sum():.1f}")
1000 点だけ: Pearson 0.420  Spearman 0.400
(+10, -10) を足す: Pearson +0.293  Spearman +0.396  足した 1 点の積 -89.7  残り 1000 点の積の合計 382.6
(+20, -20) を足す: Pearson +0.019  Spearman +0.396  足した 1 点の積 -282.0  残り 1000 点の積の合計 301.5
(+30, -30) を足す: Pearson -0.246  Spearman +0.396  足した 1 点の積 -468.9  残り 1000 点の積の合計 222.7
1000 点に 1 点を足し、その 1 点を遠くへ動かした時の相関係数
k = 30 では、足した 1 点の積が -468.9 で、残り 1000 点の積を全部足した 222.7 より大きくなり、r の符号が負に変わりました。1001 点のうち 1 点が、残り全部より重く数えられています。足した点が遠いほど、標準偏差も膨らむので、元の 1000 点の z は縮み、それらの積を足した値は 382.6 から 222.7 に減ります。
Spearman と Kendall は順位しか使わないので、1 点をどれだけ遠くへ動かしても、その点は「一番 x が大きく、一番 y が小さい点」のままで、値はほとんど変わりません。センサーの読み違いや単位の入力ミスのように桁違いの値が 1 つ混じる列では、Pearson と Spearman を両方計算し、大きく食い違えば散布図で外れ値を探します。外れ値の見つけ方は分位数と異常検知で扱っています。
目的変数と相関の無い列
相関係数は 2 つの列だけを見る指標で、3 つ目の列があって初めて現れる関係は数えません。x1 と x2 を -1 から 1 の一様乱数で 2000 個ずつ作り、目的変数を t = x1 * x2 に小さなノイズを足した値にしました。x1 が正の時は x2 と同じ向きに、負の時は逆向きに t が動きます。
from sklearn.ensemble import HistGradientBoostingRegressor
from sklearn.linear_model import LinearRegression
from sklearn.model_selection import cross_val_score

rng = np.random.default_rng(2)
x1 = rng.uniform(-1, 1, 2000)
x2 = rng.uniform(-1, 1, 2000)
t = x1 * x2 + rng.normal(0, 0.05, 2000)        # 目的変数は 2 列の掛け算
X = np.column_stack([x1, x2])
print(f"r(x1, t) = {np.corrcoef(x1, t)[0, 1]:.3f}  r(x2, t) = {np.corrcoef(x2, t)[0, 1]:.3f}")
for name, model in [("LinearRegression", LinearRegression()),
                    ("HistGradientBoosting", HistGradientBoostingRegressor(random_state=0))]:
    r2 = cross_val_score(model, X, t, cv=5, scoring="r2").mean()
    print(f"{name:<20} 5 分割交差検証の R² {r2:.3f}")
r(x1, t) = 0.011  r(x2, t) = 0.000
LinearRegression     5 分割交差検証の R² -0.008
HistGradientBoosting 5 分割交差検証の R² 0.968
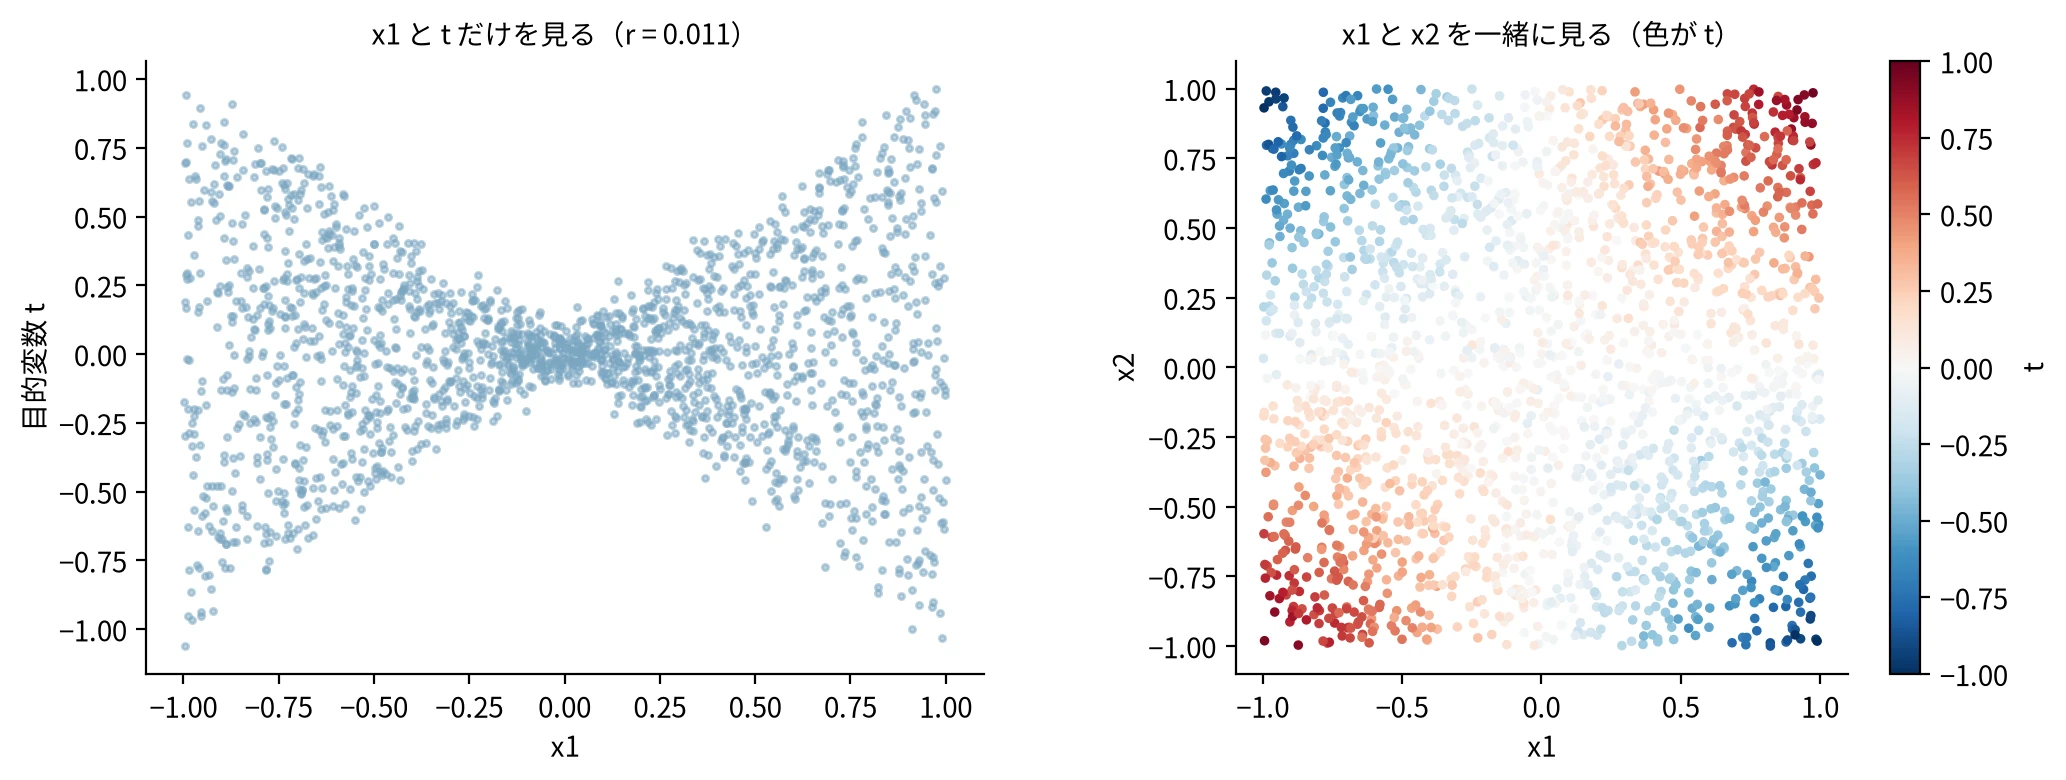
1 列ずつでは相関が 0 でも、2 列そろうと目的変数が決まる
x1 と x2 は、どちらも目的変数 t と相関がほぼ 0 です。それでも 2 列を一緒に渡すと、Gradient Boosting は交差検証の R² が 0.968 になり、目的変数のばらつきの 97% ほどを当てました。直線しか表せない線形回帰は R² が -0.008 で、何も当てられません。R² の読み方は回帰の評価指標で説明しています。
相関行列を見て「目的変数との |r| が 0.1 未満の列を落とす」と、このような列を捨てます。列を減らす時は、特徴量選択で扱っている、モデルに入れた状態で列の効き目を測る方法や特徴量重要度を使います。
逆に、説明に使う列どうしの相関が強すぎる時も困ります。diabetes の BMI と血液検査の 5 列、進行度で相関行列を出しました。
import pandas as pd

df = pd.DataFrame(d.data, columns=d.feature_names)
df["target"] = d.target                        # 1 年後の病気の進行度
print(df[["bmi", "s1", "s2", "s3", "s4", "s5", "target"]].corr().round(2))
         bmi    s1    s2    s3    s4    s5  target
bmi     1.00  0.25  0.26 -0.37  0.41  0.45    0.59
s1      0.25  1.00  0.90  0.05  0.54  0.52    0.21
s2      0.26  0.90  1.00 -0.20  0.66  0.32    0.17
s3     -0.37  0.05 -0.20  1.00 -0.74 -0.40   -0.39
s4      0.41  0.54  0.66 -0.74  1.00  0.62    0.43
s5      0.45  0.52  0.32 -0.40  0.62  1.00    0.57
target  0.59  0.21  0.17 -0.39  0.43  0.57    1.00
s1 は総コレステロール、s2 はその一部の LDL コレステロールで、r は 0.90 です。s4 は総コレステロールを s3 の HDL コレステロールで割った値なので、s3 と -0.74 になります。どちらも、片方の列が分かればもう片方の多くが分かる組です。
2 つの列がほとんど同じ動きをすると、線形回帰の係数は片方に寄ったり符号が変わったりし、1 列の値を行の間で並べ替えて予測の悪化を測る permutation importance は、もう片方の列が情報を補うので小さく出ることがあります。前者は線形回帰で係数を扱う節と正則化、後者は特徴量重要度で扱っています。相関行列で |r| が 0.9 を超える組を見つけたら、片方を落とすか、PCA で 1 つの列にまとめることを考えます。列が多くて表では見渡せない時は、seaborn の heatmap で値を色の濃さにして眺めます。
無関係な列どうしの相関
相関係数は n 個の積を平均した値なので、行が少ないと平均が安定しません。無関係な 2 つの列の r は、おおよそ平均 0、標準偏差 1 / sqrt(n - 1) で散らばります。10 行なら標準偏差は 0.33 です。正規乱数の 2 列で r を計算し、行の数ごとに 10000 回繰り返しました。
rng = np.random.default_rng(3)
for m in [10, 30, 100, 1000]:
    rs = np.array([np.corrcoef(rng.normal(size=m), rng.normal(size=m))[0, 1] for _ in range(10000)])
    print(f"{m:>4} 行: |r| >= 0.5 の割合 {np.mean(np.abs(rs) >= 0.5):6.2%}  "
          f"|r| の 95% 点 {np.percentile(np.abs(rs), 95):.2f}")
Z = rng.normal(size=(20, 1000))                # 20 行 × 1000 列の乱数
target = rng.normal(size=20)                   # 目的変数も乱数
rcol = np.array([np.corrcoef(Z[:, j], target)[0, 1] for j in range(1000)])
print(f"20 行 × 1000 列: |r| の最大 {np.abs(rcol).max():.3f}、|r| >= 0.5 の列 {np.sum(np.abs(rcol) >= 0.5)} 本")
  10 行: |r| >= 0.5 の割合 13.99%  |r| の 95% 点 0.63
  30 行: |r| >= 0.5 の割合  0.43%  |r| の 95% 点 0.36
 100 行: |r| >= 0.5 の割合  0.00%  |r| の 95% 点 0.20
1000 行: |r| >= 0.5 の割合  0.00%  |r| の 95% 点 0.06
20 行 × 1000 列: |r| の最大 0.707、|r| >= 0.5 の列 23 本
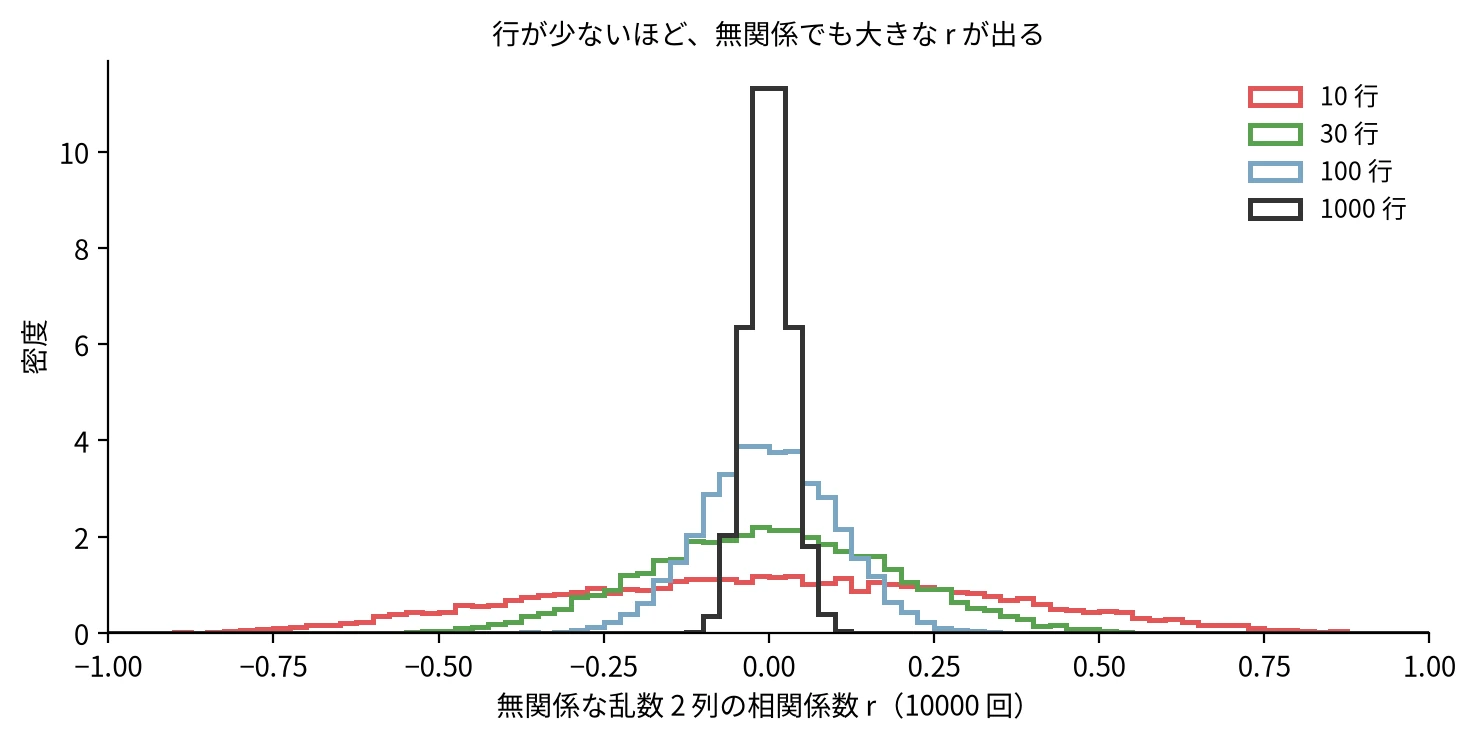
行が少ないほど、無関係な列どうしでも大きな相関係数が出る
10 行では、無関係な 2 列でも 7 回に 1 回ほど |r| が 0.5 を超え、20 回に 1 回は 0.63 を超えます。1000 行なら 95% が 0.06 以内に収まります。
1 つの組なら偶然の大きな r は珍しくても、列が多いと話が変わります。20 行 × 1000 列の乱数で、各列と目的変数で相関を全部計算すると、一番大きい列は 0.707、0.5 を超える列が 23 本ありました。冒頭の 4 枚目はこの 0.707 の列です。相関行列から大きい値だけを選ぶと、行が少ないほど偶然の相関を拾います。
たくさんのデータを組み合わせて偶然の相関を集めた例には、Tyler Vigen の Spurious Correlations があります。r が偶然でどれくらい出るかを p 値で測る考え方は仮説検定、たくさんの列から点を見て選ぶと評価が膨らむ話は過学習で扱っています。
相関係数の絶対値が 0.7 以上なら強い、0.4 から 0.7 なら中程度、という目安もよく使われますが、行の数を考えずには使えません。10 行なら無関係な列どうしでも 7 回に 1 回は 0.5 を超えます。逆に 10 万行あれば、r が 0.05 しかない弱い関係でも p 値は小さく出て、偶然ではないと判定されます。
相関と因果
偶然ではない相関でも、片方がもう片方の原因とは限りません。よく挙げられる例が、アイスクリームの売上と水難事故の件数です。気温が上がると両方が増えるので正の相関が出ますが、売上を減らしても事故は減りません。
気温のように両方を動かす共通の原因は、交絡因子(confounder)と呼ばれます。交絡因子がある時に原因と結果を調べるには、条件を変えて比べる実験か、実験ができなければ操作変数法や傾向スコアのように、観察したデータから因果を推定する方法が要ります。
Spearman・Kendall・ξ
Pearson 以外の相関係数は、積の平均という作りのどこかを変えています。
- Spearman: 値を順位に置き換えてから Pearson を計算する。
- Kendall: 2 点の組ごとに、
xとyの大小が同じ向きかを数える。 - ξ(xi):
xの順に並べ、隣どうしでyの順位が変わる幅を足す。
Spearman は 1904 年、Kendall は 1938 年に発表されました。どちらも順位しか使わないので、単調に増える関係なら曲がっていても 1 になり、外れ値を遠くへ動かしても、順位が同じなら値は変わりません。ただし、増えてから減る関係は、Pearson と同じく 0 に近づきます。SciPy では、Pearson を pearsonr、Spearman を spearmanr、Kendall を kendalltau で計算でき、pandas の DataFrame.corr も method に "spearman" と "kendall" を渡せます。
Chatterjee の ξ は、2019 年に arXiv で公開され、2021 年に学術誌 JASA に掲載された新しい相関係数です。SciPy には 1.15.0 で scipy.stats.chatterjeexi として入りました。x の小さい順に点を並べると、y が x で決まる時は、隣どうしの点で y が近い値になり、順位は少しずつしか変わりません。
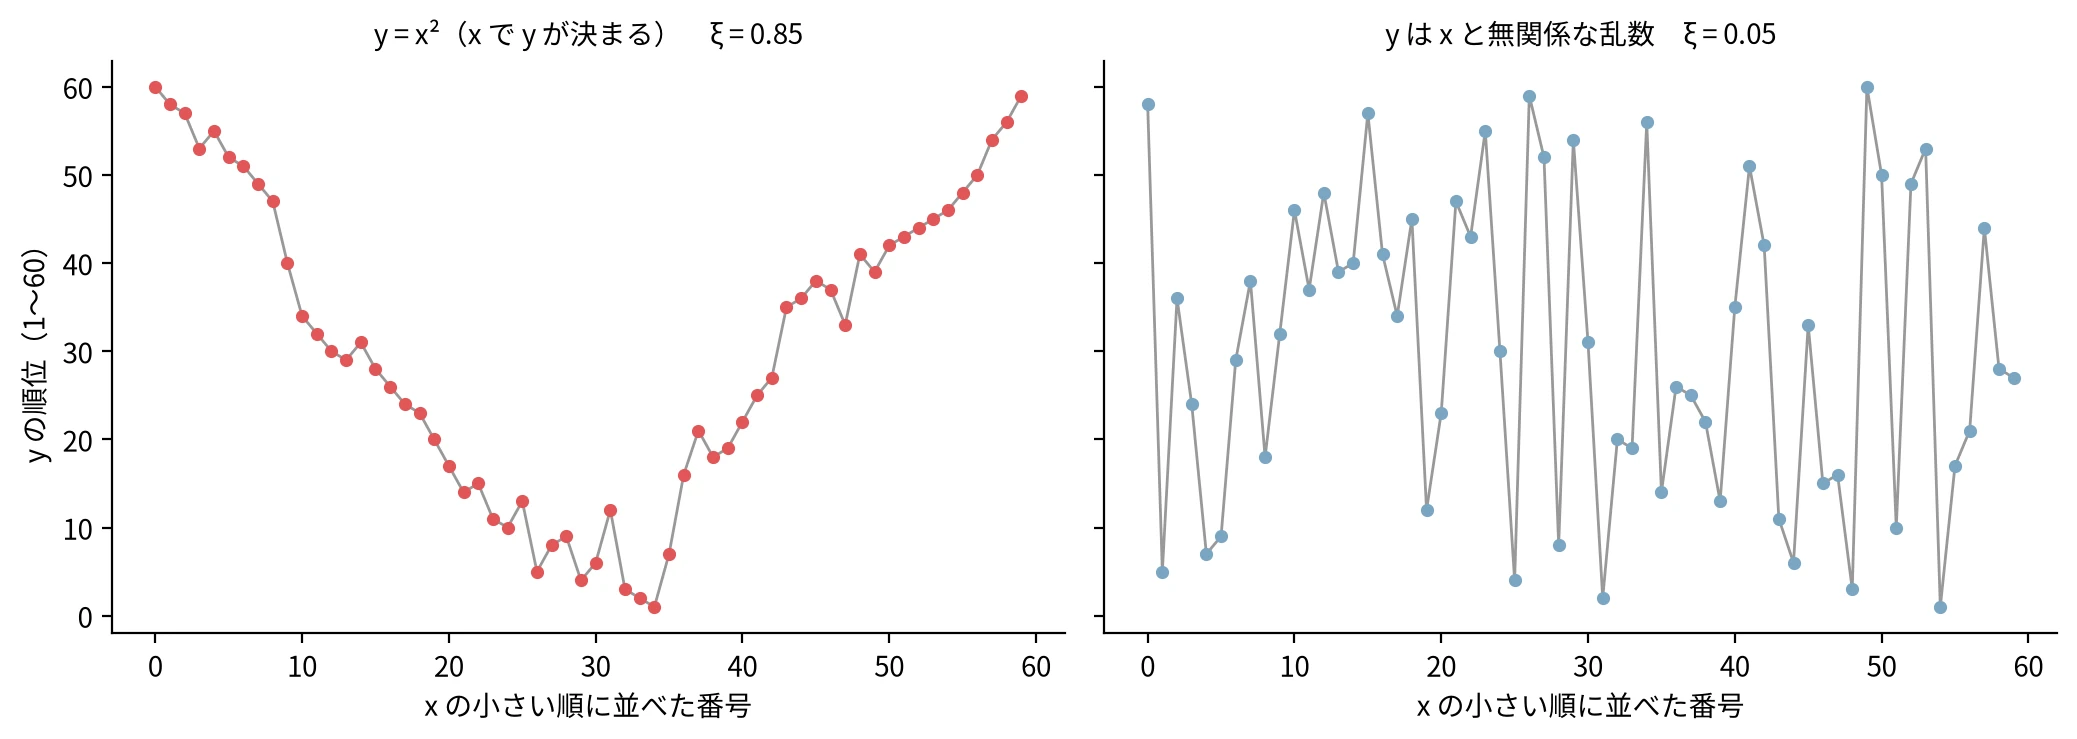
x の順に並べた y の順位。隣との差が小さいほど ξ は 1 に近い
左の y = x² は、順位が下がってから上がる V 字ですが、隣どうしの差は小さいので ξ は 0.85 になります。この図は見やすさのために 60 点で描いたもので、次の表は 500 点で計算したので、値が少し違います。右の乱数は隣どうしで順位が大きく跳ぶので、ξ は 0 に近くなります。ξ は、隣どうしの差の合計が、y の順位がでたらめに並んだ時と比べてどれだけ小さいかを表す値です。
同じデータで 4 つを比べる
本記事で使ったデータに、直線にノイズを足したデータと y = exp(x) を加え、4 つの相関係数を計算しました。
def four(x, y):
    return (np.corrcoef(x, y)[0, 1], stats.spearmanr(x, y).statistic,
            stats.kendalltau(x, y).statistic, stats.chatterjeexi(x, y).statistic)
| データ | Pearson | Spearman | Kendall | ξ |
|---|---|---|---|---|
| 直線にノイズ | 0.885 | 0.874 | 0.691 | 0.533 |
| y = exp(x) | 0.692 | 1.000 | 1.000 | 0.994 |
| y = x² | 0.080 | 0.128 | 0.107 | 0.806 |
| 外れ値 1 点(k = 30) | -0.246 | 0.396 | 0.270 | 0.107 |
| x1 と t | 0.011 | -0.002 | -0.003 | 0.066 |
Spearman と Kendall は、exp(x) のような単調な曲線では 1 になり、この 1000 点では外れ値 1 点で符号が反転することもありません。ξ は y = x² も 0.806 と見つけます。Kendall は同じデータで Spearman より小さく出やすく、直線にノイズを足したデータでは 0.874 と 0.691 でした。Pearson で使う目安は、Kendall にそのまま当てはめられません。
ξ でも見えない関係
それでも、ξ に置き換えれば済むわけではありません。直線にノイズを足しただけのデータでは、ξ は 0.533 と他の 3 つより小さく、r が 0.42 の 1000 点に外れ値 1 点を足したデータ(k = 30)では 0.107 しかありません。x と y を入れ替えると値も変わり、ノイズの無い 500 点で計算すると ξ(x, x²) は 0.988、ξ(x², x) は 0.259 でした。x² が分かっても x の符号は分からないので、後者は小さくなります。そして、2 列の掛け算の x1 と t は、4 つとも 0 に近いままです。
曲がった関係も数える指標には、ほかに相互情報量と、Székely 氏らの距離相関(distance correlation)があります。どれも 2 つの列だけを見るので、x1 と t の関係が見えないのは同じです。また、色や都道府県のようなカテゴリの列には相関係数を使えないので、Cramér’s V などを使います。満足度の 1〜5 のように順序のあるカテゴリなら、Spearman と Kendall が使えます。
順位の相関は ML の外でも使われています。PostgreSQL の統計情報 pg_stats の correlation は、表の中でレコードが置かれた順と、列の値を並べた順の相関です。プランナーはこの値が ±1 に近いほど、index scan を安く見積もります。仕組みは Index Scan のノートで説明しています。
相関行列を読む前に
相関行列で気になる値を見つけたら、まず散布図を描きます。冒頭の 4 枚は、どれも r の値だけでは形が分かりませんでした。曲がった関係や、1 点だけ離れた点は、図を見ればすぐ分かります。
次に、Pearson と Spearman を並べて計算します。外れ値 1 点の実験では 2 つの符号が食い違い、y = exp(x) では Spearman と Kendall だけが 1 になりました。食い違ったら、どちらが正しいかではなく、外れ値か曲がった関係のどちらがあるかを散布図で探します。
列を落とす判断には、目的変数と組ごとに計算した相関だけを使いません。2 列の掛け算の実験のように、1 列ずつでは相関が 0 でも、他の列と組んで効く列があります。列の効き目は、モデルに入れた状態で測ります。
最後に、行の数から偶然の大きさを見積もります。無関係な列どうしの r の標準偏差はおおよそ 1 / sqrt(n - 1) なので、30 行なら 0.19 ほど、|r| が 0.36 を超えるのは 20 回に 1 回ほどでした。列が多ければ、その中で一番大きい r は冒頭の 4 枚目のように 0.7 にも届きます。行が少なく列が多いデータでは、相関の大きい列を選ぶ前に、乱数の列でも同じくらいの r が出ないかを考えます。